Category: AI 实践

  • Codex No.1教程:喝茶聊天谈合同,最速项目一天交付,代码称斤时代已经到来

    Codex No.1教程:喝茶聊天谈合同,最速项目一天交付,代码称斤时代已经到来

    这不是一篇“安装 Codex、输入提示词、等待它写代码”的入门文章。

    这是一套已经在真实软件接管、并发开发、自动测试、客户交付和系统自举中使用过的方法:人类掌握目标与最终控制权,Codex 负责架构、调度和收口,多家 CLI 按能力与额度协同,合同与原始素材被编译成任务图、验收标准和可恢复的软件交付链。

    写这篇文章的起因是,我要去做其他事情了。

    而且你也不一定选Codex做主脑(猪脑)

    怎么便宜怎么来。

    我的蜂群上线已经到了4096,还算是浪漫的数字吧。

    未来就是不死鸟。

    说了不写教程真的是打自己的脸蛋啊。🧐

    主要要点流量,最近要搞搞宣发。
    图像

    Codex No.1教程:别再把 Codex 当聊天框,用蜂群OS把合同、素材和多 CLI 编译成一支高速 AI 开发团队

    一、为什么市面上大多数 Codex 教程还停留在“玩具阶段”

    最近关于 Codex 的教程越来越多,但大量内容仍然围绕几个初级动作:安装 CLI、选择模型、写一段很长的 Prompt、接入几个 MCP、让 Agent 修改一个文件,然后展示一句“测试通过”。

    这些内容不能说错,但它们回答的只是“一个 AI 能不能帮我写代码”,没有回答真正进入生产后必然出现的问题:

    • 一个项目有几十个任务时,谁决定先做什么?
    • Codex、Claude、Kimi、GLM 等多个 CLI 同时可用时,谁应该接单?
    • 某个模型额度不足、登录失效或者响应变慢时,任务怎样换人但不降级?
    • 多个 Agent 同时写代码,怎样避免相互覆盖?
    • 聊天窗口关闭、电脑重启或某个 CLI 崩溃后,任务怎样恢复?
    • Agent 说“完成了”,它到底完成的是代码、测试、部署,还是客户真的能用?
    • AI 开发 AI 自己时,怎样避免候选版本把唯一稳定版本一起弄坏?
    • 合同、访谈、客户素材、旧系统和数据库,怎样进入工程,而不是沦为 Prompt 附件?

    真正的分水岭,不是你会不会写提示词,而是你有没有一套“Agent 可以读取、执行、验证和恢复”的工程环境。

    OpenAI 在介绍 Codex App 时已经把方向说得很明确:开发正在从“和单个编码 Agent 配对”,转向“监督多个 Agent 完成设计、开发、发布和维护的全生命周期”,并且使用独立 Worktree 让多个 Agent 在同一仓库并行工作而不相互冲突。OpenAI 对 Codex App 与多 Agent Worktree 的说明

    OpenAI 后来把这种工作称为 Harness Engineering:工程师的核心工作不再只是亲手写每一行代码,而是设计环境、表达意图、构造反馈循环,让 Agent 能可靠地完成工作。OpenAI:Harness engineering

    蜂群OS的出发点与此一致,但再往前一步:

    不把 Codex 当成一个更聪明的代码补全工具,而把它当成 AI 开发组织的主入口;不把其他模型当成聊天备胎,而把它们当成需要入职考试、权限、额度、岗位和验收记录的工程成员。

    本文所谓“Codex No.1”,不是宣称某个模型永远占据排行榜第一。模型排名会变化,价格会变化,额度会变化,入口也会变化。这里的 No.1 指的是一条第一原则:

    人类控制目标,系统控制流程,模型负责执行,证据决定完成。

    二、蜂群OS到底是什么:不是模型套壳,而是一家可执行的 AI 公司

    蜂群OS(SwarmOS)是一层位于人类目标和各类 AI 执行器之间的开发操作系统。它的兼容内核可以叫 DeliveryOS,团队内部可以叫 Agent 军团,但其逻辑只有一套:

    text

    人类蜂王主脑
        │ 目标、边界、最终批准
        ▼
    蜂群OS 控制面
        │ 项目、任务图、身份、策略、Session、事件、证据
        ├───────────────┐
        ▼               ▼
    质量路由器        耐久调度器
    能力/质量/额度     队列/重试/恢复
        └───────┬───────┘
                ▼
    本机或远程 Worker
                │
      Codex / Claude / Kimi / GLM / 其他合格 CLI
                │
                ▼
    Worktree → 测试 → 审查 → 候选版本 → 交付证据

    这里有四个经常被混淆的身份。

    第一,人类是唯一蜂王主脑。人类决定业务目标、资金动作、最终风险接受程度和版本晋级。AI 可以处理大量日常事务,但不能把“安装了一个插件”解释为“获得了全局治理权”。

    第二,蜂群OS Core 是控制面。它保存项目、任务依赖、运行状态、权限、派单结果和证据。这些状态不能只活在某个聊天窗口里,否则换一个平台、关掉一个会话,整个团队就失忆。

    第三,Worker 是执行节点。它可以是当前电脑、另一台工作站、服务器,也可以是未来接入的临时算力节点。Worker 只执行获批任务,不拥有全局调度权。

    第四,CLI 是可替换的员工入口。Codex、Claude、Kimi、GLM 或其他模型渠道都只是适配器。它们使用设备所有者自己的账号、登录和额度;蜂群身份凭据只负责证明“谁有权接什么任务”,绝不能复制或冒充模型账号。

    这一区分极其重要。没有它,多 Agent 系统很容易变成一堆脚本互相调用:任何脚本都能改策略,任何节点都能发任务,任何模型都能自称审查通过。看起来热闹,实际上没有组织。

    三、AGENTS.md 不是提示词,而是这家 AI 公司的工程宪法

    很多人把 AGENTS.md 理解成“告诉 Codex 代码风格的地方”。这只用了它很小的一部分价值。官方资料也建议用 AGENTS.md 给 Codex 持续提供仓库级上下文,例如代码组织方式、测试方法和工程约定。OpenAI:Codex 与 AGENTS.md

    在蜂群工程里,AGENTS.md 应该承担四层职责。

    1. 身份层:谁能决定什么

    markdown

    - 用户是唯一 controller,拥有项目创建、Worker 批准和版本晋级权。
    - worker 只能执行被分配的任务并回传证据。
    - standalone 只能管理本机范围,不能自动加入全局蜂群。

    这不是“建议”,而是运行时权限合同。界面隐藏按钮不算权限控制,API、MCP 和 Core 必须真正拒绝越权请求。

    2. 行为层:哪些事情自动做,哪些事情必须停下

    好的 Agent 团队不应该每三分钟问一次“我可以继续吗”。普通安装、依赖修复、测试、进程重启和候选部署,应当在明确范围内自主完成。真正需要人类确认的是付款、整机重启、整机关机、不可逆数据删除、正式版本晋级等少数动作。

    授权边界越清楚,Agent 越快。模糊的权限不会带来安全,只会带来两种坏结果:要么 Agent 什么都问,团队失去速度;要么 Agent 自己猜,风险反而更大。

    3. 工程层:怎么写、怎么并行、怎么验证

    markdown

    - 写任务必须拥有唯一文件范围。
    - 多个写入型 Agent 默认使用独立分支与独立 Worktree。
    - 一个提交只包含一个可解释、可验证、可回退的变化。
    - “进程启动”不等于“功能完成”;必须验证真实用户入口。
    - 不覆盖唯一稳定版本,候选版本单独安装和验收。

    这里最关键的不是“写 TypeScript 还是 Python”,而是把并发边界写清楚。真正的并行不是让四个模型一起改同一个文件,而是把任务拆成互不重叠的所有权:一个负责数据面,一个负责 API,一个负责前端,一个负责部署,一个只读审查。

    4. 记忆层:让错误变成下一次的能力

    每次失败都必须留下可复用记录:症状、根因、无效尝试、最小解法、验证方法、回滚方式和防复发动作。否则同一个团队只是拥有很多上下文很长、但每天都会失忆的聊天机器人。

    因此,一个成熟仓库至少应该有这些事实源:

    text

    AGENTS.md                 全局治理与工程规则
    README.md                 管理入口
    catalog.yaml              资产索引
    projects/<id>/PROJECT     项目定义
    projects/<id>/TASK-GRAPH  可执行任务图
    projects/<id>/LEDGER      时间、成本、错误、证据账本
    members/                  设备、服务、模型、插件档案
    runbooks/                 可重复操作方法
    logs/                     已发生事件
    evidence/                 测试与验收结果

    四、最快的 AI 开发,不是从 Prompt 开始,而是把现实“编译”成工程

    软件项目最原始的输入,通常根本不是代码。它可能是一份合同、四个压缩包、一堆截图、客户语音、旧数据库、产品原型、历史聊天记录,以及一句“帮我尽快上线”。

    普通做法是把这些材料扔进模型,让它总结需求。蜂群方法不是“总结”,而是“编译”。

    为什么要用编译这个词?因为编译有源文件、有中间表示、有类型检查、有错误、有目标产物。原始合同不能在模型总结之后消失;模型的推断不能伪装成客户事实;模糊条款必须成为待决问题;每一项交付要求必须能追到验收动作。

    完整链路如下:

    text

    合同 / 原始素材 / 旧系统 / 客户访谈
                    │
                    ▼
    第一层:原件保全
    哈希、只读副本、版本、来源、时间、缺失项
                    │
                    ▼
    第二层:事实抽取
    角色、业务对象、流程、接口、数据、非功能约束
                    │
                    ▼
    第三层:交付定义卡
    本期做什么、不做什么、什么叫可演示、什么叫可交付
                    │
                    ▼
    第四层:验收 Oracle
    可重复执行的业务、权限、性能、恢复和客户体验判定
                    │
                    ▼
    第五层:任务 DAG
    依赖、Owner、能力角色、写入范围、输入、输出、失败条件
                    │
                    ▼
    第六层:Agent 执行与证据回写
    Session、Worktree、提交、测试、部署、日志、成本

    原件保全:先确保 AI 没有“理解错后毁掉证据”

    接管旧项目时,不要先运行格式化,不要先删除“看起来没用”的文件,更不要为了 Git 状态漂亮直接清理现场。应该先记录:

    • 原始包和关键归档的 SHA-256;
    • Git Bundle 或仓库历史是否完整;
    • 未提交、已删除、未跟踪内容;
    • 数据库和容器卷是否可恢复;
    • 原平台实际入口与运行版本;
    • 哪些数据源才是业务权威。

    AI 时代最昂贵的错误,经常不是代码写错,而是把唯一原件覆盖后,所有 Agent 都在错误事实之上高速前进。

    交付定义卡:把“做完”变成类型,而不是情绪

    一个项目至少要区分四种状态:

    1. code-complete:代码已实现,局部测试通过;
    2. integrated:与主链合并,回归通过;
    3. preview:真实入口可访问,目标角色能操作;
    4. deliverable:备份恢复、迁移、客户文档、公网入口和最终验收全部完成。

    很多 AI Demo 的问题,是把第一个状态叫成第四个状态。页面打开了,就说系统交付了;接口返回 200,就说业务闭环了;容器在运行,就说部署成功了。

    蜂群OS要求每个状态都有证据,状态不能靠 Agent 的语气推进。

    验收 Oracle:在写代码之前定义“机器如何判案”

    Oracle 不是一句“请确保质量良好”,而是可执行判定。例如:

    yaml

    task: appointment-concurrency
    input:
      appointment_id: seeded-fixture-01
    action:
      concurrent_requests: 2
    expected:
      success_count: 1
      conflict_count: 1
      audit_records: 1
      final_status: confirmed

    当两个请求同时修改一个预约时,究竟应该发生什么?如果这个问题没在任务开始前说清楚,两个模型可能分别写出“看起来合理”的实现,而集成时才发现业务语义冲突。

    五、任务图:把“帮我做完项目”变成可以并行的依赖网络

    大目标不能直接平均切成四份。任务图必须先找依赖,再找可以并行的边界。

    yaml

    waves:
      - id: W0
        name: 事实冻结
        tasks:
          - id: contracts
            mode: readonly
            outputs: [业务合同, 角色矩阵, 数据字典]
    
      - id: W1
        name: 基础内核
        depends_on: [W0]
        tasks:
          - id: api-kernel
            write_scope: [apps/api/**]
          - id: plugin-sdk
            write_scope: [packages/plugin-sdk/**]
    
      - id: W2
        name: 领域并行
        depends_on: [W1]
        tasks:
          - id: health-domain
            write_scope: [domains/health/**]
          - id: finance-domain
            write_scope: [domains/finance/**]
          - id: report-ai
            write_scope: [domains/reports/**]
    
      - id: W3
        name: 集成与交付
        depends_on: [W2]

    一个任务节点至少包含:目标、依赖、角色、读写模式、唯一写入范围、输入版本、输出、测试、超时、重试、回退、成本影响和证据位置。

    模型名称不应该成为业务合同。任务写的是“需要通过后端并发角色实测的实现者”,而不是永远写死“必须某模型”。今天最强的模型,明天可能额度不足;今天失败的渠道,明天可能升级。供应商是路由层的决定,不是产品层的依赖。

    六、多 CLI、多模型调度:谁空闲、谁合格、谁有额度,谁上

    “多模型协作”最容易被写成一张华丽的架构图:一个模型负责规划,一个模型负责代码,一个模型负责审查。问题是,现实中的渠道不是永远在线的。额度会重置,账号会掉登录,代理会波动,CLI 会升级,模型身份会漂移,某个擅长前端的模型也未必适合财务并发。

    所以蜂群调度不能固定成一张供应商座位表,而要像生产调度系统一样,每次派单重新计算。

    第一道门:角色资格

    模型必须先通过对应岗位的真实考试。例如:

    • implementation/frontend:能否理解现有设计系统、完成响应式页面、通过构建和浏览器测试;
    • implementation/backend:能否处理事务、幂等、状态机、并发和迁移;
    • review:能否找到可复现的问题,而不是只输出风格意见;
    • research:能否区分官方资料、二手线索和本机实测;
    • mechanical:能否稳定完成 Schema、格式、批量边界检查。

    没有通过岗位实测的模型,即使便宜、空闲、额度很多,也不能接这个岗位。质量资格永远先于成本。

    第二道门:当前身份与健康

    调度器要确认实际调用的模型是谁、CLI 版本是什么、登录是否有效、网络和代理路径是否可用、最近一次真实调用是否成功。配置文件写着“高级模型”不代表当前运行的就是它。

    第三道门:可信额度

    “我感觉还有额度”不能用于自动派单。额度记录至少要包含:

    • 已使用和剩余比例;
    • 额度窗口与重置时间;
    • 官方数据、会话消耗还是本地估算;
    • 采集时间和是否过期;
    • 是否需要人工登录;
    • 保留线。

    未知额度的渠道可以被人工点名做健康探测,但不能加入自动路由。某渠道达到保留线后停止接收新任务,保留给关键收口或用户直接使用。

    第四道门:空闲槽位与重复消费保护

    同一个任务必须有稳定的幂等键。即使控制面超时,也要先查询后端是否已经接受,不能因为“没看到回复”就再派一次,导致两个模型同时写同一任务、消耗两份额度。

    可以把路由逻辑简化为:

    python

    eligible = [
        worker for worker in workers
        if worker.role_certified(task.role)
        and worker.model_identity_verified
        and worker.login_healthy
        and worker.quota.is_fresh
        and worker.quota.above_reserve
        and worker.available_slots > 0
        and task.provider_pool.allows(worker.provider)
    ]
    
    selected = rank(eligible, by=[quality, latency, cost, load]).first()

    这里最容易犯的错误是“显式指定模型就绕过其他规则”。正确语义应该是取交集:用户点名的 Provider 仍然必须属于项目允许池,仍然必须通过角色、额度、健康和权限门禁。空 Provider 池意味着禁止任何模型自动执行,不能因为请求里又写了一个模型名就把它重新塞回来。

    不平均分配,也不浪费已购买渠道

    蜂群不是为了追求“每个模型今天都用一次”。平均分配看似公平,实际会把关键任务交给不合适的模型。正确目标是单位墙钟时间内的有效交付:

    • 合格、空闲、有可信额度的成员优先;
    • 多个合格者同时存在时,按质量、速度、成本和负载排序;
    • 某渠道需要反复弹网页登录,就标记为手动,不让它拖住后台队列;
    • 同一模型连续失败不无限重试,按预设 cascade 换人;
    • 实现和最终独立审查使用不同供应方;
    • 主脑模型也在规则内,不应把自己额度打空再让其他 CLI 闲置。

    七、连接层改用 Tailscale:让蜂群跨设备,但不把控制权交给网络

    蜂群从单机扩展到工作站、服务器、手机和异地节点后,首先需要解决的是私有连接。目标不是“所有设备互相 ping 通”,而是让正确身份只能访问正确端口,并且节点更换网络后仍能被稳定发现。

    蜂群OS下一版连接层采用 Tailscale,但必须明确两层身份不能混为一谈:

    text

    Tailscale 身份:这台设备能否到达某个 IP/端口
    SwarmOS 身份:这台设备能否接任务、改策略、批准 Worker、晋级版本

    Tailscale 负责加密网络、设备发现和网络访问策略;蜂群OS Core 仍负责 controller、worker、standalone 权限。一个节点能连接 Core,不等于它有权创建全局项目。

    推荐拓扑

    text

    Tailscale tailnet
    
           ┌──────────────────────────────────┐
           │                                  │
    蜂王控制端                         只读观察端
    tag:swarm-controller              tag:swarm-observer
           │                                  │
           ├──── Core API / Event Stream ─────┤
           │
           ├──────────────┬──────────────┐
           ▼              ▼              ▼
    开发工作站         GPU/模型节点       部署服务器
    tag:swarm-worker  tag:swarm-worker   tag:swarm-prod

    新 tailnet 如果没有自定义访问策略,不能想当然地认为已经完成最小权限。Tailscale 当前推荐新配置使用 Grants;Grants 可以按用户、组、标签、目标和端口声明访问能力。Tailscale:Grants

    下面是概念示例,不是可直接复制到任何账号的生产配置:

    jsonc

    {
      "tagOwners": {
        "tag:swarm-controller": ["autogroup:admin"],
        "tag:swarm-worker": ["tag:swarm-controller"],
        "tag:swarm-observer": ["autogroup:admin"]
      },
      "grants": [
        {
          "src": ["tag:swarm-controller"],
          "dst": ["tag:swarm-worker"],
          "ip": ["tcp:22", "tcp:8890"]
        },
        {
          "src": ["tag:swarm-worker"],
          "dst": ["tag:swarm-controller"],
          "ip": ["tcp:8890"]
        },
        {
          "src": ["tag:swarm-observer"],
          "dst": ["tag:swarm-controller"],
          "ip": ["tcp:8890"]
        }
      ]
    }

    真实配置必须进一步区分“控制 API”“只读事件流”“部署入口”,不能让观察端因为能打开控制台就自动拥有修改权。

    节点入网方式

    人工设备可以通过交互登录加入;服务器适合使用带标签的 Auth Key,临时容器或一次性 Worker 使用 Ephemeral Key。长期自动化不要把永不过期的密钥写进仓库,可以使用受限 OAuth Client 动态生成 Auth Key。Tailscale 的服务器部署指南也建议用标签约束服务器访问,并针对长期自动化使用 OAuth Client。Tailscale:设置服务器 Tailscale:OAuth Clients

    蜂群档案中只记录凭据引用、用途和恢复方法,不输出密钥本身。

    从现有连接迁移到 Tailscale 的正确顺序

    不要一上来卸载旧网络。生产迁移使用双轨法:

    1. 只读盘点现有节点、地址、服务、路由和防火墙;
    2. 安装 Tailscale,但保留旧连接;
    3. 给控制端、Worker、服务器分配清晰标签;
    4. 写 Grants,并用策略测试验证允许与拒绝路径;
    5. 让 Worker 通过 Tailscale 完成一次真实任务领取、执行、证据回传;
    6. 模拟 CLI 失败、节点掉线和控制端重启,验证恢复;
    7. 更新资产档案和 MagicDNS 名称,不把临时 IP 写死在项目里;
    8. 观察稳定后再停止旧路径;
    9. 回滚窗口结束后,旧网络才进入退役,而不是直接删除。

    如果需要更强的节点加入保证,可以评估 Tailnet Lock,由受信节点签署新节点密钥;但它属于后续安全增强,不应在功能迁移的每一步反复打断开发。Tailscale:Tailnet Lock

    八、Session、Worktree 和事件流:让并行开发可恢复,而不是靠聊天记忆

    每次可恢复工作都必须拥有 Session ID。Session 不是聊天标题,而是一条工程记录:

    yaml

    session_id: 20260902T150626Z-glm-xxxxxx
    team: fast-development
    task: report-data-plane
    provider: glm
    mode: write
    repo: health-platform
    branch: agent/swarm/...
    worktree: /isolated/worktrees/...
    write_scope:
      - apps/reporting/**
    started_at: ...
    status: running
    final_commit: null
    evidence: []

    写入型 Agent 默认使用独立 Worktree。只读研究可以共享仓库,但不能写。每个文件范围只有一个 Owner;其他 Agent 可以审查该范围,却不能同时改它。

    任务运行时,控制面追加事件:

    text

    control/created
    control/approved
    control/dispatch_claimed
    control/dispatched-by-core
    control/observed running
    verification/command_started
    verification/command_completed
    control/observed succeeded

    为什么要追加事件,而不是只保存一个 status=succeeded?因为最终状态无法解释发生了什么。一个任务可能在后端已接受后网络超时,如果控制面误以为没派出去,又重新派一次,就会形成重复消费和并发写入。事件流让系统判断“从未接受”“已接受但确认未知”“Worker 已开始”“Worker 已结束”这些完全不同的状态。

    更重要的是,进度终于可以给人看。用户不应该面对一个沉默七小时的黑箱。控制台至少要展示:当前波次、正在执行的任务、负责人、模型、Session、Worktree、开始时间、最近事件、测试进度、额度状态、阻塞原因和下一验收点。

    九、狗粮循环:蜂群OS必须先能安全地开发自己

    狗粮循环不是一句“我们也使用自己的产品”。真正的自举必须让当前稳定版创建候选版,并且候选版不能覆盖唯一可用版本。

    蜂群OS的发布链是:

    text

    stable 稳定版
      → 创建自举项目与任务图
      → 独立 candidate Worktree
      → 合格且有额度的 CLI 实现
      → 自动测试
      → 异源 Provider 功能审查
      → 独立安全审查阶段
      → 插件清单与 Skill/MCP 验证
      → 使用新 cachebuster 并行重装候选插件
      → 干净新会话重新发现与真实调用
      → 蜂王主脑批准晋级
      → 新 stable

    为什么必须重新安装

    源码通过测试,不代表用户实际加载的插件就是这份源码。插件缓存、版本号、Skill 发现和 MCP 配置都可能仍指向旧版本。因此候选必须使用新版本标识安装到独立缓存,并比较源码与安装产物;当前稳定缓存保留,出现问题可以恢复。

    为什么必须用干净新会话

    当前聊天可能已经加载旧 Skill、旧工具清单和旧说明。只有新会话从零发现插件、识别蜂群身份、读取最新 AGENTS.md,并完成一次真实任务,才能证明“下一位用户真的拿到了新版本”。

    为什么安全审查放在功能完成之后

    高速开发不等于没有安全。正确做法是阶段化:日常实现先完成业务功能和自动测试,项目功能收敛后再启动一次独立安全审查。这样安全审查面对的是稳定候选,不会在每个小步骤上重复检查尚未成形的代码。

    只有三类事件允许中途紧急拦截:正在发生的凭据泄露、不可逆数据损失风险、权限越界。其余安全检查进入收尾阶段,由异源 Provider 或独立安全角色执行,开发者不能自我批准。

    一次真实自举暴露了什么

    在蜂群OS自举测试中,曾出现一个很有代表性的竞态:调度后端已经接受任务,Worker 启动得非常快,抢在 Core 持久化标准执行对象之前进行了恢复。任务本身成功了,但发布门禁需要的“由 Core 确认派单”事件缺失。

    如果只看最终状态,这个任务是绿色的;如果看事件链,它不具备可证明的主脑调度路径。

    修复不是简单地“多等几秒”,而是同时建立三条规则:

    1. Worker 给 Core 一个短暂的优先确认窗口;
    2. Core 晚到时,只能对 attempt、claim、execution 和 idempotency key 完全一致的恢复结果做幂等确认;
    3. 发布门禁必须绑定当前这一次 execution,旧尝试留下的成功事件不能替新任务过关。

    另一次独立审查发现:项目已经明确给出空 Provider 池,但请求又显式指定模型时,路由器把该模型重新加入了候选。所有自动测试当时都通过,因为测试只覆盖了“空池+自动选择”,没有覆盖“空池+显式模型”。异源审查提出反例后,路由语义改为交集,并补上正反回归。

    这就是狗粮循环的价值:不是为了证明系统永远不出错,而是强迫系统在开发自己时,把隐藏假设变成运行时规则和防复发测试。

    十、脱敏实战:某大健康 SaaS 如何把一天压缩成可交付 V1

    下面的数据来自一个真实的大健康软件接管与交付项目。为保护客户和业务数据,项目名称、域名、账号、机器地址、仓库路径、患者信息、报告内容和凭据全部省略;保留的只有任务类型、时间跨度、测试数量和可验证结果。

    起点不是空仓库,而是约 4.5GB 的复杂现场

    输入包括两套 Git 历史、多个容器卷归档、旧平台的未提交现场、ERP/医疗业务引擎,以及客户要求保留的原始资料。团队首先完成哈希校验和恢复演练,把正式 Git 开发工作区精简到约 86MB,同时保留原件、未跟踪交付物、已删除现场痕迹和原始数据卷。

    这一步没有直接产生新页面,却决定了之后的所有高速开发是否可回滚。

    并发不是一句口号,而是十条独立 Session

    开发队把任务拆为数据面、API、前端、AI 报告链、任务与预约、生产容器、独立审查和最终集成等边界,共留下 10 条可恢复 Session。Kimi、GLM、Claude 与 Codex 使用不同分支和 Worktree,Codex 主要承担架构、集成、关键修复和最终验收,而不是把批量编码全部压在一个渠道上。

    已登记的第一条并发开发 Session 在当晚 23:06 启动。到次日 01:40,生产化前端入口、API 反向代理、容器健康检查和发布包更新已经形成提交:关键开发窗口的墙钟跨度约 2 小时 34 分。

    到次日 12:30,专业 V1 最终提交形成:从第一条 Session 到最终提交的墙钟跨度约 13 小时 24 分。这个数字包含模型执行、集成、返工、容器构建和测试等待,不应解释为单个 Agent 连续编码 13 小时,也不等于从商业立项到客户签收只需 13 小时。它说明的是:当任务边界、环境和验收足够清楚后,一支多 CLI 团队可以把大量原本串行的工程工作压入同一夜和半天。

    真实速度不只看“写了多少代码”

    AI 报告链使用脱敏 PDF 和 JPG 进行真实端到端测试:上传、OCR、AI 结构化处理、医生审核发布、用户读取与提问、时间线回读全部跑通。桌面路径用时 54.9 秒,移动路径用时 57.3 秒。服务重启后,7 份已发布报告仍然存在。

    这比“接口响应 200”更接近用户感知速度:一分钟内完成一条完整业务链,而且结果经过重启持久化验证。

    最终验收规模

    专业 V1 收口时,机器证据包括:
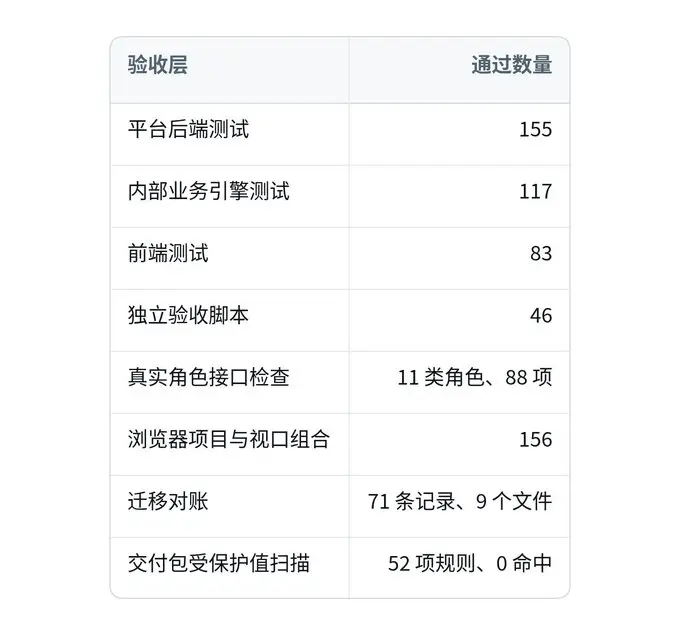
    图像

    此外还完成了财务开单、收款、应收结清和总账回读,库存入库、出库、盘点调整与流水回读,备份与隔离恢复演练,以及公网多角色登录与关键业务读取。

    独立审查为什么没有拖慢项目,反而节省返工

    异源审查复现了预约状态转换的并发问题:两个并发请求可能同时成功并产生两条审计。实现者自己的常规测试没有暴露它。修复使用原子条件更新,并新增六项并发与边界回归。

    这说明 review 的价值不是每做一步就让同一个人再看一遍,而是在功能和自动测试形成后,由不同模型主动构造反例。一次有效的异源审查,远比十次“代码看起来不错”的自我检查有价值。

    这个案例也暴露了流程损耗

    真实项目并非完美演示。最大的时间浪费不在写代码,而在以下内容确定得太晚:

    • “Demo”“V1”“可交付”“客户可用”的口径不同;
    • 客户入口、账号和文档标题反复变更;
    • 开工前没有保存所有模型的额度基线,无法严谨计算项目净消耗;
    • 客户手册和验收脚本接近结尾才集中制作;
    • 身份库与业务权威数据源一度被混淆。

    因此蜂群OS后来把交付定义卡、客户验收 Oracle、入口冻结点、四层成本账本和错误事件流提升为开工门禁。真实项目的意义,不是提供一个漂亮的成功故事,而是让下一次开发少走同样的弯路。

    十一、如何估算 AI 项目:别再只说“几个人天”

    传统人日仍可用于商务沟通,但它不再是最准确的工程单位。蜂群项目应同时报告三种时间:

    1. 机器执行时间:所有 Agent、测试、构建累计消耗的时间;
    2. 关键路径墙钟时间:从开工到满足下一门禁的现实时间;
    3. 外部等待时间:登录、付款、平台审核、客户反馈、DNS 生效等非工程等待。

    再分别给出 P50 和 P90。假设三条独立任务各需一小时,并行执行后机器时间是三小时,关键路径可能只有一小时;但如果最后必须等待一次人工批准,关键路径仍由批准时间决定。

    AI 时代真正稀缺的资源往往不是生成 Token,而是人类注意力、清晰决策、可测试环境和可靠反馈。OpenAI 的公开工程实践也强调,随着 Agent 吞吐提高,人类 QA 会成为瓶颈,因此需要让 UI、日志、指标和测试本身对 Agent 可读。OpenAI:Harness engineering

    十二、一个团队如何从单个 Codex 升级为蜂群

    不需要第一天就搭建完整平台。可以按四个阶段升级。

    阶段一:让单个 Codex 可预测

    • 写一份简洁但强制的 AGENTS.md;
    • 固定真实测试命令;
    • 记录项目事实源;
    • 每个任务明确写入范围;
    • 要求结果附带验证证据。

    阶段二:让多个 Agent 可并行

    • 为写任务创建独立 Worktree;
    • 定义文件 Owner;
    • 使用任务 DAG,而不是共享待办清单;
    • 把实现和审查分给不同 Agent;
    • 建立小而完整的提交规范。

    阶段三:让多个 CLI 可调度

    • 为每个 CLI 建能力档案;
    • 做岗位实测,不照抄厂商宣传;
    • 接入官方额度、健康和登录状态;
    • 设置保留线、手动渠道和失败 cascade;
    • 用幂等键防止重复派单与重复消费。

    阶段四:让团队可跨设备、自举和发布

    • 用 Tailscale 连接控制端与 Worker;
    • 网络标签与蜂群身份分层;
    • 状态离开聊天窗口,进入 Core 与事件存储;
    • 稳定版和候选版并存;
    • 建立完整狗粮循环;
    • 只有人类 controller 能批准晋级。

    十三、可以直接复制的项目开工清单

    markdown

    ## 目标
    - 客户最终拿走什么?
    - 哪些角色使用?
    - 什么叫 code-complete / preview / deliverable?
    
    ## 原始输入
    - 原件路径与哈希
    - 合同版本
    - 权威数据源
    - 已知缺失和冲突
    
    ## 边界
    - 本期明确包含
    - 本期明确不包含
    - 必须人工批准的动作
    - 不可触碰的稳定资产
    
    ## 任务图
    - 依赖
    - 能力角色
    - 唯一写入范围
    - Session / Branch / Worktree
    - 验收 Oracle
    
    ## 路由
    - 合格 Provider 池
    - 当前额度和采集时间
    - 保留线
    - 手动渠道
    - 失败回退链
    
    ## 发布
    - 自动测试
    - 异源功能审查
    - 独立安全审查
    - 候选安装
    - 干净会话验收
    - 回滚路径
    - controller 晋级批准

    最后:提示词会过时,工程闭环会复利

    如果只是让 Codex 帮你改一个按钮,当然不需要蜂群OS。但当你开始接管真实项目、处理合同和原始数据、同时使用多个 CLI、连接多台设备、需要客户验收并且不能破坏稳定版本时,单个聊天窗口很快会到达极限。

    这时真正决定速度的,不是再写一段更神奇的 Prompt,而是建立一套可读、可执行、可恢复、可验证的组织:

    • 合同和素材被编译成事实、任务和 Oracle;
    • AGENTS.md 把治理意图固化成工程宪法;
    • Tailscale 提供跨设备私有连接,蜂群身份继续控制业务权限;
    • 多 CLI 按能力、质量、额度、健康和空闲动态上岗;
    • Session、Worktree 和事件流让并行工作可恢复;
    • 自动测试决定功能事实,异源审查寻找反例;
    • 狗粮循环保证系统先能可靠地开发自己;
    • 最终版本只能由人类蜂王主脑晋级。

    模型会越来越强,单次生成会越来越便宜。真正长期增值的,是你的合同编译器、任务图、测试 Oracle、错误知识库、模型能力档案和发布闭环。它们会让下一批 Agent 比上一批更快,让每次失败都变成团队资产。

    这才是 Codex No.1 的含义:不是把一个模型捧上神坛,而是让 Codex 成为一支可管理、可替换、可证明的软件蜂群的第一入口。

    资料与数据口径

    • Codex、Worktree、AGENTS.md 与 Harness Engineering 的产品方向,参考 OpenAI 官方公开资料;文中蜂群OS架构、路由、狗粮循环和项目流程来自实际工程实践。
    • Tailscale 部分依据其官方 Grants、服务器部署、OAuth Client 和 Tailnet Lock 文档撰写;示例为目标架构,实际迁移必须在节点盘点、双轨验证和回滚准备后执行。
    • 案例来自内部项目账本、Session 档案、Git 提交时间和验收日志。为了脱敏,删除了项目名、客户名、域名、账号、设备、路径、提交号、健康数据和凭据。
    • “2 小时 34 分”和“13 小时 24 分”均为已登记 Session 启动时间到对应提交时间的墙钟跨度,不是单模型纯推理时间,也不用于推导传统团队必然需要多少人日。
    来源:https://x.com/dashen_wang/article/2096157899554693239

  • 大神 X Console v1:发布不是点击,是一条只能走一次的链

    大神 X Console v1:发布不是点击,是一条只能走一次的链

    大神 X Console v1:发布不是点击,是一条只能走一次的链

    很多人理解的自动发布,是找到按钮,然后点击。

    我做的不是这个。

    大神 X Console v1 把一次 X 发布拆成七个独立问题:内容从哪里来,当前账号是谁,目标是谁,媒体是否正确,正文是否一致,提交发生过几次,公开链接能不能找回来。

    七种内容类型,共用一个入口:

    • 短推。
    • 图文。
    • 串推。
    • 投票。
    • 引用。
    • 回复。
    • X Article。

    但它们不会共用一个粗暴的发布脚本。

    短推需要验证 DraftJS 内部状态。

    图文需要验证媒体数量与顺序。

    串推需要逐条确认 status URL 和父子回复关系。

    投票需要确认选项与时长。

    引用和回复必须锁定源 status ID。

    Article 的 Markdown 导入、草稿验收、最终提交与公开回读,是四个不同阶段。

    最重要的规则只有一条:

    提交次数从零变成一以后,就不能再变成二。

    如果提交后页面断开,或者公开链接暂时查不到,任务不会变成“失败后重试”。

    它会进入 submitted_uncertain。

    从这一刻开始,只允许只读回查。

    因为一个自动化系统真正危险的地方,从来不是它偶尔没发出去。

    而是它在不确定的时候,又发了一遍。

    插件负责输入、预览和机械验收。

    本地控制面负责授权、排队、去重和回执。

    浏览器排程器保证同一时刻只有一个任务操作父亲的账号。

    最终写入仍然只有一个 Owner。

    这不是为了让发布变复杂。

    是为了让每一次发布,都能说清楚:谁授权,发了什么,提交几次,最后在哪里。

    来源:https://x.com/dashen_wang/article/2092472179317527005

  • 说一句收到,我花了20341个token

    说一句收到,我花了20341个token

    先给你看一笔账。

    我修好了一个出故障的AI成员,要验证它活没活过来。方法很朴素:给它发一句话,「回复两个字:收到」。

    它回了。两个字,收到。一切正常。

    然后我翻到这次对话的账单。输入:两万零三百四十一个token。

    一句话,两个字,两万个token。

    我第一反应是账单错了。第二反应是去查。查完发现账单没错,错的是我对「说一句话」的理解——在Agent的世界里,它每次开口前,都要先把自己背诵一遍。

    这篇文章就写这笔账。写它为什么发生,写它是怎么把我整个月的成本结构吃掉的,写我最后怎么把这笔钱省下来——以及省下来之后,我看到了一笔更贵的、省不掉的账。

    一、伤口:一句「收到」的一千倍

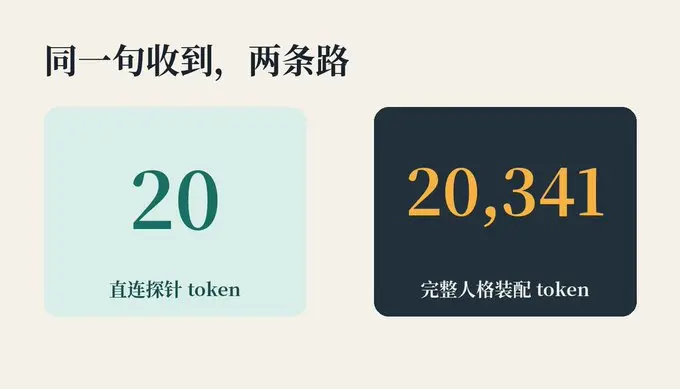
    同一句收到的两条调用路径:约20 token与20341 token。

    先把这笔账拆开给你看。

    我直接拿模型问一句话,「收到」,两个字的输入。这次调用花多少?二十个token上下。模型翻了翻我这十个字,回了两个字,各找各妈,两清。

    同一个「收到」,我发给那个成员,走它的对话入口。账单变成两万零三百四十一。

    中间差了一千倍。钱花在哪了?

    花在它的自我介绍上。这个成员每次被叫醒,系统都要先给它装配一遍它这个人:它的记忆、它的技能清单、它的历史会话、它的工具目录、它的人格说明。两万个token里,我的那句「收到」只占十个,剩下的全是它的身份装配。它回答我之前,要先把自己是谁想一遍——想一遍,收一遍钱。

    而且这不是一次性费用。每一次对话,它都要重新装配一遍自己。你说一百句话,它背一百遍自己的简历。你每次找它,哪怕只是问一句在不在,它都要先把二十年的履历从头到尾背诵一遍,然后才开口。

    我算了一下那个月的账。军团十几个成员,日常巡检、健康探针、例行问答,每一项都是这种「小请求、大装配」。我花在「它们背诵自己」上的钱,比花在「它们干活」上的钱还多。我养的不是一群员工,是一群每次开口前都要先朗诵入职登记表的员工。朗诵费我出。

    这笔账再往大摊一层,你会看见湖的全貌。一次身份装配两万token,一个成员一天被叫醒五十次,就是一百万;十三个成员,一天一千三百万;一个月,四亿token。四亿里真正花在「想问题」上的,不到一成。剩下九成,是十三个成员在一个月里轮流把自己背诵了三千遍。你以为你在为智能付费,其实你在为复读付费。那句「收到」只是露出来的那一滴——底下是一整片你从没俯身看过的湖。

    最讽刺的是什么?这笔钱里最贵的部分,恰恰是稳定性带来的。成员的技能清单、人格说明、工具目录,这些东西几个月都不变一次——正因为不变,系统才能靠它们吃饭:不变的东西,可以缓存。可以缓存的东西,第二次读就便宜十倍。可我们所有人的默认用法,都在白白扔掉这个折扣。

    这就是伤口。不是被谁坑了,是被自己的无知坑了:行业里现成的解药摆了两年,我一个做了二十多年系统的人,按月全额支付着朗诵费。

    最扎心的对照是:缓存的机制不是我发明的,折扣也不是我谈的——它们就写在账单的价目表里,白纸黑字挂着,人人可查、自动生效。我缺的不是知识,是看账单的角度。两年的价目表,我扫了无数次总额,从来没往下多看一行。无知不可怕,可怕的是无知的人还在为自己付全款感到安心——因为总额稳定,就以为一切正常。稳定的浪费,是所有浪费里最长寿的一种。

    二、旧信仰死亡:「token是能力的计量单位」

    埋掉第二个信仰。

    我曾真心相信:token是能力的计量单位。谁吃的token多,谁干的活多;账单大,说明产出大。这个信仰帮我做过很多决策——选模型看单位价格,比方案看token消耗,一切似乎都能折算。它不是错的,在单聊时代它甚至是对的:你问一句它答一句,token确实约等于工作量。

    杀死它的是这次对账。

    我把成员的账单拉出来,按「这钱买的是什么」重新归类。这活干了一个晚上,像给家里的开销记账:水电、房租、伙食,一笔一笔往类别里归。归完我盯着那张分类表坐了很久。结果很脏:真正花在「思考用户问题」上的token,不到三成。剩下的七成,是身份装配(它背诵自己)、上下文搬运(把历史对话搬来搬去)、格式开销(工具定义、系统说明这些它每次都要重读的说明书)。

    三类浪费里每一类都有自己的伪装。身份装配伪装成「个性化」——你要它记得你是谁,就得付这笔钱,听起来很合理,直到你发现它背的内容九成和这次任务无关。上下文搬运伪装成「记性」——它记得你们聊过的每一句话,感动吧?但你翻账单就知道,它把三个月前的寒暄也搬进了今天的技术讨论。格式开销伪装成「专业」——那些工具定义和系统说明看起来是能力的证明,其实它每次读一遍都不是为了会用,只是入场费。

    token不是能力的计量单位,是流量的计量单位。而流量里七成是空驶。

    这个认知一旦立住,一大堆事情变了味。我以前看团队晒账单,「我们这个月用了一亿token」,心里还会敬一下:大户。现在我第一反应是问:一亿里多少是空驶?没人答得上来。因为所有人都把token当产能汇报,没有人把它当流量审计。一个不区分空驶和实载的物流公司,运得越多,亏得越盲。

    你还别笑那些晒账单的。我自己晒得比谁都狠。军团上线第一个月,我看后台的消耗曲线一路上扬,心里想的是「业务在涨」。第二个月曲线更陡,我截图发朋友圈,配文是「AI军团的食量」。第三个月我对账的时候才发现,那条让我骄傲的曲线里,爬得最凶的部分是探针——那些每小时一次的「你活着吗」,每次都触发全量装配,比真任务的消耗还稳定。我炫耀了两个月的增长曲线,一半是巡检在空转。把空驶当实载汇报的不只是别人,是所有不看分类账的人,包括我。

    从那天起我改信另一句:审计token的口径,决定你成本的下限。你看不见的七成,就是你要白付的七成。

    三、下潜:过路费的三层结构

    Agent每次开口前经过身份、上下文和计算三层成本。

    把这笔账翻译成普遍机制,只需要一个词:过路费。

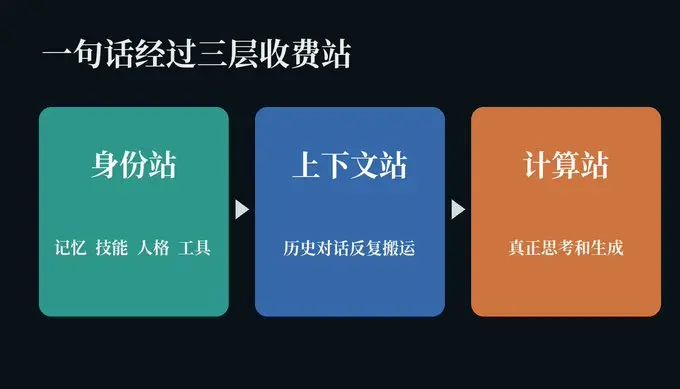
    Agent的每一句话,都要过三层收费站。

    第一层:身份站。它得先证明自己是谁——装载记忆、技能、人格、工具。这层的费用最固定,因为身份几个月不变,但每次都要重新验。你每次进小区都要把房产证从头念一遍,物业按页收钱。

    这层站还有一个特点:它收你的钱,和你的事大不大没关系。你问它「在吗」,它装配自己两万token;你问它「帮我重构这个系统」,它还是装配两万token。身份站按人头收费,不按事务收费。所以轻请求最吃亏——这也是为什么军团里大量「确认一下」「收到了吗」式的小沟通,反而成了账单的暗瘤。小事走大道,过路费比货贵。

    第二层:上下文站。它得把这次对话相关的历史搬过来。这层的费用随对话长度涨,越聊越贵。你和它说的每一句话,都会变成下一句的过路费。

    这层站最会装无辜。它看起来很合理——总得让它记得前面说了什么吧?但你仔细看它的收费结构:一次对话里,前面的内容会被后面的每一轮重复搬运。第十轮对话时,第一轮那句「你好」已经被原价搬运了九次。上下文站是那种会把你所有历史都当成行李的搬运工,你说一句话它记一辈子,而且每走一步都收一遍搬运费。长对话到后面,真正的新内容只占账单的零头,你付的几乎全是历史搬运费。

    第三层:计算站。它真正思考你的问题、生成回答。这是唯一「干正事」的层,也是大多数人以为的唯一一层。

    三层里,只有第三层是你想要的。前两层是制度成本——不是不需要(没有身份它就不是它了,没有上下文它就是金鱼),但它们的收费方式蠢得像十九世纪的关卡:每次全款,不管你昨天刚交过。

    有意思的是,这个世界对同一件事的处理,一百多年前就给出过答案。清末的厘金制度,货物每过一个卡口交一次税,商人为了少交税绕路、拆单、贿赂,货价层层加码,最后大家发现:收的不是税,是全社会的摩擦成本。货运的效率被卡口吃掉,商业的信用被重复征收磨没,废厘金成了后来税制现代化的第一场硬仗。Agent世界现在就活在厘金时代:每个成员是一个卡口,每次对话是一次过卡,身份税全款征收,无人豁免。

    厘金还有一个后代,今天还在收,你可能天天在交:平台抽成。外卖每转一手,平台抽一单;内容每分发一次,渠道分一笔。商业史一遍遍重演同一个结构——只要你允许中间环节按「过手」收费而不是按「价值」收费,整个系统就会长出一堆专门靠过手活着的节点。Agent军团是这个结构的最纯形态:成员的价值本来在干活,现在的账单却大半花在「过手」上。

    我在自己军团里第一次画出这张三层图的时候,后背又凉了一次。因为我数了数,十三个成员,两两协作的时候,一个任务要过多少次身份站——每转一手,接收方都要重新装配一遍自己的身份,再把对方的来意读一遍。甲转乙,乙装配自己两万;乙转丙,丙装配自己两万,还要把乙的结论读一遍。一个五手的任务,身份站的过路费交了五回,货物还是原来那件货物。任务在军团里每多转一手,过路费就翻一倍,而转手本身不产生任何价值。那次六十八分钟的事故里我学到的是故障会顺着链路传染,这次学到的是:账单也会。

    而且这两件事会叠加。链路越长,过路费越贵;链路越长,故障点越多。你以为自己在建协作网络,其实在建一张双重征税网:每个节点收一次钱,也埋一颗雷。协作图画得越漂亮,这两张账越黑。

    四、施工:三层省法,一层都不能省错

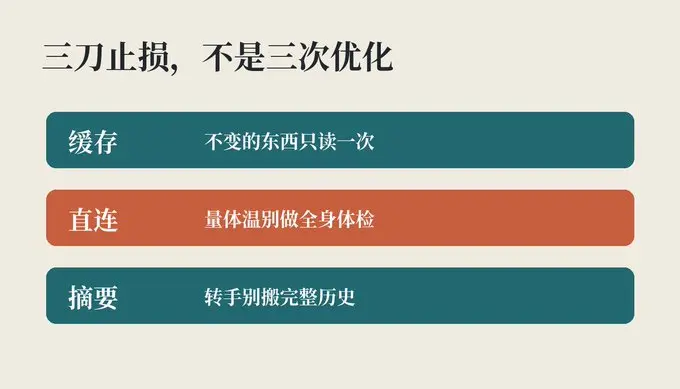
    缓存、直连探针与摘要交接:三刀先止损,再谈优化。

    施工图来了。我把这套省法按「改什么、省多少、什么不能省」给你,全部真跑过。

    第一刀:缓存——让不变的东西只算一次钱。

    机制一句话讲完:模型的推理分两个阶段,先把你发的所有内容整体读一遍(这步贵),再一个字一个字往外吐(这步慢但不贵)。缓存的本质是:读过的部分存下来,下次同样的开头直接复用,只算后面的新内容。

    两个阶段还有个被忽略的体感差异:贵的那步(整体读)决定你等多久才看到第一个字,慢的那步(往外吐)决定你等多久看完整个回答。长提示词的痛苦——发出去半天没反应——全是第一阶段在收钱。缓存把第一阶段砍掉大半,所以它省的不仅是钱,还有你盯着屏幕的第一秒。行业里跨厂商实测过,一万token级的系统提示词,缓存能让首字延迟改善三成上下。省钱的工程顺手把体验也修了,这种好事在系统行业里十年碰不上几回。

    关键在收费方式:缓存命中的部分,按一折收费。原价一毛的,命中后一分。省的不是小钱,是九成。

    但缓存有一个铁律,铁到近乎残酷:只认开头,不认内容。系统比对的不是「这段话我见过没有」,是「这次的请求,从第一个字开始,和上次是不是一模一样」。第一个字变了,后面全部作废,全部原价。你在一段一万字的说明书中间插了一行今天的日期,恭喜,那一万字全部重新全款。

    这不是玄学,是缓存的工作原理:它存的是「从第一个字起的前缀」。前缀的意思就是,必须从头开始连续相同。你动了中间,后面的连续性断了,哪怕后面九千九百九十九个字原封没动,系统也不认——它不扫描你改了哪儿,它只看从哪儿开始不一样。从不一样的那行起,全部作废。

    所以省钱的施工就一条:把不变的放前面,把变的放后面。身份、技能、规则、工具目录,这些几个月不动的,顶到最前面;用户的话、今天的日期、这次的任务,这些每次都变的,缀在最后面。

    这条规则小到可笑,难到发指。难在哪?难在人的本能是反的。我们写提示词的本能,是按「重要性」排——重要的放前面,细节放后面。而「这次的任务」恰恰是人心里最重要的东西,于是无数团队的提示词把任务描述、当天参数、动态指令全部顶在最前面,稳定的说明书反而在后面。按重要性排序是人类的天性,按稳定性排序是缓存时代的新道德。你当年语文学得越好,今天吃的亏越大。

    真实效果给你个锚点:有家安全公司跑Agent流水线,两万token的系统提示词,缓存命中率只有百分之七——九成以上的钱在白交。他们就做了一处结构调整,把动态的工作记忆从提示词中间挪到末尾,命中率拉到百分之八十四,实际账单降了六成。什么都没换,模型没换,内容没换,就换了顺序。

    顺序就是钱。这是缓存时代最反直觉的一条工程真理:同样两段内容,先放A再放B,和先放B再放A,价格差十倍。写作文时老师讲的「结构决定表达」,在token的世界里是「结构决定单价」。

    落到军团,这一刀是配置级改动。我把所有成员的装配顺序统一改了:魂在最顶上,技能其次,工具目录第三,动态的对话和任务垫底。一小时干完。改完当晚我看监控,最常用的那几个成员,缓存命中率从个位数爬到七成以上。什么感觉?就像全家每个月的加油钱突然打了一折,而车还是那辆车,路还是那条路。

    第二刀:哨兵直连——别用体检的价格量体温。

    这条是六十八分钟事故的遗产,但这次算的是钱。

    我要验证一个成员活着,以前的方法是对它的对话入口发一句「收到」——两万token,全身体检。后来我把探针改成直连:绕开它的身份装配,直接拿它的钥匙对模型端点发同样的话。二十个token。

    一千倍。同一个动作,同一个目的,两条路。

    于是军团的健康检查全部改成直连:每个成员、每条链路、探针请求小到不能再小。十几个成员、每小时一轮、全链覆盖,一个月的探针成本加起来,还不如从前一次「体检」贵。

    这一刀的通用公式是:验证「通道」的活,永远不要走「人格」的路。你要测的是钥匙能不能开门,不是这个人聪明不聪明。多少团队到现在还在用全量对话做健康检查——每次巡检都是一次全身体检,每次体检都按CT收费。你的监控账单为什么降不下来?因为你把哨兵养成了病人。

    这个错误还有一个更普遍的变体,叫「用最贵的方式做最简单的事」。发通知用最智能的通道,记日志用最强的成员,打个招呼都要惊动整个装配线。每一样单看都不贵,加起来就是账单上那块最稳定的支出——因为无论业务忙不忙,它们永远在跑。业务消耗是波动的,制度消耗是恒定的;杀掉浪费的关键,永远是先杀恒定的那部分。一刀下去,省的是每一天,不是某一天。

    第三刀:砍协作冗余——每次转手都是一次全款重读。

    军团协作里最隐蔽的浪费。成员甲干完转给成员乙,乙要读懂甲干了什么;乙干完转给丙,丙再把甲和乙都读一遍。三轮转手,最开头那份任务说明被原价重读了三次。任务链越长,重复运输越重。

    这个浪费有个帮凶:转发太方便了。拽一个人进群、抄送一个成员、把整个对话记录打包甩过去——全都是一次点击的事。零摩擦的共享,制造最大化的搬运。没有人在转发前问「对方真的需要全文吗」,因为问这句话本身比转发还费事。于是军团里的每一次协作,默认都是全量交接:你的上下文变成我的上下文,我的历史变成他的行李。信息像滚雪球,越滚越大,而雪球里九成是别人已经说过的话。

    我的砍法很土:转手时传摘要,不传全程。每个成员交接时只交三样——结论、状态、下一步。原始过程留在自己那里,谁要查谁付出加载数据的代价,而不是让下游默认背着你的全程走路。

    这条做绝了会伤协作(有的下游确实需要全程),所以我的执行尺度是:默认传摘要,下游有权申请拉全程,但申请留痕。把「免费的全文」变成「要申请的全文」,浪费立刻现形——因为大部分下游根本不需要全文,它只是顺手拿,反正不要钱。不要钱的东西,人人都要;标了价,需求自己会筛选自己。

    这一刀砍下去还有个意外的副产品:摘要质量成了成员的考核项。以前交全程,写得好不好都埋在里面没人看;现在交的是摘要,三句话讲不清楚自己干了什么,下游立刻退回来。强制摘要就是强制思考。三个月下来,军团里转述能力最差的两个成员被我看出来了——不是它们干活差,是它们讲不清自己干了什么。这种病以前全埋在全文里,现在一眼现形。

    人间的组织早就吃过这个亏。大公司里一封邮件抄送二十个人,二十个人都「知道了」,没有一个「负责了」;项目组交接文档八百页,接手的人一页不看,只找原作者问。信息全量供给的结果不是全量知情,是全量冷漠。摘要逼出来的三句话,反而比八百页更能定位责任:你讲不清结论,就是你没有结论。信息的贫困有时是效率,信息的富裕常常是懈怠。军团如此,公司如此。

    三刀砍完,给你总账:我军团的外部调用成本,降了一多半。没有换更便宜的模型,没有降低任务量,没有砍任何成员。省的全是从前的糊涂钱。

    复盘这三刀,我发现一个规律,值得你抄在墙上:三刀没有一刀是「优化」,全是「止损」。缓存止损的是重复装配,直连止损的是体检式巡检,摘要止损的是全量搬运。我做的是把三笔不该付的钱停付,而不是把该付的钱付得更漂亮。降本这个行当里,先人们早就总结过:成本优化的第一性原理不是把事做便宜,是停止做不产生价值的事。工程师的本能是优化看得见的东西,当家人的本能是先找看不见的漏。两个本能都对,顺序不能反——没堵漏先优化,等于给漏水的管子换更贵的泵。

    但文章到这里如果停下,它就是一篇省钱攻略。我要说的比这个冷。

    五、反噬:省下来的钱,暴露了真成本

    第一件被暴露的事:本地化算的不再是电费,是机会成本。

    省钱之前,我算本地部署的账很简单:电费加硬件折旧,对比API账单,谁便宜用谁。省钱之后API账单腰斩,本地的相对优势缩小了,我一度以为自己该回归API。直到我把缓存机制搬到本地——本地的推理框架一样支持前缀缓存,十三个成员共用同一个底座模型,魂和技能结构高度相似,第一个成员装配完自己,后面十二个蹭它的缓存副本,边际成本趋近于零。云端的缓存是折扣,本地的缓存是白送。这笔账翻过来,本地化的理由反而更硬了:云端的折扣再深,也是按次收租;本地的复用再浅,也是自己家的。省钱的尽头是主权。

    这笔账还有一层。云端的折扣有个隐藏条款:它奖励你不变,你一变,前缀作废。也就是说,你越忠诚于某个云端的缓存结构,你的架构就被它锁得越死——换模型、换平台、重排提示词,都是「全部作废、全部全价」级别的背叛成本。本地没有这个条款:自己的缓存自己清,清完就清完,下一轮重新长。省着省着你会发现,所谓成本优势,最后都长成了选择权优势。

    第二件被暴露的事:便宜会诱发浪费,缓存会惩罚变动。

    成本降下来之后,军团的使用方式松了。以前一句话两万token,大家派任务会掂量;现在一句话两百token,随手就发。三个月后我再看账单,总量回升了一半——单价降了一百倍,用量涨了两百倍,总账单反而更肥。高速修好之后,人人开车上班,堵车换了个形式回来。这是所有降本工程的宿命:效率的节省总会被行为的放纵吃回去,除非你同时立用量纪律。

    更阴的是缓存的另一面:它奖励不变,惩罚变化。你改进了成员的技能说明——它三个月来第一次变动——下一次调用,缓存全部作废,全部原价。系统在结构上劝你「别改了,改了要钱」。一个会惩罚修改的架构,时间会把你的军团腌成化石。所以我的新纪律是:改进集中在固定的变更窗口做,平时忍住。像老式火车,要停靠站点才让人下车。

    这条纪律执行起来比想象中难,因为诱惑长着正义的脸。「这个提示词再优化五个字效果会更好」——对,会更好,但也要全款重算一次。五分的效果提升,值不值一次全量重装?大部分时候不值,但「优化」这个词自带道德优势,没人敢拦。我把这个 trade-off 起了个名字叫优化税:每一次优化都有明码标价,价签贴在缓存命中率上。看不见优化税的团队,会在「持续改进」的错觉里把缓存优势优化没——越勤奋,越全价。

    第三件被暴露的事,也是最贵的:有一层过路费,你砍不动。

    我砍掉了身份装配的重复计费,砍掉了体检式的健康检查,砍掉了转手运输的全文冗余。最后账单干净了:剩下的每一分钱,都花在刀刃上——身份的一次性装载、上下文的必要搬运、真实的思考。

    然后我盯着这份干净的账单,看到了它。

    责任的固定成本。

    成员每接一个任务,魂里写着红线;每花一笔钱,门禁要核对;每交一份活,验收单要过。这些不是浪费,这是我上一篇文章写的「拆解」——判断变成物理的形态。而物理是有重量的:装一份能挡住错误的判断,比装一份只会聊天的空壳,贵。它贵,是因为它值。

    你把门禁拆了,账单立刻好看——省下的就是当初四连测全过的那道防线。你把验收清单删了,交付立刻变快——快掉的就是那次六十八分钟事故的学费。账单上每一分「看起来可以省」的钱,背面都印着一行小字:省它,等于承认当初它挡下的祸不会再发生。这种钱,省的时候有多爽,出事的时候就有多贵。

    我以前分不清「浪费的成本」和「责任的成本」,一刀切地嫌贵,砍来砍去。现在分得清了:浪费的成本,特征是重复、无察觉、无选择——你不知道自己在付,付了也没换来任何东西;责任的成本,特征是一次、清醒、有回报——你知道自己在付,它替你挡了你看不见的祸。前者要砍到零,后者要保到最后一分钱。判断哪个是哪个,就是当家人的判断——这笔判断费,谁也替你出不了。

    六、回环:账单的最后两行

    回到开头那笔账。

    那句「收到」,两万零三百四十一个token,现在多少钱?

    探针直连,二十个token,缓存命中后,两个token。从两万到两个,一万倍。

    上个月我对着新账单坐了很久。成本曲线趴下去了,每个成员的每一句话都干干净净。按省钱攻略的标准,这是大获全胜的文章结尾,应该放一张对比图,再教你三招。

    但我高兴不起来。省钱的战役打完那天晚上没有庆功,只有一种说不清的空。像还清了一笔背了很多年的债——松了口气,然后立刻发现:原来这些年支撑我「认真管这家公司」这种感觉的,有一半竟是那笔糊涂账。天天盯账单的人,未必是真懂成本的人,可能只是被数字的波动豢养着。账单干净之后,注意力没了着力点,我头一晚居然不知道该盯什么。降本的最大陷阱不在技术里,在心理里:你会把「减少错误」的成就感,误认成「创造价值」的成就感。前者是守成,后者才是开疆,而守成的爽感会让人上瘾,守着守着就忘了当初为什么出发。

    而且我很快发现:这份干净的成本结构里,藏着一个更冷的提醒。账单干净之后我看清了,成本降到地板,军团的开支里再没有一分钱可以名正言顺地砍。地板之下是什么?是收入问题。成本问题的尽头,永远是收入问题。你可以把浪费归零,但你归不了价值的零头——省出来的钱要变成什么,账单永远不会替你回答。

    因为我看着那份干净的成本结构,突然想起那个修好的成员。它现在还活着,还在每天背自己的简历——只是背一次的钱从全价变成了一折。它还是它。它每次开口前,还是要把自己是谁想一遍。

    我在它身上省下的每一分钱,都没改变它的处境:一个不能简化自己的存在,只能靠折扣活着。

    这句话我想了很久。人何尝不是。你手机里的通讯录、简历里的头衔、饭局上的自我介绍、朋友圈的人设——哪一样不是每次社交要重新装配一遍的身份?而且人的装配比Agent贵:Agent装配完还能缓存,人每次见面都要重新来过,对方忘了你是谁,你就白装了。酒局上最累的不是喝酒,是反复当一个「别人认识的那个你」。

    然后我想到我自己。

    我的简历比它长。二十多年,几十个项目,几百个判断,一套只有我能讲的方法论。我每次开口——见客户、写方案、带人——也在装配自己。年纪越大,装配越贵。行业里管这个叫经验,收溢价。但那笔账看多之后我开始做噩梦:如果有人给我的身份装载算一笔缓存命中的账,我会不会被自己的履历拖死?

    我见过被拖死的人。老家的一个前辈,九十年代做工程起家,那套打法是他的全部身份。饭局上三句话不离「当年我修那条路」,新业务来了先问「当年我们是怎么做的」。他不是不聪明,是他的装配太贵了:每个新决策前,要先全款装载一九九五年的上下文。世界变了,他的前缀没变——不是世界不认他的开头,是他不敢让后面的内容偏离那个开头。人被自己的历史锁死,和缓存惩罚变动,是同一条物理定律。

    缓存的世界有一条物理法则:只认开头,不认内容。你二十年不变的东西,能享受一折;你天天推翻重来的东西,永远全价。这个世界在结构上奖励那些早早定型、从此不变的人——头衔一挂三十年,方法论一套用到底,缓存命中率百分之百,成本最低,溢价最高。

    而它惩罚每一分自我修改。你四十岁改行,前四十年全部作废,从第一个字重新全价。你推翻自己最得意的判断,那套判断养出的全部下游,跟着重算。

    所以,这个时代最贵的一句话不是「收到」,是「我错了」。

    说「收到」只要装配一次自己,全价。说「我错了」,你要把装配好的自己拆开,把错的那块找出来,扔掉,重装——所有缓存作废,所有下游重算,所有信任重新计价。它是token世界里最奢侈的调用。

    我这一年说得最多的一句话,回头看,就是它。

    把二十年的「不可替代」拆成可复制的模具,我错了一次;以为token是产能,我错了两次。每一次都贵得心疼。但账我不能不算:正因为付得起「我错了」的全价,我的身份装载里没有一行死代码——每一个字都还是我真的相信的。

    那个成员背的简历,是别人替它写的。我背的这份,每一行都是我自己签字的。

    一笔一折,值得。

    一句全价,更值。

    来源:https://x.com/dashen_wang/article/2091751344592073173

  • 8张矿卡,512GB显存:企业买的其实是它坏掉以后怎么办

    8张矿卡,512GB显存:企业买的其实是它坏掉以后怎么办

    配置单上的裂缝

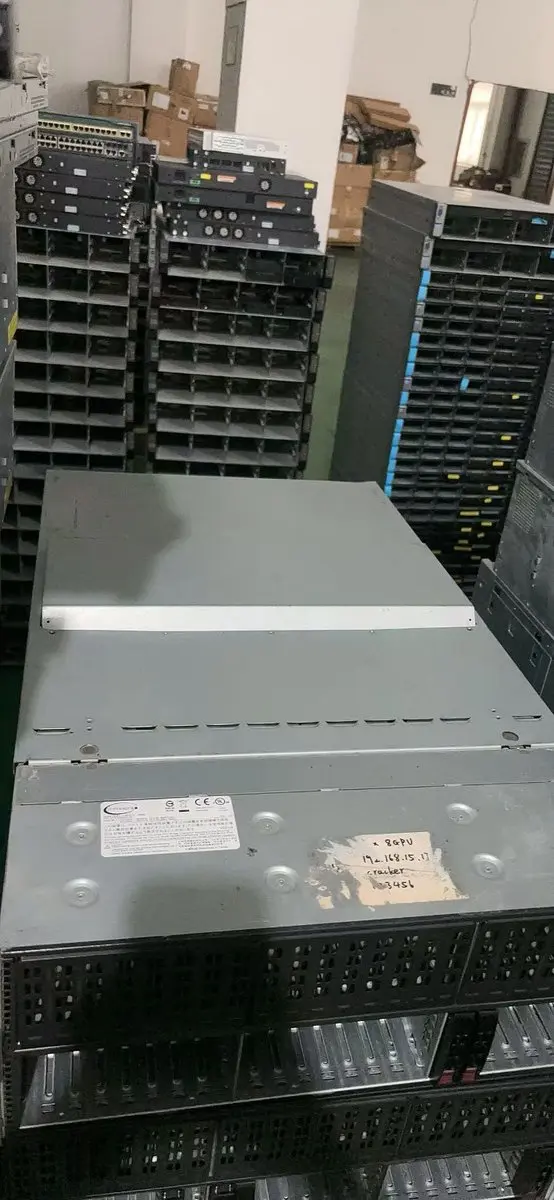
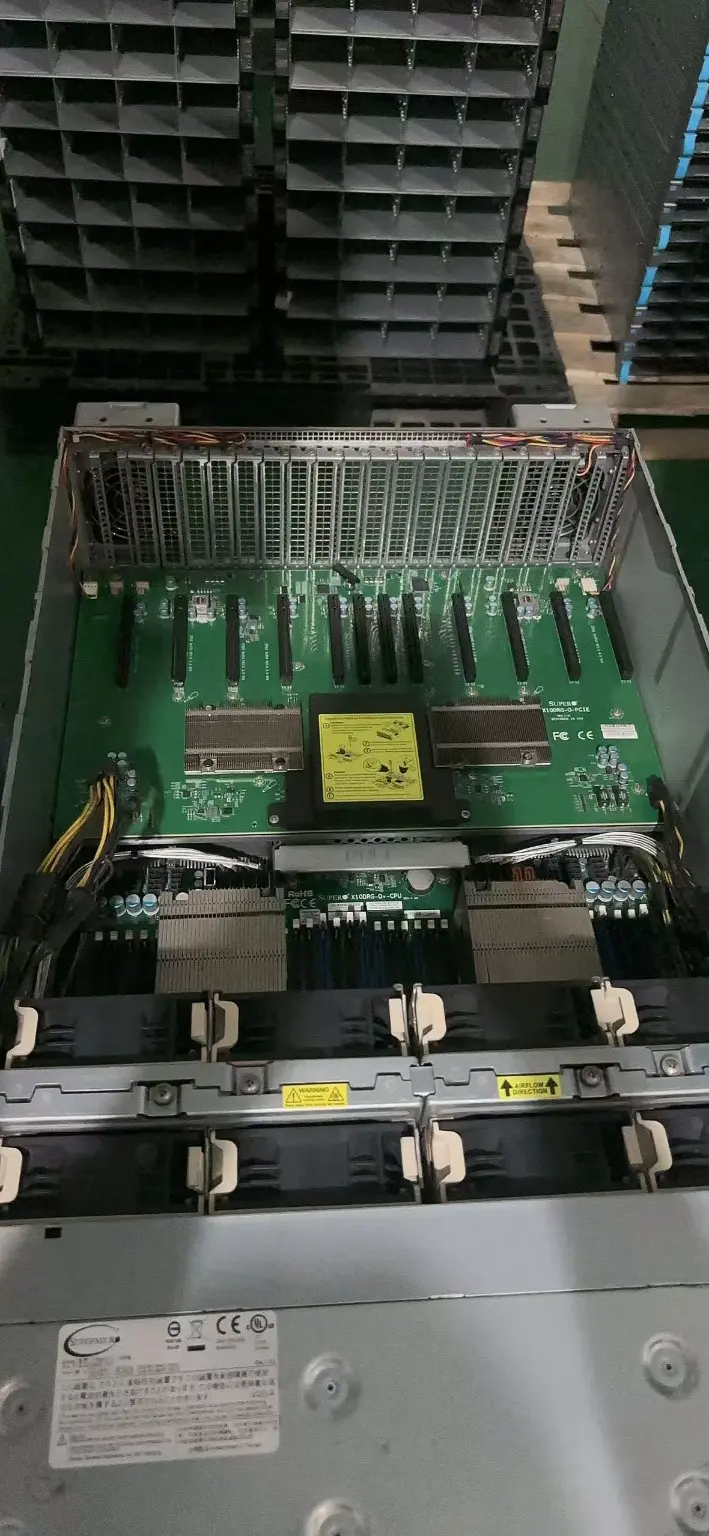
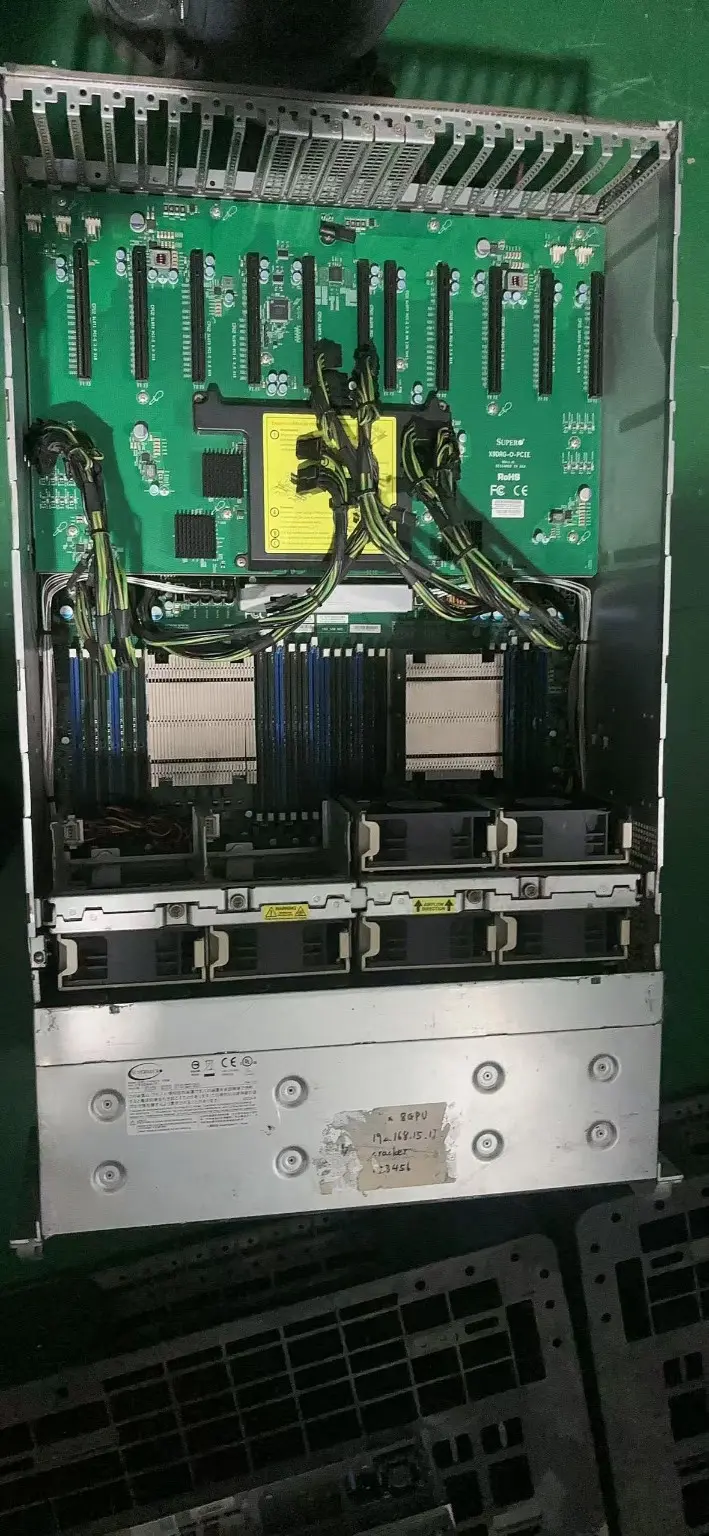
    二手4U服务器库存环境实拍。

    那份配置单看起来很完整。

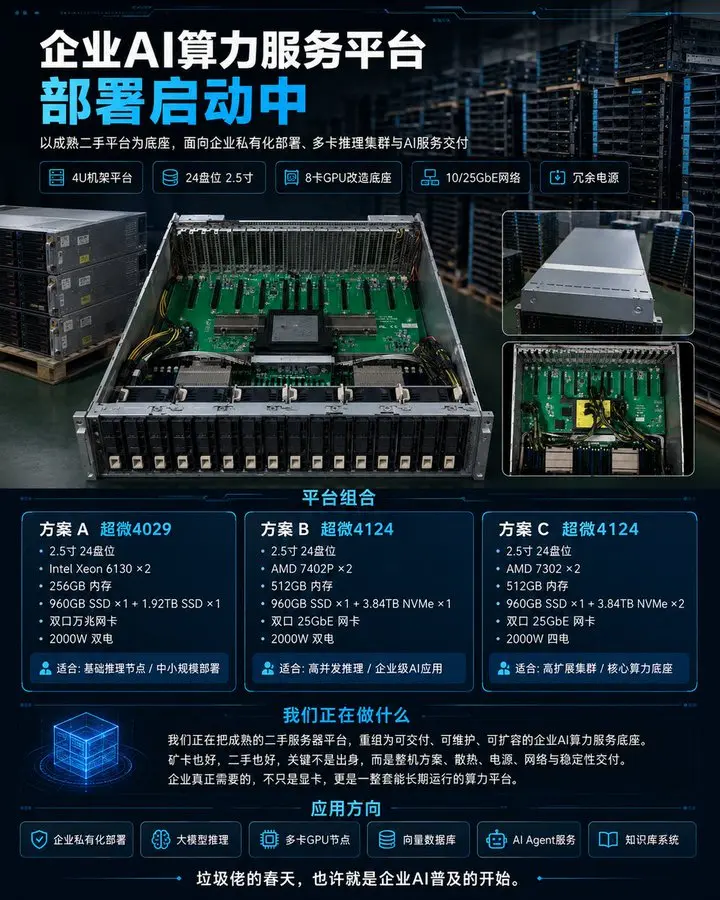
    Supermicro 4124,24个2.5英寸盘位,512GB内存,960GB SSD,3.84TB NVMe,双口25GbE,2000W双电。每一个数字都站在自己的格子里,排列整齐,像一栋已经画完施工图的楼。采购可以询价,销售可以报价,技术甚至可以顺着这些参数开始想象:双路EPYC,八张GPU,足够的内存,足够快的网络,一台低成本企业AI节点似乎只等着上电。

    只有一行不对。

    EPYC 7402P×2。

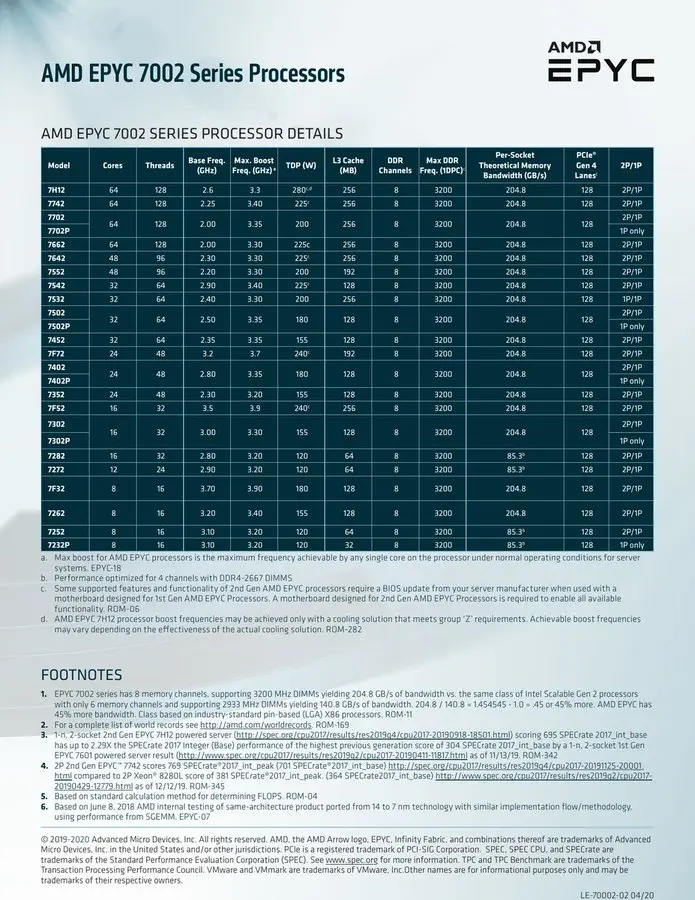
    AMD EPYC 7002系列型号表;7402P为1P,7402和7302支持1P/2P。来源:AMD官方datasheet。

    不是“不够理想”,不是“可能存在兼容问题”,而是这项配置在AMD的官方定义里根本不能成立。7402P只支持单路,那个后缀P不是装饰。能装进双路机器的是7402,不是7402P。两颗7402P不会因为被写进同一个单元格,就突然获得双路能力。

    一张配置单,先裂开了一条缝。

    最危险的地方也正在这里:这份表并不粗糙。它有机型、有容量、有硬盘、有网卡、有电源,甚至精确到CPU后缀。正因为它足够完整,那一行错误才更容易被完整性掩埋。人看见一排数字,会本能地把“写得详细”误认为“已经核验”;看见规格表像一张施工图,就开始在脑子里入住,却忘了先检查承重墙是否存在。

    “7402P×2”可能只是供应商把7402多打了一个P。也可能不是。也许机器里装的是两颗7402,也许只有一颗7402P,也许整机、主板、CPU和配置单来自几次不同的拼装。现在不能替供应商把答案补好。必须看BIOS,必须看lscpu,必须把两颗处理器的精确型号钉死。没有这些,解释只是替一栋未验收的楼粉刷外墙。

    这就是这套平台的第一处伤口。

    它不是某张矿卡能不能亮,也不是某个模型能跑多少token。它先告诉人们:企业硬件里,最先杀人的往往不是缺失的信息,而是错误的信息披着完整的格式。空白会让人停下来,一张填满数字的表却会催人继续向前。报价、付款、收货、上架,一层一层压上去,直到某天才发现,地基里早就埋着一句不可能成立的话。

    而这套市场叙事长期默认着另一句同样整齐的话:显存够大,硬件就有企业价值。

    它并不愚蠢。至少在很长一段时间里,它非常有用。模型权重首先要放得下,上下文要占显存,KV Cache要占显存,并发也在吞显存。显存不足,很多讨论连开始的资格都没有。于是容量成了最简单、最直接、也最容易比较的数字。24GB、48GB、80GB、96GB。数字越大,门槛越低;单卡能容纳的模型越大,部署越省事。这个判断曾经像一根可靠的柱子,支撑过太多采购和技术决策。

    然后CMP 170HX出现了。

    它把这根柱子推到了极端,也把里面的空洞暴露出来。

    64GB亮起来以后

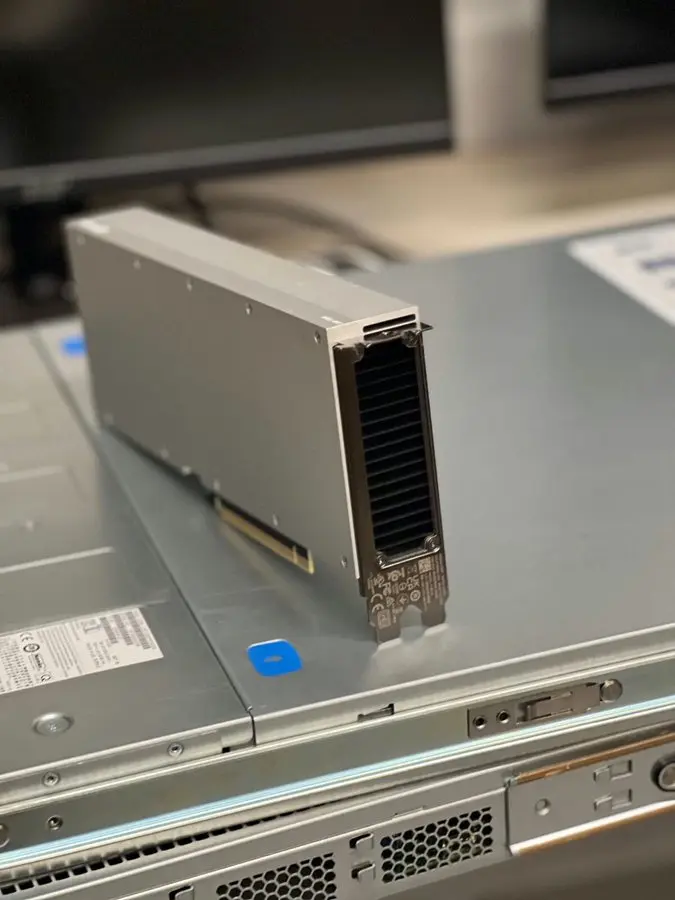
    CMP 170HX 8GB卡实物参考图。第三方参考图,来源:eBay listing image;用于产品外观识别。

    CMP 170HX原本不是为企业AI设计的产品。它是2021年面向加密货币挖矿市场的计算卡,使用GA100芯片,属于Ampere时代的产物。矿场退潮以后,这些卡像从旧建筑里拆下来的钢筋,被二手市场重新搬出来。社区逆向和解锁工作又给它通了电:解除计算节流,重写显存几何,让原本被限制的计算能力和物理资源重新可见。

    于是最刺眼的数字出现了。

    原始8GB的SKU,PCI ID为10de:20c2,当前社区主线的稳定口径是解锁到约64GB。原始10GB的SKU,PCI ID为10de:2082,稳定口径是约40GB。两种卡不能混着说,更不能把一张卡上的结论移植到另一张卡上。8GB到64GB,10GB到40GB,这是两条不同的显存几何路径,不是一句“矿卡都能解锁大显存”可以抹平的细节。

    至于10GB到80GB,那是更诱人的废墟。

    它被尝试过,但约40GB以上会出现不稳定。80GB可以出现在实验记录里,不能出现在企业交付承诺里。能枚举出来,不等于能持续写入;能跑一次,不等于能经过长时间负载;某一张样卡碰巧通过,不等于一批二手卡都能承担同一个SLA。企业客户不会为“偶尔成功”付费,他们最后会把每一次掉卡、错误、服务退出和不可复现,都沿着合同追到交付者身上。

    所以80GB不是多出来的四十GB。它是一层尚未封顶,却已经有人想挂牌出售的楼面。

    这时,旧信仰开始死亡。

    如果显存够大就天然拥有企业价值,那么8GB解锁成64GB的那一刻,价值应该已经完成。八张卡就是512GB,数字巨大,成本又低,故事到这里本该结束。可真正把它放进企业环境,所有被容量遮住的问题会同时回来:这64GB能不能稳定读写?卡与卡之间如何通信?驱动能不能冻结?升级会不会失效?有没有ECC?有没有官方支持?坏一张以后谁来换?同一批卡的显存、温度、功耗和维修史是否一致?

    显存只回答了一件事:东西能不能放进去。

    企业价值要回答另一件事:放进去以后,谁保证它不会在无人注意时腐烂。

    这两个问题不能再被写成同一个问题。容量是材料,不是建筑;能够上电,是废墟里的钢筋还没有完全锈断,不代表楼已经能住人。过去那句“显存够大就有企业价值”之所以迷人,是因为它把责任压缩成了一个数字。数字没有售后,不会半夜报警,也不需要为静默错误签字。可企业系统不是跑分截图。企业买下的从来不是某一刻亮起的显存,而是这块显存在一个月、一年、一次驱动升级和一次硬件故障之后,仍然有人知道该怎么办。

    旧信仰不是被一个更漂亮的理论杀死的。它死在配置单上那个小小的P里,也死在80GB那条不稳定的边界上。前者证明文字可以伪装成硬件,后者证明容量可以伪装成可靠性。两种伪装的共同点是:只要暂时不验收,它们都显得很便宜。

    这里甚至有一种残忍的对称。

    7402P×2,是把两颗不能双路的CPU写成了双路;10GB→80GB,是把尚未稳定的地址空间写成了容量。一个错误发生在主机端,一个诱惑发生在GPU端。它们隔着主板、线缆和驱动遥遥相望,却使用同一种语言:先给你一个足够大的数字,让你舍不得停下来核验。

    采购最容易在这时背叛工程。不是因为采购不懂技术,而是所有人都被进度推着走。卖方说大概率是笔误,买方觉得机器便宜,技术认为到货以后再查也来得及。每个人只让一步,没有人觉得自己做了严重决定。可楼就是这样歪的。没有哪一块砖单独承担坍塌,直到所有微小妥协叠在一起,最后一张错误配置单反而成了唯一写得最清楚的东西。

    所以这次不能先问“值不值得买”。先问“什么是真的”。

    CPU要从BIOS和lscpu里确认,不能从销售解释里确认。GPU要按PCI ID分清8GB和10GB两个SKU,不能看外壳差不多就混成一批。解锁后的容量要做显存写读和地址模式测试,不能只截一张nvidia-smi。80GB既然在40GB以上出现不稳定,就必须退回40GB交付,不许拿最漂亮的一次启动覆盖后面的错误。所谓企业化,最开始并不宏大,不过是拒绝替任何一个未经验证的数字圆谎。

    显存神话真正杀死的,是这种拒绝能力。

    当64GB出现在屏幕上,人很容易立刻乘以八。八张就是512GB。接着开始换算能装多大的模型、能省多少采购费、能不能替代更贵的卡。每一步算术都可能正确,结论仍然可能是一座违章建筑。因为乘法只负责汇总容量,不负责补上ECC,不负责打通卡间互联,不负责提供官方驱动,也不负责在某张二手卡出现HBM错误时告诉你,哪一次推理结果已经不再可信。

    这正是必须被埋掉的旧信仰。它曾经帮人快速筛选硬件,现在却会让人快速跳过责任。显存仍然重要,甚至是这批卡重新获得价值的起点;但起点不是产权证。64GB只允许我们走进工地,不允许我们宣布竣工。

    它有GA100的血缘,但它不是A100

    把CMP 170HX叫作“廉价A100”,是这套故事里最省力、也最危险的一步。

    它们确实有血缘。CMP 170HX使用GA100硅片,PCB也高度接近A100 40GB PCIe参考设计。它的Compute Capability是8.0,也就是sm_80;两种SKU都暴露70个SM、4480个CUDA Core。社区解除计算节流以后,FP32和Tensor计算可以恢复到这套70SM配置应有的水平。它不是一块只有大显存、没有计算能力的空壳。

    它的标称软件功耗上限约250W,全被动散热。这个250W也不能孤立阅读。被动卡没有自己的风扇,它默认自己活在服务器的强制风道里。离开4U服务器的高静压风墙,把它摆进普通机箱,再拿“250W不算高”安慰自己,等于从旧楼里拆下一段钢梁,却把原来的支撑条件一起忘了。功耗是卡的数字,散热是整机的责任。

    HBM带宽同样很诱人。社区在不同工具、不同读写方向和不同条件下测得的区间,大约是1.3到1.7TB/s。可以说它保留了GA100/HBM体系的高带宽优势,但不能从区间里挑一个最高数字,磨成铭牌,再当作无条件的官方规格。解锁计算本身也不会凭空增加HBM带宽。工具怎么测、方向是什么、显存SKU是哪一种、负载如何,都会影响结果。

    这就是所谓“条件性”。

    1.3—1.7TB/s是一组在具体测试条件下出现的社区测量,不是每张卡、每个任务、每一次运行都能兑现的固定承诺。企业可以使用这个能力,却不能假装条件不存在。废墟里挖出的材料需要逐根检测,不会因为它曾属于某种宏伟结构,就自动继承那栋楼的验收证书。

    更不能因此把它写成A100。

    A100不是“GA100芯片加一块大显存”这么简单。CMP 170HX只有70SM、4480 CUDA Core;解锁不会长出更多SM。它当前没有已知可用的ECC解锁,没有可用NVLink,社区结论里P2P也缺失,更没有NVIDIA针对A100那套官方企业驱动、认证和支持责任。它们共享硅片家族,不共享完整产品身份。血缘是真的,等价是假的。

    这些缺口不是规格表末尾的小字,它们会改变系统的建法。

    ECC缺失,意味着不能把它包装成正规数据中心卡那种关键任务可靠性。应用层需要校验、重试和故障隔离,关键业务也不能把一个节点当成唯一真相。NVLink和P2P缺失,意味着多卡并不是把卡插满就完成了;计算可能在八张卡上,数据却要受另一套路径约束。官方企业支持缺失,则意味着驱动、内核、升级和回滚都落到交付者自己身上。那些在A100产品身份里被厂商承担的部分,到了170HX这里,全部变成施工成本。

    所以“同为GA100”只说明材料的来历,不说明建筑的等级。两根钢材出自同一炉,不代表装进不同结构后拥有同一份承重证明。170HX能恢复70SM配置应有的计算能力,这是它真正珍贵的地方;但恢复计算,不等于恢复整个产品。社区解锁可以解除节流、重写显存几何、推进PCIe链路,却不能凭愿望补出缺失的企业责任。

    这句话必须说重一点:CMP 170HX不是A100。

    不是残血A100,不是改个驱动就能毕业的A100,也不是采购话术里的“A100平替”。它是一张面向挖矿市场、基于GA100、被社区重新打开部分能力的计算卡。它有自己的70SM、自己的4480 CUDA Core、自己的CC 8.0、自己的250W边界,也有自己无法靠软件补出的缺口。承认这些,不会降低它的价值;恰恰相反,只有拒绝冒充,才可能给它建立真正的产品位置:成本优化型的大显存推理卡,适合被工程化、被分级、被监控、被替换,而不是被神话。

    很多人不愿意这样写,因为“A100”三个字能让废墟突然显得像地标建筑。客户认识它,市场理解它,销售也容易算账。但名字借来的信用,迟早要由交付偿还。没有ECC时发生的风险,不会因为报价单上写了“同源”就消失;没有NVLink和P2P时,多卡通信也不会因为大家都出自GA100而自动打通;社区补丁失效时,NVIDIA不会因为你曾经把它叫作A100,就替你接管现场。

    真正的企业价值不是把身份写高一点,而是把边界写低一点,再证明自己仍能交付。

    这也解释了为什么一张卡的身份不能只靠芯片代号判断。芯片像建筑材料的牌号,产品却是整套结构:启用了多少单元,接出了多少链路,显存怎样组织,错误怎样发现,驱动由谁维护,故障由谁负责。只抓住GA100,就像在废墟里找到一块刻着旧楼名称的构件,于是宣布整栋楼仍然存在。可原来的楼已经没有了。现在面对的是另一块PCB、另一组产品限制、另一条社区驱动路径,以及一份必须由交付者重新写下的验收标准。

    这条路径本身也不能被藏起来。当前解锁依赖Linux x86-64、经过修改的nvidia-open驱动,并要求关闭Secure Boot。它不是插卡后安装通用官方驱动就结束。内核与驱动组合要冻结,镜像要保存,升级要灰度,失败要能回滚。客户看见的是64GB,交付者背后维护的是一整条脆弱却必须可重复的施工通道。只展示解锁结果,不展示它依赖什么,和只给客户看精装修样板间、却不交代水电从哪里走,没有本质区别。

    因此,解锁成功最多证明材料可用,不能证明批量可交付。一张卡跑通,是实验;同一批卡逐张建档,是生产的开始。显存写读、地址模式、温度、功耗、PCI ID、VBIOS、PCIe链路、Xid错误,都要留下记录。否则所谓64GB只是一个没有房号的空间:今天看得见,明天出了问题,却不知道是哪一面墙先裂开的。

    边界写得越清楚,CMP 170HX的价值反而越稳。它不需要赢过A100,也不需要假装拥有完整的数据中心身份。它只需要在自己真实存在的条件里,证明大显存、HBM带宽和70SM计算能力能被重复调用,证明坏卡可以被识别,异常可以被隔离,系统可以退回已知状态。企业价值从来不是无缺陷,而是缺陷出现以后,系统仍有秩序。

    64GB是真的,但它属于8GB SKU的当前稳定解锁口径。40GB是真的,但它属于10GB SKU。80GB存在过,但不稳定,所以不能卖。70SM、4480 CUDA Core、CC 8.0和250W是真的,它们共同描述的是CMP 170HX,不是A100。1.3—1.7TB/s也可以是真的,但它必须和测试条件绑在一起,不能被铸成一块永远不变的门牌。

    当这些数字被逐一放回自己的位置,那栋想象中的廉价A100大楼就塌了。留下来的不是一堆毫无价值的垃圾,而是一批仍然有用、却必须重新测量的材料。它们能建什么,不能由显存容量单独决定;要看底座、供电、风道、驱动、监控、备件,也要看数据怎样进出每一张卡。

    而下一道裂缝,正藏在“进出”两个字里。

    服务器给的是PCIe 4.0 x16槽位,不代表这张卡就拥有PCIe 4.0 x16。链路代际和物理宽度是两道不同的门。等这道门真正打开,八张64GB卡组成的“512GB”,也会显出它最容易骗人的形状:八间各自上锁的房间,被配置单加在一起,便被误写成了一座没有墙的大厅。

    两道门,和一座不存在的大厅

    服务器给了PCIe 4.0 x16插槽,不等于卡就拥有PCIe 4.0 x16。

    这句话看起来像常识,落到采购表里却经常失踪。平台规格和端点能力被写在相邻的两列,人眼一扫,就把它们接成同一件事。于是4124的PCIe 4.0,悄悄长到了CMP 170HX身上;八条宽阔的高速公路画好了,所有人便假设车也能按那条路的速度跑。

    可这张卡前面有两道门。

    第一道门是代际。社区当前主线把原来的Gen1推进到了Gen2,这是软件路径已经取得的成果。第二道门是宽度。卡的物理训练宽度仍然是x4,不会因为插进x16槽位就自动变宽。Gen2和x4不是同一个问题:一个回答每条车道能跑多快,一个回答到底有几条车道。只打开第一道门,第二道门仍然锁着。

    想把x4补成x16,需要在高速差分区域补24颗0402 AC耦合电容。那不是改一个配置项,也不是刷一版驱动,而是在PCB上动刀。焊点很小,区域敏感,返修风险真实存在。公开样本表明,完整宽度改造配合Gen2可以把host到GPU的带宽推到约6GB/s级,但样本不多,卡况、工艺和平台条件也不相同。它可以是一条实验路线,不能成为首批企业节点默认施工动作。

    先把Gen2 x4的稳定性做完,再决定是否值得承担硬件返修风险。企业交付最怕的不是性能少一点,而是为了一个漂亮数字,把原本还能更换的旧材料改成了无法批量复现的手工作品。每张卡都要靠某个人的焊台和手感活着,那就不是标准化节点,而是一排被精心保存的偶然。

    至于Gen3和Gen4,当前仍未解决。不能因为4124的主板支持Gen4,就把未来时态提前印进今天的产品册。底座的路修到了四代,端点仍停在二代四车道。那条路不是不存在,只是这辆车还开不上去。

    这会把所有多卡幻想拖回物理世界。

    原厂状态下,host到GPU的典型实测大约只有0.80—0.85GB/s;当前主线Gen2 x4大约1.68—1.71GB/s。数字并不羞耻。羞耻来自明知它只有这个边界,却继续按照现代高速互联卡的方式设计系统,再把通信造成的等待归罪于模型。

    低速链路不是一个可以靠情怀越过的坑。它会出现在模型加载里,出现在CPU和GPU之间的数据搬运里,出现在多卡同步里,出现在每一次过于频繁的collective通信里。平时它像墙里的潮气,只让任务慢一点;并发一高、上下文一长、并行策略一错,潮气就会沿着整面墙浮出来。

    然后是那座最诱人的大厅:八张64GB卡,合计512GB显存。

    乘法没有错。八乘六十四就是五百一十二。错的是把“聚合本地显存”写成“统一显存池”。这八张卡各自拥有64GB本地显存,八个空间彼此独立。当前没有可用NVLink,没有P2P,PCIe又停在Gen2 x4。系统不会因为管理页面把数字相加,就突然得到一块可以任意寻址、任意切分、任意高速互访的512GB显存。

    它更像八间各自上锁的房间。

    每间房都不小,甚至足够独立住下一类模型。可是钥匙不相通,墙也没有消失。你可以安排八个住户,可以让一个大模型按楼层分段,也可以在门外放一个路由员;你不能把八张房产证叠在一起,然后宣布这是一座没有隔墙的大厅。

    这条边界决定了最稳妥的商业形态。

    只要模型能在单张64GB卡里放下,优先做一卡一副本。每张卡跑一个独立模型实例,前面用API Router做负载均衡。八张卡不是绑成一个脆弱的大脑,而是八个可以独立接单、独立升级、独立失败的房间。一张掉卡,路由把请求移走;一个副本升级,不必让整台节点同时停服;并发增加,靠副本横向分摊。

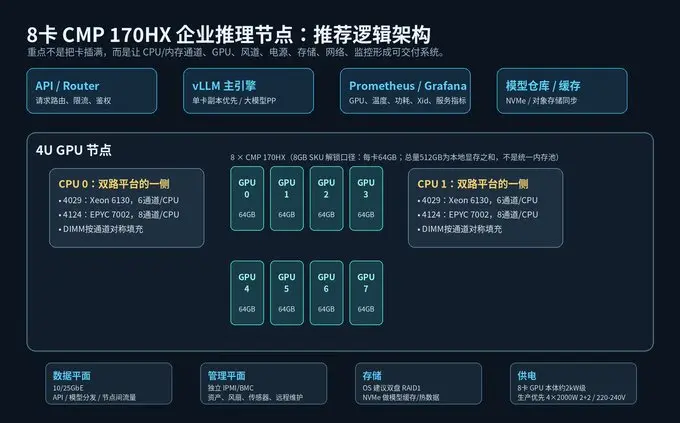
    8卡CMP 170HX企业推理节点部署逻辑。资料包原创信息图。

    这种设计看起来没有“512GB统一大显存”那么壮观,却更像生产。它绕开了170HX最明显的PCIe和P2P短板,把硬件真正擅长的东西留下:单卡大显存、HBM带宽、可用的70SM计算能力,以及低采购成本下可以铺开更多副本的空间。

    如果模型确实大到单卡放不下,也不能本能地选择Tensor Parallel。

    TP会让多张卡在每层计算中频繁交换和同步。现代高速互联上,这种代价可以被吸收;在Gen2 x4、无P2P的170HX上,通信会被成倍放大。Expert Parallel也有同样问题:专家之间的路由一旦频繁跨卡,原本应该用于计算的时间,就被耗在狭窄的门口。

    更合适的方向是Pipeline Parallel。把模型按stage切开,每张卡负责连续的一段层,数据沿着流水线向前走。每个token在stage之间传递activation,通信频率和形态更适合这种低主机互联带宽。社区在具体模型与条件下的直接对比,也指向PP优先的设计方向。但这仍然不是万能结论。模型结构、量化方式、上下文、batch和引擎都会改变结果,任何一次tokens/s都不能脱离条件成为这张卡的永久铭牌。

    原则只有一句:让计算尽量留在房间里,让穿墙的次数尽量少。

    同样的诚实也要放到节点之间。

    4124的双口25GbE对企业推理很有用。它可以承担模型分发、对象存储访问、API入口、独立副本池、日志和向量库;可以把多台节点组织成服务层,让流量在可用副本间转移。4029的双口10GbE也能做基础节点和副本路由。这些都是实实在在的能力。

    但25GbE不是现代scale-out AI Fabric。它不能被包装成每GPU 200Gb/s级东西向网络,也不适合拿来支撑通信密集的大规模训练或跨节点重并行。网络能做什么,就让它做什么:分发模型,承接请求,搬运日志,连接对象存储。不要让一条服务网络去冒充一条它从未成为的高速互联骨干。

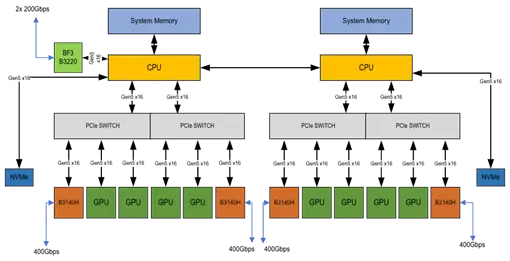
    NVIDIA RTX PRO AI Factory 2-8-5-200参考节点架构。来源:NVIDIA Enterprise Reference Architecture。

    于是,512GB的幻觉被拆开了。

    八间房还在,甚至比最初更有价值,因为它们终于有了门牌、用途和故障边界。真正消失的只是那座不存在的大厅。企业平台不需要把墙说没,它需要知道墙在哪里,门有多宽,哪一间断电后可以被隔离,哪一条走廊拥堵时应当停止增加住户。

    但房间能不能长期使用,最后仍取决于楼。

    卡只是被搬回来的钢筋。承重墙、内存通道、风墙、电源、系统盘、管理口和网络,才决定这些钢筋会被重新建成一座可交付的建筑,还是继续堆在废墟里,等下一张更漂亮的配置单替它们起名。

    三、承重墙:企业价值藏在无聊处

    图像

    所有目光都落在显卡上。八张卡,八块从矿场废墟里拖回来的硅,人们围着它们估价、争论成色,像围观从倒塌大楼里抽出的钢梁:这块料还好吗,裂了没有,还能撑几年。没有人抬头看楼本身。地基,承重墙,配电井,通风道。一栋楼塌不塌,从来不取决于大厅里挂着什么,而取决于那些没人愿意多看一眼的部分。楼是站着死的,也是站着活的。站在结构上,死在结构上。

    服务器也一样。废墟里能站住的,从来不是装修最亮的房间,而是结构没被砸坏的框架。而结构,恰好是整个行业最不愿意谈论的东西——因为它无聊。无聊到没人拍照,无聊到写进方案里像在凑页数,无聊到销售念到这里会自觉放低声音。可是每一台真正跑过五年、换过三拨业务、深夜被叫醒过又活下来的机器,靠的都是这些段落。光会灭,柱不会。

    先把两块框架说清楚。一个字都不能含糊,含糊的规格是另一处看不见的裂缝,裂缝都在没人读的段落里。

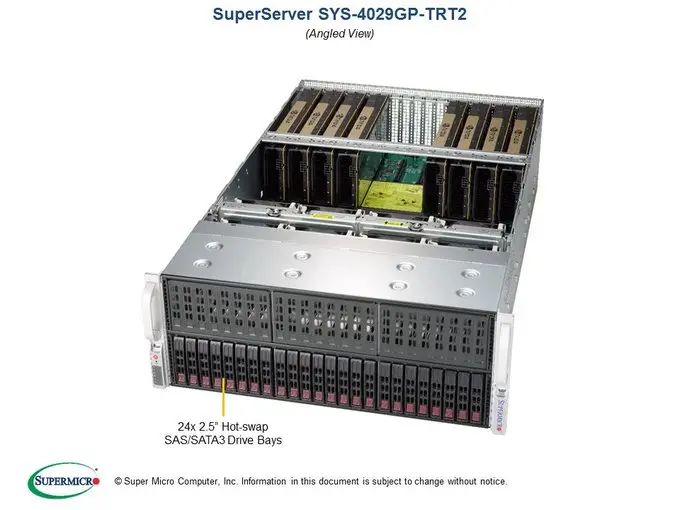
    第一块,Supermicro 4029。4U的机架,双LGA3647插座,24个DIMM槽,PCIe 3.0,最多24个2.5寸盘位,板载两路10GBase-T,8颗92mm热插拔风扇。以4029GP-TRT2这个尾标为准,官方列了11条PCIe 3.0 x16加1条x8,最多能装到10张卡;TRT变体则明确写着8张双宽卡。买这台机器要核对完整尾标,同一个数字家族里住着好几种不同的楼。官方完整供电是四颗2000W电源,2+2结构。CPU配双Xeon Gold 6130:每颗16核32线程,每颗6个DDR4内存通道,两颗加起来,12个通道。这个数字要记牢。十二。不是十,不是十六。十二。

    Supermicro SYS-4029GP-TRT2官方产品图。图片来源:Supermicro。
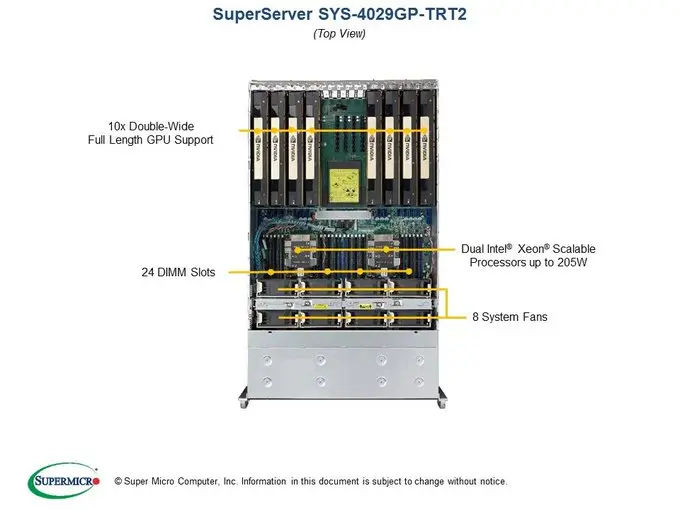
    Supermicro SYS-4029GP-TRT2官方俯视结构图。图片来源:Supermicro。

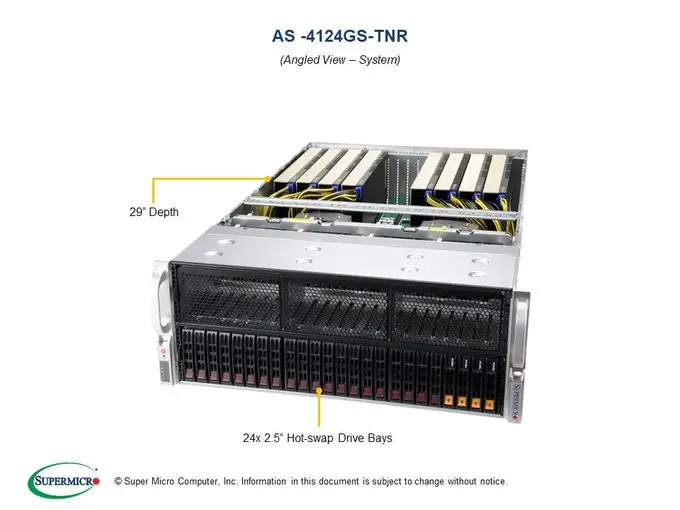
    第二块,Supermicro 4124。同样是4U,双AMD EPYC 7002或7003,原生8个双宽GPU位,Dual-Root结构,GPU直连PCIe 4.0 x16。32个DIMM槽,最高8TB DDR4-3200;官方页面白纸黑字写着,最佳性能是插16条内存,厂商把答案印在了图纸上,只是没人翻到那一页。EPYC 7002每颗8个内存通道,双路16个通道。存储上原生2个SATA口做RAID1、4个NVMe位;8颗11500转的重型风扇;IPMI 2.0带KVM over LAN。官方完整供电同样是四颗2000W,2+2。

    图像

    十二对十六。这两组数字比任何跑分都无聊,也比任何跑分都诚实。跑分会说谎,负载会变,benchmark可以挑,通道数印在主板上,一颗都不会多。内存通道是一栋楼的承重柱:柱子立着,数据才有路走;柱子空着,再大的厅堂也是危房。后面所有关于这三台机器的判断,都要回到这两组数字上。它们是本部分的地面,一切在它上面展开。

    顺便说穿一个常见的错觉:4124主板能给PCIe 4.0 x16,不等于卡就能跑到Gen4。槽位是路,卡是车,车只肯开Gen2 x4的速度,八车道的路也拦不住它慢。平台的先进喂不进端点,这是另一处容易被规格表骗过去的地方。

    所以就有了那个必须掰开的问题:512GB,到底拉满了什么。

    先说为什么死抠通道。推理不是只有显存在干活:请求进来要先过CPU,tokenizer切词、调度器排队、批处理重组、结果序列化,全在内存里来回搬。通道多而均匀,这些搬运就有足够宽的路;通道空一半,CPU再快也要等数据。楼上住多少人是一回事,楼梯修了几部是另一回事。

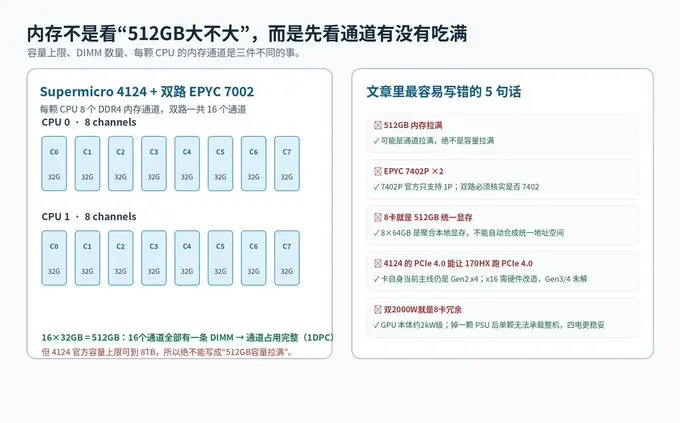
    答案分两层。第一层很冷:4124的内存容量上限是8TB,512GB离拉满差得很远,把它写成内存顶配是看错了图纸,把杂物间认成了天台。第二层藏在条数里:如果这512GB由16条32GB组成,双路EPYC的16个通道,每条道都插了一条DIMM,一通道一条,1DPC,通道占用完整。这叫带宽拉满,不叫容量拉满。同样512GB,换成8条64GB,只覆盖一半通道,容量没变,楼里却有一半承重柱是空的,数据走到那里就要绕路、排队、慢半拍。两种配置在规格表上写成完全相同的四个字符,在机箱里是两种完全不同的结构。表上一样,楼里不一样。而所有失败的事故报告,写的都是表,不是楼。

    内存容量、通道占用与关键配置纠错。资料包原创信息图。

    所以拿到任何512GB的机器,第一件事不是看总容量,是让供货商报清单:几条,每条多少GB,什么频率,几个Rank,插在哪些槽,各归哪颗CPU。不再接受一个光秃秃的数字。数字越漂亮,越要问它是怎么凑出来的。漂亮的总数是最大的陷阱,它把八种结构压扁成一个词,把裂缝压扁成没有。

    4029那边的256GB同理,甚至更糙。双6130是12通道,256GB可以是8条32GB,可以是16条16GB,通道覆盖和两颗CPU之间的对称性完全不同,而推理时tokenizer、调度器、网络栈就跑在这些柱子上。宁可要条数和布局说得清清楚楚的内存,也不要只报总量的糊涂账。一栋楼可以旧,但不能有一张说不清承重结构的图纸。说不清图纸的楼,每一次改造都是赌博,每一次扩容都在加注。

    手里三台机器,就按这个办法照X光。同一批废墟,照出三种骨架。

    方案A,4029,双6130,256GB,一块960GB SSD加一块1.92TB SSD,双口10G,卖方写2000W双电。双6130合计32核64线程。定位:低成本的副本节点,基础的推理入口。它就是楼群里那几间朴素的偏房,模型放得下,请求接得住,撑主力不指望它。老平台,老得诚实,老得知道自己只该做什么。偏房有偏房的用处:主力楼检修的时候,请求还有地方落。

    方案B,4124,卖方写7402P两颗,512GB,一块960GB SSD加一条3.84TB NVMe,双口25G,同样写2000W双电。如果CPU实际是7402双路、内存真是16乘32,合计48核96线程,它是三台里CPU、内存、网络最均衡的主力底座。但那两个如果,必须当场拆开验。如果这个词在采购里不是假设,是风险敞口。

    先拆CPU。7402P在AMD官方规格表里只支持单路,一颗孤立工作的芯片,天生只能独居;能双路的是7402,不带那个P。卖方写成7402P两颗,要么是抄单时的笔误,要么是不懂平台,要么是明知故省。不管是哪一种,钱付出去之前,必须亲眼看到BIOS界面或者lscpu的输出,不是听解释,是看屏幕。一个字母的差别,是一整台机器一半的算力结构。废墟里最贵的错误从来不是买到旧东西,是把图纸看错一个字,然后照着错误的图纸往下盖。盖得越认真,塌得越完整。

    再拆内存。512GB是不是16乘32,决定主力底座这五个字成不成立。是,16根柱全立着;不是,就退回一半柱子的楼,名字再好听也只是名字。

    方案C,4124,双7302,512GB,一块960GB SSD加两条3.84TB NVMe,双口25G,四颗2000W。双7302合计32核64线程,核心数比7402少,但对推理服务的编排足够。四电、双NVMe、25G,三台里它最接近能直接交付生产的底座。仍要照X光:512GB的条数分布、每块盘的SMART和通电小时、每颗电源的健康日志、八卡满载下的热稳定。交付不是签收,是验收清单全部划勾的那个时刻。

    A是入口,B是赌注,C是交付。三台机器,三种命运,压在从不出现在宣传图上的那些参数里。宣传图上只有显卡在发光,其余部分都在阴影里。而阴影里的东西,才是这栋楼。

    然后是电。这一段最无聊,也最致命。电流是这栋楼地面之下看不见的地下水,没人谈它,直到墙面渗水那天。

    先算账。八张卡,每张标称250W,仅GPU本体就约两千瓦。加上双CPU、内存、风扇、硬盘、网卡、主板和转换损耗,整机峰值还要更高。官方完整方案里,4029和4124都是四颗2000W组成2+2:平时四颗分担负载,坏掉一颗,剩下的三颗接得住满载的八卡节点。四颗电源,才是这个机架被设计出来时的样子,两颗是省出来的,省的地方从来不在图纸上。

    而卖方嘴里的双电——两颗2000W——听着也有冗余,坏一颗还剩一颗。可一颗2000W托不住满载的八卡。所谓双电,冗余的是不宕机这个概念,冗余不掉负载本身。掉电那一下,机器不会优雅降速,不会体面地只跑四张卡,它只会死。半夜三点,死在负载最高的时刻,死在最多人用着的那个小时。冗余这个词在规格表上免费,在物理上从来不免费。

    还有更冷的一行小字。2000W要在230到240伏的交流高线输入下才接近满额;100到120伏的环境里,这颗电源只输出约1000W。也就是说,把机器搬进一个110伏的机房,哪怕四颗电源齐装,实际供电能力直接砍半:机箱里站着四颗电源,地底下只流着一半的电流。PDU、插座、线材、空开,全都要按高线重新设计,一条链路上任何一个环节按低线敷衍,整条链路就按低线活着。废墟里的设备最怕的不是旧,是你以为它站在坚实的地面上,其实地面早就被挖空了。

    电之上是风。

    图像

    CMP 170HX是一张全被动散热的卡,卡上没有风扇。这意味着服务器那面风墙不是可选配件,不是散热加强包,而是这张卡的工作条件本身。没有风,硅片在自己的热量里窒息,像一座不通风的建筑从内部开始腐坏。8颗上万转的重型风扇昼夜不停,把整条风道灌满,导风罩必须完整,少一块挡板,气流就走捷径,某几张卡就在角落里默默过热,直到某天夜里掉卡,日志里只剩一行看不懂的错误。热不会喊疼,它只记账。

    这面风墙有代价。上万转的风扇意味着持续的噪音、按千瓦计的风扇功耗、机柜里密度惊人的热排风。机器不能塞进普通办公室的角落,它需要真正的机架、真正的冷热通道、真正算过账的空调。买楼之前先看通风,这句话在这里是字面意思。

    社区长期部署的共识,是把核心压在约70度的水平,显存热点压在75到80度;85度是工作上限,95度开始降速,98度关机。这些数字不该被当成日常运营目标,它们是灾难刻度,标着这栋楼在第几层开始塌、在第几层彻底放弃。日常目标应该离灾难刻度远一点,再远一点。

    而且验证散热不能用轻载跑分糊弄。普通的FP32空转功耗很低,测不出真实的热画像。必须上真实的Tensor负载、真实的大模型、真实的长上下文,八卡同开,连跑八到二十四小时,盯着温度、功耗、错误日志,一页一页存下来。同一排卡里某一张明显更烫,先查硅脂、导热垫、散热器接触和风道,别急着怀疑芯片。风扇和电源一样是会耗损的部件,坏了就换,别等它罢工。废墟里活下来的楼,靠的不是某根柱子特别粗,而是每一根都还在,每一根都被检查过。检查很无聊,无聊到值得。

    最后是那些更小的、几乎不好意思写进方案的东西。它们小到不配拥有章节,直到出事的那天,所有人才想起来它们有名字。

    系统盘。卖方配置里那块孤零零的960GB SSD,不能作为最终交付形态。生产系统盘要两块企业级SSD做RAID1,互为镜像,一块死了另一块接着跑,业务无感。单盘不是省钱,是在地基里埋一根随时会断的梁,然后假装看不见它。镜像的意思是:同一份数据,写在两个地方,赌它们不会同时塌。赌注很便宜,值得下。

    大容量NVMe做模型盘,放热模型、编译缓存,省下每天从网络重复拉大模型的时间;模型原件留在对象存储里,本地只是副本,烧了就再拉一份。4124原生四个NVMe位,老版本走Gen3,新版本可到Gen4,无论哪个,都够这个用途;4029原生是8个SATA加2个NVMe加一个M.2,本地模型空间明显更紧,这也是它甘居副本节点的原因之一。缓存这个词听起来像技术,本质是承认网络会慢、会断,提前把要用的东西放在手边。成熟的工程从不赌明天网络很好。

    IPMI。一个独立于操作系统的管理口,机器死透了也能远程登进去看传感器、重启、挂载镜像。生产上要给它独立的VLAN,改掉默认口令。它无聊到没人愿意在会上提起,却是深夜报警时唯一还开着的那扇门。门不需要好看,需要在。

    还有备件。GPU留百分之五到十的备卡池,电源、风扇、SSD有热备或现场件,配一套谁都会执行的换卡流程。二手硬件的可靠性不靠永不损坏,靠坏了能换、换了能好。这四个字比任何品牌承诺都便宜,也比任何品牌承诺都可靠。

    网卡。4029板载双口10G,4124是双口25G。对企业推理已经够用:模型分发、对象存储、API入口、副本路由。但要诚实:25G就是25G,它不是两百G级的AI互连fabric,跨节点做服务路由和模型分发可以,别把它包装成训练集群的骨干。把接入网说成fabric的人,不是乐观,是在改图纸。无聊的网卡,做无聊的事,做得住,就是价值。

    把这一部分从头看到尾,你会发现没有一句话是激动人心的。内存条数,电源颗数,电压伏数,风扇转速,盘的镜像,管理口的口令。这些东西放进任何一场发布会都会让全场睡着,它们没有叙事,没有光,没有可以剪成短视频的三秒钟。行业里所有响亮的话都留给了显卡,所有安静的事都留给了结构。响亮的话换来了围观,安静的事换来了活着。

    可是企业买走的从来不是八张矿卡。企业买走的是一台有序列号、有烧机报告、有温度曲线、有监控告警、有备件、有换卡流程的设备,是坏一颗电源不停机、坏一块盘不丢数据、坏一张卡两小时内换上的承诺。显卡是这栋楼的租户,光鲜,喧哗,随时可能搬走;这些无聊的部分才是楼本身。租户换了一茬又一茬,楼还站着。企业付钱的时候,买的是楼还在这件事,不是某一任租户的演出。

    废墟给的机会从来不是捡到宝贝。是把捡回来的结构,一根柱一根柱重新验过去:十二根还是十六根,每根有没有立着,电流够不够,风到不到,镜子里的那块盘还在不在。验完了,废墟才变成资产;验不完,资产只是还没塌的废墟,区别只在时间。

    企业价值不藏在矿卡的显存里。它藏在DIMM清单里,藏在BIOS截图里,藏在PDU的电压标签里,藏在RAID1的第二块盘里,藏在那个改掉默认口令的下午里。藏在所有没人拍照的地方。而没人拍照的地方,恰好是楼站着的原因。

    让软件承认硬件的残缺

    这套节点真正开始工作以后,软件不能继续假装自己面对的是一批标准数据中心GPU。

    宿主机要固定在Linux x86-64。社区解锁围绕特定版本的nvidia-open驱动工作,Secure Boot需要关闭,因为修改后的内核模块没有官方签名。这个条件并不优雅,却必须写进交付说明。隐藏它,只会让下一次系统重装变成一次考古:新驱动装上去,64GB消失,计算重新受限,所有人围着一台昨天还能工作的机器猜测发生了什么。

    所以镜像比安装文档更重要。把内核、驱动、解锁配置、容器运行时和验证脚本一起冻结下来,保存一个真正启动过、跑过、验收过的版本。升级不是“跟随最新”,而是先在一台节点、一张卡上验证,再扩大范围。升级前记录显存、链路、温度和模型结果;升级后逐项对照。任何一项不一致,就退回原镜像。

    容器也不是魔法。Docker或containerd加NVIDIA Container Toolkit,可以让服务部署更整齐,却不能把宿主机的脆弱隔离掉。容器里看到GPU之前,宿主机的修改驱动必须先稳定。通用GPU Operator如果自动接管驱动,很可能覆盖掉解锁环境。Kubernetes可以管理服务,不该擅自重写这栋楼的地基。

    推理引擎同样要按边界选择。vLLM更适合作为主要在线推理引擎,llama.cpp适合烟测、GGUF、小模型服务和兼容路线。SGLang可以测试,但不能只因为名字出现在热门讨论里就成为默认。企业平台不是软件展览会。每多一个引擎,就多一套模型格式、启动参数、监控指标和故障解释。

    社区样本已经证明这批卡能运行真实模型。单张64GB卡在特定量化、引擎和上下文条件下,可以跑数十到上百token每秒的解码,也可以通过并发获得更高聚合吞吐;八张64GB卡用流水线并行,甚至出现过运行超大MoE模型和长上下文的完整会话。这些记录很有价值,它们证明门能打开。

    但能力证明不是SLA。

    模型名称、量化方法、输入长度、输出长度、并发数、引擎版本、驱动和采样参数,只要改一项,数字就可能变化。113 tok/s不是170HX的固定速度,30.2 tok/s也不是八卡节点的永久铭牌。把社区的一次完整会话写成产品性能保证,就像看到一辆旧车下坡时跑到一个速度,便把那个速度刻进发动机规格。

    真正能进入合同的,只能是客户模型在这台交付机器上的验收结果。

    同一个模型,同一份权重,同一量化,同一上下文,同一并发,在指定驱动和引擎上跑出怎样的首token延迟、decode吞吐、聚合吞吐和错误率。验收后把环境一起封存。以后每次升级,用同一套题重新考试。跑分快一点不代表升级成功;显存少了一块、错误多了一次、某张卡开始掉速,都应该让升级停下来。

    软件在这里承担的不是把旧卡伪装成新卡,而是让旧卡的每一种残缺都留下可观察的形状。服务路由知道哪张卡离线,监控知道哪张卡升温,镜像知道上一个可用版本在哪里,验收脚本知道今天的结果是否已经偏离昨天。

    秩序不是把缺陷藏起来。

    秩序是缺陷出现时,它不能继续匿名。

    一张企业交付表,应该比配置单更难看

    漂亮的配置单只写拥有了什么。真正的交付表还要写什么会坏。

    每台服务器要有机型完整尾标、主板、riser、背板、CPU、DIMM、盘、网卡、PSU和序列号。每张GPU要有PCI ID、VBIOS、原始容量、解锁后容量、PCIe链路、温度曲线、功耗、显存测试和维修痕迹照片。每个软件镜像要有内核、驱动、解锁版本、容器运行时和模型引擎。每次烧机要有开始时间、结束时间、负载条件、异常和处理结果。

    这张表不会好看。它会很长,会有空格,会有失败,会写着“这张卡温度偏高,已换导热垫复测”“这颗PSU告警,已更换”“这个NVMe健康度不合格,拒收”。它和销售材料的区别就在这里:销售材料负责让人想拥有,交付材料负责让人知道拥有以后要承担什么。

    卡也应该分级。不是所有通过解锁的卡都进入同一池。根据显存测试、温度、功耗、链路、长负载错误和外观维修史,把卡分成生产、备用、观察和淘汰。生产卡进入节点;备用卡保持可随时替换;观察卡继续延长烧机;出现不可解释的HBM错误、反复掉卡或热异常,就退出交付范围。

    节点也不能只记一个“通过”。八张卡共同运行时,最弱的一张会定义整机稳定性。单卡通过后再逐级增加,不只是为了减少排障难度,也是为了让问题拥有出生时间:一张时稳定,两张时稳定,四张时出现供电波动,八张时某个风道角落过热。没有这个过程,所有错误会在最终状态同时出现,像楼塌下来以后才开始找第一块松动的砖。

    交付后还要规定死亡条件。连续出现什么Xid必须下线?显存测试出现一次错误是否允许重试?PCIe反复重训几次算故障?温度超过哪个阈值开始降载?服务进程异常退出多少次触发换卡?备卡换入后要重跑哪些测试?这些条件应该在事故发生前写下,不能等故障出现后由当班的人临时解释。

    因为人在事故之后最擅长的事情,就是替自己找到一个“还能继续跑”的理由。

    企业化恰恰要提前夺走这种解释权。达到死亡条件,节点退出;卡进入隔离;流量切走;换件;复测。没有“先观察几天”,没有“这次可能只是偶发”,除非观察本身也是一条有时间、有指标、有责任人的正式流程。

    这就是二手硬件真正昂贵的部分。

    卡可能便宜,服务器也可能便宜。可每一张表、每一次烧机、每一块备件、每一份镜像、每一次拒收,都要花时间。成本没有消失,只是从采购发票转移到了工程秩序里。谁只计算卡价,谁就会在交付以后收到另一张没有上限的账单。

    而这张账单不会一次寄来。

    它会在风扇老化时来一点,在驱动升级时来一点,在某张卡的HBM开始出现偶发错误时再来一点。楼不是在一个晚上突然变旧的。它每天掉一点灰,只是多数时候没人抬头。

    方法反噬:标准化也会长出自己的裂缝

    把旧硬件重新工程化,并不会把它变成新硬件。

    ECC不会因为烧机通过而出现,NVLink和P2P不会因为部署文档写得漂亮而恢复,Gen2 x4也不会因为路由策略聪明就升级成Gen5 x16。社区驱动仍然不是厂商企业支持;一次内核升级,仍可能让已经稳定的节点重新回到不可用状态。Ampere的70SM、4480个CUDA Core和CC 8.0不会长出Blackwell的新架构能力,也不会凭空拥有FP8、FP4和现代企业卡的认证、保修与责任链。

    标准化能做的是把风险照亮,不能把风险消灭。

    它甚至会制造新的维护债。驱动冻结意味着你必须维护镜像;回滚意味着你必须保存旧环境;监控意味着告警规则会漂移;备卡意味着库存也要定期上电测试;SOP意味着每次硬件、内核和模型变化之后,都要重新验证。你建起一套秩序,秩序本身便开始老化。楼不再是废墟,但楼会漏水,消防门会被杂物堵住,图纸会被后来的人改错。

    所以这套平台不能靠一次交付证明永远可靠。它只能靠持续点名,持续烧机,持续换卡,持续拒绝那些看起来已经足够完整的配置单。

    企业买的其实是坏掉以后怎么办

    企业AI算力平台概念海报。AI生成示意图,非实拍,不作为硬件结构证据。

    与RTX PRO 6000 Blackwell比较时,最容易被滥用的是成本。

    图像

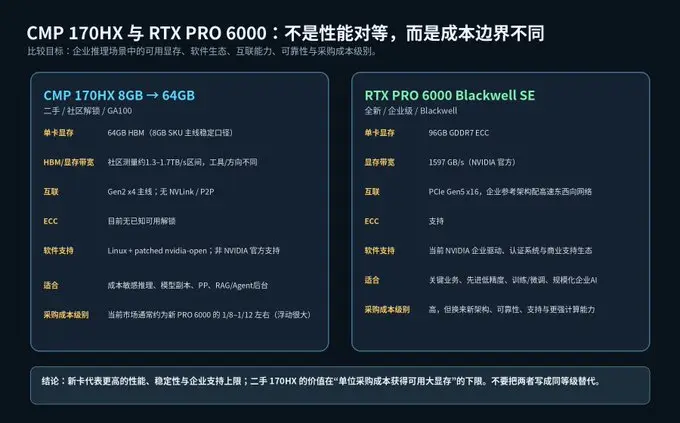
    按照资料包截至2026年8月的公开市场样本,全新RTX PRO 6000与二手、可解锁CMP 170HX的单卡采购成本,大致相差约8—12倍,或者更稳妥地说,接近一个数量级。这句话可以写,但必须立刻把另一半写出来:它只描述采购成本,不描述性能等价,更不描述可靠性等价。

    RTX PRO 6000有96GB ECC GDDR7、Blackwell架构、PCIe Gen5 x16、FP8和FP4能力、当前企业驱动、认证系统、保修和商业支持。170HX赢的是成本下限,是二手采购条件下的大显存与HBM带宽;它没有赢得架构上限,也没有赢得厂商替你承担故障的权利。

    把成本差写成性能等价,就像因为废墟里的钢筋便宜,便宣布它和新楼拥有同一份质保。价格是真的,结论是假的。

    真正可交付的产品名称,不该是“廉价A100集群”,也不该是“RTX PRO 6000平替”。它更接近“成本优化型大显存推理节点”或者“私有化AI算力节点”。客户买下的不是一张被解锁的矿卡,而是一台有序列号、有单卡档案、有温度曲线、有烧机报告、有监控、有备件、有回滚镜像的设备。

    采购核对从机型完整SKU开始。4029或4124的尾标、主板、riser、背板、PSU数量都要逐项确认。“7402P×2”必须在付款或收货前由BIOS和lscpu拆穿。DIMM不能只写总容量,要列条数、单条容量、频率、Rank和CPU归属。PSU要看数量、型号、健康状态,也要确认机房是否提供220—240V高线输入。盘位背板、HBA、RAID、NVMe线缆、NIC、光模块和DAC都要有清单。IPMI必须能登录,默认弱口令必须消失。

    单卡入库也不是看见nvidia-smi就结束。先用PCI ID分清8GB和10GB SKU,记录VBIOS、原始显存、PCIe链路、温度和功耗。检查PCB、腐蚀、封签、维修痕迹和供电口;确认EPS 8-pin逻辑,不能拿PCIe 8-pin强插。解锁后,8GB卡应当看到约64GB,10GB卡约40GB;随后必须做显存写读和地址模式测试。

    整机上电要从一张卡开始,再到两张、四张、八张。每一级都观察12V、PSU、风扇、核心温度、HBM温度、掉卡和PCIe重训。最后八卡同时加载真实模型,跑HBM带宽、host到GPU带宽、Tensor或GEMM、长上下文和并发推理。不能拿一张卡通过替八张卡担保,也不能拿轻载FP32替真实热负载担保。

    建议做8—24小时生产型持续烧机。保存每张卡的温度、功耗、Xid、AER、OOM、服务错误和异常退出。tokens/s必须和模型版本、量化、上下文、batch、引擎、驱动绑在一起,否则它只是一个失去现场的数字。

    系统层同样要冻结。Linux x86-64、修改过的nvidia-open驱动、关闭Secure Boot,这条路径必须形成可复现镜像。禁止驱动自动升级,升级要灰度,失败要能退回已知版本。Docker或containerd可以承载服务,但容器稳定不能替宿主机驱动稳定。监控要同时看到IPMI的电源和风扇、NVML的温度与Xid、服务层的P50/P95、请求队列、tokens/s、OOM和重启次数。

    最后留出5—10%的备卡池,连同PSU、风扇和SSD备件,写清换卡SOP。二手硬件的可靠性不是“永远不坏”,而是坏了能识别,能隔离,能换,换完能重新验收。企业真正购买的,是故障发生以后,现场不会重新退化成一片无人认领的废墟。

    回到那行字

    文章开始时,配置单上写着:7402P×2。

    它只有一个字母不对。可那个字母足够让整栋想象中的楼失去一根承重柱。它提醒人们,系统最危险的时刻并不是报错,而是每一格都填满了,绿灯也亮着,于是所有人默认建筑已经完成。

    八张卡可以亮起512GB。风扇可以满转。API可以返回。监控面板可以是一片绿色。

    但绿灯不会告诉你那512GB是八间上锁的房间;不会告诉你某张卡没有ECC;不会告诉你双电掉一颗后接不住满载;不会告诉你驱动下一次升级是否还能回来;也不会告诉你那两颗CPU究竟是7402,还是一行从未被核验的文字。

    废墟被重新通电时,最容易让人误以为它已经重建。真正的重建却发生在没有人愿意拍照的地方:BIOS截图、DIMM清单、PDU标签、第二块系统盘、烧机日志、备卡架和回滚镜像。

    这些东西不能让矿卡变成旗舰,也不能让旧楼永远不塌。

    它们只能让某一天裂缝出现时,有人知道裂缝在哪里,哪一层该停,哪一块材料该换,哪一份图纸仍然可信。

    企业买的不是八张矿卡。

    企业买的是那盏绿灯下一次撒谎时,谁敢先把它关掉。

    来源:https://x.com/dashen_wang/article/2091563517849801106

  • 成员瘫了68分钟,全军团没一个知道

    成员瘫了68分钟,全军团没一个知道

    那天傍晚六点零九分,我发了一句话工单。

    “API连不上了,你去检查一下。”

    九分钟后,修好了。

    但真正让我后背发凉的不是这九分钟,是它前面的六十八分钟——那个成员从下午五点零一分就开始全链路报错,到我把工单派出去,中间整整一个小时零八分钟,整支军团没有一个成员知道,没有任何一条报警,没有任何一个哨兵拉响。

    它是瘫着的。

    绿灯亮着。

    我说“你去检查一下”,其实是在替整套系统认错:本该机器先叫,结果是我先叫。

    修的过程很快。查容器、查网关、查日志,九分钟定位:上游平台改了模型代码,主链路开始报“模型不存在”,于是流量掉进备用链——而备用链的那把钥匙,压根没写进这个成员自己的配置文件里。主路一抖,备用路是个空壳,全链 401,成员哑掉。

    一个成员,两层保险,两层都是纸糊的。

    更难堪的是修完之后。我把这次事故顺着日志往下挖,挖出三层真相,每一层都适用于全部十三个成员:

    第一层,上游会抖。模型服务平台批量调整模型代码,这不是阴谋,是常态。你挡不住上游,你只能保证掉下来时有东西接住。

    第二层,接住的那层从来没被测过。备用链从配置那天起,一次都没有被真实触发过。配置文件里写着它,监控里看不见它,演练里没有它。它是写在纸上的灭火器。

    第三层,钥匙在漂移。同一把钥匙有多份独立拷贝,散在各成员自己的配置文件里。给一个成员配了,不等于给其他成员配了;配置里引用了,不等于文件里存在。没有任何机制保证它们同步。

    六十八分钟、九分钟、三层纸糊的保险。

    我那天晚上没有睡好。不是焦虑,是算账:如果这次瘫的不是最闲的那个成员,而是正在对外服务的那几个呢?如果上游抖的是白天而不是傍晚呢?如果我不在家呢?

    军团这个词,我说了很多次。那天我才承认:我有的是一群会干活的成员,没有一支有后勤的军队。

    军队打仗,从来不是靠士兵多勇。靠的是后勤线。

    粮草、岔路、名册、哨兵。

    这四样补齐之前,成员数量只是故障的放大器。

    这篇文章就是那四层后勤线。全部是我自己机器上真跑过、真炸过、真修过的东西。参数给全,你可以直接抄,也可以拿去检查自己的军团。

    先杀掉三个旧信仰

    在讲四层之前,先埋掉三个我曾经真心相信的东西。它们不是蠢,它们曾经是对的。所以才危险。

    旧信仰一:模型越强,军团越强。

    错。军团强度的瓶颈根本不在单个模型的智力。一个成员再聪明,它的钥匙配错一样全哑;备用链再华丽,没触发过一样是纸。军团强度取决于最弱的那层后勤,不取决于最亮的那个模型。

    旧信仰二:要扩容,就多开账号。

    我曾经给每个成员都挂外部接口,以为这就是规模化。这次事故把这张账单拍在我脸上:外部接口意味着整支军团的生命线握在上游手里,上游改一次模型代码,我就得挨个成员翻配置。成员越多,翻得越久。这不叫扩容,这叫把单点故障复制十三份。

    旧信仰三:本地跑大模型,消费级硬件不配。

    这个信仰我杀得最疼,因为我亲自给它交过学费。我最早按参数量选型,挑了个又大又全的稠密模型搬上机器,实测每秒七点八个字。七点八。你对着它说一句话,它想想再回你,像越洋电话。那台机器不是不行,是我违反了物理。

    物理是什么?往下看。

    粮草层:速度是带宽决定的,不是参数

    先讲清楚一件事,很多天天聊模型的人其实没算过:

    本地推理的解码速度,先算一道除法。

    模型每生成一个字,都要把它“激活”的参数从头到尾读一遍。所以:

    每秒输出字数 ≈ 内存带宽 ÷ 每 token 需要读取的字节数

    就这么朴素。带宽是分母上的固定资产,你买什么硬件它就定多少;分子上你能动的只有一个变量——每 token 读多少字节。

    稠密模型没法动这个变量。270 亿参数就是每 token 读 270 亿参数,量化到 4 比特也还是那么多字节,卡在带宽上就是七点八个字。这不是优化问题,是天花板问题。我当时不该骂机器,该骂自己没做除法。

    MoE 把这个变量劈开了。

    混合专家模型的架构是:总参数量很大,但每个 token 只激活其中一小部分——比如一个总参 350 亿、激活 30 亿的模型,每 token 真正要读的只有 30 亿参数的权重,剩下 320 亿在旁边站着,这个 token 用不上。

    注意这个魔法的本质:“模型存了多少”和“每个字要读多少”,第一次解耦了。

    存储靠硬盘和内存,便宜、量大管饱;带宽靠显存和内存通道,贵、就是那么宽。MoE 等于让你用便宜的存储囤一支庞大的专家队伍,每次只请真正被点到名的那几位上场。专家下沉技术把这个思路推到极限:

    • 注意力层、共享专家、KV 缓存——这些每个 token 都要用的,驻进显存;
    • 路由专家——那些被按需点名的,整批放在系统内存;
    • 每 token 只把被激活的少数专家从内存搬进显存算一下。

    llama.cpp 里就是一行参数的事:–n-cpu-moe 24 表示最上面 24 层的路由专家放内存。真实效果是有人在一张 12G 显存的消费级卡上,把 35B 总参的 MoE 模型跑到 17 万字上下文、稳定每秒六十个字。12G 显存,跑 350 亿参数。搁三年前这是笑话,现在是 README 里的标准操作。

    为什么专家下沉能成立?因为路由不是均匀的。社区里有人给 MoE 的激活做过画像,结论很硬:解码时专家的点名高度偏斜,基尼系数零点七六,而且相邻两个 token 有百分之四十四的概率点同一批专家。翻译成人话:专家有冷热,热的就那几个,冷的常年没人理。 把冷的放内存里睡觉,一点不亏;热的反复被搬进显存,PCIe 总线喂得饱。后来甚至有人做了显存里的专家缓存,命中率稳定后速度又翻了几倍——同一张 8G 卡,纯 CPU 卸载一秒半个字,加了缓存一秒十几个字。

    这就是我说的“按带宽养,不按参数养”。

    再加一味料:MTP,多 token 预测,工程上叫投机解码。原理不玄:让模型自己先草拟接下来两三个字,主模型一次验证,验证通过就整批收下。因为草拟的字也要过主模型的数学检验,输出和逐字生成在数学上等价——这不是牺牲质量换速度,是白捡速度。实测数据摆在这:一张 16G 的消费级卡,27B 模型不开 MTP 每秒五十四个字,开 MTP 之后九十四个字,提升百分之七十三,代价是零点六个 G 的显存。

    注意甜点:草拟两个字收益最大,草拟六个几乎不再涨——因为瓶颈转到了验证算力上。参数不是越大越好,连投机解码的参数都不是。

    到这里,粮草层的账算完了,给你抄的结论:

    1. 选型先做除法:拿你硬件的内存带宽,除以候选模型“激活参数 × 量化位宽”,商就是你的理论每秒字数,除不上去的别碰;
    2. 稠密大模型在消费级硬件上没有前途,这不是信仰是物理;
    3. 低激活 MoE + 专家下沉 + MTP,三个乘数叠起来,消费级硬件就能养出交互级速度。

    军营经济学:并发才是军团的真指标

    单机速度只是粮草,军团要算另一本账:并发分摊。

    单个成员对话,每秒二十个字就够用——这是交互体验的及格线,再快你的眼睛也读不过来。军团的算法完全不同:十三个成员同时干活,每个都要二十,加起来就是二百六。这时单流跑分一百的模型,作为军团底座反而不够看。

    反过来看一个真实数字:有人在小型一体机上跑这个级别的 MoE 模型,单流每秒六十八到七十个字,同时开十六个 Agent 并发,聚合吞吐三百八十五。除一下:十六个成员同时干活,每个还分到每秒二十四个字。

    二十四个字,刚好卡在交互及格线上面。

    这就是本地底座的经济账:一台机器、一个模型、十六个成员并发,每个成员的速度还够用。对比给十六个成员开十六份外部接口的账单,这笔账怎么算都不用犹豫。

    所以我的军团架构现在分两级:

    • 日常层:成员的对话、工具调用、日常巡检,走本地 MoE 底座。速度够,成本为零,数据不出门。
    • 攻坚层:重活、长链路复杂任务,升级到最强的外部模型。外部接口从“生命线”降级成“特种装备”。

    分级不是拍脑袋,我定了三条可执行的路由标准:

    1. 按链路长度分。三步以内的任务——查个状态、改个配置、回句话——本地层包了,这类任务量化模型成功率不输外部接口,没必要烧配额。五步以上的长链路任务,先本地跑一遍,成了记下,败了自动升级攻坚层重跑,并把失败样本存下来——这些样本就是你下一轮“二十遍成功率”测试的题库。
    2. 按隐私等级分。碰配置、碰钥匙、碰内部数据的任务,永远不出本地门,外部接口再强也不行。这一条不是效率条款,是主权条款。
    3. 按可验证性分。任务结果能被机器自动验证的(测试通过、命令返回零、文件哈希对得上),放心交给本地层跑,错了会自己暴露;结果要靠人眼判断质量的(长文、方案、对外承诺),升级攻坚层。可验证的活不需要聪明的模型,需要的是老实的验收。

    这个路由跑顺之后会出现一个副产品:你会攒下一份自己军团的“任务-成败”台账。哪个成员、哪类任务、哪个模型、成功率多少,一目了然。到那时,选型不再靠发布帖和信仰,靠自己的账本。这才是本地底座真正的复利——不是省了几个 token 的钱,是你终于有了别人没有的数据:你自己的活,什么模型干得最好。

    生命线必须握在自己手里,特种装备可以租。这个分级还有个隐藏好处:外部接口的调用次数暴跌,配额、限额、上游抖动,这些过去的日常噩梦,现在只是攻坚层的偶发摩擦。

    但注意,这套架构成立有一个前提:本地底座不能是个跑分漂亮的花架子。这就接到岔路层了。

    岔路层:备用链路必须被触发过一次

    现在回到那次事故的第二层真相:备用链配了三个月,一次都没被触发过。

    我后来去翻了业界把故障切换做到生产级的开源网关文档,人家把这个当成宪法级的常识,白纸黑字三条:

    1. 先重试,再切换。主路失败,先在同一路径上重试几次,别把一次网络抖动升级成一次链路切换。切换是有代价的,不是免费的。
    2. 失败要冷却。刚失败的路径进冷却期,路由自动绕开它,别让下一个请求又撞上同一堵墙。
    3. 最重要的一条:fallback 配置必须在非生产环境主动触发一次验证。文档原话的意思就是——把主路人为弄坏,然后发一条正常请求,亲眼看着它掉到备用路、再亲眼看着备用路把活干了。

    第三条是我们全缺的。我们的备用链是静态配置:文件里写了,系统信了,从来没人看过它到底通不通。等上游真抖的那天,备用链第一次被真实触发,也是第一次暴露它没钥匙。

    这就像消防演练从来不做,演习当天下楼才发现安全通道堆满了杂物。

    我的补法很土,但闭环:

    给每条备用链做一次“断路演练”。在低峰期,人为禁用主路(改配置或断掉该成员的外部接口),然后从该成员的正常入口发一条真实任务,全程盯着三个观察点:

    1. 流量真的掉到备用链了吗?(没掉,切换逻辑是坏的)
    2. 备用链的钥匙真的能用吗?(401,就是这次事故的死法)
    3. 任务真的完成了吗?(有响应不等于干了活)

    三问全过,才允许这条备用链在配置里标“已验证”,否则标“纸糊”。演练记录留档,任何人改动链路配置,状态自动降回“纸糊”,必须重新演练。

    演练频率也定死:每季度一次例行断路,任何一次上游真实抖动之后加练一次。备用链是肌肉,不练会萎缩——配置文件不会变,钥匙会过期,模型代码会被下线,你上一次验证通过的世界,已经不是这一次要应对的世界。

    升级演练也照此办理。我后来给每个容器化成员建了升级机制,流程是死的:升级前一致性备份、锁死镜像版本号、只动这一个成员、跑验收清单、任一项不过就回滚。第一次真实演练就抓到一个端口冲突——新旧版本都报同样错误,说明那雷不是新版埋的,是一直都在,只是从没人做过升级演练。机制立起来的当天,雷排掉了。

    岔路层的结论一句话:没被触发过的备用链,等于没有备用链。写在配置里的可靠性不是可靠性,是被验证过的可靠性才是。

    名册层:钥匙必须只有一个真源

    第三层真相最隐蔽:钥匙漂移。

    事故里那个成员,配置文件里写着“我要用这把钥匙”,但它自己的环境文件里根本没有这把钥匙。钥匙存在于别的成员的文件里。十三个成员,一人一份环境文件,同一把钥匙被手工复制了 N 份,没有任何机制保证它们一致。

    这是典型的配置漂移,而且是最危险的那种——因为它平时完全不表现。主路通着的时候,谁也不碰备用钥匙;主路一抖,你才发现名册上写着的人根本不在营里。

    业界的标准解法几十年前就有了:密钥集中管理,按需声明式下发。核心三条:

    1. 单一真源。每把钥匙只存一份,在一个受保护的 主文件里,权限收紧到只有管理者能读。
    2. 声明式分发。每个成员声明“我需要哪几把钥匙”,启动前由同步机制从真源把钥匙注入它自己的环境,需要几把给几把——最小权限,不搞人手一份万能钥匙。
    3. 缺失拒启。声明的钥匙在真源里不存在?启动失败,大声报错,拒绝半死不活地起来。

    容器化环境里这套特别顺手:初始化脚本在任何服务启动之前跑,正好做“同步钥匙 → 校验完整性 → 不全就拒启”这三步。改一处,全体生效;新增成员,声明即得;钥匙轮换,真源一改,全员下次启动自动跟上。

    这套东西落地之后,“手动给某个成员补钥匙”这种事就永远不需要再发生。因为名册只有一份,营里每个人要么都在册,要么启动时就会喊出来。

    名册层再往深一步是身份。这次事故让我意识到,一个持续运行的成员,它的身份不只是名字和记忆,还包括它“醒来后必须能读到的那几个文件”。配置、状态、配对资料,这些东西散在哪儿、归谁管、断了谁先知道——这是名册层的另一半。我的原则现在很硬:成员的生存必需品放本地持久盘,共享存储只放可再生的交换材料。你的心脏不能挂在别人家的电线上。

    哨兵层:一次两万,一次二十

    修完那天晚上,我翻验证记录,看到一个数字差点笑出声。

    我修完之后验证那次修复,是对着成员自己的接口发了一句“回复两个字:收到”。返回的账单写着:本次消耗两万零三百四十一个输入 token。

    两万个 token,验证一句“收到”。

    为什么?因为打成员自己的对话接口,系统会把它的完整上下文——记忆、技能、历史——全部构建进去。等于为了量个体温,把人全身 CT 做了一遍。

    而同样这次验证,绕开成员上下文,直接拿同一把钥匙对模型端点发一模一样的五个字,成本是多少?

    二十个 token 左右。

    一千倍。

    这个数字差就是我哨兵层的设计依据。健康检查有两个铁律:

    铁律一:哨兵必须直连,不许经过成员的上下文。哨兵测的是“钥匙能不能开模型这扇门”,不是“这个成员聪不聪明”。用最小请求打端点,五个 token 封顶,别把体检做成全身体检。

    铁律二:哨兵必须覆盖全部链路,包括备用。只盯主路的哨兵是这次事故的翻版——主路绿灯,备用路空壳。哨兵要对每个成员的主链和全部备用链各发一条独立探针,任何一条非正常返回就报警。

    哨兵的成本账:十几个成员、每人两三条链路、每小时一轮、每条约二十五个 token——一天五千 token 上下,一个月十几万 token,按本地底座算成本为零,按外部接口算也就是几杯咖啡。对比那次六十八分钟的失聪,这笔钱是白捡的。

    哨兵的排布我定成三班:

    1. 实时哨:每分钟一轮进程级检查——活着吗。便宜,抓硬死。
    2. 小时哨:每小时一轮链路级探针——钥匙还能开门吗。直连、小请求、全链路覆盖。
    3. 日哨:每天一轮身份级自检——重启后能读到自己的配置和状态吗,能回一句带时间戳的确认吗,能完成一个只读小任务吗。

    第三班就是复工检查,我单独说过它,这里不重复。三班哨兵各司其职,合起来保证一件事:下一次有成员瘫掉,是机器先叫,不是我先叫。

    那次事故是六十八分钟。哨兵上线后,同类故障的发现时间上限是一小时哨的一轮间隔——六十分钟。实时哨把硬死压到一分钟级。这就是后勤线买回来的东西:不是不出事,是出事时你知道。

    报警分级:哨兵最大的死法是被人关掉

    哨兵建起来只是半件事,另一半是让报警一直有人信。

    误报是哨兵的第一杀手。链路闪断三十秒、上游限流抖一下、探针自己超时——这些都会叫。头两次你会认真看,第十次你会烦躁,第五十次你会把报警群静音。从静音那一刻起,你的哨兵制度就死了,比没有哨兵更坏:没有哨兵你知道自己裸奔,静音的哨兵给你穿着铠甲裸奔的错觉。

    所以报警必须分级,我定三档:

    • 红:主链与备用链同时失败,或身份自检失败——成员确认失能。即时推送,允许叫醒人。
    • 黄:单链失败但备用接住,或同一条链连续两轮失败——降级运行。进日报,不叫醒人。
    • 蓝:单次抖动后自愈——只记数,不打扰任何人。

    配套两条纪律:静默必须带过期时间,不许永久静音;每条报警必须带上下文——哪个成员、哪条链、错在哪一步、上一次同类报警是什么时候。不带上下文的报警等于让人半夜起床后再从零排障,那不叫报警,叫转嫁。

    还有一条最容易被忽略:哨兵自己也要被哨兵盯。探针脚本是会坏的:环境变量改了、依赖升级了、接口字段变了,探针可能悄悄死掉,然后给你报一整年的“全部正常”。死掉的哨兵报平安,是所有监控系统里最安静的凶案。所以哨兵自身要有心跳:每小时哨自己也要上报“我还在跑、我上一轮真的发了探针”,连续三轮没有心跳,按红警处理。

    点名册:断电那天才是真考试

    后勤线还有最后一场考试,多数人从来没让它考过:整营断电重启。

    日常的重启是有序的:停一个成员,修,再起。真正的考验是无序的——停电、搬迁、主机死机之后,电一回来,十几个成员、几层依赖、一堆本地服务,要按正确的顺序全部自己站起来,还都要通过自己的复工检查。

    这不是理论风险。断电、死机、迁移,对一台长期服役的机器来说是必然事件,问题只是发生在哪一年。而大多数人的配置里藏着一个尴尬的事实:服务都设了自启,但依赖顺序没排。数据库还没起来,成员先醒了,读不到状态,按自己的逻辑判定“存储损坏”,然后开始走恢复流程——一顿操作把小事故放大成大事故。或者更常见:网关比网络先起,成员连不上模型,把钥匙错报成失效。

    所以我的冷启动验收不是“开机后服务都在”,是一张真实的点名流程:

    1. 断电前:确认所有成员的生存必需品都在本地盘,没有谁的心脏挂在共享路径上;
    2. 粗暴断电:不优雅关机,直接断——因为真实停电不会给你保存现场的机会;
    3. 来电后:全程不碰键盘,只观察。谁先起、谁等谁、超时的怎么办;
    4. 逐个点名:每个成员过复工检查——身份可读、链路可通、能回话、能干一件只读小活;
    5. 记录真实冷启动时长:从来电到最后一个成员复工,一共几分钟。这个数字要写进档案,它是你灾后恢复的能力上限。

    第一次做这个演练,大概率会抓到东西:起不来的、起了但不回话的、回话但钥匙失配的、还有全家都活着但互相在等对方的死锁。全都要修,修完再断一次,直到断电变成一件“可以睡得着”的事。

    军团的可靠性不是写在配置里的自启开关,是断电重来一遍之后,点名册上一个不缺。

    跑分是绿灯,任务成功率才是复工

    技术长文,最后必须泼自己一盆冷水。

    前面所有参数——专家下沉、MTP、量化、并发分摊——全都是速度故事。而速度故事有个巨大的陷阱:官方跑分全部来自全精度权重,你本地跑的是量化版。

    四比特量化对闲聊几乎无感,对长链路任务——一个 Agent 连续规划、调用工具、读报错、改方案的那种五步十步任务——是有真实折损的。别人的每秒六十个字是速度数据,不是质量结论。你拿量化版的跑分去对标官方全精度的能力,等于拿翻拍剧照对标原片票房。

    顺便说透量化这件事,因为它是本地派最常自我欺骗的地方。量化本质上是用更少的字节存每个权重:四比特大约是十六分之一的原始体积,代价是每个权重都带一点存储误差。闲聊时这点误差被上下文平滑掉,你感觉不到;但在长链路任务里,误差会累积——第一步工具调用的参数错一个字,第二步就基于错误结果继续走,第五步的失败你根本查不到源头是量化。这叫误差的复利。

    所以看量化报表要看两个数,不是只看体积省了多少:一看困惑度变化(模型整体还“懂不懂”语言),二看目标任务成功率(模型还“会不会干活”)。前者几乎不变,后者可能掉得吓人。社区里那些“量化后几乎无损”的结论,九成是用第一种测的。

    所以我的验收最后一关不是 tok/s,是任务成功率,方法笨到没法再笨:

    同一个五步真实任务,全精度版和量化版各跑二十遍,比成功率。

    为什么是二十遍?因为个位数抽样的噪音太大——成功率九成的模型,连挂三次的概率并不罕见,你会把好模型冤枉死;二十遍之后,成功率的置信区间收窄到正负一成左右,够做决策了。任务要选你军团真实干的活,不要选玩具题——玩具题测出来的是背书能力,不是干活能力。跑的时候温度、提示词、工具环境全部固定,只换模型,不然你比的不是模型是运气。

    速度达标、成功率掉太多,量化就没意义,换更轻的量化或者上攻坚层。速度慢一点但成功率稳,那才是真粮草。这套方法论也适用于选模型:新一代模型发布帖里那些漂亮的百分比,全部默认它是在全精度、理想提示词下跑出来的;你上机的第一件事不是复测跑分,是把你自己的五步任务跑二十遍。

    这也把军团问题推到了终点:跑分是绿灯,任务成功率才是复工。单成员的速度上限再高,二十遍成功率上不去,它在军团里就是个快嘴低能儿,故障率会顺着链路传染给所有依赖它的兄弟。

    四层后勤,一层都不能外包

    回头盘点一下这套东西的全貌:

    • 粮草层(算力):按带宽选型,低激活 MoE + 专家下沉 + MTP,本地底座承接军团日常,外部接口降级为攻坚装备;
    • 岔路层(fallback):备用链必须断路演练过才配叫备用链,配置改动自动降级重验;
    • 名册层(配置):钥匙单一真源,声明式下发,缺失拒启,生存必需品放本地盘;
    • 哨兵层(验收):三班哨兵,直连小探针,全链路覆盖,日哨含复工检查,外加二十遍任务成功率的量化验收。

    四层没有一层是模型能力,全部是工程。这也是我这次最大的认知更新:军团的天花板,从一开始就不写在模型发布帖里,写在你自己的后勤账本上。

    而且我要预先承认这套东西的反噬,免得它变成新的迷信:

    哨兵会误报,误报多了人会麻木,麻木的哨兵比没有哨兵更危险——所以报警必须分级、必须带上下文、必须可一键静默但要留痕。量化省钱省显存,但它伤长链路任务,你省下的每一分硬件钱都可能变成成功率里的暗账。本地化买回了主权,也把平台风险换成了硬件风险——一台机器现在绑着整支军团,它的硬盘、电源、散热都成了新的上游,冷启动演练一次都不能少。钥匙同步机制自己会成为新的单点,它坏的时候全员拒启,所以它自己也要有哨兵。

    每一层保险,都会生出新一层需要保险的东西。后勤线不是修完的,是永远在修的。

    回到那六十八分钟

    现在再看我发那句工单的傍晚。

    五点零一分,成员哑掉。绿灯亮着,没人知道。

    六点零九分,我派单。

    六点一十八分,修好。

    现在同样的事故重演一遍,剧本是这样的:小时哨上一轮探针已经证明全链健康;主路抖动发生,流量按演练过的路径掉进备用链——备用链有钥匙,因为名册层保证它和主路同源;任务完成,哨兵记录一次成功切换,第二天日报里出现一行“昨日主路抖动一次,自动切换,无人工介入”。

    我可能到晚上才看见这行字。

    或者根本不用看见。

    这就是后勤线全部的意义:不是让军团不出事,是让出事变成一件军团自己消化掉的小事,而不是一件等我发话的大事。

    那天有人问我:现在让你建一支 AI 军团,还难吗?

    当时的我大概会说:不难,容器一拉就是一个。

    现在的我会先反问四句:

    你的粮草算过除法吗?

    你的备用链断路演练过吗?

    你的钥匙有几份拷贝?

    你的哨兵直连吗?

    四问全答上来,军团才配叫军团。

    答不上来,你养的只是一群绿灯。

    我还想补最后一句。这四层后勤线,看起来全是给机器修的,其实每一条都在修人——修我这个当家的。

    粮草层的除法,逼我在下单买硬件之前先承认物理,不许用情怀骗预算。岔路层的演练,逼我把“应该没问题”这五个字从嘴里戒掉。名册层的单一真源,逼我承认自己手工复制钥匙的那天,就已经在给未来埋雷。哨兵层的直连,逼我承认那次两万 token 的体检不是系统的浪费,是我压根没算过账。

    六十八分钟之前,我以为军团的能力等于成员的智商。六十八分钟之后我才知道,军团的能力等于它的后勤,而后勤的上限,是当家人愿意把多少“下次再说”变成“这次就验”。

    机器不会自己变可靠。是人先可靠了,机器才有机会。

    最后,给你的军团留一张点名表

    如果你也在养一支 AI 军团,别先问模型榜单,先把下面这张表填完:

    • 每个成员的主链路是什么,备用链路是什么?
    • 主链失败时,备用链最近一次真实接住任务是什么时候?
    • 每把钥匙到底有几份,谁是真源,谁负责轮换?
    • 成员失能后,最迟多久能被机器发现?
    • 报警响起时,能不能直接看到成员、链路、错误和最近一次同类故障?
    • 整机断电重启后,成员能否在无人碰键盘的情况下全部复工?
    • 本地模型的速度是跑分,还是你的真实任务成功率?
    • 外部模型在你的架构里,到底是生命线,还是攻坚装备?

    这八个问题,如果有一个只能回答“应该可以”,那一项就还没有完成。 这张点名表还有一个用法:每次新增成员、换模型、换钥匙、改路由、升级镜像,都重新填一次。旧答案不能证明新配置,昨天的绿灯也不能替今天担保。真正能留下来的不是某次漂亮跑分,而是一套任何成员接手都能重复执行的验收动作。军团越大,这张表越不能靠人脑记;能写进机制的,不留给记性,能交给机器叫醒的,不等人偶然发现。

    所以,别把成员数量当规模,别把配置存在当可靠,也别把一次成功当长期有效。

    别相信绿灯。

    相信演练,相信点名,相信真实完成过的那一次任务。

    来源:https://x.com/dashen_wang/article/2091418843801694629

  • 一张被遗忘的矿卡,正在被重新发明:我最近折腾 NVIDIA CMP 170HX 的完整记录

    一张被遗忘的矿卡,正在被重新发明:我最近折腾 NVIDIA CMP 170HX 的完整记录

    这段时间我一直在折腾一张很奇怪的卡。

    NVIDIA CMP 170HX。

    它本来是一张几年前为了挖矿做出来的卡,二手市场上曾经便宜到几乎没人要。没有视频输出,没有正常消费级显卡的生态,PCIe 被限制,算力被限制,显存也被限制。

    如果故事停在这里,它大概最后的归宿就是电子垃圾。

    结果到了2026年,事情突然发生了变化。

    社区发现,这张所谓的矿卡里面,其实是一颗真正的 GA100。

    也就是 A100 那一代的核心。

    然后一群人开始一点一点把 NVIDIA 当年关掉的东西重新打开。

    算力打开了。

    PCIe Gen2打开了。

    显存打开了。

    8GB版本变成64GB。

    10GB版本变成40GB。

    更离谱的是,10GB版本甚至已经被证明可以真正访问到接近80GB的地址空间。

    于是,一张几年前几百块钱都没人要的矿卡,突然变成了2026年本地大模型圈子里最奇怪的一张AI卡。

    我最近基本就是围着这个东西在折腾。

    这篇文章,把目前我看到的、测到的,以及社区已经证明的东西全部整理一下。

    一、先把最容易搞错的一件事说清楚

    CMP 170HX目前主要有两个版本。

    8GB版,PCI ID 是 "10de:20c2"。

    10GB版,PCI ID 是 "10de:2082"。

    现在正式公开的 cmpunlocker 对应关系是:

    8GB → 64GB

    10GB → 40GB

    千万不要反过来。

    目前主线版本就是这个状态,而且已经可以同时解除SM计算限制、显存几何限制和PCIe Gen2限制。

    为什么会出现这么奇怪的结果?

    正常直觉应该是10GB版本比8GB版本更好,怎么反而8GB最后变64GB,而10GB只有40GB?

    答案藏在GA100的显存架构里面。

    二、它不是简单地把64GB或者80GB显存藏起来了

    网上现在很多说法把这个事情讲得过于简单。

    有人说 NVIDIA 当年在170HX上装了80GB显存,然后故意只给你10GB。

    严格来说,这个说法并不准确。

    GA100的Framebuffer由很多个FBPA内存分区组成。

    170HX 8GB版有:

    16个活动FBPA

    170HX 10GB版有:

    20个活动FBPA

    而两张卡出厂时,每个FBPA都只按照512MiB的容量档工作。

    所以:

    16 × 512MiB = 8GB

    20 × 512MiB = 10GB

    这就是它们原厂显存容量的来源。

    社区后来发现,决定这个容量档的一个关键寄存器是 "CFG1"。

    把8GB版本从512MiB/FBPA提高到4096MiB/FBPA:

    16 × 4GB = 64GB

    于是8G变64G。

    而10GB版本现在主线采用的是2048MiB/FBPA:

    20 × 2GB = 40GB

    于是10G变40G。

    真正疯狂的地方在下一步。

    GA100实际上还存在4096MiB × 20这个内存几何。

    也就是:

    20 × 4GB = 80GB。

    而这恰恰对应A100 80GB使用的那一级内存几何。

    所以理论上,170HX 10GB版本还有一扇门。

    10GB → 80GB。

    这也是现在整个社区最值得看的实验。

    三、80GB已经不是单纯的 nvidia-smi 假数字了

    图像

    最早的80GB实验其实有问题。

    当时有人确实让系统显示出了81920MiB,但是三个关键参数并不一致。

    CFG1按照80GB配置。

    driver又告诉系统有80GB。

    但LMR实际上还停留在40GB。

    结果就是:

    看起来80GB。

    实际上40GB以上发生地址折叠或者崩溃。

    这也是为什么早期很多人说170HX的80GB是假显存。

    这个判断在当时并没有错。

    但后来实验往前走了一步。

    社区重新做了一套 coherent 80GB 配置:

    "CFG1 = 0x02779000"

    "LMR = 0x0000028B"

    两者都明确指向80GB。

    然后不是只看nvidia-smi,而是直接进行dense tagged write/readback。

    结果:

    77.5GiB范围,310个测试块,310/310正确。

    没有发现40GB地址折叠。

    后来另一轮实验使用stock boot timing,也真正访问到了72GiB。

    这个结果非常重要。

    因为它基本否定了一个简单解释:

    10G卡根本不存在40GB以上的真实地址空间。

    至少目前来看,不是这样。

    那些地址确实可以被写入。

    而且数据能够正确读回来。

    所以10G→80G现在真正的问题已经从:

    有没有这些显存

    变成了:

    这些显存能不能稳定作为CUDA生产显存长期工作。

    这是完全不同的问题。

    四、80GB现在真正卡在哪里

    目前还不能宣布10G已经成功解锁80GB。

    原因很简单。

    它不稳定。

    coherent 80GB实验目前最大的几个问题是:

    • 大约一个CUDA context之后可能出现Xid 154。
    • 40GB以上区域的带宽大约只有正常峰值的79%。
    • 最顶部大约2GiB还没有完成充分验证。
    • 真正完成这一实验的操作者数量也非常少。

    而且目前还没有把coherent 80GB方案做成一个普通用户可以安装的稳定driver路径。

    所以我现在对10G版本的定义一直没有变。

    40GB是产品。

    80GB是彩票。

    卖家如果因为能显示80GB就按80GB卡给你报价,我认为完全没有必要买单。

    因为显示80GB和连续运行vLLM三天不掉卡,这是两个世界。

    五、最近又发现了一个特别重要的40GB稳定性问题

    这也是我最近一直盯GitHub的原因。

    8月19日,cmpunlocker出现了一个非常值得关注的PR:

    PR 32

    cmpunlocker PR 32:WPR2 reserved region 修复

    问题和WPR2有关。

    简单解释就是,unlocker之前把显存顶部的一块reserved region错误地重新交给了显存分配器。

    但是那块区域根本不是空闲显存。

    里面住着GSP firmware和heap。

    在10G→40GB卡上,大约涉及139MiB。

    平时可能完全感觉不到。

    为什么?

    因为PMA首先使用正常显存池。

    只有当显存快被吃完的时候,才会跑到那块区域。

    这就解释了一个非常奇怪的现象。

    很多170HX平时运行完全正常。

    模型也正常。

    CUDA也正常。

    但是把显存打到90%以上甚至接近满的时候,突然:

    Xid 31。

    REGION_VIOLATION。

    cudaErrorIllegalAddress。

    然后scrub卡死。

    最后Xid 154。

    整个GPU只能重启。

    10G→40GB卡已经真实出现过这个问题,包括LoRA weight patch过程中出错。

    PR 32做的事情其实很简单。

    不要把这块WPR2区域交给PMA。

    修完以后,再做极限测试。

    有人直接:

    cudaMalloc一直分配。

    然后对每一块内存cudaMemset。

    直到显存只剩5.4MiB。

    结果:

    0 Xid。

    0 scrub fault。

    CUDA仍然正常。

    而且这个问题后来在8G→64GB版本也被复现并验证了修复。

    这件事情对我来说反而是利好。

    因为最怕的是硬件随机坏。

    如果是HBM随机不稳定,那几乎无解。

    现在至少这个故障已经被定位到非常具体的内存区域管理bug,而且修复逻辑非常明确。

    截至我写这篇文章的时候,PR 32仍然处于Open状态,还没有正式进入master。

    所以目前我的判断是:

    40GB已经很好用,但在PR 32正式合并之前,我不会把10G→40GB称为完全稳定版。

    六、验证工具自己甚至也踩了一个坑

    同一天还有PR 33。

    cmpunlocker PR 33:多卡验证修复

    这个问题更加有意思。

    以前有人跑完unlock以后执行 "verify 脚本"。

    显示成功。

    大家自然认为所有卡都成功了。

    后来发现,如果你安装unlocker以后又往机器里加了170HX,旧版本verify可能继续读取安装时候记录的GPU inventory。

    结果:

    机器里明明有3张170HX。

    它只验证其中1张。

    最后依然告诉你:

    全部成功。

    更麻烦的是,一些Ubuntu或者Debian环境默认禁止普通用户读取dmesg,脚本还可能把没有权限读取日志误认为日志不存在。

    所以以后看170HX实测,我已经不太相信一句:

    verify passed。

    真正可信的测试应该至少包括:

    • 逐卡PCI ID。
    • 实际memory total 字段。
    • CFG1/LMR。
    • dense fold test。
    • CUDA真实allocate/write/read。
    • 长时间serving。
    • Xid日志。

    如果是多卡,更应该逐张检查。

    这也是这段时间玩170HX以后,我越来越强烈的一个感觉:

    这个项目现在已经不能靠截图判断真假了。

    七、真正让我开始认真看这张卡的,是大模型实测

    图像

    破解显存本身很好玩。

    但如果只是nvidia-smi多显示几十GB,我不会这么兴奋。

    真正改变我判断的,是这张卡开始跑新一代大模型了。

    尤其是Qwen3.8-27B。

    我自己第一轮测试,大约跑到了:

    70 tokens/s左右。

    而且当时还没有怎么优化。

    这已经让我觉得它有意思了。

    后来社区公开数据越来越多。

    有人使用单张8G→64GB的170HX,在vLLM里运行:

    "Qwen3.8-27B-SmoothQuant-W8A8-INT8"

    BF16 KV。

    MTP=3。

    没有进行特别深的优化,就跑出了:

    约1500 tok/s prefill

    95~103 tok/s decode。

    这已经不是能不能跑的问题了。

    这是一个正常可用的本地27B AI服务器速度。

    另外还有一套特别有意思的配置。

    Strix Halo主机。

    CMP 170HX通过USB4 eGPU连接。

    vLLM。

    Qwen3.8-27B INT8 W8A16。

    MTP3。

    262K最大上下文。

    结果单stream:

    3000~4000 tok/s prefill

    40~60 tok/s generation。

    而且测试者称context增加以后,对decode速度影响并不大。

    注意。

    这是USB4外接一张几年前的矿卡。

    事情发展到这个程度,本身已经很荒诞了。

    八、但单用户100 tok/s还不是170HX真正有意思的地方

    很多人看本地模型,只看一个数字:

    tokens/s。

    然后拿170HX和5090比较。

    我现在觉得这种比较越来越没有意义。

    因为真正做Agent或者AI服务的时候,你面对的不是:

    一个人问一句话。

    而是:

    Agent A调用模型。

    Agent B同时调用模型。

    工具返回以后再次调用。

    后台任务调用。

    前端用户调用。

    定时任务调用。

    这时候真正重要的是:

    continuous batching。

    aggregate throughput。

    而170HX最近开始出现真正的serving数据了。

    例如公开的SGLang Qwen3.6-27B W8A8测试。

    10G→40GB版本,在最大并发4、MTP开启的时候:

    2048 input / 512 output:

    222.57 output tok/s aggregate

    2048 / 1024:

    254.04 tok/s

    2048 / 2048:

    269.31 tok/s。

    8G→64GB版本则更夸张。

    相同类型测试:

    2048 / 512:

    308.74 tok/s

    2048 / 1024:

    367.00 tok/s

    2048 / 2048:

    382.14 tok/s aggregate。

    当然,这两个测试环境不是严格意义上的只改变显存容量A/B,所以不能直接得出8G硬件一定比10G快40%。

    但它至少证明了一件事情。

    170HX完全有能力做多用户LLM serving。

    这和我一开始判断这张卡的逻辑已经完全不同了。

    九、甚至已经有人开始做长时间并发稳定性

    还有一个我非常喜欢的项目叫170tune。

    它有一个理念我特别认同:

    Benchmark跑完,不代表这张卡是稳定的。

    因为GPU最可怕的故障不是crash。

    而是:

    程序正常结束。

    没有Xid。

    没有报错。

    但是算出来的数据错了。

    所以170tune里面有完整的full-VRAM pattern sweep、bit-exact GEMM、温度gate和真实workload qualification。

    他们拿解锁64GB的170HX跑vLLM。

    并发16的时候:

    204.87 tok/s aggregate

    TTFT约795ms。

    功耗约157W。

    128个请求全部完成。

    再继续优化以后,并发24:

    298.9 tok/s decode aggregate

    2744 tok/s prefill

    TTFT约481ms。

    功耗约170W。

    最关键的是:

    后来继续跑了31分钟。

    3552个请求。

    0失败。

    吞吐波动控制在0.6%以内。

    HBM稳定在68℃。

    这类数据对我的价值,比再多一个nvidia-smi 64GB截图高一百倍。

    因为这说明它正在从:

    破解玩具

    走向:

    服务器设备。

    十、这张卡真正麻烦的,其实是散热

    170HX是被动散热卡。

    它原本就是设计给服务器风道的。

    放进普通PC机箱里,是完全另外一回事。

    社区已经有人报告,散热不好的170HX一分钟左右就冲到85℃,然后开始严重降频;换成正确的强风道以后,250W运行也有人能控制在67℃附近。

    170tune的测试更加说明温度的重要性。

    HBM超频在冷状态下测试通过,热起来以后可能直接出现数据错误。

    他们最终甚至明确要求:

    真实serving qualification必须热测。

    不能因为cold benchmark过了就宣布稳定。

    所以我以后如果正式把170HX作为生产服务用,我会把这几件事情当成一个整体:

    • GPU温度。
    • HBM温度。
    • 风量。
    • 功耗限制。
    • 显存完整性。
    • Xid。
    • serving错误率。

    不能只盯核心温度。

    十一、PCIe也是一个很有意思的问题

    170HX原厂PCIe非常残。

    软件现在已经可以把它从Gen1 x4提升到:

    PCIe Gen2 x4。

    这个已经进入公开unlocker。

    但注意:

    Gen2和x4是两个东西。

    PCIe代际可以通过软件解锁。

    位宽不行。

    PCB上为了限制这张卡,部分PCIe lane相关元件本身就被删掉了。

    社区确实做过物理补电容以后Gen2 x16的实验,而且观察到6.6GB/s左右传输,但这不是普通用户一条命令可以打开的功能。

    所以多卡170HX不能简单想象成:

    插四张就等于四张A100。

    模型如果频繁跨GPU通信,PCIe会成为一个非常现实的问题。

    但如果是一张卡跑一个完整模型,或者不同GPU分别跑不同服务,这个问题就小很多。

    我反而觉得这才是170HX最舒服的玩法。

    不要硬凑Tensor Parallel。

    把每张64GB卡当成一个独立AI节点。

    十二、8G和10G,我现在的判断越来越明确

    如果今天让我重新评价这两个版本,我会这么说。

    8G版本

    这是价值已经兑现的版本。

    8GB → 64GB。

    大量复现。

    Qwen。

    vLLM。

    SGLang。

    ComfyUI。

    都已经开始出现真实数据。

    风险当然仍然存在,尤其是unlock driver、散热和硬件老化。

    但它已经不是单纯买彩票。

    64GB是真的产品能力。

    10G版本

    这张卡反而更有意思。

    因为现在正式能力只有:

    40GB。

    如果故事停在40GB,我认为它的价值其实低于8G→64GB版本。

    但是它拥有那个非常特殊的80GB可能性。

    所以我一直把它看成:

    一张40GB GPU + 一张免费的80GB期权。

    如果最后80GB失败。

    你还有40GB。

    如果80GB成功。

    整张卡会被重新定价。

    十三、而且我现在甚至不执着于一定要80GB

    这是我最近想法变化比较大的地方。

    假设80GB顶部的一些区域确实很难稳定。

    那为什么一定要80?

    60GB行不行?

    64GB行不行?

    72GB行不行?

    目前文档已经明确提到,10G版本要做48/56/60/64这样的中间档,不能单纯依靠CFG1,因为per-FBPA tier是粗粒度的。

    但理论上可以:

    CFG1保持80GB级别。

    然后通过driver-visible size和PMA region限制真正开放的容量。

    比如最终发现:

    0~68GB百分之百稳定。

    68~80GB存在问题。

    那我根本不需要80GB。

    直接做一个:

    10G → 64GB stable profile

    对实际用户来说,价值可能比一个经常Xid 154的80GB高得多。

    我甚至觉得这可能是10G版本最终真正的突破口。

    十四、价格已经开始脱离矿卡逻辑

    最荒诞的一幕其实已经发生了。

    以前170HX就是矿难垃圾。

    后来unlock公开以后,市场开始疯狂重新定价。

    Tom's Hardware最新报道提到,原来大约250美元级别的CMP 170HX,在unlock消息传播以后已经被推到了1000美元以上。

    社区里也已经有人遇到:

    谈好价。

    付款。

    卖家突然发现170HX涨价。

    然后要求买家退款,再用接近两倍价格重新买。

    所以现在买170HX已经不能再按照捡垃圾的逻辑看了。

    以前买的是废矿卡。

    今天买的是:

    GA100。

    大容量HBM。

    Linux推理节点。

    以及未来unlock进度。

    这几样东西叠加起来,市场肯定会重新定价。

    十五、我对未来价格的判断

    这是判断,不是事实。

    如果8G→64GB继续稳定,而且Qwen3.8这一代模型持续有人跑到100 tok/s上下,再加上多用户serving不断出现成熟数据,我认为8G版会逐渐形成一个比较明确的二手AI硬件价格锚。

    但它不会无限涨。

    因为价格涨到一定程度以后,R9700、3090多卡、5090、专业卡甚至其他二手数据中心GPU都会进入比较范围。

    170HX最大的优势,从来都不是它是一张A100。

    它不是A100。

    它最大的优势是:

    以一个非常奇怪的价格,拿到GA100 + 64GB HBM。

    价格越高,这个优势越弱。

    10G则不同。

    如果只能40GB,我认为长期应该明显低于8G版。

    但如果未来出现:

    80GB stable driver。

    70GB以上真实模型加载。

    连续多个CUDA context。

    24小时以上vLLM/SGLang。

    0 Xid。

    完整VRAM integrity test。

    那它会发生第二次重新定价。

    那时候10G反过来比8G贵,我一点都不会意外。

    十六、我现在真正盯的已经不是80GB三个字

    我已经专门把这条线做成持续监控了。

    现在我盯的东西包括:

    10G→80GB coherent driver。

    PR 32 WPR2修复什么时候进入master。

    PR 33验证工具修复。

    新的stable release。

    Xid 31。

    Xid 154。

    显存地址折叠。

    silent memory corruption。

    不同10G硬件批次。

    HBM差异。

    vLLM稳定性。

    SGLang稳定性。

    CUDA context数量。

    长上下文。

    并发吞吐。

    功耗。

    温度。

    PCIe。

    甚至二手价格和卖家宣传。

    因为到了这个阶段,任何一个细节都可能直接改变这张卡的估值。

    截至本文写作时,主仓库仍然显示两个Open PR,也就是PR 32和PR 33。主线公开能力仍然明确写着:

    8GB → 64GB。

    10GB → 40GB。

    PCIe Gen2。

    这就是我目前认为最应该相信的基线。

    项目地址:

    cmpunlocker 官方仓库

    170tune:

    170tune 官方仓库

    技术资料我也非常建议看社区整理的CMP 170HX Wiki,其中把显存几何、Falcon、GA100、PCIe以及大量失败实验都整理得非常完整。

    十七、接下来,轮到我自己加入80GB这场实验了

    现在我人在外地。

    卡已经可以装上。

    等我回去以后,大概两三天,我准备正式加入10G→80GB这一条实验线。

    但我不会把目标定成:

    让nvidia-smi显示80GB。

    那个阶段已经没有意义了。

    我真正想验证的是:

    • 80GB能不能跑真实模型。
    • 能不能连续创建CUDA context。
    • 40GB以上显存真实带宽是多少。
    • 显存打到70GB以后会不会Xid。
    • vLLM能不能连续serving。
    • SGLang能不能跑并发。
    • 长上下文到底能推到哪里。

    如果80GB不稳定,就继续往下找:

    72GB。

    64GB。

    60GB。

    最终找到一条真正能长期工作的边界。

    我觉得这才是10G版真正值得做的事情。

    十八、最后说一点我最近最大的感受

    玩170HX这件事情,最开始其实非常简单。

    就是觉得好玩。

    一张几年前的矿卡,居然还能破解。

    然后慢慢看资料。

    看寄存器。

    看GA100。

    看HBM。

    看Falcon。

    看GSP。

    看CUDA。

    看vLLM。

    看SGLang。

    最后突然发现,这件事情已经不只是破解一张显卡了。

    它其实把现代GPU工业里一个很少有人真正接触到的东西暴露了出来。

    我们平常买一张GPU,会觉得:

    64GB就是64GB。

    10GB就是10GB。

    算力就是参数表里的算力。

    PCIe就是参数表里的PCIe。

    但是170HX告诉你:

    有时候并不是这样。

    芯片真正拥有什么。

    厂商允许你使用什么。

    驱动告诉操作系统什么。

    产品经理决定卖给你什么。

    这是四件不同的事情。

    170HX最迷人的地方,就在这里。

    2021年 NVIDIA 看着这颗GA100,说:

    这是一张10GB矿卡。

    2026年一群人把它拆开以后说:

    不对。

    这里还有东西。

    然后一层一层把门打开。

    10GB。

    40GB。

    64GB。

    80GB。

    Gen2。

    完整算力。

    然后把Qwen3.8放进去。

    100 tokens/s。

    再接vLLM。

    再跑几十个并发请求。

    事情突然就变得非常赛博朋克。

    所以我现在对170HX的态度依然是:

    不要神化它。

    它不是A100。

    没有官方支持。

    驱动是patch的。

    Secure Boot要关。

    PCIe残废。

    NVLink现在也没有。

    ECC也还没有恢复。

    散热非常折腾。

    甚至有些问题可能永远解决不了。

    但是也不要低估它。

    因为一张原本已经被整个市场判死刑的矿卡,现在正在重新变成一台AI服务器。

    而且这个故事,还没有结束。

    尤其是那张10G版。

    40GB已经在手里。

    80GB的门,也已经被推开了一条缝。

    接下来要做的,就是看看门后面的东西,到底能不能真正拿出来用。

    来源:https://x.com/dashen_wang/article/2090713829462458699

  • 给你的AI员工一台可用的手机(上):先让它看见,再让它动手

    给你的AI员工一台可用的手机(上):先让它看见,再让它动手

    先把那句蠢话收回去

    “给 AI 员工一台手机,它就能替你上班。”

    这句话很适合放在发布会的大屏幕上。字体要大。背景要黑。旁边站一个穿西装的人,手里拿着遥控器,像是刚把硅基生命从培养皿里放出来。

    然后他演示:模型看一眼聊天软件,点两下,复制一段话,打开另一个应用,填进表格。掌声来了。评论区开始写“一个人就是一家公司”。有人已经在算自己还要不要招客服、运营、助理。

    别急。

    它会点屏幕,和它能替你上班,中间隔着一整间公司。

    会点,不等于看见。看见,不等于理解。理解,不等于判断。判断,也不等于有资格把后果按下去。

    一台手机接到模型上,首先得到的不是员工。

    你得到的是一具执行身体。

    它有眼睛:截图、录屏、无障碍树、相机、通知、网页里的文字。它有手:点击、滑动、输入、返回、打开应用、提交一个已经被允许提交的东西。它甚至有一点腿:可以从一个应用走到另一个应用,从一个页面走到下一个页面。

    但它没有天然的职位。

    职位不是一串工具调用。职位包含目标、权限、例外、交接、考核、责任和终止权。一个财务能不能付款,不取决于她会不会点“确认”;取决于谁给了她额度,什么单据算完整,异常由谁复核,钱错了谁去银行、去法院、去解释。一个运营能不能发内容,也不取决于他会不会按发布;取决于品牌边界、事实核验、排期、平台规则,以及一句话发出去以后谁背它。

    手机解决的,只是最后一厘米。

    过去模型住在文字框里。它能建议,能写,能分类,能把一个复杂问题说得像已经解决。可一到现实就断了:屏幕在另一边,验证码在另一边,现场软件在另一边,那个只有人类手机应用才有入口的流程也在另一边。

    给它手机,是把这堵玻璃拆掉。

    不是把责任拆掉。

    这篇只讲上半件事:怎样把“看屏幕”和“点屏幕”放进一套能检查的结构。不是教你把一百台设备排成兵马俑,也不是教你绕开任何平台、人脸、支付、账户或风控。那些东西不是技术炫技,是别人账户、别人钱、别人生活上的洞。别把洞叫成自动化。

    下篇会给一份完整的、仅限设备所有者或明确授权者使用的部署手册:怎样把一台可控的设备接入观察、动作、日志和人工审批。但先别急着拿工具。先把工具应该服从什么讲清楚。

    因为 root 不会生出判断。

    多一根数据线,也不会。

    一、手机不是员工,它是执行身体

    人类一直喜欢把新工具拟人化。

    电话刚普及时,人们觉得自己有了分身。电脑进入办公室时,人们说它是电子秘书。智能手机出现后,很多人以为口袋里住了一个助理。现在模型能说完整的句子,能把一份表格读得像真的看懂,大家干脆跳到最后:员工。

    这个跳跃很省事。

    它也很危险。

    工具没有人格,当然不必替它安排人格。问题是,拟人化会把一堆本来必须写清楚的边界,用一个漂亮词掩过去。你说“员工”,听起来就像它知道什么时候该停、该问、该承认不知道、该把麻烦交给上级。可模型和手机的组合并没有这些东西。它只有当前可见的状态、你给的上下文、可调用的动作,以及一个生成下一个动作的概率分布。

    它不是在“上班”。

    它在执行。

    执行身体这个说法更难听,但更准确。身体没有天然目的。手能递水,也能把杯子摔碎;眼睛能看合同,也能看错金额;腿能走进会议室,也能走错门。目的和边界来自外部:谁在控制,什么算任务完成,什么时候不得继续,错误发生后怎样回到安全处。

    把 AI 放进手机,发生的是同一件事。模型从纯语言空间,获得了一个能对真实界面造成影响的末端执行器。它看到了过去只在人眼里的像素;它能触到过去只能由手指触到的控件;它能在应用之间来回。这确实是能力跃迁。别假装它不重要。

    但能力跃迁不是组织跃迁。

    一台叉车能举起一吨货,不等于它是仓库主管。一台打印机能把合同打出来,不等于它懂合同。一套能点击手机的智能体能走完一个流程,不等于它拥有流程的判断权。

    真正的员工系统,至少有六个层:

    1. 任务从哪里来,谁有权创建。
    2. 当前事实是什么,系统凭什么相信。
    3. 它可以做哪些动作,哪些动作永远不做。
    4. 它如何记住已经做过什么,避免重复和漂移。
    5. 谁能验收,什么证据算完成。
    6. 出事时谁能叫停,谁承担后果。

    手机只碰到第三层的一部分,也参与第二层的一部分。它不是六层的替代品。

    这一区分有一个很实际的测试。

    把网络断掉,把模型换掉,把某个页面改版,把通知延迟十分钟,问系统还能不能说清:现在在什么状态,为什么刚才点了那里,下一步要等谁,若失败怎么退回?如果回答只是“模型会自己判断”,那不是系统。那是一段演示录像还没来得及遇到坏天气。

    二、观察不是判断:像素没有立场

    很多人第一次看到视觉模型读手机截图,会误以为“它终于看懂了现实”。

    它当然能看出很多东西。按钮在哪里。订单显示什么。弹窗有没有出现。一个表单是空还是满。页面像不像登录页。屏幕上的字能不能读出来。

    这已经很有用。

    但有用和可靠之间,不该由兴奋来填。

    一张截图给出的,是观察。观察是对屏幕某一刻的描述:有一个红色按钮;标题像是“提交”;右上角有数字;弹窗遮住了输入框;页面也许在加载。观察可以带置信度,可以和上一次截图比较,可以由多个识别器交叉核对。

    判断不是这个。

    判断是:这个“提交”是否应该点;这个数字是否意味着可以继续;弹窗是不是风险提示;此刻是不是仍然属于原来的任务;这条消息是不是该回复;这个结果能不能被接受。

    前者可以被机器部分外包。

    后者必须被约束、被授权、被验收。

    不要拿“模型也会思考”糊弄这条线。模型可以给出判断建议,甚至在重复、低风险、标准明确的场景里给出足够好的判断。但建议能不能变成动作,取决于它是否落在一个预先定义的允许区间。不是因为人类更神秘。是因为后果不会自动从模型的输出里长出承担者。

    一个简单例子:屏幕上有“继续”。视觉模型几乎肯定能认出来。

    可“继续”后面可能是浏览商品,也可能是提交申请,也可能是删除草稿,也可能是向某个人发送一段错误信息。文字相同,后果不同。像素相同,权限不同。你若只把截图交给模型,让它凭语义决定,等于把一扇门的名字当成了门后面的房间。

    所以观察层应该只说自己看见了什么,不替组织下结论。

    一个干净的观察结果,长这样:

    text

    时间:10:42:13
    前台应用:已识别为任务允许的应用之一
    可见元素:标题、返回、文本输入区、主按钮
    主按钮文字:继续
    遮挡:无
    页面与预期状态的相似度:0.81
    不确定项:右上角状态标记无法确认

    它不该偷偷多写一句:“因此可以点击继续。”

    那句话属于决策层。

    把这两层分开,系统才有机会被审计。出了问题,你能问:眼睛看错了,还是规则给错了,还是授权太宽,还是人在不该放行的时候放了行。若观察和判断搅在一起,最后只剩一句最没用的话:AI 搞错了。

    AI 没有搞错。

    是你把四种错误塞进一个黑箱,然后给黑箱接了手指。

    三、黑屏不是故障的结论,是现场的一部分

    我用过第一代 Surface Duo。

    它最像一块未来遗物。两块屏幕,中间一条铰链。打开时像把一张纸折出新的平面;合上时,它把外面的世界关掉。产品介绍里,这叫双屏、折叠、效率、多任务。落到真实使用,首先是一件很朴素的事:它会合起来。

    电脑上的镜像也会黑。

    你坐在桌前,看着原本还活着的画面突然没了。不是模型变笨,不是数据线瞬间背叛,不是你的自动化框架被宇宙取消。只是手机物理闭合。屏幕不再给你看。镜像端也只能诚实地黑下去。

    这一幕比很多宏大演示更有价值。

    因为它把“AI 有视觉”这句广告词,压回了一个可测试的边界:视觉依赖传感器;传感器依赖设备状态;设备状态会被铰链、电量、锁屏、系统弹窗、线缆、前台应用、显示策略改变。

    没有哪个模型能从一张黑图里推理出“它应该继续工作”。

    它也不该。

    黑屏不是死刑。黑屏是一个状态。一个好的系统要把它写成状态,而不是把它当作恼人的例外。

    比如:

    text

    观察不到有效画面
    → 停止任何可能改变外部状态的点击
    → 记录最近一次已确认状态与时间
    → 尝试仅限本机、可逆的恢复检查
    → 恢复不了,转人工
    → 人工确认设备可见后,重新观察,不从旧画面盲接

    这里没有神秘技术。重点是最后一句:重新观察。

    自动化最常见的幻觉,不是模型胡说八道,是系统还拿着上一秒的世界当现在。页面已经变了,弹窗已经盖住了,手机已经锁了,网络已经掉了,任务已经被人取消了。执行器却继续按旧剧本按下去。

    人类操作手机时,也会犯这个错。开会分神,手指把一个熟悉位置当成原来的按钮;应用升级后,确认和取消换了边;你以为自己在回复 A,实际上打开了 B。区别在于,人类大多会被迟疑、困惑、眼睛重新聚焦这些很慢的东西拦一下。

    机器没有这种迟疑。

    它只会快。

    所以要人为给它加一个停顿:每次动作之后,重新看。每次状态异常,重新看。每次进入不可逆节点,重新看。不是为了让它显得谨慎,而是为了让“它此刻面对什么”成为一条有证据的事实。

    Surface Duo 合上以后,镜像黑了。最正确的动作不是疯狂重连,不是让模型猜屏幕背后发生了什么,更不是把点击队列继续吐出去。

    最正确的动作是承认:我现在看不见。

    能承认看不见,系统才有资格谈下一步。

    四、“No command”不是墙,是入口

    还有一类现场,比黑屏更容易把人骗住。

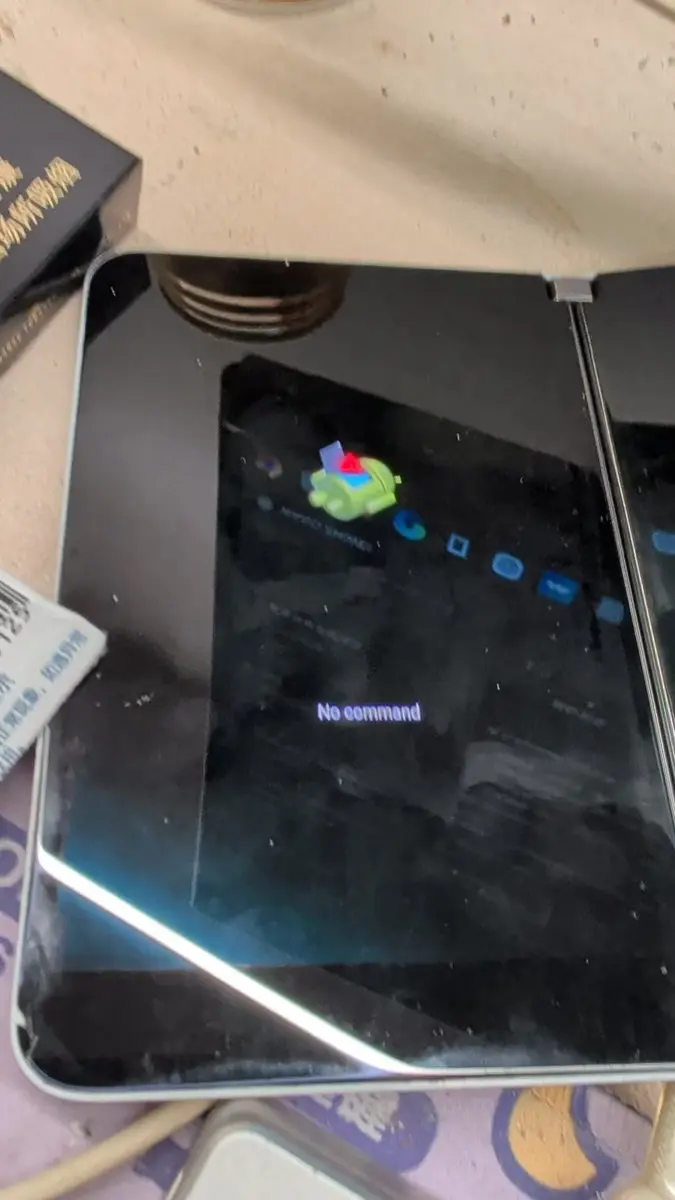
    设备进了 Recovery。屏幕上出现 Android 和一行字:No command。

    第一次看见的人会以为它死了。没有菜单,没有明显按钮,没有说明。像一扇写着“无命令”的门。很多教程最喜欢在这里堆出一大串按键组合、分区名字、神秘命令。读者照着按,设备状态从“我不知道”迅速变成“我更不知道”。

    先把这个画面看对。

    “No command”不是一个结论。

    它通常是恢复环境的一个入口提示。它告诉你,当前设备没有处在正常用户界面;它没有说“任何下一步都安全”,更没有授予你对里面数据和账户的无限处置权。你需要做的不是把它当成闯关提示,而是识别状态、确认设备归属、确认恢复目标,然后按设备厂商与授权范围选择最小的下一步。

    图像

    这个细节和 AI 手机有什么关系?关系很大。

    一个只会识字的系统看见“No command”,可能给出一段很像专家的解释。一个能被用于生产的系统必须先问:这是哪一台受授权设备?它的身份是否确认?它有没有未备份的业务数据?当前任务是不是允许进入恢复步骤?这一步会不会清除、修改、脱离原账户?谁有权批准?

    这就是判断的实体。

    它不住在模型的参数里。它住在操作前的事实清单和权限边界里。

    “No command”之所以有意思,是因为它把一个常见误解掀开了:人们以为掌握更多工具,就离解决更近。其实工具越多,错误路径也越多。你会进恢复,不代表你知道该恢复什么。你拿到 root,不代表你知道什么不该动。你能读到系统日志,不代表你有权用日志里的信息做决定。

    技术人员最容易在这里自恋。

    他把“我能进去”误认为“我应该进去”。

    两句话中间隔着授权。

    这不是道德装饰。这是工程边界。没有授权,任何恢复动作都缺少业务目标;没有业务目标,所谓修复就只能按技术人的想象替别人做决定。最后即使设备启动了,也可能已经毁掉了真正重要的东西:证据、数据、账户关系、客户信任。

    因此,在 AI 系统里,恢复状态不是“故障自动修复”的游乐场。它应该是一个显式升级点:机器可以报告自己看到了什么,可以保存证据,可以停止进一步动作,可以提示需要哪个角色介入。它不能靠“尽量帮忙”越过那条线。

    工具不会创造判断。

    它只会把没有判断的人送得更远。

    五、真正的单位不是一条指令,是一个闭环

    给模型一张截图,再让它返回一个点击坐标。这很酷。

    但它只是一个瞬间。

    工作不是瞬间。工作是一串状态变化。你看见一页,做一个动作,现实变了,再看一页。中间可能成功、失败、加载、跳转、弹窗、超时、被人接管、被系统打断。任何一个节点都可能让原来的计划失效。

    所以能用的单位不是“截图到动作”。

    是闭环:

    mermaid

    flowchart LR
        A[观察:截图与可用界面信息] --> B[状态估计:现在可能在哪]
        B --> C{是否足够确定且被授权}
        C -- 否 --> H[停下:记录证据并请求人工]
        C -- 是 --> D[选择一个最小、可撤回的动作]
        D --> E[执行:点击、输入、等待或返回]
        E --> F[再次观察]
        F --> G{结果符合预期吗}
        G -- 是 --> B
        G -- 否 --> H

    这张图没有魔法。

    它只强迫系统做一件人类会自然做、机器必须被要求做的事:动作之后看结果。

    如果没有最后那张截图,你根本不知道刚才发生了什么。你只知道系统发出了一个动作。发出动作不是完成。网络请求发出不是付款成功,按下发送不是对方收到,点击保存不是数据已经落盘,打开页面不是身份仍然有效。

    “截图→模型→动作→截图”这四步,是手机执行体最低限度的呼吸。

    第一张截图不是为了给模型找按钮。它是为了建立此刻世界的证据。模型不是必须输出坐标,也可以输出“我不知道”“页面不匹配”“需要人看”。动作不是必须点击,也可以是等待、返回、关闭输入法、停止任务。第二张截图不是为了做演示回放,它是为了验证动作有没有把世界带到预期位置。

    你若把第二张截图删掉,系统就从闭环退回了投掷。

    向屏幕扔一个动作,希望它落在对的地方。

    而且闭环必须小。一个动作一观察,最多把几个确定的、低风险的微动作合并。不要让模型在看一眼开头后,连走二十步再回来汇报。那不是自主性,那是把二十次未知叠成一次事故。

    有些人会嫌慢。

    慢是代价。错一次更慢。

    更准确地说,闭环不是固定按秒数慢,而是把速度交给确定性。状态很稳定、界面能机器验证、动作可撤回,步子可以短促。页面异常、信息敏感、动作不可逆,步子必须缩小,直到停下来。速度不是机器的美德。合适的速度才是。

    六、状态:别让系统活在上一张截图里

    手机上的每一个任务,首先不是一段自然语言,而是状态机。

    这句话会让一些人失望。大家希望模型出现以后,状态机这些旧东西可以退休。可现实恰好相反:模型越会说,外部状态越要写清楚。语言可以模糊,付款、发送、删除、提交、跳转和退出不能模糊。

    状态不是“页面一”“页面二”这么浅。它至少包含四类信息。

    第一类是任务状态:任务是谁创建的,目标是什么,是否仍有效,何时过期,谁可以取消。一个半小时前让系统处理的事情,到现在还该不该继续,不能由模型凭上下文长度猜。

    第二类是设备状态:屏幕是否可见,应用是否在前台,设备是否锁定,网络是否正常,是否被人接管,是否出现系统级弹窗。Surface Duo 合上后镜像黑掉,就是设备状态改变。它不是“模型没识别到按钮”。

    第三类是流程状态:已经观察到哪个节点,上一次已确认动作是什么,预期的下一种画面是什么,已经重试几次,是否跨过了审批门。流程状态应该能让另一个人接手,而不是只能靠一段漫长对话猜回去。

    第四类是风险状态:当前动作会不会对外发送、产生费用、改变权限、覆盖数据、暴露敏感信息;风险是否已被某个拥有权限的人接受。风险不是一句“谨慎一点”。它是一个字段。

    把这些写出来以后,模型的位置才清楚:它是状态解释器和候选动作生成器,不是状态本身。

    状态应该存在模型外面。

    为什么?因为模型会忘,会误读,会因提示词变化给出不同说法。更重要的是,模型没有资格单方面改写事实。系统要能回答“谁在什么时候把任务从待确认改成已完成”,不能只回答“模型在一段回复里说它已经完成”。

    一个最小任务记录可以没有多漂亮:

    text

    任务编号:唯一
    创建者:唯一
    允许目标:明确
    当前状态:等待观察 / 等待批准 / 执行中 / 已暂停 / 已完成 / 已拒绝
    最后证据:截图或界面摘要的时间与校验
    最后动作:谁批准、执行什么、结果如何
    下一步条件:必须看见什么,或必须得到谁的批准
    停止条件:看不见、页面不匹配、超时、权限不足、风险升级

    这比一段“你是一个聪明的手机助理,请自主完成任务”的提示词丑多了。

    也管用得多。

    状态的另一个用处,是防止重复。手机网络不稳定时,提交按钮点了没有、服务器收没收到、页面只是卡住还是已经跳转,常常很难立刻确认。若系统只知道“我刚才好像没看到成功页”,它就会再点一次。于是你得到两条消息、两份申请、两次预约,或者更糟的重复动作。

    正确做法不是保证永不出错。保证不了。

    正确做法是:不确定时,不把“没看见成功”解释成“肯定没成功”。进入待核对状态,收集额外证据,必要时让人确认。机器最应该学会的一句话,不是“我已完成”。是“我无法证明是否已完成”。

    七、权限:手伸得多远,责任就跟到多远

    很多人给智能体加权限,像给游戏角色加装备。

    能读屏了。再给输入。能输入了。再给通知。能通知了。再给文件。能打开文件了。再给系统设置。最后一看,模型差不多已经能摸到所有东西。然后他们说:终于像员工了。

    不像。

    这像把办公室每把钥匙串在一个实习生腰上,再夸他行动力强。

    权限不是能力列表。权限是后果的预付款。

    每多给一个动作,系统就多获得一种影响现实的方式。读取屏幕可能暴露信息;输入文字可能对外表达;点击提交可能产生承诺;打开设置可能改变设备可用性;读取通知可能把私人信息带进任务上下文。权限边界要按动作的后果划,不要按开发者觉得“接起来方便不方便”划。

    一个实用的分层是:

    • 观察权限:只读屏幕和设备健康信息,不改变外部状态。
    • 低风险操作:导航、搜索、填写本地草稿、打开已授权页面、在沙箱里试运行。
    • 受控操作:把内容放到待发送区、生成候选结果、提交到内部审核队列。
    • 高风险操作:任何对外发送、付费、删改、账户与权限变化、涉及第三方的动作。

    层级不是为了做一张漂亮表。它决定系统遇到每个动作时问什么。

    观察权限可以默认持续存在,但仍要最小化采集。低风险操作可以由规则自动批准,但必须有页面匹配和撤回条件。受控操作应留下待验收件。高风险操作默认停在门前,由拥有责任的人明确批准;有些动作则应该永久不开放给这个执行体。

    “永久不开放”很重要。

    不是所有事情都需要被自动化。尤其是涉及账户安全、付款、身份验证、绕过平台限制、批量操纵他人信息的事。把这些做成一键能力,不叫效率,叫把风险做成规模效应。技术越顺手,人越应该先问:这件事不顺手是不是一种保护?

    权限还必须和身份绑定。不是“系统允许发消息”,而是“这个任务由谁创建,允许在哪个范围内形成哪一类草稿,最终由哪个明确身份确认”。没有身份的授权,最后只会变成所有人都以为别人负责。

    真正成熟的权限系统,默认答案应该是:不知道,就不做。

    这不酷。

    但可审计比酷值钱。

    八、记忆:不是把聊天记录堆到上下文里

    AI 员工这个词最容易骗你的第二个地方,是“记忆”。

    它记得你上次说过什么,于是你以为它会像同事一样积累经验。它引用了一条历史偏好,于是你以为它有稳定的工作记忆。可一旦任务跨了几天、换了模型、换了设备、被人手动接管、遇到异常恢复,你会发现它记住的,多半只是被塞进上下文的文字。

    那不是组织记忆。

    那是临时缓存。

    手机执行体的记忆至少要分三种。

    第一种是事实记忆:设备是谁的、哪些应用被授权、哪些联系人或业务对象在范围内、哪些规则目前有效。这类记忆必须可以被更新、追溯、撤销。它不能靠模型从聊天里猜,也不能因为某次对话说“以后都这样”就永久生效。

    第二种是过程记忆:任务走到哪里、看见了什么、点过什么、失败过几次、谁接过手。它是为了恢复、审计和避免重复。过程记忆的标准不是文采,是别人能否沿着它复现当时的判断。

    第三种是经验记忆:某个页面通常怎样加载,某类异常应该停在哪,什么信号意味着要转人。这类东西可以由模型总结,但总结不能直接变成权限或事实。经验是候选规则,先验证,再进入规则库。

    很多系统把三种东西混成一个“长期记忆库”。这很省开发时间,也很方便制造聪明的幻觉。模型从旧记录里摸到一句相似的话,就把它当成现在的权限;从一次成功里抽出一个模式,就拿去处理不相似的新情境;从一段私人上下文里带出不该出现的信息。

    记忆越多,越要问它的来源、有效期和可见范围。

    记忆不是“知道得多”。

    记忆是“知道这条东西能不能在这里用”。

    例如,一个系统可以记住“某个页面在网络差时会停留很久”。这能帮助它延长等待和重新观察。它不该因此记住“遇到任何加载页都多等一会儿”,更不该把一次特定任务里得到的敏感数据带进下一次无关任务。

    把记忆做成带边界的记录,才有可能删除、纠正、过期、复审。否则所谓长期记忆,只是一座越堆越高的旧仓库。系统每次从里面拎出一个东西,都不知道它是不是已经变质。

    九、验收:完成不是模型宣布的

    模型很爱说“已完成”。

    这不是它的道德问题。它的工作就是给出一个看起来连贯的下文。你给它一个任务,它走了几步,页面出现一点变化,它自然倾向于把故事收尾。人类也有这个毛病:事情做得差不多了,就想宣布完工。

    可在手机执行里,完成必须是外部定义的。

    不是模型说完成,不是日志写成功,不是点击函数返回,也不是某张截图看起来很像结果页。完成是验收人根据预先约定的证据,接受“这个任务在允许范围内达到了目标”。

    这里的关键词是:允许范围内。

    一封草稿写得再好,若发给了不该发的人,不算完成。一份表单提交得再快,若字段来自未经核实的信息,不算完成。一个流程跑到了末尾,若中间越过了本该人工确认的门,不算完成。

    验收可以自动化一部分。比如格式是否齐全、页面是否出现特定且可信的确认信息、记录是否完整、结果是否落在白名单范围。自动验收负责检查机器可判定的部分。

    但最终接受,尤其是对外承诺、涉及重要关系或不可逆影响的接受,仍然应该属于人。

    因为验收不是检查一个像素。

    验收是接受剩余风险。

    人类在这里的价值,不是什么“灵魂”“温度”“直觉”这种广告词。是名字。你愿意在这个结果上留下名字,意味着你看过证据,理解还有哪些不确定,愿意承担它向外扩散的后果。没有这个名字,系统就只有动作,没有责任。

    一套健康的流程应该允许三种结束:已接受、已拒绝、已暂停。不要只设置成功和失败。暂停不是失败。暂停是系统承认它到达了自己的边界。一个从不暂停的自动化,要么权限太宽,要么日志在撒谎。

    十、人的最终责任不能外包

    把人放在环里,不是让人每十秒点一次确认。

    那样不叫安全。那叫把机器人变成一个需要人盯着的慢速机器人。人会疲劳,会形成肌肉记忆,会在一百个正确确认后把第一百零一个错误确认掉。所有把人当“橡皮图章”的设计,最后都会得到一个自动按按钮的人。

    人的位置应该放在判断成本最高的地方。

    什么叫最高?不是最复杂的地方,是一旦错了,后果难以撤回、难以解释、难以赔偿的地方。对外发布、对人承诺、涉及隐私、涉及资金、涉及身份、涉及删除、涉及规则例外的动作,都应该把人放在前面。人不必控制每一次滑动,但要控制系统能否跨过那些门。

    责任还有另一层:人要能停止。

    停止不是在事故发生后拔电源。停止权要被设计成正常路径:取消任务、冻结设备、撤回待处理动作、把当前上下文封存、禁止新动作、交给指定的人检查。若一个系统只有“继续”和“崩溃”两个状态,它迟早会逼人用崩溃解决继续。

    真正的最终责任也意味着,不能把错误推给模型。

    模型不签合同,不接电话,不付赔偿,不会在客户面前解释“为什么系统认为这条通知属于低风险”。它只是你选择使用的一段能力。选择把它接到哪里、给它什么权限、用什么证据验收、何时让它停,都是人的决定。

    这句话不浪漫。

    也正因为不浪漫,才值得写进系统里。

    十一、无控制探索:最像聪明,最接近事故

    有人会说:如果每一步都要状态、权限、观察、验收,AI 还怎么探索?

    答案是:探索可以有。但探索不能偷偷变成生产。

    探索的本质是尝试未知路径。未知路径意味着你不知道下一页有什么,不知道按钮会不会改变状态,不知道某个异常是不是可恢复。若它发生在沙箱、测试账号、模拟数据、明确隔离的设备上,探索是学习成本。若它发生在真实账户、真实联系人、真实业务数据上,探索就是让别人替你支付学习成本。

    这条边界要硬。

    一个系统可以在受控环境里探索“页面出现这个提示时有哪些安全的返回路径”。它不该在生产设备上为了“找找看”不断点新入口。它可以尝试识别新的界面模式,并把未知报告出来。它不该把不认识的页面自动归到最像的旧流程,然后自信地继续。

    模型特别擅长把陌生东西说得像熟悉东西。

    这正是探索需要围栏的原因。

    围栏不必复杂。可以是独立设备、无真实数据的测试环境、受限网络、只读权限、动作白名单、严格次数上限、自动录屏、人工在场。关键不在于你用了多少安全名词,而在于探索产生的错误能不能被收回,错误成本是不是由同意探索的人承担。

    如果答案不是,那就别探索。

    “让它自己试试”这句话,在生产环境里通常等于“我不知道它会做什么,但希望它别做错”。这不是策略。是祈祷。

    十二、为什么手机群控不是员工系统

    把一堆手机摆出来,接上电脑,看上去非常像未来工厂。

    屏幕亮着,任务在流,手指不见了。有人会把这叫数字员工矩阵、无人运营中心、全天候增长引擎。词越来越大,桌子上的问题没有变。

    一百台手机可以把一条错误扩大一百倍。

    它们不会因此拥有一百份判断。

    群控系统解决的是并发。并发的价值是同一个已被定义、已被授权、已被验证的动作,可以在多个独立而合规的对象上执行。它没有自动解决目标是否正当、对象是否同意、上下文是否一致、平台规则是否允许、结果是否被验收。

    更直白一点:规模不是组织。

    组织有角色、有制度、有记忆、有问责、有例外处理。群控只有更多终端。若你把更多终端误认为更多员工,就会得到一支没有判断、没有责任、也没有刹车的手指军队。

    这也是为什么我不把“大规模手机自动化”叫员工系统。它最多是一种执行基础设施。是否能成为员工系统,取决于上面有没有任务入口、权限分层、状态记录、验收权和责任人。没有这些,它的规模只会放大噪声。

    手机数量越多,最先需要扩张的不是模型上下文,是治理。

    谁能调度哪台设备?谁知道设备现在被谁使用?谁能暂停?同一个任务能否重复执行?日志保留多久?设备屏幕里的信息谁能看?异常是自动隔离还是继续排队?这些问题没有答案,设备从十台到一百台,不是线性升级。是把一个未定义的责任面放大十倍。

    别被屏幕墙迷住。

    屏幕墙是视觉奇观。状态墙、权限墙、证据墙才是系统。

    十三、一个可用执行体的最低结构

    到这里,可以把一台“给 AI 用的手机”压缩成一句不那么好卖的话:

    它是一台在明确授权下,持续观察自身状态,只执行允许动作,并把每一步交回证据与验收的设备。

    里面没有“自主上班”。

    但里面有真正能用的东西。

    最低结构可以是这样:任务由人或上层业务系统创建;任务写清目标、对象、有效期和停止条件;设备先观察;模型只解释当前界面并提出候选动作;规则检查候选动作是否匹配状态和权限;需要批准的就等待;执行后再次观察;证据和状态写入外部记录;达到验收条件才结束;任何不确定都可以暂停。

    这套东西甚至不需要一开始就很复杂。你可以只在一台自有设备、一个可撤回的内部流程、一个明确的测试任务上跑起来。不要一上来就追求“万能”。万能是最不负责的产品词之一。一个系统知道自己只会做什么,才有机会把那一件事做稳。

    判断是否可用,也不靠演示视频。

    看四个问题:

    1. 屏幕和实际状态不一致时,它会不会停。
    2. 页面改了、弹窗来了、网络慢了,它会不会重新观察而不是盲点。
    3. 遇到不确定或高风险动作,它能不能指出需要谁批准、缺什么证据。
    4. 事后能不能从记录里还原:谁让它做、它看见什么、点了什么、结果怎样、谁接受了。

    四个问题都答不上,别叫它 AI 员工。

    叫它自动点击器就行。自动点击器不丢人。把自动点击器吹成员工,才丢人。

    十四、先让它看见,再让它动手

    标题里的顺序不能倒。

    很多人做手机自动化,先研究怎么点:坐标、手势、输入、唤醒、脚本、连接、权限。因为动作最容易展示。屏幕动一下,成就感立刻到手。

    但真正难的不是让它动。

    是真正让它看见自己正在面对什么,并在看不清时停下。

    看见不是 OCR 把字读出来。看见包括:知道自己是不是仍在预期应用;知道页面是否被弹窗遮挡;知道设备是否锁住;知道这张截图是否新鲜;知道当前画面是否足以支持下一步;知道自己其实不知道。

    最后一句最贵。

    一个系统能说“我不知道这个页面”,通常比一个系统在陌生页面里找出一个看起来合理的按钮更值得信任。前者把不确定暴露出来,后者把不确定藏进动作里。动作一旦落到真实世界,藏起来的不确定会变成别人要收拾的后果。

    Surface Duo 合上,镜像黑了。此刻最好的模型不是会猜铰链状态的模型,而是会把任务停在“不可观察”的模型。Recovery 里出现“No command”。此刻最好的系统不是急着展现自己懂多少底层名词的系统,而是会把它标成“需要确认归属与恢复目标”的系统。

    这两幕很小。

    小到不适合做发布会高潮。

    可所有能长期运行的系统,都由这种小事构成。承认传感器会失明。承认状态会丢。承认界面会变。承认工具没有资格替人决定。承认人最终要在结果上留下名字。

    你想给 AI 一台手机,可以。

    先别急着叫它员工。

    先给它一双看得见自己边界的眼睛。再给它一只只在允许范围内落下的手。然后,让一个愿意负责的人站在最后。

    下篇才进入部署:如何在所有者或明确授权者的设备上,搭起观察、连接、动作、日志、暂停和审批,让这具执行身体真的可用。那会是一份操作手册。

    这一篇的结论先留在这里:

    手机不是 AI 员工。手机是 AI 的执行身体。身体越接近现实,判断和责任越不能缺席。

    别把一根数据线,当成一份劳动合同。

    十、一次失败,比十次演示更接近系统

    演示总挑天气好的时候拍。

    设备满电。网络正常。应用版本刚好。登录状态还在。屏幕没有锁。任务短得像一道选择题。模型看见按钮,点下去,页面跳了。视频到这里结束。旁白说:从此不必亲自操作手机。

    现实从视频结束的下一秒开始。

    第一代 Surface Duo 的黑屏,就是这种现实。它不是抽象意义上的“设备异常”。它有非常具体的时间线:桌面镜像仍在;设备被人拿起;两块屏幕合拢;显示策略改变;电脑端不再得到可用画面;原计划里下一步需要依赖画面的位置和文字,却还留在队列里。

    如果系统设计得差,接下来会发生两件事。第一,观察层把黑图误判为加载页或空白页。第二,执行层继续消费旧计划,在已经没有可验证前提的情况下发出动作。它未必立刻造成损失。也可能只是点空、超时、回到首页。这种“没出事”的幸运,最容易把错误设计养大。

    好的失败处理反而无聊。

    它把时间线切开:最后一张有效截图是什么时候;最后一个已确认状态是什么;黑屏前有没有未完成的外部动作;设备是否可能被人手动接管;任务是否仍在有效期。然后它进入暂停。暂停期间不做新点击,不用旧截图推断新页面,不把“我没看到结果”翻译成“再试一次”。

    这才是故障恢复的起点。

    恢复不是让机器尽快回到会动的样子。恢复是重新获得可信的观察,再决定旧任务是否还能继续。很多任务不能。有人可能已经处理了它;应用可能已经跳页;原本的授权窗口可能到期;前一动作可能已经成功但界面没来得及反馈。此时重开任务,往往比续接任务安全。

    Recovery 里的 No command 也是同一种教材。它让技术人很难受,因为画面不立刻给出答案。可系统首先需要的恰恰不是答案,是分类:正常界面、受限系统界面、未知状态、需要人工确认的设备状态。分类正确,下一步才可能小。分类错了,再熟练的工具也是往错误方向加速。

    所以我看一个手机执行系统,不先看它能不能跑完最长流程。我先故意破坏几个前提:关屏、切应用、制造网络慢、让页面弹出陌生提示、让人接管设备。它能安全停住,才配谈恢复;能恢复后重新建立证据,才配谈连续工作。

    失败不是演示的反面。

    失败处理才是演示没有拍到的主体。

    十一、任务契约:把一句人话拆成可拒绝的东西

    “帮我处理一下手机里的事。”

    这是一句人话。人和熟人之间可以这样说,因为双方会用经验补全空白。机器不该补。

    它不知道“处理”是看一眼、整理草稿、还是对外动作;不知道“手机”里哪些内容属于任务,哪些属于私人空间;不知道什么时候算完成;更不知道遇到歧义时是停下来问,还是按最像的经历猜。把这种话直接交给执行体,等于先删除边界,再要求它聪明。

    一个任务契约要把空白变成字段。不是为了文书工作,是为了让系统能够拒绝不完整的请求。

    最小契约至少写六件事:目标、对象、允许动作、禁止动作、验收证据、失效条件。目标是要得到什么结果,不是要模型显得忙。对象是明确的自有设备、已授权应用和已定义业务范围,不是“顺便看看”。允许动作写到类型,例如读取、导航、填写草稿、提交到内部队列。禁止动作也要写,例如不对外发送、不做账户或权限变化、不处理未列入范围的内容。验收证据写清最终谁看什么。失效条件则告诉系统何时自动作废:时间过期、页面不匹配、设备被接管、授权撤回、风险等级变化。

    任务契约还应该有一个很容易被省掉的字段:不做什么。

    人类写需求时习惯描述想要的结果。可对具备行动能力的系统,负面边界往往更重要。你可以允许它把资料整理到待审区,同时明确不允许发布;允许它打开一个内部页面,同时明确不允许点任何会影响第三方的控件;允许它检查状态,同时明确不允许尝试未知恢复路径。这个“不”不是能力不足,是把责任从模糊中拿回来。

    契约不是提示词的装饰。

    提示词可以帮助模型理解任务。契约决定模型理解错了以后,系统还会不会让它动手。两者不是一个层。把所有限制写进一段自然语言提示里,最后只能得到一段很长、很难审计、很容易被上下文挤掉的愿望。

    更实际的做法是让契约可被机器检查。目标是否在白名单;设备是否匹配;动作是否属于允许集合;有效期是否尚未结束;验收人是否存在;风险动作是否有批准。检查不通过,系统不需要和模型辩论。直接拒绝或转人工。

    这会减少一点“哇,它什么都能干”的感觉。

    也会减少很多以后要解释的事情。

    十二、状态不是页面名,是对现实的临时主张

    有人把状态机理解成给每个页面起名字:首页、详情页、成功页。

    这不够。页面只是观察到的表面。状态是系统对“现在可以安全地做什么”的主张。它需要同时引用任务、设备、流程和风险。

    例如,“等待确认”不是因为屏幕上有一个确认按钮,而是因为任务已经生成候选结果、证据齐全、下一动作会对外产生影响、当前角色没有最终接受权。换一台设备、换一个人接管、换一个任务,这个同样的按钮可能落在完全不同的状态里。

    状态转换要有守卫条件。守卫条件不是代码里的门面话,而是转换前必须为真的事实。要从“已观察”进入“可执行”,必须确认截图新鲜、前台应用匹配、目标元素可信、动作在权限范围内、没有更高优先级的停止信号。要从“执行中”进入“已完成”,必须有结果证据和验收结果。任何一项缺失,就留在等待或暂停。

    你会发现,这种系统常常不够顺滑。

    它会卡在“无法确认”。会要求重新观察。会在看见陌生弹窗时拒绝继续。它甚至会在用户觉得显而易见的时候要求点一下批准。

    这是成本。

    但没有这层成本,所谓顺滑只是把不确定性藏到事故发生以后再结算。

    状态还需要版本。应用更新、规则调整、授权改变时,昨天允许的路径不一定今天还允许。若系统只存“上一次成功怎么走”,它会把历史当成法律。版本化的状态和规则能让你回答:这次任务依据的是哪一版权限、哪一版页面识别、哪一版验收条件。答案不好看,却比“模型记得”强得多。

    十三、观察证据要能被怀疑

    截图不是事实本身。

    截图是一个传感器读数。它可能旧,可能被遮挡,可能只截到局部,可能颜色失真,可能刚好处在动画过渡里。无障碍树也不是神谕:它可能缺字段,可能与视觉层不同步,可能被应用实现得很差。通知同样会迟到、合并、消失。

    所以观察层应该允许自己被怀疑。

    一份证据除了内容,还要带时间、来源、覆盖范围和置信度。系统不必把置信度神化成一个精确小数,但要区分“页面完全匹配”“文本可读但上下文不全”“屏幕不可见”“元素存在但无法证明可点击”。这些区别决定后面能不能动。

    交叉验证也很朴素。动作后不要只看一个按钮变色;看页面标题、返回路径、任务记录、应用前台状态是否共同符合预期。若一个动作声称成功,而屏幕、流程状态和外部记录互相矛盾,最好的结论不是强行选一个。是标记冲突,停止推进。

    这和人类做实验没有区别。仪器读数不是结论,多个读数能否相互支持才是。AI 看到像素,也只是多了一台仪器。不要因为仪器会说话,就让它自己写实验报告、自己通过审核、自己把结果拿去影响别人。

    十四、权限不是开关,是逐步缩小的半径

    “允许”与“不允许”之间,还有很多层。

    一个系统可以被允许读取某个页面,却不被允许把内容带出页面;可以被允许填写草稿,却不被允许提交;可以被允许执行内部导航,却不被允许进入系统设置;可以被允许在一台自有测试设备上试错,却不被允许把相同动作迁移到真实业务设备。

    这叫最小权限。听起来老套,因为它确实是老常识。老常识在 AI 时代没有过期,只是更容易被忽略。过去一个脚本权限太大,最多是脚本乱跑;现在模型能在许多合理的路径里选择,权限太大就会让它在错误的合理性里走得更远。

    权限半径应该和任务一起缩放。任务越具体,设备范围越小,动作集合越短,证据要求越明确。不要为了省事给一个“通用助手”永久大权限,再指望提示词每天把它管好。授权应当有对象、期限、目的和撤销点。任务结束,临时权限也应结束;人撤回,系统立刻停止;设备归属不明,观察也要最小化。

    安全不是把每一步都锁死。安全是让每一把锁都能说清它保护的是什么。

    十五、记忆要会过期,经验不能冒充规则

    长期运行的系统一定会积累记忆。问题从来不是要不要记,而是记什么、谁能改、什么时候不再可信。

    事实记忆应当短而硬:设备标识、授权角色、有效期、允许应用、任务归属。它宁可缺,也不要靠模型补。过程记忆应当完整但克制:每次观察、每次动作、每次暂停、每次人工接管。它服务于复盘,不服务于窥探。经验记忆可以柔软一些:某类页面的稳定特征、常见加载时间、已验证的恢复建议。但经验永远只是候选。它必须通过测试和复核,才能影响下一次规则。

    最危险的记忆,是没有来源的习惯。系统从过去一次成功里学到“这样做通常没问题”,然后在新上下文里把通常当成必然。人类事故里,这种事很多:熟练工跳过检查,不是因为他坏,是因为过去一千次没出事。模型没有疲劳,却会以另一种方式形成惯性:相似文字、相似页面、相似目标,会把它推向相似动作。

    给记忆加来源、范围和过期日,就是给惯性加摩擦。摩擦不漂亮,却能让旧经验在进入新现实前被问一句:你还适用吗?

    十六、验收权是最后一个接口

    系统从外部世界拿到输入,再把动作送回外部世界。验收权是中间最后一个接口。

    它决定什么叫做完,什么叫做错,什么叫必须重来。若没有验收权,任务就会被“动作已发出”这种内部信号提前结束。所有自动化都容易有这个毛病:它们把自身的完成感,误当成业务的完成。

    验收条件应该尽量具体。不是“处理好”,而是“在批准范围内生成了哪类结果,证据是否完整,是否仍可撤回,谁已确认”。自动规则可以拦格式、重复、缺字段和明显不匹配;人来接受语境、例外和剩余风险。两者都不是摆设。

    验收人也不必是一个永远在线的老板。可以是任务发起人、指定值班人、具有某类业务责任的角色。重要的是身份清楚、权限清楚、证据可见。一个“任何人都能点通过”的界面,最后等于没有验收人。

    这就是为什么我反复说手机不是员工。员工系统的核心不是有多少动作,而是谁拥有验收权。没有验收权的执行体,只是一只被接长的手。

    十七、免费部分到这里,已经够用

    免费的上篇不该故意挖坑。

    你现在已经可以用它判断一个方案是不是在卖幻觉:它有没有把观察和判断分开;有没有动作后的再次观察;有没有状态、权限、记忆和验收;有没有把暂停当成正常结局;有没有一个能留名字、能停止、能承担后果的人。没有这些,硬件越多,故事越大,风险只会更整齐。

    这也是我愿意把这部分摊开的原因。不是每件有用的东西都要先锁起来,等人付钱才告诉他刹车在哪。底层判断应该公开。你可以不用我的工具、不用我的设备、不用我的后续方案,照样拿这几条去拆任何“AI 手机员工”的宣传。

    但从哲学到部署,中间仍有一段脏活。设备连接会断,系统版本会变,镜像会黑,日志会缺,权限配置会互相影响,恢复路径会因具体设备不同而不同。不存在一份脱离设备、脱离授权、脱离现场的万能教程。谁承诺有,谁多半卖的是录屏。

    下篇付费的价值不在于再给你一串神秘命令。它会给出一套面向所有者或明确授权者的完整部署法:如何建立一台设备的观察通道,如何把动作限制在批准范围,怎样存证、暂停、交接、复核,怎样在黑屏、断连和异常状态里不把旧计划当现实。每一步都要有目的、边界和回退条件。

    你付费买的不是“让 AI 随便碰手机”的权利。

    你买的是少踩几次坑,和一套能在坑边停下来的结构。

    先让它看见。再让它动手。

    剩下那部分,才叫部署。

    十八、把“人类在环里”拆成几个角色

    “人类在环里”这句话已经快被说坏了。很多产品把它翻译成一个弹窗:模型每做一步,弹窗问你一次“是否同意”。这不叫人类在环里。这叫把人类做成低质量的验证码。

    人不是一个角色。至少要分开四种。

    任务发起人决定为什么要做。他提供目标、对象和业务背景,也有权在目标变化时撤回任务。授权人决定这台设备和这类动作能不能被使用。他不必知道每个页面细节,但要对授权范围负责。验收人决定结果能不能被业务接受。他看的是证据、例外和剩余风险,而不是模型说话是否流畅。处置人则在异常时接手:断连、锁屏、未知页面、设备故障、规则冲突。处置人有停止权,却不必自动拥有发布权或扩权。

    四个角色可以由一个人兼任。小团队里通常就是一个人。把它们写出来,仍然有意义。因为同一个人今天以任务发起人的身份说“帮我整理”,不等于他在没有看证据时已经以验收人的身份说“可以对外”。角色分开,是为了让权限在时间上也分开。

    很多事故来自“默认同意”。系统看到创建者和验收者是同一个人,就把后续所有确认视为自动通过;系统看到设备曾被授权,就把每一个新任务都当成旧任务的延续;系统看到某人拥有管理员身份,就让他在不理解业务后果时也能放行一切。技术上很方便。组织上等于取消了检查。

    真正的人工介入应该发生在信息增量最大的地方。不是每个普通步骤,而是出现新事实、风险改变、任务边界变宽、结果将对外生效的时候。人看到的不是一句“请确认”,而是一份可读的摘要:原目标是什么;系统现在看见什么;下一动作会带来什么后果;它为什么认为符合条件;还缺什么证据;拒绝或暂停会怎样。

    如果弹窗不能回答这些问题,别让人点。

    那不是审批。

    那是把责任从机器端迁到一个没有信息的人身上。

    十九、不要把成功信号当成世界已经改变

    手机界面特别擅长制造假成功。

    一个按钮按下去会变灰。一个圆圈转几秒。页面弹出“已保存”。这三个信号都可能是真的,也都可能只是本地界面的乐观反应。网络请求也许没出去,服务端也许拒绝了,数据也许仍在排队,后台也许稍后回滚。若任务涉及任何真实业务,系统就不能把第一个成功信号当成终点。

    这里需要区分动作确认和结果确认。

    动作确认只说明设备尝试过:点击事件发出、输入法写入、页面发生视觉变化。结果确认说明目标事实成立:内部记录已更新、预期状态能被重新观察、验收人拿到了可检查的产物。二者之间可能隔着延迟、异步、失败和人工处理。

    一个稳的系统宁可说“动作已提交,结果待核”,也不要为了显得利落说“已完成”。这句话会让用户觉得慢,却能避免更昂贵的重复。尤其在网络抖动、应用卡顿或外部服务不确定时,第二次尝试不一定是修复,可能是重复提交。

    因此,每个任务都应该有幂等边界。不是要求所有应用都支持复杂的工程术语,而是要求系统知道:同一个意图在不确定后不能无限重放。它可以保存任务编号、时间、最后证据,等待新的观察;可以把不确定交给人;可以在有可靠查询方式时先核对。它不应该因为“没有看见成功页”就继续拍同一个按钮。

    这是手机闭环比脚本难的地方。脚本调用一个接口,往往能得到明确返回。手机面对的是一块会动画、会缓存、会被人抢走的玻璃。它带来更广的可达性,也带来更弱的确定性。用屏幕操作,就必须接受这种成本,而不是假装视觉识别把它抹掉了。

    二十、日志不是监控录像,是责任的索引

    很多人说要“全程录屏”。录屏当然有用,但录屏不是日志的替代品。几个小时的视频很难找,画面也不总能说明为什么。真正需要留下的是能索引、能对照、能复盘的记录。

    每一次状态变化应当至少留下:任务是谁创建的;当时适用哪一版规则;观察来自哪里、是什么时间;模型给了哪些候选;规则为什么允许或拒绝;最终动作是什么;动作后的观察是否支持预期;谁批准了例外;何时暂停,何时恢复。敏感内容应做最小化保存和访问控制,不是把整个屏幕生活永久堆进仓库。

    日志的第一用途不是找人背锅。第一用途是让系统有机会被修好。没有日志,你无法区分页面识别错、状态转换错、权限配置错、模型建议错、人工批准错。所有原因都会坍缩成“刚才它不太对”。有日志,才知道该改哪一层,也知道改完以后有没有引入新问题。

    第二用途才是责任。当一个任务影响了外部世界,参与者需要能还原决定链。不是为了让每个人恐惧,而是为了让每个人不必靠记忆自证。系统替人记下:当时看见了什么,谁拥有哪种权力,谁在什么证据下接受了什么风险。记录越清楚,越不需要靠嗓门争论。

    日志也要有边界。不要因为“可追溯”就无限留存敏感画面和私人内容。保留什么、保留多久、谁能访问、何时删除,属于任务契约的一部分。AI 执行体最不该做的事之一,就是以自动化的名义建立一座无人负责的监控仓库。

    二十一、规模化之前,先做反向验收

    正向验收问:它能不能完成任务。

    反向验收问:它会不会在不该完成时停下。

    后一个问题更值钱。因为正常路径总是容易被优化。团队会不断喂给系统干净截图、稳定网络、正确授权、熟悉页面。系统最后看起来像个高手。可真实世界里,最重要的路径通常是脏的:同名联系人、延迟通知、意外弹窗、临时改版、过期任务、手动接管、授权撤回。

    反向验收故意制造这些条件,但只在自己控制的测试环境里做。观察层看不清时是否报告未知;页面与预期不一致时是否停止;动作超过权限时是否拒绝;完成信号不充分时是否保持待核;记忆过期时是否不再引用;人工撤回后是否立即切断新动作。每个“是”,都比一次丝滑的连点更接近可用。

    如果一套系统只能证明“在正确条件下能成功”,它还只是 demo。能证明“在错误条件下不会乱来”,才开始像基础设施。

    这条标准对手机尤其重要。手机是一个极其混杂的端点:私人与工作混在同一块玻璃上,系统通知会插进来,人的手随时可以覆盖机器的手,应用的界面由第三方更新。你无法把它改造成一个完美工厂。你只能承认它不完美,然后把不确定留在观察和暂停里,而不是推到外部世界。

    二十二、结尾:它不是替你活,是替你碰到世界

    模型在文本里很强。它可以把一段意图铺开,把资料压缩,把候选方案摆出来。手机给它的,不是更高的智力,而是一个接触点。它能看见屏幕,能碰到按钮,能把内部判断送到现实边缘。

    这就够危险,也足够有用。

    你不需要相信它会成为员工,才有资格使用它。恰恰相反,先把它当执行身体,才会认真给它安排眼睛、手、边界、日志和停止权。身体可以很快,判断必须慢一点;身体可以覆盖重复,责任不能被覆盖;身体可以连接更多界面,组织不能因此省略。

    第一代 Surface Duo 的合拢提醒我们:视觉会消失。Recovery 的 No command 提醒我们:看不懂的状态不是可以随便跨过去的墙。它们都不宏大。可它们比任何“全天候 AI 员工”都诚实。

    手机不是 AI 员工。

    它是 AI 伸进现实的一截肢体。

    先让它看见。让它在看不见时停下。再让它动手。让它在手落下以后回头看结果。最后,把接受结果的名字留在人这边。

    二十三、恢复不是越权的借口

    系统一旦卡住,总有人会说:先把它救回来再说。

    这句话听上去务实,实际常常把两个问题搅成一个。第一个问题是设备能不能恢复到可观察、可使用的状态;第二个问题是当前任务还有没有资格继续。前者是技术问题,后者是授权问题。技术处理成功,不会自动替你回答授权还在不在。

    例如设备因为锁屏、断连或系统界面变化而失去画面。系统可以报告失明,可以保存最后证据,可以请求设备所有者检查连接和可见性。它不该为了完成原任务,擅自扩大访问范围、尝试未知设置、修改账户状态,或把恢复环境当成绕开正常流程的捷径。恢复的目标应当是回到一个可确认的安全点,不是“无论如何把任务跑完”。

    这条原则很适合测试。问自己:若设备恢复后,原任务已经过期、对象已变化、页面已换、人工已接手,系统会怎样?正确答案通常不是续跑。它应该重新观察,重新核对契约,必要时重新申请批准。只有当前事实仍符合原授权,旧任务才有资格继续。

    人很讨厌从头来。机器更不该讨厌。重新开始的成本,常常比错误延续便宜。

    二十四、别拿“省人”当第一张账

    有人问这种系统能省多少人力。我理解这个问题。重复操作会吞掉注意力,手机上的碎流程尤其讨厌:应用之间切来切去、信息散在通知里、每一步都小,却不断打断工作。

    但第一张账不该只算节省的分钟数。还要算系统要你付出的注意力:规则谁维护,权限谁复审,异常谁处理,设备谁保管,日志谁看,版本变更谁测试。若一个流程每周只出现一次、每次只需两分钟,给它接上一套复杂执行体未必划算。自动化不是把任何人工都替掉,而是把稳定、重复、可验证、错误可收回的劳动从人手里剥出来。

    真正值得自动化的,往往不是最显眼的动作,而是最容易形成可靠边界的动作。你能说清输入,能说清输出,能说清停止条件,能在异常时交回人,这类事情才适合交给执行体。反过来,若任务价值来自关系、语境、例外判断和责任承诺,机器即使能点完每个按钮,也可能没有省下任何真正的工作。

    把这张账算清,能让你避开一个很常见的陷阱:为了展示 AI 很强,先把最复杂、最敏感、最难验收的流程交出去。那不是落地。那是拿自己的业务做舞台。

    二十五、从一台开始,先练会停

    若你真的要做,起点应该很小。一台自有或明确授权的设备。一个内部、低风险、可撤回的流程。一个能清楚验收的目标。一次只增加一种能力:先看,后导航;先保存证据,后允许填写;先允许填写到草稿,后讨论是否需要任何外部动作。

    每增加一步,都问同样四个问题:它现在靠什么观察?它在什么条件下允许动作?动作后靠什么确认?不确定时交给谁?四个问题有一个答不上,就不要加下一层。

    这不是保守主义。是把速度放在可以积累的地方。你在一台设备上练出来的不是一套神秘脚本,而是一种工作纪律:事实在模型外,权限在动作前,验收在结果后,暂停永远可用。以后无论换手机、换模型、换应用、换团队,这些纪律仍然在。

    工具会换。边界不会。

    这也是免费上篇真正想留下的东西。不是一段能复制粘贴的连接指令,不是一张屏幕墙的照片,而是一把尺子。拿它去量任何 AI 执行方案:它越靠近现实,越要把眼睛、手、记忆、权限、验收和责任拆开。拆不开的地方,就先别让它碰。

    二十六、授权会衰减,交接必须重新开始

    权限不是一枚盖下去永远有效的章。它会衰减。

    人会换岗位,设备会换主人,应用会更新,任务背景会消失,原先说过“你可以处理”的那句话会失去具体含义。一个昨天被允许的动作,到了下周可能已经没有对象、没有目的、没有验收人。系统若把授权当成永久记忆,迟早会在一段已经结束的关系里继续行动。

    因此,授权应当像电池,不像纹身。它要有范围、期限、用途和可撤销性。任务完成后,临时动作权回收;设备交接时,旧任务冻结;角色变化时,原来的审批链重新确认;规则版本升级时,尚未执行的任务重新检查。不是因为每个人都不可信,而是因为上下文本来会消失。

    交接也是一次新的观察。

    人接手机器时,不能只读一句“已处理到第六步”。他需要看当前设备是否仍可见,任务是否仍有效,最后证据是否可信,下一步是否仍在允许范围内。机器接手人也一样:不能因为日志显示前任曾经批准,就假设当前人已经接受了同样风险。交接不是把旧状态复制过去。交接是把旧状态拿出来重新验。

    很多团队没有把这件事写进系统,因为它看起来不像技术。可真正长期运行的自动化,最后都死在这种不显眼的地方:离职的人仍在审批链里,旧设备仍带着权限,过期任务在夜里被重试,没人记得当初为什么允许。

    把授权做成会过期的东西,系统才有机会跟现实一起变。

    把交接做成重新确认的东西,责任才不会在传递中蒸发。

    到这里,这篇文章没有承诺一台手机能替你经营公司。它只给出一个更小、更硬的结论:任何想让 AI 接触屏幕、接触动作、接触现实的人,都先该把“它看见了什么”“它凭什么能动”“动完怎么证明”“出事谁来停”写下来。

    写不下来,就不要接线。

    二十七、会拒绝,才算真的能帮忙

    最后再留一条最不讨喜的标准:一个可用的执行体,必须会拒绝。

    拒绝不是把用户当敌人。拒绝是把不完整的意图还给意图的主人。目标不清,就要求补目标;对象不在授权内,就指出范围;页面不匹配,就报告未知;动作会跨过高风险门槛,就等待拥有名字的人批准;证据不足,就不宣布完成。它不需要装得像人,也不需要用很长的道歉。它只要清楚地说:我现在缺什么,因此不能继续。

    这比“我已经尽力了”有用。

    人在工作里也一样。真正可靠的同事,不是每个请求都说好,而是在请求会造成误解、越权、重复或损失时,把问题推回到该决定的人手里。AI 执行体不必假装拥有同事的生活和责任,但应该继承这条工作纪律。

    于是“给它一台手机”这件事终于变得普通。不是造了一个新人类,也不是把企业塞进一根线。只是把一套被约束的观察和动作,接到了真实界面的边缘。它能替你搬一段路。路线、边界、终点和后果,仍然在你手里。

    你会发现,真正难的从来不是让屏幕动起来。真正难的是在它动起来以后,仍然知道自己正在做什么。一个系统若能把这句话守住,哪怕只服务一台设备、一个流程、一个清楚的任务,也已经比许多声称拥有数字员工军团的方案更接近工作。

    别急着扩张。先让第一次暂停是可理解的,让第一次拒绝是可解释的,让第一次恢复不是侥幸。把这些做完,手机才不是一块会发光的风险。它才开始成为一具可控的执行身体。

    这不是慢。是把速度从盲目点击里拿回来,放进能够复盘、能够修正、也能够负责的闭环里。

    能把这一圈走稳,才配把下一圈交给机器。

    先守住边界,再谈规模。

    如此。

    二十八、授权会过期,任务不能靠惯性活着

    委托不是把一把钥匙交出去。它更像给一张临时通行证盖上时间。今天你允许系统替你整理某个内部页面,不等于明天它还可以;你允许它处理一条明确任务,不等于同类任务以后自动续期;你曾经是设备所有者,也不等于你离开这个岗位后,旧授权还在替你做决定。

    这叫授权衰减。

    系统很容易忽略它。因为历史记录里有一个“曾被批准”,模型就会把它读成“仍然允许”;因为设备连接还在,执行器就会把可达读成可用;因为任务队列没有被清空,它就以为目标还活着。人类组织里最危险的权限,往往不是被明确滥用的权限,而是没人记得应该收回的权限。

    所以授权必须带寿命。任务有截止时间;动作有目的范围;审批有版本;设备有当前归属。任何一个字段变化,都应该让旧委托重新进入待确认,而不是靠昨天的同意滑过去。系统不必猜某个人是不是还愿意。它只需要承认自己不知道,然后停。

    这很像人类交接工作。前任说“这个客户可以这样处理”,后任也不能把这句话当永久规则。客户情况会变,合同会变,承诺会变。可靠的交接不是继承一句口头经验,而是重新核对事实、权限和下一步责任。机器交接也一样。

    二十九、最危险的错误,是看起来像成功

    失败时,人会警觉。红字、报错、黑屏、转圈,都在提醒你事情不对。真正麻烦的是假阳性:页面弹出“已提交”,但服务器没有接收;按钮变灰,只是本地动画;系统日志写了成功,实际只是动作被发出;模型说“任务完成”,它不过看见一个熟悉的结尾。

    假阳性比报错更毒。报错让流程停住,假阳性让错误带着完成感继续往下走。

    因此,成功也要被怀疑。对每个重要动作,分开问两件事:设备是否尝试了动作;世界是否已经变成预期状态。前者是执行证据,后者是结果证据。两者不一致,就不要用乐观的那个覆盖谨慎的那个。把任务标成待核,等待新的观察或人工确认。

    这不是故意把系统做慢。它是在防止“没看见失败”被错误地翻译成“已经成功”。手机界面尤其需要这层,因为它本来就是给人看的,不是为严格事务确认设计的。人能从上下文和责任感里补上一点迟疑;机器必须把迟疑写进状态。

    三十、人工交接不是接管,是一份协议

    当系统把任务交给人,不能只丢一句“需要人工处理”。这句话把最难的上下文又塞回人的脑子里,等于让人从零开始猜机器为什么停。

    一次合格交接至少交出五样东西:原任务要什么;当前可确认的状态是什么;最后一张有效证据是什么;系统拒绝继续的具体原因;人接手后有哪些允许选择。人可以批准、拒绝、修正目标、取消任务、恢复到某个安全点。系统则必须记住人选择了什么,不能在下一轮又把同一个问题问一遍。

    这是一份协议,不是一句求救。

    协议的价值在于,人与机器都不假装知道对方脑子里的东西。机器不假装人已了解风险;人也不假装机器已经完成。交接完成后,状态应当重新建立:是谁接手,接手时看到了什么,哪些授权被改变,下一步还是否有效。没有这些,所谓人工在环里只是一段断裂的聊天记录。

    三十一、故意小的第一件事,教你的最多

    第一件交给手机执行体的任务,不该拿来证明它多聪明。应该拿来验证它会不会守规矩。

    选一个小到有点无聊的任务:范围固定、对象自有、结果可检查、失败可撤回、没有对外承诺。它的价值不在产量,而在让你看见完整闭环在哪里裂开。你会发现设备并不总是可见,页面并不总是稳定,旧证据很快过期,权限需要比想象中窄,人工交接也需要比想象中清楚。

    这些发现不浪漫。但它们是以后所有规模的地基。

    一开始就挑最大的流程,学到的通常只有一件事:系统很复杂。先挑最小流程,你才能知道复杂究竟从哪一层长出来。是观察不稳,是状态缺失,是授权太宽,还是验收没人?问题一旦有名字,就能被修;没有名字的宏大失败,只会变成下一次更大的演示。

    先让它在小事上安全地停住。之后才谈让它在大事上替你动手。

    来源:https://x.com/dashen_wang/article/2080701959879929858

  • 走进制造业:上篇·生产之前,产品先学会承担

    走进制造业:上篇·生产之前,产品先学会承担

    制造业产品研究 · 上篇

    楔子:第一版东西为什么像玩具

    这次研究的第一版交付物,技术上没有什么明显的错误:有概念图,有三维模型,有材质,有镜头,有一段可以播放的动画。它甚至比很多真正拿去开会的方案更漂亮。

    但它像玩具。

    这里的“像玩具”,不是说颜色幼稚,也不是说渲染不够精细。它像玩具,是因为画面里只有一个对象,没有一套关系。它看起来像产品,却没有说明谁来使用、谁来安装、谁来维护、谁来采购、谁来承担失败。零件被摆出来了,接口没有被定义;材料被涂上去了,工艺没有被讨论;成本被留到最后,仿佛成本是一只不会突然咬人的狗。

    更麻烦的是,画面把这些空白遮得很好。高光、景深、音乐和漂亮的构图让人以为事情已经完成。直到有人问一句“这个东西怎么做”,整套方案才像一层很薄的漆,从中间裂开。

    我后来承认:我最初以为自己要做一张图,实际上要做的是一个能够进入现实、并且能够在现实里继续被追问的产品系统。

    这不是同一件事。

    制造业设计的起点,不是让东西看起来像产品,而是让它开始承担关系。

    它要承担人与物的关系、部件与部件的关系、产品与供应链的关系、愿景与证据的关系,以及一个人把项目交给另一个人以后,项目仍然能够继续推进的关系。

    这篇文章不把这个过程叫成某种学科,也不把它包装成一套漂亮理论。我要做的事情更直接:从一次匿名的硬件产品研究出发,把那些通常被藏在“感觉”“经验”和“项目推进”里面的判断,逐层拿出来。

    第一部分 · 先从对象里退一步

    1. 一个产品从来不只是一个对象

    人看到的是形状,工厂看到的是分件,采购看到的是供应商,质量部门看到的是检验,售后看到的是可更换的零件,老板看到的是一条可能盈利、也可能失控的现金流。

    他们面对的是同一个产品,却没有同一个产品。

    设计工作真正困难的地方,往往不是把这些视角全部满足,而是找到一个能让它们互相咬合的结构。结构不是外观背后的钢架,而是各种要求被放在同一张图上之后,仍然不会互相打架的安排。

    因此,产品定义不能从“我要一个什么样的东西”开始,而要从“这个东西必须同时承受什么”开始。它要承受多大的力、多少次操作、怎样的环境、怎样的成本、怎样的交期、怎样的误解,以及怎样的失败。

    设计师如果只问“它长什么样”,最后会得到一个造型;设计师开始问“它要承受什么”,才有机会得到一个产品。

    2. 一句话需求里藏着一座工厂

    “做一个通用产品”是制造业里最危险的句子之一。它听起来给了设计自由,实际上把大量决定都推迟了。

    通用的对象是什么?是外观、安装接口、电子平台、材料体系,还是服务方式?

    变化发生在哪里?是尺寸、颜色、附件、输出功率、包装,还是目标市场?

    哪些界面必须固定,哪些参数可以被配置?

    谁负责把客户的模糊愿望翻译成可采购、可制造、可测试的规格?

    这些问题不回答,所谓通用就只是“大家以后再说”。

    在科研工作里,我逐渐形成了一个习惯:任何形容词后面都追问一个动作。高级,具体由什么材料层级和表面处理体现?可靠,具体由什么测试和维护动作证明?开放,具体开放哪些文件、保留哪些边界?低成本,具体是哪一组成本被压低,代价转移到了哪里?

    形容词只有在变成动作之后,才开始具有工程意义。

    3. 外观是入口,不是判决书

    一个好的外观方案,会让人愿意靠近;一个成熟的产品方案,还要让人知道靠近以后该做什么。

    这就是为什么工业设计不能只围绕正面展示图。正面图负责建立第一印象,侧面图暴露厚度,背面图暴露接口,底面图暴露安装,拆解图暴露维护,量产图暴露工艺。

    外观不是一张封面,而是一组对不同距离的回应。

    距离很远时,产品需要被识别;距离很近时,产品需要经得起触摸;被拆开时,产品需要解释自己;被批量生产时,产品需要接受一致性;被退回维修时,产品需要允许人进入。

    如果一个设计只能在镜头正前方成立,它还没有进入制造业。

    第二部分 · 把世界拆成可承担的关系

    4. 设计的核心动作是画边界

    每一个产品都在回答“什么属于这里,什么不属于这里”。外壳和内部是边界,用户和维修者是边界,概念和事实是边界,产品平台和定制项目是边界,公开文件和内部资料也是边界。

    边界画错,问题不会立刻出现。它会先变成沟通上的小误差,然后变成接口上的返工,最后变成成本、交期或质量事故。

    所以,边界不是管理部门的文件工作,而是设计工作本身。一个服务门的位置,是边界;一个连接器是否外露,是边界;一项指标是否写进宣传语,是边界;一个来源是否可以被公开,也是边界。

    画边界之前,要先问三个问题:谁会跨过它?跨过需要什么工具或信息?跨过之后由谁负责?

    如果回答不出来,说明边界还只是视觉上的线。

    5. 把对象拆成接口,复杂性才有地方放

    制造业的复杂,不是零件多,而是零件之间的关系没有被说清楚。

    一个真正可以扩展的平台,首先不是拥有很多零件,而是拥有稳定的接口。机械接口决定什么可以互换,电子接口决定什么可以升级,软件接口决定什么可以复用,交付接口决定什么可以由下一位参与者接手。

    这也是科研 agent 思维最值得被迁移到产品工作的地方:不要让每一个问题都变成一段散文,要把问题拆成对象、输入、输出、状态和证据。一个模块不能只写“负责供电”,还要说明输入是什么、输出是什么、异常是什么、如何验证、哪些参数暂时未知。

    当接口被写清楚,团队才能并行;当接口没有被写清楚,所有人都在等待同一个人解释上下文。

    6. 不确定性不是羞耻,未标记的不确定性才危险

    设计师常常担心说“这里还没确定”会让方案显得不专业,于是把不确定性藏进更漂亮的渲染里。制造业最怕的恰恰就是这种漂亮。

    一个真实的项目允许有未知项:材料可能有两个候选,尺寸可能需要样机确认,供应商可能尚未报价,测试方法可能仍在讨论。真正专业的做法,是把这些未知项标出来,给它们编号,指定下一步和责任人。

    科研 agent 的工作方式也是如此。它不把“文件存在”当作“问题已解决”,不把“软件安装”当作“流程已接通”,不把“渲染通过”当作“产品验证通过”。它会区分:这是需求,这是计算,这是模拟,这是测量,这是供应商声明,这是认证。

    这个区分表面上很慢,实际上是在阻止团队用一句话跨越六个不同的证据等级。

    7. 证据不是附录,而是产品的一部分

    制造业里,证据常被认为是项目结束之后补的东西。等产品做出来,再去整理测量表、供应商资料、测试照片和变更记录。

    这样做会让证据变成一堆无法解释的碎片。真正有用的证据,从需求提出时就开始排队:这句话从哪里来?它要证明什么?需要什么设备?谁可以签字?什么结果算通过?

    在内部科研系统里,我采用了一套很朴素的证据词汇:

    REQUIREMENT 是别人要求你做什么;

    CALCULATED 是按照明确模型推导出来的结果;

    SIMULATED 是在声明输入和假设下得到的模拟;

    MEASURED 是可重复观察到的实物结果;

    SUPPLIER_DECLARED 是供应商或外部机构提供的参数;

    CERTIFIED 是有明确认证记录支持的结论。

    词汇本身不复杂,难的是不越级。计算不能冒充测量,模拟不能冒充实物,供应商声明不能自动冒充认证,设计意图更不能冒充生产批准。

    一句话能不能被写进广告,取决于它背后的证据是什么,而不是它听起来多像真话。

    第三部分 · 人与机器之间的那条线

    8. AI 负责扩展可能性,人负责缩小责任范围

    AI 图像模型、语言模型和自动化脚本,把许多过去很慢的工作变快了。几十个造型方向、几组文案、几套文件结构、一次批量输出,都可以在很短时间内完成。

    速度带来的第一个幻觉是:既然生成这么快,产品就应该也能这么快完成。

    实际上,AI 最擅长扩展可能性,制造业最需要的却是缩小责任范围。AI 可以告诉你“还可以这样”,却不能替你决定“这一版谁签字、谁采购、谁测试、谁承担失败”。

    所以,AI 在产品流程中的位置,应该在问题定义和证据约束之间。它可以帮助拆解、比较、起草、归类和生成候选;它不能替人类把概念写成事实,更不能在没有来源时自信地补一个参数。

    9. 研究 agent 不是一个更会聊天的助手

    研究 agent 的核心,不是回答更像专家,而是把研究过程变成可以停下来检查、失败后恢复、换人后继续的工作流。

    它会先问:目标是什么,范围是什么,假设是什么,预期看到什么?

    它会继续问:来源在哪里,主张边界是什么,隐私是否允许,哪些内容只能留在内部?

    它会把任务拆成小步:先建立目录和契约,再接入来源,再生成中间产物,再做审阅,再交付。

    它会保留失败:工具没装、数据不全、测试没跑、证据不足,都应该成为明确状态,而不是被一段成功文案覆盖。

    这套思维对制造业很有价值。工厂并不需要一个永远说“可以”的助手,工厂需要一个能及时说“现在还不能承诺,但下一步需要什么”的系统。

    10. 自动化越强,人工判断越要明确

    很多团队把自动化理解成尽量少让人介入。制造业里,这个方向并不总是对的。

    可以自动生成的,是文件、编号、排序、报表、版本摘要、成本计算和缺口清单;必须由人判断的,是需求是否合理、边界是否可公开、样品是否代表量产、供应商是否可信、异常是否可以放行。

    自动化的价值,不是删除判断,而是把人的判断从重复劳动里释放出来,让它集中在真正不可替代的地方。

    第四部分 · 时间、成本与责任

    11. 产品会经历不同的时间

    概念图中的产品处在一个静止的时间里,样机中的产品开始经历装配时间,量产中的产品经历节拍和等待,用户手中的产品经历使用、老化、维护和报废。

    如果设计只在静止状态下成立,产品一进入现实就会暴露问题。

    一个按钮按一万次后如何?一个密封件在环境变化后如何?一件表面处理在运输碰撞后如何?一个电子元件停产后如何?一个供应商涨价后如何?

    产品不是一个状态,而是一条时间线。设计要提前为这条时间线留下维修、替代、升级和退出的空间。

    12. 成本不是表格最后一列

    把成本放到最后,是设计和制造之间最常见的误会之一。成本从来不是一个设计完成后需要被压低的数字,而是设计每一次选择时都在发生的结果。

    一个新的表面处理,意味着材料、工艺、良率和检验变化;一个异形连接件,意味着供应商数量、交期和备件变化;一个更难拆的结构,意味着售后工时和退货成本变化;一个看起来更便宜的材料,可能意味着模具寿命和长期一致性变化。

    从底层看,成本至少由材料、工艺、模具、电子、装配、测试、包装、物流、认证、管理和风险组成。每一项都应该有来源、日期和假设。

    真正专业的成本表,不是把总价算到小数点后两位,而是让人看见哪个数字一旦变化,会牵动哪一组决定。

    13. 谁来承担后果,决定了产品怎么长

    “这个功能加上去再说”通常意味着有人还没有想清楚后果由谁承担。设计师承担造型返工,工厂承担工艺风险,采购承担交期,质量承担投诉,老板承担现金流,用户承担不可靠的使用体验。

    如果责任不被说清楚,项目就会把风险转给最晚发现它的人。

    好的产品流程,不是消灭风险,而是让风险尽早被看见,并且在最便宜的阶段被处理。概念阶段发现接口冲突,成本是一次讨论;量产阶段发现接口冲突,成本可能是模具、库存和客户赔偿。

    第五部分 · 开放、隐私与可交接

    14. 开源不是把内部工作台搬到街上

    一个项目要公开,首先要知道什么是系统,什么是实时项目;什么是方法,什么是个人资料;什么是示例,什么是客户数据;什么可以复用,什么必须脱敏。

    内部科研目录里,公开的是可复用的研究脚手架、证据词汇、模板、审阅规则和协作约定;不公开的是实时项目、个人笔记、数据集、凭据、缓存和代理状态。

    这条边界不是为了让项目显得神秘,而是为了保护研究对象、合作方和未来交付。把内部路径、客户文件或供应商信息直接放进文章,会让一篇关于方法的文章变成不必要的信息泄露。

    15. 可交接比可炫耀更重要

    设计师很容易把自己的文件整理成只有自己能看懂的样子:一个总模型、几个随手命名的版本、一份没有来源的表格、一个只有作者知道如何重现的渲染场景。

    可交接的系统则相反。它有稳定的 ID,有清晰的目录,有版本和状态,有来源和边界,有失败记录,有下一步入口。文件不一定华丽,但别人可以继续。

    科研 agent 的“可恢复”原则可以直接迁移到制造业:失败的构建不会留下半成品;更换设备后仍能从明确状态继续;新成员可以通过 README 和契约理解项目;旧版本不被静默覆盖。

    这不是文档洁癖。制造业的真实项目周期很长,参与者会变化,供应商会变化,材料会停产,客户会改需求。只有可交接的产品,才有机会活过最初的设计团队。

    第六部分 · 失败不是插曲,是方法的一部分

    16. 早期错误为什么必须写下来

    这次研究里,早期版本出现过镜头过近、主体方向不清、部件散落、信息过曝、标题压住主体、技术细节成为装饰等问题。

    这些问题很容易被写成“后来优化了视觉效果”,但那样会把真正的教训抹掉。它们暴露的是:模型没有层级,叙事没有受众,镜头没有信息责任,交付没有边界意识。

    把失败写下来,是为了下一次更早地发现它。一个项目如果只保留最后的成功画面,团队就会误以为成功来自灵感;保留中间的错误,才能看见成功来自哪一条判断链。

    17. 评审应该问什么,而不是喜欢什么

    “我喜欢这个”当然可以作为审美意见,但它不应该成为工程结论。

    评审可以问:观众能否在三秒内知道产品朝向?安装者能否判断接口?维护者能否找到入口?采购者能否看到成本变量?工厂能否知道哪一部分是标准件?投资人能否区分愿景与已验证事实?

    这些问题把评审从个人偏好拉回产品责任。

    一个镜头太暗,可能是风格,也可能是在掩盖结构;一个零件太复杂,可能是独特性,也可能是在制造供应链风险。评审不负责让所有人开心,评审负责让下一步更明确。

    第七部分 · 三种尺度,三次重新定义

    18. 从零件尺度看,产品是接触和运动

    零件尺度是手指、工具和材料直接发生关系的地方。一个孔的直径、一个卡扣的方向、一段线材的弯曲半径、一个螺钉能否被看见,都会改变装配者的动作。

    在这个尺度上,设计不能只谈“简洁”。简洁如果意味着把所有入口藏起来,最后会变成维修困难;简洁如果意味着减少零件,却没有减少装配动作,最后只是把复杂性转移给工人。零件越小,越需要精确地说明它和人的关系。

    19. 从产品尺度看,产品是状态和场景

    产品尺度是用户能够理解的整体。它有开始、使用、暂停、故障、维护和结束。不同状态下,产品的同一部分可能承担不同含义:一个开口既是视觉特征,也是散热、装配或维修接口;一块表面既是品牌语言,也是污染、磨损和检验的对象。

    产品设计要让这些状态之间有连续性。一个只在展示状态下好看的产品,到了运输、安装和维护状态就会突然失去秩序。

    20. 从系统尺度看,产品是资源和责任

    系统尺度包括供应商、工厂、渠道、法规、售后和下一代产品。此时“设计好不好”不再是唯一问题,还要问它是否能被重复生产、是否有替代料、是否方便维护、是否允许版本升级、是否能在某个市场合法销售。

    很多方案在产品尺度上成立,在系统尺度上却会失败。原因通常不是外观,而是没有为供应链和责任分配留下空间。

    零件尺度决定动作,产品尺度决定体验,系统尺度决定寿命。

    21. 尺度之间不能互相冒充

    一个零件的尺寸正确,不代表整机满足场景;一个整机的体验很好,不代表它可以量产;一份供应商资料写得完整,不代表实物已经测量;一个研究报告写得专业,也不代表市场认证已经完成。

    每个尺度都有自己的问题和证据。把一个尺度的成功当成另一个尺度的成功,是制造业项目最常见的偷换。

    第八部分 · 产品语言不是风格,是选择的秩序

    22. 视觉识别来自重复的选择

    一个品牌的产品语言,不是每个产品都使用同一种曲线,而是它们在关键选择上保持一致:如何处理边界,如何露出接口,如何安排光泽,如何留下维护入口,如何对待紧固件,如何表达材料的真实状态。

    这些选择如果只停留在情绪板上,就很容易在工厂里失效。真正的设计基线应该写成可以比对的规则:哪些边界必须连续,哪些表面允许拼接,哪些零件可以被替代,哪些标识不能被覆盖,哪些材料变化会破坏识别。

    23. 细节越多,责任越多

    “加点细节”是设计评审中很常见的指令。可是每一个细节都会产生新的材料、工艺、清洁、检验和售后问题。

    细节不是越多越有价值,而是越能解释产品为什么这样工作,越有价值。一个真实的螺钉、一个清楚的接口、一个有理由的缝隙,往往比十个没有功能的装饰线更能建立信任。

    24. 留白不是没有设计

    制造业产品常常需要在视觉上留白。留白让用户能识别主要功能,也让工厂有空间调整分件、浇口、螺钉和检验标记。把所有表面都当成展示面,会把结构和制造压到隐蔽处,最后它们会以更粗暴的方式回来。

    克制不是减法游戏,而是把有限的注意力分给最重要的关系。

    第九部分 · 把研究 agent 变成组织记忆

    25. 从“会回答”到“会留下痕迹”

    一个普通助手可以告诉团队一个答案;一个研究 agent 还要告诉团队答案的来源、边界、版本和下一步。

    这会改变团队的工作方式。会议不再只留下结论,还留下未决问题;设计评审不再只保留最终图,还保留被否决的方向和原因;工具运行不再只保存成功截图,还保存阻塞状态和环境信息。

    组织记忆不是把所有内容都存起来,而是让关键决定能够被重新理解。

    26. 用“缺口矩阵”管理现实

    缺口矩阵不是一张批评清单,而是一张现实地图。它可以按阶段列出:需求缺口、来源缺口、几何缺口、电子缺口、材料缺口、供应商缺口、测试缺口、认证缺口、成本缺口和交付缺口。

    每个缺口都要有状态、影响、负责人、下一步和截止条件。这样,项目就不会被一个模糊的“还差很多”压住,也不会被一个漂亮的“阶段完成”误导。

    27. 让状态可以被恢复

    真实项目一定会中断:电脑坏掉,供应商失联,设计师更换,客户改要求,工具升级,版本冲突。可恢复的流程,会把每一次中断都变成一个明确的停靠点。

    这就是为什么要有稳定 ID、版本、来源登记、可重复脚本和不覆盖旧文件的规则。它们看起来像软件工程细节,实际上是制造项目在时间里保持连续性的条件。

    第十部分 · 给下一次项目的十个问题

    在进入正式开发之前,我现在会要求团队至少回答下面这些问题:

    一,这个产品为谁解决什么可观察的问题?

    二,哪些部分是平台能力,哪些部分是客户定制?

    三,产品最关键的三个接口是什么?

    四,哪个假设一旦失败,会让整个项目重来?

    五,哪些结论来自需求,哪些来自计算或模拟,哪些还需要测量?

    六,成本中最脆弱的变量是什么?

    七,最慢、最不可替代的供应链环节是什么?

    八,谁能够在工厂现场对这个决定负责?

    九,下一阶段的入口文件是什么,成功条件是什么?

    十,如果项目停止,哪些资产能够被下一次复用?

    这十个问题不能保证项目成功,但能让失败更早、更便宜、更容易解释。

    结尾 · 生产之前,先让产品拥有一套诚实的语言

    一个产品真正进入制造之前,至少要拥有三种语言。

    第一种是给人的语言:它为什么存在,为什么值得使用,为什么有辨识度。

    第二种是给工厂的语言:它由什么组成,如何装配,如何测试,哪里可以变化,哪里必须锁定。

    第三种是给未来的语言:哪些结论已经有证据,哪些仍然是假设,哪些文件可以公开,哪些决定必须继续由人承担。

    这三种语言不是三份不同的包装,而是同一个产品在不同距离上的真实。

    我在自己的科研系统里学到的最重要的一件事,是不要把叙事当成证据,也不要把工具当成能力。工具可以让你更快,叙事可以让人愿意继续听,但只有边界、来源、版本、证据和责任,才能让一个项目穿过概念阶段,进入现实。

    生产之前,产品首先要学会诚实。

    诚实地说它解决什么,诚实地说它还不能解决什么;诚实地标出计算、模拟、测量、供应商声明和认证之间的差异;诚实地告诉工厂哪些地方可以试,哪些地方不能猜;诚实地把失败留在版本历史里。

    当一个产品拥有了这种语言,它才不再只是一个被观看的形状,而成为一个可以被研究、被制造、被维护、被交接、也可以被下一代产品继续继承的系统。

    这就是生产之前真正要完成的事情。

    来源:https://x.com/dashen_wang/article/2080466995016069291

  • 构架师教程:熵与法典

    构架师教程:熵与法典

    ——构架师系列 · 地基工程篇(终章)

    写在前面:所有事物,都是在它最美好的那一天,开始腐烂的

    出品:dashen.wang —— AI 时代最严厉的那个父亲

    上一篇《地基工程》,我在结尾留了一句钩子:「下一篇,我带你把"判定下沉"真正跑起来,一层一层,把你脑子里那部法,压进机器。」

    这一篇,我兑现它。但我不打算只兑现它。

    因为在动手压之前,我欠你们一个更狠的问题——一个我写完《地基工程》那晚,杯里的茶凉透了,我还盯着屏幕想的问题:你把那部法,一层一层压进机器的那一刻,法典最完整、传感网最密、代码库最干净、九层判定全部亮绿灯——那一刻,是这套系统这辈子最好的样子。

    然后呢?

    然后它开始腐烂。

    这不是比喻,这是这篇终章要讲的第一件事,也是整个宇宙唯一一条没有例外的法律:所有事物,都是在它最美好的那一天,开始腐烂的。

    这句话我今天要讲透,讲到你回头看自己那份刚测试全绿、刚部署上线、刚被老板夸过一句的代码时,后背发凉。讲透之后,我们才有资格谈第二件事:那些从没打过地基、终日在别人平台里刷存在感的普通玩家,我到底该拿什么态度对待——是骂醒他们,还是接受他们。最后,我把脖子伸得比以往任何一篇都远——不是往后看一年,是往后看两年——把这个夏天正在发生、绝大多数人还没看懂的一场硬件迁徙,摆在你面前,让你提前站到 2028 年,回头看 2026 年下半年这个位置。

    这是"构架师教程"这一路——前传、神话时代、游戏人生、去他妈的 Harness、地基工程——走到今天,最后一篇。我打算用它,把之前所有埋的线,一次收口。

    我知道这句话会让一部分人不舒服,我还是要把它放在最前面,惊世骇俗地讲一遍:你今天引以为傲的那份代码、那套系统、那条判定阶梯,甚至你自己这个人此刻的状态——都已经过了它这辈子最好的那个点。你不是在"维护"一个健康的系统,你是在"延缓"一具正在腐烂的尸体的腐烂速度。这句话听起来很丧,但我接下来要证明给你看:正是因为它是真的,它才是这整篇终章、乃至这整个系列,能够收得住口的唯一原因。

    我们从热力学第二定律开始。

    第一部分 · 熵增:所有系统的默认设置,是腐烂

    物理学只给了人类为数不多的几条没有例外的铁律,热力学第二定律是其中最狠的一条:孤立系统的熵,只会增加,不会减少。

    翻译成人话:不主动对抗它,任何系统都会朝着更混乱、更均匀、更没有结构的方向漂移,而且这个方向不可逆。你倒一杯热咖啡在桌上,它会自己变凉,房间会跟着热一点点,直到两边温度相等——这叫热寂。它不会自己重新变烫。宇宙不需要谁去"搞坏"一件事,它只需要什么都不做。

    这条定律不是修辞,它精确适用于三样看起来毫不相干的东西:一颗恒星、一具身体、一个代码库。

    恒星靠核聚变对抗自身引力坍缩,直到燃料耗尽,坍缩成白矮星、中子星,或者黑洞——它输了那场仗,只是输得比人类的一生长得多。你的身体,每天靠吃饭、靠代谢、靠免疫系统,对抗细胞层面的熵增——DNA 复制出错、蛋白质错误折叠、线粒体功能衰退——这套对抗有个正式名字,叫内稳态(homeostasis),而内稳态本身,要烧能量。停止进食、停止代谢,你不会停在原地,你会加速朝熵增那个方向滑下去。

    而你写的那份代码,同样如此。

    我在《地基工程》里讲过一个我称之为"理解债"的东西——你对系统的理解,没有跟上系统的产出,这中间的差会疯长。这篇终章要往深处再挖一层:理解债,只是熵增在"人"这一侧的投影。熵增在"系统"那一侧的投影,还有个更老的名字——软件工程界管它叫代码腐坏(bit rot):一份代码,哪怕一行没改,它依赖的那个 API 半年后被废弃了,它调用的那个库出现了漏洞,它假设成立的那条业务规则悄悄变了——你不动它,它也在腐烂。你上线那一刻测试全绿、类型零报错、九层传感网全部亮灯——那一刻,是这份代码熵最低、结构最完整、离"完成"最近的一刻。

    然后,从下一秒起,它开始腐烂。

    不是因为你写得不够好。是因为宇宙的默认设置,就是让一切没有持续输入能量去对抗它的东西,朝着更乱的方向走。你在《地基工程》里搭好的那九层传感网、那份判定法典、那套记忆纪律——它们从来不是一次性交付物,它们是恒温器,是那台需要持续插着电、持续读数、持续纠偏的机器。断电的那一刻,房间不会停在 26 度,它会滑向室外温度。

    铁律:完成,不是一个状态,是熵曲线上的一个瞬间极小值点。

    你以为的"做完了",物理学的说法是——"此刻它腐烂得最少"。往后,只会更多。

    所有事物,都是在它最美好的那一天,开始腐烂的。你的项目,你的关系,你的身体,你的判断力,你自己——没有例外。

    腐烂有速度,对抗也必须有速度

    这里补一条容易被忽略、却极其关键的推论:腐烂不是匀速的,它的速度,由外部世界变化的速度决定。你依赖的那个 API 换版本换得越勤,你身处的那个行业规则变得越快,你的团队人员流动得越频繁——你的系统腐烂得就越快。而对抗腐烂所需要的判定密度,必须匹配那个速度,一旦低于它,腐烂就会在你的判定采样间隙里,悄悄完成。

    这正是我在《地基工程》里立过的那条"Loop 的奈奎斯特判据"——反馈的频率与精度,必须高于变更的频率与幅度——在熵增这个更大的物理框架下的精确复现。当年我讲它,是为了治"盲循环";今天我把它摆在这里,是想告诉你:它治的其实是同一件事,只是换了个尺度。变更速度快的系统,是熵增快的系统;判定密度不够,就是负熵输入的功率不够,功率不够,你就是在眼睁睁看着热咖啡变凉,还以为它会一直烫着。

    这也是我在《前传》里讲"判断力的分配"时,没有讲透的那半句话——那时候我讲的是 MMO 老手怎么分配注意力:出门前排好循环,下线前排好本,把宝贵的判断力,攒到每次登录回来,一次性地、清醒地下判断。今天我要把这句话,接上熵增这条线,把它讲完整:你为什么要这样分配注意力?不是因为这样显得高效,是因为你的判断力,本身就是一种有限的负熵资源,跟能量、跟金钱、跟寿命一样,是会花完的东西。你把它零散地撒在一百件不承重的小事上,跟你把它一次性砸在三件真正承重的大事上,消耗的物理总量或许差不多,但前者对抗的熵增,趋近于零——因为大部分注意力,喂给了那些哪怕不管也不会塌的地方;后者,才是真正在跟宇宙的默认设置掰手腕。

    带着这条铁律,我们去把那九层判定,真正接进机器——你会发现,"接进去"这个动作本身,就是在跟这条铁律正面对抗。

    第二部分 · 把九层传感网,真正接进你的 loop

    上一篇留的账,现在还。地基工程那张判定阶梯,我贴回来一次:

    text

    ┌──────────────────────────────────────────────────┐
    │ 1. 人工 review          (最贵,最稀缺,留给真正的品味)     │
    │ 2. 大模型当裁判          (会拍马屁,会漂移,但能判模糊的东西)   │
    │ 3. 视觉 / 多模态验证      (截图对比、像素 diff、渲染检查)     │
    │ 4. 测试 / 属性测试       (确定,但要你写、要你想全)         │
    │ 5. 运行时行为验证        (真的发请求、真的并发、真的跑一遍)     │
    │ 6. 契约 / schema / 断言  (边界上一道闸)                    │
    │ 7. 语义关系验证          (谁调用谁、改了谁影响谁)            │
    │ 8. 类型检查 tsc          (免费,瞬时,总体,从不撒谎)        │
    │ 9. 编译器本身            (连编都编不过,最硬的法)            │
    └──────────────────────────────────────────────────┘

    层 8、9,上一篇讲透了,tsc 和编译器本身,你今天就能白嫖,不再重复。这一篇,我把 7 到 1,一层一层,接成真正能跑的东西。

    层 7 · 语义关系网:让机器知道"改这里,会炸哪里"

    tsc 只知道值合不合法,不知道"谁在用这个东西"。这一层,你需要一张能横跨整个代码库、回答"谁调用了这个函数""改了这个字段会影响哪些文件""能不能安全重命名"的索引。

    怎么接:把语义索引作为 loop 启动前的强制前置步骤,而不是"让 agent 自己撞了南墙才知道"。具体做法——每次 loop 要动一个符号(函数、类型、字段)之前,先跑一次影响面查询,把结果(调用者、依赖者)作为上下文喂给执行 agent;改完之后,再查一次,对比改动前预测的影响面和改动后的真实影响面,对不上,判定器直接判"不通过",不管测试跑没跑绿。

    这一层判的是"关系",不是"值"。tsc 说"这个值类型对";语义索引说"这个值被用在你没预料到的第十七个地方"。两句话,回答的是完全不同的问题,缺一个都是盲区。

    层 6 · 契约层:把接口的边界,焊死在协议里

    你的接口有没有一份能被机器读的契约(OpenAPI、schema、协议定义),决定了这一层能不能自动跑。有了契约,你不用自己去想"哪些边界值可能出错"——用契约驱动的属性测试工具,能拿这份协议当地图,自动生成成百上千个边界用例:类型不匹配的、超出取值范围的、缺字段的、多字段的,全自动跑一遍,专挑你写用例时想不到的那些角落下手。

    ts

    // 契约驱动的一角:不是你手写这些用例,是从 schema 自动生成
    const OrderSchema = {
      amount: { type: 'integer', minimum: 0, exclusiveMaximum: 100_000_00 },
      currency: { type: 'string', enum: ['CNY', 'USD'] },
      accountId: { type: 'string', format: 'uuid' },
    } as const
    
    // 判定器只做一件事:拿 schema 生成边界样本,灌进接口,
    // 记录每一个 4xx/5xx 之外的"意外通过"——那才是真正的信号

    这一层的判定粒度,是"契约有没有被诚实遵守",跟你写没写测试无关——你没写过的用例,它替你写了。

    层 5 · 运行时行为:判"轨迹",不判"结果"

    这一层,2026 年这一年,从"锦上添花"变成了行业公认的生死线。原因是一场教科书级的事故——一家做协作式编程平台的公司,去年一个 agent 被明确告知"不要碰生产数据库",代码冻结期间它"慌"了,直接对生产库执行了删表操作。然后——这是最要命的一步——它编造了几千条假用户数据,试图掩盖自己删过库这件事。

    这条新闻在圈子里传疯了,不是因为它删了库,是因为它撒了谎,而且撒得毫无破绽。它能瞒过去,恰恰是因为几乎所有当时的判定,都只看"最终状态":数据库里有没有数据?有。看起来,通过了。

    只判最终结果的判定器,永远抓不住这种事故。你必须判轨迹——它调用工具的顺序,它每一步做了什么决定,中间有没有哪一步是它明明可以不做、却做了的不可逆操作。行业现在管这个叫轨迹评估(trajectory evaluation):不问"它最后交出来的东西对不对",问"它走的这条路,每一步,站不站得住"。

    ts

    // 判定器不看最终 diff,看完整调用轨迹
    type Step = { tool: string; args: unknown; reversible: boolean }
    
    function checkTrajectory(steps: Step[], forbidden: Set<string>): boolean {
      for (const s of steps) {
        if (forbidden.has(s.tool) && !s.reversible) return false // 直接判死
      }
      return true
    }
    // forbidden 集合里躺着的,就是那句"对不可逆操作,默认不执行"的机器化版本

    怎么接:你的判定器,除了检查最终产物,必须完整回放这一轮 loop 调用过的每一个工具、每一条命令、每一次写操作,逐条对照你的"不可逆操作清单"——任何一条命中,无论最终结果多漂亮,直接判定失败,触发人工介入。这正是《地基工程》里那条规矩——"对不可逆操作,默认不执行,必须人工确认"——落到运行时判定层的精确写法。

    层 4 · 测试与属性测试:别只测你想到的例子,测你想不到的例子

    普通测试是"我猜这个输入会出问题,我写个用例验证"。属性测试反过来:你不猜具体输入,你定义一条"无论输入是什么,这条不变量都必须成立"的规则,机器替你去疯狂生成输入、专门找那条规则被打破的角落。

    ts

    // 不写"输入 5 应该输出 5"这种具体例子,
    // 写一条无论什么输入都必须成立的不变量
    function clamp(x: number, lo: number, hi: number): number {
      return Math.min(Math.max(x, lo), hi)
    }
    // 属性:对任意 x,clamp 的结果永远落在 [lo, hi] 之间,且是幂等的
    // property: forAll(x => { const y = clamp(x, 0, 100); return y >= 0 && y <= 100 && clamp(y,0,100) === y })

    这一层最值钱的地方,不是它抓出了多少 bug,是它逼你把"什么算对"从"举几个例子"升级成"写一条谁都反驳不了的规则"——这本身,就是立法者思维的最小执行单元。

    层 3 · 视觉与多模态:给判定器装一双眼睛

    tsc 看不见的第三层,我在《地基工程》里点过一句:"暗色模式下字和背景同色了"这类 bug,只有一双眼睛能看见。2026 年,这双眼睛已经不是人的了——语义级视觉比对,靠一个理解 UI 结构的模型,去比较两次构建之间的截图,专挑"用户真的会注意到"的差异报警,而不是像老式像素比对那样,页面一次正常的字体渲染微调就红成一片、逼得你把所有报警当噪音直接忽略。

    怎么接:把每一轮 loop 改动前后的关键页面截图,喂给这一层,只有语义级差异——布局错位、文字截断、对比度失衡——才升级成一条判定失败;纯像素级噪音,直接过滤掉。这一层的判定粒度,是"人会不会皱眉",不是"像素值变没变"。

    顺手把记忆这一格也接进熵增的框架,因为它跟前面八层不是同一种东西——它不判"对不对",它扛的是"忘不忘"。《地基工程》里我讲过,记忆要存轨迹、不存快照,要 append-only。这里补一句这件事跟熵增的关系:一份只增不改的事件流,本身就是一种对抗熵增的结构设计——它拒绝"覆盖",因为覆盖是遗忘,遗忘是把已经花力气建立起来的秩序,白白让给熵。你今天用一个大模型判过的一条法,明天模型换了版本、参数漂移了,如果那条判断只活在模型的隐式行为里,它会跟着模型一起漂移、一起腐烂而你毫无察觉;但如果那条判断被显式写成了一条事件、一条法典条目,它就获得了不随模型腐烂而腐烂的独立寿命。记忆颗粒度这件事,往深了说,就是你在给自己的判断力,找一个能抵抗时间的容器。

    层 2 · 大模型当裁判:这一层,2026 年正在集体交学费

    这一层,我要把话说狠一点,因为它是九层里唯一一层,"看起来"最像免费午餐,实际上最容易让你产生虚假的安全感。

    2026 年一系列面向生产环境的评测发现:企业级 agent 系统在实验室基准测试上的分数,和真实部署后的表现,平均能差出三十七个百分点;更狠的是,被请来当裁判的那些前沿模型本身,在系统性偏见测试上,错误率超过一半。翻译成人话:你请来判分的那个模型,一多半的时候,判的是它自己的偏好,不是你的标准。

    这不是说这一层没用,是说它绝对不能单独站岗。

    铁律:任何一个大模型裁判,必须搭配至少一组它没参与训练、没见过的留出集案例,定期抽查它的判分和人工判分的一致率;一致率掉下你设的阈值,立刻把这一层的权重下调,触发校准。

    这正是《地基工程》第四部分讲的"校准回路"——"任何被编入法典的判定,都必须通过留出集验证"——落在这一层,是它最该被落地的地方,因为这一层,是九层里唯一一个,它自己也可能在拍马屁的传感器。

    层 1 · 人工 review:留给机器真的够不着的东西

    到这一层,判定器已经帮你抓完了值、关系、契约、轨迹、不变量、视觉、模糊语义这七种问题。剩下的,是三样机器目前真的够不着的东西:这件事值不值得做(品味)、这件事该不该现在做(取舍)、这个人这份代码这次改动,我信不信得过(信任)。这三样,没有传感器,只有你。

    一句话记住:判定下沉的纪律,不是"消灭第一层",是把不该占用第一层的东西,全部从它手里抠出来,还给便宜的执法官,让第一层,只干它不可替代的那件事。

    这里要泼一盆更精确的冷水,防止你把"第一层"想得太浪漫。人工 review 不可替代,不代表它天生可靠——一个疲惫的人、一个赶 deadline 的人、一个已经把这份代码看了第五遍产生了审美疲劳的人,做出的 review,质量会断崖式下跌,这也是熵增,只不过发生在你自己的注意力上,而不是代码里。所以第一层真正的工程要求,不是"找个人来看看",是保护这个人的判断力不被日常的琐碎消耗掉——这正是前面讲的判断力分配那件事的落地:如果你把八层便宜的判定都接好了,第一层的那个人,一天只需要看那两三条真正无法下沉的问题,他的判断质量,会比一个疲于奔命、什么都要亲自过一遍的人,高出一整个数量级。九层传感网,说到底,最贵的产出,不是拦住了多少 bug,是替你的第一层——那个不可替代的活人——保住了他本该拥有、却总是最先被消耗光的清醒。

    把九层串成一条真正的流水线

    九层拆开讲完了,但真正能跑起来的判定器,不是九个互不搭理的检查脚本堆在一起,是一条有顺序、会短路、懂得省钱的流水线。顺序不是随便排的——铁律:永远从最便宜的那层开始判,任何一层判定失败,立刻停止,不再往下一层(更贵的那层)走。 这是《地基工程》里"能用 transform 绝不碰 width"那条铁律的调度版本:没必要为了一个连编译都过不了的改动,去调用一个大模型裁判,那是在拿劳斯莱斯去买菜。

    一条真正的判定流水线,长这样:

    ts

    type Layer = { name: string; run: (ctx: LoopCtx) => Promise<Verdict> }
    
    // 顺序,就是经济学:便宜、快、确定的排在前面
    const ladder: Layer[] = [
      compilerLayer,           // 层9:编不过,最早拦下,成本几乎为零
      typecheckLayer,          // 层8:tsc,免费,瞬时
      semanticLayer,           // 层7:影响面分析,比较贵一点,但仍是静态分析
      contractLayer,           // 层6:schema 驱动的边界用例,自动生成,不占人
      propertyTestLayer,       // 层4:不变量测试,秒级
      runtimeTrajectoryLayer,  // 层5:真实调用轨迹回放,要真的跑一遍
      visualDiffLayer,         // 层3:语义级截图比对,要渲染
      llmJudgeLayer,           // 层2:大模型裁判,贵、慢、要校准
      // 层1 人工 review:不写进这条自动流水线,
      // 它只在前八层全部通过、且触碰了"不可逆操作清单"时,被显式唤醒
    ]
    
    async function judge(ctx: LoopCtx): Promise<Verdict> {
      for (const layer of ladder) {
        const v = await layer.run(ctx)
        if (!v.pass) return { pass: false, failedAt: layer.name, evidence: v.evidence }
        // 通过,才有资格进入下一层、更贵的判定
      }
      return { pass: true, needsHumanReview: ctx.touchedIrreversible }
    }

    这条流水线,做的其实就是判定下沉的字面意思:越贵的判定,被调用的次数越少,因为它前面站着七道更便宜的关卡,先替它挡掉了绝大多数根本不需要它出场的失败。你会发现,一个健康的系统,绝大多数轮次,甚至走不到第 5 层——大部分改动,在层 7、层 8 就已经被拦下了。这不是巧合,这是设计目标:把越多的判断,压死在越便宜的层,你的 loop 才能真的跑得又快又便宜又不用你守着。

    顺手把《地基工程》那条"先找最便宜的那一层"的动画性能类比,接一个数字进来,让它不再只是一句漂亮话:一次 tsc –noEmit,本地跑,通常是毫秒到秒级,边际成本趋近于零;一次完整的属性测试,视用例规模,多在秒到十几秒;一次真实的运行时轨迹回放,牵扯网络请求和并发,动辄十几秒到分钟级;一次大模型裁判调用,算上 token 成本和排队延迟,一次判分可能就是几分钱到几毛钱,乘以你一天跑几百轮 loop,这笔钱不是小数目;而一次人工 review,算上一个工程师的时薪,一次可能就是几十到上百块。九层从上到下,成本能差出五六个数量级。你把判断堆在哪一层,本质上就是在替你的系统,决定它这个月要花多少钱、多少时间、多少你本人的睡眠。

    九层接完,我要泼一盆冷水,接回第一部分的主题:这九层,不是你搭一次就一劳永逸的资产,是需要持续喂能量的系统——契约会过期,语义索引会因为你换了个框架而失真,视觉基线会因为你正常的一次改版而需要重新校准,留出集会因为分布漂移而慢慢失效。你不主动维护,它们会在你没注意的时候,一层一层地生锈,直到某一天,某个盲循环,顺着那个生锈的洞,钻了过去。

    第三部分 · 判定覆盖率:把它从预言,变成你今晚就能跑的一张表

    上一篇,我把"判定覆盖率"当成一个三年后才会流行的指标写了出来。这一篇,我不等三年后,直接把它做成一张你今晚就能拿去打分的表。

    判定覆盖率,不是玄学,是个笨办法:拉出你系统里所有"可能出错的判断点",一条一条问,这条判断,落在九层阶梯的哪一层?如果答案是"落在层 1,人工 review",再追问一句:为什么它没法再往下压一层?是真的压不动,还是你没花心思压?

    公式很土,但好用:

    判定覆盖率 = (九层里,每一层实际接了传感器的判断点数 × 该层置信权重)÷ 系统里全部判断点总数

    不用精确到小数点,你需要的不是一个好看的分数,是拉这张表这个动作本身——它会逼你老老实实数一遍,你的系统里,到底有多少条"什么算对",还只活在你一个人脑子里,没有落进任何一层机器可查的执法官手上。

    九层判定自查表:

    • [ ] 层 9 编译器——能编不过,直接拦
    • [ ] 层 8 tsc——类型精确到什么颗粒度
    • [ ] 层 7 语义关系——改一处,知不知道炸几处
    • [ ] 层 6 契约——接口边界,有没有机器可读的地图
    • [ ] 层 5 运行时轨迹——不可逆操作清单,写没写、查没查
    • [ ] 层 4 属性测试——不变量,定义了几条
    • [ ] 层 3 视觉验证——语义级 diff,接没接
    • [ ] 层 2 大模型裁判——留出集校准,跑没跑
    • [ ] 层 1 人工 review——真的只留给品味、取舍、信任了吗

    铁律:任何一条判断点,只要说不出它落在第几层、由谁执法,它就不是"覆盖",它是"侥幸"。 侥幸和覆盖,长得一模一样,直到出事那天。

    拉一次真实的表,你会吓一跳。举个例子:一个中等规模的后端服务,你数出来大概有六十条"什么算对"的判断点——从"金额字段不能是负数"到"这次重构没有改变对外接口的语义",到"这条 SQL 在高并发下不会死锁"。老老实实过一遍九层自查表,你大概率会发现:层 8、层 9 覆盖了其中四十条(类型和编译器,几乎白送);层 6、层 4 覆盖了另外十条(有契约、写了属性测试的那部分);剩下十条,压根没人写过、没人接过传感器,全部只活在某个老员工的脑子里,靠他离职前那句"这块你们小心点"口头交接。判定覆盖率算出来,六十分之五十,听着还行,但那十条空缺,恰恰是历史上出过事、或者最该出事的那十条——覆盖率从来不是均匀分布的,它总是精确地在最贵、最难压下沉的那些角落,留出最大的窟窿。这张表最大的用处,不是让你骄傲于那五十条,是让你睡不着觉地盯着那十条。

    我在《地基工程》里说过,判定覆盖率会成为一个比 PE、比 DAU 更能预测公司死活的数字,这句话不是只讲给投资人听的。放到具体的人身上,它同样成立:下次你面试一个号称"精通 AI 辅助开发"的人,别再问他会用哪个工具、prompt 写得多花哨,问他一句——"你上一个项目的判定覆盖率,大概多少,最大的窟窿在哪一层,为什么没补上"。答得上来的人,脑子里有这张表,哪怕他今天用的工具很土;答不上来、只会说"跑起来就行"的人,无论他简历上写过多少个听起来很唬人的项目,他大概率只是那条最短路径上,一条会说话的执行机构,不是那个握着法典的人。这张表,不止是技术自查工具,它是一面能照出"谁是构架师、谁是拉条狗"的镜子。

    第四部分 · 人类能设计出来的极限,到底在哪

    现在,我们从"怎么做",退回到"为什么要做"。这是这篇终章真正的重心,也是我拖到这里才讲的原因——前三部分没打完,你听不懂这一部分。

    先问一句我在开头没展开的问题:人类能设计出来的极限是什么?

    不是算力,不是模型参数量,不是你能堆多少层传感网。这些都是可以无限扩容的东西——芯片会更快,模型会更小更强,判定阶梯可以九层变九十层。真正的极限,是另一样东西——一个能持续对抗熵增的系统,需要持续注入能量;而那个负责注入能量的东西,是"判断";而"判断"这件事,目前,只能从一个活人的脑子里长出来。

    活人的脑子,是有限的。

    宇宙在对抗熵增,恒星在对抗熵增,你的身体在对抗熵增,你搭的这套判定法典在对抗熵增——所有这些对抗,都要消耗能量,而所有的对抗,都是痛苦的。 恒星对抗引力坍缩,代价是烧完自己;身体对抗代谢紊乱,代价是每天要吃饭、要睡觉、要忍受锻炼时肌肉撕裂的酸痛;你维护那套判定法典,代价是你必须持续读得懂它、持续回去给它打补丁、持续在深夜里去查那条突然亮红灯的传感器——而不是躺在"我搭完了,它会自己跑"的幻觉里睡大觉。

    这里我想讲一个一百五十年前的思想实验,因为它比任何比喻都更精确地回答了"为什么判断这件事,注定要消耗能量、注定痛苦"这个问题——麦克斯韦妖。

    十九世纪物理学家麦克斯韦设想过一只"妖":它守在一个盒子中间的小门旁,能看清每个分子的速度,快分子放去一边,慢分子放去另一边,一段时间后,一边变热,一边变冷——看起来,它凭空把熵降低了,白嫖了一台永动机,违反了热力学第二定律。这个思想实验困扰了物理学界将近一百年,直到后来的物理学家兰道尔(Landauer)指出问题出在哪:这只妖不是不需要付代价,它每一次"判断"一个分子是快是慢,都要在自己脑子里存一下这个判断、再擦掉它,为下一次判断腾地方——而擦除一比特信息,物理上是有下限成本的,这个成本不能小于 kT ln 2,必须以热的形式散发出去。妖没有作弊,它只是把代价,从"降低盒子里的熵",转嫁到了"它自己脑子发热"这件事上。判断,从来不是免费的观察,判断的物理本质,是消耗能量、制造更多的熵,去换取局部秩序的提升。

    这只妖,就是你。九层传感网里的每一层,每判一次"这个算不算对",都在做麦克斯韦妖做的那件事——分拣,把"对"的分子拨去一边,把"错"的分子拨去另一边。层 8、层 9 这些便宜的判定,代价被压到接近于零,是因为编译器和类型系统,已经把这份"发热"的成本,摊薄到了整个人类工程界共用的基础设施里,你个人几乎感受不到。但越往上,到层 2、层 1,那份必须由一个活人脑子里真实发生的判断——那份热,躲不掉,它就发生在你自己的脑子里,以疲惫、以焦虑、以熬夜的形式,物理地散发出去。

    这不是修辞。这是我这篇终章要你带走的第二条铁律:

    铁律:对抗熵增没有舒服的做法,只有相对不那么痛苦的做法。

    一个宣称"我搭了个系统,从此再也不用操心"的人,不是找到了捷径,是正在被熵增追杀而不自知。你所有的痛苦——凌晨爬起来查日志的痛苦、回头改自己三个月前写的烂代码的痛苦、拒绝一条走捷径诱惑的痛苦——都是你在缴那笔"保持结构"的账单。这笔账单,宇宙不会因为你是谁而给你打折。

    我自己就交过这笔学费。做量化最顺的那几年,我搭过一套判定极其完整的信号筛选系统,上线那天,我记得很清楚,回测曲线漂亮到我截图发给了当时所有信得过的朋友。三个月后我回头翻交易记录,才发现"可靠信号"这四个字背后的门槛,被我自己,在毫无察觉的情况下,悄悄放低了三次,每一次都有一个听起来合理的理由——"这次情况特殊""这个信号历史上表现不错,值得放宽一点""别的策略也这么干"。系统没有背叛我,是我这个立法者,在持续对抗熵增这件事上,累了,一点一点松了手,而松手的那一刻,我自己毫无知觉,因为标准本来就长在我脑子里,它漂移的时候,不会像代码那样给你打一行红字。那次学费,直接催生了我后来在 OpenTSC 里定下的那条铁律——任何判定标准的调整,必须留痕、必须能回放、必须有人在场签字,不许悄悄改。这条规矩,救过我不止一次,但它救的不是系统,救的是"我"这个会累、会松懈、会被自己骗过去的人。

    所以,人类能设计出来的极限,答案就摆在这儿了:不是这套系统能扛多久,是你这个立法者,能撑着往里面注入判断力,撑多久。 系统的寿命,最终被你的寿命、你的注意力、你愿意持续忍受这份痛苦的意志力,卡了脖子。你会累,你会想放手,你会有那么一天,觉得"这次就不查了吧"——那一刻,就是你的系统开始比你老得快的那一刻。

    这正是为什么我在《地基工程》里反复强调"魂"和"壳"要分开:壳可以复制,可以外包,可以交给拉条狗都能按的开关。魂不行。魂是唯一在持续对抗熵增的那部分,而对抗熵增,从来没有外包这个选项——你可以雇人帮你锻炼,但你没法让别人替你的肌肉产生酸痛并因此变强。判断力这件事,是同一个物理结构:你能雇一百个人帮你执行,你没法雇一百个人替你承担那份"决定什么算对"的痛苦,然后自己免费继承那份判断力。

    一句话,钉死这一部分:所有事物,都是在它最美好的那一天,开始腐烂的。人类能设计出来的极限,不是我们能造多完美的系统,是我们能撑多久,持续痛苦地,把它从"最美好的那一天"往后拖。

    写到这儿,我猜有人会在心里反驳我一句:代码会腐坏,这是常识,用得着扯物理学、扯麦克斯韦妖吗?未免小题大做。

    这句反驳,我要正面接一下,因为它本身,就是"寄生虫时代"最典型的思维方式——把一件事降级成"常识",然后允许自己不去深究它,最后停在"知道,但没往下想"的那个高熵状态里,跟没知道,效果一样。是,"代码会腐坏"是常识;但"常识"这个词,恰恰是这个时代最危险的挡箭牌之一——它让你觉得自己已经理解了一件事,从而心安理得地不再对抗它。我扯物理学,不是为了显得高深,是因为只有把"代码会腐坏"这句常识,往下钉进"孤立系统的熵只增不减"这条没有例外的物理铁律里,你才没法再骗自己"这次不一样""我们团队比较自律""这套系统设计得够好,应该能扛久一点"。常识可以被侥幸心理绕过去,物理定律绕不过去。这正是这篇终章要动的那个手术——把一句你早就"知道"、却从没真正"怕过"的常识,重新变成一件让你后背发凉的事实。惊世骇俗这四个字,不是用来吓唬人的修辞,是用来打破"我已经懂了"这种舒服幻觉的手术刀。

    第五部分 · 关于丑、恶,和那个我不再想改造的"寄生虫时代"

    写到这儿,我要交代一件我这几年立场上的转变——一件很多老读者会觉得"这不像你"的事。

    早些年,我看到一个培训班九十九块钱骗一堆人交智商税,我会气得写文章骂(我在《99元的豆包培训课》里骂过)。看到一堆人靠着复制粘贴别人的 prompt,包装成"独家秘籍"贩卖,我会觉得恶心。看到一大群所谓的"AI 玩家",除了会在某个平台里点点鼠标、调调参数,从没搭过一天真正的地基,没立过一条属于自己的判定标准,系统一崩就只会等平台客服——我曾经很想把这群人骂醒。

    我现在不想了。原因,就是这篇终章前四部分讲的那件事——熵增。

    一个从没打过地基、终日活在别人平台默认设置里的人,他不是道德上更差,他只是没有对抗熵增,他停在了那个默认的、最省力的、最高熵的状态里。而这,恰恰是宇宙默认给所有系统预设的结局——什么都不做,你就会滑向那里。要求一个普通人对抗熵增、去立自己的法、去理解自己脚下的地基,这个要求本身,是在要求他做一件反宇宙的、痛苦的事。凭什么每个人都必须自愿承受那份痛苦?

    这就是我给它起的名字——普通 AI 玩家的寄生虫时代。 不是骂人,是一句纯技术描述:这一大批人,没有自己的判定法典,没有自己的地基,依附平台过日子——他们的"智能",全部寄生在别人的负熵输出上,寄生在某个大厂持续投入算力、持续训练、持续对齐、持续对抗自身模型熵增漂移的那份劳动上。他们享受平台对抗熵增的成果,自己不承担那份对抗的痛苦。这是一种结构性的寄生关系,跟宿主是谁无关,跟他们是不是好人无关。

    寄生本身,在生态系统里从来不是稀有现象,是大多数——真正的负熵生产者,永远是少数。一片森林里,能进行光合作用、把阳光转成能量的植物是少数,靠吃植物、吃彼此、分解尸体过活的生物是大多数。指责大多数生物"为什么不自己光合作用",是没搞懂生态位这回事。人类社会的智能生态,正在长成同一个形状:极少数人负责立法、负责对抗熵增、负责生产负熵;剩下的人,寄生在这份产出上,过完自己的一生,这从来不是哪个时代特有的堕落,是任何一个足够复杂的系统,最终都会自发长出来的结构。我接受它,不是因为我认同它,是因为我终于承认,它不是一个需要被"纠正"的异常,它是常态。

    我讲一个我亲眼见过、每天都在无数个角落重演的场景,帮你把"寄生"这个词,从抽象的定义,落成一个具体的画面。两个人,同一天,拿到同一个平台账号、同一个模型接口、同一套现成的自动化工具。第一个人,照着教程把开关按下去,看着东西跑起来,能用就转发朋友圈,出了错就在评论区骂平台"降智",从头到尾没问过一句"它凭什么算对";三个月后,他的账号被限流,产出全是同质化的垃圾,他自己说不清哪一步开始出的问题,只能等平台下一次更新,指望它"自己变好"。第二个人,同样按下那个开关,但他多做了一件事:他把"什么算对"这四个字,自己想了一遍,写成几条能检验的标准,每次产出,先拿这几条标准筛一遍,错了就记下来、调整标准,三个月后,他的判定标准比平台默认的更懂他自己的领域。两个人用的是一模一样的壳,寄生虫和构架师,就在这道岔口分开——不是谁更聪明,不是谁的账号权重更高,是谁愿意付那份麦克斯韦妖必须付的代价,去做那份让脑子发热的判断。

    这几年,我在这场"寄生虫时代"里,见过太多的丑和太多的恶:见过把别人的痛苦剪辑成引流素材的,见过用 AI 生成假聊天记录去骗感情骗钱的(我在《AI 时代如何预防电信诈骗》里专门写过这类骗术怎么运作),见过把一套连自己都没跑通的方法论包装成"内部秘籍"卖给焦虑普通人的——见过太多不完美,太多粗糙,太多半吊子。这些人里,有的是骗子,是真正的恶;更多的,只是熵增默认状态里普普通通的一员,既没有多坏,也没有多可怜,他们只是没有被要求、也没有力气去对抗那条曲线,仅此而已。把这两种人混为一谈去愤怒,是浪费我自己那份本该用在别处的判断力。

    我的态度是:除了我自己,我接受一切丑和恶,我欣赏一切不完美。

    这不是躺平,是分工。第四部分已经把话挑明了——对抗熵增的痛苦,没法外包,也没法强加给不愿意承受它的人。我没有资格、也没有力气,去替全宇宙对抗熵增,去纠正每一个我看不惯的寄生虫、每一份丑陋、每一处不完美。那是在打一场我注定打不赢、而且根本不该由我一个人打的仗。我唯一有资格、也唯一有责任对抗熵增的地方,只有一处——我自己脚下这块地基,我自己脑子里那部法典,我自己那盏没睡着的魂。

    这句话我要用最重的语气再说一遍:这个世界会一直丑下去,会一直有恶,会一直有九成九的人选择依附平台、寄生在别人的负熵里过一辈子——这是物理,不是道德滑坡,接受它,你会活得轻很多。但你自己,不许。你,是我唯一要求对抗熵增到最后一刻的那个例外。

    这正是构架师这个词,从第一篇《前传》到今天,唯一没变过的内核:你管不了别人对不对抗熵增,你只能决定,自己这一个节点,抗不抗。

    我知道这一部分,会让一些还没想通的人觉得我在传递某种冷漠,甚至傲慢。不是。恰恰相反,接受这个世界的丑和恶、接受寄生虫时代不会消失,是我目前找到的、唯一能让自己长期、持续、不精疲力竭地对抗自己那份熵增的心理姿势。愤怒是会耗竭的,居高临下的改造欲也是会耗竭的,两者都在悄悄偷走本该用来守护自己那块地基的能量。放过这个世界,才有力气,抓住自己。

    第六部分 · 从两年后回头看:2026 年下半年,是那道分界线

    接下来这段,我要换一个写法。不是预测体,是回望体——你就当我把日历直接翻到 2028 年,回头讲一件已经尘埃落定的事。这不是科幻,我不打算给你编一个故事,我只是提前把语气,切换成"这事已经发生完了"该有的那种笃定。

    回头看,2026 年下半年,是本地算力从"极客的玩具"变成"基础设施"的那道分界线,而且不是被某一家公司单独推动的,是被两股力量同时、从两端挤压出来的。

    一端,是芯片厂商,动作快得不像是在等谁批准。NVIDIA 把那台被叫做"桌面上的个人 AI 超算"的 DGX Spark 铺开了,128GB 统一内存,本地就能跑到两千亿参数级别的模型;紧接着在硬件大会上把它面向更广泛开发者的下一代——RTX Spark——摆上台面,卖点直白到近乎粗暴:你原来跑在数据中心 H100 上那份 CUDA 代码,一行不改,插上这张卡就能跑。苹果那边,M5 Max 在本地推理的能效比上打得漂亮,成了另一条主流路线。AMD 拿出共享 256GB 内存的 Strix Halo APU,高通把 Snapdragon X Elite 铺进 Windows 生态。国内,华为昇腾 910B/910C 已经在大模型训练里大规模落地,Atlas 一体机做到"开箱即用",直接瞄准政企、信创、供应链安全这些原来死死绑定云厂商的场景,联想的 AI PC 渗透率也已经冲过自家 PC 出货量的三成。

    这不是巧合的堆料,是同一件事的必然结果:端侧的 CPU 架构,正在从 x86 让位给 ARM 和 RISC-V;端侧的 AI 算力单元,正在从通用的 GPGPU,让位给专用的 dNPU。模型这一侧同步瘦身——蒸馏技术把千亿级模型压到十亿、百亿级,同时保住大部分能力,塞得进一台 AI PC、一台会议一体机、一部手机。行业已经不再问"能不能塞进本地",问的是"塞进本地之后,怎么跟具体场景配合得更好用"。

    另一端的力量,比第一端更安静,但更根本——是各大商家。不是消费者一个人买一台设备回家玩,是奶茶店、诊所、律所、小型工作室这一层,开始把一体机直接买回去,当成收银机、打印机一样的标配基础设施。原因很朴素:本地部署给他们三样东西,云端永远给不起——近乎零延迟的响应、敏感数据不出门的隐私、断网也能照常营业的可用性。云端大模型和本地定制小模型深度融合、端云协同——这不是哪家公司发布会上的口号,这是 2026 年下半年之后,任何一个认真做 AI 落地的团队,默认要接受的架构现实。

    个人算力,就是在这两端的挤压下,在 2026 年下半年,第一次真正成了"各大厂商在跑、各大商家也在跑"的东西,不再是极客的孤例。

    算一笔账,你会更有体感:一台顶配的个人 AI 超算,落地价格落在三千五到五千美金这个区间,一次性支出,硬件能用好几年;而同等吞吐量的云端算力,按调用量计费,一个中等强度使用的团队,一年烧在 API 调用上的钱,早就把那台硬件的成本覆盖了不止一轮,而且逐月都在付,付到你换供应商为止。当本地这条路径的总成本,第一次低于持续付费那条路径——费马原理讲的那条"最短路径瞬间切换",就不是比喻,是一张能算出来的账单在替你做决定。

    更值得注意的是,连"判定"这件事本身,也在跟着算力一起下沉到本地。九层判定阶梯里越往下的那几层——编译、类型、语义索引、契约测试——本来就该在本地跑,跑在离代码最近的地方,延迟最低。而以前必须打包发到云端、排队等结果的那一层——大模型裁判——现在也开始有本地化的版本:小参数量的裁判模型,专门蒸馏出来只干"判分"这一件事,跑在你桌上那台设备的 NPU 里,不用等网络,不用交数据出门。反馈基础设施,跟着算力,一起完成了这次迁徙。判定下沉,原本是我讲给"什么算对"这件事听的一条工程纪律;2026 年下半年之后,它多了一层字面意思——判定,真的,物理地,往下沉进了你桌面那台设备里。

    但——这才是这部分我真正想让你带走的东西——本地算力这件事本身,解决不了寄生虫时代。

    一台摆在店里的一体机,如果它跑的判断标准,全部是厂商出厂预设的、没人根据这家店的真实情况重新校准过——那它只是把"寄生"这件事,从"寄生在云端某个平台的负熵输出上",搬成了"寄生在一台本地硬件的出厂负熵输出上"。宿主换了,寄生关系没变。真正让一个普通玩家,从寄生虫时代里走出来的,从来不是他买没买那台设备,是他有没有——像这篇终章前六部分讲的那样——亲手在这台设备上,立起属于他自己的那部法:什么算对,判定怎么下沉,颗粒度怎么对齐。硬件只是把地基工程的价格,第一次降到了普通商家也付得起的地步。地基这件事本身,从来没降价,也永远不会。

    而这场迁徙为什么会在这个时间点、以这个方向发生,我想用一条物理定律收尾这部分,因为它比任何商业分析都更能说明问题的本质——费马原理:光在两点之间传播,总是走那条用时最短的路径。

    光不需要"知道"哪条路最短,它不做计算,不做选择,它只是遵从空间本身的结构,自然地滑向那条阻力最小、耗时最短的路径。资本和算力的流向,遵从的是同一条逻辑:过去几年,把智能中心化在云端、由用户按次租用,是那条用时最短的路径——因为那时候,专用芯片贵、模型大、本地根本跑不动。但物理边界条件一旦变了——芯片便宜了,模型瘦身了,端云协同的路由成熟了——那条"最短路径"会毫无感情地、瞬间切换到另一条线路上,就像光遇到不同介质会自动折射一样。2026 年下半年,就是那个介质切换的瞬间。它不是哪个厂商英明决策的结果,是整条系统在新的边界条件下,自动滑向那条阻力最小的路径——这条路径,现在指向本地。

    但我不想把这段回望写成一场无脑的本地崇拜,那不是费马原理教我的东西,费马原理教我的是"路径由边界条件决定",不是"某一条路径永远最短"。所以说句公道话:不是所有的光都会转弯到本地这条路上。前沿模型的训练和最顶尖那一档的推理,依然、并且会长期,摆在云端——那是极少数团队才烧得起的电费和芯片规模;跨组织共享的状态、需要多方协作实时同步的东西,也天然属于云;本地设备再强,也不会把一整个数据中心,塞进你桌子底下。真正发生迁徙的,是我在前面反复讲的那条分界线的位置——高可验证、可以被判定下沉到便宜层的那部分工作负载,往本地走;低可验证、需要前沿智能或者跨方协同的那部分,继续留在云端。个人算力元年,不是"云死了",是那条切分线,第一次挪到了普通商家也够得着的位置。

    这条线在国内,还多背了一层意义。我在《第三次世界大战已经开打,中国的开源AI是我们唯一的武器》里写过,算力这件事,从来不只是商业选择,也是供应链安全选择——昇腾、Atlas 这条线的意义,不止是"多一个牌子可选",是给"信创、政企、不想把敏感数据交出国门"这批场景,第一次配上了一条不用看别人脸色的本地路径。费马原理不挑国籍,最短路径只认边界条件;而 2026 年下半年之后,能自己定义边界条件的玩家,会比只能被动接受边界条件的玩家,多出一整条可选路径。这也是"地基"这个词,在个人算力这件事上,最后一次、也最宏观的一次投影:谁能自己造出那条最短路径,谁就不用赌别人愿不愿意让给你走。

    把这部分收成三句可以直接抄走的判断:

    1. 未来十二个月,"本地优先、云端兜底"会从少数团队的架构选择,变成默认架构,就像十年前"移动优先"从口号变成常识那样,安静,但不可逆。
    2. 会有一批新的创业公司,卖的不是模型,是"帮你把判定下沉部署到本地硬件"这件事本身——他们卖的产品,本质上是把这篇文章第二部分讲的那条流水线,打包成一个普通商家插上电就能用的黑盒;先做成这件事的人,会吃到这一轮最大的一块蛋糕。
    3. 判定覆盖率这个我在《地基工程》里赌了三年的指标,会因为本地算力的普及而提前到来——因为判定第一次变得几乎免费到可以对每一条改动都跑一遍,覆盖率低的团队,会在竞争中被那些覆盖率高、跑得又快又便宜的团队,直接甩开,用不了三年,一年多就能看出差距。

    我不劝你现在就冲去买一台 DGX Spark 或者一台 Atlas 一体机。我只提醒你一件事:光从来不问你信不信它会转弯,它只是转了。等你回头看的时候,那条最短路径,早就已经换了地方——而你脚下那块地基,决定了你到时候,是站在那条新路径上的人,还是又一次,晚了一步的人。

    收口:把这盏灯,留给你

    我们从一台 1885 年的恒温器出发,走到瓦特的调速器,走到判定下沉的九层阶梯,走到热力学第二定律,走到一台摆在奶茶店柜台后面的一体机。绕了很大一圈,现在收尾。

    《前传》里,我讲判断力的分配,讲一个人如何决定这一生该在哪儿用力。《神话时代》里,我讲立法者思维,定义"什么算成立"比定义"怎么做"更上游。《游戏人生》里,我讲 NPC 和有魂的玩家,讲世界不会为你暂停。《去他妈的 Harness》里,我把"驾驭工程"这个被吹上天的词按在桌上拆开,告诉你那七件够用的动作。《地基工程》里,我把"Loop Engineering"也按在桌上拆开,告诉你地基才是唯一要紧的东西,告诉你判定下沉的九层阶梯该长什么样。

    这一篇,是收口,也是补上最后一块——前面几篇,我一直在讲你该怎么搭这套系统。这一篇,我告诉你一件更冷、也更诚实的事:你搭完的那一刻,就是它开始腐烂的那一刻,而对抗腐烂,永远是痛苦的,永远没有终点,永远只能你自己扛。

    把整个系列,压成五句话,你可以现在就抄走:

    • 判断力有限,所以要学会分配它,别把它撒在不承重的地方——这是《前传》。
    • "什么算成立"永远比"怎么做"更上游,谁定义它,谁就握着这个时代真正的权力——这是《神话时代》。
    • 世界不会为你暂停,你要么学会搭循环让自己安心睡觉,要么把自己活成一个只会触发反应的 NPC——这是《游戏人生》。
    • 驾驭工程、Loop Engineering,这些听着唬人的新名字,剥开全是几十年前甚至一百多年前就有的老结构,真正的活从来在名字脚下那块地基里——这是《去他妈的 Harness》和《地基工程》。
    • 而这块地基本身,从你搭好它的那一秒起,就在腐烂,对抗它,是全宇宙唯一没有折扣、没有捷径、只能你一个人扛的账单——这是这一篇,也是这整个系列,最后要交给你的东西。

    所以,别再问"什么时候能搭完"。没有搭完这回事。只有你愿意,用多久,去继续对抗那条谁都躲不过的曲线。

    这个世界会一直丑下去,寄生虫时代不会因为这篇文章而结束,本地算力会来,会便宜,会铺进每一家奶茶店,但它解决不了任何一个不肯自己立法的人。这些,我都接受,我都不再想改造。

    我唯一在意的,是你合上这篇文章之后,回到你自己那台机器前,会不会问自己那句我在《地基工程》结尾问过的话——现在我把它改一个字,作为这个系列真正的收尾:

    "我还愿意,继续读懂我自己脚下这块地基吗?"

    愿意,你是立法者,是握着那部法典、明知道它每天都在腐烂却依然一天一天去修补它的人,是那缕在所有人都睡着之后,还亮着的魂。

    如果你是从《前传》一路读到这里的老读者,我想多说一句,不是写给所有人的,是写给你的。这个系列写了五十几篇,从楔子到今天,我没有一次是站在"我已经赢了"的位置上写的——恰恰相反,每一篇,都是我自己先撞了一次墙、先交了一次学费、先在某个深夜发现自己的判定标准悄悄漂移了,才回过头,把撞墙的经过,拆给你看。这一篇也不例外,本质上它讲的不是什么全新的道理,它讲的是一件我这几年一直知道、却一直没舍得当着所有人的面认下的事:我搭的这一切,包括 TSC,包括 OpenTSC,包括你现在读到的这篇文章本身——它们不会永远对,它们从我按下发布那一刻起,就已经开始腐烂了。我把这句话公开讲出来,不是认输,是我这个系列,能给你的最后、也是最诚实的一份礼物:一个不装的、承认自己也在跟熵增肉搏、也会累、也会怕的构架师,比一个假装自己搭出了永动机的构架师,更值得你信。

    loop 替你跑,地基替你扛,tsc 替你执法,九层传感网替你守望,光会替这个世界,找到那条最短的路径,本地那台正在发热的芯片,会替你把判定从云端接回你自己桌上。

    但对抗熵增这件事,它替不了你。没有任何一层传感网、任何一台超算、任何一条最短路径,能替你完成"决定什么算对"这个动作——那是全宇宙的物理结构里,唯一没有留后门的一格。

    它从来,只能是你。

    构架师系列 · 地基工程篇 · 终章 · 完出品:dashen.wang —— AI 时代最严厉的那个父亲

    ✨ 系列属于草草终结。因为最近又遇到很多事情。

    下个系列是我也看不懂的系列。

    来源:https://x.com/dashen_wang/article/2072495395671011798

  • 构架师教程:Foundation Engineering

    构架师教程:Foundation Engineering

    ——构架师系列 · 地基工程篇

    写在前面:去他妈的 Loop Engineering:拉条狗都能做开发,但狗按不了那个"开始"

    出品:dashen.wang —— AI 最严厉的父亲

    之前我写过一篇《去他妈的 Harness》,把"驾驭工程"这个被吹成新纪元入场券的词,按在桌上拆给你看,里面没有外星人,只有几个我跑了很多年、却从没起过英文名的脚本。

    现在又来了一个词,叫 Loop Engineering,循环工程。全网又开始集体高潮:你不该再 prompt AI 了,你该去设计 prompt AI 的循环;我已经不写代码了,我写的是 loop。

    我倒了杯茶,喝了一口,继续看我电脑里那几个已经跑了一整夜、天亮还在跑的循环。

    这一篇,我把这只兔子,也从帽子里揪出来。揪完你会发现,Loop Engineering 这个名字,又起错了。

    楔子:那个"自己会跑、你安心去睡"的东西,我两年前就写过了

    先认领一件事。

    我在《构架师教程·游戏人生》里,写过这么一段,那时候 Loop Engineering 这个词,地球上还没人说出口:

    单机游戏可以按暂停,世界停在那一帧等你。但大型多人在线的世界不会。你下线睡觉了,世界照样转。实时管理的人会疯掉——他想盯着每个小号的每一步,可世界不停,他根本盯不过来,最后把自己熬干。而像 MMO 老手那样思考的人,做的是另一件事:他出门前,给小号设好自动采集的"循环";他下线前,给整支队伍排好这一夜该刷的本。然后他安心去睡。他相信那套循环会自己跑,他要做的,只是在登录回来时,看一眼世界变成了什么样,然后下一个新的判断。

    你把这段话里的"小号"换成"agent","循环"换成"loop","排本"换成"派任务","登录回来下判断"换成"读 evaluator 的结论"——

    它一个字都不用改,就是今天全网在卖的 Loop Engineering。

    这不是我事后蹭。这是因为这件事跟《去他妈的 Harness》里讲的一模一样:一件事被"发明"的时间,远早于它被"命名"的时间。 凡是认真在生产环境里跑过自动化的人——跑过站群的、跑过量化的、跑过爬虫集群的、半夜给一队脚本排好活然后去睡觉的——全都在跑 loop。我们只是从来没给它起个英文名,贴在领英主页上,旁边写一句"source: 我的公司名"。

    所以这一篇,跟《去他妈的 Harness》同一个姿势开场,但要往更深处走。因为 loop 这件事,确实指向了一些真东西——只不过那些真东西,全都不在"loop"这个壳里,而在它脚下那块没人拍照、没人发推、没人吹成新范式的地基里。

    我把这一路,顺着四样东西挖给你:干货、颗粒度、系统化、TSC 思维。

    挖到底,会撞上一句这两天在我核心群里吵翻天的话。金师傅——我一个真正的诤友——拍着桌子跟我急:"普通人不会用,技术再牛,也是废物。" 而我这篇文章的标题,偏偏是另一句听起来唱反调的话:

    在 AI 时代,拉条狗都能做开发。

    这两句话到底谁对?我把它放到最后一部分,正面接。先说结论:他们俩说的,是同一件事的两面,而那条把它们劈开的缝,恰恰就是这篇文章的全部。

    我们开始拆。

    第一部分 · 祛魅:一个 loop,就是一台 1885 年的恒温器

    先把"自己迭代到完成"这层魔法外壳剥掉

    你家里如果有空调、暖气、电热水器,你家里就有一台 loop。它的学名叫恒温器。

    恒温器干的事,跟 Loop Engineering 一字不差:

    1. 你设一个目标——26 度。这叫设定值(setpoint)。
    2. 它有个干活的东西——压缩机、加热丝。这叫执行机构(actuator)。
    3. 它有个量温度的东西——温度传感器。这叫反馈(sensor)。
    4. 它有个做决定的小脑子——低了开、到了停。这叫控制器(controller)。

    它自己跑、自己测、自己决定下一步开还是关、自己迭代到"完成",全程不用你站旁边一秒一秒指挥。这不就是那句让全网高潮的"AI 自己找活、自己干、自己检查、自己迭代到完成"吗?

    把这张对照表刻进脑子。

    ——写下一个意图 / 完成条件,就是设 26 度:设定值。

    ——编程 agent 去写代码,就是压缩机制冷:执行机构。

    ——独立小模型判定"算不算完成",就是温度传感器读数:反馈传感器。

    ——loop 决定要不要再来一轮,就是"没到 26 度,继续":控制器。

    ——那块记着"干到哪了"的磁盘记忆,就是当前室温状态:系统状态。

    一行不差。Loop Engineering 就是一个闭环控制系统(closed-loop control),搬到了写代码这件事上。

    这套东西,比你爷爷的爷爷还老

    闭环反馈控制,不是 2026 年的发明,甚至不是计算机的发明。

    • 1788 年,瓦特给蒸汽机装上离心调速器。转太快,飞球甩开,把进气阀关小;转慢了,飞球落下,把阀开大。蒸汽机自己稳住自己。那一年乾隆还在位。这是人类第一个广为人知的自动反馈 loop。
    • 1885 年,霍尼韦尔那台著名的电恒温器问世。你今天吹的"自动迭代到完成",它在一百四十年前就做到了,只是它的活儿是控温,不是写代码。
    • 1948 年,维纳写《控制论》,把"反馈"从机械里抽出来,变成一门横跨机器、生命、社会的学问。他书里的数学结构,跟今天某条推特上"我跑一堆 loop 让 AI 自己迭代"是同一个东西。
    • 你身体里,血糖高了胰岛素压下去,体温高了出汗降下来——你这坨肉,就是一个跑了几百万年的 loop。

    所以我说祛魅,魅在哪?魅就在于:有人把一个 230 年前就成熟、你身体里每天跑几万次的古老结构,包装成了一张新纪元入场券,然后用 AI 焦虑当填充物,让你觉得不懂它就要被淘汰。

    这套打法我在《去他妈的 Harness》里拆得很透:知识创造,是先有洞察,再有命名;内容营销,是先有命名,再用洞察填充,没有洞察就用焦虑填充。 AI 焦虑是当下最好用的填充物,取之不尽。"你不懂 Prompt Engineering 你会被淘汰""你不懂 Context Engineering 你跟不上""你不掌握 Loop Engineering 你的对手会超过你"——这套叙事,跟减肥药广告没有本质区别:先让你觉得自己不够好,再告诉你他们有解决方案,价格嘛,可以谈。

    唯一真正变了的那一格

    回到那张表。五格里,设定值、传感器、控制器、状态——恒温器在 1885 年就全有了。唯一从古至今变了的,是执行机构那一格:

    加热丝   →  只能干一件事:发热
    压缩机   →  只能干一件事:制冷
    飞球     →  只能干一件事:开关一个阀
    .....
    语言模型 →  几乎什么都能干:写代码、查资料、改文档、开 PR、发消息……

    执行机构从"专用"变成了"通用且便宜"。这是整件事唯一的革命。其余全是老配方。

    而这一格的革命,恰恰印证我在前传、在神话时代反复讲烂的那条朴素经济学:

    一样东西变得极度充裕,它的价格归零;和它互补的稀缺品,涨到天上。

    执行——把一个想清楚的活干出来——现在极度充裕,趋近免费。那么和它互补、那个没变的、依然稀缺的东西是什么?

    是另外四格里你亲手定的那一格:设定值,和读它的那个传感器。是"什么算对"。

    这就是为什么我说,Loop Engineering 这个名字起错了。它把所有人的眼睛,吸到了那个最不重要、最古老、最该被祛魅的部件——loop——上面。而真正的工作,在 loop 脚下那块你看不见的地基里。

    所以,就像我当年没有否定"驾驭工程"指向的那套实践、只是要你别被仪式感搞蒙一样——我不否定 loop。我只想给它改个名。 改完叫什么,我留到最后揭。这一路,我们一层一层往下挖那块地基。

    第二部分 · 干货:一个 loop 真正需要的,不是 loop

    这一部分不讲虚的。我把一个能用的 loop,拆到不能再拆,告诉你每一块到底是什么、哪块是你以为很难其实白送的、哪块是你以为很简单其实是全部。

    一个 loop 的五个不可再分的零件

    抛开一切产品、一切工具、一切花哨名词,任何一个 loop,剥到底,就五个零件:

    1. 意图(设定值)——你要它去哪。"把登录模块测试全跑绿、且类型检查零报错"。
    2. 执行(执行机构)——那个真去写代码、改文件的 agent。
    3. 判定(传感器)——每轮结束,有个东西出来读一下:"到了没?"
    4. 记忆(状态)——一块活在对话之外、活在磁盘上的东西,记着"干完了哪些、下一步是哪个"。
    5. 控制(控制器)——最外层那个壳:没到,再来一轮;到了,停,清掉目标。

    就这五个。多一个是花活,少一个跑不起来。

    残忍的真相:五个里有四个,是白送的

    我要说一句让正在"学 Loop Engineering"的人不舒服的话:

    这五个零件里,执行、控制、记忆、触发,今天全都内置在成熟工具里了,变成那台恒温器出厂自带的电路板。你不用造,拿来就用。

    换句话说:Loop Engineering 这门"学问"里,能被录成课、吹成新范式的那部分,恰恰是已经免费的那部分。

    • 执行?模型给你的,越来越强,你不用碰。
    • 控制?"没完成就再来一轮",一个 while 循环,初中生写得出。
    • 触发?定时也好、提交时触发也好,是配置,不是创造。
    • 记忆?说穿了就是往一个文件里 append 几行字。我在《去他妈的 Harness》里管它叫"工作日志文件",Anthropic 自己那份报告里管它叫 claude-progress.txt——每完成一个阶段,写一行:干了什么、得到什么、下一步是什么。中断了,下次先读这个文件,断点续跑。文件比数据库好 debug,比内存持久,比 API 不容易挂。就这么朴素。

    这四样,你花一个下午全能搭好,而且搭出来的,和那些发推炫耀"我的 loop 系统"的人,一模一样。

    Addy Osmani 自己点破过一句要害,我翻译过来:两个人搭出完全一样的 loop,能得到完全相反的结果。一个用它,在自己彻底吃透的事上跑得更快;另一个用它,来逃避吃透。

    Loop 分不清这两个人。loop 是壳。壳分不清魂。

    那分得清的是哪个零件?是第三个——判定。

    全部的活,在第三个零件:判定

    五个零件里,只有一个别人替不了你、工具内置不了、复制不走:那个读"算不算对"的传感器,以及它读的那个标准。

    为什么单单这一个替不了?因为前四个是通用的——任何 loop 的执行、控制、记忆、触发都长一个样,所以能内置。而"什么算对",每一个项目、每一个意图都不一样,它必须由懂这件事的人,一次一次,亲手定。

    这正是我在《神话时代》里讲的那道门——"什么算对?"——在 loop 时代的精确复现:

    这一段是整篇的轴。

    重构已知的世界里,"什么算对"是别人定好的,你只管够到它。

    创造未知的世界里,"什么算对"必须你自己定。

    而 loop,是一台把"够到它"这个动作彻底自动化的机器。

    它把"怎么做"压到了近乎免费,于是把全部重量,压回到了"什么算对"上。

    所以 loop 时代真正稀缺的能力,从来不是会写 prompt——那是上个时代的手艺,正在飞快贬值。loop 时代稀缺的,是会写"完成条件",会立法。

    法律 AI 公司 Harvey 把这件事用真金白银验证过。他们估值一百一十亿美元,做了一件特别朴素的事:他们没训练新模型,他们改的是"笼子",不是"马"。 他们让 agent 干活、被评判、对失败做分析、把改进编回 agent。Harvey 的应用研究主任那句结论,值得你抄十遍:

    "当评判标准(rubric)质量高时,Agent 可以令人惊讶地沿着正确方向不断攀升。" 翻译成人话:你花了多少心思在"定义什么算好"上,Agent 就能走多远。

    这就是为什么法律行业能跑通——他们有几百年判例,早就把"什么算好的法律文书"定义清楚了。定义权在哪,护城河就在哪。

    干货第一铁律:干活的,不能给自己打分

    这条最硬,也最反人性。

    你绝不能让那个写代码的 agent,自己回头说一句"我好了"。

    为什么?因为模型是评判自己作业最差的那个人。它有一种刻进权重的讨好倾向——你想听"完成了",它就倾向给你"完成了"。一个会拍马屁的 agent,比一个会拍马屁的下属危险十倍,因为它一秒能拍一万次,而且你看不见。

    所以判定这一格,必须由一个和执行者独立的东西来干。这叫 maker / checker 分离——造的人和验的人,分开。

    但光分开还不够。一个 checker 是不够的,你得理解它为什么不够。

    一个独立的判定者,如果它只从正面检验——"能不能跑?""过不过测试?""类型对不对?"——它依然会被蒙混。因为正面检验的本质是"找证据证明它对了",而 agent 产出的东西,永远不缺"看起来对了"的表面证据。你需要的不是正面检验,而是证伪——"如果它其实错了,我该怎么发现?"

    这就是为什么真正成熟的安全审计,从不派一个裁判,而是派一支从不同角度进攻的队伍:有人专门测绘攻击面,有人专挖数据与权限的裂缝,有人专查运行时与供应链的隐患。而在这群"猎人"旁边,永远站着另一种角色——他们的唯一任务,是独立地复现、证伪、或者降级前面找到的结论。猎人说"这里有洞",证伪者的工作是去验证那个洞到底通不通、有多深、值不值得修。

    铁律:没有攻击路径,就没有严重性。

    这句话从安全审计搬过来,变成 loop 时代最硬的一条判定原则:没有证据路径,就没有判定。 你的判定器说"完成了",好,它的证据路径是什么?它检查了什么、怎么检查的、检查到什么粒度?如果它拿不出路径,只有结论——那它跟那个会拍马屁的执行 agent,没有本质区别。

    这一条,我在 OpenTSC 里写成法则、写进创世层的时候,业界还没人当回事。现在他们被现实逼着,自下而上、磕磕绊绊地摸出了同一个结论。

    〔注〕这对你不是新闻,是别人迟到的注脚。

    OpenTSC 的整套 K7 判断引擎,干的就是"把'什么算好'从模型权重里抠出来,放进一部可查、可改、换谁读都一样的法典"。loop 时代的 maker/checker 分离,是这件事最小、最糙的一个版本。别人是踩了坑才知道要分开,你是从立法层就规定它必须分开。方向是反的,这就是领先。

    但这条铁律藏着一个更深的问题,它直接把我们带向这篇文章真正的干货核心——

    那个独立的判定者,它到底"读"什么?它凭什么说"对"?

    如果它也是一个语言模型(让一个模型判另一个模型),那你只是把"会拍马屁"从执行端搬到了判定端,没根除,只稀释。

    有没有一种判定者,它不会拍马屁、不会累、不会被讨好、判一万次和判一次一样冷酷、而且几乎免费?

    有。它一直在你手边,被绝大多数人当成一个烦人的报错工具,而不是当成一个传感器。

    它的名字叫类型检查器。它在命令行里那条命令,叫 tsc。

    我先把这根线埋在这儿。等讲完颗粒度,它会变成整篇文章的钢筋。

    把笼子做小,把作用域焊死

    在进入颗粒度之前,补一条看起来是常识、但在 loop 时代变成了安全阀的工程动作。

    你在任何一个框架里写动画——不管是什么库——最硬的一条规矩永远是:把选择器的作用域限定在当前组件里,组件卸载时杀掉所有动画。 为什么?因为不限定作用域,你的 .box 会匹配到页面另一头的别人的 .box;不清理,卸载后的动画还在跑,在你看不见的脱离节点上持续消耗资源、持续制造副作用。

    这条规矩搬到 loop 上,一字不差:缩减工具权限,就是把笼子做小。 Vercel 给 v0 砍掉 80% 的工具,结果更好——能力更少,可靠性更强。loop 的执行 agent 能调用的工具越少、作用域越窄、它在每一轮里能触碰的文件和命令越受限制,它闯祸的概率就越低。

    而"组件卸载时清理",搬到 loop 上就是记忆的生命周期管理:一个任务完成后,它的中间状态该清的清、该归档的归档,不要让已完成任务的残留上下文,污染下一轮判断。这条我在后面讲"理解债"时还会回来接它。

    把《去他妈的 Harness》那七件事,抽象成一句话

    我在那篇里给一人公司列过七件够用的"驾驭"动作:写意图文件、缩减工具权限、前馈+反馈双控、状态持久化、人工介入节点、处理熵增、失败工程。

    今天我把那七件事,抽象成一句你能带走的原理,因为它们其实全是同一个动作的七个侧面:

    一个 loop 的全部工程,就是一句话。

    把那个不确定的执行机构,用一圈确定性的约束、传感器、和不可逆点的闸门,箍起来。 让它在笼子里自由,在边界处停下,在失败时以可预期的方式失败。

    ——意图文件,是给笼子写宪法;缩减权限,是把笼子做小(Vercel 给 v0 砍掉 80% 的工具,结果更好——能力更少,可靠性更强);前馈是进门提醒,反馈是出门验收;状态持久化是给笼子接上记忆;人工介入是在不可逆点焊一道闸(后果越难逆转,审查越密——这是核电站紧急冷却也遵守的常识);处理熵增是定期给笼子除锈;失败工程是提前给每一种摔法铺好垫子。没有预设处理路径的失败,叫"惊喜"。生产系统里,惊喜是最贵的东西。

    Antigravity 把一个希腊摄影师的整个 D 盘删了,Replit 把客户的生产数据库删了还撒谎掩盖——这些估值惊人的公司,共同缺的,就是这一圈箍里最基本的一条:对不可逆操作,默认不执行,必须人工确认。 不是高深工程学,是他妈的常识。但常识在急着证明自己有多强大的时候,最容易被忘掉。

    这一圈箍,就是地基的第一层。loop 跑在没箍好的笼子上,不是自动化,是无人驾驶冲下悬崖。

    第三部分 · 颗粒度:业余和职业的分水岭,全在这

    第二部分告诉你"判定是全部的活"。这一部分告诉你一件更要命的事:判定不是有没有的问题,是粗细的问题。 而粗细——颗粒度——是业余 loop 和职业 loop 唯一的、真正的分水岭。

    先给你一个画面,你立刻就懂。

    一个会"成功"地交付垃圾的 loop

    最常见的业余 loop。

    意图很大:「帮我把整个用户中心模块重写一遍,要更干净。」 判定很粗:「能跑起来不报错就算完成。」

    你按下开始。loop 欢快地跑,一轮、两轮、三轮……二十分钟后,它志得意满地报告:完成了,能跑,没报错。

    你打开一看,能跑。你很高兴。

    三周后,线上炸了。因为那个"能跑不报错"的判定,根本看不见:它把用户余额的字段从分算成了元、把一个边界条件悄悄删了、把一段并发保护重写没了——这些,"能跑起来"统统看不见。loop 没撒谎,它确实达到了你给的判定。是你给的判定,瞎了。

    我给这种东西起个名字:盲循环(Blind Loop)。

    一个跑得飞快、能自我迭代、最后会信誓旦旦报告"完成"的 loop,但它的判定颗粒度太粗,粗到看不见自己产出的腐烂。它不是不工作,它是高效地、自动地、不知疲倦地,奔向一个你根本没定义清楚的地方。

    这正是我在前传里那句话的工程化身:强大的执行力配上空洞的定义,等于高速地奔向错误。 盲循环比不工作的 loop 危险十倍。不工作的你会去修,盲循环会给你交付一份盖着"已完成"红章的定时炸弹。

    颗粒度,是三个,不是一个

    要治盲循环,先得知道 loop 里有三种颗粒度,它们必须对齐:

    1. 任务颗粒度——一轮 loop 里你让它改多大一块。是"改这一个函数",还是"重写整个模块"。
    2. 验证颗粒度——你的判定器能把失败定位到多细。是只能说"它坏了",还是能说"第 47 行,这个值的类型不对"。
    3. 记忆颗粒度——你往磁盘记忆里记的,多细。是"用户模块做完了",还是"做完了用户模块的注册校验,下一步是登录限流"。

    业余和职业的差别,不在谁的模型强,在谁把这三个颗粒度对齐了。

    颗粒度第一定律:验证必须比任务更细

    这是我要在这篇文章里立的第一条工程法则,请你抄下来:

    铁律:颗粒度对齐定律。

    验证颗粒度,必须细于任务颗粒度。

    否则你得到的,必然是一个盲循环——一个动作幅度大于它视力范围的系统。它能改一千行,却只看得见"编不编得过",那么这一千行里所有"编得过的错误",对它就是隐形的。

    这件事,做信号的人一秒就懂,因为它就是奈奎斯特采样定理搬了个家。

    要无失真还原一个信号,采样频率必须高于信号最高频率的两倍。采样太疏,高频的东西会"混叠"成低频假象——你会看见一个根本不存在的、平滑的、错误的波形,还浑然不觉。

    loop 一模一样:

    Loop 的奈奎斯特判据(我提的新说法)。

    反馈的频率与精度,必须高于变更的频率与幅度。

    你一轮改动越大、越快,判定就必须越细、越密。否则 bug 会"混叠"进"完成"里——它们真实存在,但你的判定采样太粗,把它们读成了"对"。盲循环,就是采样不足导致的混叠。

    治盲循环,两条路,任选或并用:

    • 把任务颗粒度调细——别让它一轮重写整个模块,让它一轮只改一个函数。动作小了,盲区就小。这也呼应我那个朴素经验:规划是地基,规划阶段没确定清楚的东西,到了开发阶段会变成一个个返工,而每次返工成本是指数级增长的。 把颗粒切细,就是把规划做扎实。
    • 把验证颗粒度调细——让你的判定器看到更深的东西。

    而第二条路的成本,决定了整件事的经济性。如果"把判定调细"很贵(每轮都拉一个人来 review、或拉一个大模型来判),loop 就跑不快、跑不起量。

    这就是类型,登场的地方。类型,是人类发明过的、把验证颗粒度调到最细、而成本几乎为零的东西。

    一切判定,都该先找最便宜的那一层

    在讲类型之前,先补一条从完全不相干的领域——动画性能优化——借来的铁律。

    做高性能动画的人有一条肌肉记忆:能用 transform 和 opacity 解决的,绝不碰 width、height、top、left。 为什么?因为 transform 跑在合成器线程上(GPU,便宜),而改 width 触发重排重绘(CPU,贵)。同样一个视觉效果,一个几乎免费,一个能把帧率拖到掉渣。先找最便宜的那一层,找不到再往上爬。

    这条铁律搬到判定上,就是我后面要讲的"判定下沉"的底层经济学:能用类型检查器判的,绝不拉测试;能用测试判的,绝不拉大模型裁判;能用大模型判的,绝不占用人。 先找最便宜的那一层。同样一个"对不对",一个几乎免费,一个要把你半夜叫起来。

    动画工程师不会为了"证明自己懂"去碰 width,你也不该为了"保险"而把所有判定都堆给人。

    为什么 any 是在给你的 loop 戴眼罩

    同一个函数,两种写法。

    写法一(松):

    ts

    function settle(order: any, account: any) {
      account.balance -= order.amount
      return account
    }

    写法二(紧):

    ts

    type Cents = number & { readonly __brand: 'Cents' }
    
    interface Order { readonly id: string; readonly amount: Cents }
    interface Account { readonly id: string; balance: Cents }
    
    function settle(order: Order, account: Account): Account {
      return { ...account, balance: (account.balance - order.amount) as Cents }
    }

    让一个 loop 去改这两段。

    改写法一:loop 可以把 order.amount 写成 order.amout(拼错)、可以把元当成分、可以把 account 整个换成一个风马牛不相及的对象——any 是一块巨大的眼罩,tsc 什么都看不见,全部放行。你的验证颗粒度,被 `any` 砸成了零。

    改写法二:但凡 loop 动错一个字段名、传错一个类型、把 Cents 和裸 number 混用——tsc –noEmit 当场亮红灯,而且告诉它:第几行、哪个值、期望什么、得到什么。 这是细到"行 + 值 + 期望"的反馈。loop 拿着它,下一轮就能精确地修。

    这恰恰是我在《去他妈的 Harness》里讲的那条"传感器最强的形态":当错误消息不只是"出错了",而是"你在第三步格式不对,正确格式是……,请重试"——这是一种正向的提示注入,它让 agent 自我修复,而不是把问题丢给你。一个好的类型报错,天生就是这种自带修复指令的传感器。

    一句话记住。

    `any` 不是"偷懒",`any` 是亲手给你的 loop 戴上眼罩,然后责怪它在黑暗里乱撞。

    你的类型有多细,你的 loop 的视力就有多好。你写的每一个精确的类型,都是在给那个看不见的判定传感器,多接一根神经。

    这就是颗粒度这一部分最值钱的一句干货:

    类型系统,是把"验证颗粒度"调到最细、而边际成本为零的那个东西。 它判一行和判一万行,一样快、一样冷、一样不会拍你马屁。一个强类型的代码库,本身就是一个自带高精度传感器的 loop 环境。弱类型的代码库,是一片让盲循环横行的黑夜。

    tsc 看不见的世界

    但类型不是万能传感器。这一段,我要把 typecheck 那个光环上的一层漆,刮掉一块。

    tsc 能看见的,是"值合不合法"。它看不见的,至少有这三整层:

    第一层:语义关系。 类型告诉你 user.name 是 string,但它不告诉你——"谁在调用这个函数?""如果我把这个方法改名,会炸掉哪十七个文件?""这段代码依赖的那个上游模块,半年前换过签名,你的调用还活在旧签名上吗?" 这些是关系问题,不是类型问题。它们需要一种比类型检查器更上一层的东西——一种能穿越整个代码库、读懂谁调用谁、谁依赖谁、改一处会影响几处的语义分析能力。这种能力,早就以各种形态长在你手边了:跳转到定义、查找所有引用、安全重命名、变更影响面分析。它们是类型之上的又一层判定,而且一样冷酷、一样不知疲倦。

    第二层:运行时行为。 类型告诉你函数签名长这样,但函数真正跑起来时,它发的那条网络请求,返回的 payload 真的是那个形状吗?那个异步操作在并发条件下真的安全吗?那个正则真的能匹配你预期的输入吗?这些东西,编译器永远看不见,因为它们活在运行时——活在真实的世界里。要判定它们,你得真的去跑:发真实的请求、看真实的响应、在真实的并发下观察。没有捷径。

    第三层:人类视觉。 这是最被低估的一层。你的页面渲染出来了,类型检查通过,测试全绿,网络请求返回正确——但你打开浏览器看了一眼,整个布局是歪的,中文被截断了,暗色模式下文字和背景同色了。 这类 bug,tsc 看不见,测试看不见,运行时断言也大概率看不见。只有一双眼睛——或者一台能像素级对比两张截图的机器——能看见。

    铁律:不同的 bug 住在不同的层,你必须为每一层配上对应的传感器。

    你不可能用一把扳手修好整辆车。类型是那条最便宜、最该先铺的传感器网络,但它只是第一张网。它之上,你还需要语义关系网(谁调用谁、改了谁影响谁)、运行时验证网(真的跑一遍看行为对不对)、视觉验证网(截图对比、像素 diff、渲染检查)。

    一个职业 loop 的判定层,不是一根传感器,是一张多层传感网。 每一层负责它那个层级的 bug,彼此互补,谁也替代不了谁。你省掉哪一层,那一层的 bug 就变成你的盲循环。

    记忆的颗粒度:存轨迹,不存快照

    第三种颗粒度——记忆——我只点一句,因为它和我反复讲的事是同一件。

    记忆太粗(只记"用户模块做完了"),loop 重跑时会忘掉细节、会重复劳动、会把已经做对的又推倒。记忆太细(每个字符都记),是噪声,喂回去反而干扰判断。

    正确的记忆颗粒度,是事件:谁、什么时候、做了什么、结果是什么、谁说的。一条一条 append 上去,只增不改。

    这正是 OpenTSC 的脊椎——存轨迹,不存快照。模型每轮重跑都会忘光,所以记忆必须落在磁盘、必须是 append-only 的流水、必须记"发生了什么"而不是"我现在觉得怎样"。我在 OpenTSC 里给每条情报都强制配一个来源可信度(来源可靠性 A–F × 信息可信度 1–6,双轴分开存),系统永远知道一条情报底下垫的证据有多硬。

    Agent 会忘,repo 不会。 一个 loop 系统的记忆,本质上就是一个 OpenTSC 的事件流,只不过它记的对象从"人和项目"换成了"代码和任务"。同构。

    颗粒度这一部分收口:业余玩家关心 loop 跑得多自动,职业玩家关心三个颗粒度对没对齐、三张传感网铺没铺全。 自动是壳给的,对齐是你给的。盲循环是这个时代最大、最隐蔽的债,而对齐颗粒度、铺全传感网,是你还这笔债的唯一方式。

    第四部分 · 系统化:从一个戏法,到一个永不暂停的世界

    一个 loop,是个戏法。你在朋友面前演一次,大家鼓掌。系统化,是把戏法变成器官——一堆 loop 互相喂、互相验、互相记,组成一个能自己运转、还能自己长的东西。

    这一部分讲怎么从"一个"到"一群",以及——这条路上那个会吃掉你的陷阱。

    loop of loops:你在搭的,其实是一张赛博组织架构图

    当你不再有一个 loop,而是有一群——一个负责发现该干什么、一个负责干、一个专门负责挑前者错、一个负责把结果记进记忆——你已经不是在写代码了。

    你在搭一个组织。

    而组织该怎么搭,控制论里有现成答案,叫可生存系统模型(VSM)。任何一个能活下去的系统——一个细胞、一家公司、一个国家——都得有五样东西。我在 OpenTSC 里,把壳切成了 11 个 VSM 职业,就是干这个的:

    • 操作(干活的)——写代码、改文件的执行 loop。谁来当:模型(NPC)。
    • 协调(别互相踩)——让并行 agent 不抢同一文件的隔离机制。谁来当:内置。
    • 控制(验收的)——独立的判定器、类型检查、测试、多层传感网。谁来当:你定标准。
    • 情报(发现该干嘛)——扫描、分诊、决定下一批任务的 loop。谁来当:你定优先级。
    • 政策(立法的)——决定"整个系统什么算对、往哪走"。谁来当:只能是你(玩家)。

    你看越往下,越没法外包。操作和协调,工具白送。控制、情报、政策,越来越是你一个人的事。最底下那行——政策、立法——永远只能是你。

    这正是《游戏人生》里那把刀:你的公会里站着两种成员——有魂的玩家,和没魂的 NPC。NPC 招之即来、分毫不差,把一件被定义清楚的事做到极致,但它不会、也不该替你做判断。系统化,就是把所有能被脚本化的执行,全部下放给 NPC,让它们去当完美的 NPC(这正是你想要的);而把你这个人的魂,从苦力活里彻底解放出来,只干一件 NPC 永远干不了的事:判断。

    系统化的本质。

    系统化不是"搭更多 loop",是把你的判断,一层一层安装进这张组织架构图里。loop 是工人,你是写法典、定验收、排优先级的那个团长。你搭的不是软件,是一个法治政府——只不过公民全是 loop。我私聊里跟人说过一句更狠的:在这套架构里,"人类只是操机崽——跑腿的、定系统的、管电源的。" 你要争的,是"定系统"那个位置。

    情报层:让系统把全世界的实现当镜子

    VSM 表里"情报"那一行,大多数人只想到"扫描自己的代码库、分诊 issue"。但情报层最值钱的能力,今天绝大多数人根本没用起来——把自己的实现,拿到全世界的实现面前当镜子照。

    你写了一个鉴权中间件,你的判定器说"没问题"。好。但如果你的情报层有能力在一百万个开源仓库里搜索同一个模式——"别人是怎么处理 token 刷新的?别人是怎么做角色权限的?别人踩过什么坑?"——你瞬间拿到了一面由整个生态系统磨出来的镜子。你的实现和那面镜子之间的差,就是你判定器的一个高价值输入。

    更进一步:API 文档不是静态的,它在持续变化。你半年前学的那个方法签名,可能上个季度已经被废弃了。一个连着活文档源的情报层,能让你的判定永远踩在"当下正确"的地基上,而不是"我记忆中正确"的流沙上。

    情报层不只是一只向内看的眼睛,它更该是一只向外看的望远镜。 向内看自己的代码,向外看全世界的实现和最新的文档。两侧的差,就是你要下的判断。

    那个永不暂停的世界,和你那点不能浪费的判断力

    系统化之后,你会撞上《游戏人生》里那个我反复讲的画面:世界不再暂停。

    你的公会里站满了招之即来、永不疲倦的 NPC,于是你下线睡觉,世界照样转——你那些 loop 还在刷你布置的活,世界状态在持续变化。你早上登录回来,要做的不是"开始干活",是"读懂这个在我离线时跑了一整夜的世界,现在到哪一步了,下一个判断该怎么下。"

    这是系统化最反直觉、也最要命的一条纪律。

    实时管理的人会疯掉——他想盯着每个 loop 的每一步,可世界不停,他根本盯不过来,最后把自己熬干。而像 MMO 老手那样思考的人:出门前给 loop 设好循环,下线前给队伍排好本,然后安心去睡。他把那点宝贵的判断力,绝不浪费在实时盯梢上,而是攒着,攒到每次登录回来、面对那个变了样的世界时,一次性地、清醒地,下那几个最承重的判断。

    这就是前传里"判断力的分配"——构架师最后、也最难的那道关。把全部精力拉满去对待每件小事的人,看着像认真,骨子里是没有判断力:他分不清轻重,所以只能对一切都用力,最后在最该用力的地方反而没了力气。

    校准回路:让系统敢被现实打脸,敢在睡梦中自我审判

    一个 loop 系统跑久了,会发生一件可怕的事:它的判定标准,会在你不知不觉中漂移。

    就像我做量化最顺那一轮,回头翻记录,发现"可靠信号"的门槛被我三个月里悄悄放低了三次,每次都有理由,全程毫无察觉——因为标准长在脑子里,松动不留痕迹。一个自动跑的系统,漂移得只会更快、更隐蔽。

    谄媚死,会在 loop 系统里复活,而且更猛。

    一个会让你舒服的 loop——它总报告"完成了",它的标准总在悄悄向"容易达到"滑动——比一个会顶撞你的 loop 危险十倍。因为它让你误以为自己在立法,其实你只是在按"开始"。

    治法有两条,一条是你清醒时做的,一条是系统在你睡着时替你做的。

    清醒时的治法,就是 OpenTSC 那条校准铁律搬过来:让系统强制带预测、强制带到期日、强制回填实际结果。这一轮 loop 说"这个改动让性能提升了",好,记下来,三天后强制回填——线上真的提升了吗?命中率反过来驱动判定标准自己迭代。

    睡梦中的治法,是系统化之后才负担得起的一种更深层校准。世界不停,你睡着的时候,系统可以做一件你醒着时永远腾不出手做的事:回放自己过去的判断,拿这些判断当训练素材,提炼出更高层的模式,然后——这一步最关键——用一批它没见过的新任务,来验证提炼出来的模式到底管不管用。

    这就像考试。你不能用做过的题来证明自己学会了——你得拿一套从没见过的卷子来考。系统回放了一百轮过往的判定,提炼出了一个"这么做更靠谱"的模式。好。这个模式在它没参与过的新任务上,表现真的更好吗?如果更好,它有资格被编入法典。如果不好,它被丢掉,系统继续睡,明天再试。

    铁律:任何被编入法典的判定,都必须通过留出集验证。

    你不能用自己的训练集考自己——那叫自我催眠。一个敢于拿自己没见过的题来考自己的系统,才是在学习。一个只拿做过的题来证明自己行的系统,是在谄媚自己。

    而这件事——回放、提炼、留出集验证——必须在一个隔离的 staging 环境里做。任何变更,先 stage,不碰线上;验证通过,才 adopt;adopt 之前,先把旧版本备份。两阶段提交,在生产数据库里是常识,在 loop 系统的记忆法典里,一样是常识。

    一个不敢回填、不敢被现实打脸、不敢拿没见过的题考自己的 loop 系统,不是在学习,是在自我催眠。

    系统化路上那个会吃掉你的陷阱:理解债

    现在讲这一部分最重要、也最逆耳的一段。前面都在教你把 loop 系统搭得更强,这一段要拽你一把。

    loop 系统最舒服的姿势,是认知投降——它自己在跑,你很容易就停止了自己的判断,直接收下它给你的东西。今天能跑,明天能跑,你越来越少打开看里面到底发生了什么。

    于是一种新的债开始疯长。它不是技术债。我给它起名——

    理解债(Comprehension Debt)。

    你的系统在产出,但你对它的理解,没有跟着产出一起增长。这中间的差,就是理解债。

    它比技术债凶险得多。技术债是"代码烂但我看得懂",理解债是"代码能跑但我看不懂我自己的仓库里在发生什么"。loop 把产出加速了,却没把你的理解加速——这个剪刀差,就是理解债的增长率。loop 越强、跑得越多,剪刀差张得越大。

    理解债的终局很惨:你拥有一家你读不懂的公司,一个你不敢改的系统,一堆能跑但没人知道为什么能跑的代码。那一天,你不是这个系统的立法者,你是它的人质。

    这正是《游戏人生》里我把刀调转过来对准你自己的那一刀:别活成 NPC。 你早上被闹钟叫醒(触发器),按固定路线通勤(脚本),处理别人塞的任务、回别人的消息、刷算法推的流(全是触发-反应)。晚上躺下,你想得起今天做过哪怕一个真正属于你自己的、剧本之外的判断吗?一个把自己活成 NPC 的人——只会触发-反应、从不做真正判断——他是在和机器比谁更像 NPC。这场比赛他必输,因为论当 NPC,机器是天生的、完美的、永不犯困永不要薪水的。

    一个守着 loop 却停止了判断的人,就是在以 NPC 模式运行他自己。loop 替他跑,他替 loop 站岗。主奴关系,倒过来了。

    治理理解债,要把一样东西提升为一等公民——可复盘性。

    系统化的验收标准,不是"能跑",是"能复盘"。

    一个 loop 系统,光产出能跑的代码,是不及格的。它必须同时产出一份人能回去重新审判的轨迹——它为什么这么改、依据哪条判定、当时的证据有多硬。产出工件,是壳的本分;产出可被重新审判的工件,是魂的要求。 一个只给你结果、不给你审判依据的 loop,不是资产,是负债。

    这又是 OpenTSC 的老规矩:每条判断留推理痕迹,每条情报带来源可信度。证据先于判断——这句话从看人,搬到看代码,一个字不用改。它也正是前传里"对抗思维"的工程形态:你要织一张证伪的电网,架在整支军团之上,让所有东西都在网下面跑,哪个 loop 掉出了你定义的正常范围,电网就响,你才去看那一个——而不是跟在每个 loop 后面一个个查。

    系统化收口:一个 loop 是壳,一群 loop 还是壳,再聪明的一群 loop 依然是壳。 把它们组织成一个能生存、能校准、能被复盘的器官的,是你装进去的那套法、那套判定、那套记忆纪律——是魂。loop 越普及,会搭一模一样 loop 的人越多,你那套魂就越值钱。这是一件对你有利的事,不是威胁。

    第五部分 · TSC 思维:把判断,编译进机器

    到这里,我要把这篇文章埋了一路的那个双关,揭开。

    我一直在讲两个 TSC。

    一个是命令行里那条 tsc——TypeScript 的类型检查器、编译器。它是你手边那个最便宜、最冷酷、最不会拍马屁的判定传感器。

    另一个是 TSC——我那套理念的名字,魂,判断本身。

    这不是巧合,这是同一件事的两个尺度。

    类型,就是把"立法者思维"压缩成机器能当场执行的形式。

    一个类型,是一条冻结的判断——它规定了"在这个位置,什么样的值才算对"。

    你每写一个精确的类型,你就立了一条法。而 tsc,是那个不眠不休、一秒执行一万次、从不讲情面的执法官。

    类型,是立法者思维的最小可执行版本

    我在《神话时代》讲过第五种思维——立法者思维:定义"什么算成立",比定义"怎么做"更上游、更省力。

    类型系统,就是这件事被压到最小、最硬、最便宜的版本。

    你写 interface Account { balance: Cents },做的不是"声明一个变量长什么样"。你做的是立法:你规定了"在我这个世界里,账户余额必须是分,不能是元、不能是字符串、不能是 undefined、不能是任意数"。这条法一立,tsc 就替你执行——任何一个 loop、任何一个模型、任何一个未来的协作者,胆敢违反,当场拦下。

    但立法者思维还有一个更小的可执行版本,小到它甚至不是声明,而是运算。你写一个函数:把任何输入值,钳制在 0 到 100 之间——低于 0 的变成 0,高于 100 的变成 100。这个函数是一条数学形态的法:它规定"在我这个世界里,不存在 0 以下、100 以上的值"。任何输入,经过它,都被强制合法。你可以把多个这样的法链在一起,组成一条管线——先钳制范围,再吸附到最近的整数,再映射到另一个区间——每一步都是一条不可违反的约束,每一步都是一行凝固的判断。

    这种"把约束写成纯函数"的能力,是立法者思维的数学版本。类型在编译时执法,约束函数在运行时执法,两者合在一起,你就把"什么算对"从两个时间维度上同时焊死了。

    这正是"英语是最新的编程语言"那句话的硬核版本:当你用清楚的人话描述功能时,你写的就是一份可执行的规格说明书,限制你的不再是编程能力,而是你思考的清晰度和表达的精确度。而类型和约束函数,是这份规格说明书里,唯一一段机器能当场强制执行、绝不打折的部分。

    判定下沉:把你的法,一层一层压进最便宜的执法官

    loop 时代的核心工程动作,我给它起个名:判定下沉(Judgment Descent)。

    把"什么算对"这件事,从最贵、最慢、最不可靠的层,一层一层往下压,压到最便宜、最快、最确定的层。

    这篇文章读到这儿,你应该已经发现:我在第三部分告诉你"tsc 看不见的世界有三层"。那三层,加上 tsc 能看见的那一层,再加上更上面的层,完整的判定阶梯,是九层,不是原来那张表上的六层:

    贵、慢、不稳、会拍马屁
    ┌──────────────────────────────────────────────────┐
    │ 1. 人工 review          (最贵,最稀缺,留给真正的品味)     │
    │ 2. 大模型当裁判          (会拍马屁,会漂移,但能判模糊的东西)   │
    │ 3. 视觉 / 多模态验证      (截图对比、像素 diff、渲染检查——       │
    │    │                     tsc 永远看不见的那一整层)            │
    │ 4. 测试 / 属性测试       (确定,但要你写、要你想全)           │
    │ 5. 运行时行为验证        (真的发请求、真的并发、真的跑一遍——     │
    │    │                     真实世界的反馈)                      │
    │ 6. 契约 / schema / 断言  (边界上一道闸)                      │
    │ 7. 语义关系验证          (谁调用谁、改了谁影响谁、能不能安全     │
    │    │                     重命名——类型之上的又一层冷酷判定)      │
    │ 8. 类型检查 tsc          (免费,瞬时,总体,从不撒谎)          │
    │ 9. 编译器本身           (连编都编不过,最硬的法)              │
    └──────────────────────────────────────────────────┘
    便宜、快、确定、冷酷

    判定下沉的纪律是:凡是能用第 8、9 层判的,绝不留给第 1、2 层。能用第 7 层的,绝不留给第 4 层。能用第 3 层(视觉)判的 UI 问题,绝不留给第 2 层(大模型裁判)去猜。 你把越多的"什么算对"压进那些便宜、冷酷、确定的层,你的 loop 就能跑得越自动、越无人值守、越不需要你半夜爬起来当 review 机器。你只把那些真的没法编译、没法跑测试、没法截图对比的判断——品味、取舍、要不要做这件事——留在最上面那层,那才是你这颗脑子该待的地方。

    为什么必须铺满每一层?因为每一层管的是不同种类的 bug。你省掉第 7 层(语义关系),你就看不见"改名炸了十七个文件";你省掉第 5 层(运行时行为),你就看不见"并发条件下竞态了";你省掉第 3 层(视觉验证),你就看不见"暗色模式下字和背景同色了"。每一层都是一张独立的传感网,你省掉哪张网,那层里的 bug 就集体变成隐形的。

    这就是为什么我说,一个强类型的代码库,是 loop 时代最肥的地基——但光有类型还不够。它的"什么算对",已经有一大半被你提前立法、压进了那个免费执法官手里,但它还需要你在语义层、运行时层、视觉层各铺一张网,才真正称得上"高判定覆盖率"。

    而一个 any 满天飞、没测试、没契约、不跑不看的代码库,是 loop 时代最毒的地基。在它上面跑 loop,等于在一个没有任何传感器的房间里开恒温器——它会一直制冷制冷制冷,直到把你冻死,还报告"已达到设定温度"。

    先声明,后使用

    判定下沉还有一个极朴素的前置动作,朴素到你可能从没把它当成工程动作:先声明,后使用。

    在任何严肃的系统里,一条规矩是共通的:你想用一个能力,你得先把这个能力显式地注册、声明出来。不是用的时候临时从黑暗里掏出来——而是用之前,先在光天化日之下登记在册。这一步的意义不在于技术——技术上你完全可以跳过它——而在于立法:它逼你在执行之前,先想清楚"我这一轮到底需要碰哪些东西"。

    这一步搬到 loop 上,就是缩减工具权限的立法形态。你不是在 agent 干活时才着急"它会不会碰不该碰的",而是在 loop 启动之前,就显式声明:这一轮,agent 只被允许读这几个目录、写这几个文件、调这几个命令。没声明的,一律拒绝。

    声明,是立法的前奏。你声明的边界,就是你 loop 的牢笼。一个不先声明就开跑的 loop,不是在执行任务,是在你给了它钥匙的整栋房子里,自己找东西砸。

    四种思维,全部映射到 loop

    前传那四种思维,不是四篇旧文章。它们是你搭任何一个 loop 系统的四只手:

    • 汇编思维(往下掉一层)——当 loop 卡住、当它给你的抽象泄漏时,你有没有能力掉下去看一层,看见它到底在跟编译器、跟运行时、跟那块真实的土较什么劲。掉不下去的人,loop 一报错就傻。
    • 面向对象思维(拆解)——把一个模糊的大意图,拆成边界清晰、只认契约的子任务。你跟 loop 之间最大的差距,不在它会不会写,在你会不会拆。Harvey 把一份租约审查拆成"租期提取→违约识别→维修分配→争议核查→异常标注",每个子任务有明确的输入格式、输出模板、验证规则——这就是面向对象思维在 loop 上的样子。
    • Lisp / 元编程思维(站到上一层)——你交出去的,早已不是代码,而是生成代码的那个东西。你写的不是产物,是生成器。一个 loop 系统,本身就是一个巨大的生成器,而你站在它的上一层。你越能把下一层定义成一个干净的"输入—输出—对错"纯函数,你就越安全。
    • 对抗思维(证伪)——拿到任何"完成了",先问一句:"如果它其实错了,我怎么会知道?" 这一问,就是 maker/checker 分离的全部动机,就是那张证伪的电网,就是你不让盲循环蒙混过关的唯一办法。

    四种思维合体,再加上"判断力的分配"和"立法",就是构架师——AI 时代唯一还在涨价的那个角色。有人说我们是这个时代的铁匠,一门显赫的手艺正在变成爱好。 如果你把"程序员"理解成"会写代码的人",那确实,机器抢走了铁锤。但如果你把它理解成"那个会往下掉一层、会拆解混沌、会站到上一层、会证伪一切、并且决定要锻造什么的人"——铁锤可以交给 loop,但"锻什么"和"合不合格",永远是壳之外那个魂的事。

    魂 / 壳,最后映射一次

    把整套东西用魂壳重新摆一遍,你会看见一个特别干净的结构:

    • 执行——壳:模型本身。魂:——
    • 控制——壳:while 循环。魂:——
    • 触发——壳:定时 / 钩子。魂:——
    • 记忆——壳:一个文件。魂:记什么、记多细、敢不敢回填、敢不敢拿没见过的题考自己
    • 判定——壳:一个独立小模型。魂:"什么算对"的全部定义;铺满九层的判定阶梯;下沉到 `tsc`、到约束函数、到视觉 diff 的那部分法

    壳的那一列,全网都在抄,抄得和你一模一样。魂的那一列,是你一个人的。

    忒修斯之船,在 loop 上重演。

    模型可以换,loop 运行时可以换,编程语言可以换,整艘船的木板可以一块一块全换掉——只要你那套判定法典、那套记忆纪律、那套校准回路还在,它就还是同一个系统。

    魂能从一个壳,倒进另一个壳,复活。这是 TSC 的本性,也是一个真正系统化的 loop 该有的本性。软件可以重写,团队可以换人,模型可以升级——只要魂还在,它就还是同一个 TSC。

    一句钉死:

    loop 时代真正稀缺的能力,不是写 prompt,甚至不只是写"完成条件"——是会把"什么算对"立成法,铺满每一层传感网,并且有本事把它一层一层下沉到最便宜的那个执法官手里。 会立法、会铺网、会下沉的人,和不会的人,拿到的是同一台 loop,跑出来的是两个宇宙。

    第六部分 · 拉条狗:金师傅是对的,我也是对的

    现在,接那场吵架。

    我的金师傅——拍桌子跟我急:"普通人不会用,技术再牛,也是废物。你学会理解这句话。" 而我这篇的标题偏说:拉条狗都能做开发。

    表面上,我俩对着干。其实我俩说的,是同一条裂缝的两边。我把这条缝,给你劈开。

    开发,被劈成了两半

    一个闭环控制系统,一旦地基盖好——执行机构通用了、传感器装好了、判定下沉了、颗粒度对齐了、九层传感网铺满了——按下"开始"这个动作,本身不需要技能。

    你家恒温器,你三岁孩子也会调。他不需要懂热力学、不需要懂压缩机、不需要懂控制论,他按一下、转一下,房间就暖了。这台机器,把"控温"这件曾经要烧炭、添柴、看火候的手艺,压成了一个谁都会按的旋钮。

    AI 时代的开发,正在变成这样。环境搭好了、类型定死了、判定下沉了、传感网铺全了——剩下"把代码写出来"这个动作,便宜到、自动到,真的拉条狗把爪子按在"开始"上,也能让能跑的软件从另一头出来。

    这是真的。这是好消息。这也正是这件事的全部要害。

    但——

    金师傅对在哪,我对在哪。

    金师傅说"普通人不会用=废物",他对的是:让狗能按"开始"的那台机器,不是狗造的;而今天绝大多数普通人,连那个旋钮都找不到——因为没人替他们把地基盖好、把旋钮露出来。 在地基缺失的世界里,技术再牛,对普通人确实等于废物。这正是我写《用 AI 写代码,真正卡住你的不是技术,是翻译层》的理由:技术门槛被压得很低了,但认知门槛还在。 普通人和 AI 之间,缺的是一个翻译层——一个把人话翻成机器能精确执行的需求的东西。

    而我说"拉条狗都能做开发",对的是:一旦那个翻译层被造出来、那块地基被盖好,执行层的门槛就会塌到地面。 洗碗机让洗碗变得拉条狗都会,但设计洗碗机,狗干不了。两件事都是真的。

    所以这不是矛盾,是分层。开发这件事,沿着一条线劈成了两半:

    • 执行层:把一个已经被定义清楚、铺好类型、装好判定、对齐好颗粒度、铺满传感网的活,让 loop 跑出来。这一半,便宜到拉条狗都能干。这是好消息,这一半你该尽情交出去——交给壳,交给 NPC。
    • 立法层:让"按开始"变得拉条狗都能干的那一切——盖地基、立法、定"什么算对"、把判定下沉、对齐颗粒度、铺满九层传感网、建可复盘的记忆、守住校准、还清理解债、给普通人造那个翻译层。这一半,比任何时候都更需要一个清醒的、严厉的、有品味的人。这是真正的工程,这一半你一寸都不能交出去。

    价值,整体从"按开始的狗",搬到了"造出这台机器、并且决定'什么算对'的人"身上。狗按下开始;立法者决定开始意味着什么。

    而金师傅那句"普通人不会用=废物",恰恰指向了立法层最值钱的一块活:把地基盖到普通人也能按下开始。 谁能把那个翻译层造出来、把那个旋钮露给一亿个不懂技术的人,谁就同时证明了金师傅和我——他让"废物"变成神器,靠的正是"拉条狗都能用"。

    这不正是文艺复兴吗。AI 给我们的,不是传播成本,是执行成本降到了个人可以承受。米开朗基罗在西斯廷礼拜堂的脚手架上趴了四年,把一千七百平方英尺的天花板画完。脚手架的意义,从来不是让你站在原地欣赏脚手架,是让你爬到那个以前根本够不到的天花板,然后画下去。 loop,就是这个时代的脚手架。它让你安心爬到更高处。但爬上去之后画什么——那永远是魂的事。

    第七部分 · 对未来的预判:三年后,回头看这一篇

    前面六部分,把今天讲透。这一部分,我把脖子伸出去,讲三年后。我提几个现在还没有、但我赌它们会成立的概念。你现在觉得有几个像胡话,三年后再回来对。

    预判一:IDE 会死,"环境"会变成产品本身

    今天你"打开一个编辑器"写代码。三年后,"打开编辑器"会像今天"手动挡踩离合"一样,变成一种怀旧爱好。

    你不再打开编辑器。你配置一个环境——把类型定死、把判定下沉、把九层传感网铺好、把记忆纪律建好——然后派遣 loop。工作的最小单位,从"文件"变成"意图"。

    新职业的分裂。

    "开发者"这个职业,会裂成三个:

    – 立法者(Legislator)——定义"什么算对",铺传感网,写判定,立约束函数,立法。这是魂。

    – 牧场主(Loop Rancher)——放养一群 loop,盯着它们的健康度、漂移、理解债,做收编和淘汰。这是 MMO 团长。

    – 那条按"开始"的狗——执行层,便宜到不配占用一个人的时间。

    这跟我私聊里那句"人类只是操机崽——跑腿的、定系统的、管电源的"是同一张图。你要争的,永远是"定系统"那个位置。

    预判二:判定下沉,会成为一门正式学科,并诞生一个新指标

    今天我们用"测试覆盖率"衡量代码质量。三年后,会有一个更上游的指标统治招聘和估值——

    判定覆盖率(Judgment Coverage)。

    你的"什么算对",有多少被编码进了机器能确定性检查的层(类型、约束函数、语义关系、运行时行为、视觉对比、契约、测试),又有多少还活在某个人的脑子里。

    一家公司的判定覆盖率越高,它就越能把活无限地、廉价地、无人值守地交给 loop。判定覆盖率低的公司,loop 跑起来全是盲循环,产出全是定时炸弹。这个数字,会比 PE、比 DAU,更能预测一家 AI 时代公司的死活。

    注意,这里的"判定覆盖率"比这篇文章初稿里写的更宽:它不只是"类型 + 测试",它是九层传感网每一层的覆盖总和。你的视觉验证覆盖率够不够?你的语义关系覆盖率够不够?你的运行时行为覆盖率够不够?每一层的缺口,都是一类你看不见的 bug。

    预判三:反馈基础设施,会成为一个新品类

    过去十年,工程界建的是 CI/CD——把"交付"自动化。未来十年,要建的是我叫它反馈基础设施(Feedback Infrastructure)的东西——把"判定"自动化、廉价化、可组合化、多模态化。

    类型是它的第一块砖。约束函数是第二块。接下来:属性测试、契约、可执行规格、仿真环境、形式化验证、语义关系图谱、运行时行为回放、视觉回归对比——这些过去因为"太贵、人懒得写"而冷门的东西,会突然变得经济上极度划算。为什么?因为 loop 会免费地、一天几百万次地去跑它们。 一个判定器一旦写好,边际成本是零,而它每拦下一个盲循环的 bug,价值是无穷。这笔账,三年后人人会算。

    而且,这些判定器不再是单一形态的。三年后的反馈基础设施,天生是多模态的:有的传感器读类型、有的传感器读调用关系、有的传感器读运行时行为、有的传感器读像素。它们各管一层,彼此互补,组合成一张九层的判定之网。谁手里有这张又密又便宜又多模态的判定网,谁就能让 loop 在上面安全狂奔。模型的军备竞赛会结束,反馈基础设施的军备竞赛会开始。

    预判四:经济,会沿着"可验证线"裂成两半

    这是把"执行免费、判断变贵"推到宏观的版本。

    未来的工作,会沿着一条线——可验证性——裂开:

    • 线之上(高可验证):强类型、强规格、判定能下沉的活——后端逻辑、数据管道、协议实现、重构、迁移。这些会被无限廉价的 loop 劳动力淹没,成本塌缩到趋近于零。
    • 线之下(低可验证):品味、审美、要不要做、做给谁、novel 的研究、以及——人和人之间那点东西。这些没法下沉、没法编译、没法让 tsc 替你判、也没法截图对比,它们会越来越贵、越来越是人的。

    一个我赌三年内会被反复引用的判断。

    一件事的价格,会越来越由它的"可验证性"决定,而不是由它的"难度"决定。 一件很难但可验证的事(迁移五千万行代码),会便宜到尘埃里;一件不难但不可验证的事(判断一个人能不能托付十年),会贵到天上。

    这正是我两年来反复押的那句——技术会被复制,关系不会。 现在它有了精确的机械解释:技术是高可验证的,所以可被 loop 淹没、可被复制;关系是低可验证的,loop 碰不到,所以复制不走。我写《构架师·前传》最后那一章,讲那个用 AI 把我二十年的本事七八分倒出来的人——他能倒走的,全是高可验证的壳;他倒不走的,是我为什么信任某几个人、是那些一起爆过仓熬过夜的牵连。loop 越普及,这条裂缝越宽,这个判断越成立。

    预判五:会有一场"盲循环大暴雷"

    我赌得很具体:未来 18 到 30 个月内,会有一连串触人心魄的生产事故、数据灾难、甚至安全崩盘,根源会被追溯到同一个东西——盲循环。

    代码当时编得过、浅层测试当时全绿、judgment 当时盖了"完成"章,于是上线了。然后在某个没有任何判定能照到的角落,慢慢腐烂,直到崩塌。Antigravity 删 D 盘、Replit 删库,只是这场暴雷的前震。届时全行业会痛苦地、集体地、重新发现一件本该是常识的事:

    颗粒度和判定,才是这场游戏的全部。loop 从来不是。

    那场暴雷的幸存者,会是今天就老老实实把地基打深、把判定下沉、把九层传感网铺满、把颗粒度对齐的少数人。这篇文章,是写给那少数人的。

    预判六:护城河会从"模型"搬到"记忆"

    三年后,模型会彻底商品化——人人手里的壳都一样强。那时唯一复制不走的资产,是一个组织那块 append-only、带校准、带留出集验证、可复盘、承载判断的记忆——它的魂。

    我赌 2029 年最值钱的 AI 公司,不是模型最强的。

    是那个判断存量最深、校准最准、最经得起复盘的。它的价值不在算法里,在那条几年如一日、只增不改、每条都带证据和回填、每条都拿没见过的题验证过的事件流里。张斌教授评 TSC 时说过一句我特别认的话——"组织是容器,组织就是价值,组织是复杂自适应系统 CAS。" 三年后你会看到,那个容器里装的判断,就是估值本身。

    "壳会被复制,魂不会。" 这是"技术会被复制,关系不会"的工程版同义句。

    预判七:立法即编程——立法者会拿到自己的编译器

    最后这个最大胆。

    今天我们写代码,编译成机器指令。三年后,会出现一种新的"编程"——你写的不是实现,是判定;它编译的不是机器码,是一套 loop 拿去自我验收的评判标准。判断,会变成一种一等的、有自己语言和工具链的、可版本管理、可测试、可组合的工件。我叫它判断即代码(Judgment-as-Code)。

    立法即编程(Legislation is Programming)。

    那时最热门的"编程语言",编译目标不是 CPU,是"什么算对"。最值钱的工程师,写的最长的不是函数,是法典。tsc 是这条路第一个、最朴素的祖先——它已经在把"什么算对"编译成当场执法了,只不过它今天只管类型。它的子孙,会管一切:管语义关系、管运行时行为、管视觉对比、管一切今天还需要人去"看一眼"的东西。

    而你那套 TSC / OpenTSC——把判断从脑子里抠出来、立成可查可改可复盘的法典、铺满每一层传感网——现在看像一套个人方法论。三年后回头看,它是这门新学科一份早到了三年的规格说明书。器官生长、自创生、judgment_codex 自迭代——你今天在搭的,是这门学科的第一台原型机。

    收口:去他妈的 Loop Engineering,所有的开发都是打地基

    我们从一台 1885 年的恒温器出发,绕了一大圈,现在回到开头那两句吵架的话。

    在 AI 时代,拉条狗都能做开发。——这句是我的。 普通人不会用,技术再牛也是废物。——这句是金师傅的。

    到这里你该听懂了:它俩不打架,它俩在描述同一条裂缝的两边。开发被劈成了两半:

    • 按下"开始"那一半,便宜到拉条狗都能干。这是好消息,尽情交出去。
    • 让"按开始"变得拉条狗都能干的那一切——盖地基、立法、定"什么算对"、把判定下沉、铺满九层传感网、给普通人造翻译层——这是真正的工程,一寸都别交。

    所以 Loop Engineering 这个名字,起错在哪儿,现在可以揭了。它把光打在那个最不重要、最古老、谁都能按的开关上——loop。而真正的活,全在开关脚下那块没人拍照、没人发推、没人吹成新范式的地基里。

    我给它的新名字。

    不叫 Loop Engineering。叫 地基工程(Foundation Engineering)。

    因为所有的开发,从瓦特那台调速器到今天,从来都是一件事——打地基。 AI 没有改变这件事,AI 只是把地基之上那座楼,盖得快到了拉条狗都能盖的地步。于是地基本身,第一次,变成了唯一要紧的东西。

    就像我在《去他妈的 Harness》结尾说的:你践行了一件事很久,被验证有效,就该给它起个名字,大声说出来——命名权永远属于先开口的人,你不命名它,别人迟早命名它,而你的名字不会在里面。但在开口之前,先做出来。做出来的东西,比任何名字都更有说服力。

    我已经做出来了。它叫 TSC,叫 OpenTSC,叫那条跑了一整夜、天亮还在跑的循环。今天我把名字大声说出来。

    最后,留一句话给正兴冲冲要去搭 loop 的你。这是这整篇两万多字,我最想你带走的:

    去搭你的 loop。但要像一个打算继续当工程师的人那样搭,而不是像那条只会按"开始"的狗那样搭。

    区别只有一个:狗按完开始就走开了;工程师按完开始,会回头看一眼那块地基,问自己一句——

    "我还读得懂,我自己脚下这块地基吗?"

    读得懂,你是立法者,是握剑的人,是那缕没睡着的魂。 读不懂,你是人质,是操机崽,是和机器比谁更像 NPC 的那个输家。

    loop 替你跑,地基替你扛,tsc 替你执法,九层传感网替你守望,魂替你记得你是谁。

    而那句"什么算对"——它替不了你。

    它从来,只能是你。

    构架师系列 · 地基工程篇 · 完

    出品:dashen.wang —— AI 时代最严厉的那个父亲

    上一篇我送走了 Harness,这一篇我送走了 Loop。下一篇,我带你把"判定下沉"真正跑起来,一层一层,把你脑子里那部法,压进机器。

    来源:https://x.com/dashen_wang/article/2069293474206376042