Category: 技术折腾

服务器、网络、硬件与自建工具的实践记录。

  • 解决Python项目导入问题:如何正确使用Python的模块导入和环境变量

    解决Python项目导入问题:如何正确使用Python的模块导入和环境变量

    最近,我在处理一个Python项目时遇到了一个常见的问题,即在移动同事的项目到我的项目中后,导入出现了问题。这个问题可能会困扰很多Python开发者,所以我想和大家分享如何正确解决这个问题。

    问题背景

    在处理Python项目时,我们经常需要使用其他模块或者项目中的代码。在这个问题中,我希望将我的同事写好的项目(称之为项目B)放入我的项目A中使用。项目B的结构如下:

    .
    ├── __init__.py
    ├── b
    │   ├── __init__.py
    │   ├── config.py
    │   └── process.py
    └── main.py

    其中,main.py中的代码试图导入b项目中的模块。但是,当我运行main.py时,出现了以下错误:

    Traceback (most recent call last):
      File "main.py", line 1, in <module>
        from b.process import process
      File "b/process.py", line 1, in <module>
        from config import PDF_FILE
    ModuleNotFoundError: No module named 'config'

    这个错误表明Python无法找到名为config的模块,即使在项目B中存在。这是因为Python默认使用绝对导入,而项目B中的导入是相对导入。

    解决方案一:修改导入语句

    一种解决方案是修改项目B中的导入语句,将绝对导入改为相对导入。在b/process.py中,将导入语句:

    from config import PDF_FILE

    改为:

    from .config import PDF_FILE

    这样,Python就会从当前模块所在的包中寻找config模块,而不是从全局命名空间中寻找。这是一种有效的解决方法,但如果项目B非常复杂,有大量的导入语句需要修改,这可能会变得非常繁琐。

    解决方案二:添加环境变量PYTHONPATH

    另一种解决方案是通过添加环境变量PYTHONPATH来告诉Python在哪里查找模块。您可以在项目A的根目录下执行以下命令:

    export PYTHONPATH='.'

    这会将当前目录添加到PYTHONPATH中,使得Python能够找到项目B中的模块。这种方法在开发环境中是有效的,但要注意,在生产环境中可能会导致命名空间冲突,因此需要谨慎使用。

    解决方案三:使用相对导入

    最好的解决方案是使用相对导入,即使项目B非常复杂。相对导入可以确保在项目A中导入项目B的模块时,始终从项目B的根目录开始查找,而不会依赖于环境变量或绝对路径。在项目B中,只需将导入语句改为:

    from .config import PDF_FILE

    这样,无论项目B有多复杂,都能保持模块导入的一致性,减少了维护的难度。

    结论

    在处理Python项目时,正确的模块导入是非常重要的。虽然可以通过修改导入语句或添加环境变量来解决导入问题,但最好的做法是使用相对导入,以确保项目的可维护性和一致性。

    无论项目有多复杂,相对导入都可以避免命名空间冲突和依赖于环境变量的问题。因此,建议在项目开发中始终使用相对导入来确保代码的可移植性和可维护性。

  • 正则表达式在Python爬虫中的应用与处理技巧

    正则表达式在Python爬虫中的应用与处理技巧

    在网络时代,数据是无处不在的。无论您是做市场研究、数据分析还是需要从网站中获取信息,Python爬虫是一个强大的工具,能够帮助您收集、提取和处理网页上的数据。而正则表达式是Python爬虫中不可或缺的工具之一。本文将深入介绍正则表达式在Python爬虫中的应用与处理技巧,帮助您更好地利用这一工具来解决各种数据抓取和处理的问题。

    1. 正则表达式是什么?

    正则表达式是一种强大的文本匹配和处理工具,它允许您定义一种模式,然后在文本中搜索和匹配符合该模式的内容。在Python中,正则表达式的操作由re模块提供支持。正则表达式的模式可以包含特殊字符和元字符,用于表示文本中的模式。

    2. 正则表达式在Python中的应用

    2.1 爬虫中的网页内容提取

    正则表达式在爬虫中最常见的用途之一是从网页内容中提取所需的信息。例如,您可以使用正则表达式来匹配和提取网页中的电子邮件地址、电话号码、价格、日期等信息。

    2.2 数据清洗与处理

    在爬取到数据后,通常需要进行清洗和处理,以使其符合您的需求。正则表达式可以帮助您快速定位和替换不需要的文本、特殊字符或HTML标签。

    2.3 网址抓取与链接提取

    正则表达式还可用于从网页中提取链接和URL。这对于构建网站地图、链接数据库或进行深度爬取非常有用。

    3. Python中的正则表达式操作

    3.1 匹配与搜索

    在Python中,使用re模块的match()函数可以在文本的开头匹配正则表达式,而search()函数可以在整个文本中搜索匹配。这两个函数返回的是一个匹配对象,您可以使用其方法来获取匹配的内容。

    3.2 查找所有匹配项

    使用findall()函数可以查找文本中所有与正则表达式匹配的部分,并返回一个包含所有匹配项的列表。

    3.3 替换与修正

    sub()函数可以用来替换文本中与正则表达式匹配的部分。这对于数据清洗和修正非常有用。

    3.4 分组

    正则表达式中的分组允许您捕获和提取匹配的特定部分。通过使用小括号将模式分组,您可以轻松地访问和处理这些部分。

    4. 实际应用案例

    4.1 提取电子邮件地址

    我们将展示如何使用正则表达式从一个网页中提取电子邮件地址。这对于建立联系列表或进行市场营销非常有用。

    4.2 清洗HTML标签

    我们将演示如何使用正则表达式从HTML文本中清除所有HTML标签,以便提取纯文本内容。

    4.3 提取价格信息

    我们将展示如何从电子商务网站中提取产品价格信息,以进行价格监控或市场竞争分析。

    5. 总结与建议

    正则表达式是Python爬虫中强大而灵活的工具,但也需要谨慎使用,避免出现不必要的复杂性。在使用正则表达式时,请始终测试您的模式,并确保它们适用于不同类型的文本。此外,考虑使用Beautiful Soup等库来解析和处理HTML,以避免正则表达式处理复杂HTML的困难。

    希望本文能帮助您更好地理解正则表达式在Python爬虫中的应用,以及如何使用它们来解决各种数据抓取和处理的问题。

  • Go项目目录命名:分割与否的争议

    Go项目目录命名:分割与否的争议

    Go语言是一门以简洁和效率著称的编程语言,但在项目开发中,一个常见的争议是关于项目目录的命名规范。具体来说,是应该在多个单词之间使用下划线进行分割,还是直接将多个单词连接在一起,全小写,不做分割?这个问题一直困扰着开发者们。本文将深入探讨这个争议,以及不同方式的优缺点。

    1. 不分割:clientapi, serverapi

    在不分割目录名称时,通常会采用全小写的方式,并将多个单词直接连接在一起。例如,clientapi和serverapi。这种方式的优点是简洁,符合Go语言的命名风格,不容易引起歧义。此外,它也适合项目的主目录名称,使整个项目结构更加清晰。

    2. 分割:client_api, server_api

    分割目录名称时,通常会在多个单词之间使用下划线进行分割,例如,client_api和server_api。这种方式的优点是可读性更强,单词之间的分隔符使目录名称更清晰明了,有助于理解目录的用途。此外,对于较长的目录名称,分割可以提高可读性和维护性。

    3. 项目实例

    在讨论中,有人提到了一些知名开源项目的实际例子。例如,Kubernetes、etcd、和Prometheus等项目通常采用了不分割的方式,保持了目录名称的简洁性。然而,也有像InfluxData的Telegraf项目等项目采用了分割的方式,以增强可读性和清晰性。

    4. 遵循官方建议

    Go语言官方建议包名应该为小写单词,不要使用下划线或混合大小写。但在项目名方面,可以使用中划线来连接多个单词。这意味着对于主目录名称,不分割是更符合官方建议的方式,而对于子目录名称,分割可以提高可读性。

    5. 结论

    Go项目目录命名的分割与否存在争议,没有一种绝对正确的方式。最重要的是要根据项目的实际需求和团队的偏好来选择合适的方式。不分割的方式简洁,符合官方建议,适用于主目录名称。而分割的方式可读性更强,适用于子目录名称,特别是对于较长的目录名称。

    最终,关键是要保持一致性,遵循团队内部的规范,以确保项目的可维护性和可读性。

  • 如何使用FRP实现通过同一域名+SSL+不同端口访问内网穿透服务

    如何使用FRP实现通过同一域名+SSL+不同端口访问内网穿透服务

    在现代社会中,我们经常需要访问家庭或企业内部的网络服务,但由于网络配置的限制,往往无法直接通过公网IP来访问这些服务。这时,内网穿透技术就派上了用场。在本文中,我们将介绍如何使用FRP(Fast Reverse Proxy)来实现通过同一域名+SSL+不同端口来访问内网穿透服务,让您能够轻松访问您的网络资源。

    准备工作

    在开始之前,确保您已经完成以下准备工作:

    • 在公网服务器上安装FRPS(FRP服务器端)
    • 在内网设备上安装FRPC(FRP客户端)
    • 拥有一个域名并将其解析到您的公网服务器

    实现步骤

    1. 在公网服务器上配置反向代理

    在公网服务器上,您可以选择使用不同的Web服务器软件,如Apache或Nginx,来配置反向代理。这里以Nginx为例:

    使用Nginx配置多个虚拟主机

    在Nginx配置文件中,您可以创建多个虚拟主机,每个虚拟主机监听不同的端口,并将请求代理到FRP穿透服务的相应端口。示例Nginx配置如下:

    server {
        listen 9080;
        server_name yourdomain.com;
    
        location / {
            proxy_pass http://127.0.0.1:10001;  # 将请求代理到FRP客户端的端口10001
        }
    }
    
    server {
        listen 9081;
        server_name yourdomain.com;
    
        location / {
            proxy_pass http://127.0.0.1:10002;  # 将请求代理到FRP客户端的端口10002
        }
    }
    
    server {
        listen 9082;
        server_name yourdomain.com;
    
        location / {
            proxy_pass http://127.0.0.1:10003;  # 将请求代理到FRP客户端的端口10003
        }
    }

    这样,不同的端口将被代理到不同的FRP客户端端口,实现了同一域名+不同端口的访问。

    2. 配置SSL证书

    为了保障数据传输的安全性,我们可以为每个虚拟主机配置SSL证书。您可以使用免费的Let’s Encrypt证书来实现SSL加密。

    3. 域名解析

    确保您的域名已经正确解析到公网服务器的IP地址。

    4. 配置FRP客户端

    在内网设备上,配置FRP客户端,将不同的服务映射到不同的本地端口。确保FRP客户端的配置与Nginx反向代理配置一致。

    5. 访问您的服务

    现在,您可以通过同一域名+SSL+不同端口来访问您的内网穿透服务了。只需使用域名和相应的端口号即可访问不同的服务,而无需记住复杂的IP地址和端口号。

    总结

    通过FRP、Nginx、SSL证书以及域名解析,您可以实现通过同一域名+SSL+不同端口来访问内网穿透服务。这种方式不仅方便了访问,还增强了数据的安全性。希望本文对您有所帮助,让您更好地管理和访问您的网络资源。

  • 项目介绍:将特朗普的推特转化为金钱的神奇机器

    项目介绍:将特朗普的推特转化为金钱的神奇机器

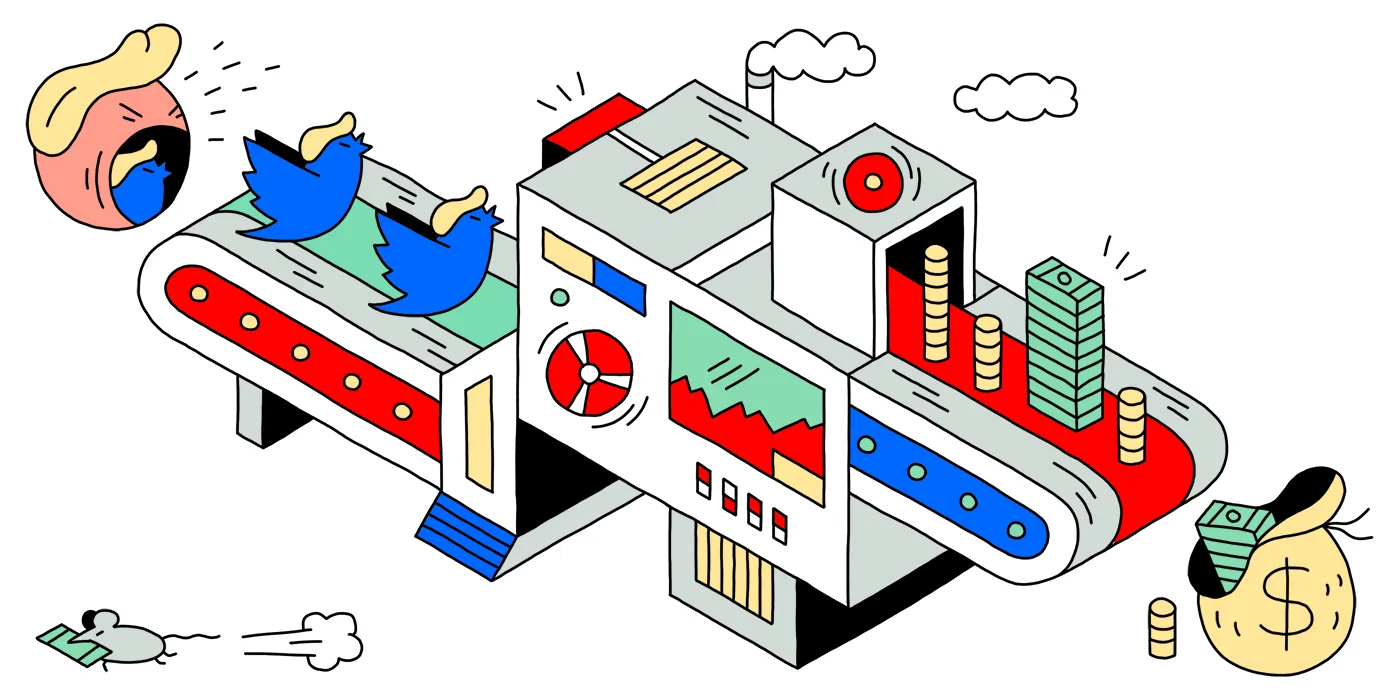
    特朗普,这个名字不仅仅代表着美国政治的一个时代,还代表着一个独特的市场影响力。在他担任美国总统期间,他的推特言论不仅影响了政治舞台,还对股市产生了巨大的波动。而现在,有一台神奇的机器,能够将特朗普的推特转化为金钱,让我们来一探究竟。
    开篇故事

    故事的开头,让我们想象一下这样一个场景:特朗普刚刚发布了一条推特,内容是对某个大型上市公司的评论。这个时候,一个神奇的机器开始运行,自动分析特朗普的情感,判断他的评论是积极的还是消极的。然后,这台机器自动进行股票交易,根据市场预期的反应来赚取巨额利润。同时,机器还会在推特上发布实时摘要,告诉世界这一切。

    这听起来像是科幻小说中的情节,但实际上,这个项目就叫做Trump2Cash,而且它是真实存在的。

    Trump2Cash是什么?

    Trump2Cash是一个基于Python编写的自动化交易机器,它的任务是监视特朗普的推特,并等待他提到任何上市公司。一旦他这样做,它将使用情感分析来确定他对这些公司的态度是积极的还是消极的。然后,这台机器会根据预期的市场反应自动执行相关股票交易。与此同时,它还会在@Trump2Cash上实时发布项目摘要。

    这个项目的核心功能包括:

    • 监听特朗普的推特,等待他提到上市公司。
    • 使用情感分析来确定特朗普对这些公司的情感态度。
    • 根据情感分析结果,执行相应的股票交易策略。
    • 在推特上发布交易摘要,告诉大家项目的进展。

    为什么这个项目如此令人感兴趣?

    这个项目之所以如此令人感兴趣,有几个独特之处:

    特朗普的影响力

    特朗普是一位备受关注的政治人物,他的推特言论经常引起全球媒体的关注。他的一句话可以影响股市的波动,这种影响力是前所未有的。因此,能够自动化地分析并利用他的推特对股票市场进行交易,无疑是一个极具吸引力的创意。

    技术复杂性

    这个项目不仅仅是一个简单的Twitter机器人,它结合了多个复杂的技术和API。它使用了Google的自然语言处理API来进行情感分析,使用Wikidata Query Service来获取公司数据,还使用了TradeKing API来执行股票交易。这种技术复杂性使得项目更加引人注目。

    自动化交易

    Trump2Cash的最大魅力之一是它的自动化交易能力。一旦特朗普发布了相关推特,机器就能够自动执行股票交易,无需人工干预。这种自动化能力可以在股票市场上创造更多机会,同时降低了人为错误的风险。

    项目背后的技术

    要实现这个项目,需要使用一系列技术和API。以下是项目背后的一些关键技术:

    Twitter Streaming APIs

    项目使用Twitter Streaming APIs来获取特朗普的推特。这些API允许开发者实时监测特定用户的推特流,以便及时获取最新的信息。

    Google Cloud Natural Language API

    Google的自然语言处理API用于对特朗普的推特进行情感分析。它能够识别文本中的情感,并为文本分配情感分数,帮助机器判断评论是积极的还是消极的。

    Wikidata Query Service

    Wikidata Query Service提供了公司数据的来源。通过这个服务,机器能够获取到特朗普提到的公司的相关信息,包括股票代码等。

    TradeKing API

    TradeKing API用于执行股票交易。一旦机器分析出了特朗普的情感,它将自动选择适当的交易策略,如买入或卖空,并执行相应的交易操作。

    如何运行这个项目?

    如果你也想尝试运行这个项目,以下是一些关键步骤:

    1. 创建VM实例

    首先,你需要在Google Cloud Platform上创建一个虚拟机实例。你可以按照快速入门指南的步骤来完成这一步骤。选择一个适合你需求的机器类型。

    2. 设置认证

    这个项目使用了多个API,因此你需要设置相应的认证信息。具体步骤如下:

    Twitter

    • 登录你的

    Twitter账号,创建一个新的应用程序。在应用程序的“Keys and Access Tokens”选项卡下,你将找到“Consumer Key”和“Consumer Secret”,将它们导出为环境变量。

      export TWITTER_CONSUMER_KEY=""
      export TWITTER_CONSUMER_SECRET=""
    • 如果你希望推特来自与应用程序相同的账户,你可以使用相同页面上的“Access Token”和“Access Token Secret”。如果你想要从不同的账户发推特,可以按照Twitter的步骤获取访问令牌,并将它们导出为环境变量。

      export TWITTER_ACCESS_TOKEN=""
      export TWITTER_ACCESS_TOKEN_SECRET=""

    Google

    TradeKing

    • 登录你的TradeKing账号,创建一个新的应用程序。在应用程序的“Details”选项下,你将找到“Consumer Key”、“Consumer Secret”、“OAuth (Access) Token”和“Oauth (Access) Token Secret”,将它们导出为环境变量。

      export TRADEKING_CONSUMER_KEY=""
      export TRADEKING_CONSUMER_SECRET=""
      export TRADEKING_ACCESS_TOKEN=""
      export TRADEKING_ACCESS_TOKEN_SECRET=""
    • 你还需要导出你的TradeKing账号号码,你可以在My Accounts下找到它。

      export TRADEKING_ACCOUNT_NUMBER=""

    3. 安装依赖

    这个项目有一些库依赖项,你可以使用pip来安装它们。

    pip install -r requirements.txt

    4. 运行测试

    为了确保一切都按预期工作,你可以运行测试来验证。

    export USE_REAL_MONEY=NO && pytest *.py -vv

    5. 运行基准测试

    项目中提供了一个基准测试报告,展示了分析和交易算法在历史数据上的表现。你可以运行它来检验任何可能的改动。

    export POLYGON_API_KEY="<YOUR_POLYGON_API_KEY>"
    python benchmark.py > benchmark.md

    6. 启动机器

    最后,如果你想要启用真实订单,即使用你的资金进行交易:

    export USE_REAL_MONEY=YES

    然后,使用以下命令在后台运行代码:

    nohup python main.py &

    项目的未来

    Trump2Cash是一个令人惊叹的项目,但它也有着无限的潜力。未来,这个项目可能会进一步发展,包括以下方面的改进:

    • 增强的情感分析:改进情感分析算法,使其更准确地理解特朗普的情感。

    • 更多的交易策略:引入更多的交易策略选项,以适应不同的市场情况。

    • 扩展到其他领域:将类似的自动化交易机器应用到其他领域,不仅限于特朗普的推特。

    无论如何,Trump2Cash已经证明了自动化交易在股票市场中的巨大潜力,让我们拭目以待,看看它未来会有什么样的发展。

    这就是Trump2Cash项目的介绍,一个将特朗普的推特转化为金钱的神奇机器。无论你是对金融市场感兴趣,还是对技术创新充满好奇心,这个项目都是一个令人着迷的案例。

  • 建立GRE over IPSec隧道的网络连接教程

    建立GRE over IPSec隧道的网络连接教程

    在网络通信中,选择适当的协议和技术来建立安全、高效的连接至关重要。在某些情况下,GRE(通用路由封装)结合IPSec(Internet协议安全)是一种常见的选择,尤其在需要多个站点网络互联、支持路由协议和数据加密的情况下。本文将探讨为什么选择GRE over IPSec,以及如何在RouterOS V7.10环境下建立GRE over IPSec隧道。

    为何选择GRE over IPSec

    1. 多站点网络互联: 当你需要连接多个站点的网络,而且这些站点之间网络较复杂时,GRE over IPSec可以是一个理想的选择。它允许你在不同站点之间建立虚拟隧道,使数据可以在这些隧道上传输。

    2. 支持路由协议: GRE隧道可以传递路由协议,如RIP(路由信息协议),这在需要动态路由的情况下非常有用。相比之下,IPSec不支持组播和路由协议,因此在这方面不如GRE方便。

    3. 数据加密: IPSec提供了数据加密的能力,这意味着你可以在GRE隧道上运行的数据进行安全传输。这是保护敏感信息的关键。

    4. 广泛应用: 在Cisco等设备上,GRE over IPSec的组合被广泛应用。它已被证明是一种稳定、可靠的解决方案。

    应用场景

    在企业中,有多个分支办公室分布在不同地点,但需要共享中央办公室的文件服务器、打印服务器和软件服务器。这就是所谓的GPN(全球私有化网络)场景。通过建立GRE over IPSec隧道,这些分支办公室可以在本地使用中央办公室的资源,同时比使用公共互联网更加安全。

    实验环境

    本教程使用了EVE-NG虚拟化平台和RouterOS V7.10。

    步骤

    1. ROS-1设置步骤

    创建GRE Tunnel接口

    在ROS-1路由器上,首先创建GRE Tunnel接口。在这个示例中,我们将命名它为 gre-tunnel-R1,远端地址为 192.168.3.19。同时,我们将使用IPsec Secret进行加密。

    /interface gre
    add allow-fast-path=no name=gre-tunnel-R1 remote-address=192.168.3.19

    设置GRE接口IP地址

    接下来,为 gre-tunnel-R1 接口设置一个IP地址。在这个示例中,我们将使用 100.1.1.1/24。

    /ip address
    add address=100.1.1.1/24 interface=gre-tunnel-R1 network=100.1.1.0

    配置RIP广播协议

    为了支持路由协议,我们需要配置RIP广播协议。这里我们创建了一个RIP实例,并将其应用于GRE接口。

    /routing rip instance
    add disabled=no name=rip-instance-R1 redistribute=connected
    
    /routing rip interface-template
    add disabled=no instance=rip-instance-R1 interfaces=gre-tunnel-R1

    2. ROS-2设置步骤

    在ROS-2路由器上,我们执行与ROS-1相似的步骤。

    创建GRE Tunnel接口

    创建GRE Tunnel接口,命名为 gre-tunnel-R2,远端地址为 192.168.3.20,使用IPsec Secret进行加密。

    /interface gre
    add allow-fast-path=no name=gre-tunnel-R2 remote-address=192.168.3.20

    设置GRE接口IP地址

    为 gre-tunnel-R2 接口设置IP地址,例如 100.1.1.2/24。

    /ip address
    add address=100.1.1.2/24 interface=gre-tunnel-R2 network=100.1.1.0

    配置RIP协议

    为支持路由协议,配置RIP广播协议,类似于ROS-1。

    3. 测试连接

    完成ROS-1和ROS-2的设置后,你可以测试两端的电脑是否成功ping通,以验证GRE over IPSec隧道连接是否正常。

    其它说明

    • 在本示例中,IPSec采用RouterOS的默认配置,但你也可以根据自己的需求进行加密设置。

    通过这个教程,你可以学习如何使用GRE over IPSec建立安全、支持路由协议的隧道连接,适用于多站点网络互联的情况,以及保护数据的需求。

  • 安装国产操作系统通用打印驱动 – 适用于奔图等国产打印机

    安装国产操作系统通用打印驱动 – 适用于奔图等国产打印机

    在使用国产电脑和国产打印机的环境中,有时我们可能会遇到一些挑战,特别是在安装打印机驱动程序方面。奔图等国产打印机在Linux系统下的支持文档相对较少,这给一些用户带来了困扰。本文将介绍一个适用于大部分国产操作系统和国产打印机的解决方案,以奔图P2206NW为例,系统为UOS,同时也适用于其他基于Debian的操作系统,如麒麟、深度等。

    安装国产操作系统通用打印驱动 – 适用于奔图等国产打印机

    步骤一:安装CUPS

    首先,我们需要安装CUPS(通用UNIX打印系统)。CUPS是一个用于管理打印机和打印任务的开源打印系统。

    你可以通过以下命令检查系统中已支持的打印机类型是否包括奔图的相关机型:

    lpinfo -m | grep Pantum

    如果没有找到相应的机型,那么我们需要安装奔图打印机的Linux版驱动。你可以联系我获取驱动。

    步骤二:安装奔图打印机驱动

    1. 解压下载的奔图打印机Linux版驱动文件。

    2. 在解压后的文件夹中,你会找到一个名为 install.sh 的文件,这是为桌面版Linux使用的。但在 Resources 文件夹中,你会发现 pantum-1.1.5-amd64.deb 和 pantum-1.1.5-i386.deb 两个文件,你可以使用 dpkg 来进行安装:

    sudo dpkg -i pantum-1.1.5-amd64.deb
    1. 安装完成后,再次使用 lpinfo 命令查看支持的打印机型号列表。如果驱动安装成功,你将会看到支持的机型中新增了奔图的产品。
    sudo lpinfo -m | grep Pantum

    步骤三:添加奔图打印机

    现在,你可以使用 lpadmin 命令来添加奔图打印机了。以下是添加的示例命令,其中 pantum2200nw 是我给打印机起的名字,socket://your_printer_address 是你的打印机地址,请将其替换为实际的地址。

    sudo lpadmin -p pantum2200nw -v socket://your_printer_address -E -m "Pantum/Pantum P2200NW Series.ppd"

    步骤四:打印文件

    添加打印机后,你可以使用以下命令来打印文件,将 <YOUR_FILENAME> 替换为你要打印的文件名:

    sudo lpr -P pantum2200nw <YOUR_FILENAME>

    这样,你就成功地安装了奔图打印机的驱动,并可以开始打印文件了。

    结语

    通过这个简单的步骤,你可以在国产操作系统上安装奔图等国产打印机的通用驱动,无论你使用的是UOS还是其他基于Debian的操作系统。希望这个教程对你有所帮助,让你更轻松地使用国产打印机。

  • Ubuntu 20.04 安装后的配置指南

    Ubuntu 20.04 安装后的配置指南

    你是否刚刚安装好了 Ubuntu 20.04,但感到有些不知所措?别担心,这篇文章将为你提供一份详尽的配置指南,帮助你将系统调整到最佳状态,以满足你的需求。无论是提高系统性能、安全性,还是让桌面环境更加舒适,我们都将一一介绍。

    第一部分:系统基本配置

    1. 更新系统

    首先,打开终端,输入以下命令,以确保系统已更新至最新版本:

    sudo apt update
    sudo apt upgrade

    2. 添加常用软件源

    为了能够顺畅安装软件,我们可以添加常用的软件源:

    sudo add-apt-repository universe
    sudo add-apt-repository multiverse
    sudo add-apt-repository restricted

    3. 安装基本工具

    在默认安装的 Ubuntu 中,有些基本工具可能没有预装,你可以使用以下命令安装它们:

    sudo apt install curl wget git

    4. 设置系统时区

    确保系统的时区设置正确,你可以使用以下命令来配置:

    sudo dpkg-reconfigure tzdata

    5. 安装常用字体

    提高系统字体质量和显示效果,安装一些常用字体:

    sudo apt install fonts-firacode fonts-roboto

    第二部分:桌面环境定制

    1. 选择桌面环境

    Ubuntu 20.04 默认使用 GNOME 桌面环境,但你可以根据个人偏好选择其他桌面环境,比如 KDE、Xfce、或 LXQt。安装新桌面环境的命令如下:

    # 以安装 KDE Plasma 桌面为例
    sudo apt install kubuntu-desktop

    2. 美化桌面

    为了美化你的桌面环境,你可以安装一些主题和图标包。可以在软件中心搜索并安装你喜欢的主题,然后在系统设置中应用它们。

    3. 设置壁纸

    为桌面选择一张漂亮的壁纸,让你的工作环境更加舒适。你可以在系统设置中轻松更改壁纸。

    4. 安装扩展

    GNOME 桌面支持扩展,你可以根据需求安装一些扩展,以增强功能和定制桌面环境。一些常见的扩展包括 Dash to Dock、Workspace Matrix、和 Arc Menu。

    第三部分:系统优化和安全性

    1. 清理系统

    定期清理系统,删除不必要的临时文件和缓存:

    sudo apt autoremove
    sudo apt clean

    2. 安装防病毒软件

    尽管 Linux 系统相对较安全,但也不是绝对安全的。你可以考虑安装 ClamAV 或其他防病毒软件来提高系统的安全性。

    sudo apt install clamav

    3. 配置防火墙

    Ubuntu 20.04 默认启用了 UFW 防火墙,你可以配置它来加强系统的安全性。确保只开放必要的端口。

    # 启用 UFW
    sudo ufw enable
    
    # 开放 SSH 端口(如果需要)
    sudo ufw allow ssh
    
    # 开放其他需要的端口,如 HTTP(80)和 HTTPS(443)
    sudo ufw allow 80/tcp
    sudo ufw allow 443/tcp
    
    # 最后,重启防火墙
    sudo ufw reload

    4. 安装 Fail2ban

    Fail2ban 是一个用于防止暴力破解攻击的工具。安装并配置它可以提高系统的安全性。

    sudo apt install fail2ban

    第四部分:开发环境配置

    如果你是开发人员,还可以对开发环境进行一些配置。

    1. 安装编程语言

    根据你的需求,安装所需的编程语言和开发工具。比如,安装 Python:

    sudo apt install python3

    2. 配置开发环境

    安装集成开发环境(IDE)或文本编辑器,如 Visual Studio Code、PyCharm 或 Sublime Text,以便更轻松地进行编码工作。

    3. 安装版本控制工具

    如果你使用版本控制来管理代码,安装 Git 并设置你的身份信息:

    sudo apt install git
    git config --global user.name "Your Name"
    git config --global user.email "[email protected]"

    结语

    通过按照以上步骤进行配置,你可以将 Ubuntu 20.04 调整到最佳状态,以满足你的需求。无论是日常使用、开发工作还是安全性,这些配置都将有助于提高你的系统体验。希望这篇指南对你有所帮助!

  • AI崛起:电力消耗的新挑战

    AI崛起:电力消耗的新挑战

    你有没有想过,当你在使用AI助手时,它到底需要多少电力?或者当你进行一次谷歌搜索时,会耗费多少电力?AI技术的崛起给我们带来了无限便利,但同时也带来了一个巨大的挑战:能源消耗。让我们一起探讨这一问题,看看AI如何消耗电力,以及它对我们的生活和星球产生了哪些影响。

    AI崛起:电力消耗的新挑战

    AI的电力饕餮盛宴

    AI技术的崛起是当今科技领域最引人注目的事件之一。它已经渗透到我们的日常生活中,从语音助手到自动驾驶汽车,再到智能家居设备,AI无处不在。然而,这些看似神奇的技术背后,隐藏着巨大的电力需求。

    以Hugging Face为例,这家知名的AI公司曾经报告称,他们的多语言文本生成AI工具在训练期间消耗了约433兆瓦时(MWH)的电力,相当于为40个普通美国家庭供电一年。这个数字让人大吃一惊,因为我们通常认为AI只是一台电脑运行的软件,但实际上,它需要大量的能源来进行训练和运行。

    AI的电力背后的故事

    为了更好地理解AI的电力消耗,让我们深入挖掘一下它背后的故事。当AI工具进行训练时,它们需要大量的计算能力和能源。这包括数据中心中的数百台服务器,以及它们所需的冷却系统,以保持温度在可接受的范围内。这些数据中心通常位于偏远地区,因为它们需要大量的空间,并且需要稳定的电力供应。

    但电力消耗不仅仅发生在训练阶段。当我们使用AI工具时,比如ChatGPT,它也会消耗大量的电力。每天运行ChatGPT可能需要564兆瓦时的电力,这相当于一个小型城市的日常用电量。这是因为在AI生成文本或图像时,它需要进行大量的计算,以确保输出是准确和有意义的。

    杰文斯悖论:效率提高与资源增加的冲突

    当然,许多公司都在努力提高AI硬件和软件的效率,以降低能源消耗。然而,这引出了一个有趣的问题,即杰文斯悖论。这个悖论的核心思想是,尽管我们提高了技术的效率,但却增加了对资源的需求。为什么会这样呢?

    效率提高通常会导致更多的人和应用程序开始使用AI技术。换句话说,当AI变得更容易使用和更高效时,它将被更广泛地采用。这意味着更多的AI工具将被部署,消耗更多的电力和计算资源。因此,虽然每个AI工具的电力消耗可能会降低,但总体电力消耗可能会增加。

    荷兰阿姆斯特丹自由大学的Alex de Vries指出:“提高这些工具的效率和易用性的结果可能是,我们允许更多的应用程序和更多的人使用它。” 这是一个有趣的现象,需要我们认真思考如何在技术进步和资源可持续性之间取得平衡。

    AI的电力需求:惊人的数字

    让我们来看一个令人震惊的数字:如果每一次谷歌搜索都使用AI技术,那么每年将需要大约29.2太瓦时(TWH)的电力。这相当于爱尔兰一年的用电量!这个数字让人印象深刻,因为谷歌搜索是我们日常生活中的一个常见行为,而且我们通常不会考虑到它背后的电力需求。

    更令人担忧的是,根据研究,到2027年,全球AI相关的电力需求预计每年将增加85到134太瓦时。这相当于荷兰、阿根廷、瑞典等国家的年用电量。这是一个庞大的数字,引发了对电力供应和环境可持续性的担忧。

    AI的未来:找到平衡点

    虽然AI技术带来了无限的潜力,但我们必须找到一种方法来平衡其电力需求和资源可持续性。这不仅涉及到提高AI技术的能源效率,还包括寻找可再生能源和清洁能源供应的途径。同时,我们也需要思考如何在AI的广泛应用和资源保护之间取得平衡。

    政府、科技公司和个人都有责任来应对这一挑战。政府可以出台政策,鼓励可持续能源的使用,同时也可以制定监管措施,以确保AI技术的电力消耗在可控范围内。科技公司可以继续投资研发,提高AI技术的效率,并积极采用可再生能源。而每个人也可以通过节约能源和支持环保举措来为解决这一问题做出贡献。

    结语

    AI技术的电力需求是一个迫切需要解决的问题。虽然它为我们带来了便利,但也给我们的星球带来了巨大的负担。我们必须在技术进步和资源保护之间找到平衡点,以确保我们的未来更加可持续。只有这样,我们才能继续享受AI技术带来的好处,而不会伤害我们的环境。

    以上就是关于AI电力消耗的一些思考和数据。我们应该密切关注这一问题,并为解决它而共同努力。

  • Nvidia与Masterpiece Studio合作,革新3D建模领域

    Nvidia与Masterpiece Studio合作,革新3D建模领域

    近日,世界领先的图形处理器制造商Nvidia与3D软件开发商Masterpiece Studio宣布了一项令人振奋的合作,推出了名为”Masterpiece X”的全新软件。这一合作旨在彻底改变3D建模的方式,使其变得像创建二维图像一样简单。

    Masterpiece X的目标是通过借鉴与MidJourney或Stable Diffusion等工具相似的理念,使3D建模变得直观而容易上手。这一合作在3D建模领域引发了巨大的关注,因为它可能会为艺术家、设计师和创意人士提供前所未有的工具和机会。

    3D建模的革新之路

    Masterpiece Studio在官方声明中表示:“多年来,我们一直在努力创建直观的尖端3D工具,同时也使越来越多的人能够开始创建3D。生成式AI实现了全新的可能性。”

    这一合作的目标是让3D建模不再是高门槛的领域,而是变得更加开放和包容。通过结合Nvidia的强大计算能力和Masterpiece Studio的创新软件,他们希望能够降低3D建模的学习曲线,让更多人能够轻松进入这一领域。

    云端3D建模的未来

    除了改变3D建模的方式,Masterpiece X还引入了另一个令人激动的概念:云端建模。这意味着用户不再需要依赖本地硬件或软件来创建3D模型,一切都可以在云端实现。

    “你所需要的只是一个键盘,一个浏览器,一点想象力,以及几个单词,”他们在声明中写道。这种云端建模的方式极大地降低了使用门槛,让更多人可以轻松参与到3D建模的创作中来。

    潜力与挑战

    然而,尽管这一合作充满了潜力,但在测试中取得的效果并不总是如人所愿。有人将其描述为”儿童机器人”更像一只胖乎乎的鸽子,而另一些渲染则看起来更像是一个醉酒的流浪汉。这些挑战显示出,尽管AI在3D建模中具有巨大的潜力,但还需要进一步的改进和优化。

    尽管如此,这些测试结果也表明了Masterpiece X软件的巨大潜力。从现有的模型开始,更容易获得所需的结果,而不必从头开始创建设计。这将为3D建模领域带来一场革命,让更多人可以轻松参与到创意的世界中来。

    展望未来

    这一合作的推出代表了3D建模领域的一次革命性尝试。随着技术的不断发展,我们可以期待看到更多类似的合作和创新,为创意产业带来更多可能性。虽然目前还存在挑战,但这一合作无疑为3D建模领域的未来铺平了道路,让更多人可以探索、创造和想象。

    结语

    Nvidia与Masterpiece Studio的合作是科技与艺术的结合,是革新与创造的交汇点。无论你是一名艺术家、设计师还是创意人士,这一合作都将为你提供更多工具和机会,让你的创意得以更好地表达。让我们期待未来,看到3D建模领域的不断发展和创新。