Category: 技术折腾

服务器、网络、硬件与自建工具的实践记录。

  • Ubuntu 20.04教程:安装、配置、和使用指南

    Ubuntu 20.04教程:安装、配置、和使用指南

    在数字化时代,操作系统是我们计算机生活的核心。Ubuntu 20.04是一款基于Linux的操作系统,它凭借其稳定性、安全性和易用性,成为了个人和企业用户的首选。无论您是计算机新手还是经验丰富的用户,本教程将为您介绍如何安装、配置和使用Ubuntu 20.04,帮助您掌握这个强大的操作系统。

    第一步:下载Ubuntu 20.04

    首先,您需要前往Ubuntu官方网站,从中下载适合您计算机架构的Ubuntu 20.04镜像文件。您可以选择64位或32位版本,根据您的计算机配置进行选择。下载完成后,将镜像文件保存在您的计算机上的任何位置。

    第二步:创建启动盘

    接下来,您需要将Ubuntu 20.04镜像文件写入USB闪存驱动器或DVD。为此,您可以使用工具如Rufus、Etcher或UNetbootin。将启动盘插入计算机,并确保在计算机启动时从该启动盘启动。

    第三步:安装Ubuntu 20.04

    当您的计算机从启动盘启动时,您将看到Ubuntu 20.04的安装界面。选择“Install Ubuntu”选项,然后按照屏幕上的指示进行安装。

    在安装过程中,您将需要选择一些选项,如语言、键盘布局和时区。同时,您还需要决定是否与其他操作系统(如Windows)共存,或者是否要将整个磁盘用于Ubuntu。

    在安装过程中,您还需要创建一个用户名和密码,以及选择是否自动登录。完成所有选项后,点击“Install”按钮开始安装。

    第四步:使用Ubuntu 20.04

    一旦安装完成,您可以重新启动计算机并进入Ubuntu 20.04。您将看到一个友好的桌面环境,类似于Windows或Mac。

    在Ubuntu 20.04中,您可以使用左侧的启动器访问各种应用程序和系统设置。右上角的网络图标可以让您轻松连接无线网络。

    Ubuntu 20.04还提供了一个应用商店,您可以在其中搜索和安装各种应用程序。此外,您也可以使用终端来安装软件包,只需使用以下命令:

    sudo apt-get install 软件包名称

    终端还允许您执行各种其他操作,如文件管理、系统配置和软件更新。

    第五步:学习Ubuntu 20.04

    Ubuntu 20.04是一个功能强大的操作系统,提供了众多功能和工具。为了更好地使用Ubuntu 20.04,您可以参考官方文档、在线教程和社区论坛。

    同时,您还可以尝试使用不同的应用程序和功能,以了解它们的工作原理。通过实践和探索,您将逐渐熟悉Ubuntu 20.04,并能够充分利用其功能。

    总结

    通过按照上述步骤安装和使用Ubuntu 20.04,您将能够体验到这个流行的Linux操作系统的强大功能。无论是日常使用还是开发工作,Ubuntu 20.04都是一个可靠的选择。祝您在Ubuntu 20.04上玩得开心!
  • 教程:如何使用AI进行虚拟货币相关新闻的情绪分析

    教程:如何使用AI进行虚拟货币相关新闻的情绪分析

    虚拟货币市场充满了机会和风险,投资者常常需要依靠各种信息来做出决策。在这篇教程中,我们将学习如何使用情感分析技术,通过分析虚拟货币相关的新闻,预测市场走势。我们将使用Python编程语言,并结合TextBlob库进行情感分析,同时利用网络爬虫技术来获取新闻文本。

    步骤1:环境准备

    在开始之前,确保您已安装了以下必要的Python库:

    pip install textblob beautifulsoup4 requests
    python -m textblob.download_corpora

    步骤2:编写代码

    获取新闻文本

    首先,我们需要从新闻网站获取相关文章的文本内容。我们将使用BeautifulSoup库来简化网络爬虫任务。

    import requests
    from bs4 import BeautifulSoup
    
    def get_news_text(url):
        response = requests.get(url)
        soup = BeautifulSoup(response.text, 'html.parser')
        paragraphs = soup.find_all('p')
        news_text = ' '.join([para.text for para in paragraphs])
        return news_text

    进行情感分析

    接下来,我们将使用TextBlob库对获取的新闻文本进行情感分析。情感分析将文本的情感倾向划分为正面、中性或负面。

    from textblob import TextBlob
    
    def analyze_sentiment(news_text):
        analysis = TextBlob(news_text)
        if analysis.sentiment.polarity > 0:
            return '正面'
        elif analysis.sentiment.polarity == 0:
            return '中性'
        else:
            return '负面'

    预测市场走势

    最后,我们将根据多个新闻来源的情感分析结果,预测市场可能的走势。我们将统计情感分析结果中出现最频繁的情感,并作为市场趋势的预测。

    from collections import Counter
    
    def predict_market_trend(news_sources):
        sentiments = []
        for source in news_sources:
            news_text = get_news_text(source)
            sentiment = analyze_sentiment(news_text)
            sentiments.append(sentiment)
    
        sentiment_counts = Counter(sentiments)
        most_common_sentiment = sentiment_counts.most_common(1)[0][0]
    
        if most_common_sentiment == '正面':
            return "预测市场上涨"
        elif most_common_sentiment == '负面':
            return "预测市场下跌"
        else:
            return "市场趋势不明确"

    步骤3:测试

    现在,我们可以使用以上代码对市场走势进行预测。将新闻来源的URL传递给predict_market_trend函数,即可得到市场走势的预测结果。

    news_sources = [
        'https://news.example1.com/bitcoin-rise',
        'https://news.example2.com/bitcoin-analysis',
    ]
    
    prediction = predict_market_trend(news_sources)
    print(f"市场预测: {prediction}")

    结论

    本教程为您提供了一个基本的框架,通过对虚拟货币新闻进行情感分析来预测市场走势。然而,在实际应用中,您可能需要结合更多的数据源、使用更精确的模型,并考虑其他可能影响市场的因素。希望本教程能为您提供一个良好的起点,并鼓励您进行更深入的研究。

  • 抛砖引玉:AI虚拟货币量化交易模型运行流程

    抛砖引玉:AI虚拟货币量化交易模型运行流程

    虚拟货币市场的波动性和机会吸引了越来越多的投资者,而量化交易成为了一种备受关注的策略。通过使用人工智能(AI)虚拟货币量化交易模型,您可以更加精确地捕捉市场机会,实现稳定的盈利。在本教程中,我们将介绍AI虚拟货币量化交易模型的运行流程,让您了解如何构建一个强大的量化交易系统。

    数据收集模块

    实时数据获取

    第一步是获取实时的市场数据,包括价格、成交量、买卖单信息等。这些数据可以通过交易所的API来获取。不同的交易所提供不同的API,您可以根据自己的需求选择合适的交易所。以下是一些常见的虚拟货币交易所:

    • Binance
    • Coinbase
    • Kraken
    • Bitstamp

    金融新闻采集

    除了市场数据,金融新闻和公告也是影响虚拟货币市场的重要因素。因此,我们需要自动爬取与虚拟货币相关的金融新闻和公告,以捕捉可能影响市场的重大事件。您可以使用网络爬虫来实现这一步骤,确保及时获取最新信息。

    数据存储

    获取的数据需要存储在高速、安全的数据库中,以确保数据的完整性和可用性。常见的数据库包括MySQL、MongoDB、或者专门用于时间序列数据的InfluxDB。数据存储的良好组织和管理对于后续的分析和模型训练至关重要。

    数据预处理模块

    数据清洗

    在进行数据分析和模型训练之前,需要对数据进行清洗,去除无效、异常和重复的数据。这可以确保模型的输入数据是干净且可靠的。

    数据归一化

    不同的市场数据可能具有不同的尺度,例如价格和成交量。为了提高模型的预测准确性,我们需要将这些数据转化到统一的尺度上,例如将它们标准化为0到1之间的范围。

    特征工程

    特征工程是将原始数据转化为可供模型使用的特征的过程。根据虚拟货币市场的特性,您可以计算各种技术指标和其他相关特征,例如移动平均线(MA)、相对强度指标(RSI)、MACD等,以帮助模型更好地理解市场趋势。

    模型预测模块

    模型加载

    在模型预测模块中,我们需要加载预先训练好的深度学习模型,例如循环神经网络(RNN)、长短时记忆网络(LSTM)等。这些模型可以帮助我们对虚拟货币市场进行预测。

    数据输入

    将预处理后的数据输入到模型中,供模型进行预测。通常,模型需要历史数据来预测未来的价格走势,因此输入数据应包括一定的历史数据窗口。

    价格预测

    模型根据输入的数据进行预测,通常是对未来的价格走势进行预测。这个预测可以是连续的价格曲线,也可以是买卖信号(例如,买入、卖出、持有)。

    策略生成

    根据模型的预测结果,结合预设的交易策略,生成实时的买/卖信号。这些策略可以基于技术指标、趋势分析、风险管理等因素。

    交易执行模块

    风险评估

    在执行交易之前,进行实时的风险评估是非常重要的。确保交易策略与预设的风险容忍度相匹配,以避免过度风险。

    订单生成

    根据策略生成的买/卖信号,自动产生交易订单。这些订单应当包括交易对、交易方向、数量、价格等信息。

    实时监控

    监控订单的执行状态是确保交易顺利进行的关键。您需要实时监控订单的成交情况,如果出现部分成交或者全部成交,需要及时调整策略。

    反馈优化模块

    策略评估

    根据实际交易的结果,评估策略的有效性和盈利性。分析交易的胜率、盈亏比等关键指标,以便优化策略。

    模型调整

    使用新数据对模型进行微调,确保模型的预测能力始终处于最优状态。模型的性能会随着市场变化而变化,因此需要不断进行调整。

    策略更新

    根据市场变化和策略评估的结果,对交易策略进行调整和优化。灵活性是成功的关键,策略需要根据不同市场情况进行更新。

    报告生成模块

    交易记录

    生成详细的交易记录,包括交易时间、数量、价格、盈亏等信息。这些记录对于审计和报告非常重要。

    策略分析

    对交易策略的执行情况进行分析,提供策略的胜率、盈亏比等关键指标。这些分析有助于了解策略的表现如何,并作出相应的调整。

    风险报告

    分析实际交易与预设风险容忍度之间的差异,确保交易行为始终在可控的风险范围内。风险管理是量化交易成功的关键。

    通过以上步骤,您可以构建一个完整的AI虚拟货币量化交易模型,用于自动化交易虚拟货币市场。请记住,虚拟货币市场充满风险,任何交易都需要谨慎对待,建议在实际应用之前进行充分的测试和回测。

  • Windows下安装WSL2并搭建Arch Linux开发环境

    Windows下安装WSL2并搭建Arch Linux开发环境

    你是否曾经因为Windows下的不便捷而烦恼?在日常开发中,Linux或者Mac系统相对更受欢迎,但是如果你还在使用Windows,不必担心,因为Windows Subsystem for Linux 2(WSL2)已经成熟发展,为你提供了一个强大的开发环境。本教程将带你一步步完成WSL2和Arch Linux的安装,并配置开发环境,让你可以轻松地进行各种开发工作。

    第一部分:为什么选择WSL2?

    打破Windows的局限

    众所周知,Windows系统的快捷键和命令行支持相对不完善,而在开发中,这些功能却是不可或缺的。相较于Unix系系统,Windows在这方面一直处于劣势。然而,WSL2的出现改变了这一格局,让Windows用户也能够享受到Linux系统的强大特性。

    完备的开发环境管理

    WSL2的优点在于,整个开发环境都可以打包,迁移方便,而且可以轻松管理。这意味着你可以在不同的计算机上轻松部署相同的开发环境,而不必担心配置的问题。这对于个人开发者来说是一个巨大的优势。

    强大的兼容性

    虽然WSL2的GUI程序在某些方面还不够完美,但对于绝大多数开发场景来说,WSL2已经能够完美满足需求。你可以在WSL2中运行各种Linux应用程序,享受Linux系统的强大功能,同时也能够与Windows系统无缝协作。

    第二部分:安装WSL2

    步骤一:打开“控制面板”

    首先,打开Windows系统的“控制面板”。你可以通过在Windows搜索栏中输入“控制面板”来找到它。

    步骤二:启用WSL2和虚拟机平台

    在“控制面板”中,选择“程序”,然后点击“启用或关闭Windows功能”。在弹出的窗口中,勾选“适用于Linux的Windows子系统”和“虚拟机平台”,然后点击“确定”。

    步骤三:重启计算机

    完成勾选后,系统会提示你需要重启计算机以应用这些更改。请按照提示,重启计算机。

    步骤四:设置WSL2为默认版本

    一旦计算机重新启动,打开PowerShell,运行以下命令,将WSL2设置为默认版本:

    wsl --set-default-version 2

    步骤五:安装Linux发行版

    现在,你需要从Microsoft商店安装你喜欢的Linux发行版,比如Ubuntu。在Microsoft商店中搜索Linux发行版的名称,然后点击“安装”。

    步骤六:启动Linux发行版并配置用户名和密码

    安装完成后,启动Linux发行版。第一次启动时,系统会要求你设置一个用户名和密码,按照提示进行操作即可。

    第三部分:Arch Linux搭建开发环境

    安装Node.js

    Node.js是一款强大的JavaScript运行环境,用于构建服务器端和客户端应用程序。在WSL2中安装Node.js非常简单:

    1. 打开终端。
    2. 运行以下命令来安装Node.js和npm:
    sudo pacman -S nodejs npm
    1. 验证安装是否成功,运行以下命令检查Node.js和npm的版本:
    node -v
    npm -v

    安装Conda

    Conda是一个强大的包管理工具,用于创建和管理Python环境。在WSL2中安装Conda的步骤如下:

    1. 下载Miniconda安装脚本,运行以下命令:
    wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh
    1. 运行以下命令来执行安装脚本:
    bash Miniconda3-latest-Linux-x86_64.sh
    1. 按照提示完成安装。

    2. 重启终端或者运行以下命令来激活Conda:

    source ~/.bashrc

    安装Java

    Java是一种广泛使用的编程语言和平台,用于开发各种类型的应用程序。在WSL2中安装Java的步骤如下:

    1. 运行以下命令来安装OpenJDK:
    sudo pacman -S jdk-openjdk
    1. 验证安装是否成功,运行以下命令检查Java的版本:
    java -version

    安装Flutter

    Flutter是一款流行的移动应用程序开发框架,可以用于构建跨平台的移动应用。在WSL2中安装Flutter的步骤如下:

    1. 下载Flutter SDK,运行以下命令:
    git clone https://github.com/flutter/flutter.git ~/flutter
    1. 将Flutter添加到PATH。编辑 ~/.bashrc 文件,添加以下行:
    export PATH="$PATH:~/flutter/bin"
    1. 重启终端或者运行以下命令来使修改生效:
    source ~/.bashrc
    1. 运行以下命令来检查Flutter环境:
    flutter doctor

    安装C++

    C++是一种强大的编程语言,广泛用于系统编程和应用程序开发。在WSL2中安装C++编译器的步骤如下:

    1. 运行以下命令来安装GCC编译器:
    sudo pacman -S gcc
    1. 验证安装是否成功,运行以下命令检查GCC的版本:
    gcc --version

    第四部分:Android Studio使用连接Windows的手机设备

    Android Studio是一款用于Android应用程序开发的集成开发环境。如果你需要在Windows上连接手机设备并进行Android应用程序开发,以下是简单的步骤:

    1. 打开Android Studio。
    2. 将你的Android手机连接到计算机。
    3. 在Android Studio中,选择“运行”>“选择运行/调试设备”。
    4. 在弹出的设备列表中,选择连接的Android手机设备,然后点击“确定”。

    现在,你已经成功连接了你的Android手机设备,可以在Android Studio中进行应用程序的开发和调试了。

    通过本教程,你已经了解了如何在Windows上安装WSL2和Arch Linux,并配置了一个强大的开发环境,包括Node.js、Conda、Java、Flutter和C++。同时,你还学会了如何在Android Studio中连接Windows的手机设备进行Android应用程序的开发。希望这些步骤能够帮助你轻松地进行各种开发工作,提高工作效率。

  • WordPress 分类/标签 Meta 数据延迟加载的改进

    WordPress 分类/标签 Meta 数据延迟加载的改进

    你是否曾经在使用WordPress建立自己的网站时感到困惑?或者你是一名WordPress开发者,一直在寻找提高网站性能的方法?无论你是哪一种用户,你都会感到兴奋,因为WordPress 6.3带来了一项重大改进,即分类/标签Meta数据的延迟加载优化。这不仅将提高你的网站性能,还为开发者提供了更多的灵活性。

    背景故事:WordPress的演进之路

    在进入WordPress 6.3的具体改进之前,让我们回顾一下WordPress的演进之路。自从WordPress 4.4版本引入延迟加载功能以来,这个功能一直受到开发者和用户的欢迎。它的核心思想是只在需要时加载数据,而不是一开始就加载所有数据。这在性能方面有明显的优势,但存在一个问题:这一延迟加载的行为仅适用于WP_Query,在其他核心组件如WP_Term_Query中并未得到同样处理。这导致了分类/标签Meta数据的不必要加载,影响了系统性能。

    WordPress 6.3的改进

    好消息是,WordPress 6.3解决了这个问题。它带来了WP_Term_Query的重要改进,取消了分类/标签Meta数据的提前加载,而是将其加入专门用于加载Meta数据的队列中。这个队列通过当前线程内存中的数组实现,性能显著提升。

    延迟加载的优化

    为了优化分类/标签Meta数据的延迟加载,核心代码中引入了一个名为wp_lazyload的新机制。以下是一些关键优化:

    1. 队列加载: 只有在第一次调用get_term_meta函数时,分类/标签的Meta元数据才会在单个请求中加载。这意味着你的网站不再需要在每个页面加载时都获取所有分类/标签的Meta数据,从而加快了页面加载速度。

    2. 方便开发者: 这个新机制还允许开发者在预期稍后需要分类/标签ID时方便地包含它们。这使得开发更加灵活,可以根据具体需求来加载Meta数据。

    3. 性能提升: 通过使用内存中的数组来实现队列,提高了加载速度和效率。这对于高流量的网站尤其重要,可以减轻服务器的负担。

    对开发者的影响

    虽然WordPress 6.3的改进对用户来说是一个积极的步骤,但对开发者也有一些影响。许多开发者在使用分类/标签Meta数据时忽略了update_term_meta_cache参数,这也是WordPress 6.3对WP_Term_Query进行改进的原因之一。开发者现在需要更加关注这个参数,以充分利用新的延迟加载机制。这个参数控制着是否要在加载分类/标签数据时更新Meta缓存,开发者需要根据具体情况来设置它,以避免不必要的性能开销。

    总结

    WordPress 6.3分类/标签Meta数据的延迟加载改进是一个积极的步骤,它不仅优化了性能,还提供了更灵活的开发选项。这对于网站所有者来说意味着更快的加载速度和更好的用户体验,对于开发者来说则意味着更多的控制权和优化空间。随着WordPress的不断演进,我们可以期待更多的优化和改进,以满足开发者和用户的需求。

    现在,是时候升级你的WordPress网站,享受这些令人兴奋的改进带来的好处了!

  • 噩耗!NASA意外误发指令,宇宙长者”航海家二号”失联!

    噩耗!NASA意外误发指令,宇宙长者”航海家二号”失联!

    在浩瀚的宇宙中,有一位宇宙长者一直在默默地探索着,解开宇宙的奥秘。他就是“航海家二号”,一艘在太空中飞翔了46年的宇宙探测器。然而,最近发生的一次意外事件让我们陷入深深的忧虑,因为NASA意外误发了错误的指令,导致这位宇宙长者与地球失去了联系。在这篇文章中,我们将深入探讨这一事件,以及科学家们正在采取的措施来重新建立与“航海家二号”的联系。

    一次意外的指令

    故事发生在不久前,一个航空管制员在执行任务时犯下了一个不小心的错误。他向“航海家二号”发送了一个让其天线倾斜、偏离地球的指令。尽管这个倾斜角度仅仅为2%,对于距离地球190亿公里的探测器来说,这个微小的变化足以导致与地球的联系中断。这个错误的指令成为了“航海家二号”的失联的导火索。

    宇宙中的孤独之旅

    “航海家二号”于2018年进入星际空间,与地球的通讯需要花费至少18小时的时间。因此,要重新建立与它的联系并不是一件容易的事情。NASA正在紧急尝试各种可能的办法,以期望能够再次与这位遥远的“宇宙旅者”取得联系。这包括重新发送信号并捕捉它的回应,同时也借助澳洲坎培拉的深空卫星天线来帮助追踪探测器的位置。然而,如果这些努力都无果,我们只能等待到10月,那时探测器的系统将自动重新设定,也许才有可能再次接收到它的信号。

    宇宙的探险家

    “航海家二号”最初是“水手号”计划的一部分,当时被命名为“水手11号”。随着项目的发展,它被重新命名,并于1977年成功升入天际。尽管它比“一号”提前一个月出发,但因为任务和轨道的设计,它选择了更长的路线。它依靠行星之间的引力,大幅缩短了航行时间,成为首艘造访天王星和海王星的探测器,更在176年一遇的行星几何排列下,完成了造访四个巨行星(木星、土星、天王星及海王星)的壮丽壮举。它是宇宙的探险家,一直在为我们揭示宇宙的奥秘。

    期待的重联

    在“航海家二号”失联的这段时间里,每一个科学家都在默默祈祷,期待再次听到它遥远的信号。这位宇宙长者虽然失联,但我们仍然相信他能够克服困难,继续为我们揭示宇宙的神秘面纱。他的探索之旅还没有结束,我们期待着他早日恢复通讯,继续为人类的知识进步贡献自己的力量。

    在这个宇宙中,我们每一个人都是宇宙的一部分,每一次探索都是一次冒险。让我们一起为“航海家二号”的安全重联,为宇宙的奥秘揭开更多的层面而努力。

  • Python编程小技巧:让代码更优雅的列表推导式

    Python编程小技巧:让代码更优雅的列表推导式

    编程是一门艺术,每一行代码都像是画师的一笔,创造出数字世界的精彩画卷。作为Python程序员,我们一直在追求代码的优雅和效率,而列表推导式就是实现这一目标的得力工具。

    一、列表推导式的魔力

    1. 什么是列表推导式

    列表推导式(List Comprehensions)是Python中一种独特的语法糖,它允许我们以一种简洁的方式创建新的列表。

    2. 如何使用列表推导式

    假设我们有一个需求,要将一个列表中的所有元素都乘以2。如果不使用列表推导式,代码可能是这样的:

    numbers = [1, 2, 3, 4, 5]
    doubled_numbers = []
    for n in numbers:
        doubled_numbers.append(n * 2)

    而如果使用列表推导式,代码会变得更加简洁:

    numbers = [1, 2, 3, 4, 5]
    doubled_numbers = [n * 2 for n in numbers]

    这两行代码完成了同样的任务,但列表推导式使代码更加清晰和精炼,展现了其魔力所在。

    二、列表推导式的优势

    1. 简洁与优雅

    列表推导式让代码变得简洁而优雅。在一行代码中,我们可以完成对列表的操作,避免了繁琐的循环和临时变量。

    2. 高效与快速

    与传统的for循环相比,列表推导式在执行速度上更具优势。它们经过内部优化,处理大量数据时表现更出色,提高了代码的运行效率。

    三、深入学习列表推导式

    1. 基本语法

    列表推导式的基本语法如下:

    new_list = [expression for item in iterable]

    其中:

    • new_list:新列表的名称。
    • expression:对每个元素执行的操作或计算。
    • item:迭代过程中的每个元素。
    • iterable:可迭代的对象,如列表、元组、字符串等。

    2. 条件过滤

    列表推导式还支持条件过滤,可以根据条件筛选元素。例如,我们想要创建一个只包含偶数的新列表:

    numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
    even_numbers = [n for n in numbers if n % 2 == 0]

    3. 嵌套列表推导式

    列表推导式还可以嵌套使用,用于处理嵌套数据结构,例如二维列表。假设我们有一个二维列表,我们想要将其中的所有元素展开成一个新列表:

    matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
    flattened = [x for row in matrix for x in row]

    四、实际应用场景

    1. 数据处理与转换

    列表推导式在数据处理和转换中非常有用。例如,从一个字符串列表中提取所有字符串的首字母:

    words = ['apple', 'banana', 'cherry']
    initials = [word[0] for word in words]

    2. 快速生成数值序列

    列表推导式还可用于生成数值序列,非常方便。例如,生成1到10的平方数列表:

    squares = [x**2 for x in range(1, 11)]

    3. 字典与集合推导式

    除了列表推导式,Python还支持字典推导式和集合

    推导式,用于创建字典和集合。例如,将一个列表中的元素作为字典的键:

    fruits = ['apple', 'banana', 'cherry']
    fruit_lengths = {fruit: len(fruit) for fruit in fruits}

    五、总结

    在Python编程中,列表推导式是一项强大的工具,可让代码更加优雅和高效。通过掌握其基本语法和应用技巧,我们可以更轻松地处理列表数据,提高编程效率。列表推导式只是Python中众多特性之一,让我们持续探索,不断提升编程技能,写出更加精彩的代码。

  • 初学编程:书本的智慧,还是视频的启迪?

    初学编程:书本的智慧,还是视频的启迪?

    在现代社会,编程已经成为一项极具价值和需求的技能。然而,对于初学者而言,选择正确的学习方式却是一个关键的问题。有的人喜欢翻阅书本,认为书籍是汲取知识的最佳途径;而另一些人更倾向于观看视频教程,因为它们能够生动地演示编程过程。本教程将探讨书本和视频两种学习方式的优势,并提供建议,帮助初学者选择适合自己的学习路径。

    一、书本的魅力

    1. 书本,寂静的智慧之源

    编程书籍是知识的海洋,它们凝结了作者的智慧和经验。翻开一本好书,就仿佛踏入了一个全新的世界。书本之中的每一行代码、每一个概念都是经过精心挑选的,它们像种子一样埋在你的心中,等待着发芽。

    “书本是知识的宝库,它们蕴含着丰富的编程智慧。” – 作者

    2. 学习的深度和广度

    书籍在深度和广度上具有明显优势。通过阅读编程书籍,你可以系统地学习编程的原理和思想。你可以按照自己的进度反复研读,深入思考,使得你的理解更加透彻。

    “书本能够帮助你建立坚实的编程基础,掌握编程的核心概念。” – 作者

    二、视频教学的优势

    1. 直观,生动

    相对于枯燥的文字,视频教程能够通过图像和声音生动地展示抽象的编程概念。观看视频教程就像有一个亲身的导师在你身边,为你解开编程的难题。

    “视频教程让编程变得更加直观和易于理解,它们是学习编程的生动工具。” – 作者

    2. 操作的现场感

    视频教学最大的优势在于它可以直接演示编程的全过程,让你看到编程的实际操作,就像身临其境。这种模仿和跟随的过程,能够帮助你快速入门和熟悉新的编程语言和框架。

    “通过观看视频,你可以跟随着实际操作,更快地掌握编程技能。” – 作者

    三、我的建议:书本与视频,双管齐下

    1. 理论与实践相结合

    作为一个编程者,理论和实践同样重要。书本和视频可以相辅相成,结合使用。通过阅读书籍,你可以建立坚实的理论基础,了解编程的原理。而通过观看视频,你可以学习实际操作和技巧。最终,通过实战项目来巩固你的知识和技能。

    “理论和实践相辅相成,是成为一名优秀编程者的关键。” – 作者

    2. 因人而异

    不同的人有不同的学习方式。有些人更善于通过文字吸收知识,而有些人则更善于通过观看和模仿来学习。找到最适合自己的学习方式是成功的关键。

    “每个人都有独特的学习方式,要根据自己的喜好和需求来选择学习方法。” – 作者

    结语

    在编程的世界里,书本与视频都是获得知识的宝贵途径。选择书本还是视频,取决于个人喜好和学习需求。然而,最好的学习方式是通过实际项目来应用你所学的知识。只有在实践中,你才能真正理解和掌握编程技能,成为一名优秀的编程者。

    学习编程是一项持续不断的过程,书本和视频只是帮助你起步的工具。最终,成功取决于你的实际行动和努力。不要害怕尝试新的学习方式,因为只有你自己知道哪种方式最适合你。

  • 揭秘Windows卡顿背后的神秘力量:优化Microsoft Defender,让你的电脑飞起来!

    揭秘Windows卡顿背后的神秘力量:优化Microsoft Defender,让你的电脑飞起来!

    你是否曾经在使用Windows 10或Windows 11系统时,突然感受到系统变得卡顿,影响了你的工作效率?有时候,问题的根源可能并不在于你正在使用的软件,而是因为Microsoft Defender(MD)的后台扫描活动。这篇文章将告诉你如何优化Windows系统,以降低Microsoft Defender的CPU占用,提升系统性能。

    问题的根源

    Windows 10和Windows 11系统默认配置了杀毒软件MD,它会定期在后台扫描电脑,以查找潜在的恶意程序。通常情况下,MD会在系统空闲时执行扫描,以不干扰你的日常工作。然而,有时候你可能会遇到MD的扫描活动突然启动,占用大量CPU资源,导致系统变得卡顿。

    默认情况下,MD在扫描时占用最多50%的CPU。这可以加快扫描速度,但也可能因为占用过多的系统资源而导致卡顿。因此,我们可以根据个人需求来调整CPU占用比例,下面将介绍三种方法来实现这一目标。

    方法1:使用组策略

    首先,打开系统的“开始菜单→设置→隐私和安全→Windows安全中心”。确保“Microsoft Defender防病毒”选项已启用定期扫描。

    然后,按照以下步骤来调整CPU占用比例:

    1. 按下Win+R组合键,运行对话框中输入gpedit.msc,然后点击确定。
    2. 在新打开的窗口中,依次点击“计算机配置→管理模板→Windows组件→Microsoft Defender防病毒→扫描”,然后双击“指定扫描期间CPU使用率的最大百分比”。
    3. 在弹出的窗口中,选择“已启用”,然后将默认的50修改为5~100之间的数值。例如,将其修改为30,MD在扫描时的CPU使用率就不会超过30%。

    注意: 如果将这个数值修改为0,则表示MD在扫描时可以无限制地占用CPU资源。

    方法2:使用PowerShell命令

    1. 使用PowerShell命令也可以调整MD的CPU占用比例。首先,右键点击开始按钮,选择“以管理员身份运行Windows PowerShell”。
    2. 在新打开的窗口中,输入以下命令以查看当前的CPU占用比例:
    Get-MpPreference | select ScanAvgCPULoadFactor
    1. 接着,输入以下命令来调整CPU占用比例,例如,将其设置为30:
    Set-MpPreference -ScanAvgCPULoadFactor 30

    方法3:修改注册表

    1. 通过修改注册表也可以调整MD的CPU占用比例。按下Win+R组合键,运行对话框中输入regedit,然后点击确定。
    2. 在新打开的窗口中,在搜索框中输入以下路径,以快速定位到注册表的Windows Defender路径:
    HKEY_LOCAL_MACHINE\SOFTWARE\Policies\Microsoft\Windows Defender
    1. 在Windows Defender项上右键单击,选择新建“项(K)”,将新项命名为“Scan”。然后在右侧窗口中,右键单击创建“DWORD(32位)值(D)”,将其命名为“AvgCPULoadFactor”。
    2. 最后,双击“AvgCPULoadFactor”,将数值修改为5~100之间的数值,然后点击确定。

    总结

    通过上述方法,你可以成功调整MD的CPU占用比例,从而改善系统卡顿问题。如果你从未遇到MD后台扫描导致的卡顿问题,或者已经关闭了MD的功能,那么你可能不需要进行上述调整。但如果你遇到了类似的问题,希望本文能帮助你解决问题,提升Windows系统的性能。

  • SDXL1.0体验报告:高效的AI图像生成工具的四大挑战

    SDXL1.0体验报告:高效的AI图像生成工具的四大挑战

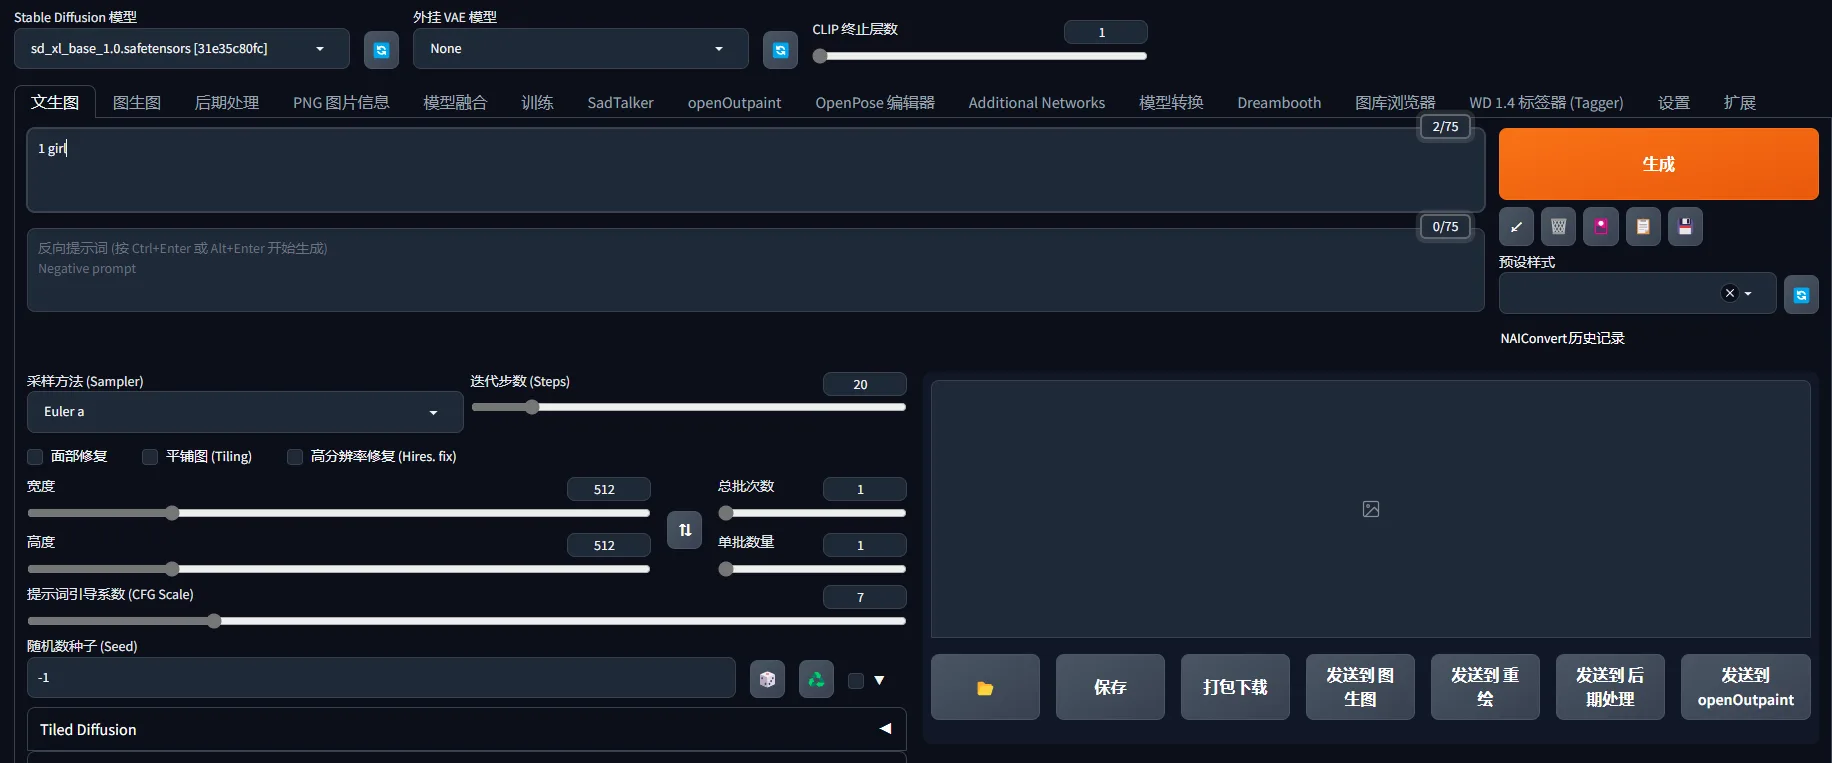
    在人工智能领域,图像生成是一个颇具挑战性的任务。SDXL,作为stable-diffusion的一个模型,具有高效生成图像的能力。然而,对于用户来说,如何在具体的操作过程中避免出错并最大化工具的性能,便是一项重要的技巧。下面,我们就针对SDXL1.0的四个关键问题进行探讨。

    1. NVIDIA 3060-12G显存显卡参数设置

    在SDXL1.0中,当使用NVIDIA的3060-12G显存显卡时,需要在命令行中加上参数–xformers –no-half-vae。这两个参数能够帮助显卡在运行SDXL1.0时保持稳定,避免出现错误。

    2. 图像生成的分辨率要求

    SDXL1.0在生成图像时,有一项固定的要求,即生成的图像分辨率必须设为1024*1024。这是由于SDXL1.0采用了一种特殊的图像处理算法,这种算法需要在这个特定的分辨率下进行,否则可能会导致图像质量问题,甚至无法完成图像生成。

    3. 插件支持的局限性

    虽然SDXL1.0具有强大的图像生成功能,但是它在插件支持上还存在局限性。当前版本的SDXL1.0并不支持许多常见的插件。因此,用户在使用SDXL1.0时,需要提前确认其需要的插件是否能够在SDXL1.0中正常工作。

    4. 显存错误问题

    使用SDXL1.0进行大规模的图像生成工作时,可能会遇到显存错误。一般来说,当连续生成大约十张图像后,显存就可能出现错误。这是因为在大量的图像生成任务中,显卡的显存会被大量占用,当超出显存容量时就会出现错误。在此种情况下,可以尝试降低生成图像的分辨率,或者减少同时处理的图像数量,以降低对显存的使用。
    file

    序号 问题描述 解决办法
    1 NVIDIA 3060-12G显存显卡参数设置 添加参数–xformers –no-half-vae
    2 图像生成的分辨率要求 设置为1024*1024
    3 插件支持的局限性 需要确认插件是否与SDXL1.0兼容
    4 显存错误问题 降低图像分辨率或减少同时处理的图像数量