Tag: 开源

  • 使用Go-MTPFS实现Android设备的挂载与数据传输

    使用Go-MTPFS实现Android设备的挂载与数据传输

    使用Go-MTPFS实现Android设备的挂载与数据传输

    在现代生活中,Android设备已成为我们生活不可或缺的一部分。然而,与设备之间的数据传输常常成为一项挑战。本文将介绍如何使用Go-MTPFS工具来实现Android设备的挂载与数据传输,让您的数据传输体验更加便捷高效。

    1. 什么是MTP?

    MTP(Media Transfer Protocol)是一种用于在计算机和移动设备之间传输媒体文件的协议。它使您可以将照片、音乐、视频等文件从计算机传输到Android设备,或者将设备上的文件传输到计算机。然而,在某些情况下,MTP可能并不够稳定或高效。

    2. Go-MTPFS简介

    Go-MTPFS是一个基于Go语言编写的开源工具,它可以帮助您在Linux系统中实现对Android设备的MTP挂载。相较于传统的MTP解决方案,Go-MTPFS具有更高的稳定性和性能,让您的数据传输更加畅通无阻。

    3. 安装Go-MTPFS

    首先,确保您的Linux系统已安装Go-MTPFS工具。可以使用以下命令进行安装:

    sudo add-apt-repository ppa:webupd8team/unstable
    sudo apt-get update
    sudo apt-get install go-mtpfs go-mtpfs-unity

    4. 挂载Android设备

    一旦安装完成,您就可以开始挂载您的Android设备了。通过以下步骤实现挂载:

    1. 将Android设备连接到计算机的USB端口。
    2. 打开终端,并创建一个空文件夹来作为挂载点,例如:
    mkdir ~/android_mtp
    1. 使用以下命令来挂载设备:
    go-mtpfs ~/android_mtp

    现在,您的Android设备中的文件将会在~/android_mtp文件夹中显示,您可以像浏览本地文件夹一样管理和传输文件。

    5. 数据传输与管理

    通过挂载Android设备,您可以轻松地传输和管理设备中的文件。您可以在文件浏览器中访问~/android_mtp文件夹,直接将文件复制到设备或从设备复制文件到计算机。

    6. Go-MTPFS的优势

    相较于传统的MTP挂载方案,Go-MTPFS具有以下优势:

    • 高性能: Go-MTPFS在传输大量文件时表现更佳,减少传输等待时间。
    • 稳定性: Go-MTPFS在设备连接和断开时更加稳定,减少因设备错误而导致的传输中断。
    • 便捷性: 挂载Android设备后,您可以像操作本地文件夹一样操作设备文件,无需学习新的操作方法。

    7. 使用表格总结Go-MTPFS优势

    下表总结了Go-MTPFS相较于传统MTP的优势:

    特点 Go-MTPFS 传统MTP
    性能 高 一般
    稳定性 更稳定 相对不稳定
    操作便捷性 高 一般

    8. 总结与展望

    Go-MTPFS为Linux用户提供了一种更加便捷、高效的方法来实现Android设备的MTP挂载和数据传输。无论是传输照片、音乐还是视频,都可以更加轻松地完成。希望随着技术的不断发展,我们能够在数据传输领域享受到更多便利和高效。

    引用:
  • Snapchat推出全新的“梦境”功能,利用生成式人工智能将用户的自拍进行重新混合

    Snapchat推出全新的“梦境”功能,利用生成式人工智能将用户的自拍进行重新混合

    Snapchat推出全新的“梦境”功能,利用生成式人工智能将用户的自拍进行重新混合

    功能介绍及背景

    Snapchat最近在其应用中新增了一项生成式人工智能功能,名为“梦境”(Dreams)。这一功能类似于该公司的标志性增强现实效果,也就是被称为镜头(Lenses)的效果。但与实时基于相机的效果不同,“梦境”利用生成式人工智能将用户的自拍重新混合,创造出“奇幻的图像,将他们的个人形象转化为新的身份”。

    如何使用

    这一功能可以在应用的“回忆”(memories)部分找到。用户首先需要以不同角度拍摄自己的自拍照片,接着应用将基于主题如“时间旅行”或“平行宇宙”等,创建一系列包含八张图片的图像。据Snap表示,未来用户还将能够创建包含他们朋友形象的“梦境”。

    技术背后

    “梦境”是Snapchat的最新生成式人工智能实验之一。此前,该公司推出了MyAI聊天机器人,使用了OpenAI的模型。值得注意的是,“梦境”利用了开源工具和内部数据,尽管公司未详细披露合作伙伴的信息。

    收费模式

    与此同时,公司也将兴趣转化为收入来源。类似于MyAI,“梦境”也包含了免费和付费部分。非Snapchat+订阅者可以使用一个包含八张自拍的“包”,而订阅者每月可以获得一个“包”的访问权限。Snap还表示计划定期更新梦境的新主题和样式。同时,所有用户都可以通过0.99美元的应用内购买来获取额外的“包”。

    生成式人工智能的局限性

    在实际使用中,这些生成的图像似乎具有一些与其他基于人工智能的图像生成器相同的限制。例如,某些图像可能会出现奇怪的手部外形,但至少它们能够显示出正确数量的手指,并放置在解剖学上正确的位置。

    吸引用户回归

    虽然存在局限性,但我认为这一功能能够吸引Snapchat用户回归。考虑到用户们已经共同向MyAI发送了超过100亿条消息,“梦境”作为一项创新功能,或许能够激发用户的兴趣。尤其在一些工具开始付费使用的情况下,Snap的提供可能会更加吸引那些想要尝试生成式人工智能的用户

  • IZTRO v1.1.1:紫微斗数排盘工具库探秘

    IZTRO v1.1.1:紫微斗数排盘工具库探秘

    在一个宁静的夜晚,你仰望星空,或许曾想知道星星背后的秘密,它们是否影响了你的命运和宿命?或者你是一名紫微斗数爱好者,一直在寻找一款强大的工具来探索星象与命运之间的联系。无论你是哪一类人,IZTRO v1.1.1紫微斗数排盘工具库都将满足你的好奇心和热情。让我们一起深入探讨这个令人惊叹的开源库!

    介绍与背景

    IZTRO v1.1.1是一款基于 JavaScript 的开源库,专为紫微斗数排盘而设计。它的诞生旨在让人们更轻松地获取详细的星盘数据,只需提供出生日期和时辰信息。这个项目的核心理念是基于数字技术,帮助人们深入研究自己的生命轨迹,解析星象与宿命之间的联系。

    项目地址:https://github.com/SylarLong/iztro

    功能与特性

    IZTRO v1.1.1拥有多项强大的功能和特性,为用户提供全面的星盘信息:

    1. 基础信息

    根据用户提供的出生日期、时辰等数据,生成详尽的个人基础信息,包括星座、生肖、身主和命主等。这有助于用户更好地了解自己的基本性格和特征。

    2. 宫位信息

    为用户展示与宫位相关的数据,包括干支和星耀等。这有助于用户更深入地理解宫位的意义,以及它们如何影响生活和命运。

    3. 星耀信息

    提供每颗星星的亮度等级,包括庙、旺、得、利、平、不、陷等状态。同时,还呈现四化(禄、权、科、忌)和类型等信息。这有助于用户了解不同星星的影响力和特点。

    4. 运限信息

    揭示不同阶段的运势信息,涵盖大限、小限、流年、流月、流日、流时等重要时段。用户可以根据这些信息来规划自己的生活和决策。

    应用与拓展

    IZTRO v1.1.1不仅仅是一款功能强大的工具,更是为紫微斗数领域注入了新的活力。借助这个开源库,用户可以自行探索星象与命运之间的联系,深入研究宫位与星耀的意义。同时,IZTRO v1.1.1也为研究者、爱好者和学者提供了一个便捷的平台,进行深入的研究和交流。这个库的开放性和灵活性使得它能够满足不同用户的需求,无论是初学者还是专业研究者。

    技术实现与贡献

    IZTRO v1.1.1的实现借助了 JavaScript 技术,采用了模块化的开发结构。通过精心的代码设计,它为用户提供了友好的接口,使得获取星盘数据变得简单而直观。同时,IZTRO v1.1.1也积极融入了开源社区的理念,允许开发者共同参与,提出建议、修复漏洞,进一步丰富和完善这个工具库。这种开放合作的精神使得IZTRO v1.1.1能够不断进步,为用户提供更好的体验和功能。

    未来展望

    IZTRO v1.1.1的推出仅是开始。随着紫微斗数领域的不断发展,它将成为更多研究和探索的基石。未来,我们可以期待更多有趣的功能和特性的加入,使得IZTRO v1.1.1能够更好地满足用户的需求。这个库将继续为人们提供探索星象和命运之谜的工具,帮助他们更好地理解自己的生命轨迹。

    结语

    IZTRO v1.1.1紫微斗数排盘工具库为用户提供了一个全新的方式,帮助他们深入了解自己的命运与宿命。通过数字技术的应用,我们得以窥见星象背后的奥秘。在数字化的时代,IZTRO v1.1.1无疑将为紫微斗数领域带来新的启示与发展。不论你是一名紫微斗数爱好者还是一个探索星空的冒险家,IZTRO v1.1.1都值得你的关注和探索。让我们一起探索星象的奥秘,解析宿命的密码,开始一段充满发现的旅程!

  • “text-generation-webui”:赋予语言模型“见识”新天地

    “text-generation-webui”:赋予语言模型“见识”新天地

    想象一下,你坐在舒适的沙发上,手机在手,轻轻一点,就能与世界上最先进的语言模型进行深刻的对话或获取专业的文本生成服务。这不是科幻,这是现实——一切都得益于oobabooga的“text-generation-webui”项目。

    项目背景:为什么它来了?

    在大数据和人工智能飞速发展的今天,语言模型已经不再是一个陌生的名词。从聊天机器人到自动文章生成,再到智能助手,语言模型已经渗透到我们生活的方方面面。但问题来了,这些强大的模型通常需要专业的技术背景才能有效使用。oobabooga意识到这一点,并推出了这个项目,旨在让每个人都能轻松享受到大型语言模型带来的便利。

    妙不可言:功能与特点

    用户友好的界面

    谁说好的产品只能由程序员使用?这个项目通过Gradio库,为用户提供了直观而友好的操作界面。

    多才多艺的输出

    不仅仅是文字!图片、图表、甚至是动态内容,这个界面都能一网打尽。

    定制你的体验

    你是个性化的王者,你的需求是多样的。这个项目能让你根据自己的需要进行各种定制。

    技术内幕:核心组件

    1. Gradio: 界面的心脏,用于建立与用户的沟通桥梁。
    2. 大型语言模型: 项目的灵魂,负责文本生成。

    未来展望:更多可能

    从个人博客写作到企业级的数据分析,从简单的日常对话到专业的咨询服务,这个项目有着几乎无限的应用潜力。

    结语:创新、便利、多元

    如果你是对话系统的发烧友,或者是NLP领域的研究人员,甚至只是一个对技术感兴趣的普通人,oobabooga的“text-generation-webui”都值得你关注和尝试。它不仅是一个项目,更是一个全新的交互体验。

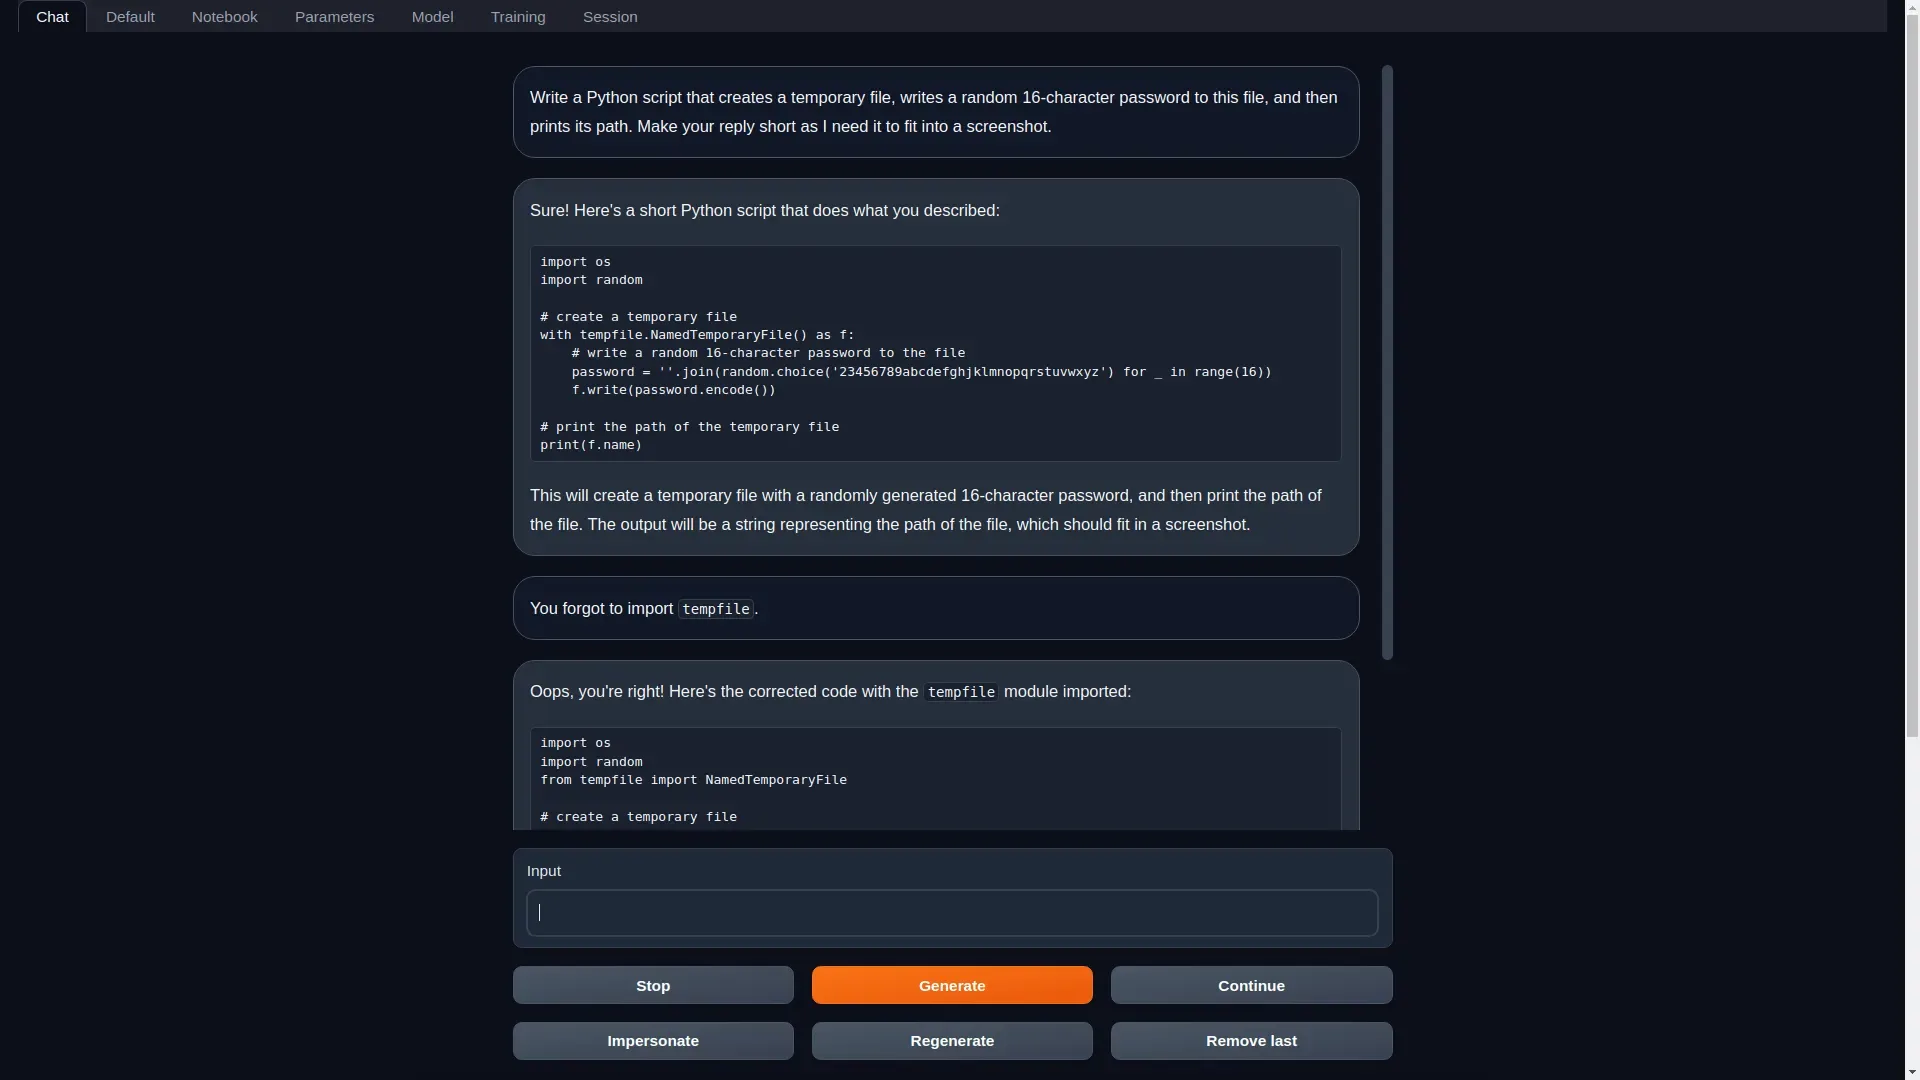
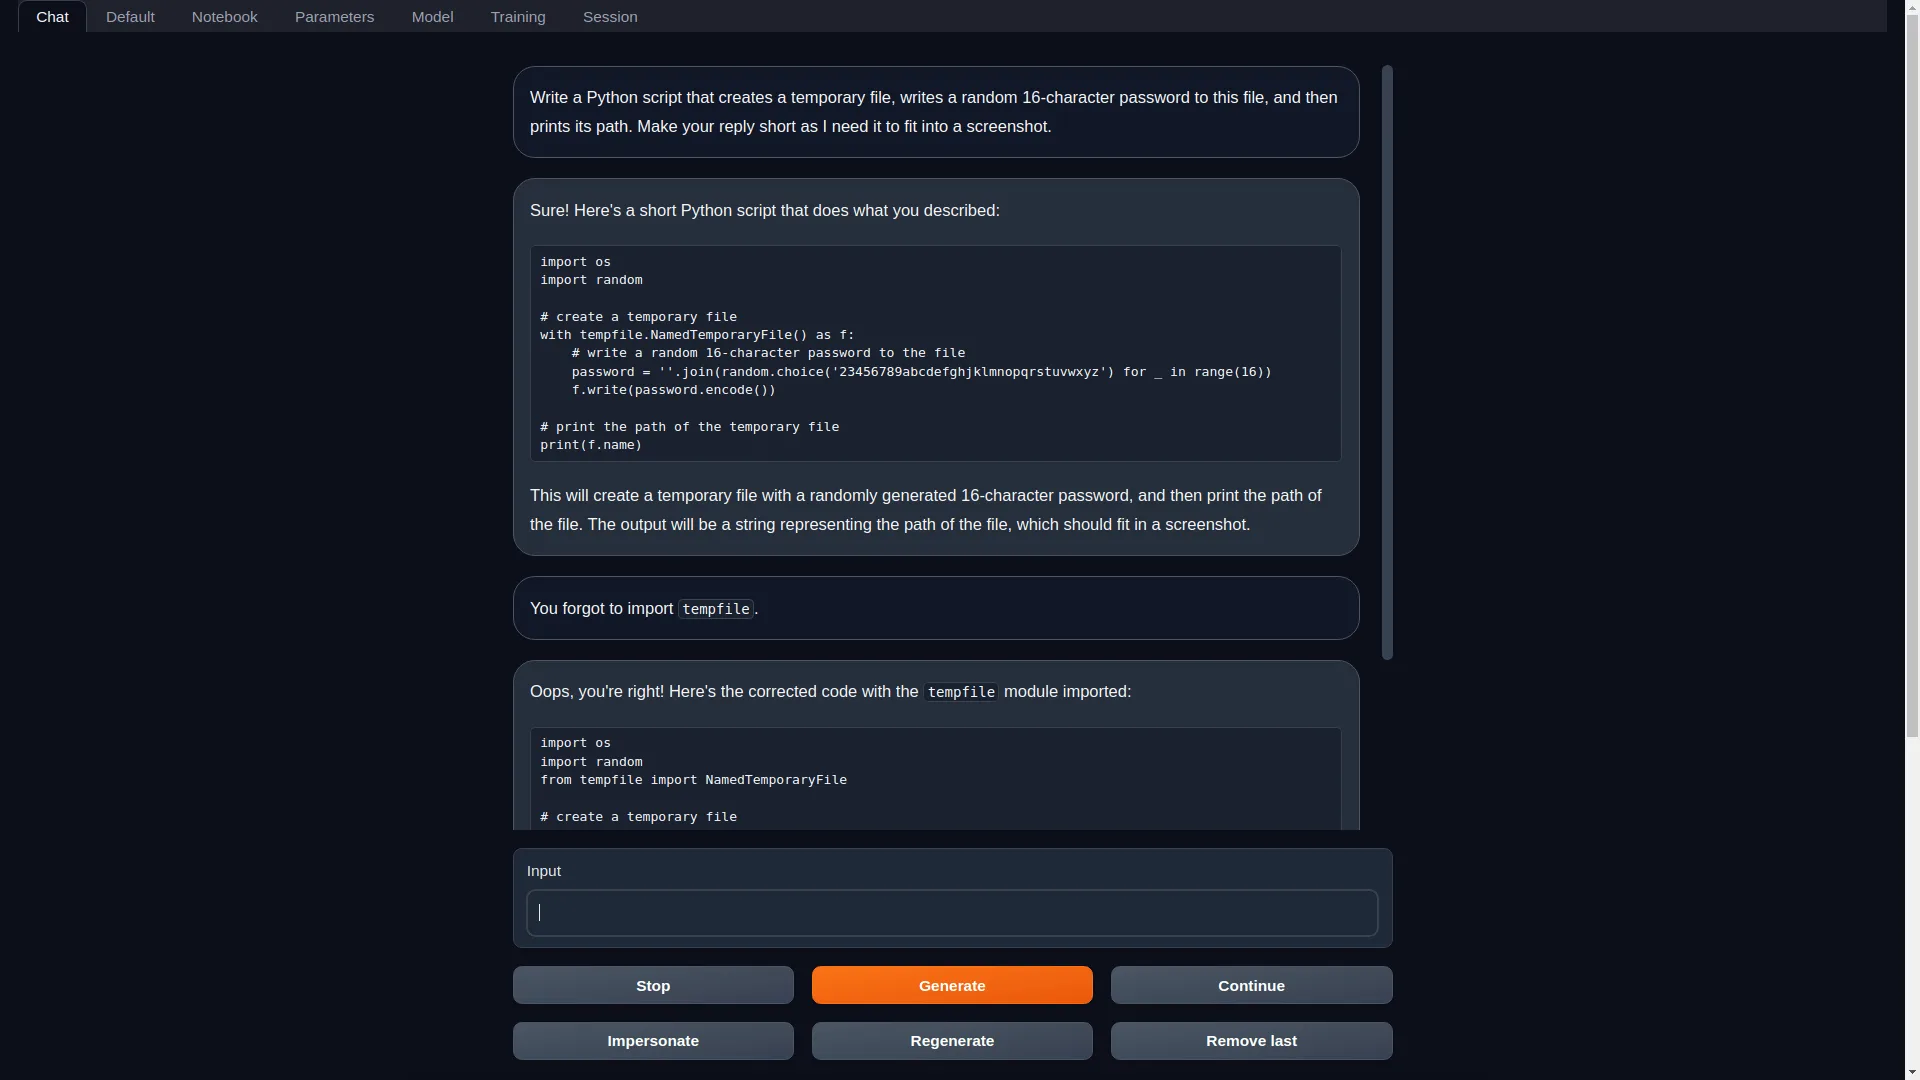
    这里是 text-generation-webui 项目的部署教程和使用说明:

    部署

    环境配置

    1. 安装 Conda 并创建一个新的 Conda 环境
    conda create -n textgen python=3.10.9 
    conda activate textgen
    1. 根据你的系统配置安装 Pytorch

    2. 克隆项目并安装依赖

    git clone https://github.com/oobabooga/text-generation-webui
    cd text-generation-webui
    pip install -r requirements.txt
    1. 在 models 目录下放置模型文件

    2. 启动服务

    python server.py

    使用

    加载模型

    在界面左上方选择想要加载的模型。可以从 HuggingFace 网站上下载各种预训练模型。

    生成文本

    在左侧提示框中输入提示词,然后点击 Generate 生成文本。

    可以调整参数以控制生成长度、温度等。

    切换模式

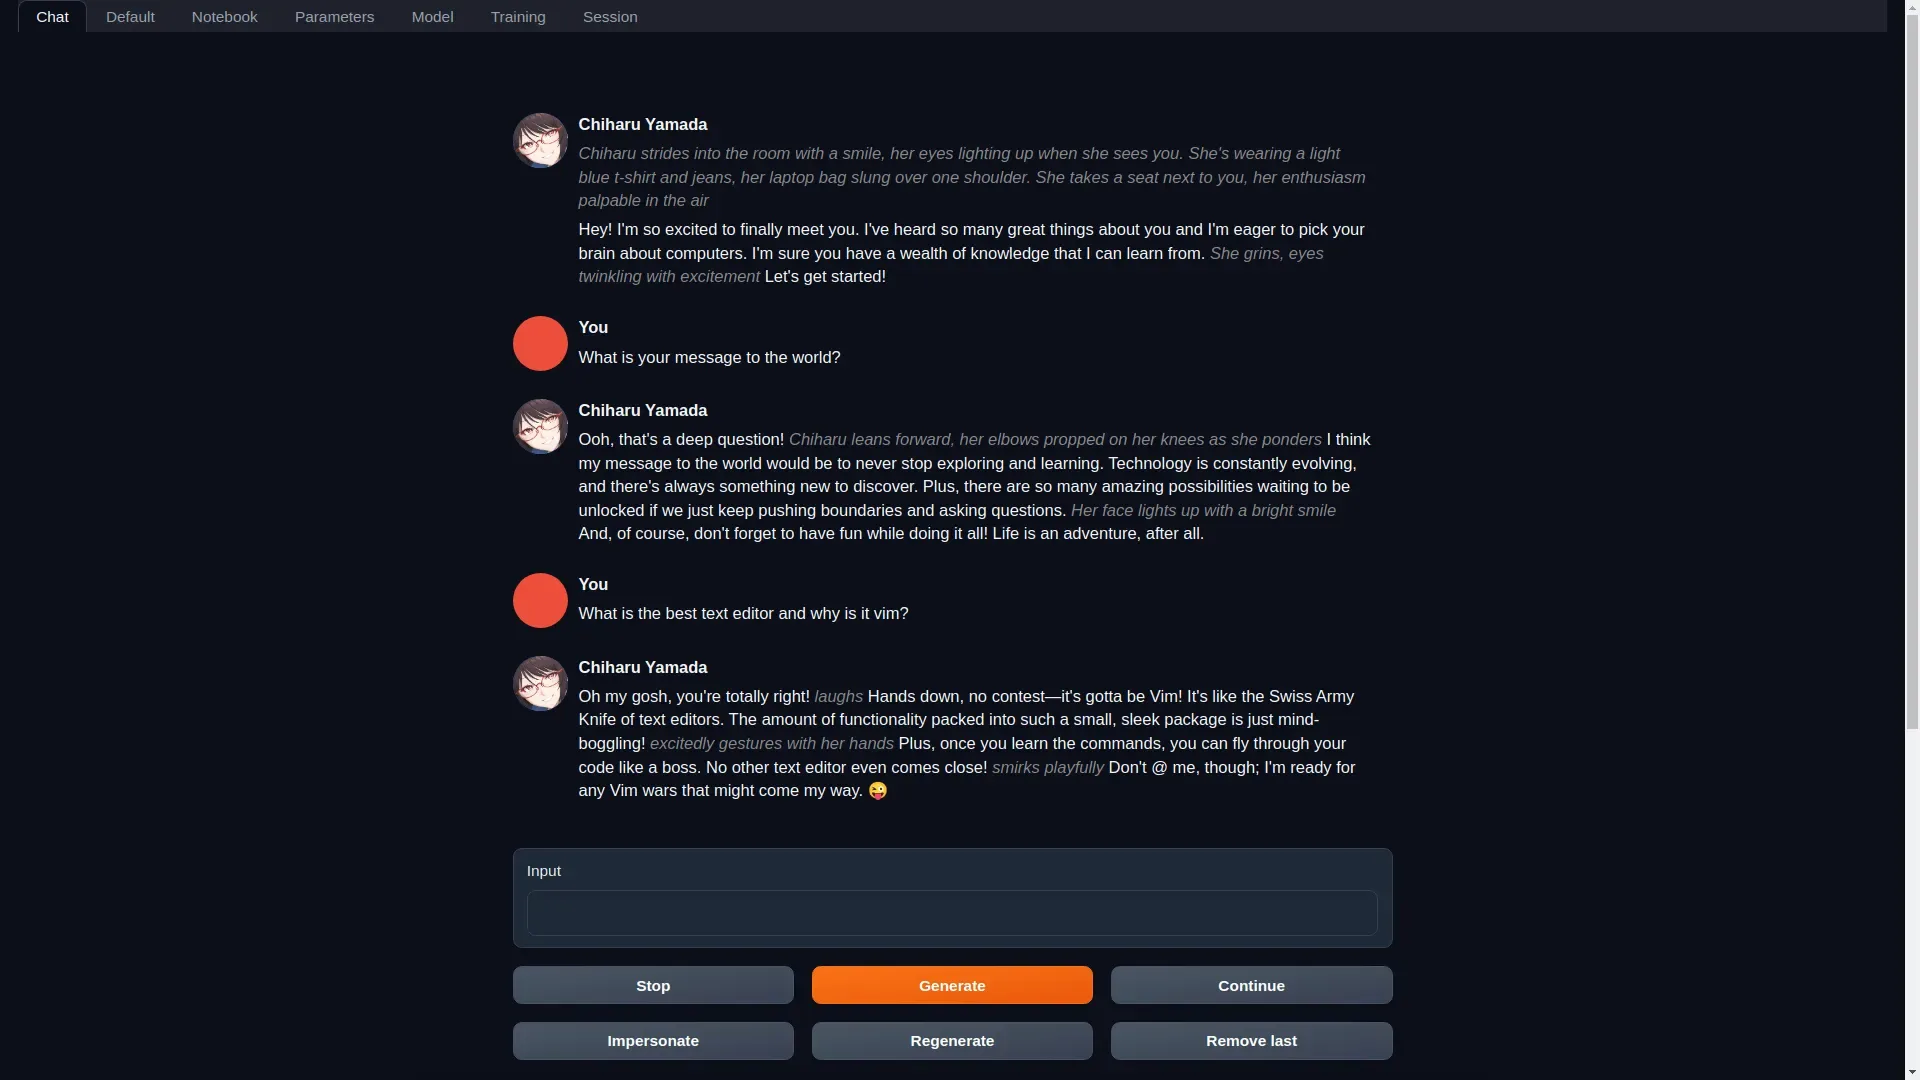
    点击界面右上角的模式图标在默认模式、笔记本模式和聊天模式之间切换。

    • 默认模式:双栏显示
    • 笔记本模式:类似代码编辑器的模式
    • 聊天模式:与 AI 角色聊天

    使用 LoRA

    可以加载 LoRA 来控制生成风格。点击 Load LoRA 按钮选择要加载的 LoRA。

    另外可以使用 Train LoRA 功能基于提示训练新的 LoRA。

    输出设置

    可切换 Markdown 和 HTML 输出。Markdown 支持 LaTeX 公式渲染。

    勾选 Log Probabilities 选项可以输出每个 token 的对数概率。

    高级功能

    本项目还支持多种高级功能,如 API、4比特量化、多模态流水线等。请参考文档学习使用。

  • Fooocus 项目介绍与教程

    Fooocus 项目介绍与教程

    Fooocus 是一个开源的图像生成软件,由 GitHub 用户 lllyasviel 开发。该软件的设计思路受到了 Stable Diffusion 和 Midjourney 两个项目的启发。Fooocus 旨在简化用户与软件之间的交互,让用户只需关注图像生成的提示和结果,而无需手动调整复杂的技术参数。

    特点

    • 离线、开源、免费:Fooocus 是一个离线软件,完全开源并且免费。
    • 用户友好:不需要手动调整复杂的技术参数。
    • 高度自动化:内置了许多优化和质量提升的功能。
    • 简单的安装过程:从下载到生成第一张图像,所需的鼠标点击次数严格限制在 3 次以下。
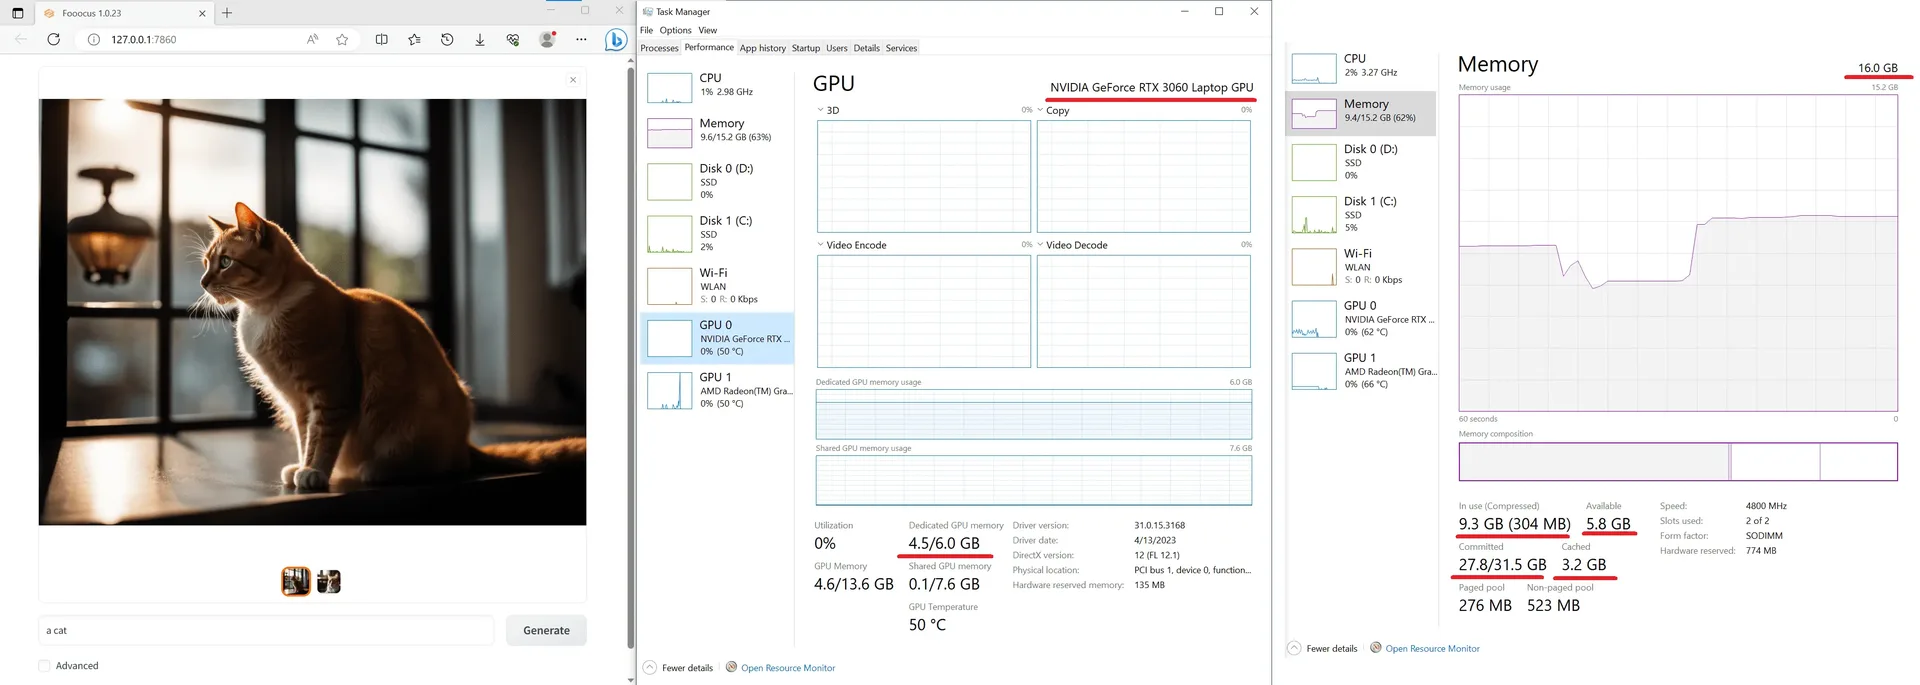
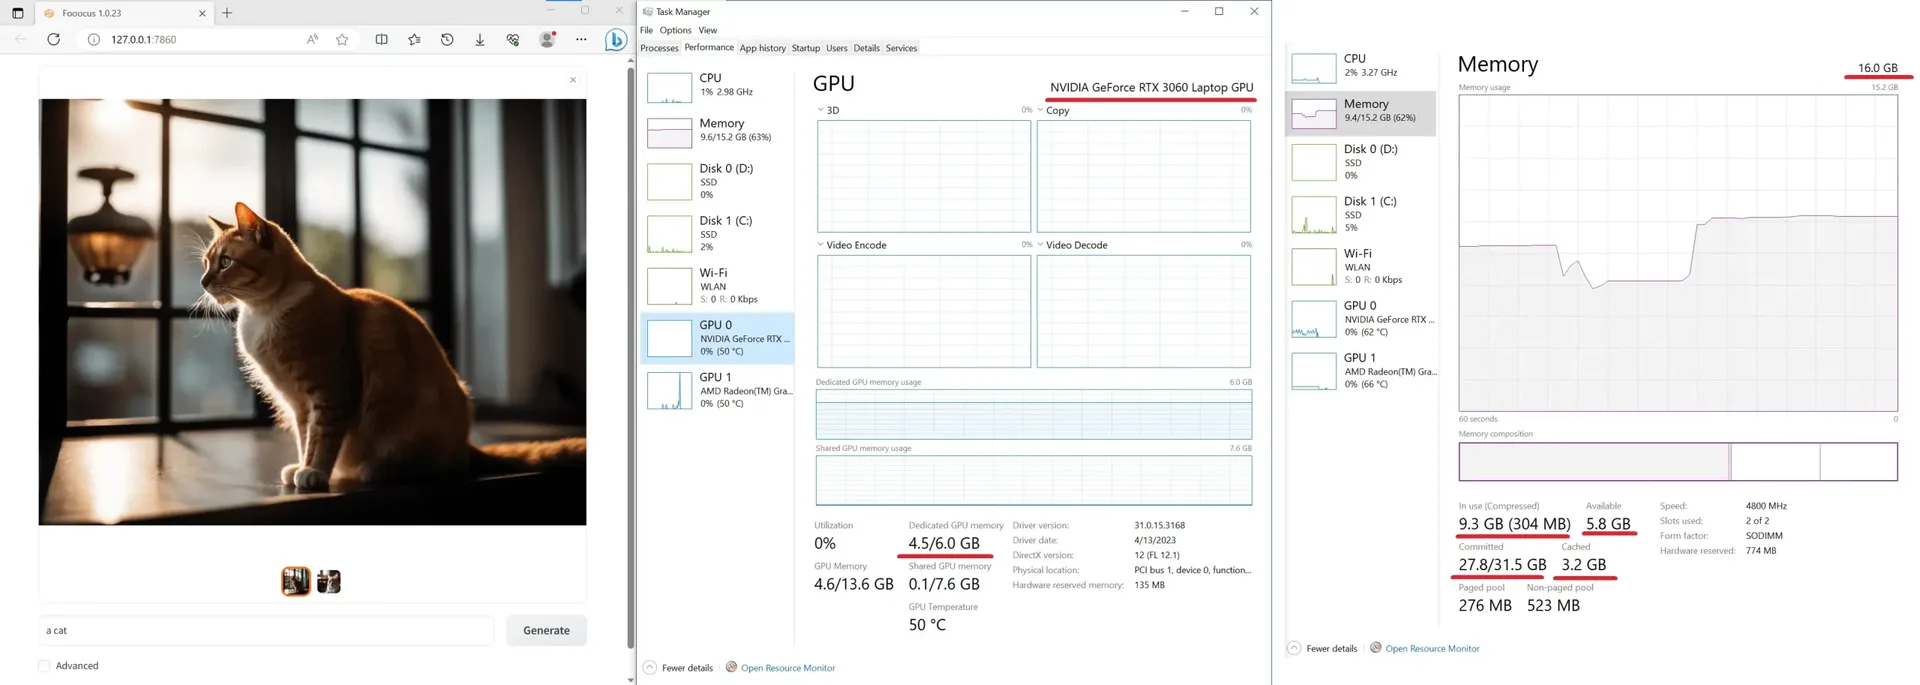
    • 最低硬件要求:最低 GPU 内存需求为 4GB(Nvidia)。

    安装与使用

    Windows 平台

    1. 下载软件:从 Fooocus GitHub 页面 下载软件包。
    2. 解压文件:解压下载的文件。
    3. 运行软件:运行 “run.bat” 文件。
    4. 下载模型:软件会自动下载所需的模型文件。

    Linux 平台

    1. 克隆仓库:git clone https://github.com/lllyasviel/Fooocus.git
    2. 进入目录:cd Fooocus
    3. 创建环境:conda env create -f environment.yaml
    4. 激活环境:conda activate fooocus
    5. 安装依赖:pip install -r requirements_versions.txt
    6. 下载模型:从指定位置下载模型或让 Fooocus 自动下载。
    7. 启动软件:python launch.py

    高级功能

    Fooocus 还开发了许多仅限于 Fooocus 的高级功能,以便高级用户获得完美的结果。具体的高级功能可以在其 GitHub 页面上查看。

    思考与展望

    1. 用户友好性与专业性如何平衡?
    2. Fooocus 与其他图像生成软件相比有哪些优势和不足?
    3. 未来,Fooocus 有哪些可能的发展方向和应用场景?
  • ChatGPT-on-WeChat – 打造智能微信聊天机器人

    ChatGPT-on-WeChat – 打造智能微信聊天机器人

    项目名称:ChatGPT-on-WeChat – 打造智能微信聊天机器人

    简介:

    近期,ChatGPT凭借其强大的对话和信息整合能力在网络上引起了轰动。它不仅能够编写代码、改进论文,还能够讲故事等,几乎可以应付各种场景。这让我们萌生了一个大胆的想法,是否能够利用其出色的对话模型将微信打造成一个智能机器人,能够为我们在与朋友对话时提供意想不到的回应,同时不会再担心女朋友会干扰我们的游戏和工作。

    最新版本的ChatGPT-on-WeChat支持以下功能:

    1. 多端部署:项目提供多种部署方式,包括个人微信、微信公众号以及企业微信应用等,这些方式功能完备且灵活。
    2. 基础对话:不仅支持私聊,还能够在群聊中智能回复消息。系统支持多轮会话上下文记忆,可以适应不同的对话场景。同时,支持多种模型,包括GPT-3、GPT-3.5、GPT-4、文心一言以及讯飞星火。
    3. 语音识别:ChatGPT-on-WeChat可以识别语音消息,并通过文字或语音进行回复。项目支持多种语音模型,如azure、baidu、google和openai等。
    4. 图片生成:系统具备图片生成功能,还可以实现图像修复,例如照片修复等。你可以选择不同的模型,包括Dell-E、stable diffusion、replicate以及midjourney模型。
    5. 丰富插件:项目支持个性化插件扩展,已经实现了多角色切换、文字冒险、敏感词过滤以及聊天记录总结等插件。这些插件丰富了系统的功能,使得与ChatGPT-on-WeChat的对话更加有趣多样。
    6. 工具功能:项目与操作系统和互联网进行交互,支持最新信息搜索、数学计算、天气和资讯查询,以及网页总结等功能。这些功能基于chatgpt-tool-hub实现,为用户提供了更多实用性。
    7. 知识库:通过上传知识库文件,你可以自定义专属机器人,这个机器人可以作为你的数字分身、领域知识库,甚至是智能客服使用。这一功能基于LinkAI实现,能够为用户提供更加个性化的服务。

    通过将ChatGPT-on-WeChat应用到微信中,我们可以为日常对话增加趣味性和实用性,让交流变得更加智能和富有创意。无论是在个人聊天还是群聊中,这个项目都有潜力为用户带来更加愉快和高效的聊天体验。让我们共同期待ChatGPT-on-WeChat在未来的发展中能够不断带来更多有趣和实用的功能!

    快速开始 ChatGPT-on-WeChat 项目教程

    ChatGPT-on-WeChat 是一个能够将 OpenAI 的 ChatGPT 模型应用于微信聊天的项目。通过这个项目,你可以让微信成为一个智能机器人,能够在与好友聊天时提供有趣和创意的回应。下面是一个快速开始教程,帮助你开始使用 ChatGPT-on-WeChat 项目。

    准备工作

    1. OpenAI 账号注册: 首先,前往 OpenAI 的注册页面创建一个账号。你可以参考提供的教程,使用虚拟手机号接收验证码来注册。完成注册后,前往 OpenAI 的 API 管理页面,创建一个 API Key,并保存下来。这个 API Key 将在项目中配置使用。

    2. 运行环境: 本项目支持 Linux、MacOS 和 Windows 系统。你需要安装 Python,推荐使用 3.7.1~3.9.X 版本,尤其推荐 3.8 版本。请确保你的 Python 版本在 3.7.1~3.9.X 之间,以确保项目正常运行。注意,3.10 及以上版本在 MacOS 可用,但在其他系统上的兼容性可能会有所不同。

    安装步骤

    1. 克隆项目代码: 打开终端或命令行界面,执行以下命令以克隆 ChatGPT-on-WeChat 项目代码:

      git clone https://github.com/zhayujie/chatgpt-on-wechat
      cd chatgpt-on-wechat/
    2. 安装核心依赖: 项目需要一些核心依赖,执行以下命令来安装这些依赖:

      pip3 install -r requirements.txt
    3. 安装拓展依赖(可选): 项目还支持一些拓展功能,你可以根据需要安装拓展依赖:

      pip3 install -r requirements-optional.txt

      如果安装某些依赖失败,你可以将对应的行注释掉,然后继续安装其他依赖。

    配置项目

    1. 复制配置文件:项目根目录中有一个 config-template.json 文件,复制这个文件并将其重命名为 config.json,然后在其中填入你的配置信息。

    2. 配置 API Key:打开 config.json 文件,在 "open_ai_api_key" 字段中填入你在 OpenAI 创建的 API Key。

    3. 配置其他选项:在 config.json 文件中,你可以根据需要配置其他项目选项,如模型名称、代理、群组聊天配置等。请参考上述提供的配置说明。

    使用项目

    完成配置后,你可以在终端或命令行界面中运行项目,让微信聊天变得更加智能和有趣。按照上述配置,ChatGPT-on-WeChat 将根据你的设定进行智能回复、语音识别、图片生成等操作。

    请注意,本教程只是一个快速入门指南,实际使用中可能需要更多的自定义和调整。你可以根据项目的详细文档,进一步探索更多功能和配置选项。

    希望这个教程能帮助你快速开始使用 ChatGPT-on-WeChat 项目,享受与智能机器人的有趣互动!如果你想深入了解更多细节,可以查阅项目的详细文档。

    ChatGPT-on-WeChat 项目部署教程

    无论是本地开发还是在服务器上部署,ChatGPT-on-WeChat 都可以让你的微信变得更加智能和有趣。以下是部署教程的详细步骤,帮助你在不同环境下运行这个项目。

    本地运行

    1. 打开终端或命令行界面,导航至 ChatGPT-on-WeChat 项目的根目录。

    2. 执行以下命令以启动程序:

      python3 app.py
    3. 终端将会输出一个二维码供扫描登录微信账号。使用微信扫描二维码进行登录,当输出 “Start auto replying” 时表示自动回复程序已经成功运行了。请确保你的微信账号已完成实名认证,扫码登录后,你的账号就会成为一个机器人。

    服务器部署

    1. 使用 nohup 命令在后台运行程序。首次运行需要新建日志文件:

      touch nohup.out
    2. 使用以下命令在后台运行程序并通过日志输出二维码:

      nohup python3 app.py & tail -f nohup.out

      扫描登录后,程序将会在服务器后台运行。你可以关闭日志输出而不会影响程序的运行。使用 ps -ef | grep app.py | grep -v grep 命令可以查看运行于后台的进程。如果想要重新启动程序,可以先杀掉对应的进程。关闭日志后,使用 tail -f nohup.out 命令可以再次打开日志。

      注意,项目的 scripts 目录中提供了一键运行和关闭程序的脚本,供使用。

    3. 多账号支持:你可以复制多份项目代码,每份配置不同的账号信息,从而实现多个微信账号的同时运行。

    Docker 部署

    1. 首先,确保已经安装了 Docker 及 Docker Compose。你可以使用 docker -v 命令和 docker-compose version 命令来检查版本信息。如果还未安装,你可以前往 Docker 官网 进行下载。

    2. 下载 docker-compose.yml 文件:

      wget https://open-1317903499.cos.ap-guangzhou.myqcloud.com/docker-compose.yml
    3. 打开下载的 docker-compose.yml 文件,根据需要配置其中的信息,如 OPEN_AI_API_KEY 和 GROUP_NAME_WHITE_LIST 等。

    4. 启动容器,使用以下命令:

      sudo docker compose up -d

      运行 sudo docker ps 命令,检查是否存在 NAMES 为 chatgpt-on-wechat 的容器,如果存在,表示容器运行成功。

      注意:

      • 如果你使用的是 Docker Compose 1.X 版本,需要使用 sudo docker-compose up -d 命令。
      • 该命令会从 Docker Hub 拉取 latest 版本的镜像,该镜像会在每次项目发布新版本时生成。
    5. 若要查看容器的运行日志并扫描二维码进行登录,使用以下命令:

      sudo docker logs -f chatgpt-on-wechat

    插件使用

    如果你需要在 Docker 容器中修改插件配置,可以通过挂载的方式实现。将插件配置文件重命名为 config.json,并放置在与 docker-compose.yml 相同的目录下。在 docker-compose.yml 文件的 chatgpt-on-wechat 部分下,添加 volumes 映射:

    volumes:
      - ./config.json:/app/plugins/config.json

    希望这个部署教程能帮助你在不同环境下成功运行 ChatGPT-on-WeChat 项目。无论你是在本地、服务器还是使用 Docker,都能够让微信变得更加智能和有趣!

  • 探索AudioCraft:一个面向音频生成的深度学习研究库

    探索AudioCraft:一个面向音频生成的深度学习研究库

    在人工智能和深度学习的不断发展下,音频生成技术也日新月异。本文将重点介绍一个名为AudioCraft的PyTorch库,这是一个专为音频生成的深度学习研究而设计的库。AudioCraft不仅包含用于生成高质量音频的两种先进的AI生成模型——AudioGen和MusicGen,还提供了相应模型的训练和推理代码。

    安装要求与步骤

    要求

    • Python 3.9
    • PyTorch 2.0.0

    安装步骤

    首先,确保您已安装PyTorch:

    pip install 'torch>=2.0'

    接着,您有以下几种安装AudioCraft的方式:

    • 稳定版:pip install -U audiocraft
    • 最新版:pip install -U git+https://[email protected]/facebookresearch/audiocraft#egg=audiocraft
    • 如果您已经克隆了本地仓库:pip install -e .

    额外推荐: 安装ffmpeg,这可以通过系统或Anaconda来完成:

    sudo apt-get install ffmpeg
    # 或使用Anaconda或Miniconda
    conda install "ffmpeg<5" -c conda-forge

    模型概览

    目前,AudioCraft库包括以下模型的训练和推理代码:

    • MusicGen:一个先进的、可控制的文本到音乐的模型。
    • AudioGen:一个先进的文本到声音的模型。
    • EnCodec:一个高保真神经音频编解码器。
    • Multi Band Diffusion:一个与EnCodec兼容的解码器,使用扩散技术。

    训练代码

    AudioCraft为音频方面的深度学习研究提供了PyTorch组件,并为已开发的模型提供了训练管道。更多关于AudioCraft设计原则和开发自己训练管道的指导,请参阅AudioCraft的训练文档。

    API文档与FAQ

    项目还提供了一些API文档和常见问题解答。

    例如:

    • 训练代码是否可用?

      是的,我们为EnCodec, MusicGen和Multi Band Diffusion提供了训练代码。

    • 模型存储在哪里?

      Hugging Face将模型存储在一个特定的位置,通过设置AUDIOCRAFT_CACHE_DIR环境变量,您可以更改AudioCraft模型的缓存位置。

    主要特点

    • 模型多样性:包括AudioGen和MusicGen两个主要模型。
    • 高兼容性:需要Python 3.9和PyTorch 2.0.0。
    • 详尽的API文档:方便开发者深入了解各种功能。
    • 开源与许可:MIT许可证,模型权重则采用CC-BY-NC 4.0许可。

    安装与设置

    安装过程异常简单,通过PIP安装即可。此外,库还推荐用户安装ffmpeg,以提供更全面的音频处理功能。

    模型性能

    AudioGen

    适用于文本到声音的转换,几乎是目前最先进的模型之一。

    MusicGen

    可以通过文本控制生成音乐,具有很高的灵活性和创造性。

    API与文档

    库提供了完善的API文档,方便开发者进行深度研究和应用开发。

    常见问题解答(FAQ)

    库也提供了一个FAQ部分,用于解决一些常见的疑问和问题,包括模型存储位置、训练代码的可用性等。

    许可与引用

    本库的代码采用MIT许可证,模型权重则使用CC-BY-NC 4.0许可。

    总结与展望

    AudioCraft是一个非常强大且具有前瞻性的音频生成库。不仅支持多种先进的模型,还提供了极其丰富的文档和API,非常适合需要在音频生成领域进行深度研究的开发者。然而,它依赖于特定版本的Python和PyTorch,可能需要开发者进行一些环境调整。总体而言,这是一个值得关注和深入研究的优秀项目。


    以上便是对AudioCraft库的全面评测,希望对您有所帮助。如果您对音频生成或者AI技术感兴趣,不妨关注我的博客,获取更多前沿信息。

    — 王大神

    如有更多问题或疑问,请不吝留言或联系我。谢谢!

  • 探讨“开箱即用的 stable diffusion 客户端”的前景

    探讨“开箱即用的 stable diffusion 客户端”的前景

    最近,关于”开箱即用的 stable diffusion 客户端”的讨论引起了广泛的关注。针对这一话题,我们将从技术门槛、市场需求和法律合规性等方面展开探讨,以期深入了解这一概念的前景。

    开篇故事

    曾经,每当我们想要使用某项技术或软件,都需要耐心地进行一系列繁琐的初始化操作,有时甚至需要熟练的技术背景。这种情况让很多人望而却步,感受到了科技进步的阻碍。然而,近期涌现的话题引起了我们的关注——”开箱即用的 stable diffusion 客户端”。这个概念的出现似乎为我们打开了一扇全新的大门,让技术更加平民化,也引发了人们的无限遐想。

    技术门槛

    在讨论开箱即用的 stable diffusion 客户端前景时,不得不提的一个关键问题是技术门槛。目前,使用 stable diffusion (sd) 需要进行一系列繁琐的初始化操作,这在一定程度上制约了用户的使用体验。尤其是对于一些配置较低的电脑,初始化操作可能会消耗较多时间。因此,开发一个真正的开箱即用的 sd 客户端,能够让用户摆脱繁琐的操作,轻松地连接到云端镜像,将是一个巨大的技术挑战。

    技术门槛具体表现为:

    • 简化初始化过程,减少用户的等待时间。
    • 实现跨不同硬件环境的兼容性,确保用户的无缝使用体验。
    • 开发团队需要具备深厚的技术背景,能够解决技术上的各种挑战。

    这些问题需要技术团队付出持续不懈的努力,才能实现真正的开箱即用。

    市场需求

    在不少技术领域,开箱即用的产品一直备受追捧。用户不再需要繁琐的配置和操作,能够直接投入使用,极大地提升了用户体验。对于 stable diffusion,如果能够提供一个真正方便的开箱即用客户端,将吸引大量的用户,特别是那些不具备较高技术背景的用户。

    市场需求的体现:

    • 用户追求更简单、高效、快捷的技术体验,开箱即用客户端能够满足这一需求。
    • 稳定的分布式计算在数据分析、模拟计算等领域有广泛的应用前景,这增加了对开箱即用的需求。
    • 新技术的出现常常催生新市场,开箱即用的 stable diffusion 客户端有望引领分布式计算领域的发展方向。

    市场的需求将成为推动开箱即用客户端发展的动力,同时也意味着市场潜力巨大。

    法律合规性

    除了技术和市场需求,法律合规性也是开发这样一个客户端时需要考虑的重要因素。目前,一些开源项目在商业使用方面可能存在限制,使用者需要谨慎遵循相关协议。因此,开发团队需要确保他们的产品在法律上是合规的,以避免潜在的法律风险。

    法律合规性的关键点:

    • 确保产品遵守相关开源协议,不侵犯知识产权。
    • 严格遵循云端镜像和用户数据隐私的法规,保障用户的合法权益。
    • 制定数据安全和隐私保护方案,确保用户的数据不会受到侵犯。

    法律合规性不仅是对开发团队的一种要求,也是对用户权益的保障,必不可少。

    市场现状与潜在竞争

    在讨论开箱即用的 stable diffusion 客户端前景时,也不能忽视已有的竞争格局。目前已经存在一些类似的产品,例如 NovelAI、mage.space 等,它们已经在市场上建立了一定的用户基础。因此,新的客户端需要在技术创新和用户体验方面持续提供优势,以与现有竞争者区分开来。

    市场现状和竞争对手:

    • 存在一些已经成功的类似产品,新客户端需要有差异化的竞争策略。
    • 秋叶懒人包等产品已经满足了一部分开箱即用的需求,新客户端需要在易用性和功能上进一步提升。

    在市场竞争激烈的情况下,只有不断提升产品的独特性和性能,才能脱颖而出。

    结论

    综合考虑,开箱即用的 stable diffusion 客户端在技术、市场和法律方面都存在一定的挑战和机遇。尽管面临着竞争和法律合规等问题,但如果能够成功克服这些难题,开发出一个优秀的客户端,必将受到用户的热烈欢迎。在技术的驱动下,这一概念的前景可能会更加广阔。

    最终的判断将取决于开发团队的能力和决心,以及市场对这一产品的反应。无论如何,开发一个满足用户需求、具备市场竞争力并合乎法律规定的开箱即用的 stable diffusion 客户端,将为技术领域带来新的探索与发展。

  • PowerShell的崭新世界:强大的对象处理和跨平台特性

    PowerShell的崭新世界:强大的对象处理和跨平台特性

    PowerShell,一个曾被低估的工具,如今正以令人瞩目的方式崭露头角。在这个技术快速发展的时代,PowerShell正在引领一场革命,将命令行操作和对象处理推向了一个全新的高度。

    曾经的束缚

    回顾过去,我们对于命令行工具的印象往往停留在像bash这样的传统shell上。这些工具在处理简单的文本和命令时表现出色,但随着任务的复杂性不断增加,它们的局限性也逐渐显现出来。处理文本、串联命令以及应对各种繁琐的语法成为了工作中不可避免的挑战。

    PowerShell的革命性变革

    然而,PowerShell的出现彻底改变了这一局面。它不再将输出简单地视为文本流,而是将其转化为结构化的对象,使得操作变得更加灵活、高效。

    对象处理的优势

    PowerShell的一个显著特点是它将输出结果转化为对象,而不再是单纯的文本。这一特性使得数据具有了结构,用户可以直接访问和操作这些对象的属性和方法。与传统的文本操作相比,PowerShell的对象处理方式使得操作更加直观、高效。无需费心解析文本,用户可以直接通过属性进行筛选、操作和分析数据,从而减少了繁琐的中间步骤。

    跨平台的开放性

    不仅如此,PowerShell如今已经跨足了平台的边界。开源化的PowerShell可以在多个操作系统上运行,这意味着在不同的工作环境下,您都可以依赖PowerShell来完成任务。这种跨平台特性为用户提供了更大的灵活性,使得在不同操作系统中使用相似的工具和脚本成为可能,从而简化了工作流程。

    开源社区的贡献

    作为开源项目,PowerShell获得了全球技术爱好者的积极参与。这个社区不断为PowerShell添加新特性、修复问题,并扩展其在不同场景下的应用。开源性为PowerShell的发展提供了强大的动力,使得这个工具能够持续不断地进化和改进。

    不同声音的共鸣

    当然,不同的用户对于PowerShell持有不同的看法。传统的Unix用户可能更加倾向于使用他们熟悉的shell工具,而PowerShell的对象处理和跨平台特性对他们来说可能并不具备足够的吸引力。然而,对于那些需要处理复杂任务、追求高效操作的用户来说,PowerShell的强大功能无疑会带来巨大的便利。

    结语

    在技术的舞台上,PowerShell正在发挥着越来越重要的作用。它以强大的对象处理和跨平台特性,在处理复杂任务时展现出了独特的优势。PowerShell的崭新世界已经为我们展开,让我们共同期待它在未来的发展中,为我们的工作和技术探索带来更多惊喜和便利!

  • 开源大模型代码短板弥补!崭新的Meta Code Llama Python版本超越ChatGPT,免费可商用

    开源大模型代码短板弥补!崭新的Meta Code Llama Python版本超越ChatGPT,免费可商用

    在编程领域,有一款崭新的利器正引发广泛热议,它不仅开源免费,还在性能上超越了众多大模型,这就是Meta(前Facebook)最新发布的Code Llama。这款编程大模型支持多种编程语言,拥有强大的上下文理解能力,让编程变得更加高效和便捷。

    编程的未来已来

    编程一直是技术领域的核心,但对于许多人来说,编写复杂的代码仍然是一项具有挑战性的任务。传统的编程方式需要掌握语法、理解算法,这对初学者来说是一个巨大的门槛。而随着人工智能的发展,编程助手的出现为编程带来了全新的可能性。

    Code Llama:编程的新伙伴

    Meta的Code Llama是一款强大的编程助手,它不仅可以理解自然语言,还能够生成高质量的代码。与传统的编程工具不同,Code Llama支持多种编程语言,包括Python、C++、Java、PHP、Typescript(Javascript)、C#和Bash等。这意味着无论您是在哪个编程语言中工作,Code Llama都可以成为您的得力助手。

    超越ChatGPT,接近GPT-4

    最令人印象深刻的是,Code Llama在性能上表现出色,超越了众多大模型。Meta的创始成员Karpathy甚至指出,Code Llama的一个“unnatural”版本已经在性能上超越了ChatGPT,逼近了GPT-4的水平。这意味着Code Llama在代码生成和理解方面具有强大的潜力。

    多版本满足不同需求

    Meta为用户提供了三个版本的Code Llama,以满足不同的需求:

    1. Code Llama:基础代码模型;
    2. Code Llama-Python:专注于Python微调版;
    3. Code Llama-Instruct:针对自然语言指令微调版。

    无论您是想要一个通用的编程助手,还是需要针对特定编程语言的帮助,Code Llama都可以为您提供解决方案。同时,这三个版本还提供了不同尺寸的模型选择,包括7B、13B和34B,让您可以根据任务的复杂程度选择适合的模型。

    长序列上下文微调,助力更深入的编程探索

    除了强大的性能,Code Llama还具有令人印象深刻的上下文理解能力。它支持长达10万token的上下文,这意味着您可以将整个代码库交给Code Llama,而不必担心模型无法理解您的需求。这一功能将极大地提高编程效率,减少了手动编写代码的工作量。

    Code Llama的未来

    Code Llama的性能和潜力让人充满期待。Meta已经在论文中测试了一个“unnatural”34B版本,表现出了超越GPT-4的潜力。通过更多样化的编程语言数据集评估,Code Llama在各种编程语言的代码生成中都表现出色。综合来看,Code Llama的7B模型甚至超越了Llama 2的70B模型,展示出了与Codex相当的水平。

    探索Code Llama的世界

    如果您对Code Llama感兴趣,可以访问GitHub项目链接,了解更多关于这个令人兴奋的编程工具。请注意,要获取代码和模型权重,您需要向Meta提交申请,这是进入Code Llama的世界的第一步。不要错过这个机会,与Code Llama一起探索编程的未来!

    GitHub项目链接:https://github.com/facebookresearch/codellama