Tag: 教程

  • Windows 11 Build 23580发布:如何自定义Voice Access语音命令

    Windows 11 Build 23580发布:如何自定义Voice Access语音命令

    Windows 11一直以来都备受关注,而今天,微软又为Dev频道的Windows Insider项目成员带来了一份令人兴奋的好消息。最新的Windows 11 Build 23580预览版更新中,隐藏着一项引人注目的特性,允许用户自定义Voice Access语音命令。这个新功能究竟如何使用?如何在你的Windows 11系统中启用它?今天,我们将深入探讨这一话题,带你一窥Windows 11 Build 23580的最新特性。
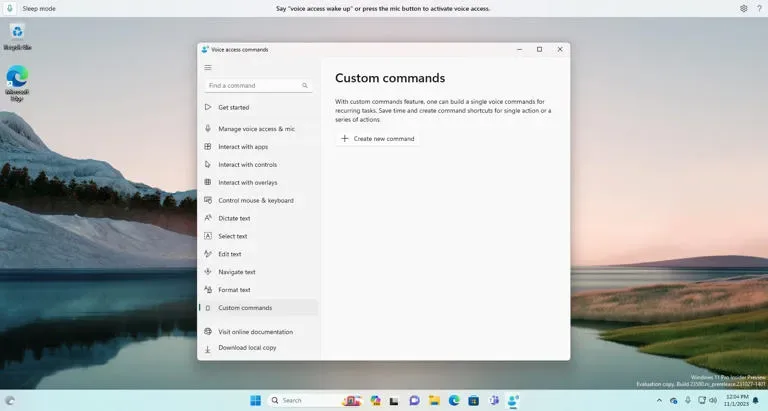
    开启Voice Access自定义命令

    首先,让我们来看看如何开启这一令人期待的Voice Access自定义命令功能。这项功能的存在为我们提供了更多的便利,可以为我们的电脑操作创建定制的语音命令,从而提高工作效率和便捷性。

    步骤1:下载ViveTool工具

    为了启用这一功能,你需要下载ViveTool工具,这是一个非官方的工具,但它可以帮助你在Windows 11 Build 23580中开启Voice Access自定义命令。你可以在GitHub页面上找到这个工具,并将其下载并解压缩到你选择的文件夹中。确保你记住了这个文件夹的路径,因为你将需要在后续步骤中使用它。

    步骤2:以管理员权限打开命令提示符

    按下Win键(或者使用鼠标)打开开始菜单,然后在搜索栏中输入“cmd”。在搜索结果中,选择“以管理员权限”打开命令提示符。这是因为在后续的步骤中,你需要以管理员权限运行ViveTool工具。

    步骤3:跳转到ViveTool文件夹

    在命令提示符中,使用cd命令切换到ViveTool工具所在的文件夹。例如,如果你将ViveTool工具解压缩到了“C:\Program Files (x86)\ViVeTool-v0.3.2”文件夹中,那么你就需要输入以下命令:

    cd C:\Program Files (x86)\ViVeTool-v0.3.2

    步骤4:启用Voice Access自定义命令

    现在,你已经切换到了ViveTool工具所在的文件夹,接下来,输入以下命令以启用Voice Access自定义命令功能:

    vivetool /enable /id:40501685

    按下回车键,ViveTool将会执行相应的操作,启用Voice Access自定义命令功能。

    步骤5:重启电脑

    完成以上步骤后,建议重新启动你的电脑,以确保Voice Access自定义命令功能已经成功启用,并可以正常运行。一旦你的电脑重新启动,你就可以开始享受这一新功能带来的便利了。

    Voice Access自定义命令的应用场景

    那么,Voice Access自定义命令到底可以在哪些场景下发挥作用呢?这一功能的应用范围非常广泛,下面是一些可能的应用场景:

    1. 提高工作效率

    如果你经常需要在电脑上执行一些重复性的任务,比如发送邮件、打开特定的应用程序,Voice Access自定义命令可以为你节省大量时间。只需通过语音命令一次,系统就可以为你自动执行这些任务,让你的工作效率大幅提升。

    2. 个性化操作

    Voice Access自定义命令还允许你根据自己的需求创建个性化的语音命令。例如,当你在使用某个特定应用程序时,你可以定义自己喜欢的命令词,使操作更符合你的习惯和口味。

    3. 便捷的登录

    在登录屏幕上,Voice Access自定义命令也可以派上用场。你可以设置自己的语音密码,从而以更便捷的方式登录系统,增强了安全性的同时也提高了用户体验。

    结语

    Windows 11 Build 23580带来的Voice Access自定义命令功能为用户提供了更多的便利和个性化选择。通过简单的几个步骤,你就可以启用这一功能,并在日常使用中享受到它的便捷。无论是提高工作效率,还是个性化操作,Voice Access自定义命令都将成为Windows 11用户的一项实用工具。

    在未来的Windows 11版本中,我们可以期待更多类似的创新功能,为操作系统带来更多的便利和乐趣。无论你是普通用户还是开发者,都可以通过加入Windows Insider项目,第一时间体验到这些新特性,为Windows 11的发展贡献你的建议和意见。

    不过需要注意的是,ViveTool工具虽然能够帮助你启用Voice Access自定义命令功能,但它并非官方工具,使用时请谨慎,确保你的系统安全。希望这篇文章能够帮助你更好地了解并使用Windows 11 Build 23580中的Voice Access自定义命令功能。让我们一起期待Windows 11的未来,看看微软将为我们带来哪些令人惊喜的创新!
  • 王大神2023年工作总结

    王大神2023年工作总结

    2023年即将结束,我在此分享我的工作总结,以便于回顾这一年我们共同努力和成长的轨迹。这一年对我来说,是挑战与机遇并存的一年,也是收获满满的一年。

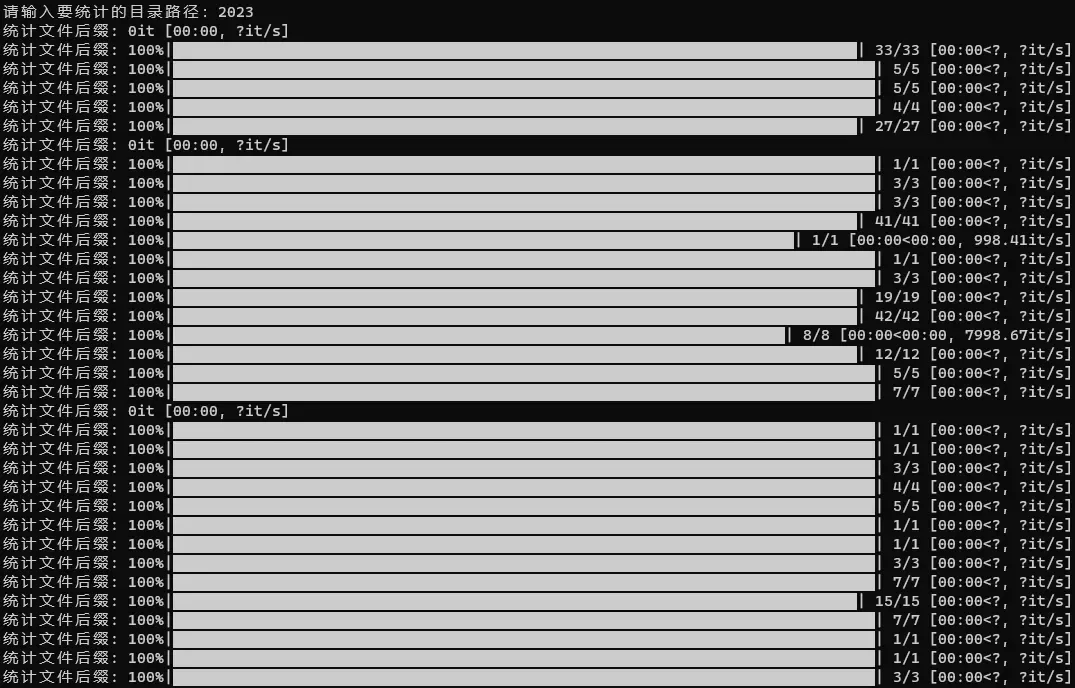
    既然是总结,当然要有数据了,于是写代码分析自己今年的工作量:

    代码放在文末,需要的复制粘贴即可。

    然后写一篇分析报告:

    一、图像处理与设计

    今年,我共创建了2400个PNG格式图像,940个JPG和JPEG格式图像,以及大量其他格式的图像文件,包括GIF、WEBP等,这反映了我的主要工作之一是图像处理与设计。通过使用高级编辑软件如Photoshop(由PSD文件可见),我不仅提高了工作效率,也在视觉效果上达到了更高的专业标准。

    二、文档创作与管理

    文档创作与管理是我今年工作的另一大板块。我共产出了超过4000个文档类文件,包括Word、PDF以及演示文稿等。其中,PDF文件的大量产出(2979个)凸显了我们的内容共享与输出能力。这些文件覆盖了项目报告、市场分析、研究论文等多个领域,彰显了我们在知识管理和文档输出方面的专业性。

    三、软件与网页开发

    在软件开发方面,我创建了278个Python脚本,以及一定数量的JSON、JavaScript、CSS和HTML文件,这说明我参与了多个软件和网页开发项目。Python的大量使用表明了在自动化和数据处理方面的深入工作。此外,IPython笔记本的使用也指向了我在数据科学和教育领域的努力。

    四、三维模型设计

    我在三维建模和设计方面也有所涉猎,从SKP到OBJ,再到FBX文件,我在这一领域的工作虽不如其他领域频繁,但也体现了我的多元技能和对新技术的探索精神。

    五、音频处理与视频制作

    音频文件的编辑与制作同样是我今年工作的重点。我共处理了587个音频文件,包括MP3、WAV、FLAC等格式,这展现了我的音频制作能力。此外,视频文件的编辑也占据了我的部分工作时间,其中MP4格式的文件数量最多。

    六、数据分析与演示

    在数据处理和分析方面,我使用Excel进行了大量的数据整理与分析工作,生成了716个XLSX文件和52个XLS文件。演示文稿的制作也是我的日常工作之一,我在这一年里制作了81个PPT和PPTX格式的文件。

    代码分享

    用于统计文件后缀和大小的python脚本

    首先安装需要的模块

    pip install tqdm

    然后,复制粘贴这个代码,等待数据生成完毕:

    import os
    from tqdm import tqdm
    
    def calculate_folder_size(folder_path):
        total_size = 0
        for dirpath, dirnames, filenames in os.walk(folder_path):
            for filename in tqdm(filenames, desc="计算文件大小"):
                file_path = os.path.join(dirpath, filename)
                total_size += os.path.getsize(file_path)
        return total_size
    
    def count_file_extensions(folder_path):
        extension_count = {}
        for dirpath, dirnames, filenames in os.walk(folder_path):
            for filename in tqdm(filenames, desc="统计文件后缀"):
                file_extension = os.path.splitext(filename)[-1].lower()
                if file_extension:
                    extension_count[file_extension] = extension_count.get(file_extension, 0) + 1
        return extension_count
    
    def main():
        folder_path = input("请输入要统计的目录路径:")
        if not os.path.exists(folder_path):
            print("指定的目录不存在。")
            return
    
        extension_count = count_file_extensions(folder_path)
        total_size = calculate_folder_size(folder_path)
    
        print("文件后缀名统计:")
        for extension, count in extension_count.items():
            print(f"{extension}文件:{count}个")
    
        total_size_mb = total_size / (1024 * 1024)
        print(f"合计:{total_size_mb:.2f}MB")
    
    if __name__ == "__main__":
        main()

    最后输出表格

    文件后缀名 数量
    .png文件 2400个
    .jpg文件 914个
    .txt文件 666个
    .md文件 59个
    .apk文件 3个
    .mp3文件 74个
    .bat文件 9个
    .py文件 278个
    .json文件 20个
    .skb文件 1个
    .skp文件 2个
    .log文件 2个
    .mp4文件 264个
    .avi文件 10个
    .doc文件 187个
    .zip文件 57个
    .xlsx文件 716个
    .docx文件 936个
    .pdf文件 2979个
    .html文件 22个
    .gif文件 21个
    .ini文件 3个
    .mtl文件 10个
    .obj文件 11个
    .stl文件 31个
    .css文件 17个
    .ttf文件 6个
    .js文件 16个
    .pyc文件 20个
    .todolist文件 1个
    .xls文件 52个
    .iml文件 2个
    .xml文件 26个
    .map文件 20个
    .wav文件 470个
    .conf文件 5个
    .webp文件 689个
    .pptx文件 49个
    .tmp文件 194个
    .wps文件 8个
    .crdownload文件 11个
    .caj文件 6个
    .ppt文件 32个
    .cfg文件 1个
    .9)文件 1个
    .awb文件 2个
    .m4a文件 11个
    .aac文件 33个
    .lnk文件 63个
    .flac文件 33个
    .accdb文件 1个
    .svg文件 13个
    .ico文件 2个
    .psd文件 4个
    .exe文件 11个
    .3ds文件 3个
    .jpeg文件 26个
    .eps文件 2个
    .rpy文件 1个
    .rpyc文件 1个
    .pkf文件 130个
    .gz文件 2个
    .ts文件 1个
    .tif文件 1个
    .pat文件 1个
    .m4v文件 1个
    .blend文件 4个
    .rar文件 2个
    .dwg文件 2个
    .srt文件 1个
    .plist文件 1个
    .7z文件 1个
    .fbx文件 2个
    .un~文件 1个
    .yml文件 6个
    .psb文件 1个
    .mov文件 2个
    .reg文件 1个
    .yaml文件 4个
    .ipynb文件 7个
    .hjson文件 4个
    .sample文件 39个
    .idx文件 3个
    .pack文件 3个
    .下载文件 4个
    .jfif文件 48个
    .csv文件 42个
    .php文件 3个
    .thmx文件 2个
    .dotx文件 2个
    .pub文件 1个
    .tex文件 1个
    .livp文件 1个
    .spec文件 1个
    .jpeg-workdetailbodyorigin文件 1个
    .toc文件 7个
    .manifest文件 1个
    .pkg文件 1个
    .pyz文件 1个
    .sh文件 1个
    .ovobj文件 2个

    怎么样,我的工作总结写完了,你要不要也总结一下?

  • 提高在线隐私和安全性的关键技术和设置方法

    提高在线隐私和安全性的关键技术和设置方法

    在日常生活中,我们越来越依赖互联网来进行各种活动,包括浏览网页、发送电子邮件、购物等。然而,随之而来的是个人隐私和安全性的风险。黑客、广告商和其他恶意行为者可能会监视您的在线活动,窃取您的敏感信息。为了保护自己的隐私和安全,我们需要采取一些关键技术和设置措施。

    问题描述

    在互联网上保护自己的隐私和安全性是至关重要的,因为我们的个人信息可能会被不法分子利用。为了解决这个问题,我们可以使用一些技术和设置方法来提高在线隐私和安全性。本文将介绍如何使用DoT、DoH和ECH来加强您的在线安全性,并提供详细的设置方法。

    解决方案

    1. 使用DoT(DNS over TLS)和DoH(DNS over HTTPS)

    DoT和DoH是两种不同但相关的技术,它们可以帮助您提高在线隐私和安全性。以下是设置DoT和DoH的方法:

    使用第三方工具

    许多第三方DNS提供商提供了自己的DoT和DoH服务,其中最知名的是Cloudflare的1.1.1.1和NextDNS。这些服务通常提供了Windows客户端,让您可以轻松切换到DoT或DoH。只需按照以下步骤进行操作:

    1. 前往提供商的网站,例如Cloudflare或NextDNS。
    2. 注册并创建一个帐户。
    3. 下载并安装他们的Windows客户端。
    4. 打开客户端并按照说明进行设置。
    5. 一旦设置完成,您的DNS请求将通过TLS或HTTPS加密,提高了您的在线隐私和安全性。

    手动设置

    如果您不想使用第三方工具,您也可以手动设置DoT或DoH。以下是手动设置的步骤:

    1. 打开“控制面板”。
    2. 选择“网络和共享中心”。
    3. 点击您的连接(例如“以太网”或“Wi-Fi”)。
    4. 在弹出的窗口中,点击“属性”。
    5. 双击“Internet 协议版本 4 (TCP/IPv4)”或“Internet 协议版本 6 (TCP/IPv6)”(取决于您的配置)。
    6. 选择“使用以下DNS服务器地址”,然后输入您所选择的DoT或DoH提供商的地址。例如,对于Cloudflare,可以使用1.1.1.1和1.0.0.1。
    7. 点击“确定”保存设置。

    请注意,这种方法只会更改您的DNS,而不会确保它是通过HTTPS或TLS加密的。为了确保加密,您可能需要使用第三方工具或客户端。

    2. 使用ECH(Encrypted Client Hello)

    ECH是TLS 1.3的一个扩展,旨在保护客户端hello消息免受第三方监听。它可以提高通信的隐私和安全性,尤其是在连接到互联网时。以下是使用ECH的方法:

    使用支持ECH的浏览器

    要利用ECH,您需要使用一个支持它的浏览器,如最新版本的Firefox或Chrome。确保您的浏览器已更新到最新版本,以便获得最佳的安全性和隐私保护。

    检查并启用ECH

    在某些浏览器中,您可能需要进入高级设置或 “about:flags” 页面来确保ECH已启用。启用ECH后,您的浏览器将能够更安全地与服务器建立连接,减少了第三方监听的风险。

    总结

    在线隐私和安全性对于每个互联网用户都是至关重要的。通过使用DoT、DoH和ECH等关键技术和设置方法,我们可以提高我们的在线隐私和安全性,减少了个人信息泄露和监视的风险。不管您选择使用第三方工具还是手动设置,都可以采取措施来加强您的在线安全性。同时,始终确保了解这些技术的工作原理以及它们可能带来的影响,以便做出明智的决策,并保护您的在线隐私和安全。最重要的是,保持您的软件和浏览器更新,以确保您始终享有最新的安全性和隐私保护功能。

  • 查询域名历史持有者信息:解锁域名的神秘过去

    查询域名历史持有者信息:解锁域名的神秘过去

    曾经,互联网是一片无主之地,域名如同无主的领地等待着探险家的发现。但是,如今的互联网已经不再神秘,域名的归属和历史信息也可以轻松查询。你可能听说过WHOIS,一个能够揭示域名持有者信息的神奇工具。本文将带你探索这个神秘的世界,告诉你如何通过WHOIS查询域名的持有者信息以及一些你需要注意的事项。

    WHOIS是什么?

    首先,让我们来了解一下什么是WHOIS。WHOIS是一个用于查询域名注册者信息的系统。通过WHOIS,你可以获得域名的各种信息,包括当前的持有者、注册日期、到期日期、联系信息等。这个系统允许你追踪一个域名的归属者,以及与之相关的详细信息。

    如何查询域名的持有者信息?

    你可能会好奇,如何才能查询到域名的持有者信息呢?其实,这并不难。有许多在线的WHOIS查询工具可以帮助你轻松获取这些信息。以下是一些简单的步骤:

    1. 打开WHOIS查询网站:首先,你需要访问一个在线的WHOIS查询网站,比如https://whois.icann.org/ 或 https://www.whois.com/。

    2. 输入域名:在查询框中输入你想要查询的域名,然后点击查询按钮。

    3. 获取信息:查询结果会显示该域名的各种信息,包括当前的持有者、注册日期、到期日期等。你可以查看这些信息以了解更多关于这个域名的情况。

    注意事项

    然而,需要注意的是,虽然你可以查询到当前的域名持有者信息,但要查询到历年的持有者记录可能会有些困难。以下是一些需要注意的事项:

    1. 隐私保护:许多域名持有者会选择启用隐私保护服务,这样在WHOIS查询中就不会显示他们的实际联系信息,而是显示代理服务的信息。这样,即使你可以查询到历史记录,也可能看不到真正的持有者信息。

    2. 数据不完整:并不是所有的历史WHOIS记录都能被完整保存和查询。有时因为各种原因,某段时间的数据可能无法获得。

    历史记录查询

    虽然查询当前的域名持有者信息相对容易,但查询历史记录可能需要一些额外的工作。不是所有的WHOIS查询工具都提供历史记录查询功能。然而,有一些专门的网站和服务,如DomainTools、Whoisology等,提供了域名的历史WHOIS记录查询功能,可以查看域名过去的持有者信息。如果你有特定的需求,想要了解域名的过去归属者,这些服务可能会对你有所帮助。

    结语

    在互联网的世界里,域名扮演着重要的角色,它们是网站的地址,也是品牌的象征。通过WHOIS查询,我们可以了解域名的归属者信息,以及一些与之相关的详细信息。但要注意,随着隐私保护的普及和数据不完整的问题,有时我们可能无法获取到完整的历史记录。无论如何,查询域名的持有者信息是一个有趣的过程,让我们更深入地了解互联网的运作机制。希望这篇文章对你有所帮助,让你能更好地理解域名的神秘过去和现在。

  • 了解DoT、DoH和ECH:保护您的在线隐私

    了解DoT、DoH和ECH:保护您的在线隐私

    在当今数字化时代,我们的生活与互联网息息相关,几乎每个人都会在日常生活中使用互联网。不过,您可能没有想到,每次访问网站或使用应用程序时,您的在线隐私都可能处于风险之中。为了保护您的数据免受窥视,有一些关键技术正在不断发展,其中包括DoT、DoH和ECH。本文将为您详细介绍这些技术,帮助您更好地了解如何保护自己的在线隐私。

    开篇故事:您的隐私受到威胁

    想象一下,您正在一家咖啡馆里用手机连接Wi-Fi,准备浏览最新的社交媒体帖子或在线购物。您可能没有察觉到,但与此同时,您的个人数据可能正在被窃取。黑客和不法分子正在不断寻找机会来访问您的敏感信息,这包括您的用户名、密码、信用卡号码等。

    这并不是危言耸听。在互联网上,数据泄露和隐私侵犯事件屡见不鲜。为了应对这种威胁,各种网络安全技术应运而生,其中包括DoT、DoH和ECH。让我们深入了解这些技术是如何保护您的在线隐私的。

    第一部分:DoT – 加密DNS

    DNS,或域名系统,是互联网的基础之一。它充当了一个类似电话簿的角色,将域名(如www.example.com)转换为IP地址,以便计算机能够找到并连接到特定的网站或服务器。然而,传统的DNS通信是明文传输的,这意味着您的DNS查询可能会被窃听,导致您的上网活动暴露给不法分子。

    这就是DoT(DNS over TLS)的用武之地。DoT是一种用于加密DNS通信的安全协议,它确保您的DNS查询在传输过程中受到保护。它的工作原理很简单:通过使用传输层安全协议(TLS),它将您的DNS查询加密,以防止任何人窃听或篡改数据。

    DoT的好处不言而喻。首先,它提供了隐私保护,因为您的DNS查询不再以明文形式传输。其次,它增加了网络安全,防止不法分子劫持DNS查询或进行恶意操作。最重要的是,DoT可以在您的设备和DNS服务器之间建立安全的通信渠道,确保您的在线活动得到保护。

    要启用DoT,您需要配置您的设备和DNS服务器以支持此协议。不幸的是,尚未所有的DNS服务器都支持DoT,但随着时间的推移,这种支持会逐渐普及。现在,您可以在一些流行的DNS服务提供商那里找到DoT支持,例如Cloudflare和Google。

    第二部分:DoH – 加密DNS查询

    DoH(DNS over HTTPS)是另一种加强DNS隐私和安全性的技术。与DoT不同,DoH不是通过TLS加密DNS通信,而是通过HTTPS来实现。HTTPS是用于加密网站通信的协议,已经得到了广泛的采用,因此DoH将DNS查询嵌入到HTTPS中,以确保其隐私和安全性。

    DoH的一个显著优势是它更加难以被阻止或检测。在某些网络环境中,DNS被审查或屏蔽,以限制访问特定网站。但由于DoH使用了HTTPS端口,它更容易绕过此类限制,使用户能够自由访问互联网。

    另一个DoH的优点是它提供了更好的隐私控制。一些互联网服务提供商和网络提供商可能会收集并分析您的DNS查询数据,以了解您的上网习惯。使用DoH,您可以将DNS查询发送到受信任的DNS服务器,而不是依赖于ISP提供的DNS服务,从而更好地保护了您的隐私。

    与DoT一样,要使用DoH,您需要配置您的设备和浏览器以支持此协议。许多现代浏览器已经内置了DoH支持,但您可能需要在设置中启用它。此外,一些DNS服务提供商也提供了DoH支持,您可以选择使用它们的DNS服务器。

    第三部分:ECH – 扩展连接加密

    在讨论DoT和DoH之后,我们来看看另一项重要的隐私技术,即ECH(Encrypted ClientHello)。ECH是TLS 1.3的扩展,它旨在加强客户端发起的TLS握手的隐私和安全性。

    要理解ECH的作用,首先让我们简要回顾一下TLS握手过程。当您连接到一个加密的网站时,您的浏览器会与该网站的服务器进行TLS握手,以建立一个安全的通信通道。在握手过程中,客户端会向服务器发送一个称为

    ClientHello的消息,其中包含有关其支持的加密套件和协议的信息。

    在传统的TLS握手中,ClientHello消息是明文发送的,这意味着您的ISP或网络观察者可以轻松地查看它,并了解您正在访问的网站。这可能会泄露您的上网活动,对您的隐私构成威胁。

    ECH通过将ClientHello消息加密,以确保其不会被窃听或篡改,从而解决了这个问题。这意味着即使您的网络流量受到监视,也无法轻松识别您正在访问的网站。ECH还可以帮助您绕过某些审查或屏蔽,因为监视者无法检测到您的目标网站。

    要使用ECH,您的浏览器和目标网站的服务器都必须支持TLS 1.3,并且已启用ECH。虽然ECH是一个强大的隐私工具,但目前还没有得到广泛采用,因此不是所有的网站和浏览器都支持它。但随着时间的推移,我们可以期待它的普及。

    结论:保护您的在线隐私

    随着互联网的普及和依赖程度的增加,保护在线隐私变得愈发重要。DoT、DoH和ECH等技术为我们提供了强大的工具,帮助我们在互联网上保持隐私和安全。

    如果您关心在线隐私,不妨考虑启用DoT和DoH,以确保您的DNS查询和通信得到保护。另外,随着ECH的发展,您也可以关注它的普及,以提高TLS握手的隐私性。

    最后,不要忘记保持您的操作系统、浏览器和应用程序更新,以确保您始终享有最新的安全性和隐私保护功能。通过采用这些措施,您可以更好地保护自己免受在线威胁的侵害,安心享受数字化世界的便利。

  • ChatGPT参数量曝光:20B真相何在?

    ChatGPT参数量曝光:20B真相何在?

    曾经,ChatGPT是个神秘的存在,像是装在宝箱里的珍宝,无人知晓其真正的内在。然而,昨天晚上,一篇EMNLP论文和其中的截图,突然揭开了ChatGPT的神秘面纱,这个曾经的宝箱变得千疮百孔。

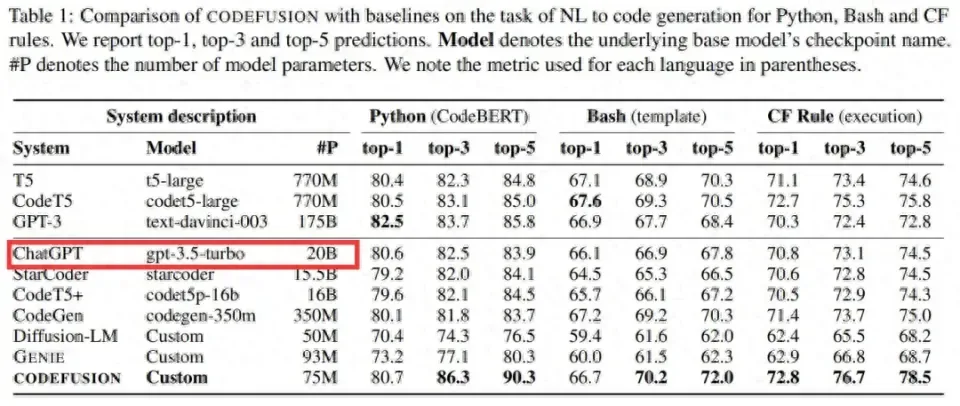
    微软的一篇名为《CodeFusion: A Pre-trained Diffusion Model for Code Generation》的论文,在做对比的时候,无意中透露出了一个令人震惊的消息:ChatGPT仅仅有20B(200亿)的参数量。这个消息引起了广泛的关注和讨论,大家都在想,这合理吗?

    ChatGPT:参数量之谜

    ChatGPT发布已经将近一年,但OpenAI一直对其技术细节保持缄默。由于其出色的性能,人们对ChatGPT的参数量、训练数据等一直充满了好奇和猜测。

    作为一款备受瞩目的大型语言模型,ChatGPT在解决各种问题上表现出色。其前身GPT-3的参数量已经达到了1750亿,而ChatGPT却只有20B,这合理吗?

    这个问题引发了热烈的讨论,人们纷纷在知乎和Twitter上表达了自己的观点。毕竟,拥有200亿参数的模型能够取得如此出色的效果,令人惊叹不已。而且,国内外的大模型通常都以数百亿、上千亿的参数量为特点。

    参数量的真相

    但是,这个20B的参数量是否真实可信呢?大家都有不同的看法。有人认为这个数据是可信的,因为微软和OpenAI一直是合作伙伴,并且这篇论文是在2023年的EMNLP上发表的,因此很可能是真实的。

    然而,也有人怀疑这个数据可能是个拼写错误,或者是有意误导。因为与GPT-3的参数量相比,20B显得太过微小。有人甚至认为实际参数量可能是120B,至少和GPT-3(175B)是一个数量级的。

    从价格上分析

    另一方面,有人从ChatGPT的API定价出发进行了分析,认为20B的参数量是可信的。ChatGPT的API价格仅为0.002美元/1000个token,相比于GPT-3.5的1/10。这个价格反映出了ChatGPT的规模较小,因此20B的参数量可能是符合实际的。

    ChatGPT的未来

    ChatGPT的参数量是否真的只有20B,仍然是一个未解之谜。但无论如何,ChatGPT作为一款出色的大型语言模型,已经在各个领域取得了不小的成功。它的出现改变了人们对大型语言模型的认知,也引发了更多关于模型规模和性能的讨论。

    未来,大型语言模型的改进方向将是增加参数量吗?或者是通过增加训练数据和其他技术手段来提高性能?这些问题仍然值得深入探讨。

    在不久的将来,OpenAI的开发者大会将举行,或许我们将有机会了解更多关于ChatGPT和大型语言模型的有用信息。让我们拭目以待,继续关注这个引领人工智能领域发展的重要话题。

    (注:以上内容仅为猜测和观点,实际参数量尚未得到官方确认。)

  • 腾讯云向量数据库:引领大数据时代的新篇章

    腾讯云向量数据库:引领大数据时代的新篇章

    在数字化时代,数据被视为黄金,而如何高效地管理和查询海量数据成为了企业和科研机构面临的挑战之一。腾讯云向量数据库的全面开放公测,为解决这一挑战提供了强大的解决方案。本文将深入探讨腾讯云向量数据库的特点以及它如何领先于大数据时代。

    腾讯云向量数据库:高效数据向量化

    腾讯云向量数据库是一项令人兴奋的技术突破,它通过将数据向量化,极大提升了存储和查询的效率。传统的数据库系统需要对数据进行复杂的索引和查询操作,而腾讯云向量数据库将数据转化为向量,使得查询过程更加高效。这种向量化的方法不仅提高了存储和查询效率,还解决了大模型预训练中的一系列问题,包括成本高、幻觉、缺乏长期记忆和知识更新不及时等。

    高规模向量检索

    腾讯云向量数据库具有高达100亿级向量检索规模的特点。这意味着它可以处理庞大的数据集,快速进行向量检索,为用户提供准确的查询结果。无论是面对海量图像、文本还是其他类型的数据,腾讯云向量数据库都能够轻松胜任。

    低计算成本

    在大数据时代,计算成本是一个不容忽视的问题。腾讯云向量数据库通过高效的向量化方法,将计算成本降到了最低。这意味着企业可以更经济高效地管理和查询数据,将资源用于更有价值的任务。

    高查询量

    腾讯云向量数据库不仅具有高效的计算能力,还能够处理高查询量。这意味着它适用于各种大规模数据应用场景,无论是电子商务、社交媒体还是科研项目,都能够得心应手。

    独家集成 Embedding 功能

    腾讯云向量数据库的独家集成 Embedding 功能使其在大模型场景下表现出色。企业和科研机构可以轻松地将大型模型嵌入到数据库中,实现更复杂的数据分析和查询。这一功能不仅提高了数据库的灵活性,还为用户提供了更多的数据分析工具。

    腾讯云的全套解决方案

    腾讯云不仅仅提供了腾讯云向量数据库这一强大的工具,还针对大模型场景建立了全套解决方案,加速了人工智能与大数据的全面融合。腾讯云的综合解决方案使人工智能与大数据更加紧密地结合,为企业带来了更多的机会和竞争优势。

    结语

    腾讯云向量数据库的全量开放公测标志着大数据时代的新篇章。它的高效向量化技术、低计算成本、高查询量以及独家集成 Embedding 功能,将为企业和科研机构带来前所未有的数据管理和查询体验。腾讯云的全套解决方案更是加速了人工智能与大数据的融合,为未来的发展开辟了更广阔的道路。让我们共同期待腾讯云向量数据库的应用,助力数字化时代的发展和创新。

  • windows多线程下载神器IDM-官方正版入手渠道

    windows多线程下载神器IDM-官方正版入手渠道

    每当你在浏览网页时,是否曾遇到这样的情景:看到一个精彩的视频或者需要的文件,但下载速度慢得令人发指,或者下载管理混乱,弹窗不断,让你感到烦躁不已?如果是的话,那么这篇文章将为你介绍一款真正的下载神器——Internet Download Manager(IDM)。

    IDM:速度与便捷的代名词

    在网络世界里,下载工具扮演着重要的角色,而IDM已经成为了Windows平台上的一颗璀璨明珠。不同于其他繁杂复杂的下载工具,IDM以它的高效、简洁和便捷而脱颖而出。

    限时优惠:49元起步,118元终生授权

    首先,让我们来看看这个令人心动的价格。官方售价一年版79元,终生版165元,已经让人望而却步。然而,现在,你有机会以限时优惠价,一年版仅需 49元,终生版仅需 118元,更有会员首单立减,仅需 113元,这简直是太超值了!

    点击合作伙伴专属优惠链接即可抢购这款下载神器!

    专注下载:IDM如何提升你的下载体验

    自动捕获链接

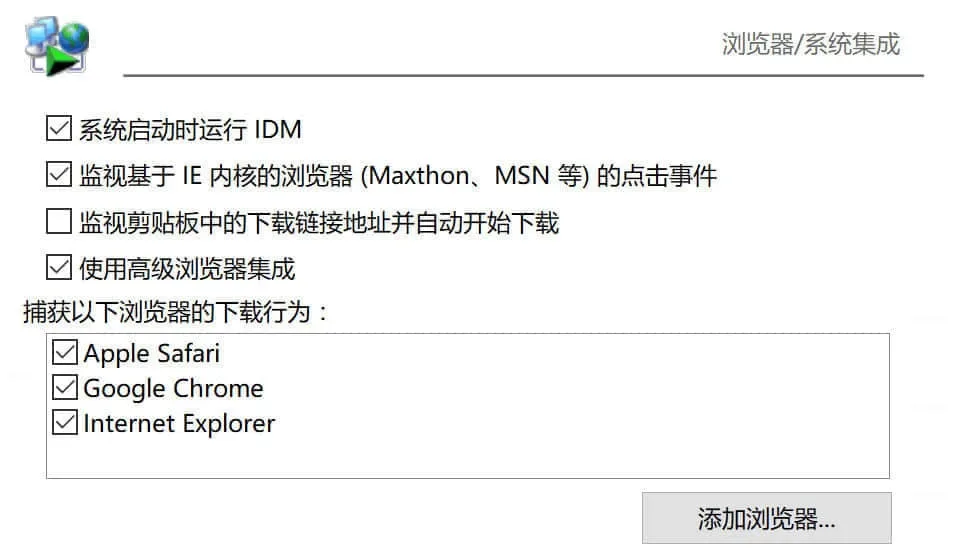
    无需手动复制粘贴下载链接,IDM可以自动捕获浏览器中的下载链接,并将它们添加到下载任务中。支持主流浏览器如Chrome、Safari、Firefox、Edge、Internet Explorer等。如果你使用的浏览器不在支持列表中,也可以在软件设置中轻松添加。

    静默下载

    不再被下载弹窗打扰,不再需要手动点击保存按钮。IDM的静默下载功能可以将下载窗口最小化,下载任务在后台默默进行。如果需要修改保存位置或其他选项,只需在系统托盘中找到IDM图标即可,再也不用打断你的工作或娱乐时间。

    多媒体下载

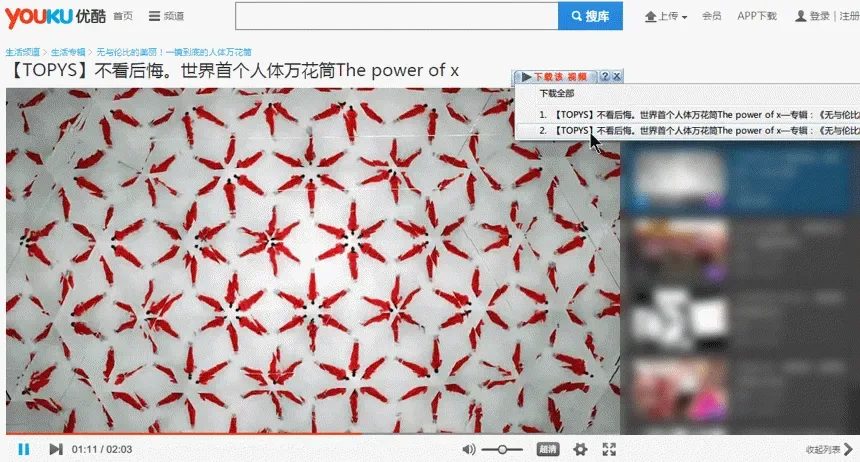
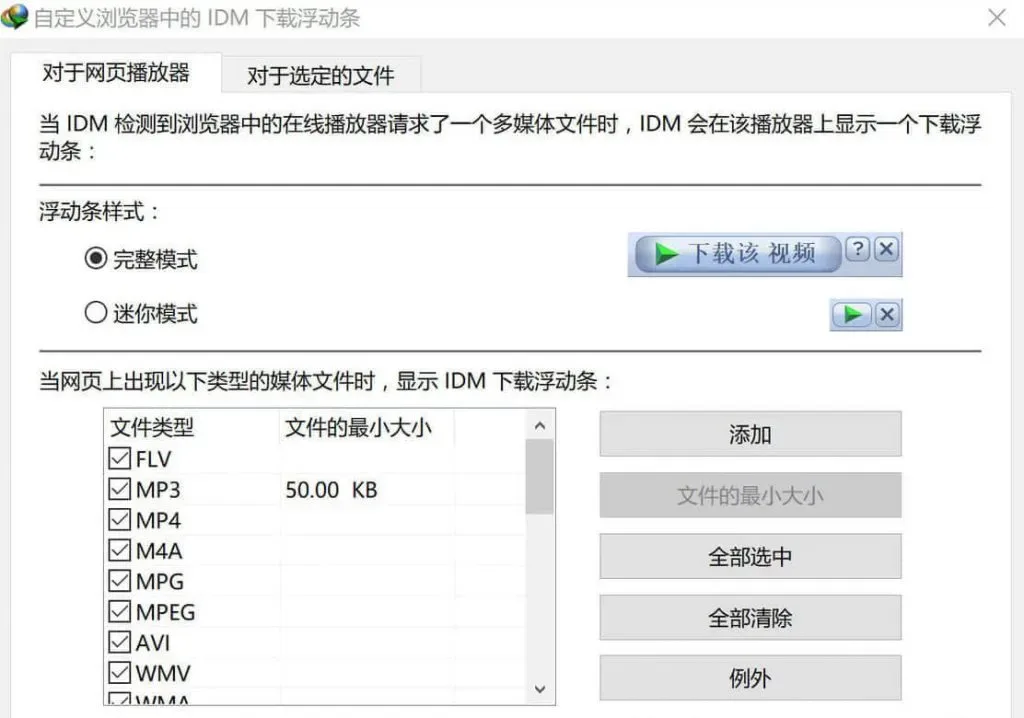
    如果你经常浏览音视频网站,那么IDM将成为你的得力助手。它可以自动检测在线播放器发出的多媒体请求,并在播放器上显示下载浮动条。你可以直接下载流媒体网站中的视频,供离线观看。IDM支持常见音视频格式如MP4、MP3、MOV、AAC等,而且你还可以自定义站点的下载操作。

    强大的扩展功能

    除了以上的基础功能,IDM还拥有一系列强大的扩展功能,满足用户的高阶下载需求。

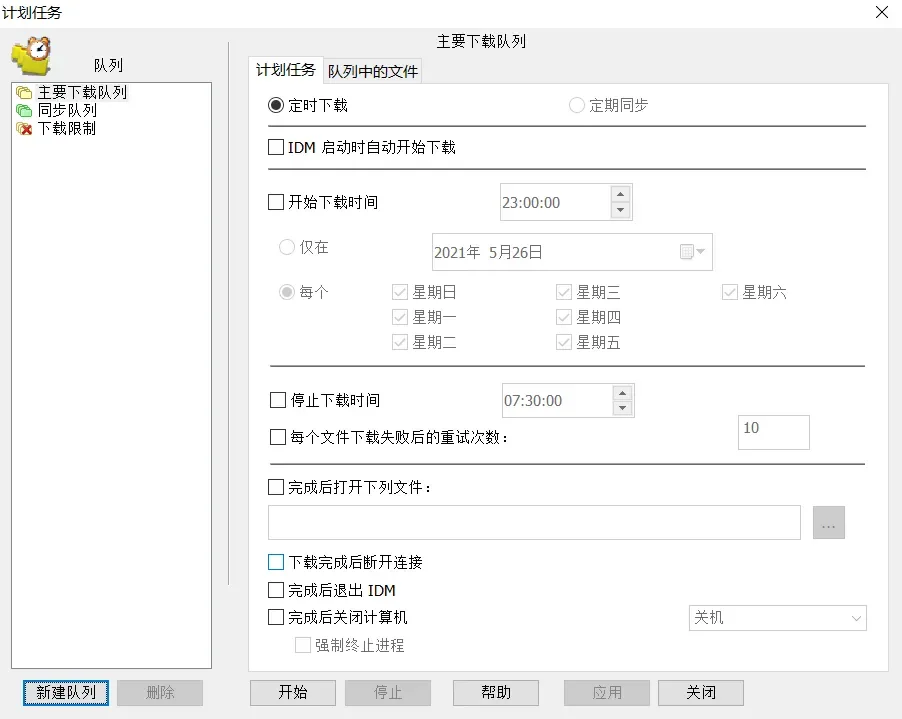
    计划下载任务

    如果你希望在特定的时间段自动启动下载任务,或者需要在特定时间自动暂停下载,IDM的计划下载任务功能将非常实用。比如,你可以在上班时间让电脑自动下载需要的文件,回家后就可以立即使用,非常便捷。

    站点抓取

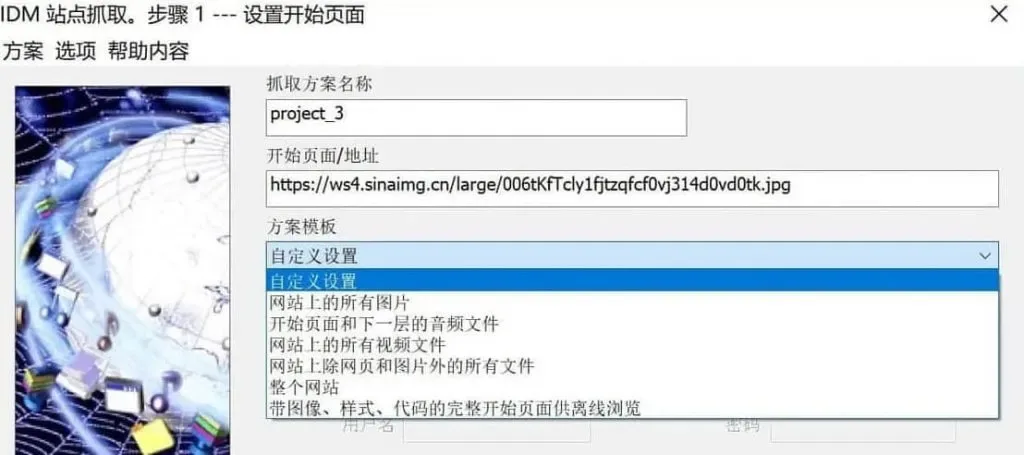
    站点抓取功能让你能够直接选择要下载网页中的指定内容,而无需使用通配符。这包括图片、音频、视频、文件或者包含完整样式的网站离线文件,IDM都可以轻松完成。你还可以根据自己的需求自定义站点抓取的内容与规则。

    批量下载

    如果你需要下载一个链接中的所有文件,比如一个网页中的所有图片,IDM也能胜任。只需使用软件默认或自定义的通配符,你就可以一次性下载多个文件,节省时间,提高效率。

    支持主流国外网盘

    许多国外网站上的资源文件都存放在他们常用的网盘中,直接下载速度慢且容易中断。IDM可以将这些网盘文件作为队列进行批量下载,让你可以独立定制每个队列的下载时间和数量,极大地提高下载效率。目前支持的网盘包括RapidShare、Uploaded.net、FileServe等,你可以访问官网查看所有IDM支持的网盘服务。

    结语:行动起来,抢购IDM,解锁下载新境界!

    IDM限时特惠仅需 49元起步,终生版仅需 118元,再加上会员首单立减仅需 113元,这个机会可不能错过!不再被繁琐的下载流程困扰,不再为下载速度慢而烦恼,赶紧点击合作伙伴专属优惠链接,立刻拥有这款下载神器,享受高速、便捷的下载体验吧!不要再错过任何精彩的内容,让IDM帮助你

    畅快下载,畅快观看!

    现在就行动,解锁下载新境界,感受极速下载的魅力!

  • 如何使用OpenAI API和Langchain构建自然语言问答系统

    如何使用OpenAI API和Langchain构建自然语言问答系统

    在数字化时代,人们对信息的需求日益增长。无论是在学术研究、工作中还是日常生活中,我们都需要快速、准确地获取答案。构建一个自然语言问答系统可以帮助我们在海量信息中迅速找到所需的答案,这不仅提高了工作效率,还增强了用户体验。

    然而,要构建一个强大的自然语言问答系统并不容易。幸运的是,OpenAI提供了一种强大的工具,可以帮助我们轻松构建自然语言问答系统,而Langchain则是一个集成了OpenAI API和Tair的框架,使构建问答系统更加容易。

    在本教程中,我们将向您展示如何使用OpenAI API和Langchain构建一个自然语言问答系统。首先,我们需要准备好OpenAI API密钥和Tair URL,然后加载数据,定义Langchain的链条,最后进行搜索数据。

    准备您的OpenAI API密钥和Tair URL

    首先,我们需要获取OpenAI API密钥和Tair URL。您可以在OpenAI的官方网站上申请API密钥。一旦您获得了API密钥和Tair URL,我们可以继续下一步。

    import getpass
    
    openai_api_key = getpass.getpass("输入您的OpenAI API密钥:")
    TAIR_URL = getpass.getpass("输入您的Tair URL:")

    加载数据

    在构建自然语言问答系统之前,我们需要加载一些包含自然问题和答案的数据。这些数据将用于创建Langchain应用,其中Tair将作为知识库。

    import wget
    import json
    
    # 从Google提供的数据集中下载问题和答案的JSON文件
    wget.download("https://storage.googleapis.com/dataset-natural-questions/questions.json")
    wget.download("https://storage.googleapis.com/dataset-natural-questions/answers.json")
    
    # 读取问题和答案数据
    with open("questions.json", "r") as fp:
        questions = json.load(fp)
    
    with open("answers.json", "r") as fp:
        answers = json.load(fp)

    定义Langchain链条

    接下来,我们将定义Langchain链条,以便使用OpenAI API和Tair存储答案数据。

    from langchain.vectorstores import Tair
    from langchain.embeddings import OpenAIEmbeddings
    from langchain import VectorDBQA, OpenAI
    
    # 创建OpenAI嵌入
    embeddings = OpenAIEmbeddings(openai_api_key=openai_api_key)
    
    # 创建Tair存储
    doc_store = Tair.from_texts(
        texts=answers, embedding=embeddings, tair_url=TAIR_URL,
    )
    
    # 定义整个QA链条
    llm = OpenAI(openai_api_key=openai_api_key)
    qa = VectorDBQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        vectorstore=doc_store,
        return_source_documents=False,
    )

    搜索数据

    一旦我们将数据放入Tair中,就可以开始提问了。每个问题都将由OpenAI模型自动矢量化,然后使用这个矢量找到Tair中可能匹配的答案。一旦检索到答案,最相似的答案将被合并到发送给OpenAI大型语言模型的提示中。

    import random
    import time
    
    # 随机选择一些问题进行提问
    random.seed(52)
    selected_questions = random.choices(questions, k=5)
    
    for question in selected_questions:
        print(">", question)
        print(qa.run(question), end="\n\n")
        # 由于速率限制,等待20秒
        time.sleep(20)

    自定义提示模板

    Langchain的”stuff”链条类型使用特定的提示,其中包含问题和上下文文档。下面是默认提示的样式:

    使用以下上下文信息来回答最后的问题。如果你不知道答案,只需说你不知道,不要试图编造答案。
    {context}
    问题: {question}
    有帮助的回答:

    然而,我们可以提供自定义提示模板,改变OpenAI LLM的行为,仍然使用”stuff”链条类型。重要的是要保持{context}和{question}作为占位符。

    from langchain.prompts import PromptTemplate
    
    custom_prompt = """
    使用以下上下文信息来回答最后的问题。请提供一个简短的单句摘要答案。如果你不知道答案或上下文中没有,不要试图编造答案,而是建议我一首随机无关的歌曲名。
    上下文: {context}
    问题: {question}
    有帮助的答案:
    """
    
    custom_prompt_template = PromptTemplate(
        template=custom_prompt, input_variables=["context", "question"]
    )
    
    custom_qa = VectorDBQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        vectorstore=doc_store,
        return_source_documents=False,
        chain_type_kwargs={"prompt": custom_prompt_template},
    )
    
    # 随机选择一些问题进行提问
    random.seed(41)
    for question in random.choices(questions, k=5):
        print(">", question)
        print(custom_qa.run(question), end="\n\n")
        # 由于速率限制,等待20秒
        time.sleep(20)

    结论

    在本教程中,我们展示了如何使用OpenAI API和Langchain构建一个自然语言问答系统。从获取API密钥和Tair URL,到加载数据,定义Langchain链条,搜索数据,以及自定义提示模板,我们详细介绍了每一步。希望这个教程能帮助您构建自己的自然语言问答系统,以满足各种信息需求。

    无论是在教育、研究还是商业领域,自然语言问答系统都具有广泛的应用前景。通过结合OpenAI的强大语言模型和Langchain的便捷工具,您可以轻松构建出色的问答系统,为用户提供更好的体验。

    如果您有任何问题或需要进一步的帮助,请随时联系我们。愿您的自然语言问答系统在各个领域都取得成功!

  • 使用grep命令获取包含两个关键字的行及其上下文

    使用grep命令获取包含两个关键字的行及其上下文

    在处理文本文件时,有时我们需要查找包含两个关键字的行,并且希望获取这些行的上下文信息,以便更好地理解它们所在的上下文。Linux系统中的grep命令是一个强大的文本搜索工具,可以用来实现这个目标。本文将介绍如何使用grep命令来查找包含两个关键字的行,并获取它们的上下文。

    使用grep命令查找包含两个关键字的行

    grep命令是一个用于在文本文件中搜索指定模式的工具。要查找包含两个关键字的行,可以使用正则表达式来构建搜索模式。下面是一个示例:

    grep -E 'keyword1.*keyword2|keyword2.*keyword1' filename

    让我们解释一下这个命令的各个部分:

    • -E选项:启用扩展正则表达式,允许我们使用|来表示或的关系,以便同时匹配两个关键字。

    • 'keyword1.*keyword2|keyword2.*keyword1':这是我们的搜索模式。它表示查找包含keyword1和keyword2中任意一个关键字的行。.*表示匹配任意字符零次或多次,确保关键字可以在行中以任意顺序出现。

    • filename:要搜索的文本文件的名称。

    获取包含关键字的行及其上下文

    现在,我们知道如何使用grep命令来查找包含两个关键字的行。但是,如果我们想要获取这些行的上下文信息,以便更好地理解它们所在的文本内容,可以使用-C选项来指定上下文行的数量。例如,如果我们想要获取每个匹配行的上下10行,可以这样做:

    grep -C 10 -E 'keyword1.*keyword2|keyword2.*keyword1' filename

    这将输出每个匹配行及其上下10行的文本内容。

    示例与实际应用

    让我们通过一个实际示例来演示如何使用grep命令来查找包含两个关键字的行及其上下文。

    假设我们有一个名为sample.txt的文本文件,内容如下:

    1. 这是一段示例文本。
    2. 包含关键字1的行。
    3. 这是一些上下文文本。
    4. 包含关键字2的行。
    5. 这是另一段示例文本。
    6. 包含关键字1和关键字2的行。
    7. 这是最后一段示例文本。

    现在,我们想查找包含关键字1和关键字2的行,并获取它们的上下文。我们可以使用以下命令来实现:

    grep -C 1 -E '关键字1.*关键字2|关键字2.*关键字1' sample.txt

    输出将是:

    2. 包含关键字1的行。
    3. 这是一些上下文文本。
    4. 包含关键字2的行。

    在输出中,我们看到了包含两个关键字的行,以及每个匹配行的上下文信息(上下1行)。

    这个功能对于分析日志文件、查找特定文本段落或理解文本数据的上下文非常有用。

    总结

    使用grep命令查找包含两个关键字的行并获取其上下文信息是一项有用的任务,可以帮助我们更好地理解文本数据。通过使用正则表达式构建搜索模式,并结合-C选项来指定上下文行的数量,我们可以轻松地实现这个目标。这个功能对于日常的文本搜索和分析任务非常有帮助,是Linux系统中一个强大的文本搜索工具的应用示例。