
Tag: 教程

  • ChatGPT重磅升级:OpenAI计划降低开发成本、提升安全性

    ChatGPT重磅升级:OpenAI计划降低开发成本、提升安全性

    有一天,你坐在电脑前,试图构建一个基于人工智能的应用程序。你有一个创意,但是随之而来的问题是如何让这个想法变为现实,而且要成本可控。正当你为这个挑战感到困惑时,OpenAI宣布了一个重大消息:他们即将推出一系列重大更新,旨在帮助开发人员更便宜、更快速地构建基于AI模型的软件应用程序。

    开发者的好消息

    随着人工智能技术的不断发展,开发者们面临着许多挑战,其中之一是成本。使用先进的AI模型可以帮助你的应用程序变得更智能,但这可能会导致高昂的运营成本。为了解决这个问题,OpenAI计划在下个月推出一次重大更新,其中一个亮点是增加了内存存储功能。这一功能的理论效果是,可以将应用程序的成本降低20倍左右。

    这对于众多初创公司和独立开发者来说是一个利好消息。他们可以更轻松地获得先进的AI技术,而不必担心高昂的开支。这意味着创新将变得更加容易,我们可以期待看到更多智能应用程序的涌现。

    Stateful API:降低成本的利器

    除了内存存储功能,OpenAI还计划发布Stateful API(状态API)。这个功能将使公司能够更便宜地创建应用程序,因为它允许应用程序记住查询的对话历史。这对于构建聊天机器人、虚拟助手等应用程序非常有用。以前,合作伙伴需要为每次查询支付ChatGPT模型高昂的费用,但现在他们可以更具成本效益地构建自己的应用程序。

    这是一个明显的改进,有助于降低AI技术的门槛,使更多人能够受益于这一领域的创新。

    视觉开发工具:开启更多可能性

    除了语言方面的更新,OpenAI还计划推出新的视觉开发工具。这将使开发人员能够构建具有图像分析和图像描述能力的应用程序。这个功能在医疗、金融、电子商务、娱乐等领域都有巨大的潜力。

    想象一下,一个应用程序可以识别病例中的X光图像并提供医生诊断,或者在电子商务网站上为用户提供关于他们正在浏览的产品的详细信息。这些都是视觉开发工具可以带来的潜在应用场景。

    OpenAI DevDay:不容错过的大会

    如果你对这些新的开发工具和功能感兴趣,那么你绝对不应该错过OpenAI即将举办的首届全球开发者大会,即OpenAI DevDay。这个大会将于11月6日在美国加利福尼亚州旧金山举行。在这个大会上,OpenAI将介绍一些全新的产品和技术趋势,你将有机会参加由OpenAI技术人员主持的分组会议,深入了解这些创新。

    GPT-5是否会现身?

    当然,关于OpenAI的未来计划还有一个备受关注的问题,那就是GPT-5是否会推出。在今年4月15日的一次活动中,OpenAI的首席执行官Sam Altman表示,短期内没有计划开发GPT-5。这一决定受到了用户隐私和数据安全的影响,以及来自社会的一些担忧。

    值得注意的是,之前有上千人签署了一封公开信,建议暂停开发比GPT-4更强大的模型。Sam Altman解释说,在正式推出GPT-4之前,OpenAI花费了半年时间来增强其安全性。这表明OpenAI正在采取谨慎的态度,确保其新的AI模型不会引发不必要的风险。

    然而,今年7月31日,OpenAI提交了GPT-5的商标注册申请,并与美国政府签署了AI安全协议,承诺将以透明、安全和稳定的方式来开发生成式AI技术。这些举措表明,OpenAI仍然对GPT-5的发展持开放态度,但也将确保其安全性和稳定性。

    因此,尽管目前没有明确的计划推出GPT-5,但我们不能完全排除它的可能性。或许在未来的某个时候,我们将看到GPT-5的面世。

    提升ChatGPT的安全性

    除了降低成本和增强功能,提升安全性也是OpenAI关注的重点之一。在今年7月26日,OpenAI宣布停止了其AI内容检测工具的研发。原因是该工具在识别率方面表现不佳,无法准确检测由ChatGPT等生成式AI自动产生的文本。

    这引发了对生成式AI安全性的担忧。在这方面,谷歌采取了一项新的举措,推出了名为“SynthID”的数字水印技术。这项技术可以直接植入谷歌的文本生成图像模型生成的图片中。水印对人眼来说是不可察觉的,并且不受颜色更改、滤镜添加等破坏操作的影响;SynthID还能识别图片中的水印。

    这种技术的应用可以提高生成式AI的安全性,防止恶意使用和滥用。人们好奇OpenAI是否会借鉴谷歌的策略,发布类似的产品以增强ChatGPT的安全性并拓宽其应用范围。

    API更新:保持竞争力

    自OpenAI推出API以来,他们不断对其进行更新,以包含最先进的AI模型。这使得开发者们能够更轻松地通过简单的API,将最先进的AI技术集成到他们的项目和产品中,从而增强用户体验。

    总的来说,OpenAI的新举措表明他们致力于降低开发成本、提升安全性,并将先进的AI技术带给更多的开发者和应用场景。这将推动人工智能领域的创新,为我们的未来带来更多可能性。

    如果你对人工智能和OpenAI的发展感兴趣,不妨关注他们即将举行的开发者大会,了解最新的技术趋势和产品发布。
  • 创造流畅视频:AnimateDiff Prompt Travel Video-to-video技术详解与实践指南

    创造流畅视频:AnimateDiff Prompt Travel Video-to-video技术详解与实践指南

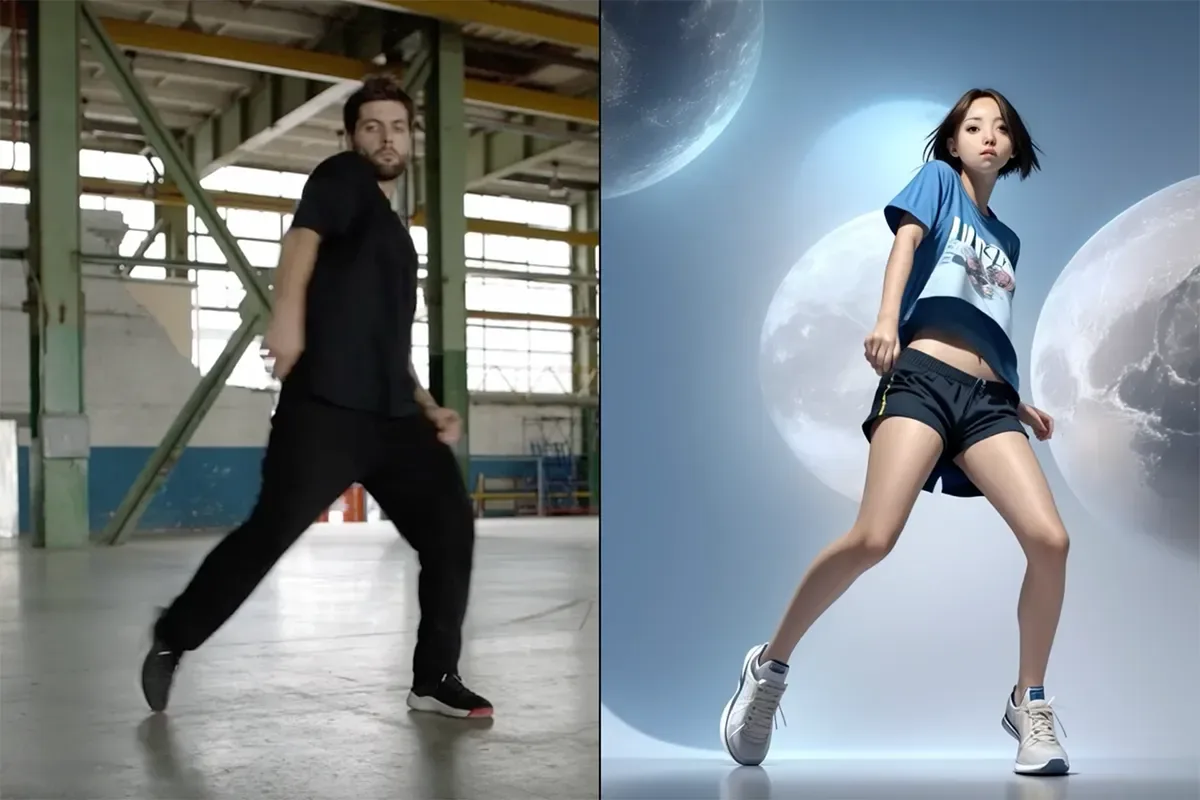
    故事的开始总是那么的神秘和吸引人。想象一下,您可以使用另一个视频作为参考,生成一部充满流畅和时间一致性的视频,其中场景不断变化。这种奇妙的技术就是AnimateDiff Prompt Travel Video-to-video。

    AnimateDiff Prompt Travel Video-to-video AnimateDiff Prompt Travel Video-to-video

    在这篇文章中,我们将深入了解AnimateDiff Prompt Travel Video-to-video的背后技术,以及使用ComfyUI生成此类视频的逐步指南。

    1. AnimateDiff Prompt Travel是如何工作的?

    AnimateDiff通过使用任何Stable Diffusion模型生成具有惊人质量的运动视频。它利用运动控制模型来实现高时间一致性的运动。然而,这种运动是通用且有限的。

    那么,如果我们:

    • 使用AnimaeDiff以实现时间一致性
    • 使用ControlNet来复制参考视频的运动
    • 在不同时间点更改提示,以创建各种场景

    这些就是AnimateDiff Prompt Travel Video-to-video的思路!它克服了AnimateDiff运动效果有限的问题,并与Deforum不同,保持了高帧与帧之间的一致性。

    2. 软件设置

    在我们深入指南之前,让我们确保您已经做好了软件设置。我们将使用ComfyUI来生成AnimateDiff Prompt Travel视频。如果您对ComfyUI还不熟悉,可以查看ComfyUI安装指南和初学者指南。

    在开始教程之前,请确保您已经安装了ComfyUI Manager。

    3. 创建AnimateDiff Prompt Travel视频的步骤

    接下来,我们将逐步指导您如何使用ComfyUI创建AnimateDiff Prompt Travel视频。

    步骤1:加载工作流文件

    ComfyUI的一个很好的特点是分享工作流相对容易。整个工作流程在一个工作流JSON文件中指定。

    将文件拖放到ComfyUI的浏览器页面中。

    您应该会看到加载了视频到视频的工作流程。

    步骤2:安装缺失节点

    您可能需要安装一些缺失的节点,这些节点在此工作流中是必需的。这就是为什么需要ComfyUI Manager来帮助您识别它们。

    点击ComfyUI Manager按钮。

    然后点击“Install Missing Custom Nodes”。

    重新启动ComfyUI,然后点击“Queue Prompt”。如果您不再看到ComfyUI关于缺失节点的投诉,那么您可以继续下一步。

    您可能需要多次执行此步骤。

    步骤3:选择检查点模型

    下载Dreamshaper 8的检查点模型。将safetensors文件放入ComfyUI > models > checkpoints文件夹。

    刷新浏览器选项卡。

    找到“Load Checkpoint w/ Noise Select”节点。

    点击ckpt_name下拉菜单,选择“dreamshaper_8.safetensors”。

    当然,您也可以选择使用不同的模型。

    步骤4:选择VAE

    下载Stability AI发布的VAE。将文件放入ComfyUI > models > vae文件夹。

    刷新浏览器页面。

    在“Load VAE”节点中,选择刚刚下载的文件。

    步骤5:选择AnimateDiff运动模块

    下载AnimateDiff v1.5 v2运动模型。将其放入ComfyUI > custom_nodes > ComfyUI-AnimateDiff-Evolved > models文件夹。

    刷新浏览器页面。

    在AnimateDiff Loader节点中,选择model_name下拉菜单中的“mm_sd_v15_v2.ckpt”。

    步骤6:选择Openpose ControlNet模型

    下载Openpose ControlNet模型。将文件放入ComfyUI > models > controlnet文件夹。

    刷新ComfyUI页面。

    在“Load ControlNet Model (Advanced)”节点中,从下拉菜单中选择“control_v11p_sd15_openpose.pth”。

    步骤7:上传参考视频

    在“Load Video (Upload)”节点中,点击“video”并选择刚刚参考视频。

    步骤8:生成视频

    现在,我们终于可以生成视频了!点击“Queue Prompt”开始生成视频。

    观察终端控制台以查看错误信息。

    大部分时间都会在KSampler节点中度过。在终端控制台中应该有一个显示进度的进度条。

    进度条完成后会消失,您将在AnimeDiff Combine节点中看到生成的视频。

    4. 故障排除

    如果需要进行故障排除,您可以检查中间阶段的输出图像。

    • 在Image Upscaling节点后,您应该看到提取的视频帧。
    • 在ControlNet区域附近,您应该看到提取的Openpose控制图像。
    • 在输出视频上方,您应该看到所有输出视频的帧。您可以进一步处理这些图像,并将它们组合成一个视频。

    5. 自定义

    您可以根据自己的需求生成不同的视频。

    • 更改种子值以生成不同的视频。
    • 更改提示前缀和提示旅行以更改主题和背景。

    6. 使用技巧

    • 确保原始视频的人脸不要太小。工作流使用v1模型,v1模型的VAE尺寸为512×512像素,无法绘制太小的脸部。
    • 如果必要,您可以调整视频的宽度和高度。

    • 要加快渲染速度,可以减少视频输入框中的最大帧数(frame_load_cap)。尤其是在测试设置时,您希望限制它,以便不必等待太长时间。
    • 您还可以通过将select_every_nth设置为大于1的值来跳过视频中的帧以加快渲染速度,但会以平滑度为代价。
    • 不同的检查点模型可能效果不同。训练良好的模型与AnimateDiff一起工作效果更好。因此,如果您的模型不起作用,请尝试使用不同的模型。
    • 由于AnimateDiff是针对特定数据集进行训练的,因此它可能无法理解提示中某些关键词的运动。如果看到奇怪的效果,请尝试确定哪些关键词引起了问题。
    • 最好从一个非常简单的提示开始,根据需要添加内容。
    • 您可以尝试使用其他ControlNets。使用OpenPose的好处是可以去除背景,只提取人体姿势。因此,背景可以受提示的影响。
    • 另一方面,使用线条艺术将提取主体和背景的线条。因此,在视频的样式上使用线条艺术。通过提示添加新元素可能并不容易。

    7. 总结

    通过AnimateDiff Prompt Travel Video-to-video技术,您可以创造出令人惊叹的视频,充满了流畅和时间一致性。无论您是想制作创意视频还是探索视觉创新,这项技术都为您提供了无限可能性。

    希望这篇文章对您在使用AnimateDiff Prompt Travel技术方面提供了有用的指南。现在,尽情发挥创造力,创造出令人瞩目的视频吧!

  • 如何选择最佳的AI图像放大器:提升图像质量的秘密武器

    如何选择最佳的AI图像放大器:提升图像质量的秘密武器

    每个人都曾遇到过这样的情况:一张宝贵的照片,可能是您珍藏已久的回忆,或者是一份重要文件的扫描件,看上去模糊不清,缺乏细节。或者您在网络上找到了一幅壁纸,但分辨率太低,以至于在您的设备上看起来像素化严重。这时,图像放大器就成了您的救星。

    然而,选择合适的图像放大器并不容易,尤其是当您在互联网上搜索时,会发现有数不清的选项。今天,我将向您介绍一些顶级的AI图像放大器,帮助您提升图像质量,无论是修复旧照片还是增强网络图像。

    1. LDSR:慎用慢如蜗牛

    首先,让我们来谈谈LDSR,即Latent Diffusion Super Resolution。这个模型在Stable Diffusion 1.4版本中首次发布,是一个训练有素的潜在扩散模型,用于执行图像放大任务。

    虽然LDSR能够提供卓越的图像质量,但它的运行速度极其缓慢。我不建议您使用它,特别是如果您需要快速处理大量图像的话。

    2. ESRGAN 4x:保留细节的高手

    接下来,让我们看看ESRGAN,即Enhanced Super-Resolution Generative Adversarial Networks。这个图像放大网络赢得了2018年的感知图像恢复与处理挑战赛。它是对之前的SRGAN模型的增强版本。

    ESRGAN有一个强大的特点,它倾向于保留图像中的细节,生成清晰而锐利的图像。如果您需要让您的图像保持尽可能多的细节,这是一个不错的选择。

    3. R-ESRGAN 4x:适用于真实世界图像

    接下来,我们来介绍Real-ESRGAN(R-ESRGAN)。它是对ESRGAN的进一步增强,可以恢复各种真实世界图像,包括那些受到相机镜头和数字压缩影响的图像。

    与ESRGAN相比,R-ESRGAN倾向于生成更平滑的图像,这使它特别适用于真实世界的照片。

    总的来说,R-ESRGAN是处理照片或逼真绘画的最佳选择。

    4. 其他选择

    当然,除了上述提到的选项,还有许多其他图像放大器可供选择。

    需要注意的是,不同的图像放大器适用于不同类型的图像。例如,处理动漫图像可能需要专门训练用于恢复动漫的图像放大器。

    您可以访问图像放大器模型数据库,以便下载其他可用的图像放大器模型。

    结论

    在选择合适的AI图像放大器时,关键是根据您的具体需求和图像类型进行选择。如果您需要最高质量的图像,并且可以容忍较长的处理时间,那么ESRGAN或R-ESRGAN可能是您的首选。但如果您需要快速处理大量图像,那么LDSR可能并不是一个明智的选择。

    无论您选择哪个图像放大器,都要记住定期备份原始图像,以防意外发生。最后,图像放大器是一个令人兴奋的工具,可以帮助您提升图像质量,创造更加令人印象深刻的视觉作品。

    希望本文对您选择合适的图像放大器有所帮助!祝您在图像处理的旅程中取得成功。

  • DreamBooth模型:打开创作的新世界之门

    DreamBooth模型:打开创作的新世界之门

    在创意的世界里,每一位艺术家都渴望拥有一种特殊的工具,能够让他们的想象力更加自由地流淌,并创造出更精致和个性化的艺术作品。DreamBooth模型就是这样一款令人兴奋的工具,它可以用于训练预调模型,通过演算指定主题的图像,让模型产生令人赞叹的输出图像。本文将深入研究DreamBooth模型,介绍其使用方法以及如何将其融合到您的艺术项目中,为您的创作提供新的可能性。

    1. DreamBooth模型概述

    DreamBooth模型是一种用于训练预调模型的工具,其核心思想是通过指定主题的图像进行演算,以训练模型生成更加精致和个性化的输出图像。以下是一些关于DreamBooth模型的要点:

    • 常见模式:DreamBooth模型通常以.ckpt和.safetensors为后缀,具有2G-7G的常见大小。

    • 最新版本的DreamBooth:最新版本的DreamBooth模型具有融合Lora算法的能力,进一步提升了其输出图像的质量和独特性。

    • 训练主题:DreamBooth模型可以用于训练角色、画风、物件等不同主题,其使用方法与主模型相似。

    2. 如何使用DreamBooth模型

    使用DreamBooth模型非常简单,以下是一些基本的操作步骤:

    1. 打开您的AI绘画工具,并找到DreamBooth模型选项。

    2. 选择要用于训练的主题或主题图像,这将成为您的训练基础。

    3. 启动训练过程,让模型根据指定主题的图像进行演算,以生成更具个性化的输出图像。

    4. 在训练完成后,您可以在创作过程中应用训练后的模型,创造出与指定主题相关的艺术作品。

    3. DreamBooth的创作可能性

    DreamBooth模型为艺术家们打开了创作的新世界之门。通过训练模型,您可以实现以下可能性:

    • 个性化创作:模型可以生成与指定主题相关的个性化图像,使您的作品更具独特性。

    • 创造性演算:通过演算不同主题的图像,模型可以帮助您探索不同风格和创作思路。

    • 高质量输出:DreamBooth模型的训练使生成的图像更加精致和高质量。

    结论

    DreamBooth模型是一款令人兴奋的工具,可以为艺术家们提供更多创作的可能性。无论您是专业的艺术家还是刚刚入门的新手,DreamBooth模型都可以成为您的创作伙伴,帮助您实现更精致和个性化的艺术作品。探索DreamBooth,释放您的创作潜力,创造出令人惊叹的艺术作品吧!

  • 文本反转模型和Hypernetworks:个性化图像生成的秘密武器

    文本反转模型和Hypernetworks:个性化图像生成的秘密武器

    在人工智能的世界中,个性化图像生成已经成为一个备受瞩目的领域。文本反转模型(Embeddings/Textual Inversion)和Hypernetworks是两种强大的工具,它们可以通过仅使用几张图像,向模型教授新的概念和风格,用于个性化图像生成。本文将深入研究这两种技术,以及如何在您的艺术项目中巧妙应用它们,创造出独一无二的作品。

    1. 文本反转模型(Embeddings/Textual Inversion)

    文本反转模型是一种微调模型,它允许您通过文本描述来生成个性化图像。这些模型使用小文件(通常为10-100 KB),称为Embeddings,来定义新关键字,以生成新人物或图片风格。以下是关于文本反转模型的一些重要信息:

    • 文件模式:文本反转模型通常以.pt为后缀。

    • 存放路径:您可以在\sd-webui-aki-v4\embeddings目录下找到Embeddings文件。

    • 使用简单:安装后,只需在提示词中提到Embeddings文件,模型就能理解并生成相应图像。非常方便。

    • 限制:由于训练集较小,生成的图像通常只是神似,难以做到完全“形似”。

    尽管文本反转模型有一些限制,但仍然有一些值得安装的Embeddings,如包含大量负面词汇的EasyNegative,可以减少负面词的输入痛苦。

    2. Hypernetworks

    Hypernetworks曾经是一种流行的微调模型,但目前已经不太被广泛使用。这些模型也可以用于个性化图像生成,但与文本反转模型相比,它们的应用范围已经有所局限。以下是关于Hypernetworks的一些信息:

    • 文件模式:Hypernetworks模型通常以.pt为后缀。

    • 存放路径:您可以在\sd-webui-aki-v4\models\Hypernetworks目录下找到Hypernetworks模型。

    与文本反转模型不同,Hypernetworks目前已经不太受欢迎,因此在使用之前需要仔细考虑其适用性。

    3. 如何使用文本反转模型和Hypernetworks

    使用文本反转模型和Hypernetworks非常简单,只需按照以下步骤操作:

    使用文本反转模型(Embeddings/Textual Inversion):

    1. 打开您的AI绘画工具,在生成界面或设置中找到文本反转模型选项。

    2. 选择您希望应用的Embeddings文件,确保它与您的项目和文本描述相匹配。

    3. 开始绘制或编辑您的艺术作品,模型将根据文本描述生成相应的图像。

    使用Hypernetworks:

    1. 打开您的AI绘画工具,在生成界面或设置中找到Hypernetworks选项。

    2. 选择您希望应用的Hypernetworks模型。

    3. 开始绘制或编辑您的艺术作品,模型将根据模型的参数进行个性化生成。

    结论

    文本反转模型和Hypernetworks是个性化图像生成的强大工具,它们允许艺术家们通过文本描述或模型参数来创造独特的作品。尽管Hypernetworks目前已经不太流行,但文本反转模型仍然是许多艺术家的首选工具之一。探索这两种技术,挖掘潜力,创造出令人惊艳的艺术作品吧!

  • VAE美化模型:探索变分自编码器的艺术魅力

    VAE美化模型:探索变分自编码器的艺术魅力

    在当今的艺术创作领域,人工智能已经成为一位独具魅力的合作者。其中,变分自编码器(Variational Autoencoder,VAE)模型为艺术家们提供了一种令人兴奋的工具,它不仅可以实现滤镜效果,还可以进行微调,使艺术创作更加丰富多彩。本文将深入探讨VAE美化模型的奥秘,并介绍如何在您的艺术项目中巧妙应用它,以获得令人惊艳的结果。

    1. VAE模型概述

    VAE模型是一种基于变分自编码器的人工智能模型,它的功能不仅仅是美化图像,还包括滤镜效果和微调。VAE模型的作用可以类比于摄影中的后期处理,它可以改善图像的质量、调整色彩、增加细节,并赋予图像独特的风格。以下是一些关于VAE模型的要点:

    • 文件模式:VAE模型通常以.ckpt或.pt为后缀。

    • 存放路径:您可以在\sd-webui-aki-v4\models\VAE目录下找到VAE模型。

    • 不同模型的适用场景:系统自带的VAE是animevae,但效果一般。建议使用kl-f8-anime2适合画二次元,而vae-ft-mse-840000-ema-pruned适合画写实人物。

    2. VAE与大模型的关系

    一些大模型,例如Chilloutmix,可能会自带VAE模型。在这种情况下,再次添加VAE可能并不会显著改善画面效果,甚至可能适得其反。因此,在使用VAE模型时,需要仔细考虑是否与已有模型兼容,以确保获得最佳效果。

    3. 不同类型的VAE模型

    在VAE模型的世界中,有各种不同类型的模型可供选择。以下是一些常见的VAE模型及其适用场景:

    • kl-f8-anime2:适合绘制二次元风格的艺术作品,提供出色的滤镜效果。

    • vae-ft-mse-840000-ema-pruned:适合绘制写实人物,具有高度的微调能力,可以增强细节。

    4. 如何使用VAE模型

    使用VAE模型非常简单,只需按照以下步骤操作:

    1. 打开您的AI绘画工具,在生成界面或设置中找到VAE模型选项。

    2. 选择您希望应用的VAE模型,确保选择适合您项目的模型类型。

    3. 调整模型参数,如滤镜效果的强度、微调的程度等。

    4. 开始绘制或编辑您的艺术作品,您将看到VAE模型的神奇效果。

    结论

    VAE美化模型是艺术创作的一项宝贵工具,它可以将您的作品提升到一个全新的水平。不论您是职业艺术家还是刚刚入门的新手,VAE模型都能够让您的创作更加生动、多彩。探索不同的VAE模型,挖掘潜力,创造出令人惊艳的艺术作品吧!

  • LoRA模型:个性化风格微调的秘密武器

    LoRA模型:个性化风格微调的秘密武器

    在AI绘画的世界中,LoRA模型正如一颗闪耀的明星,吸引着众多艺术家和创作者的目光。LoRA,全称为”Local Rendering of Attributes”,是一种微调模型,具有独特的能力:它可以将特定类型的人物或事物的风格固定下来,使艺术创作更加个性化和独特。本文将深入探讨LoRA模型的奥秘,以及如何在您的艺术项目中巧妙应用它。

    1. LoRA模型概述

    LoRA模型是当下最受欢迎的微调模型之一,它可以将某一类型的人物或事物的风格固定下来。这些模型通常具有较小的文件大小(10-200 MB),但它们的潜力却无可比拟。以下是一些关于LoRA模型的要点:

    • 文件模式:LoRA模型通常以.ckpt、.safetensors或.pt为后缀。

    • 存放路径:您可以在\sd-webui-aki-v4\models\Lora目录下找到LoRA模型。

    • 与Checkpoint模型搭配:LoRA模型必须与Checkpoint模型一起使用,以发挥其最大潜力。

    2. 火爆的LoRA模型

    LoRA模型的火爆程度可见一斑,特别是一些特定风格的LoRA模型,例如Korean Doll Likeness、Taiwan Doll Likeness、Cute Girl Mix等。这些模型在美女风格的艺术创作中表现出色,效果惊艳。此外,还有一些以不同主题和风格命名的LoRA模型,如墨心等,它们也备受欢迎。未来,我们将专门开辟专题来深入探讨这些LoRA模型的应用。

    3. 使用LoRA模型的方法

    LoRA模型可以以不同方式使用,以下是两种常见的方法:

    方法1:生成界面调用

    使用生成界面是一种常见的方式,它允许您直观地设置预览图,并获得即时的效果感受。部分LoRA模型只支持这种方式的使用。操作步骤如下:

    1. 在生成界面中选择LoRA模型。
    2. 设置您的预览图,以体验模型效果。

    方法2:以插件形式使用

    插件形式的使用更加灵活,您可以轻松地调用多个LoRA模型,并根据需要对它们进行混合。操作步骤如下:

    1. 在启动器界面选择模型管理。
    2. 点击”LoRA模型(插件)”,然后点击”添加模型”。
    3. 选择要添加的LoRA模型,并重新启动启动器。
    4. 在WebUI界面选择相应的插件和权重比例,即可应用LoRA模型。

    结论

    LoRA模型是艺术创作的秘密武器,可以使您的作品更加个性化和独特。无论您是专业的艺术家还是刚刚入门的初学者,LoRA模型都将为您的创作过程带来无限可能性。尝试不同的LoRA模型,挖掘潜力,创作出令人赞叹的艺术品吧!

  • 从C站和Huggingface下载AI模型的完整指南

    从C站和Huggingface下载AI模型的完整指南

    曾经,艺术是一种需要天赋和时间的艰巨任务。然而,随着人工智能的崛起,现在每个人都可以成为绘画大师,只需几分钟的时间和适当的工具。本文将介绍如何从两个主要网站,C站和Huggingface,下载各种强大的AI模型,让您的艺术创作旅程更加轻松愉快。

    1. C站 – 艺术的宝库

    C站,即civitai.com,被誉为艺术模型的宝库。它提供了各种精彩纷呈的模型,使您能够轻松创作出令人叹为观止的艺术作品。然而,需要注意的是,C站在国内是被屏蔽的,所以您需要科学上网才能访问。以下是关于C站的一些重要信息:

    • 模型种类丰富:C站提供了各种类型的模型,包括Text-to-Image、Aesthetic Gradient、LoRA等等,您可以根据自己的需求选择合适的模型。

    • 成人认证:一些模型的预览图被屏蔽,需要进行成人认证才能浏览。这是因为某些模型可能包含成人内容。

    • 模型多样性:C站有来自不同领域的模型,您可以找到适合自己创作风格的模型。

    2. Huggingface – 朴实无华但实用

    Huggingface(huggingface.co)是另一个可靠的模型下载网站。与C站相比,它可能不够华丽,但在模型审核方面更加严格,而且无需科学上网。以下是有关Huggingface的一些信息:

    • 模型可靠性:Huggingface对模型的审核要求较高,确保模型的质量和安全性。

    • 无需科学上网:与C站不同,您可以直接访问Huggingface,无需科学上网。

    • 网速快:Huggingface的网速通常较快,下载模型更加方便。

    • 模型种类:在Huggingface上,您可以找到各种类型的模型,包括Text-to-Image等。

    3. 其他模型下载网站

    除了C站和Huggingface,还有一些其他模型下载网站可供选择:

    • 稳定扩散模型:这些是稳定扩散(SD)的基础模型,无需科学上网。但是请注意,它们一般性能一般。

    • SD模型集合:这个网站提供了大量的SD模型,但界面不如C站友好,需要科学上网才能访问。

    • 炼丹阁:这是一个国内网站,许多模型都是从C站搬运而来,合规性未知,您可以通过百度网盘下载。

    • LiblibAI:LiblibAI号称是国内最大的原创AI模型分享网站,但实际上也有很多从C站搬运的模型。不过,一些受欢迎的原创模型发布者也在该网站上发布模型。

    4. 不同类型的模型

    在下载模型之前,了解不同类型的模型很重要。以下是一些常见模型类型的说明:

    • Checkpoint/大模型/底模型/主模型:这些模型是SD能够绘图的基础模型,必须与SD软件搭配使用。它们包含生成图像所需的一切,但文件体积通常较大(2G-7G)。

    • 常见文件模式:这些模型通常以.ckpt或.safetensors为后缀。

    • 流行的Checkpoint模型:一些流行的Checkpoint模型包括Anything系列、AbyssOrangeMix3、ChilloutMix、Deliberate、国风系列等。它们基于原生SD模型进行训练,以生成特定风格或对象的图像。

    结论

    现在,您已经了解了如何从C站和Huggingface下载各种令人印象深刻的AI模型,以改善您的艺术创作。无论您是专业的艺术家还是刚刚入门的初学者,这些模型将为您的创作过程带来巨大的便利。不要害怕尝试不同类型的模型,发挥您的创造力,创造出独一无二的艺术品吧!

  • 如何使用Python自动化B站任务

    如何使用Python自动化B站任务

    在繁忙的生活中,有时候没有足够的时间去完成一些日常任务,比如在B站上投币、点赞、分享视频。但是,如果你是一名B站的资深用户,你可能知道这些任务可以帮助你获得更多的经验和银币。所以,有没有一种方法可以让计算机来代替你完成这些任务呢?答案是肯定的!在这篇教程中,我们将介绍如何使用Python编写自动化脚本来完成B站的任务,让你可以轻松地获取更多的经验和银币。

    准备工作

    在开始之前,你需要准备以下内容:

    1. B站账号:确保你有一个B站账号,并且已经登录到B站网站。
    2. Python环境:确保你已经安装了Python,并且可以在命令行中运行Python脚本。
    3. B站的Cookie:你需要从浏览器中获取你的B站Cookie,用于登录和访问B站的API。在浏览器中登录B站后,你可以按照以下步骤获取Cookie:

      • 登录B站网站。
      • 打开浏览器的开发者工具(F12键)。
      • 在开发者工具中切换到“网络”选项卡。
      • 刷新B站网页。
      • 在网络请求中找到一个名为“http://api.bilibili.com/x/space/myinfo”的请求,点击它。
      • 在右侧的面板中找到“请求标头”一栏,你将看到一个名为“Cookie”的值。复制这个值,它是你的B站Cookie。

      获取Cookie

    编写Python脚本

    现在,我们将编写Python脚本,用于自动化执行B站的任务。以下是一个示例脚本,你可以根据需要进行修改和定制。

    # -*- coding: utf8 -*-
    
    import requests
    import json
    import time
    import random
    
    # 填写你的B站Cookie
    cookies = "在这里粘贴你的B站Cookie"
    
    # 将Cookie转换为字典
    def extract_cookies(cookies):
        global csrf
        cookies = dict([l.split("=", 1) for l in cookies.split("; ")])
        csrf = cookies['bili_jct']
        return cookies
    
    # 获取银币数
    def getCoin():
        cookie = extract_cookies(cookies)
        url = "http://account.bilibili.com/site/getCoin"
        r = requests.get(url, cookies=cookie).text
        j = json.loads(r)
        money = j['data']['money']
        return int(money)
    
    # 获取个人信息
    def getInfo():
        global uid
        url = "http://api.bilibili.com/x/space/myinfo"
        cookie = extract_cookies(cookies)
        r = requests.get(url, cookies=cookie).text
        j = json.loads(r)
        uid = j['data']['mid']
        level = j['data']['level']
        current_exp = j['data']['level_exp']['current_exp']
        next_exp = j['data']['level_exp']['next_exp']
        sub_exp = int(next_exp) - int(current_exp)
        days = int(int(sub_exp) / 65)
        coin = getCoin()
        times = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())
        msg = "【B站任务】" + str(times) + "\n欢迎!当前等级为" + str(level) + "\n当前经验为" + str(current_exp) + "\n距离升级还差" + str(sub_exp) + "经验\n需要" + str(
            days) + "天\n" + \
              "剩余银币数量为" + str(coin)
        print(msg)
        return msg
    
    # 推荐动态
    def getActiveInfo():
        url = "http://api.bilibili.com/x/web-interface/archive/related?aid=" + \
            str(7)
        cookie = extract_cookies(cookies)
        r = requests.get(url, cookies=cookie).text
        j = json.loads(r)
        return j
    
    # 推荐动态的第二种方式
    def getVideo():
        random_page = random.randint(0, 167)
        url = "http://api.bilibili.cn/recommend?page=" + str(random_page)
        cookie = extract_cookies(cookies)
        r = requests.get(url, cookies=cookie).text
        j = json.loads(r)
        return j
    
    # 执行任务:投币、分享5次
    def Task():
        coin_num = getCoin()
        # 需要投币的个数
        num = 5
        if coin_num <= num:
            num = coin_num
        coin_count = 0
        count = 0
        while True:
            j = getVideo()
            list_len = len(j['list'])
            random_list = random.randint(1, list_len - 1)
            bvid = j['list'][random_list]['bvid']
            aid = j['list'][random_list]['aid']
            print(str(count) + ' ---- ' + str(bvid) + ' ---- ' + str(aid))
            count = count + 1
            toview(bvid)
            time.sleep(5)
            shareVideo(bvid)
            time.sleep(5)
            if coin_count < num:
                coin_code = tocoin(aid, bvid)
                if coin_code == -99:
                    return
            if coin_code == 1:
                coin_count = coin_count + 1
            if coin_count == num:
                break
            print('----------------------')
    
    # 观看视频【不会点赞投币】
    def toview(bvid):
        playedTime = random.randint(10, 100)
        url = "https://api.bilibili.com/x/click-interface/web/heartbeat"
        data = {
            'bvid': bvid,
            'played_time': playedTime,
            'csrf': csrf
        }
        cookie = extract_cookies(cookies)
        r = requests.post(url, data=data, cookies=cookie).text
        j = json.loads(r)
        code = j['code']
        if code
    
     == 0:
            print('观看视频成功!')
        else:
            print('观看视频失败!')
    
    # 分享视频
    def shareVideo(bvid):
        url = "https://api.bilibili.com/x/web-interface/share/add"
        data = {
            'bvid': bvid,
            'csrf': csrf
        }
        cookie = extract_cookies(cookies)
        # 需要请求头
        header = {
            "Content-Type": "application/x-www-form-urlencoded",
            "Connection": "keep-alive",
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/93.0.4577.63 Safari/537.36 Edg/93.0.961.38",
        }
        r = requests.post(url, data=data, cookies=cookie, headers=header).text
        j = json.loads(r)
        code = j['code']
        if code == 0:
            print('分享视频成功!')
        else:
            print('分享视频失败!')
    
    # 投币函数
    def tocoin(aid, bvid):
        coinNum = getCoin()
        if coinNum == 0:
            print('银币不足!')
            return -99
        url = "https://api.bilibili.com/x/web-interface/coin/add"
        headers = {
            'authority': 'api.bilibili.com',
            'method': 'POST',
            'path': '/x/web-interface/coin/add',
            'scheme': 'https',
            'accept': 'application/json, text/plain, */*',
            'accept-encoding': 'gzip, deflate, br',
            'accept-language': 'zh-CN,zh;q=0.9',
            'cache-control': 'no-cache',
            'content-type': 'application/x-www-form-urlencoded',
            'origin': 'https://www.bilibili.com',
            'pragma': 'no-cache',
            'referer': 'https://www.bilibili.com/video/' + str(bvid) + '?spm_id_from=444.41.0.0',
            'sec-ch-ua': '"Not;A Brand";v="99", "Google Chrome";v="97", "Chromium";v="97"',
            'sec-fetch-dest': 'empty',
            'sec-fetch-mode': 'cors',
            'sec-fetch-site': 'same-site',
            'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/97.0.4692.71 Safari/537.36'
        }
        data = {
            'aid': aid,
            'multiply': 1,
            'select_like': 1,
            'cross_domain': 'true',
            'csrf': csrf
        }
        cookie = extract_cookies(cookies)
        r = requests.post(url, data=data, headers=headers, cookies=cookie).text
        j = json.loads(r, strict=False)
        code = j['code']
        if code == 0:
            print(str(bvid) + ' 投币成功!')
            return 1
        else:
            print(str(bvid) + ' 投币失败!')
            return 0
    
    # 一键三连
    def toall(bvid):
        coinNum = getCoin()
        if coinNum == 0:
            print('银币不足!')
            return -99
        url = "http://api.bilibili.com/x/web-interface/archive/like/triple"
        data = {
            'bvid': bvid,
            'csrf': csrf
        }
        cookie = extract_cookies(cookies)
        r = requests.post(url, data=data, cookies=cookie).text
        j = json.loads(r)
        code = j['code']
        if code == 0:
            print(str(bvid) + ' 三连成功!')
            return 1
        else:
            print(str(bvid) + ' 三连失败!')
            return 0
    
    # 运行任务
    def run():
        getInfo()
        Task()
    
    # 主函数入口
    if __name__ == '__main__':
        run()

    如何运行脚本

    1. 将上面的Python代码复制到一个文本编辑器中,并将B站Cookie粘贴到脚本中的cookies变量中。

    2. 打开命令行终端,进入存储脚本的目录。

    3. 在命令行中运行以下命令,启动脚本:

      python your_script_name.py

      请将your_script_name.py替换为你保存脚本的文件名。

    4. 脚本将开始自动执行B站任务,包括观看视频、分享视频和投币。你可以根据需要自定义任务的数量和频率。

    结语

    通过这篇教程,你学会了如何使用Python编写自动化脚本来完成B站的任务。这可以帮助你节省时间,轻松获取更多的经验和银币。希望你能够在B站上享受更多的乐趣!

  • 揭开胎儿意识之谜:他们的世界早在出生前就开始

    揭开胎儿意识之谜:他们的世界早在出生前就开始

    你是否曾在一个婴儿的一岁生日上看到他们眼前闪烁的蜡烛,并不禁想象,他们的眼睛背后隐藏着怎样的思维和意识?这个问题一直以来都困扰着哲学家、神经科学家以及普通人。

    但这个问题的答案并不那么简单。从充满好奇的婴儿,到新生儿,再到受精卵,我们难以确定意识究竟是在哪一刻开始的。是在出生后几个月?还是在出生前就已经存在?澳大利亚莫纳什大学的哲学家Tim Bayne表示:“对于意识是在婴儿出生后不久还是在一岁甚至更晚出现,意识研究领域一直存在争议。”

    为了解开这个谜题,一组来自澳大利亚、德国、美国和爱尔兰的神经科学家和哲学家汇总了当前的研究文献,他们的结论可能会颠覆我们对婴儿意识的传统观念。

    一窥意识的起源

    意识是一个神秘的领域,是主观体验的核心,却又隐藏在我们无法触及的深处。我们知道大脑能够将声音转化为歌曲,将电磁波转化为天空和日落,但我们对于意识在成熟的大脑内如何运作,甚至在婴儿大脑内如何运作知之甚少。

    这个问题不仅仅是哲学挑战,还对科学家们构成了难题。因为没有有效的方法可以明确区分有意识的行为和无意识的反应,所以人类意识的物理理论一直是一个棘手的问题。我们难以理解意识如何在大脑中生成,尤其是在婴儿的大脑中。

    这个问题的重要性不仅仅局限于神经学领域,还涉及到计算、伦理学、法律等各个领域。因为如果我们无法确定婴儿是否具有意识,那么就很难判断他们是否有权利受到特殊保护,比如在医疗程序中是否需要给予镇痛剂。

    历史上,直到20世纪,人们普遍认为婴儿缺乏真正的意识,因此在医疗程序中给予他们最少的镇痛剂或甚至完全不给予。这个观念一直存在,直到现代医学和科学研究开始对婴儿的意识进行深入研究。

    意识的早期迹象

    研究表明,意识可能早在出生前就已经开始形成。根据来自多个国家的研究团队的发现,有足够的证据支持这一观点。这些证据包括以下四个方面:

    1. 大脑之间的高级连接

    研究发现,婴儿的大脑在出生前已经建立了复杂的连接。这些连接可能为意识的形成提供了基础。这意味着婴儿的大脑在出生前已经具备了一定的复杂性,足以支持意识的发展。

    2. 注意力的指标

    研究还发现,婴儿在出生前就已经展现出一定程度的注意力。这表明他们能够对外界的刺激产生反应,这是意识的一种表现形式。

    3. 多感官信息的整合

    研究表明,婴儿能够整合来自不同感官的信息,从而形成对外界的综合认知。这种能力是意识的一个关键组成部分。

    4. 惊讶和重新定向注意力的物理标记

    研究人员观察到,婴儿在受到意外刺激时会表现出惊讶的情绪,并重新定向他们的注意力。这些行为暗示着婴儿可能在出生前就已经开始体验到一定程度的意识。

    新生儿的认知能力

    伦敦三一学院的心理学家Lorina Naci指出:“我们的研究结果表明,新生儿可以将感官和发展中的认知反应整合成连贯的意识体验,以理解他人的行动并计划自己的反应。”

    这并不意味着意识在出生时突然开启,而是意味着我们可能会预期随着突触合并、感官融合和认知建模的发展,意识逐渐觉醒,可以在新的刺激出现时被挑战。

    意识的连续性与碎片性

    虽然研究发现有证据支持婴儿在出生前就具备了一定的意识迹象,但关于意识是连续的还是碎片化的,以及胎儿是否会做梦等问题仍然没有明确答案。

    随着大脑扫描技术的不断改进,我们或许能够更好地理解复杂的神经网络,以及它们是如何在成长过程中构建的。这可能有助于我们将意识看作是一个连续的过程,而不是突然出现的事件。

    结论

    尽管关于婴儿意识的起源仍存在许多未解之谜,但当前的研究结果表明,意识可能早在出生前就已经开始形成。这一发现可能会改变我们对婴儿的认知和对待婴儿的方式。

    这个问题的深入研究对于理解人类意识的本质以及对婴儿的关怀和保护具有重要意义。随着科学的不断进步,我们或许能够更深入地探索意识的奥秘,揭开这个神秘领域的更多秘密。

    本研究结果发表在《认知科学趋势》杂志上,为我们提供了关于婴儿意识的新视角。