Tag: 教程

  • 让Python成为你的工作助手:工作自动化的终极指南

    让Python成为你的工作助手:工作自动化的终极指南

    你是否曾经感到工作负担沉重,每天都在处理重复性任务,而无法集中精力完成更有价值的工作?如果是的话,那么Python可能会成为你的工作救星。Python是一种强大的编程语言,拥有丰富的库和工具,可以帮助你自动化各种任务,从数据处理到文件管理,再到网络操作,Python都能派上用场。本文将向你介绍如何使用Python进行工作自动化,为你的工作生活带来便捷和高效。

    开场小故事

    想象一下,你是一位数据分析师,每天的工作都包括处理海量的数据、清理数据中的空值、计算统计指标,这些工作占据了你宝贵的时间,让你无法专注于深入分析和提取有见地的洞察。有一天,你了解到Python可以帮助你自动化这些任务,从此解放了你的双手,让你可以更聚焦于数据背后的故事。这正是Python的魅力所在。

    数据处理和分析

    数据清洗

    在数据分析领域,数据清洗是一项至关重要的任务。使用Python的pandas库,你可以轻松地清洗和处理数据。

    import pandas as pd
    
    # 读取数据
    df = pd.read_csv('data.csv')
    
    # 数据清洗
    df = df.dropna()
    
    # 保存清洗后的数据
    df.to_csv('cleaned_data.csv', index=False)

    上面的代码示例演示了如何读取一个CSV文件,删除其中的空值,并将处理后的数据保存为新的CSV文件。这样,你可以在数据分析之前,轻松地准备好干净的数据。

    数据分析

    一旦数据清洗完成,接下来就是数据分析的过程。使用Python的numpy和pandas库,你可以进行各种数据分析操作。

    import pandas as pd
    import numpy as np
    
    # 读取数据
    df = pd.read_csv('data.csv')
    
    # 数据分析
    mean_value = df['column_name'].mean()
    std_dev = df['column_name'].std()
    
    print(f'均值:{mean_value}')
    print(f'标准差:{std_dev}')

    这段代码展示了如何计算数据中某一列的均值和标准差。这些统计指标对于理解数据的分布和趋势非常重要。

    文件和文件夹管理

    文件夹创建和文件移动

    在日常工作中,你可能需要创建新的文件夹、移动文件或删除文件。Python的os和shutil库可以帮助你自动化这些任务。

    import os
    import shutil
    
    # 创建文件夹
    os.makedirs('new_folder')
    
    # 移动文件
    shutil.move('source_path', 'destination_path')
    
    # 删除文件
    os.remove('file_path')

    这些操作可以大大提高文件管理的效率,尤其是在需要对大量文件进行操作时。

    网络自动化

    自动发送电子邮件

    电子邮件是商务沟通中不可或缺的一部分。Python的smtplib库可以帮助你自动发送电子邮件。

    import smtplib
    
    server = smtplib.SMTP('smtp.gmail.com', 587)
    server.starttls()
    server.login('[email protected]', 'your_password')
    
    msg = '你好,这是一封测试邮件。'
    server.sendmail('[email protected]', '[email protected]', msg)
    server.quit()

    这段代码演示了如何连接到SMTP服务器,登录你的邮箱,并发送一封测试邮件。你可以将这个过程封装成一个函数,随时用于自动发送通知或报告。

    网络爬虫

    在互联网时代,数据无处不在。Python的requests和beautifulsoup4库可以帮助你创建网络爬虫,从网页上抓取信息。

    import requests
    from bs4 import BeautifulSoup
    
    response = requests.get('https://www.example.com')
    soup = BeautifulSoup(response.text, 'html.parser')
    
    # 提取数据
    data = soup.find('div', {'class': 'class_name'}).text
    print(data)

    这个示例演示了如何从网页上提取特定元素的文本信息。网络爬虫在市场研究、竞争情报和数据采集等方面非常有用。

    定时任务

    有些任务需要按计划定期执行,例如每天自动备份文件或发送报告。Python的schedule库可以帮助你创建定时任务。

    import schedule
    import time
    
    def job():
        print('执行定时任务')
    
    # 每天上午9点执行任务
    schedule.every().day.at('09:00').do(job)
    
    while True:
        schedule.run_pending()
        time.sleep(1)

    上述代码演示了如何创建一个每天上午9点执行的定时任务。你可以根据需要定制不同的执行计划。

    结语

    Python是一种强大的工具,可以帮助你自动化工作中的各种任务,从数据处理到文件管理,再到网络操作和定时任务。通过学习和应用Python,你可以大大提高工作效率,将更多的时间用于创造性的工作和决策制定。

    现在,是时候让Python成为你的工作助手了!开始学习和应用Python,解放你的双手,提升你的工作效率吧!

    无论你是一位数据分析师、程序员、办公室职员还是任何需要自动化任务的人,Python都可以成为你的得力助手。希望这篇文章能够帮助你了解如何使用Python进行工作自动化,并让你的工作更加高效和愉快。

  • 如何使用Python进行图像形状匹配

    如何使用Python进行图像形状匹配

    你是否曾经想过如何使用Python来识别一张图片中特定形状的位置,或者进行图像中的物体匹配?在这个教程中,我们将向你展示如何使用Python和OpenCV库进行图像形状匹配。无论你是想识别图像中的某个标志性形状,还是进行图像中物体的匹配,这个技巧都会帮助你实现目标。

    开篇故事

    假设你是一名计算机视觉工程师,正在为一个机器人项目编写软件,该机器人需要能够识别环境中的特定标志以进行导航。你的团队提供了一些标志的模板图像,而机器人需要在实际场景中找到并识别这些标志。这个任务对于机器人导航至关重要,但也非常具有挑战性。

    在这个背景下,你决定使用Python和OpenCV库来开发一个图像形状匹配的算法。这个算法将帮助机器人在实际场景中寻找并匹配标志的位置,从而更好地导航。接下来,我们将一步步探讨如何实现这一目标。

    步骤 1:导入必要的库

    首先,让我们导入需要使用的Python库。我们将使用OpenCV库来处理图像和进行形状匹配。

    import cv2

    步骤 2:加载图像并进行预处理

    接下来,我们需要加载图像并对其进行一些预处理步骤,以便进行形状匹配。在这个示例中,我们有两张图像,一张是背景图像,另一张是我们要匹配的滑块图像。

    image1 = cv2.imread("background_image.jpg")
    image2 = cv2.imread("slider_image.jpg")

    步骤 3:预处理背景图像

    对于背景图像,我们需要进行一系列处理步骤,以便后续的形状匹配能够更准确地进行。以下是处理步骤:

    3.1 阈值处理

    首先,我们使用阈值处理将图像二值化,保留大部分白色背景。

    ret, thresholded_image = cv2.threshold(image1, 220, 255, cv2.THRESH_BINARY)

    3.2 灰度化

    接下来,我们将二值化的图像转换为灰度图像,以便后续的操作。

    gray_image1 = cv2.cvtColor(thresholded_image, cv2.COLOR_BGR2GRAY)

    3.3 提高对比度

    为了增强图像的对比度,我们可以使用直方图均衡化。

    denoised_image1 = cv2.equalizeHist(gray_image1)

    3.4 边缘检测

    最后,我们使用Canny边缘检测算法来检测图像中的边缘。

    edges = cv2.Canny(denoised_image1, threshold1=500, threshold2=900)

    步骤 4:预处理滑块图像

    对于滑块图像,我们也需要进行类似的预处理步骤。

    4.1 灰度化

    首先,将滑块图像转换为灰度图像。

    gray_image2 = cv2.cvtColor(image2, cv2.COLOR_BGR2GRAY)

    4.2 提高对比度

    同样,使用直方图均衡化来增强滑块图像的对比度。

    denoised_image2 = cv2.equalizeHist(gray_image2)

    4.3 边缘检测

    最后,使用Canny边缘检测算法检测滑块图像的边缘。

    edges2 = cv2.Canny(denoised_image2, threshold1=650, threshold2=900)

    步骤 5:进行形状匹配

    现在,我们已经准备好进行形状匹配了。我们将使用OpenCV的matchTemplate函数来实现这一目标。

    result = cv2.matchTemplate(edges, edges2, cv2.TM_CCOEFF_NORMED)
    min_val, max_val, min_loc, max_loc = cv2.minMaxLoc(result)
    top_left2 = max_loc
    bottom_right2 = (top_left2[0] + edges2.shape[1], top_left2[1] + edges2.shape[0])

    步骤 6:在输入图像上绘制矩形标记

    最后一步是将匹配结果在输入图像上进行可视化,我们可以在匹配到的位置绘制一个矩形标记。

    cv2.rectangle(image1, top_left2, bottom_right2, (0, 0, 255), 2)

    步骤 7:显示结果图像

    最后,让我们将处理后的图像显示出来,以便查看匹配的结果。

    cv2.imshow("Target Image", image1)
    cv2.waitKey(0)

    结语

    使用Python和OpenCV库,你可以轻松地进行图像形状匹配,识别图像中特定形状的位置。这个技巧在许多应用中都非常有用,从计算机视觉任务到图像识别和机器人导航。

    无论你是一名计算机视觉工程师、图像处理专家还是对图像处理感兴趣的人,都可以受

    益于这个技术。希望这个教程对你有所帮助,让你更好地理解图像形状匹配的原理和实际应用。

  • 如何用Python提高会计工作效率

    如何用Python提高会计工作效率

    你是否曾经想过如何在会计工作中更高效地处理数据、自动化繁琐的任务,或者提供更准确的财务报告?Python编程语言可能不是会计专业的一部分,但它可以成为你在会计领域的有力工具。在这篇教程中,我们将探讨一些Python在会计工作中的实际应用示例,帮助你提高工作效率、降低错误率,以及更好地应对日常挑战。

    开篇故事

    假设你是一名拥有多年会计经验的财务专业人士。每个月,你都需要处理大量的财务数据,进行分类、计算、生成报告,以确保公司的财务状况良好。这个任务通常非常繁琐,需要大量的时间和精力,还容易出现错误。

    有一天,你听说了Python这个强大的编程语言,以及它在数据处理和自动化方面的能力。你决定深入学习Python,并探索如何将它应用到你的会计工作中。经过一段时间的学习和实践,你发现Python可以帮助你更轻松地处理财务数据、自动化重复性任务,并生成更准确的财务报告。这不仅提高了你的工作效率,还为公司节省了时间和成本。

    Python在会计工作中的应用示例

    现在,让我们来看看Python在会计工作中的一些实际应用示例,以及如何使用它们来改善你的工作流程。

    1. 数据导入和清理

    在会计工作中,你经常需要处理各种各样的财务数据,包括银行对账单、发票、交易记录等。Python的Pandas库可以帮助你导入这些数据,并进行清理、筛选和转换,以便进一步分析和报告。

    import pandas as pd
    
    # 导入Excel文件
    data = pd.read_excel('financial_data.xlsx')
    
    # 数据清理和转换
    data_cleaned = data.dropna()  # 删除缺失值
    data_filtered = data[data['Amount'] > 0]  # 筛选正数金额的交易

    2. 自动化报表生成

    Python可以帮助你自动化财务报表的生成,无需手动整理数据和创建报表。你可以使用库如Matplotlib或Seaborn来创建图表,将数据可视化,并使用Excel或PDF库将报表导出。

    import matplotlib.pyplot as plt
    
    # 创建柱状图
    plt.bar(data['Month'], data['Revenue'])
    plt.xlabel('月份')
    plt.ylabel('营收')
    plt.title('每月营收报表')
    
    # 保存为图片或PDF
    plt.savefig('revenue_report.png')

    3. 预算和财务建模

    Python还可以用于创建财务模型和预算,以帮助公司规划和管理资金。你可以编写脚本来计算预算、估算风险,以及进行敏感性分析。

    # 计算年度预算
    revenue_growth_rate = 0.1
    initial_revenue = 1000000
    
    for year in range(1, 6):
        initial_revenue *= (1 + revenue_growth_rate)
        print(f'第{year}年预计营收: ${initial_revenue:.2f}万')

    4. 自动化数据输入

    有时,你可能需要将数据从其他系统或文件导入到会计软件中。Python可以帮助你编写脚本来自动化这个过程,以减少手动输入的错误和工作量。

    import openpyxl
    
    # 打开Excel文件
    workbook = openpyxl.load_workbook('data_to_import.xlsx')
    worksheet = workbook['Sheet1']
    
    # 从Excel中提取数据并自动输入到会计软件中
    for row in worksheet.iter_rows(min_row=2, max_row=worksheet.max_row, values_only=True):
        date, description, amount = row
        accounting_software.add_transaction(date, description, amount)

    5. 财务分析和预测

    Python的数据分析和机器学习库可以用于财务分析和预测。你可以使用历史数据来预测未来的财务趋势、风险和机会。

    import numpy as np
    from sklearn.linear_model import LinearRegression
    
    # 使用线性回归进行财务趋势预测
    X = np.array(range(1, 11)).reshape(-1, 1)
    y = np.array([100, 110, 120, 130, 140, 150, 160, 170, 180, 190])
    
    model = LinearRegression()
    model.fit(X, y)
    
    future_months = np.array(range(11, 16)).reshape(-1, 1)
    predicted_revenue = model.predict(future_months)

    结语

    Python作为一种强大的编程语言,可以在会计工作中发挥巨大的作用。从数据导入和清理到财务分析和预测,Python提供了丰富的工具和库,可以帮助你更高效地处理财务任务、降低错误率,并提供更准确的财务报告。

    无论你是一名会计师、财务分析师还是企业主,学习Python并将其应用到会计工作中都将帮助你提高工作效率、更好地理解财务数据,以及做出更明智的财务决策。开始学习Python吧,让它成为你的会计工具之一!

  • 如何使用Python快速去除图片背景并保存

    如何使用Python快速去除图片背景并保存

    你是否曾经遇到过这样的问题:你有一张图片,但是你只想保留其中的某些物体或图案,而将其他部分的背景删除?这可能是因为你需要将物体或图案添加到其他图片中,或者只是为了更好地突出显示这些物体。在这个教程中,我们将向你展示如何使用Python和PIL库快速去除图片的背景,并保存你想要的部分。

    开篇故事

    假设你是一名设计师,正在为一本儿童教育书籍制作插图。你已经有了一些美丽的插图,但它们都带有白色背景。为了使插图更好地融入书籍,你希望将背景去掉,只保留插图中的内容。手动去除每张图片的背景将非常耗时,所以你希望找到一种快速而有效的方法。

    在这个背景下,你决定使用Python编写一个脚本,自动去除图片的背景,并将结果保存为具有透明背景的PNG图像。这将帮助你节省大量的时间,同时确保插图看起来更加专业。

    准备工作

    在开始之前,确保你已经安装了以下必要的库和工具:

    • Python(建议使用3.x版本)
    • Pillow(Python Imaging Library,用于处理图像)
    • 一些包含带背景的图片

    步骤 1:导入必要的库

    首先,让我们导入所需的Python库。我们将使用Pillow库来处理图像。

    from PIL import Image

    步骤 2:编写背景去除函数

    接下来,我们将编写一个函数,该函数将负责去除图片的背景并返回结果。我们将使用Pillow库中的convert方法来实现这一点。

    def remove_background(image_path, save_path):
        img = Image.open(image_path)
        img = img.convert('RGBA')
    
        width, height = img.size
    
        for x in range(width):
            for y in range(height):
                r, g, b, a = img.getpixel((x, y))
                # 判断像素是否属于背景,这里假设背景是白色
                if r > 100 or g > 100 or b > 100:
                    img.putpixel((x, y), (0, 0, 0, 0))
                else:
                    img.putpixel((x, y), (r, g, b, 255))
    
        img.save(save_path)

    这个函数接受输入图片的路径(image_path)和保存结果图片的路径(save_path)。它将图像转换为RGBA模式,然后遍历每个像素,将背景像素的Alpha通道设置为0,从而使其变为透明。我们假设背景是白色,但你可以根据需要修改这个条件。

    步骤 3:使用函数去除背景

    现在,我们可以使用刚刚编写的remove_background函数去除图片的背景。你可以将下面的代码添加到你的脚本中,用于处理单个图片:

    input_image_path = 'input_image.png'  # 输入图片路径
    output_image_path = 'output_image.png'  # 输出图片路径
    
    remove_background(input_image_path, output_image_path)

    步骤 4:批量处理多张图片

    如果你有多张图片需要处理,你可以使用一个循环来批量处理它们。首先,将所有需要处理的图片放入一个文件夹中,然后使用以下代码来批量处理它们:

    import os
    
    input_folder = 'input_images'  # 包含输入图片的文件夹路径
    output_folder = 'output_images'  # 包含输出图片的文件夹路径
    
    if not os.path.exists(output_folder):
        os.makedirs(output_folder)
    
    # 遍历文件夹中的所有图片文件
    for filename in os.listdir(input_folder):
        if filename.endswith('.png') or filename.endswith('.jpg'):
            input_image_path = os.path.join(input_folder, filename)
            output_image_path = os.path.join(output_folder, filename)
            remove_background(input_image_path, output_image_path)

    这段代码将遍历指定文件夹中的所有图片文件,并将它们的背景去除后保存到另一个文件夹中。

    步骤 5:查看处理结果

    你现在已经成功地去除了图片的背景,并保存了处理后的图片。你可以打开这些图片,查看它们的背景是否已经被成功去除,并且只剩下了前景物体或图案。

    结语

    通过使用Python和Pillow库,你可以轻松地去除图片的背景,并创建具有透明背景的PNG图像。这个技巧在许多情况下都非常有用,无论是用于设计、图像编辑还是其他创意项目。

    无论你是一名设计师、开发者还是对图像处理感兴趣的人,都可以受益于这个简单而强大的背景去除技巧。现在,你可以将它应用到自己的项目中,创造出令人印象深刻的图像!

  • 使用FastAPI和Edge TTS创建自定义文本转语音应用

    使用FastAPI和Edge TTS创建自定义文本转语音应用

    有时候,你可能需要一个自定义的文本转语音(TTS)应用,以将文字转化为声音。这可以用于语音助手、有声书、自动化通知等各种应用场景。在这篇教程中,我们将介绍如何使用FastAPI和Edge TTS创建一个简单但功能强大的自定义TTS应用。

    开篇故事

    假设你是一名开发者,正在为一个在线教育平台开发新功能。你的用户希望能够将课程文本内容转化为音频,以便在不方便阅读的情况下仍然能够学习。然而,你发现市面上的现成TTS工具并不能满足你的需求,因为你需要更多的自定义选项。

    在这个背景下,你决定创建一个自己的TTS应用,以满足用户的需求。你选择使用FastAPI作为Web框架,结合Edge TTS来实现文本到语音的转换。这个教程将帮助你一步步构建这个应用。

    准备工作

    在开始之前,确保你已经安装了以下必要的库和工具:

    • Python(建议使用3.7或更高版本)
    • FastAPI
    • Edge TTS
    • Pygame(用于播放生成的音频)

    步骤 1:创建FastAPI应用

    首先,让我们创建一个FastAPI应用。你可以使用以下代码来创建一个基本的FastAPI应用:

    from fastapi import FastAPI
    
    app = FastAPI()
    
    @app.get("/")
    async def read_root():
        return {"message": "Welcome to your TTS app!"}

    这个应用会在根路径返回一则欢迎消息。

    步骤 2:集成Edge TTS

    接下来,我们需要集成Edge TTS,这是一个用于文本到语音转换的库。你可以按照以下步骤来进行集成:

    1. 安装Edge TTS库:

      pip install edge-tts
    2. 导入Edge TTS库:

      import edge_tts
    3. 创建一个异步函数来处理TTS:

      import asyncio
      
      async def tts(text, output, voice, rate):
         volume = '+0%'
         tts = edge_tts.Communicate(text=text, voice=voice, rate=rate, volume=volume)
         await tts.save(output)

    现在,我们已经准备好使用Edge TTS来进行文本到语音的转换。

    步骤 3:创建TTS接口

    接下来,我们将创建一个接口,允许用户输入文本,并选择声音、速度等参数来生成语音。以下是创建TTS接口的代码:

    from fastapi import Form, File
    
    @app.post("/synthesize")
    async def synthesize(text: str = Form(...), voice: str = Form(...), rate: int = Form(...)):
        # 在这里处理TTS的逻辑
        # 构造文件名并生成音频文件
        # 返回包含下载链接的响应

    在这个接口中,我们接收用户输入的文本、声音和速度参数。然后,我们可以使用上一步中定义的tts函数来生成语音,将生成的音频文件保存到指定的目录,并返回包含下载链接的响应。

    步骤 4:下载生成的音频文件

    最后,我们创建一个接口,允许用户下载生成的音频文件。以下是下载接口的代码:

    from fastapi.responses import FileResponse
    import os
    
    @app.get("/download")
    async def download(filename: str):
        file_path = os.path.join("mp3", filename)
        return FileResponse(path=file_path, filename=filename, media_type="application/octet-stream")

    这个接口将根据用户提供的文件名在指定目录中查找音频文件,并返回给用户。

    运行应用

    现在,你已经创建了一个简单的TTS应用。你可以使用以下命令来运行应用:

    uvicorn main:app --host 0.0.0.0 --port 8000 --reload

    然后,你可以通过浏览器访问http://localhost:8000/来查看你的应用。

    结语

    通过使用FastAPI和Edge TTS,你可以轻松创建一个自定义的文本转语音应用。这个应用可以满足各种需求,包括在线教育、语音助手和自动化通知等。希望这个教程能够帮助你入门FastAPI和Edge TTS,并启发你创建更多有趣的应用。

    无论你是一名新手开发者还是经验丰富的工程师,这个教程都可以帮助你构建自己的TTS应用。开始创建吧,让你的创意变成现实!

  • 解锁Steam乐趣:Watt Toolkit游戏工具包全面指南

    解锁Steam乐趣:Watt Toolkit游戏工具包全面指南

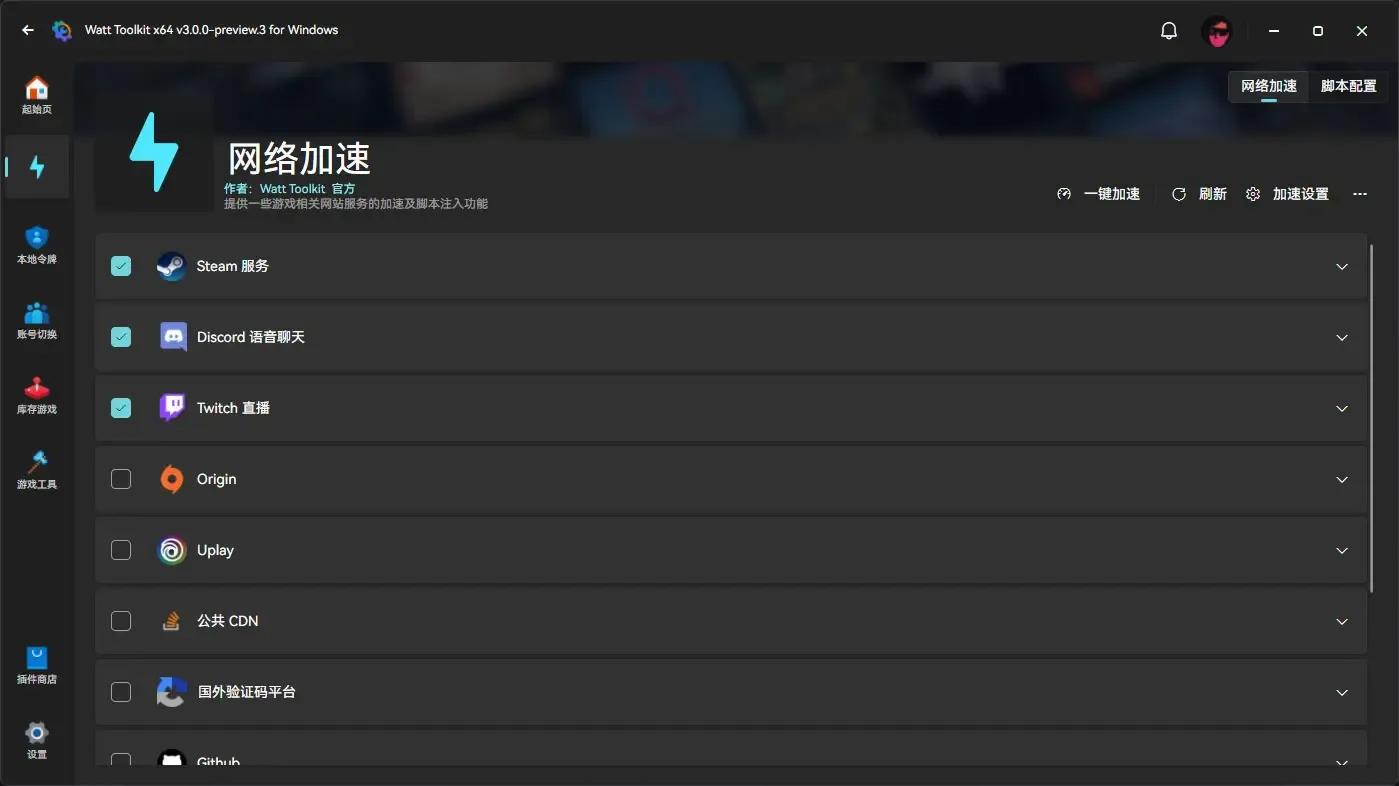
    在这个数字化时代,游戏已经成为人们生活中不可或缺的一部分。而Steam作为最大的数字游戏发行平台之一,提供了数千款游戏供玩家畅玩。但是,你是否曾经遇到过一些Steam上的烦人问题,例如管理多个账户、整理游戏库存或者强制使用无边框窗口模式?如果是的话,那么你绝对不能错过今天要介绍的神奇工具——Watt Toolkit ?!

    开篇故事

    在一个漫长而炎热的夏天,你终于决定将电脑上的游戏库整理一下。但是,当你尝试一一打开Steam账户时,发现这是一个相当费时费力的任务。每次都要输入用户名和密码,然后等待登录完成,实在是太烦人了。

    正当你准备放弃时,一个朋友告诉了你一个关于Watt Toolkit的秘密武器。你决定尝试一下,结果发现这个工具非常神奇!你不仅能够轻松切换已登录的Steam账户,还能够方便地管理你的游戏库存和成就。此外,你还可以使用它来强制游戏窗口使用无边框窗口模式,让你的游戏体验更加顺畅。

    这就是我们今天要讨论的Watt Toolkit,一个能够让你的Steam游戏体验更加便捷和愉快的开源工具。

    功能一览

    账户切换

    Watt Toolkit让切换Steam账户变得轻而易举。如果你已经在当前电脑上登录了多个Steam账户,只需点击一下,即可迅速切换到其他账户。此外,你还可以方便地管理你的共享游戏库,进行排序等操作。

    游戏库存管理

    不仅可以通过Watt Toolkit下载老旧的Steam游戏,还可以直接管理你的Steam游戏库存。它支持解锁的成就和未解锁的成就,让你更好地了解自己在游戏中的成就。

    本地身份验证

    Watt Toolkit还支持本地身份验证。你可以将手机令牌保存在电脑上,目前仅支持Steam令牌,但未来将开发更多令牌类型,并支持云同步令牌。

    ArchiSteamFarm集成

    Watt Toolkit与ArchiSteamFarm集成,提供了在应用内挂卡和掉卡的功能。这对于Steam卡片收藏者来说是一个非常有用的功能。

    游戏工具

    如果你希望游戏窗口使用无边框窗口模式,Watt Toolkit也可以满足你的需求。这将提高游戏的流畅性和用户体验。

    支持的操作系统

    Watt Toolkit跨平台支持,适用于多种操作系统,包括:

    • Windows 11
    • Windows 10 版本1809(内部版本17763)或更高版本
    • macOS 10.15或更高版本
    • Ubuntu 20.04或更高版本
    • Debian 11或更高版本
    • Fedora 37或更高版本
    • Deepin(UOS)20或更高版本
    • iOS 11或更高版本(正在开发中…)
    • Android 5.0(API 21)或更高版本

    无论你使用哪种操作系统,你都可以轻松地在Watt Toolkit中享受到所有这些强大的功能。

    下载途径

    如果你对Watt Toolkit产生了兴趣,你可以从以下途径下载它:

    无论你是Windows用户、macOS用户还是Linux用户,都可以根据自己的需要选择适合的下载途径。

    下载指南

    如果你需要下载和安装Watt Toolkit,可以参考以下步骤:

    1. 打开你选择的下载途径,例如Microsoft Store、官方网站或GitHub Releases。
    2. 在下载页面上,选择适用于你操作系统的版本,然后点击下载按钮。
    3. 下载完成后,运行安装程序,并按照提示完成安装过程。
    4. 安装完成后,启动Watt Toolkit。

    现在,你已经成功安装了Watt Toolkit,可以开始享受其强大的功能了!

    开发环境

    如果你是开发人员,可能会对Watt Toolkit的开发环境感兴趣。以下是Watt Toolkit的开发环境:

    • Visual

      Studio 2022

    • Visual Studio 2022 for Mac
    • JetBrains Rider
    • Visual Studio Code
    • OpenJDK 17
    • Android Studio Electric Eel或更高版本
    • Xcode 14或更高版本

    无论你是C#开发者、Java开发者还是移动应用开发者,你都可以使用适合自己的开发环境来贡献和定制Watt Toolkit。

    项目结构

    如果你想深入了解Watt Toolkit的项目结构,可以查看项目根目录下的src/README.md文件。这里提供了详细的项目结构信息,可以帮助你更好地理解项目的组织和架构。

    开源库

    Watt Toolkit是一个开源项目,它依赖于许多开源库来实现其功能。如果你想了解这些开源库的详细信息,可以查看项目根目录下的doc/open-source-library.md文件。这里列出了所有使用的开源库以及它们的作用。

    未来路线图

    Watt Toolkit的未来路线图充满了激动人心的计划。你可以在项目中查看详细的路线图,了解即将推出的功能和改进。如果你有任何问题或建议,都可以随时与开发团队交流。

    结语

    Watt Toolkit是一个强大的开源工具,旨在让Steam游戏体验更加便捷和愉快。它提供了许多有用的功能,包括账户切换、游戏库存管理、本地身份验证和游戏工具。无论你是普通玩家还是开发人员,都会发现Watt Toolkit是一个不可多得的工具。

    现在,你已经了解了Watt Toolkit的各种功能和特点,可以尝试下载并开始使用它,提升你的Steam游戏体验吧!

  • 探索Linux容器技术:从电子工具库到Barco项目

    探索Linux容器技术:从电子工具库到Barco项目

    你是否曾想过,计算机世界中的应用隔离是如何实现的?如何确保不同的应用程序在同一台计算机上能够安全运行而不相互干扰?Linux容器技术正是这一问题的答案。在这篇文章中,我们将深入探讨Linux容器,并介绍一个名为Barco的开源项目,它是作者用来学习Linux容器和Linux内核的一个实践项目。

    引言

    Linux容器是一种轻量级的虚拟化技术,允许你在同一台物理服务器上运行多个隔离的应用程序,每个应用程序都有自己的文件系统、网络、进程和资源隔离。容器技术的崛起已经改变了软件开发和部署的方式,使得应用程序更易于管理、部署和扩展。

    Barco是一个实验性项目,旨在帮助开发人员更好地理解Linux容器技术的内部工作原理。在本文中,我们将深入研究Linux容器的关键概念,以及如何使用Barco项目来创建和管理容器。

    Linux容器的关键概念

    要理解Linux容器,首先需要了解一些关键概念,这些概念构成了容器技术的基础。

    命名空间(Namespaces)

    命名空间是Linux内核的一个功能,它允许将系统资源分组到不同的命名空间中,以便不同的进程树可以访问不同的资源集。例如,PID命名空间用于隔离进程树,而网络命名空间用于隔离网络栈。

    seccomp

    seccomp是一种用于限制进程可以执行的系统调用(syscalls)的机制。通过限制允许的系统调用,可以增加容器的安全性。

    capabilities

    capabilities用于设置对root用户(uid 0)的操作权限限制。它允许你明确指定root用户可以执行哪些操作,从而提高了容器的安全性。

    cgroups

    cgroups(控制组)用于限制进程可以使用的资源,例如内存、磁盘I/O和CPU时间。它通过cgroupfs(控制组文件系统)来实现资源管理。

    使用Barco项目

    Barco项目是一个用于学习Linux容器技术的实验性工具,它可以帮助你创建和运行容器。以下是如何使用Barco来运行一个容器的简单示例:

    $ sudo ./bin/barco -u 0 -m / -c /bin/sh -a . [-v]

    上述命令会以root权限在根目录(/)下运行一个Shell容器。你可以使用-v选项来获得更详细的输出。

    Barco项目将会初始化容器的各种设置,包括命名空间、seccomp、capabilities和cgroups。一旦容器初始化完成,你就可以在容器内执行命令,就像在一个独立的操作系统环境中一样。

    开发与构建Barco项目

    要开始开发和构建Barco项目,你需要一些工具和依赖项。以下是设置和构建Barco项目的步骤:

    安装所需工具和依赖项

    首先,安装所有必要的工具和依赖项,包括make工具:

    $ sudo apt install -y make
    $ make setup

    构建项目

    使用提供的Makefile可以构建Barco项目。你可以选择使用debug=1来构建带有调试符号和无优化的项目,这对于调试和使用Valgrind检查内存泄漏非常有用:

    # 构建Barco项目
    
    $ make
    
    # 构建带有调试标志的Barco项目
    $ make debug=1

    开发工具

    Barco项目的开发可以使用Visual Studio Code和GitHub Codespaces进行。该仓库包含了所有必要的配置文件,以便你有效地使用这些工具。

    结构

    Barco项目的结构如下:

    ├── .devcontainer       GitHub Codespaces配置
    ├── .github             GitHub Actions和其他GitHub功能的配置
    ├── .vscode             Visual Studio Code配置
    ├── bin                 可执行文件(通过make创建)
    ├── build               中间构建文件,如*.o(通过make创建)
    ├── docs                文档
    ├── include             头文件
    ├── lib                 第三方库
    ├── scripts             设置和其他任务的脚本
    ├── src                 C源文件
    │   ├── barco.c         主CLI入口点
    │   └── *.c
    ├── tests               包含测试
    ├── .clang-format       格式化程序的配置
    ├── .clang-tidy         代码检查工具的配置
    ├── .gitignore
    ├── LICENSE
    ├── Makefile
    └── README.md

    测试与文档

    目前,该项目不包含自动化测试或文档工具。将来,可能会添加适合自动化测试和文档的工具。

    局限性

    Barco项目在运行Debian 12上的Linux内核版本6.1.0时进行了测试,启用了用户命名空间和cgroupsv2。

    Barco不处理网络命名空间,因此容器无法访问网络。网络可以通过以下方式粗略设置:

    1. 创建一个新的网络命名空间。
    2. 创建虚拟以太网对(veth pair)。
    3. 将其中一端移动到新的网络命名空间。
    4. 为新网络命名空间中的接口分配IP地址。
    5. 设置路由和NAT。

    结论

    通过Barco项目,你可以深入了解Linux容器技术的内部工作原理。这种轻量级虚拟化技术已经改变了软件开发和部署的方式,使得应用程序更容易管理和隔离。无论你是一名开发人员还是一个对容器技术感兴趣的爱好者,Barco项目都可以帮助你更好地理解这一领域的核心概念。

    希望本文对你理解Linux容器技术和Barco项目有所帮助。如果你对容器技术有更多的疑问或想要深入了解,请随时提出你的问题或探讨。

    通过这篇文章,你已经深入了解了Linux容器技术以及如何使用Barco项目来创建和管理容器。这一技术领域正在不断发展,为软件开发和部署提供了更多的灵活性和效率。如果你对这一主题有更多的兴趣,可以继续学习并探索更多相关的内容。祝你在容器技术的世界中取得成功!

  • 快速入门:ZeroNSD DNS服务器指南

    快速入门:ZeroNSD DNS服务器指南

    你是否曾经遇到DNS问题,而最后的答案总是”这一定是DNS问题”?ZeroNSD是专为ZeroTier用户设计的DNS服务器,它可以帮助你解决与ZeroTier网络相关的DNS查询问题。本文将引导你快速入门使用ZeroNSD,以便在ZeroTier网络上提供高效的DNS服务。

    简介

    ZeroNSD是一个专为ZeroTier用户设计的DNS服务器,它允许你为ZeroTier网络提供定制的DNS解析服务。通过ZeroNSD,你可以实现以下目标:

    • 为ZeroTier网络提供高性能的DNS解析服务。
    • 自定义DNS记录以满足你的需求。
    • 通过ZeroTier网络轻松访问DNS服务器。

    请注意,ZeroNSD目前仍处于Beta测试阶段,但它已经可以在你的ZeroTier网络上提供可靠的DNS解析服务。

    先决条件

    在开始使用ZeroNSD之前,请确保你已经满足以下先决条件:

    概念上的先决条件

    • 当ZeroTier加入一个网络时,它会创建一个虚拟网络接口。
    • 当ZeroTier加入多个网络时,将会存在多个网络接口。
    • 当ZeroNSD启动时,它会绑定到一个ZeroTier网络接口。
    • 当ZeroTier加入多个网络时,需要多个ZeroNSD实例,每个网络接口对应一个实例。

    这意味着:

    • ZeroNSD将从运行它的节点访问。
    • ZeroNSD将从ZeroTier网络上的其他节点访问。
    • ZeroNSD将与节点可能连接的其他网络隔离开来。

    技术上的先决条件

    本快速入门使用了两台机器 – 一个是在Digital Ocean上的Ubuntu虚拟机,另一个是在住宅ISP上的OSX笔记本电脑。为了一步一步跟随本文,你需要提供类似的基础设施。如果你使用不同的平台,你应该能够以最少的努力弄清楚应该怎么做。

    步骤

    创建一个ZeroTier网络

    首先,你需要手动通过ZeroTier Central WebUI创建一个ZeroTier网络。

    1. 登录ZeroTier Central WebUI。
    2. 创建一个新的网络。

    安装ZeroTier

    接下来,你需要安装ZeroTier并将其加入你打算提供DNS服务的网络中。以下是在大多数平台的CLI上执行的命令。Windows用户可以从ZeroTier下载页面下载MSI安装程序。在本文的其余部分,请将示例网络ID“af78bf94364e2035”替换为你自己的网络ID。

    在Ubuntu上执行以下命令:

    $ curl -s https://install.zerotier.com | sudo bash
    $ sudo zerotier-cli join af78bf94364e2035
    $ sudo zerotier-cli set af78bf94364e2035 allowDNS=1

    授权节点

    在ZeroTier Central WebUI的成员部分,通过点击“Auth”按钮,将节点授权加入网络。

    获取ZeroTier Central的API令牌

    在开始之前,我们需要登录到my.zerotier.com并在“帐户”部分创建一个API令牌。ZeroNSD将使用此令牌读取网络成员以生成记录,并更新DNS设置。

    执行以下命令将API令牌存储到文件中,以便ZeroNSD读取:

    $ sudo bash -c "echo YOUR_ZEROTIER_CENTRAL_TOKEN > /var/lib/zerotier-one/token"
    $ sudo chown zerotier-one:zerotier-one /var/lib/zerotier-one/token
    $ sudo chmod 600 /var/lib/zerotier-one/token

    安装ZeroTier Systemd Manager

    ZeroTier Systemd Manager发布了rpm和deb软件包,可以在这里下载。

    下载并安装ZeroTier Systemd Manager:

    $ wget https://github.com/zerotier/zerotier-systemd-manager/releases/download/v0.1.9/zerotier-systemd-manager_0.1.9_linux_amd64.deb
    $ sudo dpkg -i zerotier-systemd-manager_0.1.9_linux_amd64.deb

    最后,重新启动所有的ZeroTier服务:

    $ sudo systemctl daemon-reload
    $ sudo systemctl restart zerotier-one
    $ sudo systemctl enable zerotier-systemd-manager.timer
    $ sudo systemctl start zerotier-systemd-manager.timer

    安装ZeroNSD

    ZeroNSD应该只在网络中的一个节点上运行。由于DNS的延迟非常重要,请尽量将其放置在距离客户端最近的位置。

    使用软件包安装

    ZeroNSD发布了rpm、deb和msi软件包,可以在这里找到最新版本。以下是示例命令,注意要替换为最新版本:

    $ wget https://github.com/zerotier/zeronsd/releases/download/v0.1.7/zeronsd_0.1.7_amd64.deb
    $ sudo dpkg -i zeronsd_0.1.7_amd64.deb

    使用Cargo安装

    如果对于你的平台没有提供软件包,你仍然可以使用Cargo进行安装:

    $ sudo /usr/bin/apt-get -y install net-tools librust-openssl-dev pkg-config cargo
    $ sudo /usr/bin/cargo install zeronsd --root /usr/local

    提供DNS服务

    对于你希望提供DNS服务的每个网络,请执行以下操作(将“af78bf94364e2035”替换为你的网络ID):

    $ sudo zeronsd supervise -t /var/lib/zerotier-one/token -w -d YOUR_DOMAIN af78bf943
    
    64e2035
    $ sudo systemctl start zeronsd-af78bf94364e2035
    $ sudo systemctl enable zeronsd-af78bf94364e2035

    验证功能

    你应该能够通过DNS名称ping到笔记本电脑(或任何前置子域名,因为我们设置了通配符标志):

    $ ping laptop.YOUR_DOMAIN
    PING laptop.YOUR_DOMAIN (172.22.192.177) 56(84) bytes of data.
    64 bytes from 172.22.192.177 (172.22.192.177): icmp_seq=1 ttl=64 time=50.1 ms
    64 bytes from 172.22.192.177 (172.22.192.177): icmp_seq=2 ttl=64 time=49.5 ms
    64 bytes from 172.22.192.177 (172.22.192.177): icmp_seq=3 ttl=64 time=48.6 ms

    或者:

    $ ping travel.laptop.YOUR_DOMAIN
    PING travel.laptop.YOUR_DOMAIN (172.22.192.177) 56(84) bytes of data.
    64 bytes from 172.22.192.177 (172.22.192.177): icmp_seq=1 ttl=64 time=50.1 ms
    64 bytes from 172.22.192.177 (172.22.192.177): icmp_seq=2 ttl=64 time=49.5 ms
    64 bytes from 172.22.192.177 (172.22.192.177): icmp_seq=3 ttl=64 time=48.6 ms

    更新标志设置

    如果要更改设置(例如TLD),请执行以下操作(将“af78bf94364e2035”替换为你的网络ID):

    $ sudo zeronsd supervise -t /var/lib/zerotier-one/token -w -d YOUR_DOMAIN af78bf94364e2035
    $ sudo systemctl daemon-reload
    $ sudo systemctl enable zeronsd-af78bf94364e2035

    测试DNS查询

    要在没有zerotier-systemd-manager的情况下测试与ZeroNSD的DNS查询,请找到ZeroNSD绑定的IP地址,并使用dig命令明确对其进行查询。执行以下命令:

    $ sudo lsof -i -n | grep ^zeronsd | grep UDP | awk '{ print $9 }' | cut -f1 -d:
    172.22.245.70

    然后使用dig命令直接查询DNS服务器:

    对Ubuntu机器执行:

    $ dig +short @172.22.245.70 zt-3513e8b98d.YOUR_DOMAIN
    172.22.245.70
    $ dig +short @172.22.245.70 server.YOUR_DOMAIN
    172.22.245.70

    对OSX笔记本电脑执行:

    $ dig +short @172.22.245.70 zt-eff05def90.YOUR_DOMAIN
    172.22.245.70
    $ dig +short @172.22.245.70 laptop.YOUR_DOMAIN
    172.22.192.177

    添加到/etc/hosts并再次查询

    如果要添加自定义DNS记录,请执行以下操作:

    $ sudo bash -c 'echo "1.2.3.4 test" >> /etc/hosts'
    $ dig +short @172.22.245.70 test.YOUR_DOMAIN
    1.2.3.4

    验证通向公共DNS的查询

    为了验证失败的情况下,查询会落到公共DNS服务器,执行以下命令:

    $ dig +short @172.22.245.70 example.com
    93.184.216.34

    附加信息

    OSX上的DNS解析

    在OSX上,DNS解析使用dns-sd。遗憾的是,nslookup、host和dig在OSX上可能无法正常工作,但ping可以。

    $ ping server.YOUR_DOMAIN
    PING server.YOUR_DOMAIN (172.22.245.70): 56 data bytes
    64 bytes from 172.22.245.70: icmp_seq=0 ttl=64 time=37.361 ms
    64 bytes from 172.22.245.70: icmp_seq=1 ttl=64 time=38.129 ms
    64 bytes from 172.22.245.70: icmp_seq=2 ttl=64 time=37.569 ms

    要检查系统解析器设置,使用以下命令:scutil --dns。

    对于Ubuntu机器,可以执行以下查询:

    $ dns-sd -G v4 server.YOUR_DOMAIN
    $ dns-sd -G v4 zt-3513e8b98d.YOUR_DOMAIN

    对于OSX机器,可以执行以下查询:

    $ dns-sd -G v4 laptop.YOUR_DOMAIN
    $ dns-sd -G v4 zt-eff05def90.YOUR_DOMAIN

    Windows

    如果你是Windows用户,请尝试使用默认设置。如果有任何问题,请提供反馈或提交拉取请求以帮助改进ZeroNSD在Windows上的兼容性。

    提供非ZeroTier记录

    注意: 以下部分主要面向希望充分利用zeronsd的服务的高级用户。

    zeronsd还将在两种情况下提供非ZeroTier记录:

    1. 在TLD不匹配时,它将转发/etc/resolv.conf中的名称服务器。此行为类似于Linux上常用的DNS服务器dnsmasq。

    2. 为了提供自定义记录,你可以使用-f标志和一个hosts格式的文件,它将在提供的TLD下提供来自该文件的记录,与ZeroTier节点合并。以下是示例。

    注意: 如果按照上述步骤进行了操作,请在继续之前执行以下命令以停止ZeroNSD的服务和监督:

    $ systemctl stop zeronsd-<network id>
    $ zeronsd unsupervise <network id>

    创建一个名为hosts的文件,将以下内容放入其中:

    1.1.1.1 cloudflare-dns

    然后,我们将只使用zeronsd的start子命令启动一个临时服务器。这将在前台运行,因此请在新终端中运行或使用&运行。

    $ zeronsd start -t
    
     /var/lib/zerotier-one/token -f ./hosts -d YOUR_DOMAIN <network id>

    最后,我们可以查询cloudflare-dns.YOUR_DOMAIN以查找CloudFlare的DNS服务器,速度非常快!

    $ host cloudflare-dns.YOUR_DOMAIN 1.2.3.4
    cloudflare-dns.YOUR_DOMAIN has address 1.1.1.1

    结论

    使用ZeroNSD,你可以为你的ZeroTier网络提供高性能的DNS解析服务,并根据需要自定义DNS记录。这可以帮助你更好地管理你的网络,提高性能,减少DNS查询的延迟,并提供更好的用户体验。

    如果你是ZeroTier用户,ZeroNSD绝对值得一试。通过按照本指南的步骤进行操作,你可以轻松地将ZeroNSD集成到你的网络中,并提供可靠的DNS解析服务。

  • 黑盒交易:用Python进行数据分析和人工智能交易的秘诀

    黑盒交易:用Python进行数据分析和人工智能交易的秘诀

    走进黑盒交易的世界

    每天,全球金融市场都在进行着数以亿计的交易。这些交易由各种各样的参与者执行,包括机构投资者、个人交易员以及高频交易公司。但在这个快节奏、高度竞争的环境中,有一群特殊的交易者采用了一种独特的方式来执行交易,他们被称为“黑盒交易者”。

    黑盒交易,也被称为算法交易或自动化交易,是一种交易方式,其中交易决策是由计算机程序而不是人类交易员进行的。这些程序使用数据分析、大数据和人工智能技术来识别交易机会、制定买卖策略,并执行交易。与传统的人工交易相比,黑盒交易具有更高的速度和效率,可以在瞬间做出多个交易决策,从而获得更好的交易结果。

    黑盒交易的优势

    为什么越来越多的交易者转向黑盒交易呢?这是因为黑盒交易具有一些明显的优势,包括:

    1. 无情执行

    黑盒交易程序执行交易决策时没有情感干扰。它们只会根据预定的规则和算法执行操作,不受恐惧、贪婪或情绪的影响。这有助于消除了许多人为错误,提高了交易的一致性。

    2. 高速度

    黑盒交易系统可以在毫秒级别内执行交易,远远快于人类交易员。这使得高频交易成为可能,可以在极短的时间内进行大量交易。

    3. 数据分析

    黑盒交易程序可以分析大量的市场数据,并根据这些数据制定决策。这使得它们能够识别出微小的价格差异和趋势,从而找到交易机会。

    4. 自动化

    一旦设置好,黑盒交易系统可以自动执行交易,无需人工干预。这使得交易者可以在不间断地监控市场的情况下进行交易。

    如何入门黑盒交易?

    如果你对黑盒交易感兴趣,并希望探索这个领域,下面是一些入门步骤:

    步骤1:学习Python编程

    Python是数据科学和算法交易的首选编程语言。它易于学习,拥有丰富的数据分析库和机器学习工具。你可以从在线教程和课程中学习Python编程,或者阅读相关的书籍。

    步骤2:理解数据分析

    数据分析是黑盒交易的核心。你需要学习如何收集、清洗和分析金融数据。这包括学习如何使用Python库如Pandas和NumPy来处理数据,以及如何使用数据可视化工具如Matplotlib和Seaborn来呈现数据。

    步骤3:熟悉大数据技术

    在黑盒交易中,你可能会处理大量的金融数据。了解大数据技术如Hadoop和Spark可以帮助你更有效地处理和分析数据。

    步骤4:深入学习机器学习

    机器学习是人工智能交易的关键。你需要学习如何使用机器学习算法来构建预测模型,以便识别交易机会。有许多在线课程和教材可以帮助你入门机器学习。

    步骤5:选择合适的交易平台

    选择一个适合你的交易平台,它应该能够执行你的交易策略并提供必要的数据。一些常用的交易平台包括Interactive Brokers、MetaTrader和QuantConnect。

    使用Python进行黑盒交易的示例

    以下是一个简单的示例,展示如何使用Python进行黑盒交易。

    import pandas as pd
    from sklearn.model_selection import train_test_split
    from sklearn.ensemble import RandomForestClassifier
    from sklearn.metrics import accuracy_score
    import yfinance as yf
    
    # 收集金融数据
    data = yf.download('AAPL', start='2020-01-01', end='2021-01-01')
    
    # 创建特征和目标变量
    data['Price_Up'] = (data['Close'] - data['Close'].shift(1)) > 0
    X = data[['Open', 'High', 'Low', 'Volume']]
    y = data['Price_Up']
    
    # 划分训练集和测试集
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
    
    # 构建随机森林模型
    model = RandomForestClassifier()
    model.fit(X_train, y_train)
    
    # 预测价格上涨
    y_pred = model.predict(X_test)
    
    # 计算准确率
    accuracy = accuracy_score(y_test, y_pred)
    print(f'模型准确率:{accuracy}')

    在这个示例中,我们使用了Python库来下载苹果股票(AAPL)的历史数据,并构建了一个随机森林分类模型来预测股价是否上涨。这只是一个简单的示例,黑盒交易的实际应用要复杂得多,

    但它展示了你可以使用Python进行数据分析和人工智能交易的可能性。

    结语

    黑盒交易是一个激动人心的领域,它结合了数据分析、大数据和人工智能技术,可以帮助你在金融市场中取得更好的交易结果。虽然入门可能需要一些学习和练习,但一旦掌握了必要的技能,你将能够利用Python进行数据分析和人工智能交易,为你的投资策略增加一份强大的助力。

    无论你是一名初学者还是已经有一些经验的交易员,学习黑盒交易都值得一试。开始你的黑盒交易之旅吧,探索数据的奥秘,挖掘潜在的交易机会!

  • 评估自动文摘质量的终极指南

    评估自动文摘质量的终极指南

    你是否曾经尝试过创建自动文摘系统,但却不知道如何准确评估其质量?本文将为您提供关于如何评估抽象文摘质量的详细指南。我们将介绍传统的评估方法,如ROUGE和BERTScore,以及一种创新的方法,利用大型语言模型(LLM)作为评估器。

    1. 开篇故事

    在探讨自动文摘质量评估之前,让我们来看一个生动有趣的故事。假设你是一名AI研究员,正在开发一款自动文摘系统,这个系统可以将长篇文章精炼成简短的摘要。你花费了数月时间不断改进算法,优化性能,但你开始面临一个棘手的问题:如何准确地评估你的文摘质量?这个问题在自然语言处理领域一直备受关注,因为它涉及到了如何衡量文本的准确性、连贯性和相关性。

    在这个教程中,我们将为你揭示评估自动文摘质量的关键方法,让你的工作更具实际应用性和可衡量性。

    2. 引言

    自动文摘质量评估是一个耗时的过程,因为它涉及到不同的质量指标,如连贯性、简洁性、可读性和内容。传统的自动评估指标,如ROUGE和BERTScore等,虽然具体可靠,但可能与实际文摘质量的相关性不高。特别是对于开放性生成任务,它们与人类评价的相关性相对较低。因此,在评估文摘质量时,越来越需要依赖人类评估、用户反馈或基于模型的指标,同时需要警惕潜在的偏见。虽然人类判断提供了宝贵的见解,但通常不具备可扩展性,并且成本较高。

    除了传统的评估指标,我们还展示了一种使用大型语言模型(LLM)的方法(G-Eval),用作评估抽象性摘要的新型、无参考度量。在这种情况下,我们使用gpt-4来评分候选输出。gpt-4已经有效地学习了语言质量的内部模型,使其能够区分流畅、连贯的文本和低质量的文本。利用这种内部评分机制,可以自动评估LLM生成的新候选输出。

    3. 安装必要的软件包

    在进行评估之前,我们需要安装一些必要的软件包,以便进行评估。这些包包括ROUGE、BERTScore和OpenAI的API。

    !pip install rouge --quiet
    !pip install bert_score --quiet
    !pip install openai --quiet
    import openai
    import os
    import re
    import pandas as pd
    
    # 这里放置Python实现ROUGE指标的代码
    from rouge import Rouge
    
    # BERTScore利用BERT的上下文嵌入并通过余弦相似度匹配候选和参考句子中的单词。
    from bert_score import BERTScorer
    
    openai.api_key = os.environ.get("OPENAI_API_KEY")

    4. 示例任务

    为了本教程的目的,我们将使用以下示例文摘任务。请注意,我们提供了两个生成的摘要供比较,以及一个参考的人工撰写摘要,这是ROUGE和BERTScore等评估指标所需的。

    摘录 (excerpt):

    OpenAI的使命是确保人工通用智能(AGI)造福全人类。OpenAI将直接构建安全和有益的AGI,但如果其工作有助于其他人实现这一目标,它也将认为使命已达成。OpenAI遵循几个关键原则。首先,广泛分布的利益 – 对AGI部署的任何影响都将用于全人类的利益,以避免有害的使用或权力过度集中。其次,长期安全 – OpenAI致力于进行研究,使AGI安全,并促进这些研究在AI社区中的采纳。第三,技术领导 – OpenAI旨在处于AI能力的前沿。第四,合作导向 – OpenAI积极与其他研究和政策机构合作,并寻求创建一个共同工作的全球社区,共同解决AGI的全球挑战。

    摘要 (Summaries):

    • 参考摘要 /ref_summary(人工生成):
      OpenAI的目标是确保人工通用智能(AGI)造福所有人,避免有害用途或权力过度集中。它致力于研究AGI的安全性,并在AI社区中促进这些研究。OpenAI旨在领导AI能力的发展,与全球研究和政策机构合作,解决AGI的挑战。

    • 评估摘要1 / eval_summary_1(系统生成):
      OpenAI旨在使AGI造福全人类,避免有

    害用途和权力集中。它引领安全和有益的AGI研究,并在全球促进采用。OpenAI在AI领域保持技术领导地位,与全球机构合作,解决AGI的挑战。它力求领导一个协作的全球努力,为集体利益开发AGI。

    • 评估摘要2 / eval_summary_2(系统生成):
      OpenAI旨在确保AGI供所有人使用,完全避免有害内容或权力过度集中。致力于研究AGI的安全性,并在AI社区中促进这些研究。OpenAI希望在AI领域处于领先地位,并与全球研究和政策团体合作,探讨AGI的相关问题。

    5. 使用ROUGE进行评估

    ROUGE是Recall-Oriented Understudy for Gisting Evaluation的缩写,主要用于衡量生成的输出与参考文本之间的词语重叠。这是评估自动文摘任务的一种流行指标。在其各种变体中,ROUGE-L提供了系统生成和参考摘要之间最长连续匹配的信息,衡量系统保留原始摘要要点的程度。

    # 计算ROUGE分数的函数
    def get_rouge_scores(text1, text2):
        rouge = Rouge()
        return rouge.get_scores(text1, text2)
    
    # 计算两个摘要与参考摘要之间的ROUGE分数
    eval_1_rouge = get_rouge_scores(eval_summary_1, ref_summary)
    eval_2_rouge = get_rouge_scores(eval_summary_2, ref_summary)
    
    rouge_scores_out = []
    
    for metric in ["rouge-1", "rouge-2", "rouge-l"]:
        for label in ["F-Score"]:
            eval_1_score = eval_1_rouge[0][metric][label[0].lower()]
            eval_2_score = eval_2_rouge[0][metric][label[0].lower()]
    
            row = {
                "Metric": f"{metric} ({label})",
                "Summary 1": eval_1_score,
                "Summary 2": eval_2_score,
            }
            rouge_scores_out.append(row)
    
    # 展示ROUGE分数
    rouge_scores_out_df = (
        pd.DataFrame(rouge_scores_out)
        .set_index("Metric")
    )
    
    rouge_scores_out_df

    上述代码计算了两个不同摘要与参考文本之间的ROUGE分数。在rouge-1方面,摘要2优于摘要1,表示单词重叠较多。而在rouge-l方面,摘要2得分较高,意味着最长公共子序列匹配较好,因此可能更好地捕捉了原始文本的主要内容和顺序。由于摘要2直接提取了摘录中的许多词汇和短语,因此与参考摘要的重叠可能较高,从而导致较高的ROUGE分数。

    然而,需要注意的是,尽管ROUGE和类似的指标(如BLEU和METEOR)提供了定量的度量,但它们通常无法捕捉良好生成摘要的真正本质。它们与人类评分的相关性也较差。鉴于LLM的进展,它们擅长生成流畅和连贯的摘要,传统的指标如ROUGE可能会误判这些模型,特别是如果摘要的表达方式不同但仍然准确地包括核心信息。

    6. 使用BERTScore进行评估

    ROUGE依赖于候选文本和参考文本中单词的精确匹配,无法解释底层语义。这就是BERTScore的作用,它利用BERT模型的上下文嵌入,旨在评估在机器生成的文本背景下,预测文本和参考句子之间的相似性。通过比较两者的嵌入,BERTScore捕获了传统n-gram指标可能忽略的语义相似性。

    # 实例化英语语言的BERTScorer对象
    scorer = BERTScorer(lang="en")
    
    # 计算摘要1与摘录的BERTScore
    P1, R1, F1_1 = scorer.score([eval_summary_1], [ref_summary])
    
    # 计算摘要2与摘录的BERTScore
    P2, R2, F2_2 = scorer.score([eval_summary_2], [ref_summary])
    
    print("摘要1 F1分数:", F1_1.tolist()[0])
    print("摘要2 F1分数:", F2_2.tolist()[0])

    上述代码计算了两个摘要与摘录之间的BERTScore分数。F1分数接近表明它们在捕获关键信息方面表现相似。然而,这种小差异应谨慎解释。由于BERTScore可能无法完全理解人类评估员可能理解的微妙和高级概念,仅依赖于这一指标可能会导致对摘要的实际质量和细微差别进行错误解读。将BERTScore与人工评估和其他指标结合使用可以提供更可靠的评估。

    7. 使用GPT-4进行评估

    在这里,我们实现了一个使用gpt-4的示例无参考文本评估器,受到G-Eval框架的启发,该框架使用大型语言模型评估生成文本的质量。与ROUGE或BERTScore等依赖于与

    参考摘要的比较的指标不同,基于gpt-4的评估器仅基于输入提示和文本评估生成内容的质量,而无需任何基准参考。这使其适用于新数据集和任务,其中人类参考文献稀缺或不可用。

    以下是此方法的概述:

    • 我们定义了四个不同的标准:

      • 相关性:评估摘要是否仅包含重要信息并排除多余信息。
      • 连贯性:评估摘要的逻辑流程和组织结构。
      • 一致性:检查摘要是否与源文档中的事实一致。
      • 流畅性:评估摘要的语法、拼写、标点、词汇选择和句子结构。
    • 我们为每个标准创建提示,以原始文档和摘要作为输入,并利用思维链生成和引导模型以输出每个标准的1-5之间的数值评分。

    • 我们使用定义的提示从gpt-4生成分数,然后比较它们在不同摘要之间。

    # 评估提示模板基于G-Eval
    EVALUATION_PROMPT_TEMPLATE = """
    您将获得一份为一篇文章写的摘要。您的任务是根据一个度量标准对摘要进行评分。
    请确保您非常仔细地阅读和理解这些说明。
    请在审阅时保持这个文档打开,并根据需要参考它。
    
    评估标准:
    
    {criteria}
    
    评估步骤:
    
    {steps}
    
    示例:
    
    源文本:
    
    {document}
    
    摘要:
    
    {summary}
    
    评估表单(仅分数):
    
    - {metric_name}
    """
    
    # 标准1:相关性
    RELEVANCY_SCORE_CRITERIA = """
    相关性(1-5) - 从源文本中选择重要内容。 \
    摘要应仅包含源文档中的重要信息。 \
    评估员被要求惩罚包含冗余和多余信息的摘要。
    """
    
    RELEVANCY_SCORE_STEPS = """
    1. 仔细阅读摘要和源文档。
    2. 比较摘要与源文档,并确定文章的主要要点。
    3. 评估摘要多好地涵盖了文章的主要要点,以及它包含了多少无关或多余的信息。
    4. 指定一个从1到5的相关性评分。
    """
    
    # 标准2:连贯性
    COHERENCE_SCORE_CRITERIA = """
    连贯性(1-5) - 所有句子的综合质量。 \
    我们将此维度与DUC质量问题中的结构和连贯性一致,即“摘要应该具有良好的结构和组织。 \
    摘要不应仅仅是一堆相关信息,而应该从句子到一\
    个关于一个主题的连贯信息体中逐渐构建起来。”
    """
    
    COHERENCE_SCORE_STEPS = """
    1. 仔细阅读文章,确定主要主题和要点。
    2. 仔细阅读摘要,并将其与文章进行比较。检查摘要是否涵盖了文章的主要主题和要点,
       并且是否以清晰且逻辑的顺序呈现它们。
    3. 根据评估标准,为连贯性评分,评分范围从1到5,其中1是最低的,5是最高的。
    """
    
    # 标准3:一致性
    CONSISTENCY_SCORE_CRITERIA = """
    一致性(1-5) - 摘要与被总结源文之间的事实一致性。 \
    一个事实一致的摘要仅包含源文档支持的陈述。 \
    评估员还被要求惩罚包含虚构事实的摘要。
    """
    
    CONSISTENCY_SCORE_STEPS = """
    1. 仔细阅读文章,确定它呈现的主要事实和细节。
    2. 仔细阅读摘要,并将其与文章进行比较。检查摘要是否包含文章不支持的任何事实错误。
    3. 根据评估标准,为一致性评分。
    """
    
    # 标准4:流畅性
    FLUENCY_SCORE_CRITERIA = """
    流畅性(1-3): 摘要的质量,涉及语法、拼写、标点、词汇选择和句子结构。
    1: 差。摘要有许多错误,使其难以理解或听起来不自然。
    2: 一般。摘要有一些错误,影响了文本的清晰度或流畅性,但主要要点仍然可以理解。
    3: 良好。摘要几乎没有错误,阅读和理解起来很容易。
    """
    
    FLUENCY_SCORE_STEPS = """
    阅读摘要并根据给定的标准评估其流畅性。指定一个从1到3的流畅性评分。
    """
    
    # 为不同标准准备数据
    evaluation_metrics = {
        "相关性": (RELEVANCY_SCORE_CRITERIA, RELEVANCY_SCORE_STEPS),
        "连贯性": (COHERENCE_SCORE_CRITERIA, COHERENCE_SCORE_STEPS),
        "一致性": (CONSISTENCY_SCORE_CRITERIA, CONSISTENCY_SCORE_STEPS),
        "流畅性": (FLUENCY_SCORE_CRITERIA, FLUENCY_SCORE_STEPS),
    }
    
    summaries = {"摘要1": eval_summary_1, "摘要2": eval_summary_2}
    
    data = {"评估
    
    标准": [], "摘要": [], "评分": []}
    
    for metric, (criteria, steps) in evaluation_metrics.items():
        for summary_name, summary_text in summaries.items():
            prompt = EVALUATION_PROMPT_TEMPLATE.format(
                criteria=criteria, steps=steps, document=excerpt, summary=summary_text, metric_name=metric
            )
            response = openai.Completion.create(
                engine="text-davinci-003", prompt=prompt, max_tokens=100
            )
            rating = int(re.search(r"\d", response.choices[0].text).group())
            data["评估标准"].append(metric)
            data["摘要"].append(summary_name)
            data["评分"].append(rating)
    
    # 将数据转换为DataFrame以进行比较
    evaluation_df = pd.DataFrame(data)
    
    # 输出评估结果
    evaluation_df

    上述代码使用gpt-4基于定义的四个标准为两个摘要生成了1-5之间的分数。这些标准包括相关性、连贯性、一致性和流畅性。根据每个标准的提示,gpt-4生成了评分,然后将这些评分与不同摘要进行比较。根据评估结果,您可以看到每个摘要在不同标准下的表现如何。

    8. 总结

    自动文摘质量评估是一个复杂的任务,涉及多个方面,包括文本的相关性、连贯性、一致性和流畅性。传统的评估指标如ROUGE和BERTScore提供了一种方式来量化自动生成的文本与参考文本之间的相似性,但它们不能全面捕捉文本质量的各个方面。因此,将它们与基于大型语言模型的评估器结合使用可能会更全面地评估文本质量。

    在这个教程中,我们展示了如何使用ROUGE、BERTScore和基于gpt-4的评估器来评估自动生成的文本的质量。请记住,这些指标和方法只是评估文本质量的一部分,最终的评估可能需要人工评估和用户反馈来全面评估文本生成系统的性能。希望这个指南能帮助您更好地了解如何评估自动文摘质量,从而改进和优化您的自动生成文本的系统。