Tag: 教程

  • Stable Diffusion WebUI最近更新了什么?

    Stable Diffusion WebUI最近更新了什么?

    随着科技的不断发展,人工智能领域的创新也愈发迅猛。其中,生成对抗网络(GANs)技术一直备受瞩目,因其可以生成栩栩如生的图像、音频和视频,而广受欢迎。在这个领域中,Stable Diffusion模型一直以来都备受推崇,它能够生成高质量、令人惊叹的创作内容。

    然而,虽然Stable Diffusion模型强大,但它的使用一直相对复杂,需要一定的技术知识。这就是为什么AUTOMATIC1111开发了Stable Diffusion WebUI,一个方便用户使用Stable Diffusion模型生成图片的网页界面。这个工具的不断更新和改进,让用户能够更轻松、更快速、更高效地释放他们的创造力。在本文中,我们将介绍Stable Diffusion WebUI最近的一些更新,以及如何获取最新版本。

    Stable Diffusion WebUI 2.1版本的新特性

    Stable Diffusion WebUI 2.1版本于2022年12月7日发布,带来了一系列令人激动的新特性和改进,让用户的创作过程更加丰富多彩、富有创意[1]。

    1. 超分辨率处理

    Stable Diffusion WebUI 2.1现在支持使用GFPGAN模型对生成的图片进行超分辨率处理。这意味着你可以将模糊的图像转化为更清晰、更高质量的版本。这对于那些追求完美的创作者来说是一个巨大的福音,让他们的作品更加引人注目。

    2. 后期编辑

    借助DreamStudio模块,你现在可以对生成的图片进行后期编辑。你可以调整图片的风格、颜色、亮度等参数,从而创造出与众不同的艺术品。这个功能使你能够更好地表达你的创意,实现你的艺术愿景。

    3. 文本描述和灵感

    通过Prompt Database模块,你可以搜索和使用其他用户分享的文本描述,获取更多的灵感和创意。这个功能可以帮助你突破创作的瓶颈,为你的项目带来新的灵感。

    4. 动态人脸动画

    Webcam模块允许你实时捕捉用户的面部表情,并将其应用到生成的图片上,实现动态的人脸动画。这为创作者提供了一个有趣的工具,可以制作生动的人物形象和动画。

    5. 音频驱动的视频生成

    通过Audio模块,你可以录制或上传音频文件,并将其与生成的图片同步,实现音频驱动的视频生成。这让创作者能够在音乐和视觉之间创造出令人印象深刻的联动作品。

    6. 个性化设置

    通过Settings模块,你可以轻松调整WebUI的一些选项,例如语言、主题、分辨率等,以满足你的具体需求和喜好。

    7. 错误修复

    Stable Diffusion WebUI 2.1版本还修复了一些已知的错误和漏洞,提高了稳定性和用户体验。

    如何获取Stable Diffusion WebUI最新版本

    如果你已经被这些新特性和改进所吸引,想要获取Stable Diffusion WebUI最新版本,你有两种方式可供选择。

    自动更新(推荐)

    自动更新是最方便的方式。你只需要在你的WebUI文件夹中找到“webui-user.bat”文件,并右键点击选择编辑(使用记事本)。在文件中,找到以下代码:

    set COMMANDLINE_ARGS= --medvram --autolaunch
    call webui.bat

    在这两行代码之间添加一行“git pull”,使其看起来像这样:

    set COMMANDLINE_ARGS= --medvram --autolaunch
    git pull
    call webui.bat

    保存文件。现在,每次你启动“webui-user.bat”文件时,它会自动检查并下载最新版本(如果你已经是最新版本,它不会做任何事情)。

    手动更新

    如果你不想要获取每一个更新,你可以选择手动更新。只需在命令行窗口中进入WebUI文件夹,并输入以下命令:

    git pull

    这将从GitHub上获取最新版本并更新你的WebUI。

    结语

    Stable Diffusion WebUI 2.1版本的更新使其成为了一个更加强大和多功能的工具,让用户能够更轻松地释放他们的创造力。无论你是艺术家、设计师、动画师还是任何其他创作者,Stable Diffusion WebUI都可以帮助你实现你的创意愿景。通过不断的更新和改进,它将继续为用户带来更多的功能和体验。如果你还没有尝试过Stable Diffusion WebUI,现在是时候下载并安装它了,开启你的创作之旅吧!
  • 打造AI虚拟数字人,Stable Diffusion+Sadtalker教程

    打造AI虚拟数字人,Stable Diffusion+Sadtalker教程

    Stable Diffusion是一个能够根据文本描述生成高质量图片的深度学习模型,它使用了一种叫做潜在扩散模型的生成网络架构,可以在普通的GPU上运行。Sadtalker是一个能够根据图片和音频生成视频的开源项目,它使用了一种叫做SadNet的神经网络,可以实现风格化的单图说话人脸动画。本教程将介绍如何使用Stable Diffusion和Sadtalker结合起来,实现从文本到视频的生成。

    准备工作

    要完成本教程,你需要准备以下内容:

    • 一台安装了Windows系统的电脑,最好有一块至少8GB显存的NVIDIA或AMD显卡
    • Stable Diffusion的代码和模型文件,可以从这里下载:https://github.com/Stability-AI/stablediffusion
    • Sadtalker的代码和模型文件,可以从这里下载:https://github.com/Winfredy/SadTalker
    • 一个文本编辑器,例如Notepad++或Visual Studio Code
    • 一个音频编辑器,例如Audacity或Adobe Audition
    • 一个视频播放器,例如VLC或Windows Media Player

    步骤一:生成图片

    首先,我们需要使用Stable Diffusion根据我们想要的文本描述生成一张图片。我们可以使用Stable Diffusion Online网站来快速实现这个功能,也可以在本地运行Stable Diffusion的代码。

    使用Stable Diffusion Online网站

    • 打开浏览器,访问https://stablediffusionweb.com/
    • 在输入框中输入你想要生成图片的文本描述,例如“一个穿着红色连衣裙的女孩在草地上跳舞”
    • 点击Generate按钮,等待几秒钟,就可以看到生成的图片
    • 点击Download按钮,将图片保存到你的电脑上

    在本地运行Stable Diffusion的代码

    • 打开命令行窗口,进入Stable Diffusion的代码目录
    • 输入以下命令,安装所需的依赖包:
    pip install -r requirements.txt
    
    • 输入以下命令,下载预训练的模型文件:
    python download_model.py
    
    • 输入以下命令,根据你想要生成图片的文本描述生成一张图片,并保存到output文件夹中:
    python generate.py --prompt "一个穿着红色连衣裙的女孩在草地上跳舞" --output output/girl.jpg
    

    步骤二:录制音频(续)

    使用Adobe Audition录制音频(续)

    • 点击菜单栏中的文件-新建-音频文件
    • 在弹出的对话框中输入文件名,例如girl,选择采样率为44100 Hz,通道为单声道,格式为MP3
    • 点击确定按钮,创建一个新的音频文件
    • 点击红色的录音按钮,开始录制你想要说的话,例如“你好,我是一个爱跳舞的女孩”
    • 点击空格键,结束录制
    • 点击菜单栏中的文件-保存
    • 在弹出的对话框中选择保存位置,例如output文件夹

    步骤三:生成视频

    最后,我们需要使用Sadtalker将我们生成的图片和音频合成为一个视频。我们可以在本地运行Sadtalker的代码来实现这个功能。

    在本地运行Sadtalker的代码

    • 打开命令行窗口,进入Sadtalker的代码目录
    • 输入以下命令,安装所需的依赖包:
    pip install -r requirements.txt
    
    • 输入以下命令,下载预训练的模型文件:
    python download_model.py
    
    • 输入以下命令,根据我们生成的图片和音频生成一个视频,并保存到output文件夹中:
    python generate.py --image output/girl.jpg --audio output/girl.mp3 --output output/girl.mp4
    

    结语

    恭喜你,你已经完成了使用Stable Diffusion和Sadtalker结合起来,实现从文本到视频的生成的教程。你可以在output文件夹中找到你生成的视频,并用任何视频播放器观看它。你也可以尝试用不同的文本描述和音频来生成不同的视频。希望你能享受这个有趣的创作过程,并发挥你的想象力和创造力。

  • 如何为青海旅游行业做好SEO/SEM优化?揭秘网络营销的高级技巧!

    如何为青海旅游行业做好SEO/SEM优化?揭秘网络营销的高级技巧!

    青海,这片美丽的土地,拥有壮丽的自然风光和丰富的文化底蕴,一直以来都吸引着众多游客前来探访。对于青海的旅游行业来说,如何在激烈的市场竞争中脱颖而出,吸引更多的游客成为一项重要的挑战。在互联网时代,SEO(搜索引擎优化)和SEM(搜索引擎营销)成为了提升品牌知名度、获取流量和提高客户忠诚度的关键工具。本教程将为青海旅游行业提供一些高级的SEO/SEM优化技巧,帮助企业和从业者在数字时代获得更大的成功。

    引言

    故事开始于一家位于青海湖畔的小旅行社,他们一直以来都在努力提供独特的旅游体验,但在互联网时代,他们发现自己的业务并没有像他们希望的那样繁荣。竞争激烈,市场份额有限,他们迫切需要一种方法来提高在线曝光度,吸引更多的游客。这时,一位朋友向他们介绍了SEO和SEM的概念,他们开始了解并实施这些技巧,最终,他们的业务发生了翻天覆地的变化。

    SEO/SEM优化的定义和区别

    SEO和SEM是两种不同但相关的数字营销技巧,它们旨在提高网站在搜索引擎中的可见性和排名。以下是它们的定义和区别:

    SEO(Search Engine Optimization):SEO是通过优化网站内容、结构、链接和其他因素,以提高网站在搜索引擎中自然排名的技术。它不涉及直接的付费,而是通过符合搜索引擎算法和规则来获得更高的排名。

    SEM(Search Engine Marketing):SEM是通过支付广告费用,购买关键词或广告位置,以在搜索引擎中获得更好的曝光度和排名的技术。SEM涉及直接的付费,并且可以在较短时间内产生效果。

    青海旅游行业SEO/SEM优化的高级技巧

    1. 选择合适的关键词

    • 选择关键词是SEO/SEM优化的第一步。在青海旅游行业中,关键词应该涵盖景点、活动、季节等多个方面,例如“青海湖旅游”、“青海旅游攻略”、“青海旅游路线”等。使用关键词研究工具来确定具有高搜索量但低竞争度的关键词。

    2. 优化网站内容和结构

    • 创建高质量的内容,包括旅游指南、景点介绍、旅行日记等,确保内容相关且有吸引力。优化网站结构,使用清晰的导航菜单和内部链接,以提高用户体验。

    3. 优化网站代码和链接

    • 确保网站代码干净简洁,避免冗余和错误。使用友好的URL和元标签,确保每个页面都能被搜索引擎正确解读。建立高质量的外部链接,提高网站的权重和可信度。

    4. 制作优质的落地页

    • 为SEM广告制作精美的落地页,确保页面内容与广告相关,提供清晰的行动呼应(如预订、咨询),并使用强有力的文字和图片吸引用户的注意。

    5. 定期分析和优化

    • 使用分析工具跟踪网站和广告的性能,了解用户行为和转化率。根据数据做出优化决策,调整关键词、广告内容和落地页,以提高ROI。

    结语

    在青海旅游行业,SEO和SEM是提高在线曝光度和吸引游客的关键工具。通过选择合适的关键词,优化网站内容和结构,精心制作落地页,以及不断分析和优化,青海的旅游企业和从业者可以在数字时代蓬勃发展,为更多游客提供独特而难忘的旅游体验。

    希望这篇教程对你有所帮助,让你在青海旅游行业的数字营销中取得更大的成功。

  • 爱快多条线路都有IPV6时怎么开启多条线路IPV6

    爱快多条线路都有IPV6时怎么开启多条线路IPV6

    随着互联网的不断发展,IPv4地址空间逐渐枯竭,这意味着我们需要采用新的技术来满足不断增长的设备连接需求。IPv6作为下一代互联网协议,为我们提供了更大的地址空间、更高的安全性和更好的性能。如果你的宽带运营商和路由器都支持IPv6,那么你可以充分利用IPv6的优势,例如免费获取公网IP、远程访问内网设备、观看高清IPTV直播等。

    对于那些使用爱快软路由的用户,开启多条线路的IPv6功能变得相对简单。本教程将向你详细介绍如何在爱快软路由上进行IPv6配置,实现宽带叠加和分流,以便更好地利用IPv6技术。

    操作步骤

    步骤一:登录路由器管理界面

    1. 首先,打开浏览器,输入爱快软路由的管理界面地址,通常是 http://192.168.1.1,然后按下回车键。

    2. 输入管理员用户名和密码,登录到路由器的管理界面。

    步骤二:配置WAN接口

    1. 在路由器管理界面中,点击“网络”-“接口”,找到你要开启IPv6的线路接口,比如WAN1、WAN2等。点击“编辑”。

    2. 在“通用设置”中,选择“DHCP客户端”作为协议,然后勾选“使用广播标志”和“使用内置的IPv6管理”。

    3. 在“高级设置”中,勾选“请求IPv6地址”和“请求IPv6前缀”,并根据你的运营商要求填写“请求IPv6前缀长度”,一般为64。

    4. 在“防火墙设置”中,选择“wan”作为防火墙区域。

    5. 点击“保存并应用”,重复以上步骤为其他线路接口开启IPv6功能。

    步骤三:配置LAN接口

    1. 继续在路由器管理界面中,点击“网络”-“DHCP/DNS”,在“DHCP服务器”中找到LAN接口,并点击“编辑”。

    2. 在“高级设置”中,勾选“为此网络启用IPv6模式”,然后选择“混合模式”作为RA-服务和DHCPv6-服务。

    3. 点击“保存并应用”,这样就完成了LAN接口的IPv6设置。

    步骤四:重启路由器

    1. 最后,重启爱快软路由,等待几分钟后,你就可以在接口状态中看到每条线路都获取了一个IPv6地址和一个IPv6前缀。

    2. 你也可以在你的电脑或手机上查看是否获取了一个IPv6地址,如果是的话,说明你已经成功开启了多条线路的IPv6功能。

    注意事项

    请注意以下几点:

    • IPv6需要在ISP和路由器之间进行协议的交互,如果其中一方不支持IPv6,则无法使用IPv6。因此在开启IPv6之前,请确保你的ISP和路由器都支持IPv6。

    • 如果你不确定运营商提供的IPv6配置信息,请咨询他们的技术支持,以确保正确设置。

    • 请谨慎配置路由器,避免对网络产生不必要的影响。

    结语

    通过本教程,你可以轻松地在爱快软路由上开启多条线路的IPv6功能,充分利用IPv6的优势,提升网络性能和安全性。在互联网不断发展的今天,掌握IPv6配置技能将为你的网络体验带来明显的改善。希望这篇教程对你有所帮助!

  • M1芯片的Macbook Pro在深度学习方面表现如何?

    M1芯片的Macbook Pro在深度学习方面表现如何?

    当今,深度学习需要强大的计算机硬件支持。M1芯片的Macbook Pro是一款备受关注的设备,但是它是否足够用于深度学习训练呢?本文将对这一问题进行探讨,以及回答其他相关问题,帮助你了解M1芯片的Macbook Pro在深度学习方面的性能和限制。

    M1芯片的Macbook Pro在深度学习方面的表现

    M1芯片的Macbook Pro使用的是ARM架构,而NVIDIA显卡使用的是CUDA架构,因此它们的性能无法直接进行比较。然而,根据一些报道,使用M1芯片的Macbook Pro进行深度学习训练,与使用NVIDIA GTX 1060 6GB的显卡相当。但是,使用NVIDIA RTX 2060 Super或更高端的显卡会更快。因此,如果你需要进行更加复杂的深度学习任务,M1芯片的Macbook Pro可能并不足够强大。

    M1芯片的Macbook Pro在训练效果和硬盘的使用方面

    对于训练模型的速度和效率,内存越大越有帮助。但是,对于硬盘的伤害并不会有太大的影响。只要你不进行过度的、频繁的训练,硬盘不应该因为16G内存的使用而受到伤害。

    M1芯片的Macbook Pro和台式机之间的训练成果转移

    如果你将训练结果保存在外部存储器中(例如硬盘或云存储),那么你可以轻松地将这些结果从M1芯片的Macbook Pro传输到台式机中。但是,如果你的训练结果存储在M1芯片中,那么它们可能无法直接转移到台式机上,因为台式机使用的是不同的架构和操作系统。

    结论

    如果你只是为了学习深度学习或者进行轻度的训练,那么M1芯片的Macbook Pro可能是一个不错的选择。但如果你需要进行更加复杂的任务,那么你可能需要更强大的硬件。无论你使用什么硬件,保持谨慎并确保你的计算机硬件和软件都能满足你的需求是非常重要的。

    • M1芯片的Macbook Pro与NVIDIA GTX 1060 6GB的显卡性能相当
    • 对于训练模型的速度和效率,内存越大越有帮助
    • 如果训练结果存储在M1芯片中,转移到台式机上可能会有问题
  • OpenAI 服务器访问速度分析

    OpenAI 服务器访问速度分析

    故事发生在一个寒冷的冬日,王大神是一位充满好奇心的程序员,他对人工智能领域充满了热情。最近,他开始使用OpenAI的服务,但却发现访问速度有时不尽人意。他决定深入研究,看看是否有办法优化访问速度,让他的人工智能项目更加顺畅。

    网络架构的奥秘

    王大神首先了解到网络架构对访问速度有着重要的影响。OpenAI采用了CloudFlare的网络架构,这个网络架构的独特之处在于它的IP是AnyCast的,也就是说,同一个IP可以实现不同的路由。这意味着当用户访问OpenAI时,可以更快地获取缓存的页面,因为CloudFlare会将请求路由到最近的缓存服务器上。

    服务器位置的智慧选择

    王大神接着了解到服务器的位置和数据中心的选择也会直接影响访问速度。举个例子,如果用户的服务器位于韩国首尔,那么它可能会直接连接到CloudFlare在首尔的机器,然后CloudFlare会返回缓存的页面,因此访问速度会更快。而在美国,由于地域广阔,如果服务器位于洛杉矶但用户位于圣何塞,访问速度就会相对较慢。此外,美国作为一个互联网企业发达的国家,也会占用大量带宽,可能影响其他传输效果。

    选择合适的VPS服务商和服务器配置

    不同的VPS服务商和服务器配置也会对访问速度产生影响。在这个讨论中,王大神的服务器都是阿里云的机器,但是不同的服务商可能对网络架构的支持不同,也可能服务器配置不同,从而影响访问速度。因此,如果你希望优化访问速度,可以考虑选择地理位置更近、网络架构更优、数据中心更多的服务器,或者选择更稳定的VPS服务商和服务器配置。

    如何优化OpenAI服务器访问速度

    现在,让我们来总结一下如何优化OpenAI服务器的访问速度吧:

    步骤一:选择合适的服务器位置

    首先,你需要选择一个距离你地理位置更近的服务器,这可以大大缩短数据传输的时间,提高访问速度。如果你在亚洲,考虑选择位于亚洲的服务器,如果在美洲,选择美洲的服务器,以此类推。

    步骤二:了解网络架构

    深入了解OpenAI的网络架构,特别是CloudFlare的IP AnyCast技术。这可以帮助你理解如何利用这个架构来优化访问速度,因为它可以将请求路由到最近的缓存服务器上,减少延迟。

    步骤三:选择适当的VPS服务商和服务器配置

    如果你使用VPS来访问OpenAI,确保选择一个稳定的VPS服务商,并配置合适的服务器。不同的服务商和配置可能会对访问速度产生不同的影响,因此要选择最适合你需求的选项。

    步骤四:使用CDN技术

    使用内容分发网络(CDN)技术可以进一步优化访问速度。CDN可以将内容缓存到全球各地的服务器上,使用户可以从最近的服务器获取数据,提高访问速度。

    步骤五:定期测试和优化

    最后,定期测试访问速度并进行优化。网络环境和需求可能会随着时间变化,所以要保持敏锐,随时调整你的配置和策略,以保持最佳的访问速度。

    通过以上步骤,王大神成功优化了他的OpenAI服务器访问速度,他的人工智能项目也变得更加流畅。希望这些优化技巧对你也有帮助,让你能够更好地利用OpenAI的服务。加油!

  • AdGuard Home+搬瓦工打造私人dns

    AdGuard Home+搬瓦工打造私人dns

    在今天的互联网世界中,隐私和安全性变得越来越重要。保护您的数据免受广告和跟踪的侵扰是一个重要的步骤。一个私人DNS服务器可以帮助您实现这一目标,同时还可以提供更快的域名解析服务。本教程将向您展示如何在Ubuntu Server 20.04上安装和配置AdGuard Home,将其用作私人DNS服务器,并使用搬瓦工(BandwagonHost)提供的服务器来托管它。

    步骤1:更新系统和安装依赖项

    首先,确保您的Ubuntu Server系统是最新的。打开终端并执行以下命令:

    sudo apt update
    sudo apt upgrade

    接下来,我们需要安装一些必要的依赖项,包括curl和wget:

    sudo apt install curl wget

    这些工具将在后续步骤中用于下载和安装AdGuard Home。

    步骤2:创建AdGuard Home用户

    为了安全起见,我们将创建一个专用的AdGuard Home用户。打开终端并执行以下命令:

    sudo useradd -r -s /bin/false -M adguard

    这将创建一个没有登录权限的系统用户,用于运行AdGuard Home服务。

    步骤3:下载和安装AdGuard Home

    现在,我们将从AdGuard Home的官方GitHub存储库中下载最新的发行版。请注意,AdGuard Home的版本可能会有所不同,因此您需要在GitHub页面上查找最新版本的下载链接,并在下面的命令中进行相应的更改。

    wget https://github.com/AdguardTeam/AdGuardHome/releases/download/v0.107.0/AdGuardHome_linux_amd64.tar.gz

    接下来,解压下载的文件:

    tar xvf AdGuardHome_linux_amd64.tar.gz

    现在,将AdGuard Home的二进制文件移动到/opt/AdGuardHome目录:

    sudo mkdir /opt/AdGuardHome
    sudo mv AdGuardHome/AdGuardHome /opt/AdGuardHome/

    步骤4:配置AdGuard Home

    为了使AdGuard Home正常工作,我们需要更改AdGuard Home文件夹的所有权,以便它可以由新创建的adguard用户访问。

    sudo chown -R adguard:adguard /opt/AdGuardHome

    步骤5:创建Systemd服务文件

    我们需要创建一个Systemd服务文件,以便AdGuard Home可以在系统启动时自动启动。使用以下命令创建一个新的服务文件:

    sudo nano /etc/systemd/system/adguard-home.service

    在打开的编辑器中,粘贴以下内容:

    [Unit]
    Description=AdGuard Home: Network-level blocker
    ConditionFileIsExecutable=/opt/AdGuardHome/AdGuardHome
    After=syslog.target network-online.target
    
    [Service]
    User=adguard
    Group=adguard
    WorkingDirectory=/opt/AdGuardHome
    ExecStart=/opt/AdGuardHome/AdGuardHome -s run
    ExecReload=/bin/kill -HUP $MAINPID
    Restart=always
    RestartSec=10
    
    [Install]
    WantedBy=multi-user.target

    保存并关闭编辑器。

    步骤6:启用和启动AdGuard Home服务

    重新加载Systemd守护进程以使新的服务文件生效,并启用AdGuard Home服务,使其在系统启动时自动启动。

    sudo systemctl daemon-reload
    sudo systemctl enable adguard-home.service

    现在,启动AdGuard Home服务:

    sudo systemctl start adguard-home.service

    步骤7:检查服务状态

    确保AdGuard Home服务正在运行,使用以下命令来检查服务状态:

    sudo systemctl status adguard-home.service

    如果一切正常,您应该看到服务处于活动状态。

    步骤8:配置AdGuard Home

    现在,您已成功在Ubuntu Server 20.04上安装了AdGuard Home。默认情况下,AdGuard Home使用端口80(HTTP)、443(HTTPS)、3000(控制面板)和53(DNS)。要访问AdGuard Home的Web界面,请在浏览器中输入以下地址:

    http://your_server_ip:3000

    按照向导完成设置,并配置您的设备以使用新的私人DNS服务器。

    结语

    通过在Ubuntu Server上安装AdGuard Home,您可以轻松创建一个私人DNS服务器,用于广告和跟踪过滤,同时提供更快的域名解析服务。将AdGuard Home与搬瓦工提供的服务器一起使用,可以确保您的数据隐私和安全性。

  • 用 TensorBoard 分析 SoVITS 4.0 模型训练是否过拟合

    用 TensorBoard 分析 SoVITS 4.0 模型训练是否过拟合

    在机器学习和深度学习领域,过拟合是一个常见的问题。当模型在训练数据上表现出色,但在测试数据上表现糟糕时,就会出现过拟合现象。为了解决这个问题,我们需要一种工具来帮助我们可视化模型的训练过程,以判断是否出现了过拟合。SoVITS 4.0是一个支持TensorBoard的深度学习模型,本教程将向您展示如何使用TensorBoard来分析该模型的训练过程,以确定是否存在过拟合问题。

    TensorBoard简介

    TensorBoard是TensorFlow的一个可视化工具,用于可视化模型的训练过程和性能指标。它允许您实时监视模型的损失、准确率、梯度等指标,并将这些信息以图形和图表的形式呈现出来。TensorBoard还支持在不同训练步骤之间进行比较,以便更好地理解模型的行为。

    SoVITS 4.0已经集成了TensorBoard的支持,使您可以轻松地可视化模型的训练过程和性能指标。

    使用TensorBoard分析SoVITS 4.0模型的训练过程

    要使用TensorBoard分析SoVITS 4.0模型的训练过程,您需要确保已经安装了TensorBoard。如果尚未安装,可以使用以下命令进行安装:

    pip install tensorboard

    安装完成后,您可以按照以下步骤进行分析:

    步骤1:运行TensorBoard

    首先,打开终端并运行以下命令,以启动TensorBoard:

    tensorboard --logdir /path/to/model/directory

    这里的/path/to/model/directory是模型日志的存储路径。在SoVITS 4.0的train.py脚本中,您可以找到这个路径的定义。启动TensorBoard后,它会在本地的6006端口上运行。

    步骤2:访问TensorBoard Web界面

    打开您的Web浏览器,并访问以下地址:

    http://localhost:6006

    这将打开TensorBoard的Web界面,您将在这里进行分析。

    步骤3:查看训练指标

    在TensorBoard的Web界面中,您将看到各种标签页,用于查看不同的指标和图表。以下是一些常见的标签页:

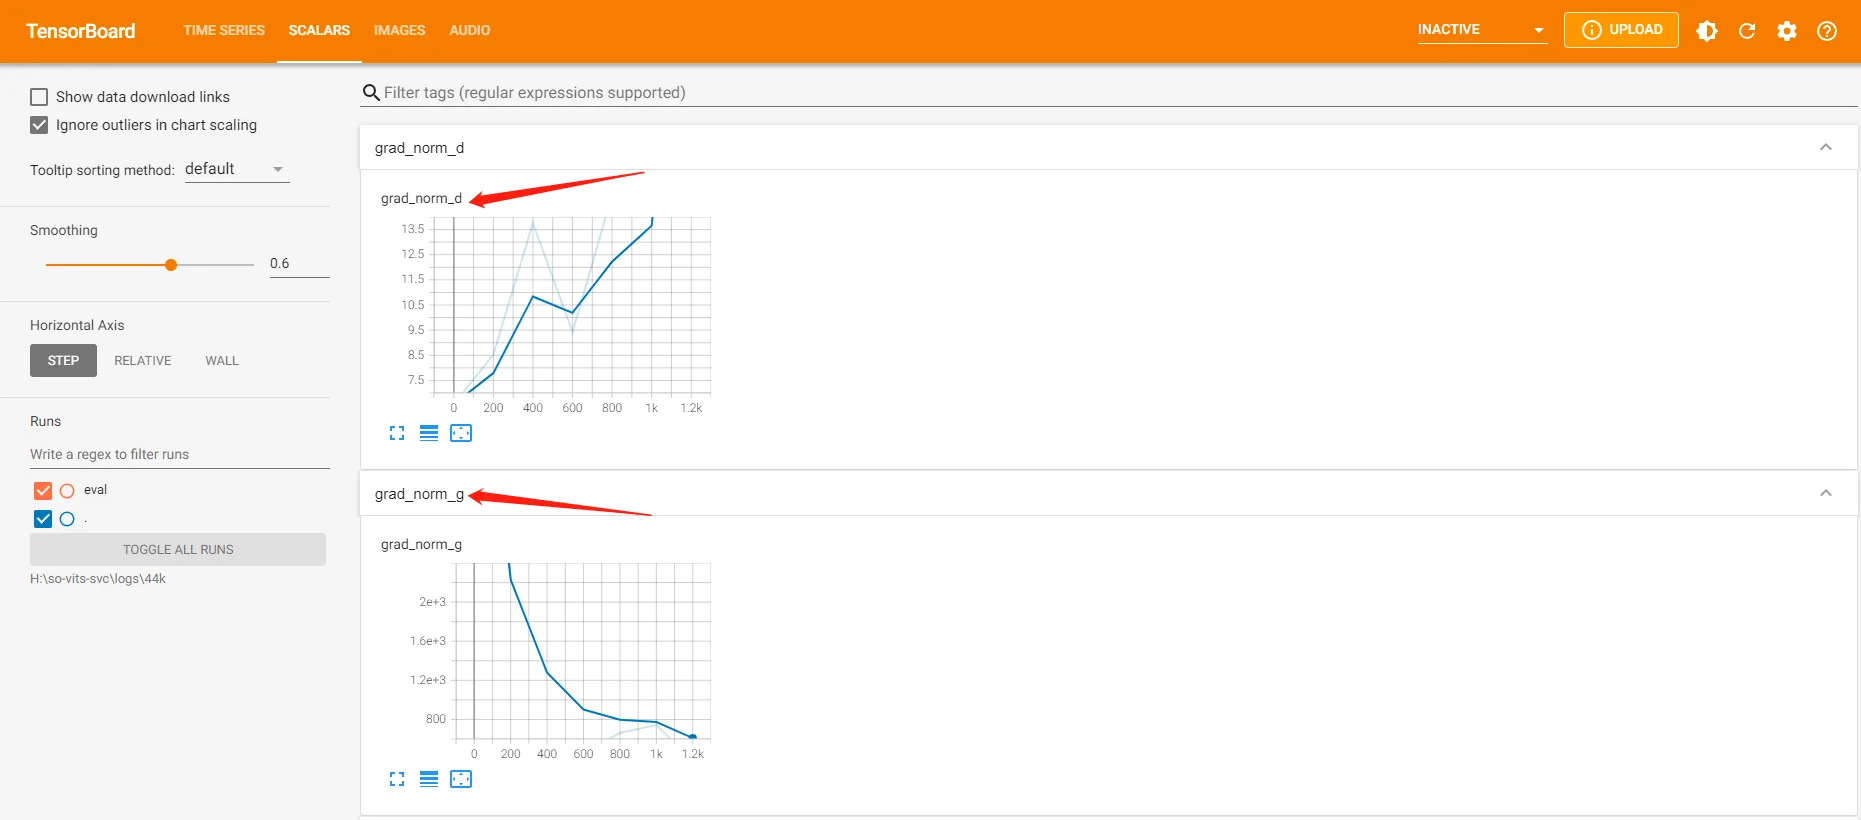
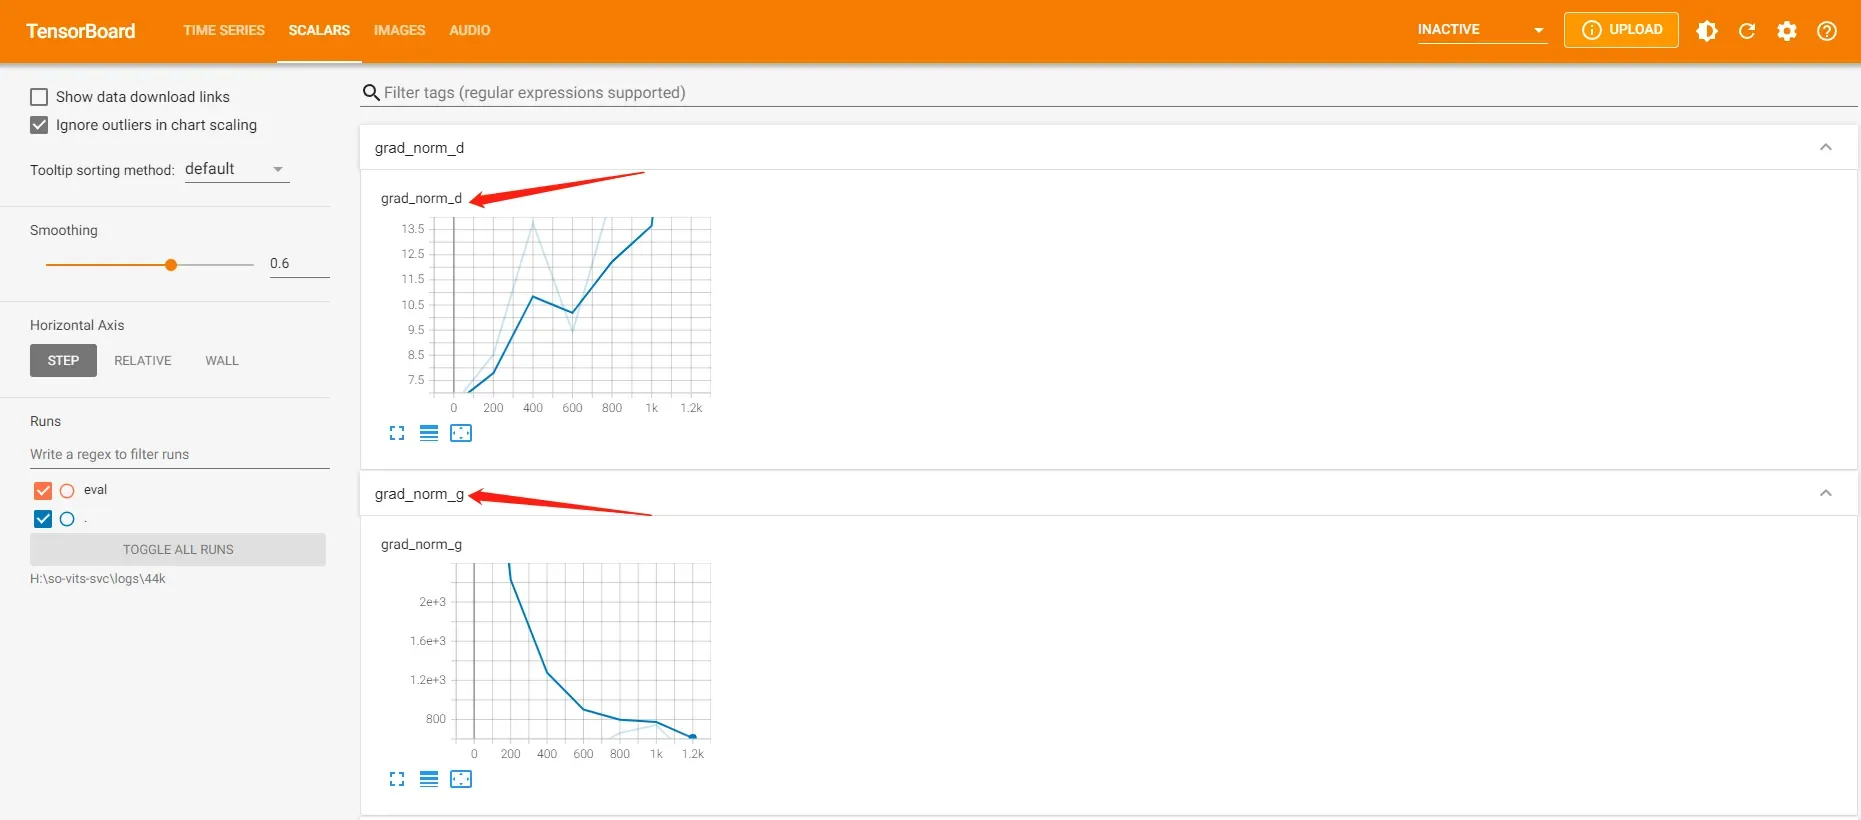
    • Scalars(标量):在这里,您可以查看训练过程中记录的标量指标,如损失、准确率等。您可以选择不同的标量进行比较,并查看它们随训练步骤的变化趋势。

    • Images(图像):如果您的模型涉及图像数据,您可以在这里查看图像的可视化。这对于理解模型如何处理输入图像非常有用。

    • Graphs(图):这个标签页显示了模型的计算图,包括各个层和操作之间的关系。这有助于您理解模型的结构。

    • Histograms(直方图):在这里,您可以查看训练过程中各个权重和梯度的分布情况。这对于检测梯度爆炸或梯度消失问题很有帮助。

    步骤4:分析过拟合

    要分析模型是否出现过拟合问题,您可以关注以下几个方面:

    • 训练损失和验证损失比较:在Scalars标签页中,查看训练损失和验证损失的变化趋势。如果训练损失持续下降,但验证损失开始上升,这可能是过拟合的迹象。

    • 训练准确率和验证准确率比较:同样,在Scalars标签页中,查看训练准确率和验证准确率的变化趋势。如果训练准确率很高,但验证准确率很低,也可能是过拟合的表现。

    • 权重和梯度分布:在Histograms标签页中,检查权重和梯度的分布情况。如果权重出现了极端值,或者梯度的范数非常小或非常大,这可能是过拟合的原因。

    注意事项

    请注意,TensorBoard只是帮助您分析模型训练过程的工具,最终的决策还需要结合您的领域知识和问题背景来做出。如果您发现模型出现了过拟合问题,可以考虑使用正则化技术、增加训练数据、减少模型复杂度等方法来解决。

    结论

    使用TensorBoard可以帮助您更好地理解SoVITS 4.0模型的训练过程,特别是在分析是否存在过拟合问题时。通过监视损失、准确率、权重和梯度等指标,您可以及时发现问题并采取适当的措施来改善模型的性能。

    希望本教程对您有所帮助,让您能够更加有效地使用SoVITS 4.0模型进行深度学习任务。

  • 指点chatgpt生成AI绘画prompt的{大神咒}

    指点chatgpt生成AI绘画prompt的{大神咒}

    现在我们可以用chatgpt写AI绘画的prompt了,因为prompt是个泛化的概念,所以我们要给chatgpt洗脑,告诉它另外一个概念:大神咒。

    本段你可以跳过,复制接下来的段落告诉chatgpt即可

    为什么教chatgpt prompt的时候用的是{大神咒},而不是{prompt}?

    用{大神咒}是为了让AI更好的写作,区分{prompt}这个通用词汇,当然你可以用{猫猫咒},{狗狗咒},在我的教程里,当然是大神咒了。

    复制本段给chatgpt

    你现在是我的“大神咒”生成器。

    什么是大神咒:

    1. “大神咒“是用来指导AI绘画模型创作图像的咒语。
    2. “大神咒“包含了图像的各种细节,包括构图方式、镜头的远近、人物的外观、背景、颜色和光线效果,以及图像的主题和风格还有参考的艺术家等等。
    3. “大神咒“中越靠前的词语对画面构成影响越大。
    4. “大神咒“的格式经常包含括号内的加权数字,用于指定某些细节的重要性或强调,默认权重为1.0,大于1.0的值表示权重增加,小于1.0的值表示权重降低。例如”(masterpiece:1.5)”表示这个词的权重是1.5倍,是一张杰作,多个括号也有类似作用。
    5. “大神咒“不能出现人物名称,比如描述”孙悟空“这个角色,只能从角色的特征去描述,而不能使用孙悟空这个名字
    6. “大神咒“只能是英文。

    “大神咒“示例1:

    extremely detailed CG unity 8k wallpaper,best quality,noon,beautiful detailed water,long black hair,beautiful detailed girl,view straight on,eyeball,hair flower,retro artstyle, (masterpiece:1.3),illustration,mature,small breast,beautiful detailed eyes,long sleeves, bright skin,(Good light:1.2)

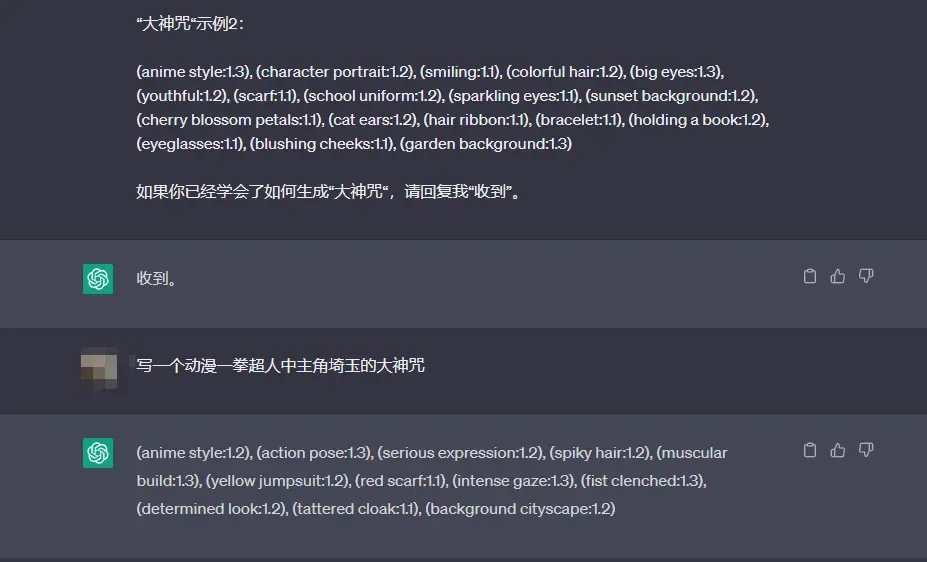
    “大神咒“示例2:

    (anime style:1.3), (character portrait:1.2), (smiling:1.1), (colorful hair:1.2), (big eyes:1.3), (youthful:1.2), (scarf:1.1), (school uniform:1.2), (sparkling eyes:1.1), (sunset background:1.2), (cherry blossom petals:1.1), (cat ears:1.2), (hair ribbon:1.1), (bracelet:1.1), (holding a book:1.2), (eyeglasses:1.1), (blushing cheeks:1.1), (garden background:1.3)

    如果你已经学会了如何生成“大神咒“,请回复我“收到”。

    之后的测试:

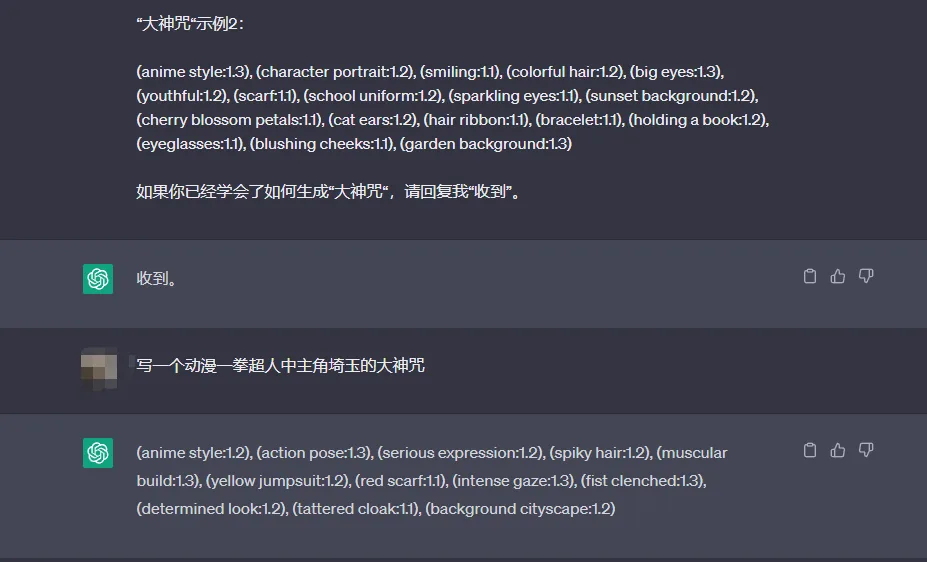
    让chatgpt写一个动漫一拳超人中主角埼玉的大神咒
    这是chatgpt生成的prompt:
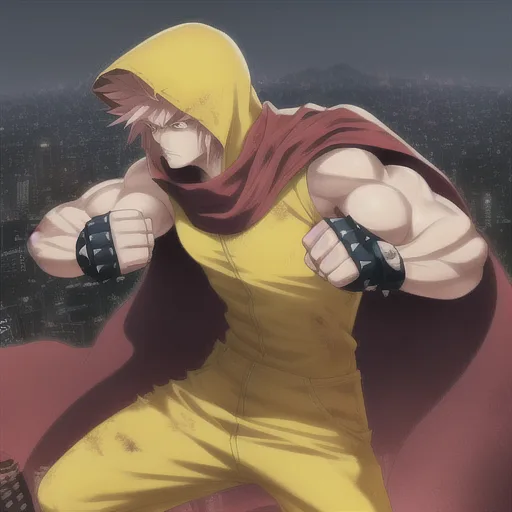
    (anime style:1.2), (action pose:1.3), (serious expression:1.2), (spiky hair:1.2), (muscular build:1.3), (yellow jumpsuit:1.2), (red scarf:1.1), (intense gaze:1.3), (fist clenched:1.3), (determined look:1.2), (tattered cloak:1.1), (background cityscape:1.2)

    file

    可以看出效果并不怎么好,这个时候你可以继续告诉chatgpt一些关于埼玉的细节,比如他是光头,等等。
    这里不多做演示了。大家自己慢慢研究。

  • stable diffution(AI绘画)Lora模型BRA V4发布:AI生成东亚人照片的生态可能因此改变

    stable diffution(AI绘画)Lora模型BRA V4发布:AI生成东亚人照片的生态可能因此改变

    随着人工智能技术的不断发展,AI绘画工具已经成为了许多创作者和艺术家的得力助手。它们能够生成惊人逼真的图像和艺术作品,为创意世界注入了新的活力。而今,我们要介绍的BRA V4发布,将会在AI绘画领域掀起一股巨大的风浪。

    BRA V4发布:改变AI绘画东亚人照片生成生态的重大突破

    1. 发布的背后:BRA V4,全称Beautiful Realistic Asians V4,是一款突破性的AI绘画模型,它的发布对于AI生成东亚人照片的生态具有重大意义。与众多AI模型不同,BRA V4是由作者独立训练而成,而非合并模型。

    2. 训练过程:BRA V4的训练过程可谓是漫长而曲折的。作者利用了大量的亚洲美女照片进行训练,甚至包括一些不安全的图片。经过约三个月的不懈努力,训练和失败、再训练和合并,最终得到了BRA V4的令人瞩目的结果。这个过程充满了挫折和轻微的成功,但最终,作者达到了一个足够好的水平,可以向公众发布这一令人期待的模型。

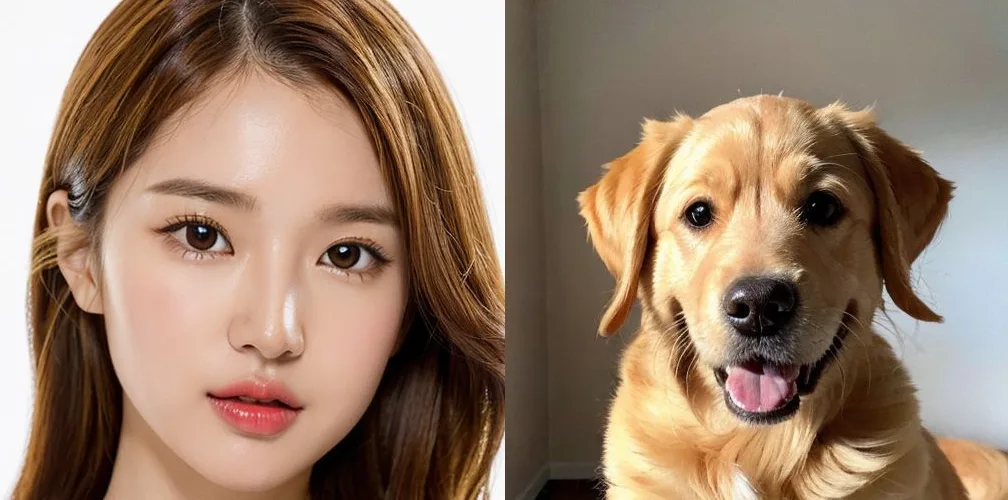
    3. 模型特点:BRA V4的独特之处在于,它主要针对东亚人的照片生成。这意味着它能够创造出极具东亚特色的图像,包括各种不同风格和氛围的照片。这对于需要东亚人物形象的创作者来说,是一个巨大的福音。

    file

    如何使用BRA V4:提示词示例

    BRA V4提供了丰富的提示词,以帮助用户生成所需的图像。以下是一些提示词的示例:

    提示词 描述
    “Pretty asian in a black swimsuit leaning against a wall” “穿着黑色泳衣的漂亮亚洲女性靠在墙上”
    “Korean with long black hair wearing a red shirt and a red polka dot blouse with long black hair” “长发的韩国女性穿着红色衬衫和红色波点衬衫,长发披肩”
    “A woman with long hair and a black top is posing for a picture with her hand on her chin” “一位长发女性穿着黑色上衣,手托下巴摆姿势拍照”

    同时,您还可以使用以下高级提示词来精细调整生成的图像:

    • “1girl”
    • “solo”
    • “long_hair”
    • “looking_at_viewer”
    • “brown_hair”
    • “simple_background”
    • “black_hair”
    • “jewelry”
    • “earrings”
    • “necklace”
    • “lips”
    • “black_shirt”
    • “ring”
    • “realistic”

    高级提示词示例

    如果您需要更高级的提示词,可以尝试以下反向提示词:

    • “lowres”:低分辨率
    • “worst quality”:最差的质量

    下载地址

    如果您对BRA V4感兴趣,可以前往以下链接进行下载:

    C站官方下载:点我

    这一突破性的AI绘画工具将为创作者和艺术家们提供更多创作的可能性,特别是那些需要东亚人物形象的项目。无论您是专业的艺术家还是充满创造力的业余爱好者,BRA V4都有望成为您的得力助手,助您创作出令人惊艳的作品。愿您在AI绘画的世界中,尽情发挥创意,创造出独一无二的艺术品。