Tag: 硬件

  • 软件开发中的风险管理:什么是灰度测试?深入探讨灰度测试的重要性

    软件开发中的风险管理:什么是灰度测试?深入探讨灰度测试的重要性

    在一个寒冷的冬夜,小李,一位经验丰富的程序员,坐在自己的工作桌前,盯着计算机屏幕。他刚完成了一个月的密集编程,为公司开发了一个新功能。他信心满满地点击了“发布”按钮,期待着这个功能被成千上万的用户所使用。但是,就在他即将庆祝的时候,他的手机突然收到了一条短信:“小李,我们收到了很多用户反馈,新功能出现了很多问题。”

    小李心跳加速,他立刻打开了用户反馈系统,发现确实有很多用户遇到了问题。他不明白,为什么在他的计算机上,这个功能运行得非常完美,但在其他用户的计算机上,却出现了各种各样的问题。小李感到非常沮丧,他决定请教他的朋友小王。

    小王是一个资深的测试工程师,听了小李的描述后,他说:“小李,你听说过‘灰度测试’吗?”

    灰度测试是什么?

    小李摇摇头,表示自己从未听说过这个词。小王解释说:“灰度测试,是在软件开发过程中,为了更好地管理风险,而对新功能或新版本进行的有限范围的发布。这样,我们可以先让部分用户使用这个新功能,观察有没有问题。如果没有问题,再逐步扩大发布范围。这就好比一个新生儿出生后,首先在一个小房间里,然后再逐步适应外面的环境。”

    小李恍然大悟,他意识到自己之前发布新功能时,并没有进行灰度测试,直接全量发布,导致了问题的出现。

    为什么需要灰度测试?

    小王继续说:“你知道,软件开发是一个非常复杂的过程。即使你的代码在自己的计算机上运行得很好,但是,由于各种各样的原因,比如不同的操作系统、浏览器、硬件配置等,用户在使用时可能会遇到很多你意想不到的问题。而灰度测试,就可以帮助我们发现这些问题,并及时修复,避免影响大部分用户。”

    如何进行灰度测试?

    小李问:“那我们应该如何进行灰度测试呢?”小王回答:“首先,你可以选择一部分用户,比如1%的用户,让他们首先使用这个新功能。观察一段时间,看有没有问题。如果没有问题,再逐步扩大发布范围,比如到10%,再到50%,直到100%。这样,即使出现问题,也只会影响到一小部分用户,不会影响到大部分用户。”

    小李点点头,表示理解。他决定,以后发布新功能时,都要先进行灰度测试,避免出现类似的问题。

    结束语

    那个冬天,小李得到了一个宝贵的教训。他学会了灰度测试的重要性,也学会了如何进行灰度测试。从此,他的软件再也没有出现过大规模的问题,用户也都非常满意。

    对于我们每一个软件开发者和测试工程师,灰度测试都是一个非常重要的工具。它可以帮助我们更好地管理风险,确保软件的稳定性和可靠性。只有这样,我们才能赢得用户的信任,让我们的软件在市场上取得成功。

  • 项目介绍:Retrieval-based-Voice-Conversion-WebUI

    项目介绍:Retrieval-based-Voice-Conversion-WebUI

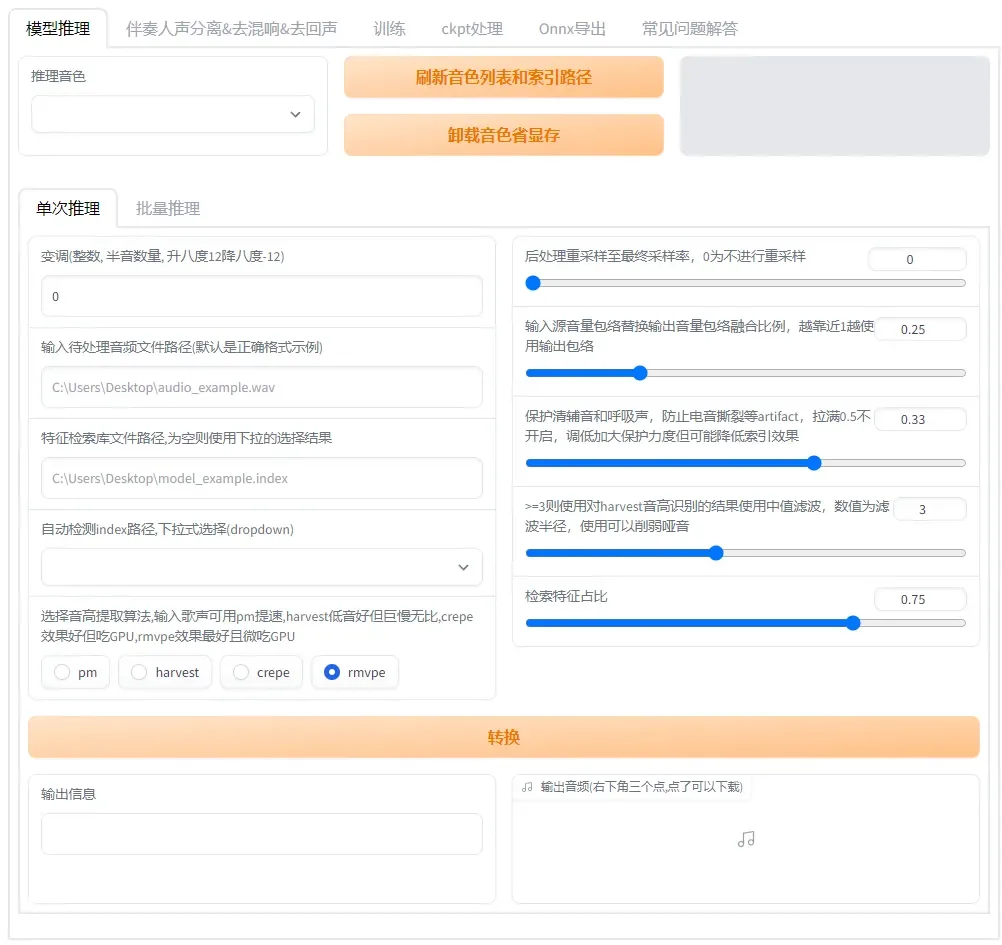
    大家是否曾经幻想过能够轻松改变自己的声音,变成不同的角色或声音风格,而不需要复杂的技术和昂贵的设备?现在,这个梦想成为现实的一部分,而且非常容易实现。在这篇文章中,我将向您介绍一个名为”Retrieval-based-Voice-Conversion-WebUI”的项目,它是一个基于VITS的简单易用的变声框架。无需深入的音频处理知识,只需轻松点击,您就可以实现令人惊叹的声音变化。

    项目概览

    Retrieval-based-Voice-Conversion-WebUI(以下简称RVC)是一个开源项目,它的目标是让声音变换变得容易、快捷和有趣。这个项目基于VITS(Variational Inference Text-to-Speech)模型,该模型在语音合成领域取得了显著的成就。RVC借助VITS的强大功能,为用户提供了一个简单的网页界面,让您能够以前所未有的方式探索声音。

    项目特点

    RVC拥有许多引人注目的特点,使其成为一个令人兴奋的项目:

    • 使用检索替换声音源特征:RVC采用了一种创新的方法,使用检索技术来替换输入源的特征,以杜绝音色泄漏,确保声音变换的高质量。

    • 适用于各种硬件:即使在相对较差的显卡上,RVC也能快速训练,这意味着您不需要超级高端的硬件来享受声音变换的乐趣。

    • 使用少量数据训练:与许多其他声音变换方法不同,RVC可以在少量数据下训练,只需10分钟左右的低噪音语音数据,就能获得出色的结果。

    • 模型融合:RVC允许您通过模型融合来改变音色,借助模型选项卡中的ckpt-merge选项,您可以自定义声音的风格。

    • 简单易用的网页界面:RVC提供了一个直观的网页界面,无需复杂的命令行操作,您只需点击几下,即可完成声音变换。

    • 人声分离:RVC还支持调用UVR5模型,以快速分离人声和伴奏,让您更轻松地处理音频文件。

    • 先进的音高提取算法:RVC采用了最先进的人声音高提取算法,根据哑音问题进行优化,实现更好的效果,同时占用更小的资源。

    • A卡和I卡加速支持:无论您使用的是A卡还是I卡,RVC都提供了相应的支持,以满足不同用户的需求。

    环境配置

    要开始使用RVC,您需要确保您的环境配置正确。以下是设置环境的简要步骤:

    1. 安装Python 3.8或更高版本。

    2. 安装PyTorch及其核心依赖,可以使用以下命令:

      pip install torch torchvision torchaudio

      对于Windows用户,如果使用Nvidia Ampere架构(如RTX30xx),您可能需要指定PyTorch对应的CUDA版本。您可以使用以下命令:

      pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu117
    3. 安装项目依赖项,您可以使用Poetry或pip来安装依赖。具体的命令请参考项目文档。

    4. 下载所需的预模型文件,项目提供了下载链接和说明。

    5. 启动WebUI,运行以下命令:

      python infer-web.py

    以上是基本的环境配置步骤,具体的配置细节可以在项目文档中找到。

    结语

    Retrieval-based-Voice-Conversion-WebUI是一个引人注目的项目,它将声音变换带入了新的境界,使其变得简单、快捷和有趣。不再需要复杂的音频处理技巧,只需轻松点击几下,您就能探索无限的声音可能性。无论您是声音爱好者还是音频专业人士,RVC都值得一试。

    如果您想要探索声音的奇妙世界,不妨前往Retrieval-based-Voice-Conversion-WebUI的GitHub仓库了解更多信息,并亲自体验声音的变幻魔法!

  • Intel是否故意对AMD进行负优化?背后的故事揭秘

    Intel是否故意对AMD进行负优化?背后的故事揭秘

    在计算机领域,竞争一直是不可避免的。不仅是硬件制造商之间的竞争,软件开发领域也是如此。然而,有时候,竞争可能会走向一条暗淡的道路,引发一些令人质疑的问题。今天,我们将深入探讨一个备受关注的话题:Intel是否故意对AMD进行负优化?

    背景故事

    故事的开始,是一则来自Java社区的推送。它提到了OpenJDK正在采用x86-simd-sort来进行AVX512基础排序,但在AMD系统上性能表现不佳。具体而言,x86-simd-sort在AMD Zen 4处理器上表现糟糕,原因被归咎于AMD平台上的compressstoreu效率问题。这个问题在今年2月份已经被提出,其中包括了与标准库的性能比较,令人吃惊的是,x86-simd-sort在某些测试中甚至比标准库慢十倍。

    本来作为一个旨在优化加速的库,却在AMD平台上变成了负优化,这引起了广泛的讨论。一些人认为这是AMD的问题,但也有人开始怀疑Intel是否在开发x86-simd-sort时,有意识地选择了AMD的弱点,并进行了针对性的负优化。

    潜在动机

    要理解这个问题,我们需要回顾过去。曾经有一段时间,Intel编译器曾对AMD进行负优化,这引起了一些争议。因此,人们开始怀疑,Intel是否在开发x86-simd-sort时,有意识地选择了AMD的弱点,以此来削弱AMD的性能表现。

    然而,至今为止,尽管有人提出了这个问题,但并没有看到AMD提交修复此问题的Pull Request。这引发了更多的猜测和争议。

    可能的解决方案

    尽管存在这个问题,但在问题的评论区,有一位用户提出了潜在的解决方案,解释了compressstoreu执行效率的问题。然而,这个解决方案似乎没有被上游接受或推广,导致问题仍然存在。

    结论

    在竞争激烈的计算机行业,像Intel和AMD这样的巨头之间的竞争常常激烈而复杂。是否有故意的负优化行为存在,很难得出确定的结论。然而,这个问题突显了开源社区中的竞争和合作之间的微妙平衡。

    最终,我们可以期待AMD的未来架构,如Zen 5以及后续的新架构,是否能够解决这个问题,以实现更好的性能。

    以上就是关于Intel是否故意对AMD进行负优化的背后故事的探讨。计算机行业永远充满了谜团和争议,而我们作为观察者,需要保持警惕,以确保竞争是公平的。

  • 如何充分利用64GB内存条发挥其潜力

    如何充分利用64GB内存条发挥其潜力

    有一位用户购买了两个金士顿32GB的DDR4内存条,合计64GB内存,用于台式机。他的目标是充分利用这64GB内存,运行虚拟机、处理大数据,以及尝试一些有趣的项目。在这篇文章中,我们将探讨如何充分利用64GB内存,玩些有趣的东西,并提供一些创意的用途建议。

    64G内存 64G内存

    内存的重要性

    内存是计算机系统中的关键组件之一,对于多任务处理和大型应用程序的性能至关重要。拥有64GB内存可以为用户提供更多的空间来同时运行多个程序,而不会降低系统的响应速度。

    虚拟化环境

    1. 虚拟机

    64GB内存是构建虚拟化环境的理想选择。您可以使用虚拟机软件(如VMware、VirtualBox或Hyper-V)来创建多个虚拟机实例,每个实例可以运行不同的操作系统或应用程序。这对于开发、测试和学习非常有用。

    2. 大数据处理

    如果您涉足大数据领域,64GB内存可以加速数据处理任务。您可以使用工具如Apache Hadoop、Spark或Kafka来处理大规模数据集,而不必担心内存不足的问题。

    创意项目

    1. Electron 应用

    64GB内存可以让您轻松运行多个Electron应用程序,这些应用程序基于Web技术构建,通常需要占用较多的内存。您可以尝试开发自己的Electron应用或者使用现有的应用来提高工作效率。

    2. 浏览器缓存

    将浏览器缓存放在内存中可以提高网页加载速度。这样,您可以更快地访问常用的网站,提高浏览体验。

    高内存需求项目

    1. 编译大型项目

    如果您从事软件开发,并需要编译大型项目,64GB内存将显得尤为重要。某些项目可能需要大量内存来进行编译,以加快开发周期。

    2. 数据库操作

    处理大型数据库时,内存是关键因素之一。如果您需要进行复杂的数据库查询和分析,64GB内存可以提供更快的数据访问速度。

    总结

    64GB内存是一种强大的资源,可以用于各种有趣的项目和任务。无论是虚拟化环境、大数据处理还是创意项目,都可以充分利用这一资源。请根据自己的兴趣和需求,挑选适合您的项目,并充分发挥64GB内存的潜力。

    在计算机领域,内存是一项宝贵的资源,对于提高性能和实现创新性项目至关重要。希望这篇文章能为您提供一些灵感,帮助您充分利用64GB内存,玩出新花样。

    64GB内存是一项令人兴奋的资源,可以用于各种有趣的项目和任务。无论您是开发者、数据科学家还是充满创意的项目爱好者,都可以充分发挥这一资源,提高工作效率和体验。希望这篇文章能启发您,让您在计算机世界中更有创意和成就感。

  • 如何选择适合iOS开发和剪辑视频的黑苹果主机

    如何选择适合iOS开发和剪辑视频的黑苹果主机

    在进行iOS开发和视频剪辑时,选择一台适合的计算机是非常重要的。一位用户提到了他的需求,即需要一台既能满足Mac端开发需求又能进行Windows端开发,并且还要用于视频剪辑。他考虑了购买Mac mini和一台搭载黑苹果系统的主机,但担心黑苹果系统可能会出现问题。在本文中,我们将深入探讨如何选择适合iOS开发和视频剪辑的计算机,以及是否应该考虑黑苹果主机。

    了解需求

    在选择计算机之前,首先要明确自己的需求。用户需要一台能够运行Xcode(iOS开发工具)的计算机,同时也需要足够的性能来处理视频剪辑任务。这意味着计算机需要具备较高的内存、处理器性能以及存储空间。

    黑苹果 vs. 白苹果

    1. 黑苹果

    黑苹果是指在非苹果硬件上安装macOS操作系统的做法。虽然它可以在一些普通PC上运行macOS,但通常需要一些技术知识来配置和维护。黑苹果系统通常比正版苹果硬件上的macOS更便宜,但也可能面临一些兼容性和稳定性问题。

    对于iOS开发来说,黑苹果通常需要在新版本的macOS发布后进行更新,以确保Xcode等开发工具的兼容性。这可能需要一些额外的工作,因为黑苹果系统需要使用Opencore等工具进行配置。

    2. 白苹果

    白苹果是指使用正版苹果硬件(如Mac mini、iMac等)来进行开发和剪辑。这些设备通常具有较好的性能和稳定性,而且不需要额外的配置或维护工作。对于iOS开发来说,白苹果设备通常能够无缝运行最新版本的Xcode,并且得到苹果官方支持。

    推荐的选择

    考虑到用户的需求和预算,以下是一些可能的选择:

    1. Mac mini

    如果预算允许,购买一台Mac mini可能是最简单的选择。它是一台正版苹果设备,能够流畅运行Xcode和其他开发工具。用户可以选择16GB内存的配置,以确保足够的性能来进行iOS开发和视频剪辑。此外,Mac mini还可以通过外接存储扩展存储空间,以满足视频剪辑的需求。

    2. 搭载黑苹果的台式机

    如果预算有限,但仍希望能够同时进行iOS开发和视频剪辑,考虑搭载黑苹果系统的台式机可能是一个经济实惠的选择。用户可以选择一台配置较高的台式机,安装黑苹果系统,并确保系统的稳定性和兼容性。这需要一些技术知识和时间来配置,但可以提供较好的性能。

    总结

    在选择适合iOS开发和视频剪辑的计算机时,要考虑自己的需求和预算。如果预算充足并且希望无忧地进行开发和剪辑工作,那么购买一台Mac mini可能是最佳选择。如果预算有限但愿意投入一些配置工作,那么搭载黑苹果系统的台式机也可以满足需求。

    无论选择哪种方式,都应该考虑到系统的稳定性和性能,以确保能够高效地进行iOS开发和视频剪辑工作。

  • 微软即将发布首款人工智能芯片:开启AI新纪元

    微软即将发布首款人工智能芯片:开启AI新纪元

    在当今数字化时代,人工智能技术正以惊人的速度演进,成为了各行各业的关键驱动力。微软,作为全球领先的科技巨头,一直以来都在积极探索人工智能领域的前沿技术。最新的消息显示,微软即将在下个月的年度开发者大会上推出其首款为人工智能设计的芯片,这将是一项具有里程碑意义的举措。本文将深入探讨微软的这一举措,揭示其对人工智能领域的重大影响。

    背景介绍

    微软是一家全球知名的科技公司,其业务涵盖了操作系统、办公软件、云计算等领域。随着人工智能技术的迅猛发展,微软一直在积极投入资源,推动人工智能领域的创新。而今,微软计划推出的这款人工智能芯片标志着其在硬件领域的重大突破,也将为人工智能的未来发展带来新的动力。

    微软的首款人工智能芯片

    据悉,微软的这款首款人工智能芯片是专门为训练和运行大型语言模型(LLM)的数据中心服务器设计的。语言模型在自然语言处理领域具有广泛的应用,包括机器翻译、智能对话系统等。而微软的这款芯片将为这些应用提供强大的性能支持,加速了人工智能技术在这些领域的应用。

    芯片的意义和影响

    微软的这一举措将对人工智能领域产生深远的影响。首先,这款芯片的问世将减少对第三方硬件供应商的依赖,提高了微软在人工智能领域的自主性。其次,芯片的设计针对语言模型,将为自然语言处理领域的研究和应用带来更大的便利性和效率。最重要的是,这款芯片有望推动人工智能技术的普及和应用,为更多行业带来创新和改变。

    行业应用和合作伙伴

    微软的数据中心服务器目前已经使用英伟达的GPU为云客户提供先进的LLM。这些客户包括了OpenAI和Intuit等知名公司,以及支持微软生产力应用程序中的人工智能功能。微软在人工智能领域的合作伙伴关系广泛而深入,这也为其新推出的人工智能芯片的应用提供了更广阔的空间。

    未来展望

    微软的首款人工智能芯片标志着该公司在人工智能领域的深刻布局。随着人工智能技术的不断进步,我们有理由相信,微软的这一举措将推动人工智能领域迈向新的高度。这也意味着未来将会有更多创新的人工智能应用涌现,为人类社会带来更多便利和机会。

    结语

    微软即将发布的首款人工智能芯片引发了广泛的关注和期待。这一举措将不仅推动人工智能技术的发展,也将为科技产业的未来带来新的机遇。随着时代的发展,人工智能将继续发挥着重要的作用,而微软正站在这一领域的前沿,为未来的AI新纪元开启了大门。

  • 如何利用开源组件提取文本中的短语

    如何利用开源组件提取文本中的短语

    在处理文本数据时,提取关键短语是一项常见的任务,它有助于理解文本的主题和内容。本文将介绍如何使用开源组件来提取文本中的短语,以及一些常见的方法和工具。

    开源组件介绍

    在NLP领域,有许多开源组件和库可用于文本处理任务。其中一个常用的组件是jieba,它是一个用于中文文本分词的工具。虽然jieba主要用于分词,但也可以用来提取关键词和短语。

    使用jieba提取短语

    以下是使用jieba库提取文本中的关键短语的示例:

    import jieba.analyse
    
    # 要提取短语的文本
    text = "牛顿冷却定律在得到 APP 的实践背景介绍..."
    
    # 提取关键短语
    phrases = jieba.analyse.extract_tags(text, topK=5)
    
    # 打印提取结果
    print(phrases)

    在上述示例中,我们使用jieba.analyse.extract_tags函数来提取文本中的关键短语,并指定了要提取的短语数量(topK=5)。提取结果将包含文本中最重要的短语。

    其他方法和工具

    除了jieba,还有其他方法和工具可用于提取文本中的短语。例如,TF-IDF(词频-逆文档频率)分析、TextRank算法、LDA(Latent Dirichlet Allocation)等方法可以用于关键短语提取。这些方法通常需要更复杂的实现,但可以根据需求选择合适的工具。

    结论

    提取文本中的关键短语对于文本理解和分析非常重要。使用开源组件如jieba,可以方便地实现短语提取任务。此外,还可以考虑使用其他方法和工具来进一步优化短语提取的效果,根据实际需求选择合适的方法和工具。

  • PyTorch与Keras:深度学习框架的选择之争

    PyTorch与Keras:深度学习框架的选择之争

    深度学习已经成为人工智能领域的热门话题,而选择适合的深度学习框架对于项目的成功至关重要。在众多深度学习框架中,PyTorch和Keras都备受欢迎,它们各有优势。在本文中,我们将深入探讨PyTorch和Keras的特点,帮助您更好地理解哪个框架更适合您的需求。

    PyTorch:风头正劲的深度学习框架

    PyTorch在近年来迅速崭露头角,成为深度学习领域的翘楚。下面我们将介绍一些PyTorch的优势:

    1. 动态计算图

    PyTorch采用动态计算图的方式,使得模型构建更加灵活。这意味着您可以像编写Python代码一样构建神经网络,无需预先定义静态计算图。这种灵活性对于研究人员和实验性项目非常有吸引力。

    2. 易于调试

    PyTorch的动态计算图使得调试变得更容易。您可以轻松地在模型中插入打印语句或使用Python调试工具来检查模型的中间状态,有助于快速发现和解决问题。

    3. 强大的社区支持

    PyTorch拥有庞大的社区,因此可以轻松找到各种教程、示例代码和问题解决方案。这对于初学者来说是一个巨大的优势,因为您可以从社区的智慧中受益。

    Keras:友好的深度学习入门门槛

    Keras是另一个备受欢迎的深度学习框架,它有着自己的一系列优势:

    1. 简洁的API

    Keras提供了简单而直观的API,使得构建神经网络变得容易。它的设计理念是“用户友好”,适用于初学者和快速原型开发。

    2. 多后端支持

    Keras可以运行在多个深度学习后端引擎上,包括TensorFlow和Theano。这使得您可以根据项目需求选择最合适的后端。

    3. 高度模块化

    Keras的模块化设计使得您可以轻松组合不同的层和模型,创建自定义神经网络结构。这对于构建复杂的模型非常有用。

    如何选择?

    选择PyTorch还是Keras,取决于您的项目需求和个人偏好。下面是一些建议:

    • 如果您是深度学习的新手,想快速入门并构建简单的模型,Keras可能是更好的选择。
    • 如果您是研究人员或需要更大的灵活性来实验不同的模型架构,PyTorch可能更适合您。
    • 如果您更倾向于使用TensorFlow作为后端,Keras是一个很好的选择。
    • 如果您喜欢动态计算图和更容易的调试,PyTorch可能更适合您。

    最终,无论您选择哪个框架,都应该根据项目的需求和您的经验水平来进行决策。

    结论

    PyTorch和Keras都是优秀的深度学习框架,各自具有一系列优势。选择适合您的框架取决于您的项目和个人偏好。无论您选择哪一个,都要充分利用社区的资源和教程,不断学习和提升自己的深度学习技能。

  • 如何在知识图谱中建立关系:解密关系的生成过程

    如何在知识图谱中建立关系:解密关系的生成过程

    知识图谱是一个强大的工具,用于组织和展示各种信息之间的关系。然而,在构建知识图谱时,最关键的问题之一是如何生成节点之间的关系。这个问题一直困扰着许多初学者。在本教程中,我们将探讨如何在知识图谱中建立关系,并提供详细的步骤和指南,帮助您更好地理解这个过程。

    步骤1:准备知识图谱

    在开始之前,首先要确保您已经准备好了知识图谱的节点数据。节点可以是各种实体,如人物、地点、事件等。这些节点代表了您希望在图谱中表示的信息。

    步骤2:了解节点之间的关系

    在生成关系之前,您需要清楚地了解节点之间可能存在的关系。这可以通过分析您的数据和领域知识来实现。例如,如果您的知识图谱涉及电影和演员,可能存在关系如“主演”、“导演”等。

    步骤3:自定义规则

    生成节点之间的关系通常需要自定义规则。这些规则可以基于您的数据和知识领域来制定。例如,如果您的知识图谱涉及人物关系,您可以定义规则如下:

    # 示例规则:如果两个人物在同一部电影中共演过,那么它们之间存在“共演”关系。
    
    # 创建一个字典来存储人物和电影的关系
    relationships = {}
    
    # 假设以下数据表示电影和演员的关系
    movies_and_actors = [
        {"movie": "MovieA", "actors": ["ActorA", "ActorB"]},
        {"movie": "MovieB", "actors": ["ActorB", "ActorC"]},
        {"movie": "MovieC", "actors": ["ActorA", "ActorD"]},
    ]
    
    # 根据数据创建关系
    for item in movies_and_actors:
        movie = item["movie"]
        actors = item["actors"]
    
        for actor1 in actors:
            for actor2 in actors:
                if actor1 != actor2:
                    relationship_key = f"{actor1} - {actor2}"
                    relationships[relationship_key] = {"movie": movie, "relationship": "共演"}
    
    # 打印生成的关系
    for relationship, data in relationships.items():
        print(f"关系: {relationship}, 电影: {data['movie']}, 关系类型: {data['relationship']}")

    这个示例代码演示了如何根据自定义规则生成关系数据。

    步骤4:使用自然语言处理技术

    为了自动生成关系,您可以借助自然语言处理(NLP)技术。这包括命名实体识别(NER)和实体关系抽取。NER可以帮助您识别文本中的实体,例如电影名称和演员姓名。实体关系抽取则可以帮助您从文本中提取出关系信息,例如两个实体之间的合作关系或亲属关系。

    以下是一个使用spaCy库进行实体关系抽取的示例代码:

    import spacy
    
    nlp = spacy.load("en_core_web_sm")
    
    # 示例文本
    text = "ActorA and ActorB starred in the movie MovieA. ActorB also worked with ActorC in MovieB."
    
    # 使用spaCy进行实体关系抽取
    doc = nlp(text)
    
    for ent in doc.ents:
        print(f"实体: {ent.text}, 类型: {ent.label_}")
    
    for token in doc:
        if "starred" in token.text.lower() or "worked" in token.text.lower():
            subject = ""
            object_ = ""
            for child in token.head.children:
                if "Actor" in child.text:
                    subject = child.text
                elif "Actor" in token.text:
                    object_ = child.text
            print(f"关系: {subject} - {object_}, 动作: {token.text}")

    这个示例代码演示了如何使用spaCy库识别实体和关系词,并抽取实体关系。

    步骤5:存储关系数据

    一旦您通过自定义规则或NLP技术生成了关系数据,接下来就是将这些数据存储到图数据库中。图数据库是一种专门用于存储和查询图形数据的数据库类型,它们能够有效地处理节点和关系之间的复杂关联。

    以下是一个使用Neo4j图数据库存储关系数据的示例代码:

    from neo4j import GraphDatabase
    
    class RelationshipImporter:
        def __init__(self, uri, user, password):
            self._driver = GraphDatabase.driver(uri, auth=(user, password))
    
        def close(self):
            self._driver.close()
    
        def import_relationship(self, relationship_data):
            with self._driver.session() as session:
                session.write_transaction(self._create_relationship, relationship_data)
    
        @staticmethod
        def _create_relationship(tx, relationship_data):
            query = (
                "MERGE (a:Actor {name: $actor1}) "
                "MERGE (b:Actor {name: $actor2}) "
                "MERGE (a)-[:ACTED_IN {movie: $movie}]->(b)"
            )
            tx.run(query, actor1=relationship_data["actor1"], actor2=relationship_data["actor2"], movie=relationship_data["movie"])
    
    # 示例关系数据
    relationship_data = {"actor1": "ActorA", "actor2": "ActorB", "movie": "MovieA"}
    
    # 连接Neo4j数据库并导入关系数据
    importer = RelationshipImporter("bolt://localhost:7687", "neo4j", "password")
    importer.import_relationship(relationship_data)
    
    # 关闭数据库连接
    importer.close()

    这个示例代码演示了如何使用Neo4j图数据库存储关系数据。

    步骤6:验证和优化关系

    生成关系后,建议进行验证和优化。确保关系数据的准确性,并根据需要进行调整和修复。这是保持知识图谱数据质量的关键步骤。

    总结

    在知识图谱中建立关系是一个复杂但关键的过程。它需要深入的领域知识、自定义规则和NLP技术的应用。通过正确执行这些步骤,您可以构建一个丰富且有价值的知识图谱,用于更好地理解和展示各种信息之间的关系。

    关键词
  • 用有趣的方式解决Mac上Stable Diffusion的GPU和内存选择困境

    用有趣的方式解决Mac上Stable Diffusion的GPU和内存选择困境

    你好,各位读者!今天我要和大家分享一个关于在Mac上跑Stable Diffusion(SD)时的GPU和内存选择问题,以及如何以有趣的方式解决这个困扰许多人的难题。或许,在文章的最后,你会找到适合你的解决方案。

    背景故事

    故事的主人公是一个拥有N年前的MBP的人,他发现在Mac上跑SD生成一张图太慢了,于是决定进行升级。但他迷茫于应该投资38核GPU还是64GB内存。这是一个充满技术和经济考量的故事。

    GPU vs. 内存

    首先,让我们来探讨一下GPU和内存在SD中的角色。在这个AI模型中,两者都发挥着重要作用,但它们的贡献略有不同。

    GPU

    GPU是用于计算的关键部分,它负责处理模型的各种数学运算,这些运算需要大量的计算资源。更强大的GPU通常能够更快地完成计算任务,因此,如果你希望提高SD的速度,一块强大的GPU是不可或缺的。

    内存

    内存在SD中的作用也很重要。SD模型的训练和生成过程需要大量的内存来存储数据和中间结果。如果内存不足,你可能会遇到性能问题,甚至无法完成生成任务。因此,拥有足够的内存对于确保顺利运行SD非常关键。

    读者的建议

    为了获得更多见解,我翻阅了一些读者的建议,他们在讨论区分享了自己的经验和观点。

    • 有人表示,Mac上跑SD速度较慢,不建议在这个平台上进行SD生成。
    • 一位读者提到,内存需求相当大,甚至需要64GB内存,以确保运行顺畅。
    • 关于GPU的问题,有人认为Mac的GPU速度可能不如N卡,因为大多数人在SD中使用N卡来跑模型。

    我的观点

    虽然每个人的需求和预算都不同,但我认为在Mac上跑SD可能并不是最佳选择。考虑到SD的计算和内存需求,以及Mac相对较小的内存和GPU性能,你可能会在速度和稳定性方面遇到挑战。

    如果你有预算限制,我建议考虑租用GPU VPS来运行SD,这样你可以获得更好的性能和内存支持。另外,你还可以考虑使用N卡来跑SD,因为它们在性能方面通常表现更出色。

    结语

    在选择GPU和内存时,要根据你的具体需求和预算做出明智的决策。无论你选择什么配置,都要记住,SD是一个计算密集型任务,需要足够的计算资源和内存支持。

    最后,希望这篇文章能帮助你更好地理解在Mac上跑SD时的GPU和内存选择问题,并为你找到合适的解决方案。