Tag: 硬件

  • 无线路由器天线数量与性能的关系解析

    无线路由器天线数量与性能的关系解析

    无线路由器天线数量与性能的关系解析

    引言

    在如今的数字时代,无线路由器成为了我们日常生活中必不可少的一部分。然而,在选购无线路由器时,经常会遇到一个问题:天线数量究竟对性能有何影响?有人认为天线越多性能越好,有人则觉得天线数量并不是唯一的决定因素。本文将深入探讨无线路由器的天线数量与性能之间的关系,揭示其中的科学道理。

    从天线数量的变化说起

    过去,早期的无线路由器多只配备一根天线,而随着技术的进步,802.11n协议的引入带来了多天线技术的应用。然而,天线数量究竟是否决定了性能的好坏呢?不妨从实际例子来分析。

    天线数量与信号覆盖范围

    有人认为,天线越多,信号覆盖范围就越广。然而,事实上,信号覆盖范围受多种因素影响,天线数量仅仅是其中之一。根据IEEE802.11协议,信号覆盖范围的主要决定因素是发射功率,而非单纯的天线数量。工信部规定无线设备的发射功率不得高于20dBm,因此即使增加天线数量,发射功率仍受限制,信号覆盖范围的改善并非天线数量的直接结果。

    天线数量与信号强度

    另一种观点是,天线越多信号越强。然而,这种观点未必成立。对于802.11a/b/g协议,其适用范围内的天线数量并不会直接影响信号强度。信号强度受到多种因素影响,包括发射功率、传输距离、信道干扰等。因此,增加天线数量并不意味着信号强度会线性提升。

    天线数量与速度提升

    有人可能会认为,天线越多,无线路由器的速度也会提升。然而,速度的提升涉及更加复杂的技术问题。802.11n协议引入的MIMO技术(Multiple-Input Multiple-Output,多入多出技术)能够提高数据传输速率。MIMO技术利用多个天线同时传输和接收信号,从而增加了数据通路,提升了速度。然而,MIMO技术的实际效果与天线数量并非简单的线性关系,而是受到信道状态、干扰等多方面因素影响。

    多天线技术的应用

    要深入理解天线数量与性能之间的关系,我们需要探讨MIMO技术的应用。MIMO技术通过利用多个天线,实现了在多径传输环境下的性能优化。波束成型(Beamforming)和空时分组码(STBC)是MIMO技术的两个重要应用。波束成型通过调整天线的相位和振幅,将信号集中在特定方向,从而提高信号质量。空时分组码则通过在不同天线上发送不同信息,增强了数据的可靠性。然而,这些技术的实现需要复杂的算法和硬件支持,天线数量并非唯一的决定因素。

    结论

    综合以上分析,天线数量与无线路由器的性能关系并非简单的因果关系。信号覆盖范围、信号强度、速度等性能指标受到多种因素的综合影响,其中天线数量只是其中之一。在选择无线路由器时,除了考虑天线数量外,还需关注发射功率、MIMO技术的实现等因素。在实际使用中,根据具体需求选择适合的产品,更为重要。

    深入了解MIMO技术

    如果想进一步了解MIMO技术,可以探索更多关于多天线技术的知识。MIMO技术在现代通信领域中扮演着重要角色,它不仅提升了无线通信的性能,也为技术的发展带来了新的思路和挑战。深入了解MIMO技术,将有助于更好地理解无线路由器性能背后的科学原理。
  • 大型机器学习模型推理:CPU和内存的角色与要求

    大型机器学习模型推理:CPU和内存的角色与要求

    在当今的人工智能时代,大型机器学习模型如GPT-4、BERT、Transformer等在各个领域取得了令人瞩目的成绩。然而,这些模型的规模和复杂性带来了一系列推理(即模型预测)方面的挑战,尤其是在CPU和内存资源有限的环境中。本文将详细介绍大型模型推理时CPU和内存的角色和要求,以及如何优化这些资源。

    CPU与内存的基本概念

    CPU(中央处理器)

    作为电脑的“大脑”,CPU负责执行程序的指令。在机器学习模型推理过程中,CPU主要承担数据的输入/输出处理、模型参数的加载和一些无法并行化的任务。随着大型模型的崛起,对于CPU的计算能力提出了更高的要求。这些模型涉及大量的矩阵运算和复杂的数学计算,需要强大的计算能力才能在有限的时间内完成推理。因此,选择高性能的多核CPU能够有效地提升推理的速度和效率。

    内存(RAM)

    内存则是电脑的“短期记忆”,用于暂时存储正在使用或即将使用的数据和指令。大型模型通常具有大量的参数和中间状态,这些需要足够的内存来存储。在推理过程中,模型的大小、批量大小(batch size)和序列长度等因素都会影响到内存的需求。内存容量不足可能导致推理失败或速度显著减慢,因此,充足的内存对于顺利进行推理是至关重要的。

    推理中的CPU和内存要求

    大型机器学习模型的推理涉及到多方面的计算任务,其中CPU和内存的角色至关重要。

    1. 计算能力: 大型模型通常需要高性能的CPU以支持复杂的矩阵运算和并行处理。这些运算是模型推理过程中不可或缺的一部分,影响着推理的速度和准确性。在处理图像、语音、自然语言等多种数据类型时,高性能CPU能够更快地执行计算任务,从而提高模型的推理效率。

    2. 内存容量: 模型的规模、批量大小以及序列长度等因素直接影响内存需求。大型模型通常具有数以亿计的参数,同时可能涉及多个层级的计算,这些都需要大量的内存来存储中间结果和计算所需的数据。如果内存不足,可能会导致推理过程中的数据溢出或内存交换,从而影响推理的速度和准确性。因此,在进行大型模型的推理时,保证充足的内存资源是至关重要的一环。

    3. 缓存与数据传输: 在推理过程中,CPU和内存之间的高速数据传输是确保快速推理的关键。一些模型的计算过程可能需要频繁地从内存读取数据、执行计算,然后将结果写回内存。如果数据传输速度较慢,会导致CPU等待数据的时间增加,从而降低整体推理的速度。因此,在设计系统架构时,需要充分考虑数据传输的效率,以保障推理的高效性。

    优化策略

    为了充分利用CPU和内存资源,优化推理过程是必不可少的。以下是一些硬件和软件优化策略,可以提升大型模型推理的效率和性能。

    硬件优化

    • 多核CPU: 使用更多的核心可以更好地并行处理任务。多核CPU能够同时执行多个计算任务,从而提高整体的计算效率。在进行大型模型推理时,将计算任务合理分配到多个核心上,能够更快地完成推理过程。

    • 高速内存: 选择DDR4或更高级别的内存,以提供更快的数据访问速度。高速内存能够加快数据传输的速度,降低CPU等待数据的时间,从而减少推理过程中的延迟。通过提供更快的数据访问速度,可以有效地减少推理所需的时间。

    软件优化

    • 模型剪枝: 通过减少模型的大小来降低内存需求。一些模型可能存在冗余的参数或层级,可以通过模型剪枝技术来去除这些冗余部分,从而减小模型的体积。较小的模型占用较少的内存,可以更快地进行推理。

    • 批量推理: 合并多个输入样本,以减少CPU和内存的使用。批量推理技术将多个样本一起输入到模型中进行推理,从而有效地利用了CPU和内存资源。通过合并推理任务,可以减少数据传输和计算过程中的开销,提高推理的效率。

    结论

    大型模型推理是一项资源密集型任务,需要充分考虑CPU和内存的要求。通过合理的硬件配置和软件优化,可以有效地解决这些挑战,提高推理的效率和性能。选择高性能的多核CPU、高速内存以及采用模型剪枝和批量推理等策略,都能够在有限的资源下实现更快速、更高效的大型模型推理。

  • Fooocus 项目介绍与教程

    Fooocus 项目介绍与教程

    Fooocus 是一个开源的图像生成软件,由 GitHub 用户 lllyasviel 开发。该软件的设计思路受到了 Stable Diffusion 和 Midjourney 两个项目的启发。Fooocus 旨在简化用户与软件之间的交互,让用户只需关注图像生成的提示和结果,而无需手动调整复杂的技术参数。

    特点

    • 离线、开源、免费:Fooocus 是一个离线软件,完全开源并且免费。
    • 用户友好:不需要手动调整复杂的技术参数。
    • 高度自动化:内置了许多优化和质量提升的功能。
    • 简单的安装过程:从下载到生成第一张图像,所需的鼠标点击次数严格限制在 3 次以下。
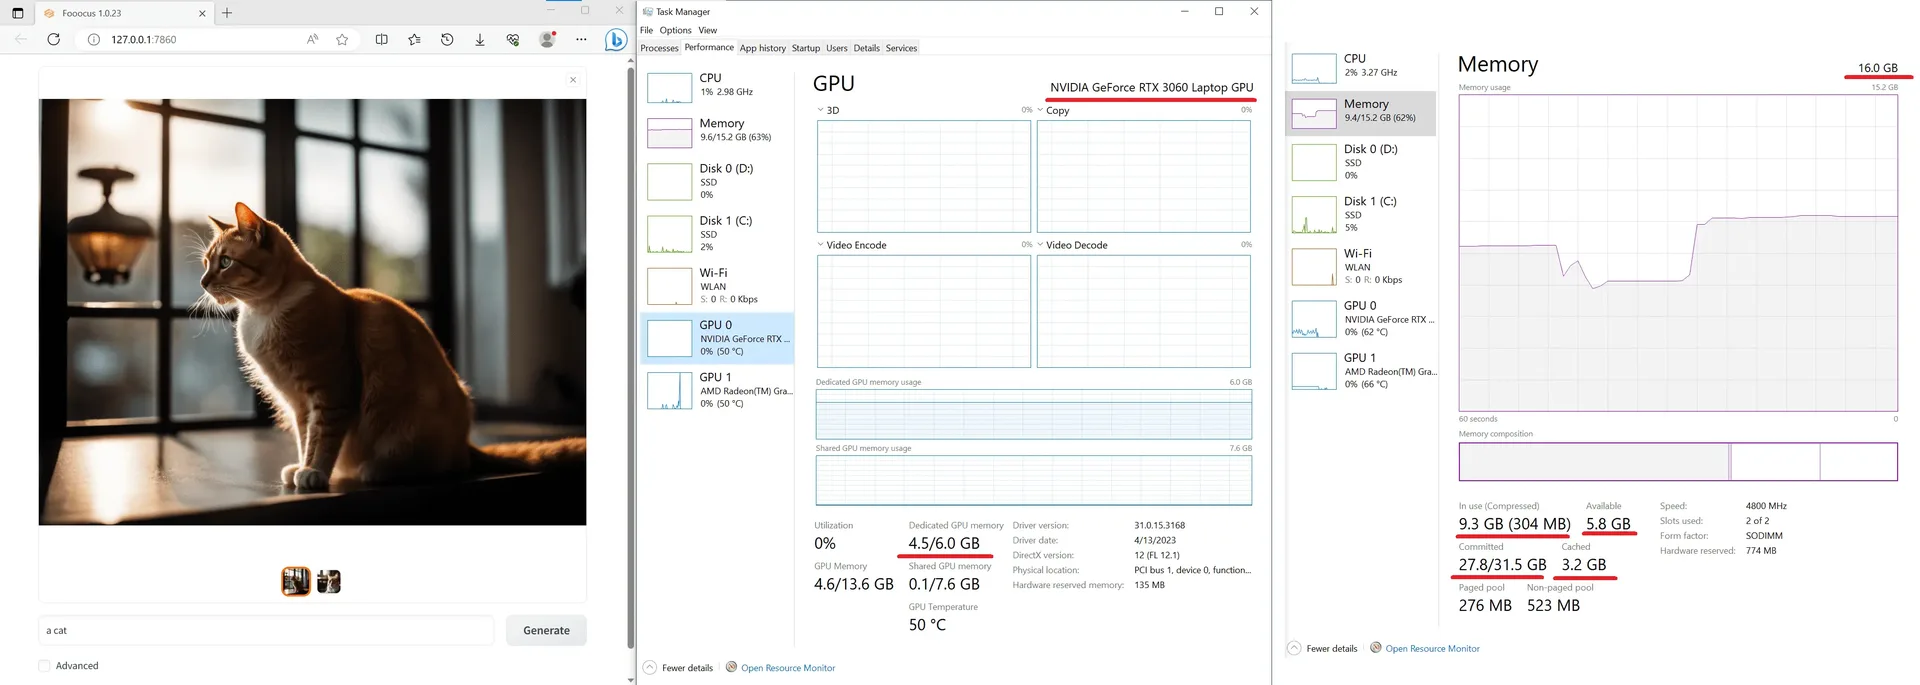
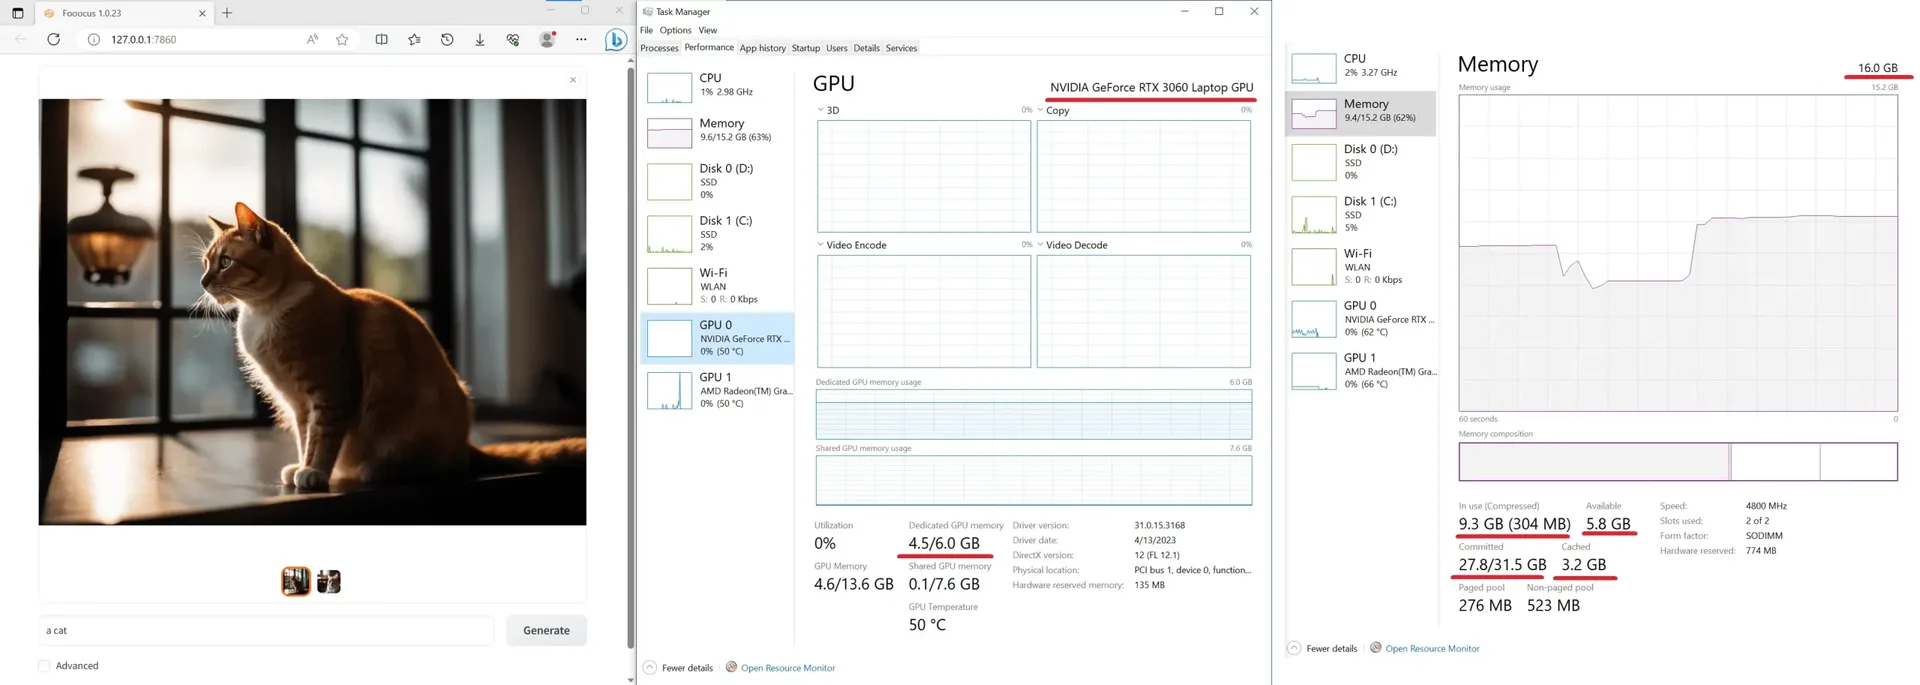
    • 最低硬件要求:最低 GPU 内存需求为 4GB(Nvidia)。

    安装与使用

    Windows 平台

    1. 下载软件:从 Fooocus GitHub 页面 下载软件包。
    2. 解压文件:解压下载的文件。
    3. 运行软件:运行 “run.bat” 文件。
    4. 下载模型:软件会自动下载所需的模型文件。

    Linux 平台

    1. 克隆仓库:git clone https://github.com/lllyasviel/Fooocus.git
    2. 进入目录:cd Fooocus
    3. 创建环境:conda env create -f environment.yaml
    4. 激活环境:conda activate fooocus
    5. 安装依赖:pip install -r requirements_versions.txt
    6. 下载模型:从指定位置下载模型或让 Fooocus 自动下载。
    7. 启动软件:python launch.py

    高级功能

    Fooocus 还开发了许多仅限于 Fooocus 的高级功能,以便高级用户获得完美的结果。具体的高级功能可以在其 GitHub 页面上查看。

    思考与展望

    1. 用户友好性与专业性如何平衡?
    2. Fooocus 与其他图像生成软件相比有哪些优势和不足?
    3. 未来,Fooocus 有哪些可能的发展方向和应用场景?
  • 探讨“开箱即用的 stable diffusion 客户端”的前景

    探讨“开箱即用的 stable diffusion 客户端”的前景

    最近,关于”开箱即用的 stable diffusion 客户端”的讨论引起了广泛的关注。针对这一话题,我们将从技术门槛、市场需求和法律合规性等方面展开探讨,以期深入了解这一概念的前景。

    开篇故事

    曾经,每当我们想要使用某项技术或软件,都需要耐心地进行一系列繁琐的初始化操作,有时甚至需要熟练的技术背景。这种情况让很多人望而却步,感受到了科技进步的阻碍。然而,近期涌现的话题引起了我们的关注——”开箱即用的 stable diffusion 客户端”。这个概念的出现似乎为我们打开了一扇全新的大门,让技术更加平民化,也引发了人们的无限遐想。

    技术门槛

    在讨论开箱即用的 stable diffusion 客户端前景时,不得不提的一个关键问题是技术门槛。目前,使用 stable diffusion (sd) 需要进行一系列繁琐的初始化操作,这在一定程度上制约了用户的使用体验。尤其是对于一些配置较低的电脑,初始化操作可能会消耗较多时间。因此,开发一个真正的开箱即用的 sd 客户端,能够让用户摆脱繁琐的操作,轻松地连接到云端镜像,将是一个巨大的技术挑战。

    技术门槛具体表现为:

    • 简化初始化过程,减少用户的等待时间。
    • 实现跨不同硬件环境的兼容性,确保用户的无缝使用体验。
    • 开发团队需要具备深厚的技术背景,能够解决技术上的各种挑战。

    这些问题需要技术团队付出持续不懈的努力,才能实现真正的开箱即用。

    市场需求

    在不少技术领域,开箱即用的产品一直备受追捧。用户不再需要繁琐的配置和操作,能够直接投入使用,极大地提升了用户体验。对于 stable diffusion,如果能够提供一个真正方便的开箱即用客户端,将吸引大量的用户,特别是那些不具备较高技术背景的用户。

    市场需求的体现:

    • 用户追求更简单、高效、快捷的技术体验,开箱即用客户端能够满足这一需求。
    • 稳定的分布式计算在数据分析、模拟计算等领域有广泛的应用前景,这增加了对开箱即用的需求。
    • 新技术的出现常常催生新市场,开箱即用的 stable diffusion 客户端有望引领分布式计算领域的发展方向。

    市场的需求将成为推动开箱即用客户端发展的动力,同时也意味着市场潜力巨大。

    法律合规性

    除了技术和市场需求,法律合规性也是开发这样一个客户端时需要考虑的重要因素。目前,一些开源项目在商业使用方面可能存在限制,使用者需要谨慎遵循相关协议。因此,开发团队需要确保他们的产品在法律上是合规的,以避免潜在的法律风险。

    法律合规性的关键点:

    • 确保产品遵守相关开源协议,不侵犯知识产权。
    • 严格遵循云端镜像和用户数据隐私的法规,保障用户的合法权益。
    • 制定数据安全和隐私保护方案,确保用户的数据不会受到侵犯。

    法律合规性不仅是对开发团队的一种要求,也是对用户权益的保障,必不可少。

    市场现状与潜在竞争

    在讨论开箱即用的 stable diffusion 客户端前景时,也不能忽视已有的竞争格局。目前已经存在一些类似的产品,例如 NovelAI、mage.space 等,它们已经在市场上建立了一定的用户基础。因此,新的客户端需要在技术创新和用户体验方面持续提供优势,以与现有竞争者区分开来。

    市场现状和竞争对手:

    • 存在一些已经成功的类似产品,新客户端需要有差异化的竞争策略。
    • 秋叶懒人包等产品已经满足了一部分开箱即用的需求,新客户端需要在易用性和功能上进一步提升。

    在市场竞争激烈的情况下,只有不断提升产品的独特性和性能,才能脱颖而出。

    结论

    综合考虑,开箱即用的 stable diffusion 客户端在技术、市场和法律方面都存在一定的挑战和机遇。尽管面临着竞争和法律合规等问题,但如果能够成功克服这些难题,开发出一个优秀的客户端,必将受到用户的热烈欢迎。在技术的驱动下,这一概念的前景可能会更加广阔。

    最终的判断将取决于开发团队的能力和决心,以及市场对这一产品的反应。无论如何,开发一个满足用户需求、具备市场竞争力并合乎法律规定的开箱即用的 stable diffusion 客户端,将为技术领域带来新的探索与发展。

  • Linux 文件内容查看编辑指南

    Linux 文件内容查看编辑指南

    在日常使用 Linux 操作系统的过程中,文件的内容查看和编辑是基本的操作技能。无论是查看配置文件、检查日志文件,还是编辑文本文件,都需要掌握一些基本的命令和工具。本指南将为您介绍一些常用的命令和工具,以及它们的用法,帮助您更加熟练地处理文件内容查看和编辑任务。

    1. cat 命令

    概述

    cat 命令是连接文件并将其内容打印到标准输出设备的命令。它可以用于快速查看文件的内容,也可以将多个文件合并输出到一个文件中。

    用法示例

    • 显示文件内容:cat file1
    • 合并多个文件:cat file1 file2
    • 重定向文件内容:cat file1 > newfile

    cat 命令的简单性使它成为快速查看文件内容的好工具。

    2. head 命令

    概述

    head 命令用于显示文件的开头内容,默认显示文件的前 10 行内容。

    用法示例

    • 显示文件的前 10 行内容:head file
    • 显示文件的前 20 行内容:head -n 20 file

    head 命令适用于查看文件的开头部分,特别适合于查看文件的文件头信息。

    3. tail 命令

    概述

    tail 命令用于显示文件的尾部内容,默认显示文件的最后 10 行内容。它常用于实时查看日志文件。

    用法示例

    • 显示文件的最后 10 行内容:tail file
    • 从第 20 行开始显示文件的内容:tail -n +20 file
    • 实时监视并显示日志文件的新增内容:tail -f logfile

    tail 命令对于查看文件的尾部信息或实时监控日志非常有用。

    4. more 和 less 命令

    概述

    more 和 less 都是用于分屏显示文件内容的命令,适合查看较长的文件。它们支持键盘操作,可以翻页、搜索等。

    more 的用法示例

    • 逐页显示文件内容:more file
    • 清屏并显示文件百分比:more -dc file

    less 的用法示例

    • 分屏显示文件内容,支持交互操作:less file

    more 和 less 命令适用于查看长文本文件,可以更灵活地浏览文件内容。

    5. sed 命令

    概述

    sed 是一个强大的流编辑器,它可以用来编辑文件内容,支持正则表达式等高级操作。

    用法示例

    • 替换文件中的字符串:sed 's/pattern/replace/' file
    • 打印文件的第 1 到 5 行内容:sed -n '1,5p' file
    • 删除匹配模式的行:sed '/pattern/d' file

    sed 命令提供了丰富的文本编辑功能,可以用于批量处理文件内容。

    6. vi 编辑器

    概述

    vi 是一种全屏幕文本编辑器,适用于编辑各种类型的文件。在 Linux 系统中,通常会使用 vim,它是 vi 的增强版,提供了更多功能和快捷键。

    用法示例

    • 打开文件进行编辑:vi filename
    • 进入插入模式:按 i
    • 退出插入模式:按 Esc
    • 保存并退出:输入 :wq

    vi 或 vim 是文本编辑的利器,熟练掌握它们将提高您的编辑效率。

    7. grep 命令

    概述

    grep 是一个强大的文本搜索工具,可以使用正则表达式搜索文件内容,并将匹配的行打印出来。

    用法示例

    • 在文件中搜索匹配模式的行:grep "pattern" file
    • 忽略大小写搜索:grep -i "pattern" file
    • 在目录中递归搜索匹配模式的行:grep -r "pattern" dir

    grep 命令是查找文本中特定内容的首选工具,对于日常的文本搜索非常有用。

    总结

    Linux 提供了丰富的文件内容查看和编辑工具,根据不同的需求,可以选择合适的命令来实现操作。无论是查看文件内容、编辑配置文件,还是搜索特定模式,都可以通过这些命令轻松完成任务。记住它们的基本用法,将有助于提高你在 Linux 系统中的工作效率。

  • 个人电脑运行 LLaMA AI 模型的最佳配置(GPU、CPU、RAM、SSD)

    个人电脑运行 LLaMA AI 模型的最佳配置(GPU、CPU、RAM、SSD)

    在当今数字时代,人工智能技术正在以前所未有的速度不断发展,自然语言处理领域的语言模型也不例外。LLaMA AI模型是这个领域中备受瞩目的模型之一,但要充分发挥其潜力,您需要构建一台配置合理的计算机。本指南将介绍如何选择最佳的GPU、CPU、RAM和SSD,以确保您的LLaMA模型能够高效运行。

    背景故事

    假设您正在进行一项重要的深度学习项目,该项目需要使用LLaMA AI模型来处理大规模的自然语言文本数据。您已经了解到,LLaMA模型具有不同的变体,每个变体都有不同的性能和硬件要求。因此,为了确保您的计算机系统能够顺利运行LLaMA模型,您需要深入了解如何选择适合您的需求的GPU、CPU、RAM和SSD。

    选择GPU

    LLaMA模型对GPU的选择至关重要,因为GPU是影响推理速度的关键组件。不同的LLaMA模型具有不同的VRAM(显存)要求,以下是一些推荐的GPU示例:

    模型 最小VRAM要求 推荐GPU示例
    LLaMA-7B 6GB RTX 3060, GTX 1660, 2060, AMD 5700 XT, RTX 3050
    LLaMA-13B 10GB AMD 6900 XT, RTX 2060 12GB, 3060 12GB, 3080, A2000
    LLaMA-30B 20GB RTX 3080 20GB, A4500, A5000, 3090, 4090, 6000, Tesla V100, Tesla P40
    LLaMA-65B 40GB A100 40GB, 2×3090, 2×4090, A40, RTX A6000, 8000

    根据您计划运行的LLaMA模型,选择具备足够VRAM容量的GPU非常关键。如果GPU的VRAM容量不足,可能会导致性能下降或无法运行模型。因此,务必选择满足或超过模型VRAM要求的GPU,以确保顺畅的性能。

    选择CPU

    除了GPU,您还需要一台性能强劲的CPU,它可以支持GPU运行并处理其他任务。以下是一些适用于LLaMA的优秀CPU示例:

    • Intel Core i9-10900K
    • Intel Core i7-12700K
    • AMD Ryzen 9 5900x

    但如果您追求更高的性能,您可以考虑选择像AMD Ryzen Threadripper 3990X这样的CPU,它拥有64个核心和128个线程。在选择CPU时,考虑核心数、线程数和计算性能,以确保它能够满足LLaMA模型的需求。

    需要注意的是,LLaMA还提供了专为CPU优化的模型,如GGML。如果您更喜欢使用CPU进行推理,您可以选择使用GGML格式的模型文件,并借助名为llama.cpp的软件来充分发挥CPU性能。

    内存(RAM)需求

    除了GPU和CPU,您还需要足够的RAM(随机存取内存)来存储模型参数和数据。不同的LLaMA模型对RAM的需求不同,以下是一些示例:

    模型 最小RAM要求 推荐RAM容量
    LLaMA-7B 6GB 8GB或更多
    LLaMA-13B 10GB 16GB或更多
    LLaMA-30B 20GB 32GB或更多
    LLaMA-65B 40GB 64GB或更多

    根据您选择的LLaMA模型和数据集的大小,选择足够的RAM非常重要。如果RAM不足,可能会导致数据交换到磁盘,从而降低性能。因此,建议选择具备足够RAM容量的计算机配置,以满足您的需求。

    存储(SSD)

    LLaMA的最低存储需求为1TB NVMe SSD,这可以存储模型文件和数据文件,并具有快速的读写速度。但如果您处理大规模数据或需要大容量的备份,您可能需要更大容量的SSD,如2TB或4TB的SSD。

    选择高速存储是至关重要的,最好选择具备出色顺序读写速度的PCIe 4.0 NVMe SSD,以便在存储和系统RAM之间实现快速数据传输。这将有助于提高数据加载和处理速度,从而提高整体性能。

    模型量化如何影响GPU的选择?

    模型的量化级别(如4位、8位、16位等)对GPU的选择具有重要影响。不同精度的LLaMA模型需要不同的GPU配置,以下是一个总结:

    LLaMA的精度 GPU内存需求 计算需求 适用GPU
    原生(32位) 较高要求 更高的计算需求 具备大VRAM容量和高计算性能的GPU
    16位量化 适度要求 适度的计算需求 具备适度VRAM容量和良好计算性能的GPU
    8位量化 相对较高要求 稍高的计算需求 具备较大VRAM容量和较高计算性能的GPU
    4位量化 较低要求 较低的计算需求 具备有限VRAM容量的GPU

    总的来说,4位量化的LLaMA模型更为高效,可以在VRAM容量较低的GPU上平稳运行,而8位量化的模型需要较大的VRAM容量和较高的计算能力的GPU。

    最适合您的量化级别将取决于您的具体需求。如果您需要一个小而高效的模型,那么4位或8位量化可能是不错的选择。但如果您需要高度准确的模型,那么16位模型可能更适合。

    结论

    通过选择适合您的LLaMA模型的GPU、CPU、RAM和SSD配置,您可以充分发挥这一强大的自然语言处理工具的性能。请根据您的项目需求和预算来选择最佳配置,以确保您的LLaMA模型能够高效运行,帮助您取得成功。

  • Stable Diffusion WEBUI版本更新,修复内存泄露的BUG

    Stable Diffusion WEBUI版本更新,修复内存泄露的BUG

    你是否曾经遇到过在使用Stable Diffusion(Stable Diffusion WEBUI)时生成失败导致的内存泄漏问题?或者,你是否对这一先进的深度学习模型的性能有更高的期望?如果是的话,那么你一定会对Stable Diffusion 1.5.2 版本的更新感到兴奋。在这个版本中,开发团队致力于解决内存泄漏问题,并对性能进行了优化。本文将为您详细介绍这一重要的更新。

    更新故事

    在深入探讨 1.5.2 版本的具体更新之前,让我们来了解一个真实的故事。假设您是一位热衷于艺术创作的深度学习爱好者,您一直在使用Stable Diffusion来生成令人惊叹的艺术作品。然而,您在一次生成过程中遇到了一个问题,模型的性能下降,最终导致了内存泄漏,使得您的计算机变得异常缓慢,甚至崩溃。这一经历可能让您感到沮丧,但现在,有了Stable Diffusion 1.5.2 版本的更新,您可以放心继续您的创作旅程,因为开发团队已经为您解决了这个问题。

    1.5.2 版本的关键修复

    Stable Diffusion 1.5.2 版本带来了一系列重要的修复和优化,其中最引人注目的是对内存泄漏问题的修复。以下是这个版本中的关键修复:

    1. 修复了在生成失败时出现内存泄漏的问题

    内存泄漏是深度学习应用中常见的问题之一,它可能会导致系统资源不断被消耗,最终导致系统不稳定甚至崩溃。Stable Diffusion 1.5.2 版本针对生成失败时出现的内存泄漏问题进行了彻底修复,保证了模型在执行失败时不再泄漏内存,从而提高了系统的稳定性。

    2. 对 doggettx 跨注意力(cross-attention)优化进行了更新

    在深度学习中,跨注意力是一种关键技术,它有助于模型更好地理解不同部分之间的关联。在 1.5.2 版本中,对于跨注意力的优化得到了更新,以在某些边缘情况下不使用不合理的内存量。这一更新是基于来自 MorkTheOrk 的宝贵建议,进一步提升了模型的性能。

    次要更新

    除了关键修复之外,1.5.2 版本还引入了一些次要更新,以提升系统的整体性能和稳定性:

    1. 新模块 devices 引入

    在 modules/call_queue.py 中引入了新模块 devices,用于更好地管理设备信息。这个更新有助于更精确地控制模型在不同设备上的运行。

    2. 新增 devices.torch_gc() 方法

    devices 模块中新增了 torch_gc() 方法,用于清理 PyTorch 的垃圾收集。这个方法可以帮助您及时释放不再需要的内存,提高系统的资源利用效率。

    3. 共享状态变量更新

    共享状态变量被更新,以更准确地表示任务状态。这个改进有助于提高系统的响应速度和稳定性,确保任务状态得到及时更新。

    4. 异常记录更详细

    在 modules/errors.py 中引入了 sysinfo 模块,使得异常记录更为详细。现在,异常记录将包括系统信息,这将有助于更准确地诊断问题,提高故障排查的效率。

    5. 对切片大小进行了调整

    在 modules/sd_hijack_optimizations.py 中对切片大小进行了调整,确保不会因为内存不足而导致运行时错误。这个更新有助于提高模型的稳定性,避免不必要的中断。

    6. 张量运算优化

    sd_hijack_optimizations.py 模块还对 einsum 和 softmax 进行了优化,以更精确地处理张量运算。这个优化有助于提高模型的性能,使其更高效地执行计算任务。

    7. 对异常和跟踪的格式化优化

    在 modules/sysinfo.py 中对异常和跟踪的格式化进行了优化,使其更易于理解和分析。更新了 get_exceptions() 方法,现在能更详细地获取异常记录,有助于开发人员更快速地定位和解决问题。

    总结

    在Stable Diffusion 1.5.2 版本中,开发团队不仅解决了内存泄漏等关键问题,还对系统的性能和稳定性进行了多项优化。特别感谢 MorkTheOrk 的宝贵建议,使我们能够更好地优化内存使用。同时,异常处理和系统信息模块的完善,为用户提供了更准确的诊断信息,有助于更快速地解决问题。

    如果您是深度学习爱好者或研究人员,不妨尝试Stable Diffusion 1.5.2 版本,体验其带来的性能提升和稳定性增强。这一版本的更新将有助于您更轻松地进行深度学习实验和创作。

    Stable Diffusion 1.5.2 版本的发布,标志着该项目在持续改进和发展。随着更多用户的反馈和贡献,我们有信心未来会有更多令人期待的版本发布,为深度学习社区带来更多创新和可能性。

    最后,请记得定期检查官方网站以获取最新版本和更新信息,以确保您始终使用的是最优化的Stable Diffusion版本。

  • 如何在 Windows 上安装 Docker Deskto

    如何在 Windows 上安装 Docker Deskto

    在今天的数字化世界中,容器技术已经成为了开发和部署应用程序的标准方式之一。Docker 是最受欢迎的容器平台之一,它可以帮助开发者更轻松地打包、分发和运行应用程序,而且在 Windows 上也有很好的支持。本教程将教您如何在 Windows 10 或 Windows 11 专业版/企业版上安装 Docker Desktop,以便开始使用 Docker 容器。

    1. 先决条件

    在开始安装 Docker Desktop 之前,确保您满足以下先决条件:

    • Windows 10 或 Windows 11 专业版/企业版 64位,内部版本号至少为 21H2(您可以在 “设置” – “关于” 中查看内部版本号)。
    • 硬件虚拟化支持必须在 BIOS 设置中开启。
    • 安装 WSL 2,需要 Windows 10 21H2 或更高版本。
    • 至少 4GB 内存。
    • 若要运行 Windows 容器,需要 Windows 10 或 Windows 11 专业版或企业版,不能用于 Windows 家庭版或教育版。

    确保您的系统满足这些要求后,就可以开始安装 Docker Desktop 了。

    2. 下载 Docker Desktop 安装程序

    首先,您需要下载适用于 Windows 的 Docker Desktop 安装程序。您可以在 Docker 官网 上找到最新版本的安装程序。点击下载并保存到您的计算机。

    3. 安装 Docker Desktop

    双击下载的 Docker Desktop 安装程序(通常为 Docker Desktop Installer.exe)来运行安装程序。

    在安装过程中,您将看到配置页面,可以选择要使用的后端,通常有两种选择:WSL 2 或 Hyper-V。如果您的系统只支持其中一种后端,您将无法选择。选择后端后,继续按照安装向导的提示进行操作。

    安装程序会要求您授权,按照提示完成授权和安装过程。一旦安装成功,您会看到安装完成的提示,点击关闭以完成安装。

    4. 启动 Docker Desktop

    安装完成后,请注意,Docker Desktop 不会自动启动。您可以按照以下方式手动启动它:

    • 在 Windows 搜索栏中搜索 “Docker”,然后选择 “Docker Desktop”。
    • 在开始菜单中找到 “Docker Desktop” 并启动它。

    5. Docker Desktop 订阅服务协议

    启动 Docker Desktop 后,您将看到订阅服务协议的提示。请注意以下事项:

    • 对于少于 250 员工且年收入少于 1000 万美元的小公司、个人学习用途等,可以免费使用 Docker Desktop。
    • 对于其他情况,需要付费订阅才能用于商业用途,包括政府机构。
    • 您必须选择接受协议才能继续使用 Docker Desktop。

    请根据您的使用情况选择相应的选项,并按照协议的要求进行操作。

    6. 接下来的步骤

    恭喜您,您已成功在 Windows 上安装了 Docker Desktop!现在,您可以开始学习如何使用 Docker,以下是一些资源,可以帮助您更深入地了解 Docker 和 Docker Desktop:

    通过这些资源,您将能够更好地利用 Docker 在 Windows 上进行开发和部署应用程序。祝您使用愉快!

  • 在Windows上安装Docker桌面版:专业教程

    在Windows上安装Docker桌面版:专业教程

    本教程提供了下载链接,系统需求信息,以及如何在Windows上安装Docker Desktop的详细指导。

    Docker Desktop for Windows

    校验和:参见发布说明

    Docker Desktop使用条款

    超过250名员工或年收入超过1,000万美元的大企业使用Docker Desktop需要购买付费订阅。

    系统需求

    • WSL 2后端
    • Hyper-V后端和Windows容器
      • WSL版本1.1.3.0或更高。
      • Windows 11 64位:Home或Pro版本21H2或更高,或企业或教育版21H2或更高。
      • Windows 10 64位:Home或Pro 21H2(构建19044)或更高,或企业或教育版21H2(构建19044)或更高。

    请按照微软的官方文档启用WSL 2功能。

    硬件前提条件

    • 64位处理器与第二级地址转换(SLAT)
    • 4GB系统RAM
    • BIOS级硬件虚拟化支持必须在BIOS设置中打开。

    注意

    Docker仅支持那些仍在微软服务时间范围内的Windows版本。

    关于Windows容器

    如需使用Windows容器的详细信息,您可以查阅Docker网站上的相关文章和博客。

    注意

    要运行Windows容器,您需要Windows 10或Windows 11的专业版或企业版。

    在Windows上安装Docker Desktop

    交互式安装

    1. 双击Docker Desktop Installer.exe运行安装程序。
    2. 根据您的后端选择,在配置页面上确保选中“使用WSL 2而不是Hyper-V”选项。
    3. 按照安装向导的指示授权安装程序并继续安装。
    4. 安装成功后,选择“关闭”以完成安装过程。

    命令行安装

    在下载了Docker Desktop Installer.exe之后,在终端运行以下命令来安装Docker Desktop:

    $ "Docker Desktop Installer.exe" install

    可用的安装标志

    • --quiet:运行安装程序时抑制信息输出
    • --accept-license:现在就接受Docker订阅服务协议,而不是在第一次运行应用程序时接受
    • --no-windows-containers:禁用Windows容器集成

    启动Docker Desktop

    Docker Desktop在安装后不会自动启动。要启动Docker Desktop,请搜索Docker,并在搜索结果中选择Docker Desktop。

    注意

    如果您不同意条款,Docker Desktop将不会运行。

    以上即为在Windows上安装Docker Desktop的专业教程,希望能为您提供所需的所有信息和指导。如有其他疑问或需求,请随时联系我们。

  • CDN技术解析:加速内容交付与提升网站性能

    CDN技术解析:加速内容交付与提升网站性能

    随着网络应用的日益普及,内容交付的效率和速度成为了各类网站和应用关注的重点。内容交付网络(Content Delivery Network,简称CDN)作为一项关键技术,正逐渐改变着互联网的现实。本文将深入探讨CDN的背景、功能以及它如何为网站和应用提供高效、可靠的内容交付服务。

    什么是CDN?

    内容交付网络(CDN)是一种分布式的服务器群,位于全球各地,用于缓存和分发互联网上的各种资源。这些资源包括HTML页面、JavaScript文件、样式表、图像和视频等。CDN旨在通过就近分发数据,加速内容加载,提供更优质的用户体验。

    CDN的功能

    1. 提供高速内容加载

    CDN通过将内容缓存在离用户更近的服务器上,实现了就近访问。这样一来,用户从CDN服务器获取资源的速度更快,从而显著减少了加载时间。用户体验的提升不仅可以留住访问者,还有助于提高网站的转化率和用户满意度。

    2. 减少带宽成本

    传统的服务器托管可能面临带宽消耗成本较高的问题。CDN的存在可以分担大量的带宽流量,降低了源服务器的负担,从而降低了网站所有者的托管成本。

    3. 增强网站的可用性和冗余

    高流量和硬件故障可能导致服务器宕机,影响网站的正常运行。CDN的分布式性质使得它能够更好地承受大流量和硬件故障,提供更稳定的服务。即使某台CDN服务器故障,其他服务器仍然可以继续提供服务,保证了网站的可用性。

    4. 提高内容安全性

    CDN可以提供一系列安全性措施,例如分布式拒绝服务(DDoS)攻击缓解、SSL/TLS加密等,以保护网站免受恶意攻击和数据泄露。这些安全性措施使得网站更加可信和安全。

    如何使用CDN?

    1. 负载均衡和就近分发

    CDN的核心是服务器网络,位于互联网交换点(IXP)的位置。CDN通过将服务器放置在全球不同的IXP位置,实现负载均衡和就近分发。用户请求将被引导至离他们更近的CDN服务器,从而提高了内容加载速度。

    2. 数据优化和压缩

    CDN不仅仅是缓存服务器,它还可以通过数据压缩和最小化等策略,减小文件的大小,从而降低传输的数据量,进一步提升加载速度。这种优化对于移动设备和低带宽环境下的用户尤其重要。

    3. 高级安全性和冗余

    CDN提供商通常具备高级的安全性措施,如DDoS攻击缓解、SSL证书的支持等,保障内容的安全。此外,CDN的分布式特性使其具备高度冗余性,即使某个数据中心出现故障,也能够自动切换到其他可用的数据中心,保障内容交付的稳定性。

    CDN的前景与挑战

    CDN作为提高内容交付效率的关键技术,未来具有广阔的发展前景。随着5G网络的普及和应用场景的不断扩展,用户对于高速、低延迟的网络体验的需求将持续增加,这为CDN技术提供了更大的市场空间。

    然而,CDN技术也面临一些挑战。例如,如何更好地适应复杂多样的网络环境,如何保证数据安全性和隐私保护,以及如何在高负载和高并发的情况下维持稳定的服务等,都是需要持续研究和创新的领域。

    结论

    CDN技术的兴起,为互联网内容交付带来了革命性的变化。它通过就近分发、带宽优化、内容安全性等方面的优势,为网站和应用提供了高效、可靠的内容交付服务。随着互联网的不断发展,CDN技术也将不断创新和完善,为用户创造更好的上网体验。