Tag: 网络

  • nobepay诺贝虚拟信用卡新卡段上线-支持chatgpt订阅和openai api支付

    nobepay诺贝虚拟信用卡新卡段上线-支持chatgpt订阅和openai api支付

    在数字化时代,金融领域不断创新,虚拟信用卡成为了许多人的首选支付方式。正当我们探讨这个话题时,nobepay诺贝虚拟信用卡闪亮登场,让我们一同深入了解这个备受欢迎的欧洲卡段「474362、474359」,以及它在全球范围内的应用。这是一个汇总了AMAZON、WALMART、CHATGPT SUBSCRIPTION、FACEBK、OPENAI、GOOGLE、MIDJOURNEY、APPLE.COM、EBAY、ALIEXPRESS、ETSY、TIKTOK、TARGET.COM等众多知名平台的推荐,绝对值得一试。

    Nobepay 最新注册邀请码和注册邀请链接

    Nobepay的界面设计简洁明了,操作流程易于理解。即使您对虚拟信用卡不太熟悉,也可以轻松上手。无需繁琐的设置,只需几步操作,您就可以完成支付,享受便捷的购物体验。

    如果您想尝试Nobepay,并获得额外的优惠,我们为您提供了以下邀请码和注册链接:

    Nobepay邀请码:BAAB0A1
    邀请链接:Nobepay注册链接
    nobepay(诺贝虚拟卡)新卡段与支持的服务一览

    平台 卡段
    AMAZON 404038 441112 474362
    WALMART 556766 441112 474362
    CHATGPT SUBSCRIPTION 404038 559666 556150
    FACEBK 556766 559666 483317
    OPENAI 556167 556766 489607
    GOOGLE 531993 474359 556766
    MIDJOURNEY 556150 441112 559666
    APPLE.COM 556766 531993 404038
    EBAY 447420 441112 404038
    ALIEXPRESS 436797 474362 556766
    ETSY 474362 553231 556371
    TIKTOK 436797 556167 556766
    TARGET.COM 556766 474359 474362

    nobepay诺贝虚拟信用卡:什么是它?

    nobepay诺贝虚拟信用卡是一种创新的金融工具,它允许用户在全球范围内进行安全、便捷的消费。与传统信用卡不同,nobepay诺贝虚拟信用卡不需要AVS(地址验证系统),并提供3DS(三维安全)功能,进一步增强了交易的安全性。这意味着用户可以更自由地在网络上购物,而不必担心付款过程中的风险。

    nobepay诺贝虚拟信用卡的应用领域

    nobepay诺贝虚拟信用卡的应用领域广泛多样,以下是一些主要的应用场景:

    1. AMAZON购物:nobepay诺贝虚拟信用卡支持AMAZON,为用户提供便捷的在线购物体验。

    2. WALMART超市购物:无论是食品、日用品还是家居用品,nobepay诺贝虚拟信用卡都可以在WALMART上使用。

    3. CHATGPT SUBSCRIPTION订阅:如果你是ChatGPT的用户,nobepay诺贝虚拟信用卡可以方便地支付订阅费用。

    4. FACEBK广告投放:FACEBK广告是推广业务的重要方式,nobepay诺贝虚拟信用卡支持FACEBK支付,助力您的营销活动。

    5. OPENAI技术咨询:对于科技爱好者和专业人士,nobepay诺贝虚拟信用卡可以用于支付OPENAI的咨询费用。

    6. GOOGLE广告投放:想要在谷歌上投放广告?nobepay诺贝虚拟信用卡支持,助您推广业务。

    7. MIDJOURNEY旅行预订:计划旅行?nobepay诺贝虚拟信用卡可在MIDJOURNEY上用于预订机票和酒店。

    8. APPLE.COM苹果官网购物:nobepay诺贝虚拟信用卡可以在APPLE.COM上购买您喜欢的苹果产品。

    9. EBAY在线购物:无论您是买家还是卖家,nobepay诺贝虚拟信用卡都是便捷的支付方式。

    10. ALIEXPRESS购物:购物狂欢节?nobepay诺贝虚拟信用卡在ALIEXPRESS上等待您的光临。

    11. ETSY手工艺品购买:支持艺术家和手工艺品制作者,nobepay诺贝虚拟信用卡可以在ETSY上购物。

    12. TIKTOK广告投放:nobepay诺贝虚拟信用卡可以用于TIKTOK广告费用支付,助您的业务快速成长。

    13. TARGET.COM购物:TARGET.COM提供各种商品,nobepay诺贝虚拟信用卡让您的购物更便捷。

    为什么选择nobepay诺贝虚拟信用卡?

    nobepay诺贝虚拟信用卡之所以备受欢迎,有着以下几个显著优势:

    • 全球通用:nobepay诺贝虚拟信用卡支持的卡段「474362、474359」在欧洲以及全球范围内广泛可用,使用户可以畅通无阻地进行国际消费。

    • 免AVS,支持3DS:nobepay诺贝虚拟信用卡不需要进行AVS(地址验证系统),但同时支持3DS(三维安全),提供高级别的安全性。

    • 广泛应用场景:nobepay诺贝虚拟信用卡可以在众多知名平台上使用,包括电子商务、社交媒体、科技咨询等多个领域。

    • 便捷支付:使用nobepay诺贝虚拟信用卡,用户可以轻松、便捷地完成支付,不再受制于传统信用卡的限制。

    • 隐私保护:nobepay诺贝虚拟信用卡使用加密通讯工具,保护用户的隐私和数据安全,使用户可以放心使用。

    结语

    nobepay诺贝虚拟信用卡的出现,为全球消费者提供了更多的支付选择,无论您是购物达人、广告主还是科技爱好者,都可以从中受益。其全球通用性、安全性和便捷性使其成为当今数字化时代的一大亮点。如果您正在寻找一种更灵活、更安全的支付方式,不妨考虑nobepay诺贝虚拟信用卡。

    最后,希望这篇文章能帮助您更好地了解nobepay诺贝虚拟信用卡,为您的消费体验带来更多便捷与安全。如果您对此有任何疑问或想要了解更多信息,请随时联系我们。愿您的生活更加便捷、多彩!
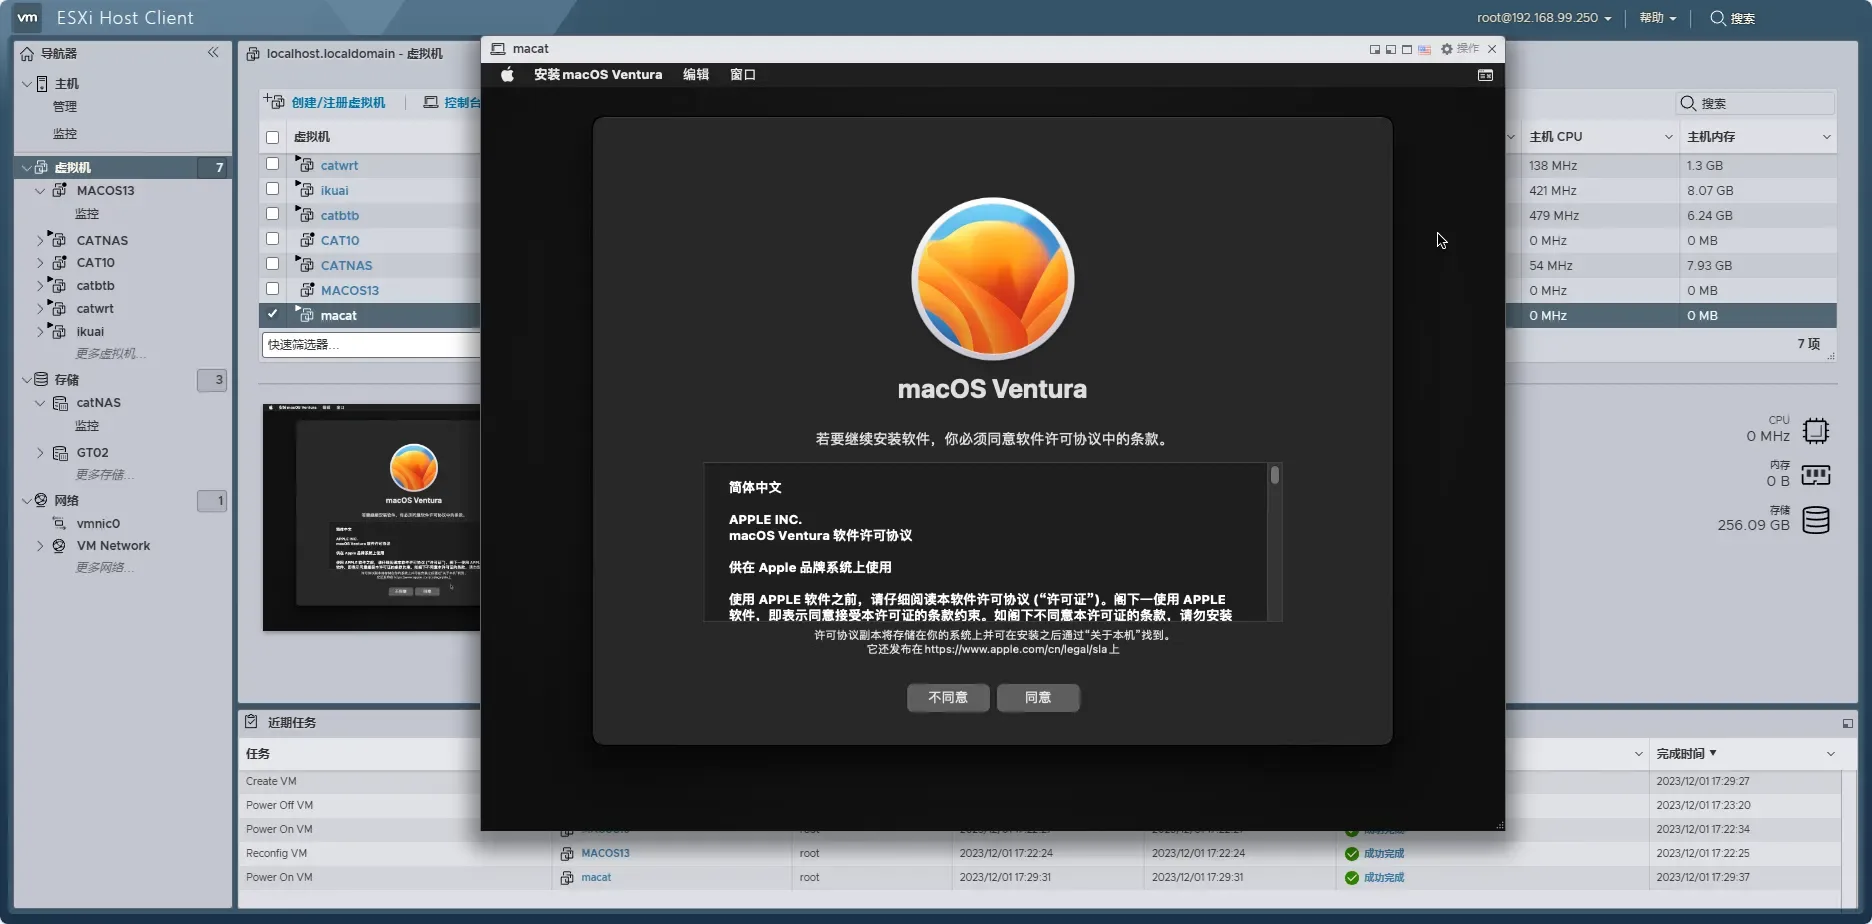
  • 在VMware ESXi上创建MacOS 13 Ventura虚拟机教程

    在VMware ESXi上创建MacOS 13 Ventura虚拟机教程

    如果你想在VMware ESXi上创建一个运行MacOS 13 Ventura的虚拟机,你来对地方了。本教程将指导你一步一步完成这个过程,确保你可以成功地运行MacOS Ventura虚拟机。让我们开始吧!

    教程目录

    1. 下载和配置ESXi

      • 下载MacOS Ventura .iso文件
      • 下载VMware ESXi的Unlocker
      • 下载WinSCP
      • 解压Unlocker并重命名文件夹
      • 登录ESXi web界面
      • 启用SSH服务
      • 运行WinSCP并连接到ESXi主机
      • 复制解压后的Unlocker文件夹到ESXi主机
      • 通过SSH连接到ESXi主机
      • 安装ESXi Unlocker
    2. 创建Ventura虚拟机

      • 登录ESXi web界面
      • 创建/注册虚拟机
      • 配置虚拟机参数,包括命名、操作系统设置、存储和网络配置
      • 挂载MacOS安装ISO文件
    3. 安装MacOS Ventura

      • 启动虚拟机并开始安装过程
      • 格式化虚拟硬盘并安装MacOS Ventura
      • 进行初始设置,包括语言、地区和帐户配置
    4. 安装VMware Tools(可选)

      • 下载MacOS Unlocker for VMware Workstation
      • 挂载darwin.iso到虚拟机的CD/DVD驱动器
      • 在虚拟机内运行VMware Tools安装程序

    开篇故事

    有一天,王大神在远程工作的时候,突然产生了一个想法:在自己的VMware ESXi主机上创建一个MacOS 13 Ventura虚拟机,以便进行一些特定的开发和测试工作。他知道这不是一个简单的任务,但他充满了决心。在经过一番研究和实践后,他成功地创建了这个虚拟机,现在,他将与大家分享如何实现这一壮举。

    第一步:下载和配置ESXi

    1. 下载MacOS Ventura .iso文件

    首先,你需要从合法的渠道下载MacOS Ventura的.iso安装文件。确保你获得了官方版本,以避免任何问题。

    2. 下载VMware ESXi的Unlocker

    接下来,你需要下载适用于VMware ESXi的Unlocker,这个工具将允许你在ESXi上运行MacOS虚拟机。确保从可信赖的来源获取Unlocker。

    3. 下载WinSCP

    为了传输文件到ESXi主机,你可以使用WinSCP。这个工具将帮助你在本地计算机和ESXi主机之间安全地传输文件。

    4. 解压Unlocker并重命名文件夹

    下载并解压Unlocker文件后,将解压得到的文件夹重命名为”unlocker”,以方便后续操作。

    5. 登录ESXi web界面

    使用你的ESXi主机的IP地址和管理员凭证登录ESXi web界面。

    6. 启用SSH服务

    在ESXi web界面中,选择”Actions”,然后选择”Services”,接着启用Secure Shell (SSH)服务。这将允许你通过SSH连接到ESXi主机。

    7. 运行WinSCP并连接到ESXi主机

    启动WinSCP并连接到你的ESXi主机的IP地址。这将为你提供一个安全的文件传输通道。

    8. 复制解压后的Unlocker文件夹到ESXi主机

    使用WinSCP将之前重命名的”unlocker”文件夹复制到ESXi主机的/root目录下。

    9. 通过SSH连接到ESXi主机

    打开SSH客户端,连接到你的ESXi主机,确保你可以执行后续的命令。

    10. 安装ESXi Unlocker

    在SSH连接中,执行以下命令来安装ESXi Unlocker:

    # 切换到unlocker目录
    cd /unlocker
    # 授予安装脚本执行权限
    chmod +x ./esxi-install.sh
    # 运行安装脚本
    ./esxi-install.sh
    # 重启ESXi主机
    reboot

    完成这些步骤后,你的ESXi主机将准备好在其中创建MacOS Ventura虚拟机。

    第二步:创建Ventura虚拟机

    1. 登录ESXi web界面

    使用之前的管理员凭证登录ESXi web界面。

    2. 创建/注册虚拟机

    在左侧导航窗格中,右键点击”Virtual Machines”,然后选择”Create/Register VM”。

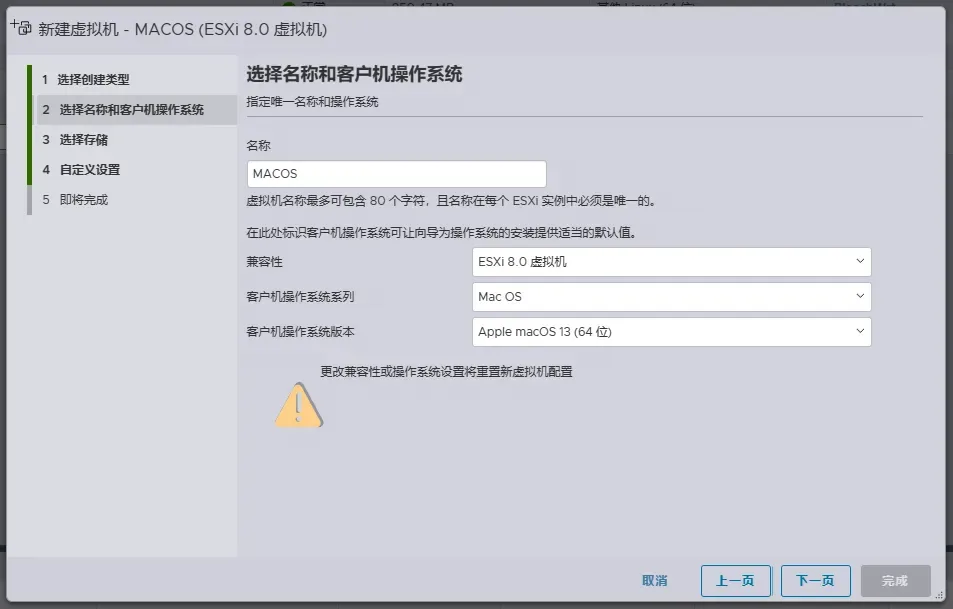
    2.1 一定要看,不看装不上。

    请仔细阅读,这里的解锁文件是我自己更新了,所以支持ESXI8.0和Apple Mac 13 64镜像。如果你是ESXI8.0 用了github的解锁文件,请在安装的时候选择ESXI 7.0 U2,用MAC 12 安装。!

    3. 配置虚拟机参数

    • 选择”Create a new virtual machine”,然后点击”Next”。
    • 给虚拟机命名为”MacOS 13″。
    • 设置Guest OS family为”Mac OS”,Guest OS Version为”Apple MacOS 13 (64-bit)”。
    • 选择存储数据存储。
    • 设置内存为至少4096MB,硬盘1大小为50GB或更大。
    • 扩展网络设置,将Adapter Type设置为”VMXNET 3″。
    • 扩展CD/DVD Drive 1,确保选择了Datastore ISO文件,然后点击CD/DVD Media字段旁边的”Browse”。
    • 上传MacOS安装ISO文件,上传完成后,点击MacOS ISO文件以高亮显示,然后点击”Select”。
    • 在Hardware customization屏幕上点击”Next”。
    • 检查提供的摘要信息,然后点击”Finish”。
    • 在页面顶部点击新创建的”MacOS 13″虚拟机,然后点击”Power on”。

    现在,你已经成功创建了一个MacOS 13 Ventura虚拟机。

    第三步:安装MacOS Ventura

    一旦虚拟机启动,将会开始MacOS Ventura的安装过程。

    1. 选择语言

    选择一个语言,然后点击下一步箭头。

    2. 选择Disk Utility

    选择Disk Utility来管理硬盘。

    3. 格式化硬盘

    在Disk Utility中,选择VMware Virtual SATA Hard Drive Media,然后点击”Erase”。给硬盘命名为”MacOS”,设置格式为”APFS”,然后点击”Erase”。

    4. 关闭Disk Utility

    完成硬盘格式化后,点击”Done”,然后关闭Disk Utility。

    5. 安装MacOS Ventura

    点击”Install macOS Ventura”,然后按照安装向导的指示继续。这将包括选择你的国家、语言和键盘布局,设置一些基本选项,并创建用户帐户。

    6. 完成设置

    按照安装向导的步骤,完成MacOS Ventura的安装设置。

    现在,你已经成功在你的ESXi主机上安装了MacOS Ventura虚拟机!

    第四步:安装VMware Tools(可选)

    如果你需要更好的性能和集成体验,可以安装VMware Tools。

    1. 下载MacOS Unlocker for VMware Workstation

    下载MacOS Unlocker for VMware Workstation,并解压下载的.zip文件。

    2. 挂载darwin.iso

    在ESXi web界面中,选择左侧导航菜单中的”Storage”,然后点击主内容窗格顶部的Datastore browser图标。点击”Upload”,然后选择由MacOS Unlocker下载的darwin.iso文件。上传完成后,点击”Close”关闭Datastore浏览器。

    3. 配置虚拟机

    在ESXi web界面中,选择”Storage”,然后点击”Datastore browser”图标。点击”Upload”,然后选择由MacOS Unlocker下载的darwin.iso文件。上传完成后,点击”Close”关闭Datastore浏览器。

    4. 安装VMware Tools

    在虚拟机内部,双击挂载的VMware Tools并运行安装程序。

    现在,你已经完成了在VMware ESXi上创建MacOS 13 Ventura虚拟机的整个过程!

    结语

    通过本教程,你已经学会了如何在VMware ESXi上创建和配置MacOS 13 Ventura虚拟机。这将为你提供一个灵活的开发和测试环境,以便进行各种工作。请记住,确保你遵循所有合法和许可要求,并尊重知识产权。

    希望这个教程对你有所帮助,祝你在使用MacOS Ventura虚拟机时取得成功!

  • WebDAV视频播放全攻略:NPlayer Plus应对新挑战

    WebDAV视频播放全攻略:NPlayer Plus应对新挑战

    曾几何时,NPlayer Plus是我们心中的不二选择,无论是本地还是WebDAV视频源,它总能完美应对。但近期,随着版本更新,一些用户开始遭遇WebDAV视频无法播放的问题。这不仅仅是一个播放器的问题,它关系到我们日常生活中的数字娱乐体验。想象一下,在你准备好爆米花,安顿好心情,准备享受一部精彩影片时,却发现视频无法播放,这是多么令人沮丧的体验。因此,解决NPlayer Plus播放WebDAV视频的问题,不仅是技术上的挑战,更是对数字生活品质的维护。

    问题诊断与解决方案

    诊断WebDAV连接问题

    首先,我们需要确认问题的根源。根据用户反馈,问题可能出现在HTTPS协议的WebDAV连接上。为此,我们可以采用以下步骤进行诊断:

    1. 确认网络连接稳定性。
    2. 检查WebDAV服务器设置,确保没有错误。
    3. 尝试使用HTTP连接代替HTTPS,观察是否能正常播放。
    4. 查看NPlayer Plus的更新日志,了解最新版本是否有相关的问题说明。
    - 如果问题依旧,建议尝试以下解决方案。

    更新与回退版本

    有时候最新版本的播放器可能会带来新的bug,这时候我们可以考虑回退到之前的版本。

    1. 寻找可靠的资源下载旧版本的NPlayer Plus。
    2. 使用第三方工具(如爱思助手)将旧版本安装到设备上。
    3. 确认旧版本是否解决了播放问题。

    注意: 回退版本可能会失去一些新功能或安全修复,需要权衡利弊。

    寻找替代播放器

    如果上述方法都不能解决问题,我们可以考虑使用其他播放器。

    1. Infuse:虽然价格较高,但用户体验良好。
    2. Vidhub:界面与Infuse类似,目前还免费,可以尝试。
    3. 其他社区推荐的播放器:多参考用户评论和评分,选择适合自己需求的播放器。

    用户体验优化建议

    字幕和播放控制

    对于NPlayer Plus的使用者来说,字幕显示问题和播放控制的不便是常见的痛点。

    1. 尝试手动加载字幕文件,确保字幕格式与视频兼容。
    2. 在设置中调整字幕显示选项,比如字体大小、颜色等。
    3. 给开发者反馈,期待官方能够在后续版本中加入长按加速等功能。
    - 用户反馈是推动产品改进的重要力量,不要吝啬你的声音。

    结语:适应变化,享受数字生活

    技术的更新换代总是伴随着一些不适,但正是这些挑战推动了我们不断探索和进步。面对NPlayer Plus播放WebDAV视频的问题,我们不仅提供了具体的解决方案,还探讨了如何优化用户体验。记住,无论是回退旧版本,还是尝试新的播放器,关键在于找到最适合你的方式,享受流畅的数字生活。

  • 如何在Cloudflare解析记录中配置多个IP地址

    如何在Cloudflare解析记录中配置多个IP地址

    在互联网上,域名解析是一个关键的过程,它将人类可读的域名转换为计算机可理解的IP地址,从而使我们能够访问网站和在线服务。Cloudflare是一个流行的域名解析和安全服务提供商,它允许你为你的域名配置解析记录,将域名映射到一个或多个IP地址。在本教程中,我们将学习如何在Cloudflare解析记录中配置多个IP地址,以实现负载均衡和高可用性。

    步骤1:登录到Cloudflare帐户

    首先,确保你已经创建了Cloudflare帐户并将你的域名添加到Cloudflare。登录到你的Cloudflare帐户并选择要配置的域名。

    步骤2:选择解析记录

    在Cloudflare控制面板中,找到并点击“解析”或“DNS”选项,以进入域名解析设置页面。

    步骤3:配置多个IP地址

    现在,我们将详细介绍如何配置多个IP地址。在解析设置页面,你可以看到现有的解析记录列表。要配置多个IP地址,你可以使用A记录或CNAME记录。

    配置多个IP地址使用A记录

    A记录是一种将域名映射到IPv4地址的记录类型。要配置多个IP地址,你可以创建多个A记录,每个记录映射到一个不同的IP地址。以下是具体步骤:

    1. 点击“添加记录”按钮,选择“A”记录类型。
    2. 在“名称”字段中输入子域名,例如“auth”。
    3. 在“IPv4地址”字段中输入第一个IP地址,例如“127.0.0.1”。
    4. 点击“保存”按钮来创建第一个A记录。
    5. 重复步骤1到步骤4,创建另一个A记录,将其映射到另一个IP地址,例如“127.0.0.2”。

    现在,你的域名“auth.example.com”将映射到两个不同的IP地址,分别是“127.0.0.1”和“127.0.0.2”。

    配置多个IP地址使用CNAME记录

    CNAME记录是一种将域名映射到另一个域名的记录类型。要配置多个IP地址,你可以使用CNAME记录将子域名映射到具有多个A记录的目标域名。以下是具体步骤:

    1. 点击“添加记录”按钮,选择“CNAME”记录类型。
    2. 在“名称”字段中输入子域名,例如“auth”。
    3. 在“目标”字段中输入目标域名,该域名已经配置了多个A记录,例如“target.example.com”。

    现在,你的域名“auth.example.com”将被映射到“target.example.com”,而“target.example.com”已经配置了多个A记录,从而实现了多个IP地址的负载均衡。

    步骤4:保存并生效更改

    无论你选择使用A记录还是CNAME记录,完成配置后,不要忘记点击“保存”或“更新”按钮来保存更改。Cloudflare将自动将新的解析记录传播到全球的DNS服务器上,使你的域名解析生效。

    结论

    通过在Cloudflare解析记录中配置多个IP地址,你可以实现负载均衡和高可用性,确保你的域名能够始终保持在线和响应迅速。无论你选择使用A记录还是CNAME记录,都可以根据你的需求来配置多个IP地址,以满足你的业务需求。

    希望这个教程能够帮助你成功配置Cloudflare解析记录,实现多个IP地址的负载均衡。如果你有任何问题或需要进一步的帮助,可以查阅Cloudflare的文档或联系他们的支持团队。

  • 如何配置网络以实现笔记本访问PVE虚拟机网络?

    如何配置网络以实现笔记本访问PVE虚拟机网络?

    在现代的工作环境中,网络配置对于保持生产力和协作至关重要。一位用户提出了一个关于网络配置的问题,他需要让自己的笔记本能够访问PVE(Proxmox Virtual Environment)服务器上的虚拟机,同时又要解决IP地址有限的问题。让我们来探讨一下如何实现这一需求,以及是否有更便捷的方式来配置网络。

    开篇故事

    故事背景设定在一个需要高度灵活性和资源共享的工作环境中。用户在PVE服务器上托管了一些开发所需的软件,同时也需要让自己的笔记本能够轻松访问PVE网络中的虚拟机。然而,由于IP地址有限的限制,他们面临着一些挑战。目前已知的方法是通过PVE创建一个虚拟网桥并进行NAT(Network Address Translation)网络配置。但这种方法需要手动添加端口转发规则,对于访问内部虚拟机的服务(如MySQL)可能比较繁琐。用户在提问中是否有更便捷的方式,这是一个常见但也很重要的问题。

    问题与解决方案

    问题一:如何实现笔记本访问PVE虚拟机网络?

    这个问题涉及到如何让笔记本与PVE虚拟机建立连接。最常见的方法是通过PVE创建一个虚拟网桥,使得虚拟机可以与外部网络通信。但这种配置可能需要手动添加端口转发规则,对于多个虚拟机和多个服务的情况可能变得复杂。解决这个问题的一种方法是使用10.0.0.x网段的IP地址,但这可能会受到地址冲突的影响。

    问题二:如何解决IP地址有限的问题?

    IP地址有限是一个常见的问题,特别是在需要大量设备连接到同一个网络时。解决这个问题的方法之一是使用不同的IP地址网段,如10.0.1.x,这样可以扩展可用的IP地址范围。另一种方法是在上级路由器或交换机上进行配置,以支持更多的IP地址分配。

    问题三:是否有更便捷的网络配置方式?

    有一些更便捷的网络配置方式可以考虑。一种思路是给PVE宿主(服务器)添加一个额外的无线局域网(WLAN)网卡或USB网卡,并创建一个热点,仅供自己使用。这种方式可以保持网络的相对稳定性,并且仅在需要时进行访问。另外,也可以考虑使用一些虚拟专用网络工具,如Tailscale或Zerotier,来构建虚拟网络,以解决IP地址有限的问题。

    总结

    网络配置是现代工作环境中不可或缺的一部分,但也可能带来一些挑战。对于需要让笔记本访问PVE虚拟机网络的用户来说,选择合适的网络配置方式至关重要。无论是通过虚拟网桥和端口转发,还是使用不同的IP地址网段,都需要根据具体情况来进行选择。另外,也可以考虑一些更便捷的网络工具和解决方案,以提高网络配置的效率和灵活性。

  • iPhone 15 Pro 4K视频卡顿问题排查与解决

    iPhone 15 Pro 4K视频卡顿问题排查与解决

    在现代数字娱乐时代,人们期望能够轻松流畅地观看高分辨率的4K视频,尤其是在家庭网络环境中。然而,有时我们会遇到问题,即使网络似乎足够快,但视频仍然卡顿,影响了观看体验。本文将深入探讨一位用户遇到的具体问题,即iPhone 15 Pro在连接到局域网时观看4K视频时的卡顿问题,并提供可能的解决方法。

    排查问题

    确认网络连接

    首先,让我们确认网络连接。作者已经明确表示,iPhone 15 Pro连接到了5GHz频段的WiFi,距离路由器只有1米左右,没有物理遮挡。这确保了足够的信号强度和稳定性,通常不应该导致视频卡顿。

    考虑视频解码和播放器

    iPhone 15 Pro作为一款高性能智能手机,通常具备处理4K视频的能力。然而,播放4K视频需要不仅是网络带宽,还需要适当的解码和播放器支持。作者提到他使用的播放器是Infuse,配置为仅使用SMB v3协议连接到NAS。

    可能的问题之一是播放器对SMB协议的性能问题。一些用户已经报告了Infuse在使用SMB协议时性能较差的情况。在这种情况下,可以考虑尝试其他支持WebDAV协议的播放器或应用程序,因为WebDAV在某些情况下可能提供更好的性能。

    服务器端问题

    作者提到他的NAS运行Windows Server 2022,并启用了SMB共享。尽管作者认为服务器端可能不是问题的原因,但我们不能完全排除这个可能性。有时,服务器端的SMB设置可能导致性能问题,尤其是当SMB版本不匹配或受到限制时。建议作者检查服务器端的SMB设置,确保其性能最优化。

    试用其他协议

    另一个可能的解决方案是尝试使用其他协议,例如FTP或WebDAV。作者提到他将尝试使用FTP协议进行测试,尽管他认为SMB更加方便。然而,不同协议在性能方面可能会有所不同,因此这是一个值得尝试的选项。

    结论

    尽管网络和硬件配置看起来足够支持4K视频播放,但卡顿问题可能是由于播放器的性能问题、服务器端设置或协议选择引起的。为了解决这个问题,建议作者尝试以下步骤:

    1. 考虑更换播放器:尝试使用其他支持WebDAV协议的播放器或应用程序,以查看是否有改善。

    2. 检查服务器设置:确保服务器端的SMB设置没有限制性能,并且与客户端兼容。

    3. 尝试其他协议:考虑尝试使用FTP或WebDAV等其他协议,以查看是否可以提高性能。

    在解决问题之前,理解问题的根本原因非常重要,这将有助于更有效地解决问题并提高4K视频观看的体验。

  • 多线程端口扫描教程

    多线程端口扫描教程

    网络安全是当今数字化时代中至关重要的一部分。为了确保网络的安全性,网络管理员和安全专家需要经常检查主机的开放端口,以便及时发现潜在的漏洞。端口扫描是一种常见的网络安全操作,它可以帮助识别哪些端口是开放的,哪些是关闭的。本教程将介绍如何使用Python编程语言创建一个多线程端口扫描工具,帮助您快速而有效地扫描目标主机上的开放端口。

    创建多线程端口扫描工具

    首先,让我们来了解如何创建一个多线程端口扫描工具。我们将使用Python编程语言和一些常见的库来完成这个任务。

    import socket
    import threading

    1. 准备工作

    在开始之前,您需要了解一些基本的准备工作:

    • 目标主机的IP地址:您需要知道要扫描的目标主机的IP地址。
    • 起始端口和结束端口:您需要指定要扫描的端口范围,通常从40000到65535。
    • 线程数量:您可以选择使用多少个线程来加速扫描。

    2. 端口扫描函数

    我们首先创建一个端口扫描函数PortScan,该函数接受目标主机IP地址、起始端口、结束端口和线程数量作为参数。该函数将返回一个包含开放端口的列表。

    def PortScan(target_ip, start_port=40000, end_port=65535, num_threads=16):
        open_ports = []
        thread_list = []
    
        def scan_ports(ip, start, end):
            local_open_ports = []
            for port in range(start, end + 1):
                try:
                    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as s:
                        s.settimeout(0.001)
                        result = s.connect_ex((ip, port))
                        if result == 0:
                            local_open_ports.append(port)
                except KeyboardInterrupt:
                    break
                except Exception as e:
                    pass
            open_ports.extend(local_open_ports)
    
        ports_per_thread = (end_port - start_port + 1) // num_threads
        for i in range(num_threads):
            thread_start_port = start_port + i * ports_per_thread
            thread_end_port = thread_start_port + ports_per_thread - 1
    
            thread = threading.Thread(target=scan_ports, args=(target_ip, thread_start_port, thread_end_port))
            thread.start()
            thread_list.append(thread)
        for thread in thread_list:
            thread.join()
    
        return open_ports

    3. 使用端口扫描工具

    在完成端口扫描函数后,您可以使用它来扫描目标主机上的开放端口。以下是如何使用端口扫描工具的示例代码:

    if __name__ == "__main__":
        target_ip = "127.0.0.1"
    
        print(f"开始多线程扫描 {target_ip} 上的端口...")
        open_ports = PortScan(target_ip)
    
        if open_ports:
            print(f"开放的端口:{open_ports}")
        else:
            print("没有开放的端口。")

    使用多线程端口扫描工具

    现在,让我们来学习如何使用这个多线程端口扫描工具:

    1. 设置目标主机和端口范围

    在使用工具之前,您需要设置目标主机的IP地址和要扫描的端口范围。将目标主机的IP地址分配给target_ip变量,然后根据需要指定起始端口和结束端口的范围。

    target_ip = "127.0.0.1"
    start_port = 40000
    end_port = 65535

    2. 运行端口扫描

    使用PortScan函数来运行端口扫描。该函数将返回一个包含开放端口的列表。

    open_ports = PortScan(target_ip, start_port, end_port)

    3. 处理扫描结果

    检查open_ports列表,如果其中有开放的端口,您可以对其进行进一步的处理,例如记录到日志文件或执行其他安全操作。

    if open_ports:
        print(f"开放的端口:{open_ports}")
    else:
        print("没有开放的端口。")

    总结

    本教程介绍了如何使用Python创建一个多线程端口扫描工具,用于快速扫描目标主机上的开放端口。通过使用多线程,我们可以加速扫描过程,提高效率。网络安全是一个不断演化的领域,定期扫描端口是确保网络安全的重要步骤之一。希望本教程对您在网络安全方面的工作有所帮助。

  • 如何运用AI技术提升远程办公效率

    如何运用AI技术提升远程办公效率

    远程办公,作为一种灵活自由的工作方式,正变得越来越流行。对于像我这样充满热情的自由职业者来说,远程办公为我提供了无限的灵活性,但同时也带来了一些挑战。在这篇文章中,我们将探讨如何运用AI技术来提升远程办公的效率,从而更好地适应这个新的工作方式。

    背景故事:远程办公的崛起

    在过去的几年里,远程办公已经成为了工作的一种全新范式。随着技术的不断发展,越来越多的公司和个人选择远程工作,这不仅提供了更多的自由度,还能够节省通勤时间和成本。正是在这个背景下,我作为一个自由职业者,深深感受到了远程办公的魅力。

    利用AI技术进行远程会议优化

    远程办公中最重要的环节之一就是远程会议。无论是与团队成员协作还是与客户交流,远程会议都是必不可少的。然而,远程会议也面临一些问题,比如通信不畅、语言障碍和时间差等。这时,AI技术可以发挥重要作用。

    AI实时翻译

    AI实时翻译工具可以帮助跨语言沟通变得更加轻松。不再需要担心语言障碍,AI翻译可以在会议期间提供实时翻译服务,确保每个人都能理解和参与讨论。这种技术不仅提高了会议的效率,还促进了跨文化交流。

    会议自动记录和摘要

    AI技术还可以用于会议的自动记录和摘要生成。无需再手动记录会议内容,AI可以将会议的重要信息记录下来,并生成精炼的摘要,这样参与者可以更容易地回顾会议内容,避免遗漏重要细节。

    AI助手提高工作效率

    除了远程会议,AI技术还可以在日常工作中提高效率。作为一个自由职业者,我常常需要处理各种任务,包括编程、设计和方案撰写。以下是一些方式,可以利用AI助手提高工作效率。

    自动化重复性任务

    AI可以用于自动化重复性任务,节省时间和精力。例如,可以编写脚本来处理大量数据,或者使用AI设计工具来快速创建图形和界面。这些自动化工具可以加快工作进程,使工作更高效。

    智能建议和提醒

    AI助手可以提供智能建议和提醒,帮助我更好地管理我的日程安排。它可以根据我的工作习惯和优先事项,提供最佳的时间安排建议,以确保我能够高效地完成任务。

    数据安全和隐私保护

    在远程办公中,数据安全和隐私保护至关重要。随着越来越多的工作在云端进行,确保敏感信息不被泄露变得尤为重要。AI技术可以帮助加强数据安全。

    自动加密和访问控制

    AI可以自动对数据进行加密,并提供访问控制,只允许授权人员访问敏感信息。这可以有效防止未经授权的访问和数据泄露。

    威胁检测和预警

    AI还可以用于威胁检测和预警系统。它可以分析网络活动,及时发现异常行为,并提供警报,以便迅速采取行动应对潜在的威胁。

    结论

    远程办公已经成为现代工作的一部分,而AI技术则为远程办公提供了许多工具和解决方案,帮助我们提高工作效率,克服挑战,保护数据安全。正如我作为一个自由职业者所体验到的那样,远程办公和AI技术的结合将继续推动工作方式的演变。

    在未来,随着AI技术的不断发展,我们可以期待更多创新的解决方案,使远程办公变得更加高效和便利。作为对未来充满信心的自由职业者,我将继续学习和成长,不断探索如何更好地利用AI技术,为自己的工作和生活带来更多的可能性。

  • 如何使用Python爬取豆瓣电影Top250数据并保存为CSV文件

    如何使用Python爬取豆瓣电影Top250数据并保存为CSV文件

    在今天的数字时代,数据是一种宝贵的资源。对于电影爱好者和数据分析师来说,豆瓣电影Top250是一个有趣的数据源,可以用于各种目的,如了解热门电影、分析评分趋势、或者简单地为电影夜晚挑选电影。本教程将介绍如何使用Python编程,爬取豆瓣电影Top250的数据,并将数据保存为CSV文件。这个教程将向您展示如何发送HTTP请求、解析网页内容以及保存数据,是一个实际的网络爬虫示例。

    准备工作

    在开始之前,您需要确保已经安装了以下Python库:

    • Requests:用于发送HTTP请求和获取网页内容。
    • Parsel:用于解析HTML和XPath选择器。

    您可以使用以下命令来安装这些库:

    pip install requests parsel

    发送HTTP请求

    首先,我们需要发送HTTP请求到豆瓣电影Top250的网页。我们将使用Python的Requests库来发送GET请求,并模拟浏览器的User-Agent以防止被网站屏蔽。以下是发送HTTP请求的代码示例:

    import requests
    
    # 定义请求头
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/105.0.0.0 Safari/537.36'
    }
    
    # 发送GET请求
    url = 'https://movie.douban.com/top250'
    response = requests.get(url, headers=headers)

    在上述代码中,我们定义了一个请求头,模拟了浏览器的User-Agent,并使用Requests库发送了GET请求。得到的response对象包含了网页的内容。

    解析网页内容

    接下来,我们需要解析网页的内容,提取我们需要的信息。我们将使用Parsel库来解析HTML和XPath选择器。以下是解析网页内容的代码示例:

    import parsel
    
    # 创建一个Selector对象
    selector = parsel.Selector(response.text)
    
    # 使用XPath选择器提取信息
    titles = selector.xpath('//*[@class="info"]/div[@class="hd"]/a/span[1]/text()').getall()
    intros = selector.xpath('//*[@class="info"]/div[@class="bd"]/p[@class="quote"]/span/text()').getall()
    ratings = selector.xpath('//*[@class="info"]/div[@class="bd"]/div/span[@class="rating_num"]/text()').getall()

    在上述代码中,我们首先创建了一个Selector对象,然后使用XPath选择器提取了电影的标题、简介和评分信息。这些信息将用于创建CSV文件。

    创建CSV文件

    现在,我们将提取的电影信息保存为CSV文件。我们使用Python的CSV库来创建和写入CSV文件。以下是创建CSV文件的代码示例:

    import csv
    
    # 打开CSV文件并写入标题行
    with open("豆瓣top250.csv", mode="w", encoding="utf_8_sig", newline='') as f:
        csv_writer = csv.writer(f)
        csv_writer.writerow(['片名', '简介', '评分'])
    
    # 将电影信息写入CSV文件
    with open("豆瓣top250.csv", mode="a", encoding="utf-8_sig", newline='') as f:
        csv_writer = csv.writer(f)
        for i in range(len(titles)):
            csv_writer.writerow([titles[i], intros[i], ratings[i]])

    在上述代码中,我们首先打开CSV文件并写入标题行,然后使用循环将电影信息逐行写入CSV文件。

    运行脚本

    最后,您可以运行这个Python脚本来爬取豆瓣电影Top250的数据并保存为CSV文件。确保您已经安装了必要的库,并且能够成功发送HTTP请求并解析网页内容。

    if __name__ == '__main__':
        # 发送HTTP请求、解析网页内容和保存CSV文件的代码

    结论

    通过本教程,您学会了如何使用Python编程,爬取豆瓣电影Top250的数据并保存为CSV文件。这是一个实际的网络爬虫示例,可以帮助您了解如何发送HTTP请求、解析网页内容以及保存数据。希望这个教程对您有所帮助,让您能够更好地处理和分析网络数据。


    请注意:在进行网络爬取时,请遵守网站的使用规则和法律法规,不要对网站造成不必要的负担或侵犯他人的权益。

  • 如何使用Python将彩票数据存入数据库

    如何使用Python将彩票数据存入数据库

    在数据科学和分析领域,获取和存储数据是至关重要的一步。本教程将介绍如何使用Python编程,从一个网站获取双色球(SSQ)彩票的历史数据,并将这些数据存入MySQL数据库。这个教程将向您展示如何使用Python的Requests库来获取数据,以及如何使用Pymysql库将数据存入数据库中。这是一个非常实用的示例,可以帮助您了解如何从网站爬取数据并进行数据库操作。

    准备工作

    在开始之前,您需要确保已经安装了以下Python库:

    • Requests:用于发送HTTP请求和获取网页内容。
    • Pymysql:用于与MySQL数据库交互。

    您可以使用以下命令来安装这些库:

    pip install requests pymysql

    此外,您还需要拥有一个MySQL数据库,并知道连接数据库所需的主机、用户名和密码。在教程的后续部分,我们将向数据库插入数据。

    获取彩票数据

    首先,我们需要从一个网站获取双色球彩票的历史数据。我们将使用Python的Requests库来发送HTTP POST请求,并将响应解析为JSON格式。以下是获取数据的代码示例:

    import requests
    import json
    
    headers ={
        'Content-Type': 'application/json',
        'User-Agent': 'Mozilla/5.0 (iPhone; CPU iPhone OS 15_6 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Mobile/15E148'
    }
    
    data ={
        "limit": 20,
        "page": 1,
        "params": {}
    }
    
    resp = requests.post('https://ms.zhcw.com/proxy/lottery-chart-center/history/SSQ', headers=headers, data=json.dumps(data))
    result = json.loads(resp.text)['datas']

    在上述代码中,我们发送了一个HTTP POST请求到指定的URL,并将响应解析为JSON格式。这个URL包含了彩票数据的API端点,您可以根据需要修改URL来获取不同的数据。

    处理彩票数据

    接下来,我们需要处理从网站获取的彩票数据,以便将其存入数据库。我们将数据存储在一个列表中,每个元素都代表一期彩票的信息,包括期号、开奖日期、星期几以及中奖号码。我们还对数据进行了排序,以确保按期号的顺序存入数据库。

    def historyData():
        h_data_list = []
        for i in range(len(result)):
            issue = result[i]['issue']
            openDate = result[i]['openDate']
            week = result[i]['week']
            winningFrontNum = result[i]['winningFrontNum']
            winningBackNum = result[i]['winningBackNum']
            h_data_list.append([issue, openDate, week,winningFrontNum,winningBackNum])
        h_data_list = sorted(h_data_list, key=lambda x: x[0])  # 从小到大排序

    连接数据库并创建表

    现在,我们将使用Pymysql库来连接到MySQL数据库,并创建一个表来存储彩票数据。在下面的代码示例中,您需要替换掩码字符(****)为您的数据库主机、用户名和密码。

    import pymysql
    
    # 连接数据库
    conn = pymysql.connect(host='****', user='root', password='***', db='mysql')
    cursor = conn.cursor()
    
    # 创建表
    cursor.execute('''CREATE TABLE IF NOT EXISTS ssq_lottery_history
                      (id INT PRIMARY KEY AUTO_INCREMENT,
                       issue VARCHAR(20),
                       openDate VARCHAR(20),
                       week VARCHAR(20),
                       winningFrontNum VARCHAR(20),
                       winningBackNum VARCHAR(20)
                       )''')

    在上述代码中,我们使用Pymysql库连接到数据库,并执行SQL语句来创建表格。如果表格已经存在,它将不会被重新创建。

    插入数据到数据库

    现在,我们将彩票数据插入到数据库表中。以下是将数据插入数据库的代码示例:

    # 向表中插入数据
    for item in h_data_list:
        cursor.execute('''INSERT INTO ssq_lottery_history (issue, openDate, week,winningFrontNum,winningBackNum)
                          VALUES (%s, %s, %s, %s, %s)''', (item[0], item[1], item[2], item[3], item[4]))
    print("存入数据库成功")
    # 提交数据并关闭连接
    conn.commit()
    cursor.close()
    conn.close()

    在上述代码中,我们使用循环遍历彩票数据列表,并将每一项数据插入到数据库表中。然后,我们提交更改并关闭数据库连接。

    运行脚本

    最后,您可以运行这个Python脚本来获取彩票数据并将其存入数据库。确保您已经准备好了数据库,并且在运行脚本之前替换了数据库连接的主机、用户名和密码。

    if __name__ == '__main__':
        historyData()

    结论

    通过本教程,您学会了如何使用Python编程从网站获取彩票数据,并将其存入MySQL数据库。这是一个实际的应用示例,可以帮助您了解如何使用Python的Requests库和Pymysql库来处理网络数据和数据库操作。希望这个教程对您有所帮助,让您能够更好地处理和管理数据。


    请注意:本教程仅供学习和参考,不鼓励或支持任何侵犯法律或道德准则的行为。请在合法范围内使用Python编程技术。