
Tag: AI

  • 使用Dotnet SDK为OpenAI ChatGPT、Whisper、GPT-4和DALL·E创建项目

    使用Dotnet SDK为OpenAI ChatGPT、Whisper、GPT-4和DALL·E创建项目

    想象一下,您正在进行一个充满创意和潜力的项目,该项目需要与OpenAI的强大AI模型进行交互,以实现各种令人惊叹的功能。这个项目可能是一个聊天机器人,一个创造性的图像生成工具,或者一个可以执行各种任务的智能应用程序。无论您的项目是什么,都可以利用Dotnet SDK为OpenAI的ChatGPT、Whisper、GPT-4和DALL·E等模型构建。

    项目背景

    在开发这个Dotnet SDK之前,OpenAI没有官方的.NET SDK可供使用。这就是为什么Betalgo.OpenAI这个非官方库诞生的原因。这个库旨在让.NET开发人员能够更轻松地与OpenAI的各种模型进行交互,包括ChatGPT、Whisper、GPT-4和DALL·E等。无论您是想构建一个智能聊天应用、生成创造性的图像还是执行其他任务,这个SDK都可以为您提供便捷的工具和方法。

    SDK特性

    这个Dotnet SDK为开发人员提供了一系列功能,使其能够更好地与OpenAI的各种模型进行集成。以下是一些主要特性:

    • 聊天GPT:您可以使用SDK与ChatGPT进行交互,构建智能聊天机器人或应用程序。通过发送消息并接收响应,您可以轻松地创建对话式用户体验。

    • Whisper:如果您的项目需要进行语音处理或生成语音内容,Whisper模型可以派上用场。SDK支持与Whisper的集成,让您能够处理语音数据。

    • GPT-4:最新的GPT-4模型也得到了支持。您可以使用SDK与GPT-4进行交互,让您的项目能够获得更强大的文本生成能力。

    • DALL·E:如果您的项目需要生成创造性的图像,SDK还支持与DALL·E模型的集成。您可以发送提示并接收生成的图像。

    • 功能调用:SDK提供了对OpenAI的函数调用功能的支持,让您可以更灵活地与模型交互,执行自定义的函数式任务。

    • Azure OpenAI:SDK还支持与Azure OpenAI的集成,使您可以在Azure环境中使用OpenAI模型。

    使用示例

    以下是一些使用SDK的示例代码片段,以帮助您更好地了解如何在.NET项目中使用它:

    聊天GPT示例

    var completionResult = await openAiService.ChatCompletion.CreateCompletion(new ChatCompletionCreateRequest
    {
        Messages = new List<ChatMessage>
        {
            ChatMessage.FromSystem("You are a helpful assistant."),
            ChatMessage.FromUser("Who won the world series in 2020?"),
            ChatMessage.FromAssistant("The Los Angeles Dodgers won the World Series in 2020."),
            ChatMessage.FromUser("Where was it played?")
        },
        Model = Models.ChatGpt3_5Turbo,
        MaxTokens = 50//可选
    });
    if (completionResult.Successful)
    {
       Console.WriteLine(completionResult.Choices.First().Message.Content);
    }

    Whisper示例

    var audioResult = await openAiService.Whisper.CreateWhisper(new WhisperCreateRequest
    {
        Text = "This is a test text to be converted into speech.",
        Engine = WhisperEngines.WhisperLatest,
        Voice = WhisperVoices.EnUsFemale
    });
    if (audioResult.Successful)
    {
        var audioBytes = audioResult.AudioBytes;
        // 保存音频或执行其他操作
    }

    DALL·E示例

    var imageResult = await openAiService.Image.CreateImage(new ImageCreateRequest
    {
        Prompt = "Laser cat eyes",
        N = 2,
        Size = StaticValues.ImageStatics.Size.Size256,
        ResponseFormat = StaticValues.ImageStatics.ResponseFormat.Url,
        User = "TestUser"
    });
    
    if (imageResult.Successful)
    {
        Console.WriteLine(string.Join("\n", imageResult.Results.Select(r => r.Url)));
    }

    结束语

    无论您的项目需要与OpenAI的哪个模型进行交互,Dotnet SDK for OpenAI ChatGPT、Whisper、GPT-4和DALL·E都可以为您提供强大的工具和支持。借助这个SDK,您可以更轻松地构建出色的应用程序和工具,充分发挥OpenAI模型的潜力。希望您能够享受使用这个SDK的过程,并实现您的创意项目!
  • 项目介绍:Retrieval-based-Voice-Conversion-WebUI

    项目介绍:Retrieval-based-Voice-Conversion-WebUI

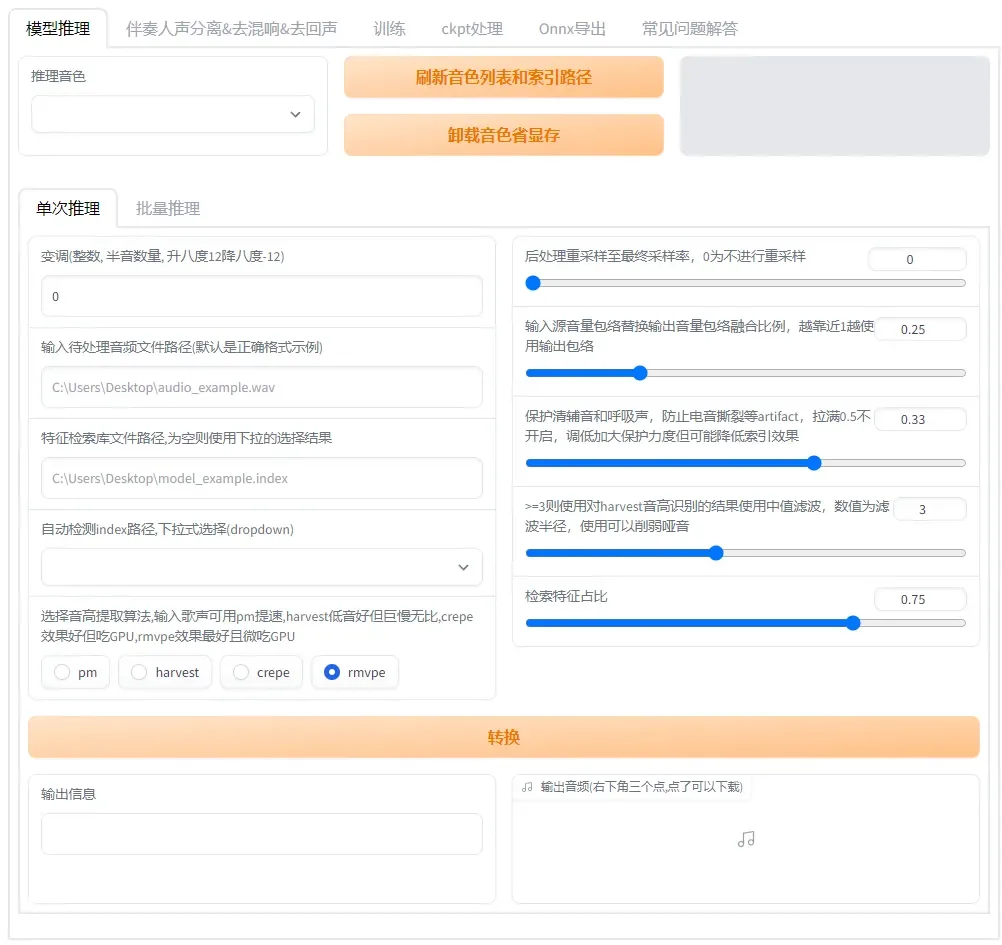
    大家是否曾经幻想过能够轻松改变自己的声音,变成不同的角色或声音风格,而不需要复杂的技术和昂贵的设备?现在,这个梦想成为现实的一部分,而且非常容易实现。在这篇文章中,我将向您介绍一个名为”Retrieval-based-Voice-Conversion-WebUI”的项目,它是一个基于VITS的简单易用的变声框架。无需深入的音频处理知识,只需轻松点击,您就可以实现令人惊叹的声音变化。

    项目概览

    Retrieval-based-Voice-Conversion-WebUI(以下简称RVC)是一个开源项目,它的目标是让声音变换变得容易、快捷和有趣。这个项目基于VITS(Variational Inference Text-to-Speech)模型,该模型在语音合成领域取得了显著的成就。RVC借助VITS的强大功能,为用户提供了一个简单的网页界面,让您能够以前所未有的方式探索声音。

    项目特点

    RVC拥有许多引人注目的特点,使其成为一个令人兴奋的项目:

    • 使用检索替换声音源特征:RVC采用了一种创新的方法,使用检索技术来替换输入源的特征,以杜绝音色泄漏,确保声音变换的高质量。

    • 适用于各种硬件:即使在相对较差的显卡上,RVC也能快速训练,这意味着您不需要超级高端的硬件来享受声音变换的乐趣。

    • 使用少量数据训练:与许多其他声音变换方法不同,RVC可以在少量数据下训练,只需10分钟左右的低噪音语音数据,就能获得出色的结果。

    • 模型融合:RVC允许您通过模型融合来改变音色,借助模型选项卡中的ckpt-merge选项,您可以自定义声音的风格。

    • 简单易用的网页界面:RVC提供了一个直观的网页界面,无需复杂的命令行操作,您只需点击几下,即可完成声音变换。

    • 人声分离:RVC还支持调用UVR5模型,以快速分离人声和伴奏,让您更轻松地处理音频文件。

    • 先进的音高提取算法:RVC采用了最先进的人声音高提取算法,根据哑音问题进行优化,实现更好的效果,同时占用更小的资源。

    • A卡和I卡加速支持:无论您使用的是A卡还是I卡,RVC都提供了相应的支持,以满足不同用户的需求。

    环境配置

    要开始使用RVC,您需要确保您的环境配置正确。以下是设置环境的简要步骤:

    1. 安装Python 3.8或更高版本。

    2. 安装PyTorch及其核心依赖,可以使用以下命令:

      pip install torch torchvision torchaudio

      对于Windows用户,如果使用Nvidia Ampere架构(如RTX30xx),您可能需要指定PyTorch对应的CUDA版本。您可以使用以下命令:

      pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu117
    3. 安装项目依赖项,您可以使用Poetry或pip来安装依赖。具体的命令请参考项目文档。

    4. 下载所需的预模型文件,项目提供了下载链接和说明。

    5. 启动WebUI,运行以下命令:

      python infer-web.py

    以上是基本的环境配置步骤,具体的配置细节可以在项目文档中找到。

    结语

    Retrieval-based-Voice-Conversion-WebUI是一个引人注目的项目,它将声音变换带入了新的境界,使其变得简单、快捷和有趣。不再需要复杂的音频处理技巧,只需轻松点击几下,您就能探索无限的声音可能性。无论您是声音爱好者还是音频专业人士,RVC都值得一试。

    如果您想要探索声音的奇妙世界,不妨前往Retrieval-based-Voice-Conversion-WebUI的GitHub仓库了解更多信息,并亲自体验声音的变幻魔法!

  • AI洗稿:技术突破与道德考量

    AI洗稿:技术突破与道德考量

    随着人工智能技术的不断进步,AI洗稿技术已经逐渐崭露头角,引发了广泛的讨论和担忧。在互联网时代,新闻和信息的传播速度前所未有地快,而AI洗稿技术的出现使得新闻内容的生成和传播变得更加高效。然而,这一技术的广泛应用是否会进一步污染中文互联网,引发了人们的担忧。本文将探讨AI洗稿技术的技术突破和道德考量,以及其对中文互联网的潜在影响。

    AI洗稿技术的技术突破

    AI洗稿技术是人工智能领域的一个重要分支,它使用深度学习算法和大数据训练模型,能够自动生成文章、新闻报道等文本内容。这种技术的突破在于其能够以极快的速度生成大量的文本,无需人工编写,大大提高了内容生成的效率。同时,AI洗稿技术还能模仿不同的文体和风格,使生成的内容更具多样性。

    技术的双刃剑

    然而,正如任何新技术一样,AI洗稿技术也具有双重性质。一方面,它能够为新闻媒体、内容创作者等提供巨大的帮助,节省时间和人力成本,让他们更专注于深度报道和创作。另一方面,这种技术的滥用可能导致信息污染,使真假难辨,降低新闻的可信度和信息的质量。

    新闻传播的挑战

    现今,互联网上的新闻和信息充斥着大量的内容,其中不乏虚假信息和谣言。AI洗稿技术的广泛应用可能会加剧这一问题,因为它可以轻松生成看似真实的新闻报道,混淆了真假界限。这对于新闻传播的可信度构成了巨大挑战,也对读者产生了误导。

    道德层面的考量

    在AI洗稿技术的背后,涉及到道德层面的重要问题。首先,AI洗稿是否会侵犯原创作者的知识产权?生成的文本是否会侵权或抄袭?这是需要认真考虑的问题。其次,新闻媒体是否有责任对使用AI生成的内容进行审核和筛选,以确保信息的准确性和可信度?这也是一个重要的道德问题。

    未来的挑战与应对

    随着AI洗稿技术的不断发展,未来将面临更多挑战。为了应对这些挑战,有必要建立更加严格的法律法规,保护原创作者的权益,规范AI生成内容的使用。同时,新闻媒体和互联网平台也应该承担更多的社会责任,对AI生成的内容进行审核和监管,确保信息的真实性和可信度。

    结语

    AI洗稿技术的出现在技术上带来了巨大的突破,但也引发了一系列道德和社会问题。在中文互联网时代,我们需要认真思考如何在技术发展和道德原则之间取得平衡,以确保信息的质量和可信度。只有通过共同的努力,我们才能充分发挥人工智能技术的优势,同时维护信息传播的公平和可靠。

  • 微软即将发布首款人工智能芯片:开启AI新纪元

    微软即将发布首款人工智能芯片:开启AI新纪元

    在当今数字化时代,人工智能技术正以惊人的速度演进,成为了各行各业的关键驱动力。微软,作为全球领先的科技巨头,一直以来都在积极探索人工智能领域的前沿技术。最新的消息显示,微软即将在下个月的年度开发者大会上推出其首款为人工智能设计的芯片,这将是一项具有里程碑意义的举措。本文将深入探讨微软的这一举措,揭示其对人工智能领域的重大影响。

    背景介绍

    微软是一家全球知名的科技公司,其业务涵盖了操作系统、办公软件、云计算等领域。随着人工智能技术的迅猛发展,微软一直在积极投入资源,推动人工智能领域的创新。而今,微软计划推出的这款人工智能芯片标志着其在硬件领域的重大突破,也将为人工智能的未来发展带来新的动力。

    微软的首款人工智能芯片

    据悉,微软的这款首款人工智能芯片是专门为训练和运行大型语言模型(LLM)的数据中心服务器设计的。语言模型在自然语言处理领域具有广泛的应用,包括机器翻译、智能对话系统等。而微软的这款芯片将为这些应用提供强大的性能支持,加速了人工智能技术在这些领域的应用。

    芯片的意义和影响

    微软的这一举措将对人工智能领域产生深远的影响。首先,这款芯片的问世将减少对第三方硬件供应商的依赖,提高了微软在人工智能领域的自主性。其次,芯片的设计针对语言模型,将为自然语言处理领域的研究和应用带来更大的便利性和效率。最重要的是,这款芯片有望推动人工智能技术的普及和应用,为更多行业带来创新和改变。

    行业应用和合作伙伴

    微软的数据中心服务器目前已经使用英伟达的GPU为云客户提供先进的LLM。这些客户包括了OpenAI和Intuit等知名公司,以及支持微软生产力应用程序中的人工智能功能。微软在人工智能领域的合作伙伴关系广泛而深入,这也为其新推出的人工智能芯片的应用提供了更广阔的空间。

    未来展望

    微软的首款人工智能芯片标志着该公司在人工智能领域的深刻布局。随着人工智能技术的不断进步,我们有理由相信,微软的这一举措将推动人工智能领域迈向新的高度。这也意味着未来将会有更多创新的人工智能应用涌现,为人类社会带来更多便利和机会。

    结语

    微软即将发布的首款人工智能芯片引发了广泛的关注和期待。这一举措将不仅推动人工智能技术的发展,也将为科技产业的未来带来新的机遇。随着时代的发展,人工智能将继续发挥着重要的作用,而微软正站在这一领域的前沿,为未来的AI新纪元开启了大门。

  • 用深度学习将设计草图转换成HTML和CSS代码

    用深度学习将设计草图转换成HTML和CSS代码

    在计算机科学和人工智能领域的快速发展下,我们见证了各种令人兴奋的技术应用。其中之一是深度学习,它已经改变了我们对图像处理和自然语言处理的认识。本文将介绍一个令人兴奋的项目,该项目使用深度学习将设计草图转换成HTML和CSS代码,从而实现自动化的网页设计。

    项目背景

    这个项目的灵感来源于设计师和开发者之间的协作。通常,设计师会创建网页设计的静态图像,然后将其交给开发者来实现。这个过程需要大量的人力和时间,并且容易出现误解和不一致。为了解决这个问题,这个项目旨在使用深度学习技术,特别是卷积神经网络(CNN)和循环神经网络(RNN),将设计图像自动转换成可用的HTML和CSS代码。

    项目详解

    1. 神经网络架构

    这个项目的神经网络模型分为三个主要版本,每个版本都经历了不同的迭代。

    Hello World 版本

    这是项目的最初版本,旨在验证概念。它将设计图像输入神经网络,并试图生成与图像相关的基本HTML元素。虽然它的功能有限,但它为后续版本奠定了基础。

    HTML 版本

    HTML版本是第一个完整的模型,它可以将设计图像转换成HTML代码。这个版本采用了卷积神经网络(CNN)来提取图像的特征,然后使用循环神经网络(RNN)生成对应的HTML代码。它已经可以在一定程度上实现自动化的网页设计。

    Bootstrap 版本

    Bootstrap版本是这个项目的最终版本,也是最强大的版本。它不仅可以生成HTML代码,还可以生成对应的CSS样式,从而实现了更高级的网页设计。这个版本使用了长短时记忆网络(LSTM)来提高性能,同时具备了更好的泛化能力。

    2. 数据集和训练

    为了训练这些神经网络模型,项目使用了一个包含大量设计图像和其对应HTML/CSS代码的数据集。通过将设计图像与真实的HTML/CSS代码进行配对,神经网络可以学习如何将图像转化为代码。

    3. 模型权重

    为了方便用户,项目提供了已经训练好的模型权重,用户可以直接使用这些权重来进行设计图像到代码的转换。

    4. 项目应用

    这个项目的应用潜力巨大。它可以极大地提高网页设计的效率,减少了设计师和开发者之间的沟通成本。同时,它还可以用于自动生成简单网页的原型或快速制作。

    安装和使用

    如果你想尝试这个项目,你可以通过以下步骤来安装和使用:

    在FloydHub上运行

    点击FloydHub按钮来在FloydHub上打开一个Workspace,你将找到与“Bootstrap版本”相同的环境和数据集,以供测试和使用。

    本地安装

    如果你想在本地运行项目,请按照以下步骤操作:

    1. 安装所需的Python库:

      pip install keras tensorflow pillow h5py jupyter
    2. 克隆项目仓库:

      git clone https://github.com/emilwallner/Screenshot-to-code.git
      cd Screenshot-to-code/
      jupyter notebook
    3. 在Jupyter Notebook中打开所需的笔记本文件(以.ipynb结尾)。然后在菜单中选择“Cell” > “Run all”来运行模型。

    请注意,最终版本的Bootstrap版本已经准备好了一个小数据集用于测试模型。如果要使用所有数据,你需要下载数据并在代码中指定正确的目录。

    结论

    这个项目展示了深度学习在网页设计领域的潜力。通过将设计图像转换成HTML和CSS代码,我们可以极大地提高网页设计的效率和自动化程度。虽然项目的最终版本已经能够实现高度准确的转换,但仍需要更多的研究和数据来进一步提高泛化能力。这个项目代表了人工智能技术在创造性领域的应用,为未来的自动化设计提供了一个令人兴奋的前景。

  • TensorFlow中自定义损失函数和反向传播方法

    TensorFlow中自定义损失函数和反向传播方法

    在使用TensorFlow进行深度学习模型训练时,有时候需要自定义损失函数并手动进行反向传播。这种情况可能出现在损失函数涉及到复杂的数学运算或者需要与外部库(如NumPy或Boost::Python)交互的情况下。在这篇文章中,我们将介绍一种正确的方式来自定义损失函数并执行反向传播。

    背景

    假设你已经创建了一个神经网络模型,其中net_out表示网络输出的某一层。你希望使用自己的损失函数,但又想利用TensorFlow的优化器进行参数更新。同时,你希望能够在训练过程中动态地修改损失函数,而不需要修改整个模型。

    步骤

    1. 创建自定义损失函数

    首先,你可以创建一个自定义的损失函数,该函数使用TensorFlow的数学操作。这个损失函数的计算可以包括复杂的运算,但仍然在TensorFlow中进行。

    import tensorflow as tf
    
    # 自定义损失函数的计算,可以包括net_out等任何TensorFlow操作
    def custom_loss(net_out, ph0, ph1):
        # 比如:使用ph0和net_out计算损失
        loss = ph0 * tf.reduce_mean(net_out) + ph1
        return loss

    2. 创建损失占位符

    为了能够在训练过程中动态地修改损失函数,你可以使用TensorFlow的占位符来传递损失的值。

    # 创建损失占位符
    loss_placeholder = tf.placeholder(tf.float32, shape=())

    3. 使用损失占位符创建损失

    现在,你可以使用损失占位符和自定义损失函数来创建一个损失张量。

    # 使用损失占位符和自定义损失函数创建损失张量
    loss = custom_loss(net_out, ph0, ph1)

    4. 创建优化器和训练操作

    接下来,创建一个TensorFlow优化器和训练操作,用于最小化损失。

    # 创建优化器
    optimizer = tf.train.AdamOptimizer(learning_rate=learning_rate)
    
    # 使用优化器最小化损失
    train_op = optimizer.minimize(loss)

    5. 在训练循环中执行前向传播和反向传播

    在训练循环中,首先执行前向传播以获取net_out,然后计算自定义损失值np_loss。最后,将np_loss传递给损失占位符,并执行反向传播。

    # 在训练循环中执行前向传播
    net_out_value = sess.run(net_out, feed_dict={xxx})
    
    # 计算自定义损失值
    np_loss = calculate_np_loss(net_out_value)
    
    # 将np_loss传递给损失占位符,并执行反向传播
    sess.run(train_op, feed_dict={xxx, loss_placeholder: np_loss})

    结论

    通过以上步骤,你可以自定义损失函数并使用TensorFlow的优化器进行参数更新,同时可以在训练过程中灵活地修改损失函数的值。这种方法允许你充分利用TensorFlow的功能,并将损失计算与外部库(如NumPy)集成,以满足个性化需求。

  • PyTorch与Keras:深度学习框架的选择之争

    PyTorch与Keras:深度学习框架的选择之争

    深度学习已经成为人工智能领域的热门话题,而选择适合的深度学习框架对于项目的成功至关重要。在众多深度学习框架中,PyTorch和Keras都备受欢迎,它们各有优势。在本文中,我们将深入探讨PyTorch和Keras的特点,帮助您更好地理解哪个框架更适合您的需求。

    PyTorch:风头正劲的深度学习框架

    PyTorch在近年来迅速崭露头角,成为深度学习领域的翘楚。下面我们将介绍一些PyTorch的优势:

    1. 动态计算图

    PyTorch采用动态计算图的方式,使得模型构建更加灵活。这意味着您可以像编写Python代码一样构建神经网络,无需预先定义静态计算图。这种灵活性对于研究人员和实验性项目非常有吸引力。

    2. 易于调试

    PyTorch的动态计算图使得调试变得更容易。您可以轻松地在模型中插入打印语句或使用Python调试工具来检查模型的中间状态,有助于快速发现和解决问题。

    3. 强大的社区支持

    PyTorch拥有庞大的社区,因此可以轻松找到各种教程、示例代码和问题解决方案。这对于初学者来说是一个巨大的优势,因为您可以从社区的智慧中受益。

    Keras:友好的深度学习入门门槛

    Keras是另一个备受欢迎的深度学习框架,它有着自己的一系列优势:

    1. 简洁的API

    Keras提供了简单而直观的API,使得构建神经网络变得容易。它的设计理念是“用户友好”,适用于初学者和快速原型开发。

    2. 多后端支持

    Keras可以运行在多个深度学习后端引擎上,包括TensorFlow和Theano。这使得您可以根据项目需求选择最合适的后端。

    3. 高度模块化

    Keras的模块化设计使得您可以轻松组合不同的层和模型,创建自定义神经网络结构。这对于构建复杂的模型非常有用。

    如何选择?

    选择PyTorch还是Keras,取决于您的项目需求和个人偏好。下面是一些建议:

    • 如果您是深度学习的新手,想快速入门并构建简单的模型,Keras可能是更好的选择。
    • 如果您是研究人员或需要更大的灵活性来实验不同的模型架构,PyTorch可能更适合您。
    • 如果您更倾向于使用TensorFlow作为后端,Keras是一个很好的选择。
    • 如果您喜欢动态计算图和更容易的调试,PyTorch可能更适合您。

    最终,无论您选择哪个框架,都应该根据项目的需求和您的经验水平来进行决策。

    结论

    PyTorch和Keras都是优秀的深度学习框架,各自具有一系列优势。选择适合您的框架取决于您的项目和个人偏好。无论您选择哪一个,都要充分利用社区的资源和教程,不断学习和提升自己的深度学习技能。

  • 如何使用虚拟信用卡支付ChatGPT Plus订阅:2023大神亲测推荐

    如何使用虚拟信用卡支付ChatGPT Plus订阅:2023大神亲测推荐

    在数字化时代,虚拟信用卡已经成为一种便捷的支付工具,尤其是对于订阅服务的付款。在这篇文章中,我将分享我的亲身经历,介绍几款可靠的虚拟信用卡服务商,它们能够成功支付ChatGPT Plus订阅。这些信用卡不仅在支付ChatGPT Plus方面表现出色,而且经过了大神的亲自验证。如果你也在寻找一种稳定可靠的支付方式,不妨跟随我的步伐,了解这些虚拟信用卡的使用方法。

    file

    虚拟信用卡:便捷与安全的支付选择

    虚拟信用卡是一种不需要实体卡片的支付方式,它通过数字形式存在,可以用于在线购物、订阅服务等各种支付需求。与传统信用卡不同,虚拟信用卡的使用更加便捷,同时也更安全,因为它们通常不直接连接到你的银行账户。

    但要注意,不是所有的虚拟信用卡都支持ChatGPT Plus订阅的支付。因此,选择一款可靠的虚拟信用卡服务商至关重要。接下来,我将介绍三款经过我亲自测试的虚拟信用卡服务商,它们在支付ChatGPT Plus订阅方面表现卓越。

    Nobepay:首选之一

    Nobepay是我使用过的第二个虚拟信用卡,也是大神们推荐的首选之一。它的成功率非常高,特别适合用于支付ChatGPT Plus订阅费用。我个人使用了Google Pay或Apple Pay结合外区账号进行支付,都取得了令人满意的结果。

    Nobepay的优势:

    • 高成功率:经过多次测试,Nobepay表现出色,特别是在支付ChatGPT Plus时。
    • 多种支付方式:你可以选择使用Google Pay、Apple Pay等多种支付方式,灵活方便。
    • 用户友好:界面简洁,易于操作,即使对虚拟信用卡不熟悉的人也能轻松上手。

    如果你想尝试Nobepay,可以使用以下邀请码注册,这将帮助你获得额外的优惠:

    Nobepay邀请码:BAAB0A1
    邀请链接:Nobepay注册链接

    Onecard:美元优选卡

    Onecard是专门为ChatGPT(OpenAI)的订阅推出的一款虚拟信用卡,经过大神们的测试,成千上万的人都成功通过IP地址支付了ChatGPT Plus订阅费用。

    Onecard的优势:

    • 专为ChatGPT用户设计:Onecard针对ChatGPT用户的需求而设计,支持美元支付。
    • 高通过率:经过多次验证,Onecard在支付ChatGPT Plus方面表现卓越。
    • 使用便捷:支持Apple Pay,操作简单快捷。

    如果你想使用Onecard,可以使用以下邀请码注册,享受额外的福利:

    Onecard邀请码:WDKEXY
    邀请链接:Onecard注册链接

    Dupay(前身为Depay):稳定可靠的选择

    Depay已经改版为Dupay,目前是我一直在使用的虚拟信用卡。虽然它没有那么多花哨的功能,但它的稳定性和可靠性令人满意。我个人绑定了微信,可以随时进行消费。

    Dupay的优势:

    • 稳定可靠:Dupay一直保持着良好的稳定性,让你无忧支付。
    • 微信绑定:支持微信绑定,方便管理和使用。
    • 高度安全:虚拟信用卡通常更安全,因为它们不直接连接到你的银行账户。

    如果你想使用Dupay,可以使用以下邀请码注册:

    Depay注册邀请码与邀请链接

    Dupay邀请码:958079

    邀请链接:Dupay注册链接

    结语

    虚拟信用卡是一种便捷、安全的支付方式,特别适用于在线订阅服务。在选择虚拟信用卡时,务必选择可靠的服务商,以确保成功支付ChatGPT Plus订阅。根据我的亲身经历,Nobepay、Onecard和Dupay都是优秀的选择,它们在支付ChatGPT Plus方面表现卓越。通过使用以上邀请码注册,你还可以享受额外的福利。希望这篇文章能够帮助你找到适合你的虚拟信用卡,让订阅ChatGPT Plus变得更加便捷。

  • 用有趣的方式解决Mac上Stable Diffusion的GPU和内存选择困境

    用有趣的方式解决Mac上Stable Diffusion的GPU和内存选择困境

    你好,各位读者!今天我要和大家分享一个关于在Mac上跑Stable Diffusion(SD)时的GPU和内存选择问题,以及如何以有趣的方式解决这个困扰许多人的难题。或许,在文章的最后,你会找到适合你的解决方案。

    背景故事

    故事的主人公是一个拥有N年前的MBP的人,他发现在Mac上跑SD生成一张图太慢了,于是决定进行升级。但他迷茫于应该投资38核GPU还是64GB内存。这是一个充满技术和经济考量的故事。

    GPU vs. 内存

    首先,让我们来探讨一下GPU和内存在SD中的角色。在这个AI模型中,两者都发挥着重要作用,但它们的贡献略有不同。

    GPU

    GPU是用于计算的关键部分,它负责处理模型的各种数学运算,这些运算需要大量的计算资源。更强大的GPU通常能够更快地完成计算任务,因此,如果你希望提高SD的速度,一块强大的GPU是不可或缺的。

    内存

    内存在SD中的作用也很重要。SD模型的训练和生成过程需要大量的内存来存储数据和中间结果。如果内存不足,你可能会遇到性能问题,甚至无法完成生成任务。因此,拥有足够的内存对于确保顺利运行SD非常关键。

    读者的建议

    为了获得更多见解,我翻阅了一些读者的建议,他们在讨论区分享了自己的经验和观点。

    • 有人表示,Mac上跑SD速度较慢,不建议在这个平台上进行SD生成。
    • 一位读者提到,内存需求相当大,甚至需要64GB内存,以确保运行顺畅。
    • 关于GPU的问题,有人认为Mac的GPU速度可能不如N卡,因为大多数人在SD中使用N卡来跑模型。

    我的观点

    虽然每个人的需求和预算都不同,但我认为在Mac上跑SD可能并不是最佳选择。考虑到SD的计算和内存需求,以及Mac相对较小的内存和GPU性能,你可能会在速度和稳定性方面遇到挑战。

    如果你有预算限制,我建议考虑租用GPU VPS来运行SD,这样你可以获得更好的性能和内存支持。另外,你还可以考虑使用N卡来跑SD,因为它们在性能方面通常表现更出色。

    结语

    在选择GPU和内存时,要根据你的具体需求和预算做出明智的决策。无论你选择什么配置,都要记住,SD是一个计算密集型任务,需要足够的计算资源和内存支持。

    最后,希望这篇文章能帮助你更好地理解在Mac上跑SD时的GPU和内存选择问题,并为你找到合适的解决方案。

  • 探索生成对抗网络(GANs):艺术与技术的交汇

    探索生成对抗网络(GANs):艺术与技术的交汇

    在当今数字时代,人工智能技术不断演进,为我们带来了各种惊人的创新。其中,生成对抗网络(GANs)无疑是一个引人瞩目的明星。你或许已经听说过GANs,但是否真正理解它们的工作原理以及它们如何在艺术和技术领域中崭露头角呢?

    开篇故事

    曾经有一个名叫艾丽的年轻画家,她一直梦想着创作出令人惊叹的数字艺术品。然而,她发现自己在创作逼真的数字画作时遇到了巨大的挑战。她的作品总是缺乏那种令人叹为观止的真实感。但是,一天,当她听说了生成对抗网络(GANs)时,一切都改变了。

    GANs是什么?

    GANs,全名生成对抗网络(Generative Adversarial Networks),是一种令人惊叹的算法。它们由两个主要组成部分组成:生成器(Generator)和判别器(Discriminator)。这两者之间存在一种有趣的博弈关系,它们彼此竞争,推动着GANs不断进化。

    生成器的任务是创造逼真的数据,例如图像、声音或文本。与此同时,判别器的任务是判断给定的数据是否真实。这两个组件之间的博弈如同一场艺术与技术的对决,让我们深入了解它们的工作原理。

    生成器:创造的魔法

    生成器就像一位魔法师,它可以从虚无中创造出华丽的数字艺术品。让我们看看它是如何做到的:

    1. 随机噪声输入:生成器以随机噪声作为初始输入。这个噪声是一个随机向量,看似毫无规律,但却包含着无限的潜力。

    2. 神经网络:生成器通过深度神经网络将这个随机噪声逐渐转化为一幅图像或其他形式的数据。神经网络的层次结构允许它逐渐捕捉到更高级别的特征,使生成的数据越来越逼真。

    3. 优化:生成器的目标是欺骗判别器,使其认为生成的数据是真实的。为此,它通过不断优化神经网络参数,使生成的数据更加逼真。

    生成器的魅力在于它的创造力,它可以生成任何我们能想象的东西,从惊艳的风景画到令人惊叹的人像。

    判别器:真实与虚假的鉴别师

    判别器的任务是识别真实与虚假,就像一位聪明的鉴别师一样。它的工作原理如下:

    1. 真实数据对比:判别器首先接触真实数据,例如真实的图像或文本。这样,它可以学会真实数据的特征和模式。

    2. 生成数据对比:接下来,判别器会与生成器产生的数据进行对比。它会评估生成的数据与真实数据之间的相似度。

    3. 反馈给生成器:根据对比的结果,判别器将反馈信息传递给生成器。如果生成的数据足够逼真,判别器会称其为真实。否则,它将指出生成器的不足之处。

    通过不断迭代这个过程,判别器变得越来越擅长区分真实和虚假数据,从而迫使生成器不断改进,以达到更高的逼真度。

    艺术与技术的奇妙交汇

    现在,让我们看看GANs是如何在艺术和技术领域中崭露头角的:

    艺术创作

    1. 数字艺术品的创作:艺术家们已经开始利用GANs创作数字艺术品。生成器可以创造出令人叹为观止的画作,为艺术界带来了新的可能性。

    2. 风格转换:GANs可以将一幅艺术品的风格应用到另一幅图像上,创造出令人惊艳的效果。这种技术已经被广泛应用于图像编辑和电影特效制作中。

    技术应用

    1. 合成图像:GANs可以用于合成逼真的图像,这在游戏开发和虚拟现实领域发挥了巨大作用。它们可以创建虚拟世界中的场景和角色,使之看起来像真实世界一样。

    2. 改进图像分辨率:GANs可以通过增加图像的细节和质量来改进图像分辨率。这在医学图像处理和摄影领域具有重要意义。

    结语

    生成对抗网络(GANs)是一种令人惊叹的算法,它们以其独特的生成器和判别器之间的博弈关系,为我们带来了无限的可能性。无论是在艺术创作还是技术应用中,GANs都展现出了其强大的潜力。

    对于那些像艾丽一样渴望创造出令人惊叹的数字艺术品的人来说,GANs是一种不可多得的工具。它们将继续引领着我们进入数字创新的新纪元,带来更多令人惊叹的成果。

    无论你是一位艺术家还是一位技术爱好者,GANs都值得你深入了解。它们代表了艺术与技术的奇妙交汇,为我们打开了前所未有的可能性之门。