Tag: Windows

  • 如何绕过虚拟机检测来进行恶意代码分析

    如何绕过虚拟机检测来进行恶意代码分析

    在进行恶意代码分析时,有时会遇到虚拟机检测,这会给分析工作带来一些挑战。虚拟机检测是一种防止恶意软件在虚拟化环境中运行的技术。然而,如果你是一个安全研究人员或想要深入了解恶意代码的开发者,你可能需要学习如何绕过这些检测方法,以便更好地分析恶意代码。在本教程中,我们将讨论一些常见的虚拟机检测技术以及如何绕过它们。

    开篇故事

    假设你是一位安全研究人员,最近对一种新发现的恶意软件进行分析。然而,你发现恶意软件在虚拟机中运行时会自动终止,这让你陷入了困境。你决定深入研究虚拟机检测技术,以便顺利完成你的分析工作。在接下来的教程中,我们将一起探讨如何绕过虚拟机检测,使你能够更好地理解和分析恶意代码。

    基于特征的检测

    虚拟机检测的一种常见方法是基于特征的检测,它通过检查虚拟机环境中的特定文件、目录和设备来确定虚拟机的存在。下面是一些常见的基于特征的检测方法以及如何绕过它们:

    1. 文件以及目录

    在虚拟机中,各种虚拟化软件会在操作系统中创建特定的文件和目录。这些文件和目录的存在可以被检测,从而确定虚拟机的存在。例如,VMware 虚拟机中可能会存在以下文件:

    • C:\Program Files\VMware\
    • C:\Windows\System32\vm3dc003.dll
    • C:\Windows\System32\vm3ddevapi64-debug.dll

    要绕过这种检测,你可以尝试修改虚拟机中的文件或目录,或者使用虚拟机管理工具隐藏它们。

    2. Devices

    虚拟机中的设备也可以被用来检测虚拟化环境。例如,VMware 虚拟机中存在名为 “\.\HGFS” 和 “\.\vmci” 的设备,用于主机和虚拟机之间的通信。你可以尝试修改这些设备的属性或关闭它们来绕过检测。

    3. MAC 地址

    虚拟机的网络适配器通常具有特定的 MAC 地址范围。例如,VMware 虚拟机的 MAC 地址通常以 “00:50:56” 或其他特定前缀开头。你可以尝试修改虚拟机的 MAC 地址来绕过检测。

    4. BIOS 字符串

    虚拟机中的 BIOS 字符串通常包含虚拟化软件的标识信息。例如,VMware 虚拟机的 BIOS 字符串可能包含 “VMware, Inc.”。你可以尝试修改虚拟机的 BIOS 字符串来绕过检测。

    5. 其他 Windows 注册表项

    在 Windows 注册表中,某些项可能包含与虚拟化环境相关的信息。例如,VMware 虚拟机可能会在注册表中留下包含 “VMWARE” 或 “VM” 字符串的信息。你可以修改这些注册表项来绕过检测。

    6. SMBIOS 字符串

    SMBIOS(System Management BIOS)中包含有关系统硬件的信息。虚拟机可能会在 SMBIOS 字符串中包含特定的标识信息。你可以尝试修改这些信息来绕过检测。

    7. ACPI 字符串

    ACPI(Advanced Configuration and Power Interface)也包含了与硬件相关的信息,虚拟机中可能包含特殊的字符串。你可以尝试修改这些字符串来绕过检测。

    8. 进程

    虚拟机中通常会运行一些特殊的后台进程,用于虚拟化环境的管理。例如,VMware 虚拟机中可能会存在进程如 “Vmtoolsd.exe” 和 “Vmwaretray.exe”。你可以尝试关闭或修改这些进程来绕过检测。

    9. 硬盘硬件ID以及名称

    一些恶意软件可能会检测硬盘的硬件ID或名称来确定虚拟机的存在。你可以尝试修改这些信息来绕过检测。

    10. 通过 WMI 获取硬件信息

    Windows Management Instrumentation(WMI)提供了一种标准化的接口,允许程序获取系统信息。你可以使用 WMI 来获取 BIOS 序列号、硬件信息和其他相关信息,并修改它们来绕过检测。

    基于指令的检测

    除了基于特征的检测,一些虚拟机检测方法还涉及到基于CPU指令的检测。这些方法通过检查虚拟机中执行的指令来确定虚拟机的存在。以下是一些常见的基于指令的检测方法以及如何绕过它们:

    1. IN 指令

    IN 指令用于从指定的I/O端口读取值到内存中。

    在虚拟机中,一些虚拟化软件允许这些指令在非特权用户模式下执行,而在物理机上会触发特权指令异常。你可以使用这一特性来检测虚拟机的存在。要绕过这种检测,你可以尝试关闭虚拟机中的相关功能或修改虚拟机的配置。

    2. CPUID 指令

    CPUID 指令用于获取有关CPU的信息,包括制造商ID和支持的指令集。一些虚拟机会在 CPUID 返回的信息中包含特定的标识信息。例如,VMware 虚拟机中的 CPUID 返回值可能包含 “VMwareVMware”。你可以修改虚拟机的 CPUID 返回值来绕过检测。

    3. RDTSC 指令

    RDTSC 指令用于获取时间戳计数器的值,通常用于测量指令执行的时间。在虚拟机中执行 CPUID 指令通常会触发 VM-Exit Event,导致进程从 guest 切换到 VMM。你可以使用 RDTSC 指令来计算这个开销,并检测虚拟机的存在。要绕过这种检测,你可以尝试修改虚拟机的配置以减少这种开销。

    总结

    虚拟机检测是一种常见的安全措施,用于防止恶意软件在虚拟化环境中运行。然而,对于安全研究人员和恶意代码分析者来说,了解如何绕过这些检测方法是非常重要的。在本教程中,我们讨论了一些常见的虚拟机检测技术以及如何绕过它们,以帮助你更好地进行恶意代码分析。

    请注意,绕过虚拟机检测可能涉及到修改虚拟机的配置或文件,因此请确保你在合法的环境中进行这些操作,以遵守法律和道德规范。

    希望本教程能够帮助你更好地理解虚拟机检测技术,并在恶意代码分析中取得更好的成果。
  • 解决谷歌浏览器SSL证书无效问题,轻松畅游互联网

    解决谷歌浏览器SSL证书无效问题,轻松畅游互联网

    在我们的数字生活中,安全性与便利性之间的平衡一直都是一个挑战。谷歌浏览器作为全球最受欢迎的网络浏览器之一,非常注重用户的安全性。但有时,当我们尝试访问某些网站时,会遇到一个让人困惑和烦恼的问题:SSL证书无效或失效,导致浏览器阻止了我们的访问。今天,我将与大家分享一些小技巧,以解决这种屏蔽问题,让你轻松畅游互联网。

    解决方法一:一劳永逸版

    这是一种解决SSL证书无效问题的方法,但不建议长期使用,因为它可能会降低浏览器的安全性。请按照以下步骤执行:

    对于Windows用户:

    1. 打开谷歌浏览器。
    2. 在启动谷歌浏览器时,加入以下参数:--ignore-certificate-errors

    对于Mac用户:

    1. 打开终端(Terminal)。
    2. 输入以下命令,并回车执行:open -a "Google Chrome" --args --ignore-certificate-errors --ignore-urlfetcher-cert-requests &> /dev/null

    确保在输入命令时不要漏掉任何空格。然后重新打开谷歌浏览器,你将能够正常访问网站。

    解决方法二:临时解决版(推荐)

    这是一个更加安全且推荐的方法,它允许你在需要时解决SSL证书无效问题。请按照以下步骤执行:

    1. 当你遇到 “您的连接不是私密连接” 页面时,不要着急关闭或刷新浏览器。
    2. 点击页面上的 “高级” 选项。
    3. 在键盘上敲击以下字符:thisisunsafe
    4. 不要在浏览器地址栏输入,而是直接敲击键盘上的字符。
    5. 按下回车键。

    这种方法相对于第一种更加安全,但需要在每次遇到类似问题时进行操作。老白个人建议大家使用第二种方法,因为通常情况下我们不会频繁访问存在SSL证书问题的网站。

    结语

    在互联网时代,我们总是面临各种各样的挑战,但幸运的是,也有各种解决方案。解决谷歌浏览器SSL证书无效问题只是其中之一。无论你选择哪种方法,都要记住在保证便利性的同时,不要牺牲安全性。希望这些小技巧能帮助你轻松畅游互联网,无论你遇到什么问题。

  • 如何使用Python获取局域网内的IP与MAC地址

    如何使用Python获取局域网内的IP与MAC地址

    当我和一群朋友一起参加一场网络游戏对战时,有一个问题开始困扰我们:如何确保只有我们这群朋友在局域网内?我们想知道是否有其他人也连接到了我们的网络。一个念头突然冒出来,为什么不使用Python来检测局域网内所有的设备IP和MAC地址呢?这样我们就可以轻松识别并管理网络内的设备了。于是,我开始写下了以下的代码。

    1. 开始之前

    在开始之前,确保你的电脑上已经安装了win32api和win32con这两个库。如果没有,你可以通过pip进行安装。

    2. 弹出消息框

    使用win32api我们可以轻松地在Windows上弹出一个消息框来显示信息。

    def msgbox(msg, title='提醒'):
        win32api.MessageBox(0, msg, title, win32con.MB_OK)

    3. 获取本机的IP和MAC地址

    利用ipconfig命令,我们可以获取到本机的IP和MAC地址信息。

    def local_ip_mac():  # 本机IP和MAC
        output = os.popen('ipconfig /all')
        for i in output:
            if '物理地址.' in i:
                mac = i.split(':')[1].strip()
            if 'IPV4' in i.upper() and '(' in i:
                ip = i.split(':')[1].split('(')[0].strip()
        if ip and mac:
            return [ip, mac]

    4. 获取局域网内的IP和MAC地址

    通过arp命令,我们可以查看局域网内所有设备的IP和MAC地址。

    def lan_ip_mac():  #局域网IP和MAC
        ls = []
        output = os.popen('arp -a')
        for i in output:
            if '动态' in i:
                ip, mac, _ = i.strip().split()
                ls.append([ip, mac])
        return ls

    5. 将结果写入到文件中

    最后,我们将结果写入到一个txt文件中,以便后续查看。

    if __name__ == '__main__':
        res = lan_ip_mac()
        res.append(local_ip_mac())
        print(res)
    
        # 结果写入文本
        txt = 'ip_mac.txt'
        out_txt = '\n'.join(['\t'.join(i) for i in res])
        with open(txt, 'w') as f:
            f.write(out_txt)
    
        msgbox(f'提取结果已保存到:{txt}')  #注释掉此行则不弹窗提醒

    6. 结论

    使用上述方法,我们可以轻松地获取到局域网内所有设备的IP和MAC地址,从而轻松管理网络设备。希望这篇教程能够帮助到你。

  • 使用Python破解路由器登录密码

    使用Python破解路由器登录密码

    一个寒冷的冬夜,我的朋友突然打来电话,语气急切:“哥,你能不能帮我破解一下我家路由器的密码?我家小孩不小心给重置了。” 这个紧急请求激发了我的好奇心,我决定尝试编写一个Python脚本,帮助他找回密码。这不仅可以帮助我的朋友,还有可能帮助其他遇到类似问题的人。

    1. 前言

    使用Python编写路由器密码破解脚本听起来可能有些危险,但在合法的情况下,比如找回自己遗忘的密码,这个工具可以派上用场。在这篇教程中,我将向你介绍如何编写一个Python脚本,来尝试破解路由器的登录密码。

    2. 工作原理

    我们的脚本将采用一种称为暴力破解的方式,通过不断尝试密码字典中的密码,直到找到正确的密码为止。

    3. 脚本依赖

    首先,我们需要导入以下Python模块:

    • requests
    • aiohttp
    • asyncio
    • logging

    以下是一个简化的示例代码,用于说明脚本的基本原理:

    import requests
    import asyncio
    import aiohttp
    import logging
    
    # 设置目标URL
    target_url = "http://routerlogin.net"
    
    # 密码字典,包含尝试的密码列表
    passwords = ["password1", "password2", "password3"]
    
    # 配置HTTP请求头
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36"
    }
    
    # 日志记录
    logging.basicConfig(filename='password_cracking.log', level=logging.INFO)
    
    # 异步处理
    async def try_password(password):
        async with aiohttp.ClientSession() as session:
            async with session.get(target_url, headers=headers) as response:
                if response.status == 200:
                    logging.info(f"密码破解成功: {password}")
                    print(f"找到密码:{password}")
                    return True
                else:
                    logging.info(f"密码尝试失败: {password}")
                    return False
    
    async def main():
        tasks = []
        for password in passwords:
            task = asyncio.ensure_future(try_password(password))
            tasks.append(task)
        await asyncio.gather(*tasks)
    
    if __name__ == '__main__':
        loop = asyncio.get_event_loop()
        loop.run_until_complete(main())

    4. 使用指南

    1. 设置目标URL:在脚本中,你需要设置你要破解的路由器登录页面的URL。

    2. 配置密码字典:将你想要尝试的密码添加到密码字典中,可以包括常用密码、推测的密码等。

    3. 运行脚本:使用Python执行脚本,然后脚本将开始尝试密码字典中的每个密码。

    4. 结果:当找到正确的密码时,脚本将停止运行,并显示找到的密码。

    5. 注意事项

    1. 合法性:请牢记,使用此脚本破解他人密码是违法的,确保只在合法场合下使用此脚本。

    2. 效率:密码字典的大小将影响所需的时间。确保密码字典既不太大也不太小。

    3. 封锁风险:多次错误的登录尝试可能会导致IP被封锁,了解并承担这一风险。

    6. 总结

    使用Python来破解路由器密码是一项有趣但充满挑战的任务。这篇教程希望能够帮助你了解如何编写这种类型的脚本,并鼓励你只在合法的场合下使用它。

    请谨记,技术应当用于合法的目的,我们强烈反对将其用于非法活动。

  • 当你的Ubuntu云服务器上下键突变:深入挖掘的解决方案

    当你的Ubuntu云服务器上下键突变:深入挖掘的解决方案

    在一个秋日的午后,我坐在自己的办公桌前,正准备登录我的Ubuntu云服务器进行常规的维护工作。突然,我发现上下方向键不再像以往那样可以轻松翻看历史命令,而是显示出了奇怪的[A和[B字符。这种情况让我十分困惑,我猜测是不是我的键盘出了问题,但其他键都能正常使用。难道是服务器的问题?

    linux shell linux shell

    故障的现象

    当我试图使用上下方向键翻看历史命令时,而不是如期显示历史命令,屏幕上显示的是[A和[B。这个问题出现得很突然,让我一时间不知所措。我在网上搜索了相关资料,发现很多人都遇到了相同的问题,但是提供的解决方案众说纷纭。

    探索解决方案

    1. 查阅外部资料: 首先,我在外部网站找到了一个相关的链接,这个链接提供了一个可能的解决方案。但是,在我尝试后并没有奏效。

    2. 切换键盘状态: 有网友建议切换NumLock键看看,或者是重启Windows的rdp客户端。但我没有小键盘,而且我使用的是termius,重启后问题依然存在。

    3. 软件偏好设置问题?: 有人提出可能是软件的偏好设置导致的。但是,我确认我使用的shell是bash。

    4. 尝试其他命令: 有人提议尝试:set nocp或者使用ctrl+p/n来切换上一条/下一条历史记录。这些建议暂时可以作为一个替代方案,但并不是真正解决问题的方法。

    5. 确认使用的Shell: 最后,有几位网友提到这种情况一般会出现在没有解析ANSI ESC方向键序列的shell里,比如sh、dash,但在bash里应该会解析。他们建议确认现在的shell是否真的是bash,并尝试手工开一个/usr/bin/bash --noprofile --norc。

    最终的解决办法

    经过一番尝试,我发现问题真的是出在了shell上。我原来是在sh环境下工作,但我需要的是bash环境。于是,我切换到/bin/bash,问题得到了解决!

    结束语

    对于许多开发者来说,面对这样的问题可能会感到困惑和沮丧。但其实,只要我们耐心地尝试和探索,往往都能找到问题的根源和解决办法。这次的经验让我更加明白,无论遇到什么问题,都不要轻易放弃,坚持到底,答案总会浮现出来。

  • 如何使用Python爬取网页并保存为Word文档

    如何使用Python爬取网页并保存为Word文档

    假设您是一位热衷于收集好文章的人,每天都希望能够快速获取优质文章并保存在本地,以备离线阅读。但是,手动复制粘贴文章内容并保存为Word文档是一项繁琐的任务,特别是当您需要获取大量文章时。在这篇教程中,我将向您介绍如何使用Python编写一个简单但功能强大的网络爬虫,可以帮助您自动从网站上获取文章并保存为Word文档,让您更轻松地构建自己的文章库。

    准备工作

    在开始之前,我们需要准备一些工具和环境:

    1. Python环境:确保您已经安装了Python,最好使用Python 3.x版本。您可以在Python官网上下载并安装最新版本的Python。

    2. 代码编辑器:选择一个您喜欢的代码编辑器,例如PyCharm或Visual Studio Code,以便编写Python脚本。

    3. 必要的库:在本教程中,我们将使用Requests、Beautiful Soup和docx库来进行网络请求、解析HTML和创建Word文档。您可以使用以下命令来安装这些库:

      pip install requests beautifulsoup4 python-docx
    4. 网络连接:确保您的计算机能够连接到互联网,因为我们将从网页上获取文章内容。

    编写Python爬虫脚本

    以下是我们的Python爬虫脚本,它将从指定网站上获取文章并保存为Word文档:

    # -*- coding: utf-8 -*-
    import time
    import random
    import requests
    import re
    from bs4 import BeautifulSoup
    from w3lib.html import remove_tags
    from docx.oxml.ns import qn
    from docx import Document
    from docx.enum.text import WD_PARAGRAPH_ALIGNMENT
    from docx.shared import Pt
    from docx.shared import RGBColor
    
    # 爬取网页
    def get_url(URL, SIGN):
        headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2228.0 Safari/537.36'}
        html = requests.get(URL, headers=headers)
        html.encoding = 'utf-8'
        soup = BeautifulSoup(html.text, 'lxml')
        text = soup.select(SIGN)
        return text
    
    # 创建doc
    def get_docx(TITLE, BODY):
        document = Document()
        head0 = document.add_heading(level=1)
        head0.alignment = WD_PARAGRAPH_ALIGNMENT.CENTER
        title_run = head0.add_run(TITLE)
        title_run.font.size = Pt(24)
        title_run.font.name = 'Times New Roman'
        title_run.element.rPr.rFonts.set(qn('w:eastAsia'), '方正小标宋简体')
        title_run.font.color.rgb = RGBColor(0, 0, 0)
        document.styles['Normal'].font.name = '宋体'
        document.styles['Normal']._element.rPr.rFonts.set(qn('w:eastAsia'), '仿宋_GB2312')
        p = document.add_paragraph()
        p_run = p.add_run(BODY)
        p.paragraph_format.space_before = Pt(30)
        p.paragraph_format.alignment = WD_PARAGRAPH_ALIGNMENT.JUSTIFY
        p.paragraph_format.line_spacing = Pt(28.8)
        p.paragraph_format.first_line_indent = Inches(0.5)
        p_run.font.color.rgb = RGBColor(0, 0, 0)
        p_run.font.size = Pt(16)
        TITLE = re.sub('([^\u4e00-\u9fa5\d])', '', TITLE)
        name = 'D:\\Download\\Articles\\' + TITLE + '.docx'
        document.save(name)
    
    def main():
        n = 0
        menus = get_url('http://www.haoword.com', '.infobox .indexleft .infoco .lm .news_title h2 a')
        menus_url = []
        for menu_url in menus:
            menus_url.append(menu_url['href'])
        print(menus_url)
        for menu_url in menus_url:
            time.sleep(random.random())
            results = get_url(menu_url, '.infobox .lmleft .infoco2 .lm_addon .articles3 ul li a')
            for result in results:
                title_url = result['href']
                title = result['title']
                print(f'{title}:{title_url}')
                time.sleep(random.random())
                articles_results = get_url(title_url, '.infobox .detail .content p')[1:]
                body = remove_tags(str(articles_results))[1:]
                get_docx(title, body)
                n += 1
        print(f'爬取完毕!共爬取 {n} 篇文章。')
    
    if __name__ == '__main__':
        start = time.perf_counter()
        main()
        end = time.perf_counter()
        print(f'耗时 {end - start} 秒。')

    使用说明

    • 在脚本中,我们使用了Requests库来发送HTTP请求,Beautiful Soup来解析HTML内容,以及docx库来创建Word文档。

    • 通过修改get_url函数中的URL和SIGN参数,您可以指定要爬取的网站和文章内容的选择器。

    • 修改get_docx函数中的文档保存路径和格式以适应您的需求。

    • 运行脚本后,它将自动从指定网站上获取文章并保存为Word文档。

    总结

    通过这篇教程,您学会了如何使用Python编写一个简单的网络爬虫,用于爬取网站上的文章并保存为Word文档。这个脚本可以帮助您轻松地建立自己的文章库,方便离线阅读和收藏。希望这对您有所帮助!

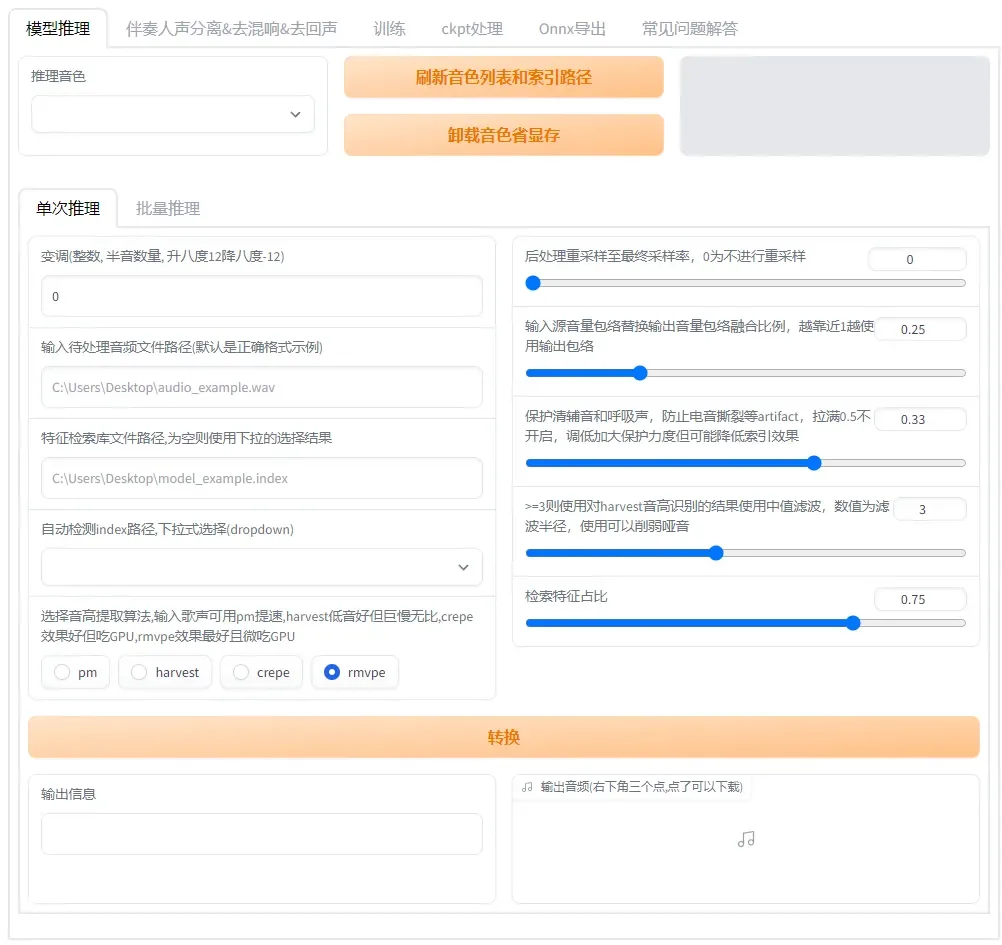
  • 项目介绍:Retrieval-based-Voice-Conversion-WebUI

    项目介绍:Retrieval-based-Voice-Conversion-WebUI

    大家是否曾经幻想过能够轻松改变自己的声音,变成不同的角色或声音风格,而不需要复杂的技术和昂贵的设备?现在,这个梦想成为现实的一部分,而且非常容易实现。在这篇文章中,我将向您介绍一个名为”Retrieval-based-Voice-Conversion-WebUI”的项目,它是一个基于VITS的简单易用的变声框架。无需深入的音频处理知识,只需轻松点击,您就可以实现令人惊叹的声音变化。

    项目概览

    Retrieval-based-Voice-Conversion-WebUI(以下简称RVC)是一个开源项目,它的目标是让声音变换变得容易、快捷和有趣。这个项目基于VITS(Variational Inference Text-to-Speech)模型,该模型在语音合成领域取得了显著的成就。RVC借助VITS的强大功能,为用户提供了一个简单的网页界面,让您能够以前所未有的方式探索声音。

    项目特点

    RVC拥有许多引人注目的特点,使其成为一个令人兴奋的项目:

    • 使用检索替换声音源特征:RVC采用了一种创新的方法,使用检索技术来替换输入源的特征,以杜绝音色泄漏,确保声音变换的高质量。

    • 适用于各种硬件:即使在相对较差的显卡上,RVC也能快速训练,这意味着您不需要超级高端的硬件来享受声音变换的乐趣。

    • 使用少量数据训练:与许多其他声音变换方法不同,RVC可以在少量数据下训练,只需10分钟左右的低噪音语音数据,就能获得出色的结果。

    • 模型融合:RVC允许您通过模型融合来改变音色,借助模型选项卡中的ckpt-merge选项,您可以自定义声音的风格。

    • 简单易用的网页界面:RVC提供了一个直观的网页界面,无需复杂的命令行操作,您只需点击几下,即可完成声音变换。

    • 人声分离:RVC还支持调用UVR5模型,以快速分离人声和伴奏,让您更轻松地处理音频文件。

    • 先进的音高提取算法:RVC采用了最先进的人声音高提取算法,根据哑音问题进行优化,实现更好的效果,同时占用更小的资源。

    • A卡和I卡加速支持:无论您使用的是A卡还是I卡,RVC都提供了相应的支持,以满足不同用户的需求。

    环境配置

    要开始使用RVC,您需要确保您的环境配置正确。以下是设置环境的简要步骤:

    1. 安装Python 3.8或更高版本。

    2. 安装PyTorch及其核心依赖,可以使用以下命令:

      pip install torch torchvision torchaudio

      对于Windows用户,如果使用Nvidia Ampere架构(如RTX30xx),您可能需要指定PyTorch对应的CUDA版本。您可以使用以下命令:

      pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu117
    3. 安装项目依赖项,您可以使用Poetry或pip来安装依赖。具体的命令请参考项目文档。

    4. 下载所需的预模型文件,项目提供了下载链接和说明。

    5. 启动WebUI,运行以下命令:

      python infer-web.py

    以上是基本的环境配置步骤,具体的配置细节可以在项目文档中找到。

    结语

    Retrieval-based-Voice-Conversion-WebUI是一个引人注目的项目,它将声音变换带入了新的境界,使其变得简单、快捷和有趣。不再需要复杂的音频处理技巧,只需轻松点击几下,您就能探索无限的声音可能性。无论您是声音爱好者还是音频专业人士,RVC都值得一试。

    如果您想要探索声音的奇妙世界,不妨前往Retrieval-based-Voice-Conversion-WebUI的GitHub仓库了解更多信息,并亲自体验声音的变幻魔法!

  • 从零开始学习使用Robocopy进行文件管理

    从零开始学习使用Robocopy进行文件管理

    在数字化时代,文件管理和数据备份至关重要。无论是在个人生活中还是在工作中,我们经常需要将文件从一个地方复制到另一个地方,或者创建文件的备份。为了帮助您高效地管理文件,我将介绍Robocopy,这是Windows操作系统中一个强大的命令行实用工具。使用Robocopy,您可以轻松进行文件复制、同步和备份,而无需依赖图形用户界面。

    什么是Robocopy?

    Robocopy,也称为“Robust File Copy”,是Windows操作系统内置的命令行实用程序,用于高效地复制、同步和备份文件和目录。Robocopy具有强大的功能,允许您在不同目录之间复制文件,保留文件属性、时间戳和权限。与普通的文件复制工具相比,Robocopy提供了更多的控制选项,适用于各种文件管理需求。

    安装Robocopy

    幸运的是,Robocopy已经预装在Windows操作系统中,因此您无需单独安装它。只需打开命令提示符窗口,即可开始使用Robocopy。

    Robocopy的基本语法

    在使用Robocopy之前,让我们先了解一些基本的语法。

    robocopy 源目录 目标目录 [文件名] [选项]
    • 源目录:要复制文件的起始位置。
    • 目标目录:要将文件复制到的目标位置。
    • 文件名:可选参数,指定要复制的文件的名称。如果不提供文件名,将复制源目录中的所有文件。
    • 选项:用于控制复制操作的各种选项和标志。

    基本文件复制

    首先,让我们看看如何使用Robocopy进行基本的文件复制。假设您有一个名为C:\Source的源目录,您想要将其中的文件复制到D:\Destination目录中。以下是命令的示例:

    robocopy C:\Source D:\Destination

    这将复制C:\Source目录中的所有文件和子目录到D:\Destination目录中。

    保留文件属性和时间戳

    Robocopy默认会保留文件的属性、时间戳和权限。这意味着复制的文件在目标位置将具有与源文件完全相同的属性和时间戳。

    备份文件

    Robocopy还可以用于创建文件的备份。要执行备份操作,您可以使用/B选项,该选项将尝试使用备份模式复制文件。

    robocopy C:\Source D:\Backup /B

    请注意,备份操作需要管理员权限,因此您可能需要以管理员身份运行命令提示符。

    复制特定文件

    有时,您可能只想复制特定类型的文件,例如.txt文件。您可以使用/XF选项来指定要排除复制的文件。

    robocopy C:\Source D:\Destination /XF *.txt

    这将复制C:\Source目录中除了.txt文件之外的所有文件。

    同步目录

    Robocopy还可以用于同步两个目录,确保它们的内容保持一致。要执行同步操作,可以使用/MIR选项。

    robocopy C:\Source D:\Destination /MIR

    这将确保D:\Destination目录的内容与C:\Source完全一致,包括删除不再存在于源目录中的文件。

    计算复制速度

    Robocopy还提供了计算复制速度的功能,这对于评估复制操作的效率非常有用。在Robocopy完成操作后,它会显示复制速度,以MB/分钟为单位。

    结论

    通过学习如何使用Robocopy,您可以更轻松地管理文件、备份数据并确保目录的同步。无论是在个人电脑上进行文件管理还是在企业环境中进行数据备份,Robocopy都是一个强大而可靠的工具。

    请记住,Robocopy是一个功能强大的命令行工具,具有多种选项和标志,可以根据您的需求进行自定义。掌握它将使您更加高效地管理文件和数据。

    如果您对Robocopy有任何问题或需要更多的帮助,请随时访问我的博客大神的AI技术博客,我将尽力提供支持。

  • 生成SSH公钥:探索安全之门

    生成SSH公钥:探索安全之门

    在数字时代,安全性是至关重要的。对于大多数人来说,保护其在线信息和通信是一项首要任务。而对于像王大神这样的CEO,安全问题更是至关重要,因为他在两家公司的领导地位使得他成为黑客和网络威胁的高价值目标。因此,为了加强他的网络安全,生成SSH公钥是一个必不可少的步骤。今天,我们将探讨SSH公钥的生成过程,并为你详细介绍这一关键的安全措施。

    开篇故事:走进网络的钥匙之门

    一天,王大神坐在他的办公室里,思考着公司的网络安全问题。他明白,公司的数据和客户信息需要妥善保护,而SSH公钥是实现这一目标的关键。但与此同时,他也意识到,网络安全不仅仅是技术问题,它关乎每个员工的责任。于是,他决定亲自学习并分享有关生成SSH公钥的知识,以提高整个团队的网络安全意识。

    SSH公钥是什么?

    首先,我们需要明确什么是SSH公钥。SSH代表Secure Shell,它是一种网络协议,用于在网络上安全地传输数据。SSH公钥是SSH协议的一部分,用于认证用户并确保数据的机密性。它是一对密钥中的一部分,包括公钥和私钥。公钥通常存储在服务器上,而私钥则存储在用户的计算机上。

    为什么要生成SSH公钥?

    你可能会问,为什么要生成SSH公钥?生成SSH公钥的主要目的是进行身份验证。当你连接到远程服务器时,服务器会要求你提供公钥来证明你的身份。如果服务器上存储的公钥与你提供的公钥匹配,你将被授权访问服务器。这种方式比传统的用户名和密码认证更加安全,因为它使用了加密技术,使得黑客很难破解你的身份。

    此外,生成SSH公钥还可以实现无密码登录。当你生成SSH公钥并将公钥添加到服务器的授权列表中后,你可以在不输入密码的情况下访问服务器。这极大地提高了操作效率,尤其是对于那些需要频繁与远程服务器交互的人来说。

    生成SSH公钥的步骤

    现在,让我们详细了解生成SSH公钥的步骤。无论你使用的是Linux、macOS还是Windows,这个过程都是相似的。

    步骤1:检查是否已拥有SSH密钥

    首先,你需要确认自己是否已经拥有SSH密钥。默认情况下,用户的SSH密钥存储在其 ~/.ssh 目录下。进入该目录并列出其中的内容,你便可以快速确认自己是否已拥有密钥。在终端中执行以下命令:

    $ cd ~/.ssh
    $ ls

    如果你找到一对以 id_dsa 或 id_rsa 命名的文件,并且其中一个带有 .pub 扩展名,那么恭喜你,你已经拥有SSH密钥。.pub 文件是你的公钥,另一个是与之对应的私钥。如果找不到这样的文件(或者根本没有 .ssh 目录),那么我们需要继续下一步。

    步骤2:生成SSH密钥

    如果你没有现成的SSH密钥,可以通过运行 ssh-keygen 程序来生成它们。在Linux和macOS系统中,ssh-keygen 随SSH软件包提供;在Windows上,该程序包含于MSysGit软件包中。在终端中执行以下命令:

    $ ssh-keygen -o

    运行这个命令后,会出现以下提示:

    Generating public/private rsa key pair.
    Enter file in which to save the key (/home/your_username/.ssh/id_rsa):

    ssh-keygen 会首先确认密钥的存储位置,默认是 ~/.ssh/id_rsa,你可以按回车键接受默认值,也可以指定其他位置。接下来,它会要求你输入两次密钥口令。口令是用于保护你的私钥的,如果你不想在使用密钥时输入口令,可以将其留空。然而,如果你使用了密码,那么请确保添加了 -o 选项,它会以比默认格式更能抗暴力破解的格式保存私钥。

    生成成功后,你的私钥将存储在指定位置,而公钥将存储在相同目录下,并以 .pub 扩展名结尾的文件中。

    步骤3:发送公钥给服务器管理员

    进行了上述操作后,你需要将你的公钥发送给任意一个Git服务器管理员,前提是服务器正在使用基于公钥的SSH验证设置。他们所要做的就是复制你的公钥文件的内容,并将其通过邮件或其他安全渠道发送给你。

    你的公钥文件内容应该类似于下面的示例:

    ssh-rsa AAAAB3NzaC1yc2EAAAABIwAAAQEAklOUpkDHrfHY17SbrmTIp
    
    NLTGK9Tjom/BWDSU
    GPl+nafzlHDTYW7hdI4yZ5ew18JH4JW9jbhUFrviQzM7xlELEVf4h9lFX5QVkbPppSwg0cda3
    Pbv7kOdJ/MTyBlWXFCR+HAo3FXRitBqxiX1nKhXpHAZsMciLq8V6RjsNAQwdsdMFvSlVK/7XA
    t3FaoJoAsncM1Q9x5+3V0Ww68/eIFmb1zuUFljQJKprrX88XypNDvjYNby6vw/Pb0rwert/En
    mZ+AW4OZPnTPI89ZPmVMLuayrD2cE86Z/il8b+gw3r3+1nKatmIkjn2so1d01QraTlMqVSsbx
    NrRFi9wrf+M7Q== [email protected]

    总结

    在这篇文章中,我们详细介绍了生成SSH公钥的过程以及为什么这是保护网络安全的关键步骤。SSH公钥不仅可以帮助你实现更安全的身份验证,还可以让你实现无密码登录,提高操作效率。

    最后,无论你是王大神这样的CEO,还是普通的网络用户,保护个人信息和网络安全都是至关重要的。生成SSH公钥是加强网络安全的一种重要方法,帮助你确保只有授权用户能够访问你的系统和数据。

    So, remember, 生成SSH公钥是打开网络安全之门的关键一步!

  • 如何选择适合iOS开发和剪辑视频的黑苹果主机

    如何选择适合iOS开发和剪辑视频的黑苹果主机

    在进行iOS开发和视频剪辑时,选择一台适合的计算机是非常重要的。一位用户提到了他的需求,即需要一台既能满足Mac端开发需求又能进行Windows端开发,并且还要用于视频剪辑。他考虑了购买Mac mini和一台搭载黑苹果系统的主机,但担心黑苹果系统可能会出现问题。在本文中,我们将深入探讨如何选择适合iOS开发和视频剪辑的计算机,以及是否应该考虑黑苹果主机。

    了解需求

    在选择计算机之前,首先要明确自己的需求。用户需要一台能够运行Xcode(iOS开发工具)的计算机,同时也需要足够的性能来处理视频剪辑任务。这意味着计算机需要具备较高的内存、处理器性能以及存储空间。

    黑苹果 vs. 白苹果

    1. 黑苹果

    黑苹果是指在非苹果硬件上安装macOS操作系统的做法。虽然它可以在一些普通PC上运行macOS,但通常需要一些技术知识来配置和维护。黑苹果系统通常比正版苹果硬件上的macOS更便宜,但也可能面临一些兼容性和稳定性问题。

    对于iOS开发来说,黑苹果通常需要在新版本的macOS发布后进行更新,以确保Xcode等开发工具的兼容性。这可能需要一些额外的工作,因为黑苹果系统需要使用Opencore等工具进行配置。

    2. 白苹果

    白苹果是指使用正版苹果硬件(如Mac mini、iMac等)来进行开发和剪辑。这些设备通常具有较好的性能和稳定性,而且不需要额外的配置或维护工作。对于iOS开发来说,白苹果设备通常能够无缝运行最新版本的Xcode,并且得到苹果官方支持。

    推荐的选择

    考虑到用户的需求和预算,以下是一些可能的选择:

    1. Mac mini

    如果预算允许,购买一台Mac mini可能是最简单的选择。它是一台正版苹果设备,能够流畅运行Xcode和其他开发工具。用户可以选择16GB内存的配置,以确保足够的性能来进行iOS开发和视频剪辑。此外,Mac mini还可以通过外接存储扩展存储空间,以满足视频剪辑的需求。

    2. 搭载黑苹果的台式机

    如果预算有限,但仍希望能够同时进行iOS开发和视频剪辑,考虑搭载黑苹果系统的台式机可能是一个经济实惠的选择。用户可以选择一台配置较高的台式机,安装黑苹果系统,并确保系统的稳定性和兼容性。这需要一些技术知识和时间来配置,但可以提供较好的性能。

    总结

    在选择适合iOS开发和视频剪辑的计算机时,要考虑自己的需求和预算。如果预算充足并且希望无忧地进行开发和剪辑工作,那么购买一台Mac mini可能是最佳选择。如果预算有限但愿意投入一些配置工作,那么搭载黑苹果系统的台式机也可以满足需求。

    无论选择哪种方式,都应该考虑到系统的稳定性和性能,以确保能够高效地进行iOS开发和视频剪辑工作。