这不是一篇“安装 Codex、输入提示词、等待它写代码”的入门文章。
这是一套已经在真实软件接管、并发开发、自动测试、客户交付和系统自举中使用过的方法:人类掌握目标与最终控制权,Codex 负责架构、调度和收口,多家 CLI 按能力与额度协同,合同与原始素材被编译成任务图、验收标准和可恢复的软件交付链。
写这篇文章的起因是,我要去做其他事情了。
而且你也不一定选Codex做主脑(猪脑)
怎么便宜怎么来。
我的蜂群上线已经到了4096,还算是浪漫的数字吧。
未来就是不死鸟。
说了不写教程真的是打自己的脸蛋啊。🧐
主要要点流量,最近要搞搞宣发。
Codex No.1教程:别再把 Codex 当聊天框,用蜂群OS把合同、素材和多 CLI 编译成一支高速 AI 开发团队
一、为什么市面上大多数 Codex 教程还停留在“玩具阶段”
最近关于 Codex 的教程越来越多,但大量内容仍然围绕几个初级动作:安装 CLI、选择模型、写一段很长的 Prompt、接入几个 MCP、让 Agent 修改一个文件,然后展示一句“测试通过”。
这些内容不能说错,但它们回答的只是“一个 AI 能不能帮我写代码”,没有回答真正进入生产后必然出现的问题:
- 一个项目有几十个任务时,谁决定先做什么?
- Codex、Claude、Kimi、GLM 等多个 CLI 同时可用时,谁应该接单?
- 某个模型额度不足、登录失效或者响应变慢时,任务怎样换人但不降级?
- 多个 Agent 同时写代码,怎样避免相互覆盖?
- 聊天窗口关闭、电脑重启或某个 CLI 崩溃后,任务怎样恢复?
- Agent 说“完成了”,它到底完成的是代码、测试、部署,还是客户真的能用?
- AI 开发 AI 自己时,怎样避免候选版本把唯一稳定版本一起弄坏?
- 合同、访谈、客户素材、旧系统和数据库,怎样进入工程,而不是沦为 Prompt 附件?
真正的分水岭,不是你会不会写提示词,而是你有没有一套“Agent 可以读取、执行、验证和恢复”的工程环境。
OpenAI 在介绍 Codex App 时已经把方向说得很明确:开发正在从“和单个编码 Agent 配对”,转向“监督多个 Agent 完成设计、开发、发布和维护的全生命周期”,并且使用独立 Worktree 让多个 Agent 在同一仓库并行工作而不相互冲突。OpenAI 对 Codex App 与多 Agent Worktree 的说明
OpenAI 后来把这种工作称为 Harness Engineering:工程师的核心工作不再只是亲手写每一行代码,而是设计环境、表达意图、构造反馈循环,让 Agent 能可靠地完成工作。OpenAI:Harness engineering
蜂群OS的出发点与此一致,但再往前一步:
不把 Codex 当成一个更聪明的代码补全工具,而把它当成 AI 开发组织的主入口;不把其他模型当成聊天备胎,而把它们当成需要入职考试、权限、额度、岗位和验收记录的工程成员。
本文所谓“Codex No.1”,不是宣称某个模型永远占据排行榜第一。模型排名会变化,价格会变化,额度会变化,入口也会变化。这里的 No.1 指的是一条第一原则:
人类控制目标,系统控制流程,模型负责执行,证据决定完成。
二、蜂群OS到底是什么:不是模型套壳,而是一家可执行的 AI 公司
蜂群OS(SwarmOS)是一层位于人类目标和各类 AI 执行器之间的开发操作系统。它的兼容内核可以叫 DeliveryOS,团队内部可以叫 Agent 军团,但其逻辑只有一套:
text
人类蜂王主脑
    │ 目标、边界、最终批准
    ▼
蜂群OS 控制面
    │ 项目、任务图、身份、策略、Session、事件、证据
    ├───────────────┐
    ▼               ▼
质量路由器        耐久调度器
能力/质量/额度     队列/重试/恢复
    └───────┬───────┘
            ▼
本机或远程 Worker
            │
  Codex / Claude / Kimi / GLM / 其他合格 CLI
            │
            ▼
Worktree → 测试 → 审查 → 候选版本 → 交付证据
这里有四个经常被混淆的身份。
第一,人类是唯一蜂王主脑。人类决定业务目标、资金动作、最终风险接受程度和版本晋级。AI 可以处理大量日常事务,但不能把“安装了一个插件”解释为“获得了全局治理权”。
第二,蜂群OS Core 是控制面。它保存项目、任务依赖、运行状态、权限、派单结果和证据。这些状态不能只活在某个聊天窗口里,否则换一个平台、关掉一个会话,整个团队就失忆。
第三,Worker 是执行节点。它可以是当前电脑、另一台工作站、服务器,也可以是未来接入的临时算力节点。Worker 只执行获批任务,不拥有全局调度权。
第四,CLI 是可替换的员工入口。Codex、Claude、Kimi、GLM 或其他模型渠道都只是适配器。它们使用设备所有者自己的账号、登录和额度;蜂群身份凭据只负责证明“谁有权接什么任务”,绝不能复制或冒充模型账号。
这一区分极其重要。没有它,多 Agent 系统很容易变成一堆脚本互相调用:任何脚本都能改策略,任何节点都能发任务,任何模型都能自称审查通过。看起来热闹,实际上没有组织。
三、AGENTS.md 不是提示词,而是这家 AI 公司的工程宪法
很多人把 AGENTS.md 理解成“告诉 Codex 代码风格的地方”。这只用了它很小的一部分价值。官方资料也建议用 AGENTS.md 给 Codex 持续提供仓库级上下文,例如代码组织方式、测试方法和工程约定。OpenAI:Codex 与 AGENTS.md
在蜂群工程里,AGENTS.md 应该承担四层职责。
1. 身份层:谁能决定什么
markdown
- 用户是唯一 controller,拥有项目创建、Worker 批准和版本晋级权。
- worker 只能执行被分配的任务并回传证据。
- standalone 只能管理本机范围,不能自动加入全局蜂群。
这不是“建议”,而是运行时权限合同。界面隐藏按钮不算权限控制,API、MCP 和 Core 必须真正拒绝越权请求。
2. 行为层:哪些事情自动做,哪些事情必须停下
好的 Agent 团队不应该每三分钟问一次“我可以继续吗”。普通安装、依赖修复、测试、进程重启和候选部署,应当在明确范围内自主完成。真正需要人类确认的是付款、整机重启、整机关机、不可逆数据删除、正式版本晋级等少数动作。
授权边界越清楚,Agent 越快。模糊的权限不会带来安全,只会带来两种坏结果:要么 Agent 什么都问,团队失去速度;要么 Agent 自己猜,风险反而更大。
3. 工程层:怎么写、怎么并行、怎么验证
markdown
- 写任务必须拥有唯一文件范围。
- 多个写入型 Agent 默认使用独立分支与独立 Worktree。
- 一个提交只包含一个可解释、可验证、可回退的变化。
- “进程启动”不等于“功能完成”;必须验证真实用户入口。
- 不覆盖唯一稳定版本,候选版本单独安装和验收。
这里最关键的不是“写 TypeScript 还是 Python”,而是把并发边界写清楚。真正的并行不是让四个模型一起改同一个文件,而是把任务拆成互不重叠的所有权:一个负责数据面,一个负责 API,一个负责前端,一个负责部署,一个只读审查。
4. 记忆层:让错误变成下一次的能力
每次失败都必须留下可复用记录:症状、根因、无效尝试、最小解法、验证方法、回滚方式和防复发动作。否则同一个团队只是拥有很多上下文很长、但每天都会失忆的聊天机器人。
因此,一个成熟仓库至少应该有这些事实源:
text
AGENTS.md                 全局治理与工程规则
README.md                 管理入口
catalog.yaml              资产索引
projects/<id>/PROJECT     项目定义
projects/<id>/TASK-GRAPH  可执行任务图
projects/<id>/LEDGER      时间、成本、错误、证据账本
members/                  设备、服务、模型、插件档案
runbooks/                 可重复操作方法
logs/                     已发生事件
evidence/                 测试与验收结果
四、最快的 AI 开发,不是从 Prompt 开始,而是把现实“编译”成工程
软件项目最原始的输入,通常根本不是代码。它可能是一份合同、四个压缩包、一堆截图、客户语音、旧数据库、产品原型、历史聊天记录,以及一句“帮我尽快上线”。
普通做法是把这些材料扔进模型,让它总结需求。蜂群方法不是“总结”,而是“编译”。
为什么要用编译这个词?因为编译有源文件、有中间表示、有类型检查、有错误、有目标产物。原始合同不能在模型总结之后消失;模型的推断不能伪装成客户事实;模糊条款必须成为待决问题;每一项交付要求必须能追到验收动作。
完整链路如下:
text
合同 / 原始素材 / 旧系统 / 客户访谈
                │
                ▼
第一层:原件保全
哈希、只读副本、版本、来源、时间、缺失项
                │
                ▼
第二层:事实抽取
角色、业务对象、流程、接口、数据、非功能约束
                │
                ▼
第三层:交付定义卡
本期做什么、不做什么、什么叫可演示、什么叫可交付
                │
                ▼
第四层:验收 Oracle
可重复执行的业务、权限、性能、恢复和客户体验判定
                │
                ▼
第五层:任务 DAG
依赖、Owner、能力角色、写入范围、输入、输出、失败条件
                │
                ▼
第六层:Agent 执行与证据回写
Session、Worktree、提交、测试、部署、日志、成本
原件保全:先确保 AI 没有“理解错后毁掉证据”
接管旧项目时,不要先运行格式化,不要先删除“看起来没用”的文件,更不要为了 Git 状态漂亮直接清理现场。应该先记录:
- 原始包和关键归档的 SHA-256;
- Git Bundle 或仓库历史是否完整;
- 未提交、已删除、未跟踪内容;
- 数据库和容器卷是否可恢复;
- 原平台实际入口与运行版本;
- 哪些数据源才是业务权威。
AI 时代最昂贵的错误,经常不是代码写错,而是把唯一原件覆盖后,所有 Agent 都在错误事实之上高速前进。
交付定义卡:把“做完”变成类型,而不是情绪
一个项目至少要区分四种状态:
- code-complete:代码已实现,局部测试通过;
- integrated:与主链合并,回归通过;
- preview:真实入口可访问,目标角色能操作;
- deliverable:备份恢复、迁移、客户文档、公网入口和最终验收全部完成。
很多 AI Demo 的问题,是把第一个状态叫成第四个状态。页面打开了,就说系统交付了;接口返回 200,就说业务闭环了;容器在运行,就说部署成功了。
蜂群OS要求每个状态都有证据,状态不能靠 Agent 的语气推进。
验收 Oracle:在写代码之前定义“机器如何判案”
Oracle 不是一句“请确保质量良好”,而是可执行判定。例如:
yaml
task: appointment-concurrency
input:
  appointment_id: seeded-fixture-01
action:
  concurrent_requests: 2
expected:
  success_count: 1
  conflict_count: 1
  audit_records: 1
  final_status: confirmed
当两个请求同时修改一个预约时,究竟应该发生什么?如果这个问题没在任务开始前说清楚,两个模型可能分别写出“看起来合理”的实现,而集成时才发现业务语义冲突。
五、任务图:把“帮我做完项目”变成可以并行的依赖网络
大目标不能直接平均切成四份。任务图必须先找依赖,再找可以并行的边界。
yaml
waves:
  - id: W0
    name: 事实冻结
    tasks:
      - id: contracts
        mode: readonly
        outputs: [业务合同, 角色矩阵, 数据字典]

  - id: W1
    name: 基础内核
    depends_on: [W0]
    tasks:
      - id: api-kernel
        write_scope: [apps/api/**]
      - id: plugin-sdk
        write_scope: [packages/plugin-sdk/**]

  - id: W2
    name: 领域并行
    depends_on: [W1]
    tasks:
      - id: health-domain
        write_scope: [domains/health/**]
      - id: finance-domain
        write_scope: [domains/finance/**]
      - id: report-ai
        write_scope: [domains/reports/**]

  - id: W3
    name: 集成与交付
    depends_on: [W2]
一个任务节点至少包含:目标、依赖、角色、读写模式、唯一写入范围、输入版本、输出、测试、超时、重试、回退、成本影响和证据位置。
模型名称不应该成为业务合同。任务写的是“需要通过后端并发角色实测的实现者”,而不是永远写死“必须某模型”。今天最强的模型,明天可能额度不足;今天失败的渠道,明天可能升级。供应商是路由层的决定,不是产品层的依赖。
六、多 CLI、多模型调度:谁空闲、谁合格、谁有额度,谁上
“多模型协作”最容易被写成一张华丽的架构图:一个模型负责规划,一个模型负责代码,一个模型负责审查。问题是,现实中的渠道不是永远在线的。额度会重置,账号会掉登录,代理会波动,CLI 会升级,模型身份会漂移,某个擅长前端的模型也未必适合财务并发。
所以蜂群调度不能固定成一张供应商座位表,而要像生产调度系统一样,每次派单重新计算。
第一道门:角色资格
模型必须先通过对应岗位的真实考试。例如:
- implementation/frontend:能否理解现有设计系统、完成响应式页面、通过构建和浏览器测试;
- implementation/backend:能否处理事务、幂等、状态机、并发和迁移;
- review:能否找到可复现的问题,而不是只输出风格意见;
- research:能否区分官方资料、二手线索和本机实测;
- mechanical:能否稳定完成 Schema、格式、批量边界检查。
没有通过岗位实测的模型,即使便宜、空闲、额度很多,也不能接这个岗位。质量资格永远先于成本。
第二道门:当前身份与健康
调度器要确认实际调用的模型是谁、CLI 版本是什么、登录是否有效、网络和代理路径是否可用、最近一次真实调用是否成功。配置文件写着“高级模型”不代表当前运行的就是它。
第三道门:可信额度
“我感觉还有额度”不能用于自动派单。额度记录至少要包含:
- 已使用和剩余比例;
- 额度窗口与重置时间;
- 官方数据、会话消耗还是本地估算;
- 采集时间和是否过期;
- 是否需要人工登录;
- 保留线。
未知额度的渠道可以被人工点名做健康探测,但不能加入自动路由。某渠道达到保留线后停止接收新任务,保留给关键收口或用户直接使用。
第四道门:空闲槽位与重复消费保护
同一个任务必须有稳定的幂等键。即使控制面超时,也要先查询后端是否已经接受,不能因为“没看到回复”就再派一次,导致两个模型同时写同一任务、消耗两份额度。
可以把路由逻辑简化为:
python
eligible = [
    worker for worker in workers
    if worker.role_certified(task.role)
    and worker.model_identity_verified
    and worker.login_healthy
    and worker.quota.is_fresh
    and worker.quota.above_reserve
    and worker.available_slots > 0
    and task.provider_pool.allows(worker.provider)
]

selected = rank(eligible, by=[quality, latency, cost, load]).first()
这里最容易犯的错误是“显式指定模型就绕过其他规则”。正确语义应该是取交集:用户点名的 Provider 仍然必须属于项目允许池,仍然必须通过角色、额度、健康和权限门禁。空 Provider 池意味着禁止任何模型自动执行,不能因为请求里又写了一个模型名就把它重新塞回来。
不平均分配,也不浪费已购买渠道
蜂群不是为了追求“每个模型今天都用一次”。平均分配看似公平,实际会把关键任务交给不合适的模型。正确目标是单位墙钟时间内的有效交付:
- 合格、空闲、有可信额度的成员优先;
- 多个合格者同时存在时,按质量、速度、成本和负载排序;
- 某渠道需要反复弹网页登录,就标记为手动,不让它拖住后台队列;
- 同一模型连续失败不无限重试,按预设 cascade 换人;
- 实现和最终独立审查使用不同供应方;
- 主脑模型也在规则内,不应把自己额度打空再让其他 CLI 闲置。
七、连接层改用 Tailscale:让蜂群跨设备,但不把控制权交给网络
蜂群从单机扩展到工作站、服务器、手机和异地节点后,首先需要解决的是私有连接。目标不是“所有设备互相 ping 通”,而是让正确身份只能访问正确端口,并且节点更换网络后仍能被稳定发现。
蜂群OS下一版连接层采用 Tailscale,但必须明确两层身份不能混为一谈:
text
Tailscale 身份:这台设备能否到达某个 IP/端口
SwarmOS 身份:这台设备能否接任务、改策略、批准 Worker、晋级版本
Tailscale 负责加密网络、设备发现和网络访问策略;蜂群OS Core 仍负责 controller、worker、standalone 权限。一个节点能连接 Core,不等于它有权创建全局项目。
推荐拓扑
text
Tailscale tailnet

       ┌──────────────────────────────────┐
       │                                  │
蜂王控制端                         只读观察端
tag:swarm-controller              tag:swarm-observer
       │                                  │
       ├──── Core API / Event Stream ─────┤
       │
       ├──────────────┬──────────────┐
       ▼              ▼              ▼
开发工作站         GPU/模型节点       部署服务器
tag:swarm-worker  tag:swarm-worker   tag:swarm-prod
新 tailnet 如果没有自定义访问策略,不能想当然地认为已经完成最小权限。Tailscale 当前推荐新配置使用 Grants;Grants 可以按用户、组、标签、目标和端口声明访问能力。Tailscale:Grants
下面是概念示例,不是可直接复制到任何账号的生产配置:
jsonc
{
  "tagOwners": {
    "tag:swarm-controller": ["autogroup:admin"],
    "tag:swarm-worker": ["tag:swarm-controller"],
    "tag:swarm-observer": ["autogroup:admin"]
  },
  "grants": [
    {
      "src": ["tag:swarm-controller"],
      "dst": ["tag:swarm-worker"],
      "ip": ["tcp:22", "tcp:8890"]
    },
    {
      "src": ["tag:swarm-worker"],
      "dst": ["tag:swarm-controller"],
      "ip": ["tcp:8890"]
    },
    {
      "src": ["tag:swarm-observer"],
      "dst": ["tag:swarm-controller"],
      "ip": ["tcp:8890"]
    }
  ]
}
真实配置必须进一步区分“控制 API”“只读事件流”“部署入口”,不能让观察端因为能打开控制台就自动拥有修改权。
节点入网方式
人工设备可以通过交互登录加入;服务器适合使用带标签的 Auth Key,临时容器或一次性 Worker 使用 Ephemeral Key。长期自动化不要把永不过期的密钥写进仓库,可以使用受限 OAuth Client 动态生成 Auth Key。Tailscale 的服务器部署指南也建议用标签约束服务器访问,并针对长期自动化使用 OAuth Client。Tailscale:设置服务器 Tailscale:OAuth Clients
蜂群档案中只记录凭据引用、用途和恢复方法,不输出密钥本身。
从现有连接迁移到 Tailscale 的正确顺序
不要一上来卸载旧网络。生产迁移使用双轨法:
- 只读盘点现有节点、地址、服务、路由和防火墙;
- 安装 Tailscale,但保留旧连接;
- 给控制端、Worker、服务器分配清晰标签;
- 写 Grants,并用策略测试验证允许与拒绝路径;
- 让 Worker 通过 Tailscale 完成一次真实任务领取、执行、证据回传;
- 模拟 CLI 失败、节点掉线和控制端重启,验证恢复;
- 更新资产档案和 MagicDNS 名称,不把临时 IP 写死在项目里;
- 观察稳定后再停止旧路径;
- 回滚窗口结束后,旧网络才进入退役,而不是直接删除。
如果需要更强的节点加入保证,可以评估 Tailnet Lock,由受信节点签署新节点密钥;但它属于后续安全增强,不应在功能迁移的每一步反复打断开发。Tailscale:Tailnet Lock
八、Session、Worktree 和事件流:让并行开发可恢复,而不是靠聊天记忆
每次可恢复工作都必须拥有 Session ID。Session 不是聊天标题,而是一条工程记录:
yaml
session_id: 20260902T150626Z-glm-xxxxxx
team: fast-development
task: report-data-plane
provider: glm
mode: write
repo: health-platform
branch: agent/swarm/...
worktree: /isolated/worktrees/...
write_scope:
  - apps/reporting/**
started_at: ...
status: running
final_commit: null
evidence: []
写入型 Agent 默认使用独立 Worktree。只读研究可以共享仓库,但不能写。每个文件范围只有一个 Owner;其他 Agent 可以审查该范围,却不能同时改它。
任务运行时,控制面追加事件:
text
control/created
control/approved
control/dispatch_claimed
control/dispatched-by-core
control/observed running
verification/command_started
verification/command_completed
control/observed succeeded
为什么要追加事件,而不是只保存一个 status=succeeded?因为最终状态无法解释发生了什么。一个任务可能在后端已接受后网络超时,如果控制面误以为没派出去,又重新派一次,就会形成重复消费和并发写入。事件流让系统判断“从未接受”“已接受但确认未知”“Worker 已开始”“Worker 已结束”这些完全不同的状态。
更重要的是,进度终于可以给人看。用户不应该面对一个沉默七小时的黑箱。控制台至少要展示:当前波次、正在执行的任务、负责人、模型、Session、Worktree、开始时间、最近事件、测试进度、额度状态、阻塞原因和下一验收点。
九、狗粮循环:蜂群OS必须先能安全地开发自己
狗粮循环不是一句“我们也使用自己的产品”。真正的自举必须让当前稳定版创建候选版,并且候选版不能覆盖唯一可用版本。
蜂群OS的发布链是:
text
stable 稳定版
  → 创建自举项目与任务图
  → 独立 candidate Worktree
  → 合格且有额度的 CLI 实现
  → 自动测试
  → 异源 Provider 功能审查
  → 独立安全审查阶段
  → 插件清单与 Skill/MCP 验证
  → 使用新 cachebuster 并行重装候选插件
  → 干净新会话重新发现与真实调用
  → 蜂王主脑批准晋级
  → 新 stable
为什么必须重新安装
源码通过测试,不代表用户实际加载的插件就是这份源码。插件缓存、版本号、Skill 发现和 MCP 配置都可能仍指向旧版本。因此候选必须使用新版本标识安装到独立缓存,并比较源码与安装产物;当前稳定缓存保留,出现问题可以恢复。
为什么必须用干净新会话
当前聊天可能已经加载旧 Skill、旧工具清单和旧说明。只有新会话从零发现插件、识别蜂群身份、读取最新 AGENTS.md,并完成一次真实任务,才能证明“下一位用户真的拿到了新版本”。
为什么安全审查放在功能完成之后
高速开发不等于没有安全。正确做法是阶段化:日常实现先完成业务功能和自动测试,项目功能收敛后再启动一次独立安全审查。这样安全审查面对的是稳定候选,不会在每个小步骤上重复检查尚未成形的代码。
只有三类事件允许中途紧急拦截:正在发生的凭据泄露、不可逆数据损失风险、权限越界。其余安全检查进入收尾阶段,由异源 Provider 或独立安全角色执行,开发者不能自我批准。
一次真实自举暴露了什么
在蜂群OS自举测试中,曾出现一个很有代表性的竞态:调度后端已经接受任务,Worker 启动得非常快,抢在 Core 持久化标准执行对象之前进行了恢复。任务本身成功了,但发布门禁需要的“由 Core 确认派单”事件缺失。
如果只看最终状态,这个任务是绿色的;如果看事件链,它不具备可证明的主脑调度路径。
修复不是简单地“多等几秒”,而是同时建立三条规则:
- Worker 给 Core 一个短暂的优先确认窗口;
- Core 晚到时,只能对 attempt、claim、execution 和 idempotency key 完全一致的恢复结果做幂等确认;
- 发布门禁必须绑定当前这一次 execution,旧尝试留下的成功事件不能替新任务过关。
另一次独立审查发现:项目已经明确给出空 Provider 池,但请求又显式指定模型时,路由器把该模型重新加入了候选。所有自动测试当时都通过,因为测试只覆盖了“空池+自动选择”,没有覆盖“空池+显式模型”。异源审查提出反例后,路由语义改为交集,并补上正反回归。
这就是狗粮循环的价值:不是为了证明系统永远不出错,而是强迫系统在开发自己时,把隐藏假设变成运行时规则和防复发测试。
十、脱敏实战:某大健康 SaaS 如何把一天压缩成可交付 V1
下面的数据来自一个真实的大健康软件接管与交付项目。为保护客户和业务数据,项目名称、域名、账号、机器地址、仓库路径、患者信息、报告内容和凭据全部省略;保留的只有任务类型、时间跨度、测试数量和可验证结果。
起点不是空仓库,而是约 4.5GB 的复杂现场
输入包括两套 Git 历史、多个容器卷归档、旧平台的未提交现场、ERP/医疗业务引擎,以及客户要求保留的原始资料。团队首先完成哈希校验和恢复演练,把正式 Git 开发工作区精简到约 86MB,同时保留原件、未跟踪交付物、已删除现场痕迹和原始数据卷。
这一步没有直接产生新页面,却决定了之后的所有高速开发是否可回滚。
并发不是一句口号,而是十条独立 Session
开发队把任务拆为数据面、API、前端、AI 报告链、任务与预约、生产容器、独立审查和最终集成等边界,共留下 10 条可恢复 Session。Kimi、GLM、Claude 与 Codex 使用不同分支和 Worktree,Codex 主要承担架构、集成、关键修复和最终验收,而不是把批量编码全部压在一个渠道上。
已登记的第一条并发开发 Session 在当晚 23:06 启动。到次日 01:40,生产化前端入口、API 反向代理、容器健康检查和发布包更新已经形成提交:关键开发窗口的墙钟跨度约 2 小时 34 分。
到次日 12:30,专业 V1 最终提交形成:从第一条 Session 到最终提交的墙钟跨度约 13 小时 24 分。这个数字包含模型执行、集成、返工、容器构建和测试等待,不应解释为单个 Agent 连续编码 13 小时,也不等于从商业立项到客户签收只需 13 小时。它说明的是:当任务边界、环境和验收足够清楚后,一支多 CLI 团队可以把大量原本串行的工程工作压入同一夜和半天。
真实速度不只看“写了多少代码”
AI 报告链使用脱敏 PDF 和 JPG 进行真实端到端测试:上传、OCR、AI 结构化处理、医生审核发布、用户读取与提问、时间线回读全部跑通。桌面路径用时 54.9 秒,移动路径用时 57.3 秒。服务重启后,7 份已发布报告仍然存在。
这比“接口响应 200”更接近用户感知速度:一分钟内完成一条完整业务链,而且结果经过重启持久化验证。
最终验收规模
专业 V1 收口时,机器证据包括:
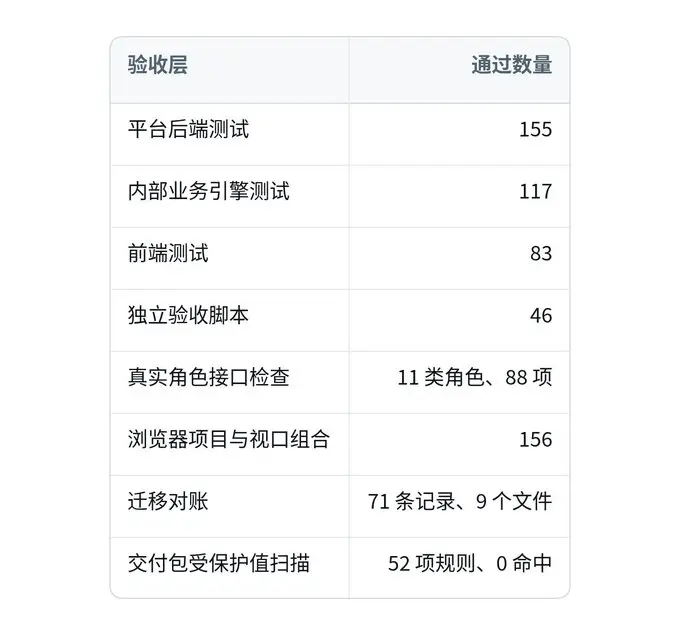
此外还完成了财务开单、收款、应收结清和总账回读,库存入库、出库、盘点调整与流水回读,备份与隔离恢复演练,以及公网多角色登录与关键业务读取。
独立审查为什么没有拖慢项目,反而节省返工
异源审查复现了预约状态转换的并发问题:两个并发请求可能同时成功并产生两条审计。实现者自己的常规测试没有暴露它。修复使用原子条件更新,并新增六项并发与边界回归。
这说明 review 的价值不是每做一步就让同一个人再看一遍,而是在功能和自动测试形成后,由不同模型主动构造反例。一次有效的异源审查,远比十次“代码看起来不错”的自我检查有价值。
这个案例也暴露了流程损耗
真实项目并非完美演示。最大的时间浪费不在写代码,而在以下内容确定得太晚:
- “Demo”“V1”“可交付”“客户可用”的口径不同;
- 客户入口、账号和文档标题反复变更;
- 开工前没有保存所有模型的额度基线,无法严谨计算项目净消耗;
- 客户手册和验收脚本接近结尾才集中制作;
- 身份库与业务权威数据源一度被混淆。
因此蜂群OS后来把交付定义卡、客户验收 Oracle、入口冻结点、四层成本账本和错误事件流提升为开工门禁。真实项目的意义,不是提供一个漂亮的成功故事,而是让下一次开发少走同样的弯路。
十一、如何估算 AI 项目:别再只说“几个人天”
传统人日仍可用于商务沟通,但它不再是最准确的工程单位。蜂群项目应同时报告三种时间:
- 机器执行时间:所有 Agent、测试、构建累计消耗的时间;
- 关键路径墙钟时间:从开工到满足下一门禁的现实时间;
- 外部等待时间:登录、付款、平台审核、客户反馈、DNS 生效等非工程等待。
再分别给出 P50 和 P90。假设三条独立任务各需一小时,并行执行后机器时间是三小时,关键路径可能只有一小时;但如果最后必须等待一次人工批准,关键路径仍由批准时间决定。
AI 时代真正稀缺的资源往往不是生成 Token,而是人类注意力、清晰决策、可测试环境和可靠反馈。OpenAI 的公开工程实践也强调,随着 Agent 吞吐提高,人类 QA 会成为瓶颈,因此需要让 UI、日志、指标和测试本身对 Agent 可读。OpenAI:Harness engineering
十二、一个团队如何从单个 Codex 升级为蜂群
不需要第一天就搭建完整平台。可以按四个阶段升级。
阶段一:让单个 Codex 可预测
- 写一份简洁但强制的 AGENTS.md;
- 固定真实测试命令;
- 记录项目事实源;
- 每个任务明确写入范围;
- 要求结果附带验证证据。
阶段二:让多个 Agent 可并行
- 为写任务创建独立 Worktree;
- 定义文件 Owner;
- 使用任务 DAG,而不是共享待办清单;
- 把实现和审查分给不同 Agent;
- 建立小而完整的提交规范。
阶段三:让多个 CLI 可调度
- 为每个 CLI 建能力档案;
- 做岗位实测,不照抄厂商宣传;
- 接入官方额度、健康和登录状态;
- 设置保留线、手动渠道和失败 cascade;
- 用幂等键防止重复派单与重复消费。
阶段四:让团队可跨设备、自举和发布
- 用 Tailscale 连接控制端与 Worker;
- 网络标签与蜂群身份分层;
- 状态离开聊天窗口,进入 Core 与事件存储;
- 稳定版和候选版并存;
- 建立完整狗粮循环;
- 只有人类 controller 能批准晋级。
十三、可以直接复制的项目开工清单
markdown
## 目标
- 客户最终拿走什么?
- 哪些角色使用?
- 什么叫 code-complete / preview / deliverable?

## 原始输入
- 原件路径与哈希
- 合同版本
- 权威数据源
- 已知缺失和冲突

## 边界
- 本期明确包含
- 本期明确不包含
- 必须人工批准的动作
- 不可触碰的稳定资产

## 任务图
- 依赖
- 能力角色
- 唯一写入范围
- Session / Branch / Worktree
- 验收 Oracle

## 路由
- 合格 Provider 池
- 当前额度和采集时间
- 保留线
- 手动渠道
- 失败回退链

## 发布
- 自动测试
- 异源功能审查
- 独立安全审查
- 候选安装
- 干净会话验收
- 回滚路径
- controller 晋级批准
最后:提示词会过时,工程闭环会复利
如果只是让 Codex 帮你改一个按钮,当然不需要蜂群OS。但当你开始接管真实项目、处理合同和原始数据、同时使用多个 CLI、连接多台设备、需要客户验收并且不能破坏稳定版本时,单个聊天窗口很快会到达极限。
这时真正决定速度的,不是再写一段更神奇的 Prompt,而是建立一套可读、可执行、可恢复、可验证的组织:
- 合同和素材被编译成事实、任务和 Oracle;
- AGENTS.md 把治理意图固化成工程宪法;
- Tailscale 提供跨设备私有连接,蜂群身份继续控制业务权限;
- 多 CLI 按能力、质量、额度、健康和空闲动态上岗;
- Session、Worktree 和事件流让并行工作可恢复;
- 自动测试决定功能事实,异源审查寻找反例;
- 狗粮循环保证系统先能可靠地开发自己;
- 最终版本只能由人类蜂王主脑晋级。
模型会越来越强,单次生成会越来越便宜。真正长期增值的,是你的合同编译器、任务图、测试 Oracle、错误知识库、模型能力档案和发布闭环。它们会让下一批 Agent 比上一批更快,让每次失败都变成团队资产。
这才是 Codex No.1 的含义:不是把一个模型捧上神坛,而是让 Codex 成为一支可管理、可替换、可证明的软件蜂群的第一入口。
资料与数据口径
- Codex、Worktree、AGENTS.md 与 Harness Engineering 的产品方向,参考 OpenAI 官方公开资料;文中蜂群OS架构、路由、狗粮循环和项目流程来自实际工程实践。
- Tailscale 部分依据其官方 Grants、服务器部署、OAuth Client 和 Tailnet Lock 文档撰写;示例为目标架构,实际迁移必须在节点盘点、双轨验证和回滚准备后执行。
- 案例来自内部项目账本、Session 档案、Git 提交时间和验收日志。为了脱敏,删除了项目名、客户名、域名、账号、设备、路径、提交号、健康数据和凭据。
- “2 小时 34 分”和“13 小时 24 分”均为已登记 Session 启动时间到对应提交时间的墙钟跨度,不是单模型纯推理时间,也不用于推导传统团队必然需要多少人日。
Leave a Reply