Category: 技术折腾

服务器、网络、硬件与自建工具的实践记录。

  • 腾讯云向量数据库:引领大数据时代的新篇章

    腾讯云向量数据库:引领大数据时代的新篇章

    在数字化时代,数据被视为黄金,而如何高效地管理和查询海量数据成为了企业和科研机构面临的挑战之一。腾讯云向量数据库的全面开放公测,为解决这一挑战提供了强大的解决方案。本文将深入探讨腾讯云向量数据库的特点以及它如何领先于大数据时代。

    腾讯云向量数据库:高效数据向量化

    腾讯云向量数据库是一项令人兴奋的技术突破,它通过将数据向量化,极大提升了存储和查询的效率。传统的数据库系统需要对数据进行复杂的索引和查询操作,而腾讯云向量数据库将数据转化为向量,使得查询过程更加高效。这种向量化的方法不仅提高了存储和查询效率,还解决了大模型预训练中的一系列问题,包括成本高、幻觉、缺乏长期记忆和知识更新不及时等。

    高规模向量检索

    腾讯云向量数据库具有高达100亿级向量检索规模的特点。这意味着它可以处理庞大的数据集,快速进行向量检索,为用户提供准确的查询结果。无论是面对海量图像、文本还是其他类型的数据,腾讯云向量数据库都能够轻松胜任。

    低计算成本

    在大数据时代,计算成本是一个不容忽视的问题。腾讯云向量数据库通过高效的向量化方法,将计算成本降到了最低。这意味着企业可以更经济高效地管理和查询数据,将资源用于更有价值的任务。

    高查询量

    腾讯云向量数据库不仅具有高效的计算能力,还能够处理高查询量。这意味着它适用于各种大规模数据应用场景,无论是电子商务、社交媒体还是科研项目,都能够得心应手。

    独家集成 Embedding 功能

    腾讯云向量数据库的独家集成 Embedding 功能使其在大模型场景下表现出色。企业和科研机构可以轻松地将大型模型嵌入到数据库中,实现更复杂的数据分析和查询。这一功能不仅提高了数据库的灵活性,还为用户提供了更多的数据分析工具。

    腾讯云的全套解决方案

    腾讯云不仅仅提供了腾讯云向量数据库这一强大的工具,还针对大模型场景建立了全套解决方案,加速了人工智能与大数据的全面融合。腾讯云的综合解决方案使人工智能与大数据更加紧密地结合,为企业带来了更多的机会和竞争优势。

    结语

    腾讯云向量数据库的全量开放公测标志着大数据时代的新篇章。它的高效向量化技术、低计算成本、高查询量以及独家集成 Embedding 功能,将为企业和科研机构带来前所未有的数据管理和查询体验。腾讯云的全套解决方案更是加速了人工智能与大数据的融合,为未来的发展开辟了更广阔的道路。让我们共同期待腾讯云向量数据库的应用,助力数字化时代的发展和创新。

  • Windows 11 2023 更新:微软再次颠覆操作系统体验

    Windows 11 2023 更新:微软再次颠覆操作系统体验

    在数字化时代,操作系统不仅是我们与计算机互动的桥梁,更是生活工作中不可或缺的一部分。微软作为全球领先的科技巨头,一直在不断推陈出新,不断创新,为用户带来更好的体验。今天,我们将聚焦在最新发布的 Windows 11 2023 更新上,探讨其中的变化和创新,以及它对我们的日常生活和工作带来的影响。

    Windows 11 2023 更新:功能升级

    微软一直以来都致力于为用户提供更好的操作系统体验,而 Windows 11 2023 更新正是这一承诺的体现。这次更新计划带来了一系列重大的功能升级,其中包括全新的 Windows Copilot、AI 驱动的 Paint、截图工具、Photos 应用的更新、RGB 灯光支持以及现代化的文件资源管理器等等。这些功能的引入,将进一步提升用户的工作效率和娱乐体验。

    全新的 Windows Copilot

    Windows Copilot 是这次更新的一大亮点,它是一款强大的辅助工具,由人工智能驱动。它可以为用户提供实时的建议和帮助,帮助用户更快速地完成各种任务。无论是在办公工作中还是在创造性的设计过程中,Windows Copilot都将成为您的得力助手。

    AI 驱动的 Paint

    Windows 11 2023 更新还为经典的绘图工具 Paint 带来了革命性的变化。现在,Paint 将由人工智能技术驱动,使您可以轻松创建出色的艺术作品。无论您是专业画家还是业余爱好者,新的 Paint 都将为您提供更多的创作可能性。

    截图工具的升级

    截图工具一直是 Windows 用户常用的工具之一,这次更新将进一步提升截图工具的功能。新的截图工具将允许用户更灵活地选择截图区域,并提供更多的标注和编辑选项,使您能够轻松地分享和保存截图。

    Photos 应用的更新

    照片是我们珍藏回忆的方式之一,Windows 11 2023 更新将 Photos 应用升级为更强大的工具。它将带来更多的编辑功能,让您能够轻松地美化照片,添加特效和滤镜,以及创建精美的相册。

    RGB 灯光支持

    对于喜欢个性化电脑外观的用户来说,RGB 灯光支持将是一大福音。Windows 11 2023 更新将为您的计算机带来更多的灯光控制选项,让您可以根据心情和场合自由调整灯光效果,打造独一无二的外观。

    现代化的文件资源管理器

    文件管理是操作系统的基本功能之一,这次更新将文件资源管理器现代化,使其更加直观和易用。新的文件资源管理器将带来更多的搜索和过滤选项,让您能够更轻松地管理文件和文件夹。

    Microsoft Teams 集成功能的变化

    然而,Windows 11 2023 更新也带来了一个重大变化,即将名为「Chat」的 Microsoft Teams 集成功能移除。这一变化引起了一些用户的关注和讨论。原来的「Chat」功能在 Windows 11 中一直令人困惑,并且只限于消费者使用,对于使用工作版本应用的绝大多数 Microsoft Teams 用户来说,这项功能毫无用处。微软的回应是将「Chat」变为 Microsoft Teams(免费版)并默认固定在任务栏上。当用户点击启动 Microsoft Teams 时,他们将发现一个迷你聊天体验,使他们能够方便地进行 Chat、通话、会议,并为社区群组创建一个空间,只需一两下点击,就能聚集、组织和分享想法。

    这一变化被认为是微软对用户反馈的回应,使 Microsoft Teams 更加集成和易用,同时消除了之前「Chat」功能的混淆。用户将更容易地访问和使用 Microsoft Teams 的功能,无论是在工作还是个人生活中。

    应用管理的变化

    除了功能升级和 Microsoft Teams 的变化,Windows 11 2023 更新还带来了一些关于应用管理的变化。现在,系统组件拥有「系统」标签,并在设置中划分到一个新的区域。内置应用如 Microsoft Store、Game Bar、Phone Link 和 Tips 应用都列在那里,看起来微软准备允许 Windows 11 用户在某个时点删除这些系统组件。这一变化将使用户有更大的自由度,能够根据自己的需求来管理系统中的应用程序。

    结语

    Windows 11 2023 更新带来了许多令人振奋的新功能和改进,为用户提供了更好的操作系统体验。从全新的 Windows Copilot 到强大的 AI 驱动的 Paint,再到便捷的 Microsoft Teams 集成功能,这次更新将让我们的数字生活变得更加精彩。同时,应用管理的变化也为用户提供了更大的灵活性和控制权。无论您是工作还是娱乐,新的 Windows 11 2023 更新都将成为您不可或缺的伙伴。让我们一起期待这一更新为我们带来的更多惊喜和便利吧!

    Windows 11 2023 更新,微软再次颠覆操作系统体验,为用户带来更多的创新和便利。无论是功能升级还是应用管理的变化,都将使我们的数字生活变得更加精彩和自由。期待着这一更新为我们带来的更多惊喜和便利!

  • windows多线程下载神器IDM-官方正版入手渠道

    windows多线程下载神器IDM-官方正版入手渠道

    每当你在浏览网页时,是否曾遇到这样的情景:看到一个精彩的视频或者需要的文件,但下载速度慢得令人发指,或者下载管理混乱,弹窗不断,让你感到烦躁不已?如果是的话,那么这篇文章将为你介绍一款真正的下载神器——Internet Download Manager(IDM)。

    IDM:速度与便捷的代名词

    在网络世界里,下载工具扮演着重要的角色,而IDM已经成为了Windows平台上的一颗璀璨明珠。不同于其他繁杂复杂的下载工具,IDM以它的高效、简洁和便捷而脱颖而出。

    限时优惠:49元起步,118元终生授权

    首先,让我们来看看这个令人心动的价格。官方售价一年版79元,终生版165元,已经让人望而却步。然而,现在,你有机会以限时优惠价,一年版仅需 49元,终生版仅需 118元,更有会员首单立减,仅需 113元,这简直是太超值了!

    点击合作伙伴专属优惠链接即可抢购这款下载神器!

    专注下载:IDM如何提升你的下载体验

    自动捕获链接

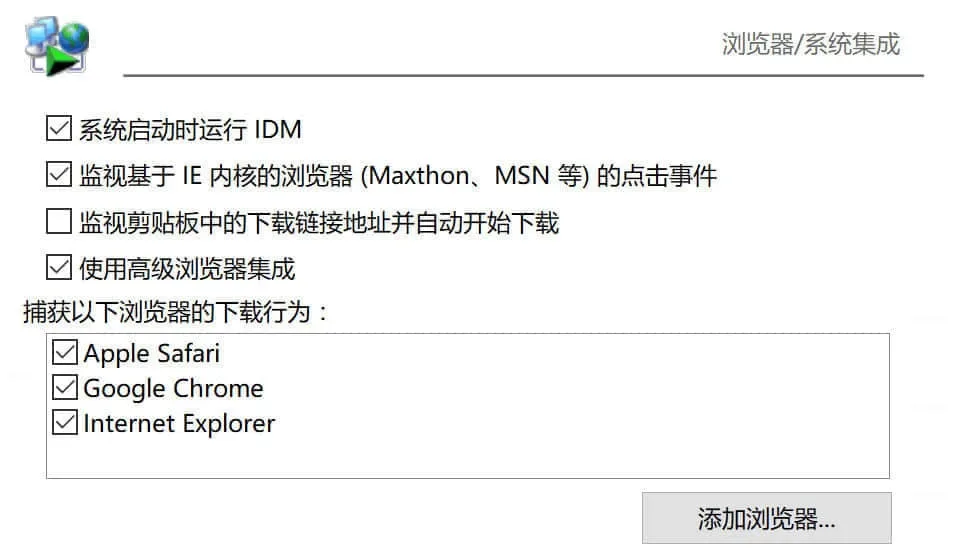
    无需手动复制粘贴下载链接,IDM可以自动捕获浏览器中的下载链接,并将它们添加到下载任务中。支持主流浏览器如Chrome、Safari、Firefox、Edge、Internet Explorer等。如果你使用的浏览器不在支持列表中,也可以在软件设置中轻松添加。

    静默下载

    不再被下载弹窗打扰,不再需要手动点击保存按钮。IDM的静默下载功能可以将下载窗口最小化,下载任务在后台默默进行。如果需要修改保存位置或其他选项,只需在系统托盘中找到IDM图标即可,再也不用打断你的工作或娱乐时间。

    多媒体下载

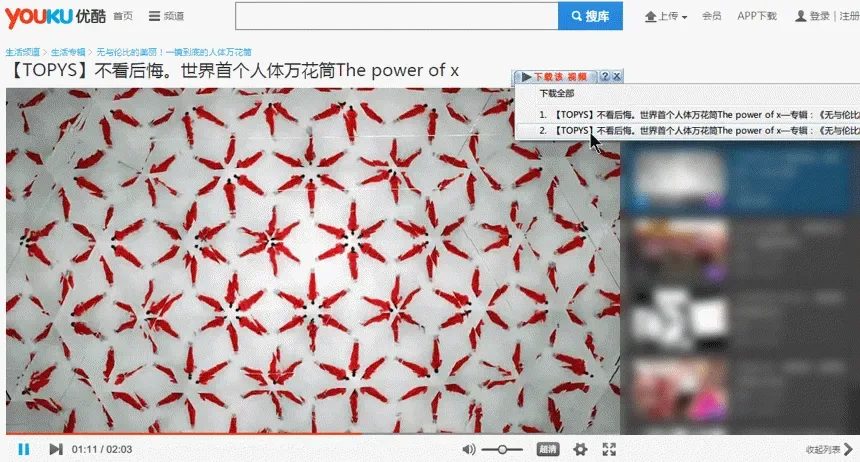
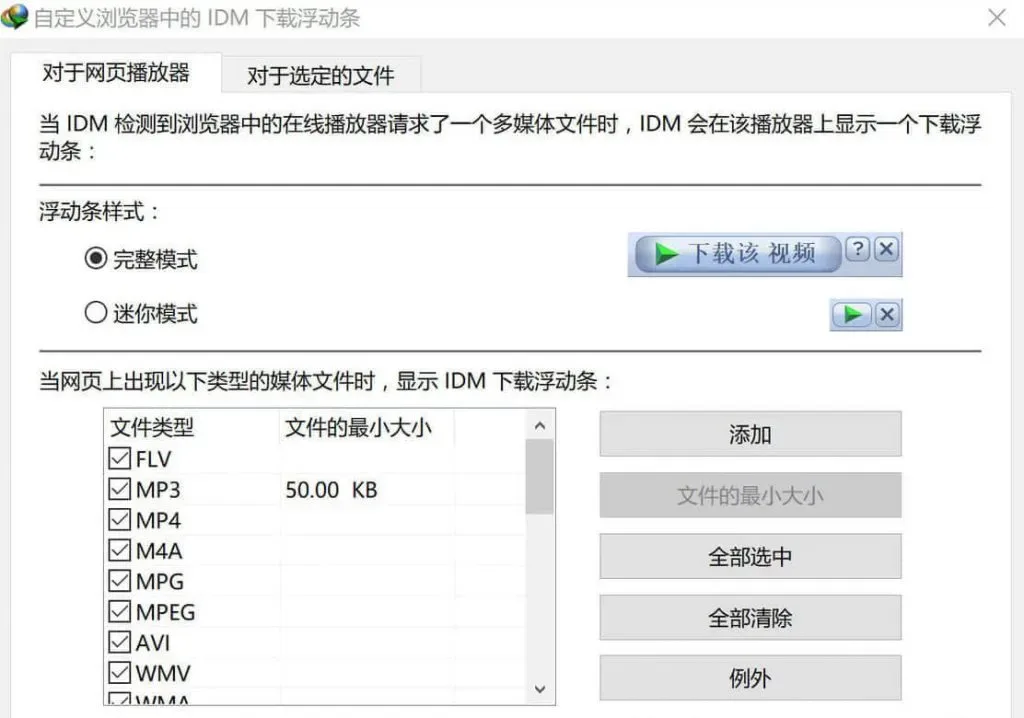
    如果你经常浏览音视频网站,那么IDM将成为你的得力助手。它可以自动检测在线播放器发出的多媒体请求,并在播放器上显示下载浮动条。你可以直接下载流媒体网站中的视频,供离线观看。IDM支持常见音视频格式如MP4、MP3、MOV、AAC等,而且你还可以自定义站点的下载操作。

    强大的扩展功能

    除了以上的基础功能,IDM还拥有一系列强大的扩展功能,满足用户的高阶下载需求。

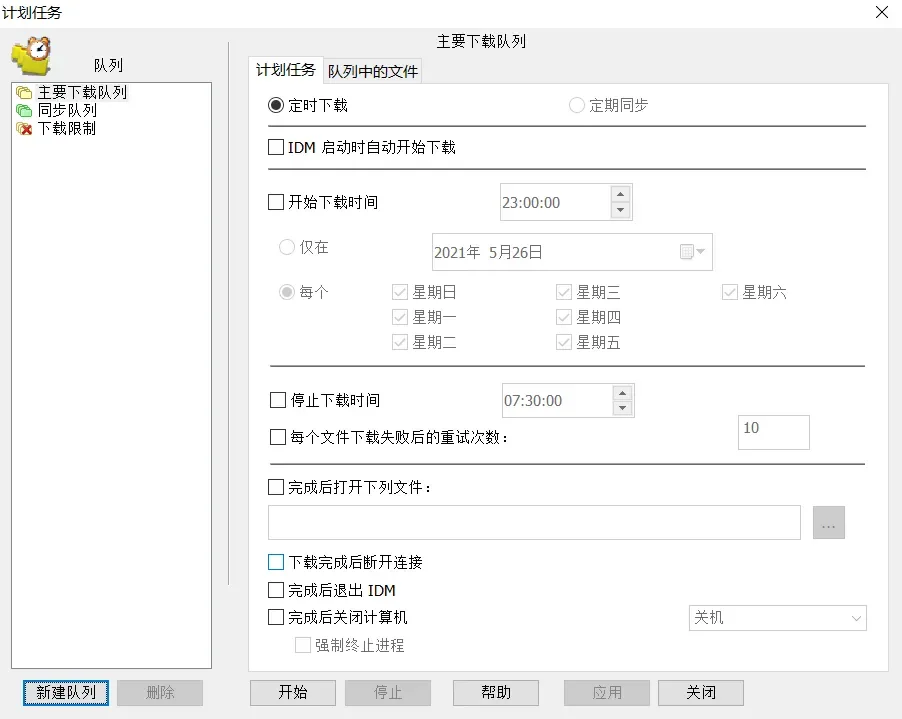
    计划下载任务

    如果你希望在特定的时间段自动启动下载任务,或者需要在特定时间自动暂停下载,IDM的计划下载任务功能将非常实用。比如,你可以在上班时间让电脑自动下载需要的文件,回家后就可以立即使用,非常便捷。

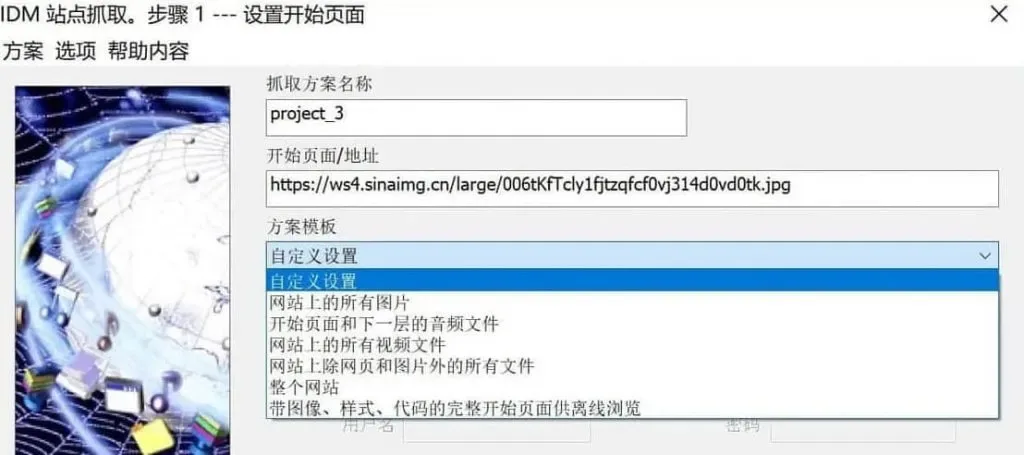
    站点抓取

    站点抓取功能让你能够直接选择要下载网页中的指定内容,而无需使用通配符。这包括图片、音频、视频、文件或者包含完整样式的网站离线文件,IDM都可以轻松完成。你还可以根据自己的需求自定义站点抓取的内容与规则。

    批量下载

    如果你需要下载一个链接中的所有文件,比如一个网页中的所有图片,IDM也能胜任。只需使用软件默认或自定义的通配符,你就可以一次性下载多个文件,节省时间,提高效率。

    支持主流国外网盘

    许多国外网站上的资源文件都存放在他们常用的网盘中,直接下载速度慢且容易中断。IDM可以将这些网盘文件作为队列进行批量下载,让你可以独立定制每个队列的下载时间和数量,极大地提高下载效率。目前支持的网盘包括RapidShare、Uploaded.net、FileServe等,你可以访问官网查看所有IDM支持的网盘服务。

    结语:行动起来,抢购IDM,解锁下载新境界!

    IDM限时特惠仅需 49元起步,终生版仅需 118元,再加上会员首单立减仅需 113元,这个机会可不能错过!不再被繁琐的下载流程困扰,不再为下载速度慢而烦恼,赶紧点击合作伙伴专属优惠链接,立刻拥有这款下载神器,享受高速、便捷的下载体验吧!不要再错过任何精彩的内容,让IDM帮助你

    畅快下载,畅快观看!

    现在就行动,解锁下载新境界,感受极速下载的魅力!

  • 强大的安卓投屏软件scrcpy 命令行进阶指南

    强大的安卓投屏软件scrcpy 命令行进阶指南

    在一个平凡的周五晚上,小张正在为第二天的产品展示准备 PPT。为了给客户带来更直观的体验,他想将其 Android 手机屏幕实时投影到计算机上。他在网络上找到了 scrcpy 这个神奇的工具。然而,他很快发现,除了基本的屏幕镜像功能,scrcpy 还隐藏了许多高级功能,这些功能能够极大地改善他的展示体验。让我们一起深入了解这些功能,优化我们的设备体验。


    1. 保持设备唤醒

    当我们的 Android 设备通过 USB 连接到电脑时,它可能会因为一段时间没有操作而自动进入休眠状态。使用 scrcpy,我们可以轻松地阻止这种情况发生。只需使用以下命令:

    scrcpy --stay-awake

    或者使用短命令:

    scrcpy -w

    当你关闭 scrcpy 时,设备的初始状态将被恢复。但需要注意,如果设备仅通过 TCP/IP 连接(即未插入电源),该命令将不起作用。

    2. 控制设备屏幕

    在某些情况下,我们可能希望在开始镜像时关闭设备的屏幕。scrcpy 提供了这样的功能,只需使用以下命令:

    scrcpy --turn-screen-off

    或短命令:

    scrcpy -S

    如果你在 scrcpy 运行时想要关闭屏幕,可以按 MOD+o。要重新打开屏幕,只需按 MOD+Shift+o。此外,Android 的电源键总是可以开启屏幕。为了方便,如果通过 scrcpy 发送电源命令(通过右键点击或 MOD+p),它将在短暂延迟后关闭屏幕。但物理电源键仍然可以开启屏幕。

    要同时防止设备休眠和关闭屏幕,你可以使用:

    scrcpy --turn-screen-off --stay-awake

    或简写:

    scrcpy -Sw

    3. 显示触摸操作

    为了在展示或教学中清晰地展示你在设备上的操作,scrcpy 提供了显示触摸的功能。这会显示物理设备上由手指触摸产生的操作。使用以下命令启动这个功能:

    scrcpy --show-touches

    或者短命令:

    scrcpy -t

    这只显示物理触摸操作,例如在设备上使用手指触摸的操作。


    利用上述 scrcpy 的高级功能,无论是在工作中还是在日常生活中,都可以极大地改善你的设备使用体验。不妨尝试一下,发掘更多可能性!

  • 多网卡负载均衡团队:MAC地址是否相同?

    多网卡负载均衡团队:MAC地址是否相同?

    在现代网络环境中,高可用性和高性能是关键要素。为了满足这些需求,许多组织和企业采用了多网卡负载均衡团队的解决方案。这种配置允许多个网络接口卡(NIC)一起工作,以实现负载均衡和冗余备份。然而,一个常见的问题是,当多个NIC组成一个团队时,它们的MAC地址是否会相同?本文将深入探讨这个问题并提供相关解答。

    多网卡负载均衡团队的概述

    多网卡负载均衡团队是一种网络配置,通常用于服务器或网络设备上,旨在提高网络性能和可用性。该团队由多个NIC组成,它们协同工作以实现以下目标:

    • 负载均衡:多个NIC一起处理网络流量,以均匀分配负载。这有助于提高网络性能,防止单一NIC成为性能瓶颈。

    • 冗余备份:如果一个NIC发生故障,其他NIC可以接管流量,确保网络的连通性和可用性。这种冗余备份可以防止网络中断。

    • 增强带宽:多个NIC的组合可以增加可用带宽,提供更高的网络吞吐量。

    然而,一个常见的疑问是,当这些NIC组成一个团队时,它们的MAC地址是否会相同?

    MAC地址和多网卡团队

    MAC地址(Media Access Control Address)是网络接口卡的硬件地址,通常是唯一的。每个网络设备都有一个唯一的MAC地址,用于在局域网中标识该设备。MAC地址通常以十六进制表示,由12个字符组成。

    在多网卡负载均衡团队中,每个NIC仍然具有自己的唯一MAC地址。这是因为MAC地址是与硬件相关的,并且通常由NIC的制造商预先分配。无论NIC是否参与团队,它们的MAC地址都保持不变。

    然而,在多网卡负载均衡团队中,还有一个虚拟MAC地址,用于标识整个团队。这个虚拟MAC地址是由负载均衡软件或硬件生成的,并且是用于接收网络流量的地址。当数据包进入多网卡团队时,它们将根据负载均衡算法被分配给其中一个NIC,并且会使用该NIC的MAC地址作为源MAC地址。然后,该NIC将负责将数据包发送到目标。

    负载均衡和MAC地址

    在多网卡负载均衡团队中,负载均衡算法通常基于不同的因素来决定将数据包发送到哪个NIC。这些因素可以包括当前NIC的负载情况、带宽利用率、或其他性能指标。负载均衡算法的目标是确保所有NIC都得到充分利用,从而提高网络性能。

    当数据包进入多网卡团队时,它们首先到达团队的虚拟MAC地址。然后,根据负载均衡算法,该团队将数据包重定向到其中一个NIC,将该NIC的MAC地址作为源MAC地址,并将数据包发送到目标。这个过程在整个多网卡负载均衡团队中不断重复,以确保各个NIC都能够平衡地处理流量。

    如何查看MAC地址

    如果您想查看您的多网卡负载均衡团队中NIC的MAC地址,您可以使用以下方法:

    1. 使用命令行工具:在Linux系统上,您可以使用命令如下来查看NIC的MAC地址:

      ifconfig

      这将显示每个NIC的详细信息,包括MAC地址。

    2. 使用操作系统的网络设置界面:在Windows操作系统中,您可以通过以下步骤查看NIC的MAC地址:

      • 打开“控制面板”。
      • 进入“网络和共享中心”。
      • 点击“更改适配器设置”。
      • 右键单击您感兴趣的NIC,并选择“属性”。
      • 在属性窗口中,找到“本地区域连接”或类似的项,然后点击“配置”。
      • 在“高级”选项卡中,您将找到NIC的MAC地址。

    总结

    多网卡负载均衡团队是一种有助于提高网络性能和可用性的强大工具。在这种配置中,每个NIC仍然具有自己的唯一MAC地址,但团队还会有一个虚拟MAC地址,用于接收和分配网络流量。负载均衡算法决定了数据包被重定向到哪个NIC,从而确保所有NIC都能够充分利用。因此,多网卡负载均衡团队中的MAC地址不是相同的,每个NIC仍然保持其唯一性。

    了解这些基础知识对于网络管理员和系统工程师来说是非常重要的,因为它们可以帮助他们更好地管理和配置多网卡负载均衡团队,以实现更高的性能和可用性。无论您是在构建数据中心还是在维护企业网络,了解多网卡团队的工作原理都将对您有所帮助。

  • 如何使用Python编写网页爬虫爬取京东商品信息并进行数据可视化

    如何使用Python编写网页爬虫爬取京东商品信息并进行数据可视化

    在数字时代,数据是至关重要的资源。无论是企业还是个人,都需要从各种渠道获取数据,并进行分析和可视化,以便更好地了解市场趋势和用户需求。本教程将介绍如何使用Python编写一个简单但强大的网页爬虫,以爬取京东商品信息,并将爬取到的数据进行可视化展示。无论你是对数据分析感兴趣,还是想要了解某一特定商品的市场情况,这个教程都将对你有所帮助。

    1. 起始故事

    假设你是一名电商从业者,你经营着一家在线商店。你一直在寻找一种方法,可以更好地了解市场上同类商品的价格、销量和用户评价等信息,以便更好地定价和推广你的产品。你可能会花费大量时间手动浏览京东等电商网站,记录商品信息,但这种方法非常耗时且容易出错。因此,你决定尝试使用Python编写一个网页爬虫来自动获取商品信息,并进行数据分析和可视化,以便更好地了解市场动态。

    2. 编写网页爬虫

    在这一部分,我们将介绍如何使用Python编写网页爬虫,来爬取京东商品信息。以下是关键部分的核心代码示例:

    import time
    import pandas as pd
    from selenium import webdriver
    from selenium.webdriver.common.by import By
    from selenium.webdriver.common.keys import Keys
    
    if __name__ == "__main__":
        word = input("请输入要爬取的商品名称")
        page_size = int(input("请输入要爬取的页数"))
    
        # 创建一个浏览器驱动器的对象
        driver = webdriver.Edge()
        # 通过驱动器去打开京东的首页
        driver.get("https://www.jd.com")
        time.sleep(2)
    
        # 找到搜索框
        input_box = driver.find_element(By.ID, "key")
        input_box.send_keys(word)
        input_box.send_keys(Keys.ENTER)
    
        names, prices, commits, shops = [], [], [], []
    
        for i in range(page_size):
            # 将滚动条拖到最下面
            driver.execute_script('window.scrollTo(0,document.body.scrollHeight)')
            # 停顿3秒,等待数据刷新
            time.sleep(3)
            good_list = driver.find_elements(By.XPATH, '//*[@id="J_goodsList"]/ul/li')
            # 遍历每页所需爬取的内容
            for good in good_list:
                price = good.find_element(By.CLASS_NAME, "p-price").text,
                name = good.find_element(By.CLASS_NAME, "p-name").text,
                commit = good.find_element(By.CLASS_NAME, "p-commit").text,
                shop = good.find_element(By.CLASS_NAME, "p-shop").text
                # 将爬取的数据赋值给空列表中
                names.append(name[0])
                prices.append(price[0])
                commits.append(commit[0])
                shops.append(shop)
    
            driver.find_element(By.CLASS_NAME, "pn-prev").click()
            # 停顿3秒,等待数据刷新
            time.sleep(3)
    
        df = pd.DataFrame(
            {
                "价格": prices,
                "标题": names,
                "评论数": commits,
                "出版社": shops
            })
        df.to_excel("商品信息.xlsx")

    上述代码中,我们使用了Selenium库来模拟浏览器操作,打开京东网站并搜索指定的商品。然后,我们通过定位HTML元素的方式,获取商品的名称、价格、评论数和店铺信息,并将这些信息存储在一个Pandas DataFrame中,最终将数据保存为Excel文件。

    3. 数据可视化

    爬取到数据后,下一步是进行数据可视化,以便更好地理解和分析数据。我们将使用Pyecharts库来创建一个简单的饼图,用于展示商品信息中不同出版社的数量分布。以下是相关代码:

    from pyecharts.charts import Pie
    
    # 按数量统计出前10名的数据
    sort_data = df.groupby("出版社").size().sort_values(ascending=True).head(10)
    
    # 进行数据处理,将数据转换为图表所需格式
    data = [list(z) for z in zip(sort_data.index.tolist(), sort_data.values.tolist())]
    
    # 绘制饼图
    pie = Pie()
    pie.add(series_name="排名", data_pair=data)
    pie.render(path="饼图.html")

    这段代码首先对出版社进行数量统计,并选择前10名的数据进行展示。然后,将数据转换为Pyecharts所需的格式,最后绘制了一个饼图,用于展示不同出版社的数量分布情况。

    结论

    通过本教程,你学会了如何使用Python编写一个简单但功能强大的网页爬虫,用于爬取京东商品信息,并进行数据可视化展示。这个过程包括了网页爬取、数据处理和可视化展示等关键步骤,可以帮助你更好地了解市场动态和竞争对手情况。

    数据爬取和可视化是数据分析的重要一环,无论你是电商从业者、数据分析师还是对数据感兴趣的人,这些技能都将对你的工作和个人发展带来很大帮助。希望你能够继续学习和探索,不断提升自己的数据分析能力。

    最后,记得合法使用爬虫技术,遵守网站的使用规则和法律法规,以确保数据获取的合法性和可靠性。祝你在数据分析领域取得成功!

  • 如何使用Python编写微信公众号文章下载工具

    如何使用Python编写微信公众号文章下载工具

    在今天的数字时代,微信公众号已经成为了信息传播的重要平台之一。许多人都喜欢阅读各种各样的文章,但有时候我们可能想要将一篇精彩的文章保存在本地,以便离线阅读或备份。本教程将介绍如何使用Python编写一个小工具,能够自动下载微信公众号文章并打包成ZIP文件,让您随时随地畅享文章内容。

    故事开端

    假设你是一名热衷于阅读微信公众号文章的用户,每天都会在不同的公众号上发现一些精彩的文章。然而,由于网络连接不稳定或者其他原因,你可能无法保证每次都能在线阅读这些文章。因此,你希望有一种方法能够将这些文章保存在本地,以便随时查看。同时,你还希望能够将文章中的图片也一并下载下来,以免文章内容不完整。于是,你决定使用Python编写一个工具来实现这个愿望。

    准备工作

    在开始编写代码之前,你需要做一些准备工作。首先,确保你的计算机上已经安装了Python编程环境。你还需要安装以下几个Python库:

    • requests:用于发送HTTP请求,获取网页内容。
    • BeautifulSoup:用于解析HTML页面,提取文章内容和图片链接。

    你可以使用以下命令来安装这些库:

    pip install requests beautifulsoup4

    编写代码

    现在,让我们开始编写代码。以下是关键部分的核心代码示例,用于实现微信公众号文章的下载和图片的下载:

    # 导入必要的库
    import requests
    from bs4 import BeautifulSoup
    import os
    import time
    from re import findall
    
    # 获取微信公众号内容,保存标题和时间
    def get_weixin_html(url):
        global weixin_time, weixin_title
        res = requests.get(url)
        soup = BeautifulSoup(res.text, "html.parser")
    
        # 获取标题
        temp = soup.find('h1')
        weixin_title = temp.string.strip()
    
        # 获取正文html并修改
        content = soup.find(id='js_content')
        soup2 = BeautifulSoup((str(content)), "html.parser")
        soup2.div['style'] = 'visibility: visible;'
        html = str(soup2)
        pattern = r'http?:\/\/[a-z.A-Z_0-9\/\?=-_-]+'
        result = findall(pattern, html)
    
        # 将data-src修改为src
        for url in result:
            html = html.replace('data-src="' + url + '"', 'src="' + url + '"')
        return html
    
    # 上传图片至服务器
    def download_pic(content):
        pic_path = htmlsavepath + '/' + weixin_title + '/' + 'pic/'
        if not os.path.exists(pic_path):
            os.makedirs(pic_path)
    
        # 使用正则表达式查找所有需要下载的图片链接
        pattern = r'http?:\/\/[a-z.A-Z_0-9\/\?=-_-]+'
        pic_list = findall(pattern, content)
    
        for index, item in enumerate(pic_list, 1):
            count = 1
            flag = True
            pic_url = str(item)
    
            while flag and count <= 10:
                try:
                    data = requests.get(pic_url)
    
                    if pic_url.find('png') > 0:
                        file_name = str(index) + '.png'
    
                    elif pic_url.find('gif') > 0:
                        file_name = str(index) + '.gif'
    
                    else:
                        file_name = str(index) + '.jpg'
    
                    with open(pic_path + file_name, "wb") as f:
                        f.write(data.content)
    
                    # 将图片链接替换为本地链接
                    content = content.replace(pic_url, 'pic/' + file_name)
    
                    flag = False
                    count += 1
                    print('...')
                    time.sleep(1)
    
                except:
                    count += 1
                    time.sleep(1)
    
            if count > 10:
                print("下载出错:", pic_url)
        return content

    上述代码中,我们首先导入了所需的库,然后定义了两个关键函数:get_weixin_html 用于获取微信公众号文章的HTML内容,download_pic 用于下载文章中的图片并替换图片链接。这些函数将帮助我们实现文章的下载和保存。

    使用示例

    接下来,我们将展示如何使用这些函数来下载微信公众号文章。你可以按照以下步骤进行操作:

    1. 定义微信公众号文章的链接和保存目录:
    wechat_article_url = "https://mp.weixin.qq.com/s/GSdK9it0N1As3H-pQ4mGdA"
    save_directory = "C:/微信公众号下载/12"
    1. 调用 get_weixin_html 函数来获取文章的HTML内容:
    article_html = get_weixin_html(wechat_article_url)
    1. 调用 download_pic 函数来下载文章中的图片:
    article_with_local_pic = download_pic(article_html)
    1. 最后,你可以将文章内容保存为HTML文件,以及将图片一起打包成ZIP文件:
    # 保存文章内容为HTML文件
    html_file_path = os.path.join(save_directory, weixin_title + ".html")
    with open(html_file_path, "w", encoding="utf-8") as html_file:
        html_file.write(article_with_local_pic)
    
    # 打包成ZIP文件
    import zipfile
    
    zip_file_path = os.path.join(save_directory, weixin_title + ".zip")
    with zipfile.ZipFile(zip_file_path, "w") as zipf:
        # 添加HTML文件
        zipf.write(html_file_path, arcname=os.path.basename(html_file_path))
        # 添加图片文件夹
        pic_folder = os.path.join(save_directory, weixin_title, "pic")
        for root, dirs, files in os.walk(pic_folder):
            for file in files:
                zipf.write(os.path.join(root, file), arcname=os.path.join("pic", file))

    总结

    通过这个小工具,你可以轻松地将你喜欢的微信公众号文章保存在本地,并确保文章中的图片也被正确下载和保存。这不仅提供了离线阅读的便利,还可以用于备份你感兴趣的文章。希望这个教程对你有所帮助,让你更好地利用Python来实现自己的需求。

    通过学习本教程,你不仅可以掌握如何编写网络爬虫程序,还可以了解如何使用Python处理HTML页面和下载文件。这些技能在许多领域都非常有用,无论是数据采集、网站分析,还是其他需要获取网络信息的任务,都可以受益于这些技能。希望你能够享受到编程的乐趣,并不断探索更多有趣的项目和应用。

    Punctuation: Use English punctuation throughout.

    Language: The article should be written exclusively in Chinese.

  • 深入探讨JavaScript中的类数组对象

    深入探讨JavaScript中的类数组对象

    在广泛而多样的JavaScript世界中,你经常会遇到看起来像数组但又不完全是数组的对象。这些通常被称为”类数组对象”。本文将深入探讨什么是类数组对象,如何识别它们以及如何有效地与它们一起工作。

    什么是类数组对象?

    类数组对象是具有索引访问和length属性的对象,类似于数组。但是,它们不继承自Array.prototype,因此没有数组特有的方法,例如push()、pop()、forEach()等。

    示例

    let 类数组对象 = {
      0: '苹果',
      1: '香蕉',
      2: '樱桃',
      length: 3
    }
    
    console.log(类数组对象[0]) // 输出: 苹果
    console.log(类数组对象.length) // 输出: 3

    识别类数组对象

    要识别一个对象是真正的数组还是类数组对象,你可以使用Array.isArray()方法。

    示例

    let 真正的数组 = [1, 2, 3]
    let 类数组对象 = { 0: 'a', 1: 'b', length: 2 }
    
    console.log(Array.isArray(真正的数组)) // 输出: true
    console.log(Array.isArray(类数组对象)) // 输出: false

    常见的类数组对象

    一些内置的JavaScript对象和方法返回类数组对象。其中一些最常见的包括:

    1. 函数中的arguments对象
    2. DOM方法,如document.querySelectorAll()
    3. 字符串字符

    示例(使用arguments对象)

    function 显示参数() {
      console.log(arguments);
    }
    
    显示参数(1, 2, 3);  // 记录类数组对象: { 0: 1, 1: 2, 2: 3 }

    示例(使用document.querySelectorAll())

    let divs = document.querySelectorAll('div')
    
    console.log(divs);  // 这返回一个类数组的NodeList对象

    将类数组对象转换为真正的数组

    由于类数组对象缺乏数组方法,通常有必要将它们转换为真正的数组。有几种方法可以做到这一点:

    1. 使用Array.from()方法:这是将类数组对象转换为实际数组的最直接方法。

    示例

    let 类数组对象 = { 0: 'a', 1: 'b', length: 2 }
    let 真正的数组 = Array.from(类数组对象)
    console.log(真正的数组) // 输出: ['a', 'b']
    1. 使用展开运算符:这是ES6功能,允许以一种优雅的方式将类数组对象转换为数组。

    示例

    let 类数组对象 = { 0: 'a', 1: 'b', length: 2 }
    let 真正的数组 = [...类数组对象]
    console.log(真正的数组) // 输出: ['a', 'b']

    与类数组对象一起工作

    即使你不将类数组对象转换为真正的数组,你仍然可以对其元素执行操作。

    1. 使用for循环:这是迭代类数组对象元素的经典方式。

    示例

    let 类数组对象 = { 0: '苹果', 1: '香蕉', 2: '樱桃', length: 3 }
    
    for (let i = 0; i < 类数组对象.length; i++) {
        console.log(类数组对象[i])
    }
    1. 使用Array.prototype方法:即使类数组对象没有原生的数组方法,你仍然可以使用Function.prototype.call或Function.prototype.apply将一些数组方法应用于它们。

    示例

    let 类数组对象 = { 0: '苹果', 1: '香蕉', 2: '樱桃', length: 3 }
    
    Array.prototype.forEach.call(类数组对象, function(item) {
      console.log(item)
    })

    注意:在这里使用call方法,它是Function.prototype的一部分,用于指示forEach像处理数组一样处理类数组对象。

    结语

    尽管JavaScript中的类数组对象可能起初看起来有些奇怪,但一旦理解了它们的本质和结构,就会变得更加清晰。通过识别这些对象并知道如何与它们一起工作,你可以在各种场景中充分利用JavaScript的强大功能。

    无论是在处理函数的arguments对象,还是在操作DOM元素集合,或者是在处理字符串字符时,了解如何处理类数组对象都将为你的JavaScript编程提供更多的灵活性和掌控力。希望这篇文章能够帮助你更好地理解和利用JavaScript中的类数组对象。

  • 使用Cloudflare CDN时NGINX不再反向代理的解决方法

    使用Cloudflare CDN时NGINX不再反向代理的解决方法

    在使用Cloudflare CDN时,您可能希望将流量通过Cloudflare的CDN进行缓存和保护,而不再直接反向代理到您的NGINX服务器。这可以提高性能并增强安全性。本文将介绍如何配置NGINX,以便与Cloudflare CDN一起使用,并确保流量经过CDN而不再直接反向代理。

    问题描述

    您已经在NGINX服务器上架设了网站,但发现访问时始终返回NGINX的欢迎页面,即”Welcome to Nginx!”。您怀疑这可能与Cloudflare CDN的配置有关,因为您希望所有流量都通过CDN进行处理,而不是直接到达NGINX服务器。您需要找到一种方法来确保NGINX与Cloudflare CDN一起工作,以提高性能和安全性。

    解决方案

    要解决这个问题,您可以采取以下步骤来配置NGINX以与Cloudflare CDN一起使用:

    步骤1:检查NGINX欢迎页面

    首先,确保NGINX服务器本身正常运行并提供您的网站内容。访问NGINX服务器的IP地址或域名的80端口,查看是否返回NGINX的欢迎页面。这将帮助您确认NGINX的配置是否正确。

    步骤2:配置Cloudflare DNS设置

    在Cloudflare控制面板中,确保您的域名已经添加到Cloudflare,并且DNS设置已正确配置。您需要将域名的DNS记录指向Cloudflare提供的DNS服务器。这样,Cloudflare可以管理您的域名的流量。

    步骤3:配置Cloudflare CDN

    在Cloudflare控制面板中,找到您的域名,然后配置CDN选项。确保CDN功能已启用,并设置适当的安全性和性能选项,以满足您的需求。这将确保所有流量都通过Cloudflare CDN进行处理。

    步骤4:更改NGINX配置

    现在,您需要更改NGINX的配置,以允许流量通过Cloudflare CDN。在NGINX配置文件中,找到服务器块,通常是一个以server关键字开始的部分,类似于以下示例:

    server {
        listen 80;
        server_name www.example.com;
    
        # 其他配置...
    }

    将该部分中的listen指令更改为80端口,并删除server_name指令,以允许任何域名或IP地址的流量通过。配置如下:

    server {
        listen 80;
    
        # 其他配置...
    }

    这将允许任何流量通过80端口,不再限制于特定的域名。接下来,确保NGINX配置文件中没有其他阻止或限制访问的条件,以便Cloudflare CDN可以正常工作。

    步骤5:保存并重新加载NGINX配置

    保存NGINX配置文件后,使用以下命令重新加载NGINX以使更改生效:

    sudo nginx -s reload

    这将重新加载NGINX配置并使更改生效。

    步骤6:验证配置

    最后,使用浏览器或其他HTTP工具验证配置是否正常工作。访问您的域名,确保您的网站内容已经通过Cloudflare CDN进行缓存和保护。您应该不再看到NGINX的欢迎页面,而是能够访问您的网站。

    结论

    通过按照上述步骤配置NGINX,您可以确保NGINX与Cloudflare CDN一起工作,以提高性能和安全性。通过允许流量通过80端口并删除域名限制,您的流量将通过Cloudflare CDN进行处理,而不再直接到达NGINX服务器。这将加速网站加载速度并增强安全性,同时确保您的网站正常运行。

  • 禁止IPv6地址的HTTP访问并关闭连接的解决方法

    禁止IPv6地址的HTTP访问并关闭连接的解决方法

    在配置Nginx服务器时,经常需要处理不同类型的访问请求,包括IPv6地址的HTTP访问。有时候,我们希望禁止IPv6地址的HTTP访问,并关闭连接,以增强安全性。本文将介绍如何在Nginx中实现这一目标,确保IPv6地址的HTTP访问被拒绝并关闭连接。

    问题描述

    假设您已经成功配置了Nginx服务器,支持HTTPS访问,同时允许IPv6地址的访问。然而,您希望禁止IPv6地址的HTTP访问,并希望当HTTP请求发生时,Nginx能够拒绝访问并关闭连接,而不是响应400错误。问题在于,Nginx默认会响应400错误,告知客户端发生了错误的HTTP请求。

    解决方案

    要禁止IPv6地址的HTTP访问并关闭连接,可以采用以下方法:

    方法1:使用error_page指令

    Nginx提供了error_page指令,可以用来处理不同类型的错误。在这种情况下,我们可以使用error_page指令来处理HTTP请求错误,并将其重定向到HTTPS端口,然后关闭连接。

    首先,在Nginx配置文件中,找到IPv6监听的部分,例如:

    server {
        listen [::]:2563 ssl;
        server_name _;
        ssl_certificate /etc/nginx/ssl/xxx/cert.pem;
        ssl_certificate_key /etc/nginx/ssl/xxx/key.pem;
        ssl_dhparam /etc/nginx/ssl/dhparam.pem;
    
        # 其他配置...
    }

    然后,添加以下配置,以处理HTTP请求错误并将其重定向到HTTPS端口:

    server {
        listen [::]:2563 ssl;
        server_name _;
        ssl_certificate /etc/nginx/ssl/xxx/cert.pem;
        ssl_certificate_key /etc/nginx/ssl/xxx/key.pem;
        ssl_dhparam /etc/nginx/ssl/dhparam.pem;
    
        # 处理HTTP请求错误,重定向到HTTPS端口并关闭连接
        error_page 497 https://$host$request_uri;
        # 其他配置...
    }

    在上述配置中,error_page 497用于处理HTTP请求错误,将其重定向到HTTPS端口,同时使用$host$request_uri来保留原始请求的主机和URI信息。这样,当IPv6地址的HTTP请求发生时,Nginx将执行这个配置,并将请求重定向到HTTPS端口,然后关闭连接。

    方法2:禁止HTTP请求

    另一种方法是直接禁止HTTP请求,而不是重定向到HTTPS端口。这可以通过Nginx的if指令来实现。首先,在Nginx配置文件中,找到IPv6监听的部分,例如:

    server {
        listen [::]:2563 ssl;
        server_name _;
        ssl_certificate /etc/nginx/ssl/xxx/cert.pem;
        ssl_certificate_key /etc/nginx/ssl/xxx/key.pem;
        ssl_dhparam /etc/nginx/ssl/dhparam.pem;
    
        # 其他配置...
    }

    然后,添加以下配置,以禁止HTTP请求并关闭连接:

    server {
        listen [::]:2563 ssl;
        server_name _;
        ssl_certificate /etc/nginx/ssl/xxx/cert.pem;
        ssl_certificate_key /etc/nginx/ssl/xxx/key.pem;
        ssl_dhparam /etc/nginx/ssl/dhparam.pem;
    
        # 禁止HTTP请求并关闭连接
        if ($scheme != "https") {
            return 444;
        }
        # 其他配置...
    }

    在上述配置中,使用了if ($scheme != "https")来判断请求的协议是否为HTTP,如果是HTTP,则返回444错误,从而禁止HTTP请求并关闭连接。

    结论

    通过使用Nginx的error_page指令或if指令,您可以轻松地禁止IPv6地址的HTTP访问,并关闭连接,以增强安全性。这些方法可以确保当IPv6地址的HTTP请求发生时,Nginx不会响应400错误,而是按照您的需求进行处理。

    选择适合您需求的方法,以确保IPv6地址的HTTP访问被拒绝,并确保Nginx服务器的安全性。这些配置可以帮助您在Nginx中实现对HTTP请求的精确控制,从而提高服务器的安全性和性能。