
Category: 技术折腾

服务器、网络、硬件与自建工具的实践记录。

  • 解决UOS无线网卡问题的新内核和驱动编译方案

    解决UOS无线网卡问题的新内核和驱动编译方案

    在使用UOS( 统信UOS)操作系统时,一些用户可能会面临无线网卡不被识别或不兼容的问题。这个问题通常可以通过更新操作系统内核和编译适用于特定无线网卡的驱动程序来解决。本文将介绍如何查找新内核并编译适用于UOS的无线网卡驱动程序,以解决这一常见问题。

    问题描述

    在UOS操作系统上,一些无线网卡可能无法正常工作,或者系统内核版本较旧,无法支持最新的硬件。用户可能会遇到以下问题:

    1. 无法连接到无线网络。
    2. 无线网络连接速度缓慢。
    3. 无法识别无线网卡。

    为了解决这些问题,我们需要更新UOS的内核并编译适用于无线网卡的新驱动程序。

    解决方案

    步骤一:查找适用于UOS的新内核

    首先,我们需要查找适用于UOS的新内核版本。在论坛中提到了一些可能的选择,但我们还可以尝试以下步骤:

    1. 访问UOS官方网站:请访问UOS官方网站,以查看是否有可用的新内核版本。通常,官方网站会提供内核更新的下载链接。

    2. 查看第三方内核源:有时,第三方社区可能会提供适用于UOS的最新内核版本。您可以搜索互联网上的Linux内核源,以查找适用于UOS的版本。

    3. 使用Xanmod内核:根据论坛中的建议,您可以尝试使用Xanmod内核。这是一个自动更新的内核,适用于UOS和Ubuntu等操作系统。它可能会解决您的无线网卡问题。

    步骤二:下载并安装新内核

    一旦找到适用于UOS的新内核版本,您可以按照以下步骤进行下载和安装:

    1. 下载新内核:从官方网站或第三方源下载新内核的源代码或二进制文件。

    2. 安装新内核:根据下载的文件类型,执行相应的安装步骤。通常,您需要运行一些命令来安装新内核。确保遵循官方文档或安装说明。

    3. 重启系统:在安装新内核后,重新启动您的UOS系统以应用更改。

    步骤三:编译无线网卡驱动

    一旦您的UOS系统已经升级到新内核,接下来我们将编译适用于您的无线网卡的新驱动程序。如果您的无线网卡是支持的,但无法正常工作,那么这一步骤可能会解决问题。

    1. 下载驱动程序:访问无线网卡制造商的官方网站,查找适用于Linux的最新驱动程序。确保您下载适合您网卡型号和UOS版本的驱动程序。

    2. 安装编译工具:在UOS上安装编译所需的工具和依赖项。您可以使用以下命令安装:

      sudo apt-get install build-essential
    3. 编译驱动程序:解压下载的驱动程序文件,并按照附带的说明编译驱动程序。通常,您需要在终端中运行一些命令,如make。

    4. 安装驱动程序:编译成功后,您可以使用命令将驱动程序安装到系统中。这可能涉及到make install或其他类似的命令。

    5. 重启系统:在安装驱动程序后,重新启动系统以应用更改。

    结论

    通过更新UOS的内核并编译适用于无线网卡的新驱动程序,您可以解决无线网卡不被识别或不兼容的问题。请注意,确保在执行任何操作之前备份重要数据,并谨慎操作系统设置,以防意外发生。如果您遇到困难或问题,可以咨询论坛中的其他用户或寻求专业支持。希望这个解决方案能够帮助您顺利解决UOS上的无线网卡问题。
  • 解决UOS系统自带文本编辑器被卸载的问题

    解决UOS系统自带文本编辑器被卸载的问题

    在使用UOS系统的过程中,有时候我们可能会不小心卸载了系统自带的文本编辑器,导致无法正常编辑文本文件。这种情况下,我们需要找到一种有效的方法来恢复系统自带的文本编辑器。本文将提供详细的解决方案,以帮助您重新安装UOS系统自带的文本编辑器。

    问题描述

    在UOS系统中,有用户在卸载系统自带的文本编辑器后,遇到了无法编辑文本文件的问题。应用商店和软件管理中没有找到相关选项,而且尝试安装deepin-editor也没有成功。那么,该如何恢复UOS系统自带的文本编辑器呢?

    解决方案

    步骤1:查找包名

    首先,我们需要找到系统自带文本编辑器的包名。可以通过以下命令来查找:

    dpkg --get-selections|grep deinstall|grep edit

    这个命令将列出已卸载的编辑器包名,记下包名以备后用。

    步骤2:尝试安装

    接下来,使用以下命令尝试安装找到的包名(请替换 <the_package_name> 为步骤1中找到的包名):

    sudo apt-get install <the_package_name>

    如果成功安装了文本编辑器,那么您的问题就已经解决了。但如果遇到了问题,可以继续下一步。

    步骤3:查找相关包

    如果步骤2没有成功,可以尝试搜索与deepin相关的包,看看是否有其他编辑器可用。使用以下命令来搜索相关包:

    sudo apt search deepin

    或者,也可以尝试搜索UOS相关的包:

    sudo apt search uos

    这些命令将列出与deepin或UOS相关的包,您可以查看是否有其他编辑器可供选择。

    步骤4:尝试替代编辑器

    如果仍然无法找到UOS系统自带的文本编辑器,您可以尝试安装其他文本编辑器,如gedit。使用以下命令安装gedit:

    sudo apt-get install gedit

    请注意,gedit是一个常见的文本编辑器,通常在许多Linux发行版中都可用。安装后,您可以尝试使用它来编辑文本文件。

    结论

    卸载UOS系统自带的文本编辑器可能会导致一些不便,但通过以上解决方案,您可以尝试恢复编辑器或安装替代编辑器来解决问题。希望本文提供的方法能够帮助您成功解决文本编辑器被卸载的问题,使您可以继续在UOS系统上轻松编辑文本文件。如果您在使用过程中遇到任何问题,可以随时在官方论坛或社区寻求帮助,以获得更多支持和建议。

  • 一键部署 AutoBangumi 脚本:打造完美二次元动漫追踪器

    一键部署 AutoBangumi 脚本:打造完美二次元动漫追踪器

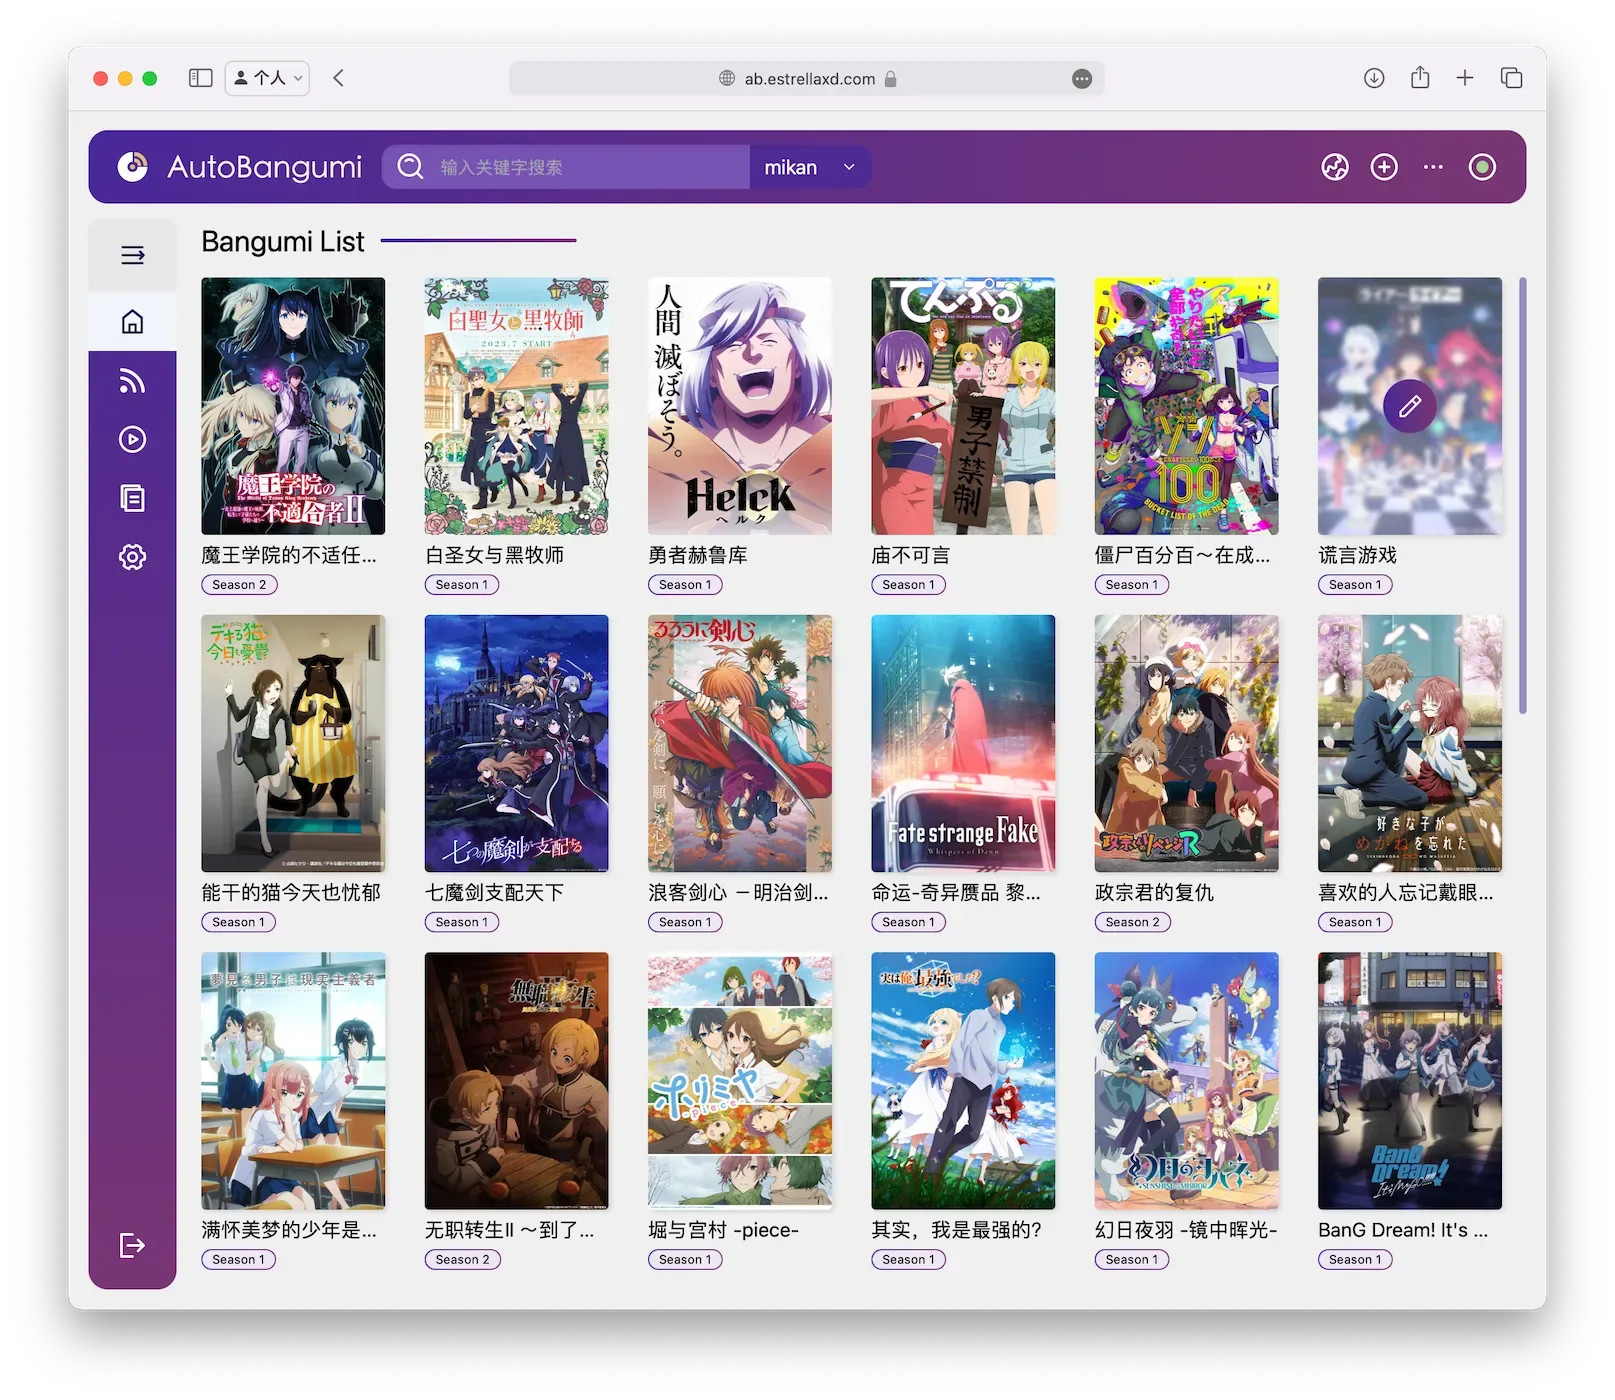
    你是否是一位热爱追番追剧的二次元爱好者?是否曾为找不到一个完美的动漫追踪工具而苦恼?不用担心,AutoBangumi(AB)是你的不二选择!AB是一款功能强大的动漫追踪器,支持自动更新番剧信息、自定义追踪进度、自动下载字幕等众多便捷功能。本教程将教你如何使用 Docker 快速部署 AutoBangumi,让你的番剧追踪更加轻松愉快。

    1. 前言

    作为一名二次元爱好者,我深知找到一款好用的番剧追踪工具有多么重要。AutoBangumi 是一个开源的动漫追踪器,可以帮助你管理和追踪你喜爱的动漫、番剧。它的强大功能包括自动更新番剧信息、自定义追踪进度、自动下载字幕等,让你的二次元生活更加丰富多彩。

    然而,为了让 AutoBangumi 在你的系统上顺利运行,你需要进行一些复杂的配置和依赖安装。为了简化这个过程,我们将使用 Docker 进行部署,使整个过程变得非常简单。无需担心复杂的安装和配置步骤,只需按照以下指南操作,你就能快速搭建起你自己的 AutoBangumi 服务器。

    2. 步骤

    2.1 创建数据和配置文件夹

    首先,我们需要为 AutoBangumi 创建数据和配置文件夹。这将确保在以后的更新和配置更改中不会丢失任何数据。

    打开终端,执行以下命令来创建文件夹:

    # 创建配置和数据文件夹
    mkdir -p ${HOME}/AutoBangumi/{config,data}
    cd ${HOME}/AutoBangumi

    你可以选择使用 Docker volume 或者 bind mount 来进行数据和配置的持久化。接下来,我们将演示如何使用 Docker volume,但你也可以根据自己的需求使用 bind mount。

    使用 Docker Volume(推荐)

    使用以下命令来创建 Docker volume:

    docker volume create AutoBangumi_config
    docker volume create AutoBangumi_data

    2.2 使用 Docker 部署 AutoBangumi

    现在,我们已经准备好了数据和配置文件夹,接下来是部署 AutoBangumi。

    确保你的终端位于 AutoBangumi 目录下,然后运行以下命令:

    docker run -d \
      --name=AutoBangumi \
      -v ${HOME}/AutoBangumi/config:/app/config \
      -v ${HOME}/AutoBangumi/data:/app/data \
      -p 7892:7892 \
      -e TZ=Asia/Shanghai \
      -e PUID=$(id -u) \
      -e PGID=$(id -g) \
      -e UMASK=022 \
      --network=bridge \
      --dns=8.8.8.8 \
      --restart unless-stopped \
      ghcr.io/estrellaxd/auto_bangumi:latest

    请注意,如果你使用了 Docker volume,你需要将上述命令中的 -v 参数进行相应的更改,例如:

    -v AutoBangumi_config:/app/config \
    -v AutoBangumi_data:/app/data \

    现在,AutoBangumi 容器已经启动。你可以通过访问 http://localhost:7892 来配置 AutoBangumi 的 WebUI。在首次启动时,AutoBangumi 会自动将环境变量写入 config.json 文件中并自动运行。

    2.3 进行进阶部署

    如果你希望更加深入地管理 AutoBangumi 容器,推荐使用带有 UI 的 Docker 管理器,例如 Portainer。这将使你能够轻松地监控和管理容器的状态,进行配置更改,以及查看日志等信息。

    2.4 一键部署 AutoBangumi 脚本(Docker|Ubuntu 20.04)

    #!/bin/bash
    
    # 设置 AutoBangumi 数据和配置文件夹的路径
    CONFIG_DIR="${HOME}/AutoBangumi/config"
    DATA_DIR="${HOME}/AutoBangumi/data"
    
    # 创建数据和配置文件夹
    mkdir -p "$CONFIG_DIR"
    mkdir -p "$DATA_DIR"
    
    # 使用 Docker volume 或者 bind mount 进行数据和配置的持久化
    # 使用 Docker volume
    docker volume create AutoBangumi_config
    docker volume create AutoBangumi_data
    
    # 启动 AutoBangumi 容器
    docker run -d \
      --name=AutoBangumi \
      -v "$CONFIG_DIR:/app/config" \
      -v "$DATA_DIR:/app/data" \
      -p 7892:7892 \
      -e TZ=Asia/Shanghai \
      -e PUID=$(id -u) \
      -e PGID=$(id -g) \
      -e UMASK=022 \
      --network=bridge \
      --dns=8.8.8.8 \
      --restart unless-stopped \
      ghcr.io/estrellaxd/auto_bangumi:latest
    
    # 输出部署完成信息
    echo "AutoBangumi 已成功部署!"
    echo "您可以访问 http://localhost:7892 进行配置。"
    

    3. 结束语

    通过本教程,你已经学会了如何使用 Docker 快速部署 AutoBangumi,让你的动漫追踪体验更加顺畅。无需复杂的配置和安装,只需几个简单的步骤,你就可以享受到 AutoBangumi 强大的功能。

    希望本教程能对你有所帮助,让你的二次元生活更加丰富多彩。如果你有任何问题或疑问,欢迎留言,我们将尽力为你解答。愿你的番剧追踪之路一帆风顺!

  • 教程:如何使用Docker部署和配置AutoBangumi

    教程:如何使用Docker部署和配置AutoBangumi

    你是否曾经为了不错过心爱的番剧而苦恼,每次都需要手动下载或者等待下载完成?现在,有一个名为AutoBangumi的工具可以帮助你自动化这一切,让你的番剧观影体验更加顺畅。本教程将向你展示如何使用Docker部署和配置AutoBangumi,让你轻松管理和下载你最喜爱的番剧。

    步骤1:创建数据和配置文件夹

    在开始之前,首先要创建数据和配置文件夹,以确保AutoBangumi在每次更新后不会丢失数据和配置。你可以选择使用bind mount或Docker volume来进行数据和配置的持久化。

    使用bind mount

    mkdir -p ${HOME}/AutoBangumi/{config,data}
    cd ${HOME}/AutoBangumi

    使用Docker volume

    docker volume create AutoBangumi_config
    docker volume create AutoBangumi_data

    步骤2:使用Docker部署AutoBangumi

    确保你已经进入了AutoBangumi目录,然后你可以选择以下两种方法中的一种来部署AutoBangumi。

    选项1:使用Docker-cli部署

    运行以下命令来使用Docker-cli部署AutoBangumi:

    docker run -d \
      --name=AutoBangumi \
      -v ${HOME}/AutoBangumi/config:/app/config \
      -v ${HOME}/AutoBangumi/data:/app/data \
      -p 7892:7892 \
      -e TZ=Asia/Shanghai \
      -e PUID=$(id -u) \
      -e PGID=$(id -g) \
      -e UMASK=022 \
      --network=bridge \
      --dns=8.8.8.8 \
      --restart unless-stopped \
      ghcr.io/estrellaxd/auto_bangumi:latest

    选项2:使用Docker-compose部署

    复制以下内容到docker-compose.yml文件中:

    version: "3.8"
    
    services:
      AutoBangumi:
        image: "ghcr.io/estrellaxd/auto_bangumi:latest"
        container_name: AutoBangumi
        volumes:
          - ./config:/app/config
          - ./data:/app/data
        ports:
          - "7892:7892"
        network_mode: bridge
        restart: unless-stopped
        dns:
          - 223.5.5.5
        environment:
          - TZ=Asia/Shanghai
          - PGID=$(id -g)
          - PUID=$(id -u)
          - UMASK=022

    运行以下命令来启动容器:

    docker compose up -d

    步骤3:安装qBittorrent

    如果你尚未安装qBittorrent,请按照以下步骤先安装qBittorrent。

    在Docker中安装qBittorrent

    在Windows/macOS中安装qBittorrent

    在Linux中安装qBittorrent-nox

    步骤4:获取聚合RSS链接

    为了使AutoBangumi能够自动下载你喜欢的番剧,你需要获取一个聚合RSS链接。以蜜柑计划的聚合RSS为例,你可以按照以下步骤获取链接:

    1. 进入MiKan Project网站,注册并登录你的账号。
    2. 点击页面右下角的RSS按钮,复制生成的链接。

    你获取的RSS地址应该类似于以下内容:

    https://mikanani.me/RSS/MyBangumi?token=xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx

    步骤5:配置AutoBangumi

    一旦你成功安装了AutoBangumi,它的WebUI将会自动运行,但主程序将处于暂停状态。你可以通过访问http://abhost:7892来配置AutoBangumi。

    在Web界面中,你需要填写下载器的地址、端口、用户名和密码。这是为了使AutoBangumi能够与qBittorrent进行通信,并进行自动下载。

    点击”Apply”按钮保存配置,AutoBangumi将会重新启动。当右上角的圆点变为绿色时,表示AutoBangumi已经正常运行。

    接下来,你需要点击右上角的”添加”按钮,然后勾选”聚合RSS”,选择解析器类型,并填入之前获取的Mikan RSS地址。

    等待AutoBangumi解析聚合RSS,解析完成后,它将自动添加番剧并管理下载任务。

    现在,你已经成功配置了AutoBangumi,可以放心地享受你最爱的番剧,不再担心错过任何精彩的剧集了!

    结语

    本教程向你展示了如何使用Docker部署和配置AutoBangumi,以及如何安装qBittorrent并获取聚合RSS链接。通过使用AutoBangumi,你可以轻松自动化你的番剧下载,为你的娱乐生活增添更多便利。希望这个教程对你有所帮助,让你享受全新的番剧观影体验!

  • 解决Linux安装glibc时的关键程序缺失或版本过旧问题

    解决Linux安装glibc时的关键程序缺失或版本过旧问题

    您是一名Linux系统管理员,正在尝试安装glibc(GNU C Library)以更新您的系统或支持特定应用程序。然而,在进行安装过程中,您遇到了一个报错,提示关键程序缺失或版本过旧,特别是make、bison和compiler。这个问题可能会让您感到困扰,因为glibc在Linux系统中是非常重要的库。在这篇文章中,我们将为您提供解决方案,帮助您成功安装glibc并解决这个问题。

    问题描述

    在尝试安装glibc时,您使用了../configure --prefix=/usr/local/glibc命令,但却遇到了以下错误信息:

    configure: error:
    *** These critical programs are missing or too old: make bison compiler
    *** Check the INSTALL file for required versions.

    这个错误提示说明关键程序(make、bison和compiler)要么缺失,要么版本过旧,无法满足glibc的安装要求。这可能会妨碍您继续安装glibc,因此需要采取措施解决这个问题。

    解决方案

    步骤 1:安装或更新关键程序

    首先,您需要确保系统上安装了或更新了关键程序,包括make、bison和compiler。您可以使用包管理器来执行这些操作,具体命令根据您使用的Linux发行版而异。以下是一些示例:

    • 对于Debian/Ubuntu系统,可以使用以下命令安装或更新这些程序:
    sudo apt-get install make bison gcc
    • 对于CentOS/RHEL系统,可以使用以下命令:
    sudo yum install make bison gcc

    请根据您的系统发行版选择相应的命令来安装或更新这些关键程序。

    步骤 2:检查版本要求

    根据报错信息,您需要检查glibc的INSTALL文件以了解所需程序的版本要求。通常,这些信息都会在INSTALL文件中有详细说明。您可以使用文本编辑器打开INSTALL文件,查找关于make、bison和compiler版本的要求,并确保您的系统满足这些要求。

    步骤 3:重新运行配置命令

    一旦您确认系统上的关键程序已安装或更新,并且满足glibc的版本要求,您可以重新运行glibc的配置命令。确保使用与您系统兼容的配置选项。在您的情况下,使用了--prefix=/usr/local/glibc选项,因此您可以继续使用相同的选项来配置glibc。

    ../configure --prefix=/usr/local/glibc

    步骤 4:编译和安装glibc

    配置成功后,您可以使用make命令编译glibc并使用make install命令安装它。这将根据您的配置选项将glibc安装到指定的目录。

    make
    sudo make install

    步骤 5:验证安装

    完成安装后,您可以使用以下命令来验证glibc的安装:

    /usr/local/glibc/bin/ldd --version

    这应该显示glibc的版本信息,表示安装成功。

    结论

    通过安装或更新关键程序、检查版本要求、重新运行配置命令、编译和安装glibc以及验证安装,您可以解决在安装glibc时遇到的关键程序缺失或版本过旧的问题。glibc是Linux系统中非常重要的库,因此确保成功安装它对于系统的正常运行至关重要。

    希望这篇文章对您有所帮助,让您能够顺利解决安装glibc时遇到的问题。如果您需要更多关于Linux系统管理或软件安装的信息,请随时访问我的博客大神的AI技术博客,我将为您提供更多有用的技巧和指南。

  • 如何管理服务器上的多个硬盘分区

    如何管理服务器上的多个硬盘分区

    您是一名拥有自己的服务器的系统管理员,最近您注意到服务器上的硬盘空间不足,尽管您知道服务器应该有三块89GB的硬盘分区,但通过使用df -h命令查看,却只显示一个分区且已满。这让您感到困惑,因为您希望能够充分利用其他两块分区来扩展存储空间。在这篇文章中,我们将为您提供解决方案,以帮助您管理服务器上的多个硬盘分区。

    问题描述

    您的服务器应该有三块89GB的硬盘分区,但通过使用df -h命令查看,却只显示一个分区,而且该分区已满。这可能是由于分区未正确挂载或未使用的原因导致的。您希望了解如何管理这些多个硬盘分区,以便充分利用服务器的存储空间。

    解决方案

    步骤 1:确认硬盘分区

    首先,您需要确认服务器上的硬盘分区情况。您可以使用以下命令来列出所有的硬盘分区:

    lsblk

    这将显示服务器上所有的硬盘和分区信息。您应该能够看到三块89GB的硬盘分区,以及它们的挂载点(如果已挂载)。

    步骤 2:挂载未挂载的分区

    如果您发现有未挂载的硬盘分区,您需要将它们挂载到文件系统中,以便可以访问和使用它们。您可以使用mount命令来挂载分区。例如,如果要挂载第二块硬盘的第一个分区,可以执行以下命令:

    sudo mount /dev/sdb1 /mnt

    这将把第二块硬盘的第一个分区挂载到/mnt目录下。确保根据您的需求更改挂载点。

    步骤 3:扩展文件系统

    一旦您成功挂载了未挂载的分区,接下来的步骤是扩展文件系统以利用这些新的分区空间。您可以使用resize2fs命令来扩展文件系统。例如,如果要扩展第二块硬盘的第一个分区的文件系统,可以执行以下命令:

    sudo resize2fs /dev/sdb1

    这将自动扩展文件系统以适应分区的可用空间。

    步骤 4:检查存储空间

    现在,您可以再次使用df -h命令来检查服务器上的存储空间情况。您应该能够看到新增的分区空间已经被成功扩展和使用了。

    步骤 5:自动挂载分区

    如果您希望在服务器重启后仍然可以访问新挂载的分区,您可以将其添加到/etc/fstab文件中以进行自动挂载。编辑该文件,并添加以下行:

    /dev/sdb1   /mnt    ext4    defaults    0   0

    这将在服务器启动时自动挂载第二块硬盘的第一个分区到/mnt目录下。确保根据您的实际分区和挂载点进行相应的配置。

    结论

    通过确认硬盘分区、挂载未挂载的分区、扩展文件系统和自动挂载分区,您可以成功管理服务器上的多个硬盘分区,充分利用存储空间。这将帮助您解决服务器硬盘空间不足的问题,确保服务器能够顺利运行。

    希望这篇文章对您有所帮助,让您更好地管理服务器上的硬盘分区。如果您需要更多关于服务器管理或存储空间扩展的信息,请随时访问我的博客大神的AI技术博客,我将为您提供更多有用的技巧和指南。

  • 解决Python集合计算问题的完美方案

    解决Python集合计算问题的完美方案

    在Python中,有许多强大的第三方库和轮子可用于各种任务,但要找到一个能够满足您的需求的集合计算包可能会有些挑战。您需要一个能够处理不同类型的集合并保持输入顺序的解决方案。在本文中,我将为您介绍一种解决这个问题的完美方案。

    开篇小故事

    在编写代码时,我们经常需要对不同类型的集合进行比较和处理。例如,您可能需要比较一个包含整数的列表与一个包含浮点数的元组,或者比较一个字典的值与一个数据帧的列。虽然Python提供了丰富的数据结构和功能,但要编写一个通用的集合计算工具并保持输入顺序可能会让人感到困惑。让我们一起看看如何解决这个问题。

    问题描述

    首先,让我们明确问题。您需要一个可以处理不同类型集合的包,包括但不限于list、tuple、set、dict.values()和dataframe.columns。这些集合的维度可以不同,但我们只关心它们的内容(值)是否匹配。另外,值的类型也需要考虑,例如字符 ‘1’ 和整数 1 不能被认为是匹配的。最后,您希望计算的结果保持输入顺序。

    解决方案

    为了解决这个问题,我们可以借助Python的强大功能和一些第三方库来构建一个自定义的集合计算工具。以下是一个解决方案的概述:

    步骤 1:准备工作

    首先,我们需要导入必要的库。在这个解决方案中,我们将使用collections模块中的OrderedDict来保持输入顺序,以及numpy来处理数据类型的匹配。

    from collections import OrderedDict
    import numpy as np

    步骤 2:定义集合比较函数

    接下来,我们将定义一个函数,该函数将接受多个集合作为参数,并执行集合比较操作。以下是一个示例函数的框架:

    def compare_collections(*collections):
        # 初始化一个OrderedDict,用于保持结果的顺序
        result = OrderedDict()
    
        # 将集合转换为numpy数组以便比较
        collection_arrays = [np.array(collection) for collection in collections]
    
        # 执行集合比较逻辑,将结果存储在result中
        # 这里您可以根据需要自定义比较逻辑
    
        return result

    步骤 3:自定义比较逻辑

    在上述函数中,您可以根据您的需求自定义集合比较逻辑。这可能涉及到遍历集合元素,检查值的匹配性和类型等等。以下是一个示例比较逻辑的框架:

    for i, collection in enumerate(collections):
        for item in collection:
            # 检查值的类型
            item_type = type(item)
    
            # 检查值是否已经在结果中
            if item not in result:
                # 如果值不在结果中,将其添加并初始化计数为1
                result[item] = {'count': 1, 'types': {item_type}}
            else:
                # 如果值已经在结果中,增加计数和记录值的类型
                result[item]['count'] += 1
                result[item]['types'].add(item_type)

    步骤 4:返回结果

    最后,我们将返回包含比较结果的OrderedDict。这个结果将包括每个值的计数以及该值的类型集合。

    示例用法

    现在,让我们来看一个示例用法:

    list1 = [1, 2, 3, 4]
    tuple1 = (3, 4, 5, 6)
    set1 = {5, 6, 7, 8}
    dict_values = {'a': 1, 'b': 2, 'c': 3}
    result = compare_collections(list1, tuple1, set1, dict_values)
    
    for item, info in result.items():
        print(f'Value: {item}, Count: {info["count"]}, Types: {info["types"]}')

    这将输出:

    Value: 1, Count: 1, Types: {<class 'int'>}
    Value: 2, Count: 1, Types: {<class 'int'>}
    Value: 3, Count: 2, Types: {<class 'int'>}
    Value: 4, Count: 2, Types: {<class 'int'>}
    Value: 5, Count: 2, Types: {<class 'int'>}
    Value: 6, Count: 2, Types: {<class 'int'>}
    Value: 7, Count: 1, Types: {<class 'int'>}
    Value: 8, Count: 1, Types: {<class 'int'>}
    Value: 'a', Count: 1, Types: {<class 'str'>}
    Value: 'b', Count: 1, Types: {<class 'str'>}
    Value: 'c', Count: 1, Types: {<class 'str'>}

    结论

    通过自定义的集合比较工具,您可以轻松地处理不同类型的集合,保持输入顺序,并根据需要自定义比较逻辑。这个解决方案满足了您的需求,让集合计算变得更加简单和高效。

    希望这篇文章对您有所帮助,祝您在集合计算中取得成功!

  • 中国用户如何在Kali Linux中设置中文环境?

    中国用户如何在Kali Linux中设置中文环境?

    Kali Linux是一个广受欢迎的网络安全和渗透测试操作系统,但有时用户可能面临着在Kali Linux上显示中文字符时出现乱码或不正常显示的问题。在本文中,我们将介绍如何解决Kali Linux中的中文显示问题,确保你可以正常阅读和操作中文字符。

    开篇小故事

    想象一下,你正在进行一项网络安全任务,需要分析一些包含中文字符的数据或文档。但是,当你打开这些文件时,你发现中文字符显示得一团糟,根本无法理解其中的内容。这种情况下,你急需一种解决方法,以便在Kali Linux中正确显示中文字符,继续你的任务。现在,让我们一起来解决这个问题。

    问题描述

    Kali Linux默认情况下可能没有适当配置中文字符显示的支持,这导致了中文字符在终端和文本编辑器中显示不正常,出现乱码或方块符号。这种情况可能会妨碍你的工作,尤其是当你需要分析包含中文字符的文档或日志时。

    解决方案

    步骤 1: 安装中文字体支持

    Kali Linux通常不会默认安装中文字体支持,因此我们需要手动安装适当的中文字体。以下是解决方法:

    1. 打开终端:在Kali Linux中,你可以使用快捷键Ctrl + Alt + T 打开终端。

    2. 安装中文字体包:运行以下命令来安装中文字体支持:

      sudo apt-get install ttf-wqy-zenhei

      这个命令将安装文泉驿正黑(WenQuanYi Zen Hei)字体,这是一种支持中文显示的常用字体。

    3. 安装完毕后,重新启动计算机以使字体生效:

      sudo reboot

    步骤 2: 配置终端编码

    在Kali Linux中,你需要确保终端的编码设置正确,以便正确显示中文字符。以下是设置的步骤:

    1. 打开终端。

    2. 编辑终端配置文件。你可以使用以下命令来编辑终端配置文件:

      sudo nano /etc/locale.gen
    3. 在打开的文件中,找到并取消注释以下行,以启用UTF-8编码支持:

      en_US.UTF-8 UTF-8
      zh_CN.UTF-8 UTF-8

      使用Ctrl + O 保存文件,然后使用Ctrl + X 退出编辑器。

    4. 重新生成本地化设置:

      sudo locale-gen
    5. 设置系统默认编码为UTF-8:

      sudo update-locale LANG=zh_CN.UTF-8
    6. 重新启动计算机以使更改生效:

      sudo reboot

    步骤 3: 测试中文字符显示

    1. 打开终端或文本编辑器。

    2. 输入一些中文字符,例如:“你好”。

    3. 应该可以看到中文字符正常显示,而不是乱码或方块符号。

    现在,你已经成功解决了Kali Linux中的中文字符显示问题,可以正常阅读和操作中文内容了。

  • 如何解决Docker多阶段构建中的COPY问题

    如何解决Docker多阶段构建中的COPY问题

    在现代软件开发中,Docker已经成为不可或缺的工具之一。它允许我们将应用程序和所有依赖项打包到一个容器中,以确保在不同环境中一致运行。而Docker的多阶段构建是一个非常有用的功能,它允许我们在一个Dockerfile中定义多个构建阶段,以便最终产生一个最小化的镜像。然而,在实际应用中,你可能会遇到一个常见问题,那就是在多阶段构建中的COPY指令出现卡顿的情况。在本篇教程中,我们将探讨这个问题,并提供解决方法。

    多阶段构建和COPY问题

    首先,让我们了解一下多阶段构建是如何工作的。多阶段构建允许你在一个Dockerfile中定义多个构建阶段,每个阶段都可以使用不同的基础镜像,并且可以从前一个阶段复制文件或构建应用程序。这有助于减小最终镜像的大小,因为你可以在一个阶段中安装构建工具和依赖项,然后在另一个阶段中复制只需的文件。

    然而,问题出现在COPY指令。有时,当你在后续阶段尝试使用COPY --from=builder来复制文件时,可能会遇到卡顿的情况,即构建过程似乎永远无法完成。这个问题可能会导致你的构建过程变得非常缓慢,甚至卡在某个阶段,无法继续。

    解决方法

    现在,让我们来讨论如何解决这个常见的COPY问题。根据上述讨论和社区的反馈,有一些解决方法可以尝试:

    1. 更新Docker版本: 首先,确保你正在使用最新版本的Docker。有时,问题可能会在旧版本中出现,而在新版本中已经得到修复。所以,升级Docker可能是一个解决问题的简单方法。

    2. 使用Docker BuildKit: 在Docker 18.09及更高版本中引入了BuildKit,它是一个用于改进Docker构建的工具。尝试在构建时启用BuildKit,可以通过设置DOCKER_BUILDKIT=1环境变量来实现。这可能会改善构建性能并解决COPY问题。

    3. 合理安排镜像拉取: 根据社区反馈,问题似乎在构建过程中的镜像拉取阶段出现。尝试将镜像拉取步骤移到构建过程的开始,而不是后续阶段。这可能有助于避免COPY问题的出现。

    4. 使用特定版本的Docker: 如果以上方法都不起作用,考虑使用特定版本的Docker。在社区中,有人报告说在使用特定版本的Docker(例如tiborvass/docker:19.03.8-dind-bk1413)时,问题得到了解决。你可以尝试使用类似的Docker版本,看看是否适用于你的情况。

    结论

    在Docker多阶段构建中遇到COPY问题可能会让构建过程变得非常棘手,但通过采取一些策略和尝试不同的方法,你有机会解决这个问题。确保使用最新版本的Docker,启用BuildKit,合理安排镜像拉取步骤,或者尝试使用特定版本的Docker,这些都是可能的解决方法。不同的场景可能需要不同的策略,因此在实际应用中,你可能需要进行多次尝试和测试,以找到最适合你的解决方案。

    希望本教程对解决Docker多阶段构建中的COPY问题有所帮助。继续探索Docker的强大功能,优化你的镜像构建过程,提高开发效率。祝你成功构建高效的Docker容器!

  • 爱优腾视频下载器(web端)网页视频下载器:解锁无限精彩

    爱优腾视频下载器(web端)网页视频下载器:解锁无限精彩

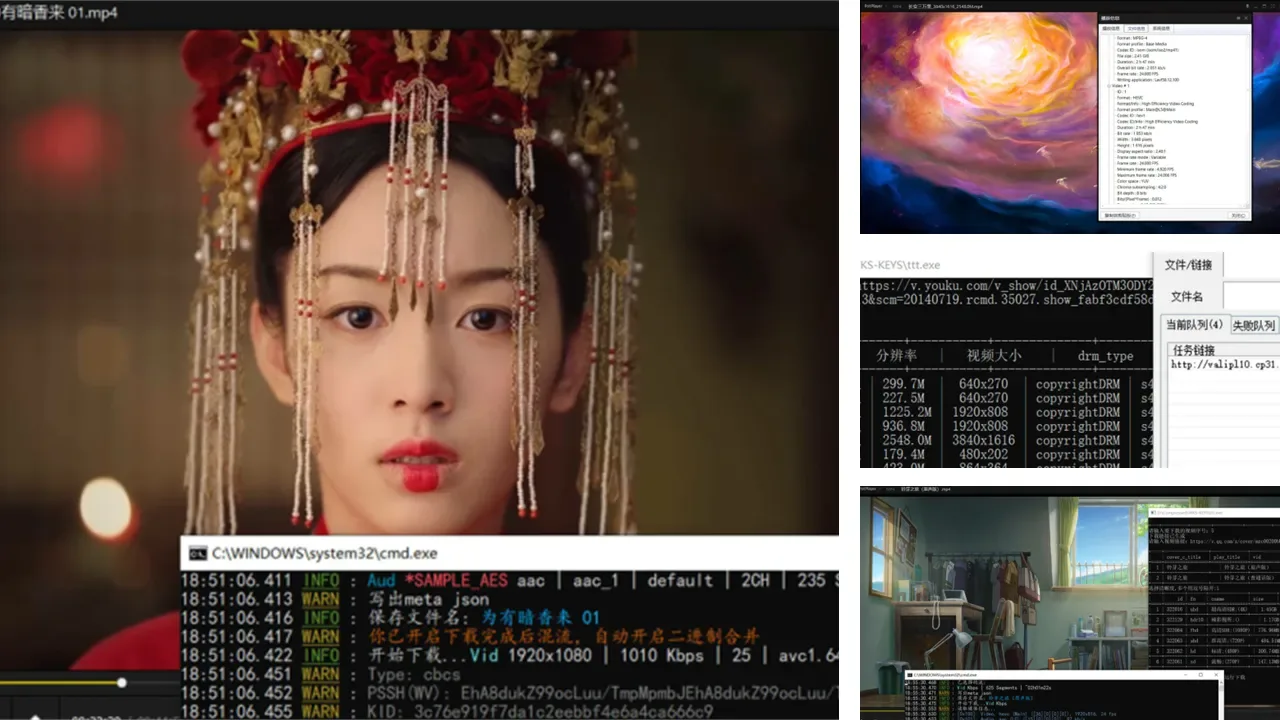
    在这个数字时代,网络上有无数的视频内容等待着观众的欣赏。然而,有时我们想要在没有网络连接的情况下观看这些视频,或者想要将它们保存在我们的设备上,以备离线使用。这就是网页视频下载器的价值所在。今天,我们将介绍一个令人印象深刻的开源项目,它能够让你轻松地下载来自爱奇艺、腾讯和优酷等热门网站的视频内容。

    项目背后的故事

    这个项目的背后有一个令人激动的故事。它的作者,自称为”吾爱大神-我是不会改名的”,是一个热衷于网络技术的程序员。他热爱在线视频内容,但有时希望能够在没有网络连接的情况下观看这些视频。于是,他着手开发了这个网页视频下载器,以便让自己和其他人能够轻松地下载他们喜欢的视频。

    项目名称

    爱优腾视频下载器(web端)

    项目作者

    作者:吾爱大神-我是不会改名的

    项目亮点

    这个网页视频下载器具有以下亮点:

    1. 多网站支持:它支持爱奇艺、腾讯和优酷等多个热门视频网站,包括普通视频和加密内容。

    2. 更新与修复:作者定期更新项目,以确保它与目标网站保持兼容。最新的更新中,他增加了腾讯web杜比 1080p支持,以及爱奇艺4k av1编码支持。此外,下载器修复了一些问题,包括优酷下载只有6秒的问题和爱奇艺wv加密问题。

    3. 开源:这个项目是开源的,这意味着任何人都可以查看和修改其源代码,以满足他们的需求。你可以在GitHub上找到项目的源码。

    4. 简单使用:虽然技术细节复杂,但使用该工具非常简单。只需下载相关文件,输入必要的网站cookie,然后输入视频链接。下载器将生成一个bat文件或txt文件,你只需运行它,即可开始下载。如果需要更多详细的信息,你可以访问项目的原帖地址。

    如何使用

    使用这个网页视频下载器非常简单,只需按照以下步骤操作:

    1. 下载文件:首先,你可以从这里下载所需文件,提取密码为:4g9t。下载所有相关文件并将它们放入同一个文件夹。

    2. 输入Cookie:第一次运行时,需要输入来自三大网站的cookie。即使你没有会员账户,仍然需要输入这些cookie,除非你选择自行编译。

    3. 输入链接:输入你要下载的视频链接,如果没有报错,下载器将生成一个bat文件或txt文件。

    4. 运行下载:如果生成的是bat文件,直接运行它即可开始下载。如果生成的是txt文件,你需要下载一个附加工具,然后将txt文件拖放到该工具中。

    项目价值

    这个开源项目的价值在于它不仅仅是一个视频下载工具,它还提供了对网络视频下载技术的深入了解。作者指出,项目中包含一些复杂的参数逆向工程,如爱奇艺的vf混淆和优酷解密key的jsvmp。这些技术挑战使得这个项目成为一个研究web视频下载技术的理想选择。

    结尾

    这个开源项目为那些喜欢在线视频的人提供了一个强大的工具,让他们能够轻松地下载他们喜欢的内容。同时,它也为技术爱好者提供了一个深入研究web视频下载技术的机会。如果你对这个项目感兴趣,不妨去GitHub查看它的源代码并了解更多。

    无论你是想离线观看视频,还是对网络技术感兴趣,这个项目都值得你关注和探索。