Tag: 硬件

  • 如何使用Frida发送微信消息给好友

    如何使用Frida发送微信消息给好友

    微信是现代生活中不可或缺的通讯工具,但有时候我们可能需要通过自动化方式发送消息给好友。本教程将介绍如何使用Frida工具来实现这一目标。Frida是一款强大的动态分析和反向工程工具,可以用于修改和控制运行中的应用程序。我们将使用Frida来构造消息数据和机器码,然后通过调用微信的函数来发送消息。

    准备工作

    在开始之前,确保您已经完成以下准备工作:

    1. 安装Frida:您可以在Frida官网找到适用于您操作系统的安装指南。

    2. 了解Frida基础知识:熟悉Frida的基本概念和使用方法,以便更好地理解本教程。

    步骤一:构造消息数据和机器码

    首先,我们需要构造要发送的消息数据,并将其编码成机器码。以下是实现此目标的关键步骤:

    1. 分配内存地址

    使用Frida的Memory.alloc函数来分配一块内存地址,以便我们可以在其中写入汇编代码。

    let messageData = Memory.alloc(0x100); // 分配一块大小为0x100的内存

    2. 写入汇编代码

    使用Frida的Memory.patchCode函数将汇编代码写入分配的内存地址。在这里,我们将使用x86汇编语言来构造消息发送的机器码。

    Memory.patchCode(messageData, 0x100, (code) => {
        let asm = new X86Writer(code);
    
        // 在这里编写汇编代码来构造消息数据和机器码
        // 例如,可以使用汇编指令push、mov、call等来构造发送消息的代码
    
        asm.flush();
    });

    3. 构造消息数据

    构造要发送的消息数据,这可以是文本消息、文件路径等。将消息数据写入分配的内存地址。

    4. 构造消息机器码

    使用汇编指令来构造消息发送的机器码,确保正确设置消息数据的地址等参数。

    5. 调用微信函数

    获取微信函数的地址,并使用Frida的NativeFunction来调用这些函数,实现消息发送功能。

    步骤二:构造结构体

    在发送消息之前,通常需要构造一些结构体来存储消息内容和相关参数。例如,构造一个表示好友的结构体和一个表示消息内容的结构体。

    function buildFriendStruct(friendId) {
        let structAddress = Memory.alloc(20);
    
        // 将好友ID写入结构体
        // 可根据微信数据结构自定义构建过程
    
        return structAddress;
    }
    
    function buildMessageStruct(content) {
        let structAddress = Memory.alloc(20);
    
        // 将消息内容写入结构体
        // 可根据微信数据结构自定义构建过程
    
        return structAddress;
    }
    
    // 使用示例:
    let friendId = "your_friend_id";
    let friendStruct = buildFriendStruct(friendId);
    
    let messageContent = "Hello, Frida!";
    let messageStruct = buildMessageStruct(messageContent);

    步骤三:调用发送消息函数

    获取微信发送消息的函数地址,然后使用Frida的NativeFunction来调用该函数,实现消息的发送。

    let wechatModule = Process.getModuleByName('wechatwin.dll');
    let sendMessageFunctionAddress = wechatModule.base.add('0x521D30'); // 替换为实际函数地址
    
    let sendMessage = new NativeFunction(sendMessageFunctionAddress, 'void', ['pointer', 'pointer']);
    
    // 调用发送消息函数
    sendMessage(friendStruct, messageStruct);

    结尾

    通过这个教程,您学会了如何使用Frida来发送微信消息给好友。请注意,Frida的使用需要谨慎,不要用于非法活动或侵犯他人隐私的行为。这个教程旨在帮助您理解Frida的基本原理和使用方法。
  • 云计算平台大比拼:Paperspace、Kaggle、Google Colab、Azure ML和更多

    云计算平台大比拼:Paperspace、Kaggle、Google Colab、Azure ML和更多

    云计算平台在现代数据科学和机器学习领域扮演着至关重要的角色。它们提供了强大的计算资源和便捷的开发环境,使研究人员和数据科学家能够进行高效的工作。本文将深入研究几个热门的云计算平台,包括Paperspace、Kaggle、Google Colab、Azure ML和SageMaker Studio Lab,以帮助你了解它们的特点和适用场景。

    Paperspace

    Paperspace是一个广受欢迎的云计算平台,为研究人员和开发者提供了丰富的工具和资源。官方指南和由Cyberes和camenduru维护的内容确保了平台的稳定性和可用性。你可以在Paperspace上运行各种计算任务,包括深度学习、数据分析和模型训练。

    优势:

    • 丰富的资源:Paperspace提供了强大的GPU和CPU资源,适用于各种计算需求。
    • 社区支持:有维护者和社区提供的指南和教程,帮助用户更好地使用平台。

    注意:Paperspace是一个强大的平台,但价格可能相对较高,因此需要注意成本管理。

    Kaggle

    Kaggle是一个数据科学竞赛和合作社区,但它也提供了云计算平台,用于数据科学家执行实验和建模。维护者包括roguewild和camenduru等。Kaggle提供了各种数据集、内置的机器学习工具和Notebook环境,使数据科学家能够轻松开展研究工作。

    优势:

    • 数据科学社区:Kaggle具有庞大的数据科学社区,用户可以分享代码和知识。
    • 丰富的数据集:平台上有大量的数据集可供使用。

    注意:Kaggle的计算资源有限,适合中小规模的项目,大型计算可能需要额外的配置。

    Google Colab

    Google Colab是一个免费的云计算平台,提供了基于云端的Jupyter Notebook环境。维护者包括TheLastBen、camenduru、ddPn08和Akaibu等。它受到了众多研究人员和学生的喜爱,但需要注意的是,根据2023年9月9日的消息,Google似乎限制了对Colab上任何形式的Stable Diffusion的使用,无论用户是否付费。这需要谨慎使用,以避免可能的封禁。

    优势:

    • 免费使用:Google Colab免费提供了一定的计算资源。
    • 轻松共享:你可以轻松分享Colab Notebook,并与他人协作。

    注意:由于限制可能导致封禁,使用Colab时需要小心。

    Azure ML 和 SageMaker Studio Lab

    Azure ML是微软的云计算平台,SageMaker Studio Lab则是亚马逊AWS的机器学习平台。这两个平台都提供了强大的计算资源和机器学习工具,适用于大规模的数据科学和机器学习项目。

    Azure ML的优势:

    • 与Microsoft生态系统集成:如果你已经使用Microsoft工具和服务,Azure ML可能更容易集成到你的工作流程中。
    • 自动化机器学习:Azure ML提供了自动化机器学习功能,简化了模型开发过程。

    SageMaker Studio Lab的优势:

    • 与AWS生态系统集成:如果你在AWS上托管其他服务,SageMaker Studio Lab可能是一个无缝的选择。
    • 丰富的机器学习工具:AWS提供了丰富的机器学习工具和服务,可以满足各种需求。

    结论

    选择适合自己项目需求的云计算平台是非常重要的。不同的平台具有不同的优势和限制,因此需要根据项目的规模、预算和特定需求来进行选择。无论选择哪个平台,都需要注意成本管理和资源的有效利用,以确保项目能够高效进行。

    在云计算的世界里,不同的维护者和社区贡献了丰富的资源和支持,使我们能够更轻松地进行数据科学和机器学习研究。最终,选择最适合你的平台将有助于提高工作效率,推动科学研究和创新。

  • OPCache 分析报告

    OPCache 分析报告

    OPCache(PHP Opcode Cache)是一个用于提高 PHP 性能的重要工具,它通过缓存 PHP 脚本的编译代码来减少服务器的负载,提高网站的响应速度。在本报告中,我们将对OPCache进行详细分析,包括使用率、内存使用、命中率、存储Keys、临时字符串存储内存、状态以及配置信息。

    OPCache 使用率

    上移下移切换面板:OPCache 使用率

    在这一部分,我们将查看OPCache的使用率情况。

    • 已用内存:79.64 MB
    • 剩余内存:48.36 MB
    • 浪费内存:0 MB
    • 所有内存:128 MB

    从上面的数据可以看出,已用内存占据了总内存的62.22%,而剩余内存占据了37.78%。这表明OPCache在服务器上占用了一定的内存资源,但仍有一定的剩余内存可供使用。

    刷新缓存

    刷新缓存是一个重要的操作,它可以清除OPCache中的缓存,以便重新加载最新的PHP脚本。这对于在代码更新后立即生效非常重要。

    命中率

    命中率数量比例

    在这一部分,我们将分析OPCache的命中率情况。

    • 命中:13,829,544(99.99%)
    • 未命中:1,853(0.01%)
    • 所有请求:13,831,397(100%)

    从上述数据可以看出,OPCache的命中率非常高,达到了99.99%,这意味着绝大多数请求都从缓存中获取,而不需要重新编译PHP脚本。这对于提高性能非常重要。

    存储Keys

    存储Keys数量比例

    这一部分将分析OPCache中存储Keys的情况。

    • 已用Keys:2,109(1.61%)
    • 剩余Keys:128,878(98.39%)
    • 所有Keys:130,987(100%)

    从上述数据可以看出,OPCache中的已用Keys相对较少,占总Keys的1.61%,而剩余Keys占总Keys的98.39%。这表明OPCache中的Keys数量还有很大的空间,可以继续缓存更多的PHP脚本。

    临时字符串存储内存

    临时字符串存储内存数量比例

    在这一部分,我们将分析OPCache中临时字符串存储内存的情况。

    • 已用内存:5.25 MB(21.88%)
    • 剩余内存:18.75 MB(78.13%)
    • 所有内存:24 MB(100%)

    从上述数据可以看出,OPCache中已用的临时字符串存储内存占总内存的21.88%,而剩余内存占78.13%。这表明OPCache在存储临时字符串方面占用了一定的内存资源,但仍有大量内存可供使用。

    OPCache 状态

    上移下移切换面板:OPCache 状态

    这一部分将提供OPCache的状态信息。

    • num_cached_scripts:1505
    • num_cached_keys:2109
    • max_cached_keys:130987
    • hits:13829544
    • start_time:1700014904
    • last_restart_time:1700840625
    • oom_restarts:0
    • hash_restarts:0
    • manual_restarts:3
    • misses:1853
    • blacklist_misses:0
    • blacklist_miss_ratio:0
    • opcache_hit_rate:99.9866%

    OPCache的状态信息包括缓存的脚本数量、缓存的Keys数量、最大缓存的Keys数量、命中次数、启动时间、最后重新启动时间、OOM重新启动次数、哈希重新启动次数、手动重新启动次数、未命中次数、黑名单未命中次数、黑名单未命中比例以及缓存命中率。这些信息可以用于监控和调整OPCache的性能。

    OPCache 配置信息

    上移下移切换面板:OPCache 配置信息

    这一部分提供了OPCache的配置信息。

    • version:8.1.21
    • opcache_product_name:Zend OPcache
    • enable:1
    • enable_cli:1
    • use_cwd:1
    • validate_timestamps:1
    • memory_consumption:134,217,728
    • interned_strings_buffer:32
    • max_accelerated_files:80,000
    • max_wasted_percentage:0.05
    • consistency_checks:0
    • force_restart_timeout:180
    • revalidate_freq:3
    • jit:1205
    • jit_buffer_size:134,217,728
    • jit_debug:0
    • jit_bisect_limit:0
    • jit_blacklist_root_trace:16
    • jit_blacklist_side_trace:8
    • jit_hot_func:127
    • jit_hot_loop:64
    • jit_hot_return:8
    • jit_hot_side_exit:8
    • jit_max_exit_counters:8192
    • jit_max_loop_unrolls:8
    • jit_max_polymorphic_calls:2
    • jit_max_recursive_calls:2
    • jit_max_recursive_returns:2
    • jit_max_root_traces:1,024
    • jit_max_side_traces:128
    • jit_prof_threshold:0

    这些配置信息包括OPCache的版本、产品名称、启用状态、内存消耗、文件缓存等等。这些配置项可以帮助您调整OPCache以满足您的应用程序需求。

    结论

    本报告对OPCache的使用率、内存使用、命中率、存储Keys、临时字符串存储内存、状态和配置信息进行了详细分析。通过监测和调整OPCache的性能参数,您可以提高PHP应用程序的性能,减少服务器负载,提高用户体验。

    希望这份报告对您有所帮助,如果您有任何问题或需要进一步的帮助,请随时联系我们。

  • VMware ESXi 8.0:引领虚拟化技术革新

    VMware ESXi 8.0:引领虚拟化技术革新

    在不断变化的科技世界中,创新和改进是企业生存的关键。VMware作为虚拟化技术领域的领导者,不断推陈出新,不仅满足了现代IT环境的需求,还引领着技术的发展。最新的VMware ESXi 8.0版本带来了一系列令人振奋的新特性和增强功能,让我们一起深入了解这些令人兴奋的创新。

    1. vSphere 分布式服务引擎:硬件加速的性能提升

    VMware ESXi 8.0引入了vSphere分布式服务引擎,这是vSphere 8的一个重要特性,原名为Project Monterey。该特性利用数据处理单元(DPU)来硬件加速数据处理,从而提高了基础架构的性能。这意味着在处理工作负载时,不再完全依赖于x86 CPU,而是借助DPU的强大计算能力,实现更高效的数据处理,提高了整体性能。

    此外,vSphere分布式服务引擎还增强了安全性,通过硬件级别的加密和隔离,有效保护了关键数据。更令人印象深刻的是,它简化了DPU的生命周期管理,使管理更加轻松。对于像我这样的技术热爱者和自由职业者,这个特性为提高工作效率提供了强大的支持。

    2. 网络卸载的简单配置:提升网络性能

    vSphere Distributed Switch 8.0带来了另一个令人激动的功能——网络卸载。这意味着网络服务可以卸载到DPU上,进一步提高了网络性能。不再需要完全依赖于x86 CPU来处理网络数据,而是通过DPU来处理,减轻了CPU的负担,使网络性能得到显著提升。

    对于远程工作者和云计算领域的专业人士,网络性能至关重要。这项功能的引入,将使虚拟化环境的网络更加高效,有助于提供更快的数据传输速度,提升了整体用户体验。

    3. Tanzu Kubernetes Grid 2.0:灵活的容器管理

    容器技术在现代应用开发中扮演着重要角色,而VMware ESXi 8.0通过Tanzu Kubernetes Grid 2.0进一步加强了容器管理。这个版本提供了跨越vSphere集群的工作负载可用区,以提高可用性,同时实现了声明式Tanzu Kubernetes集群部署。

    对于我这个对技术和创新充满热情的自由职业者来说,Tanzu Kubernetes Grid 2.0的灵活包管理通过Tanzu CLI非常吸引人。此外,集成身份验证功能Pinniped的引入,增强了安全性,让我更加放心地管理容器化应用程序。

    结语

    VMware ESXi 8.0的引入代表着虚拟化技术领域的一次重要革新。通过硬件加速、网络卸载、容器管理等一系列新特性和增强功能,VMware不仅提高了性能和安全性,还为用户提供了更多灵活性和便利性。

    作为一名对技术充满热情的自由职业者,我对这些创新充满期待。这些功能将有助于我更高效地管理我的远程工作和项目,同时为我的技术研究和兴趣提供了更多可能性。

    无论是提高性能、增强安全性,还是更好地支持容器化应用程序,VMware ESXi 8.0都为我们带来了无限可能。让我们一起期待这个令人兴奋的虚拟化技术未来!

  • 如何优化CPU浮点性能测试以获得准确结果

    如何优化CPU浮点性能测试以获得准确结果

    在计算机科学和工程领域,浮点性能测试是一个重要的课题。通过测量CPU处理浮点数的能力,我们可以评估其性能和效率。本教程将向您介绍如何进行CPU浮点性能测试,并优化测试以获得准确的结果。

    起源故事

    在现代计算机应用中,性能至关重要。无论是游戏、数据分析还是科学计算,都需要快速的CPU浮点性能。王大神,一个对音乐和技术充满热情的自由职业者,最近参与了一个有关CPU性能的讨论。他在一个在线社区中看到了一组关于不同CPU的浮点性能测试结果,结果却让他感到困惑。他注意到不同CPU的测试结果差异很大,有些CPU表现得很快,而有些却表现得很慢。王大神决定深入了解这个问题,以便更好地理解CPU浮点性能测试的原理和优化方法。

    教程内容

    什么是浮点性能测试?

    浮点性能测试是评估CPU处理浮点数运算速度的方法。它通常涉及执行一系列浮点运算,如加法、减法、乘法和除法,然后测量所花费的时间。测试结果通常以每分钟或每秒执行的操作数量来表示。

    如何进行浮点性能测试?

    要进行浮点性能测试,您需要一个合适的测试套件或程序。在本教程中,我们将使用一个名为billionsort.cpp的示例程序。以下是进行浮点性能测试的一般步骤:

    1. 下载测试程序:

      wget https://github.com/xiexiexx/PPLA/raw/main/billionsort/billionsort.cpp
    2. 编译测试程序:

      clang++ -O3 billionsort.cpp
    3. 运行测试程序:

      ./a.out

    优化浮点性能测试

    浮点性能测试的准确性和可比性取决于多个因素,包括硬件、编译器和测试程序本身。以下是一些优化浮点性能测试的建议:

    • 使用适当的编译器优化标志,如-O3,以提高编译后代码的性能。
    • 确保测试程序不受内存和缓存影响,以便测量CPU的真正性能。
    • 确保测试程序是单线程的,以避免多线程效应对性能测试的影响。
    • 使用不同的CPU进行测试,以便比较它们的性能。

    结果分析

    在浮点性能测试的结果中,王大神注意到不同CPU的表现差异很大。有些CPU在相同测试条件下表现出色,而有些则相对较慢。他还学到了浮点性能测试结果不仅受到CPU本身性能的影响,还受到内存和缓存性能的影响。因此,了解如何优化浮点性能测试是非常重要的,以获得准确的结果。

    总结

    浮点性能测试是评估CPU性能的重要工具,但要获得准确的结果,需要注意多个因素。通过优化测试程序和理解测试结果背后的原理,您可以更好地评估不同CPU的性能,从而更好地选择适合您需求的处理器。

  • 使用TensorRT加速Stable Diffusion:提高图像生成效率的关键技巧

    使用TensorRT加速Stable Diffusion:提高图像生成效率的关键技巧

    在现代的深度学习领域,图像生成是一个备受关注的重要任务。对于像王大神这样的AI技术爱好者和自由职业者来说,效率和性能的提升是至关重要的。最近,他在探索了多种方法后,发现了一项令人印象深刻的技术:使用TensorRT加速Stable Diffusion,这不仅提高了他的工作效率,还让他更快地生成高质量的图像。

    一、TensorRT加速概述

    在我们深入介绍如何使用TensorRT加速Stable Diffusion之前,让我们先了解一下TensorRT是什么以及它如何帮助优化深度学习模型。

    1.1 什么是TensorRT?

    TensorRT是由NVIDIA开发的深度学习推理加速库,专门用于优化深度学习模型在NVIDIA GPU上的运行速度。它通过一系列的技术和优化,提高了模型的推理效率,从而实现了更快的预测速度。

    1.2 为什么使用TensorRT?

    王大神在尝试使用Stable Diffusion进行文本到图像生成时,发现速度较慢,尤其是在处理高分辨率和复杂图像时。这时,TensorRT就成为了一个强大的工具,可以显著提升图像生成的速度,从而提高工作效率。

    1.3 准备工作:显卡驱动更新

    在使用TensorRT之前,确保您的显卡驱动已更新到最新版本(建议版本为537.3或更高),以充分发挥GPU的性能。这一步对于TensorRT的有效使用至关重要。

    1.4安装过程(图示)有手就行

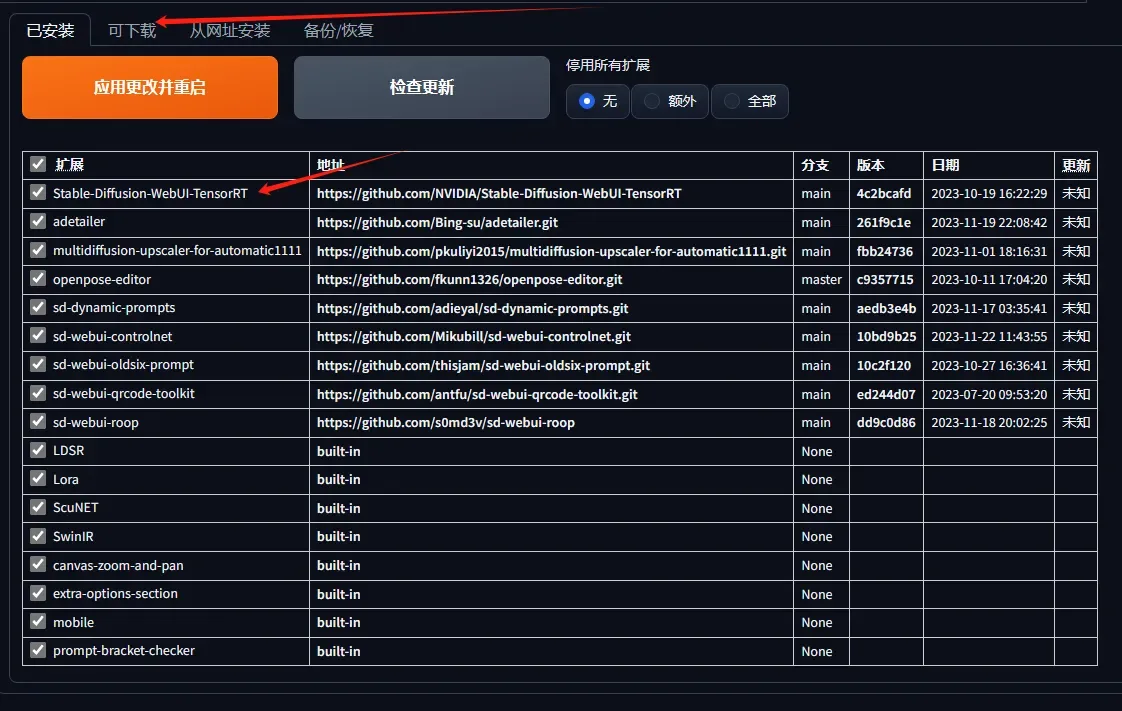
    从扩展直接安装

    安装完成之后重启webui

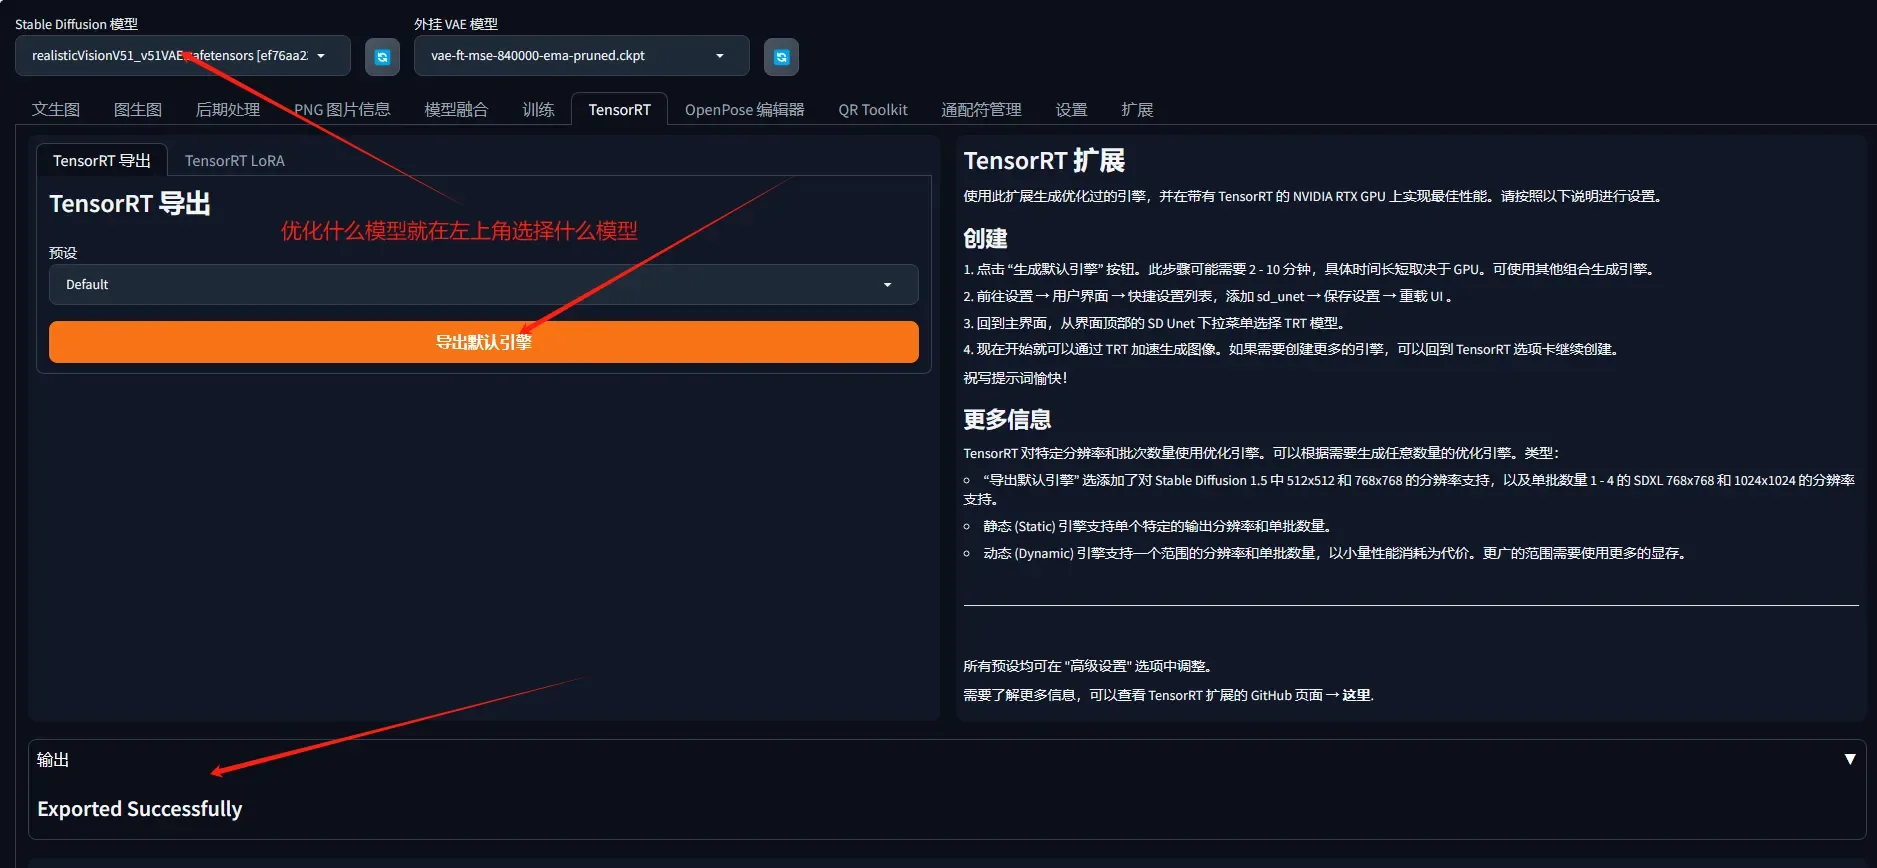
    加速哪个模型就在左上角选择哪个模型

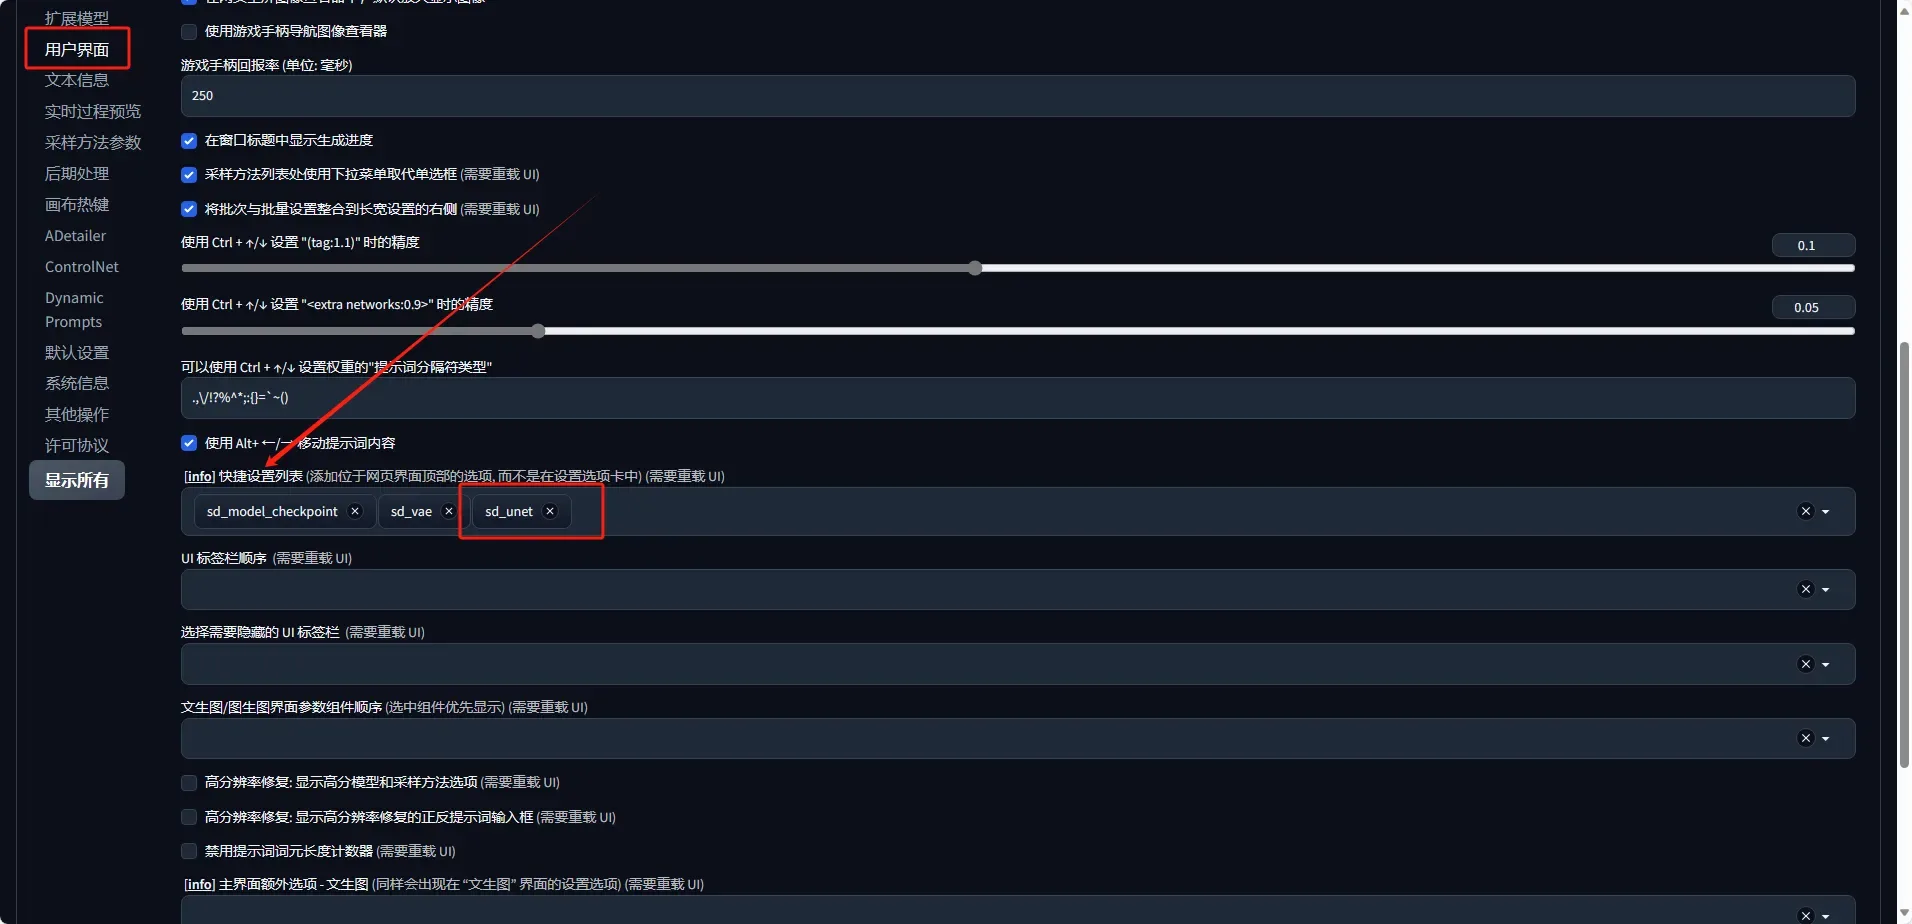
    为了方便选择,在快捷栏里加入sd_unet

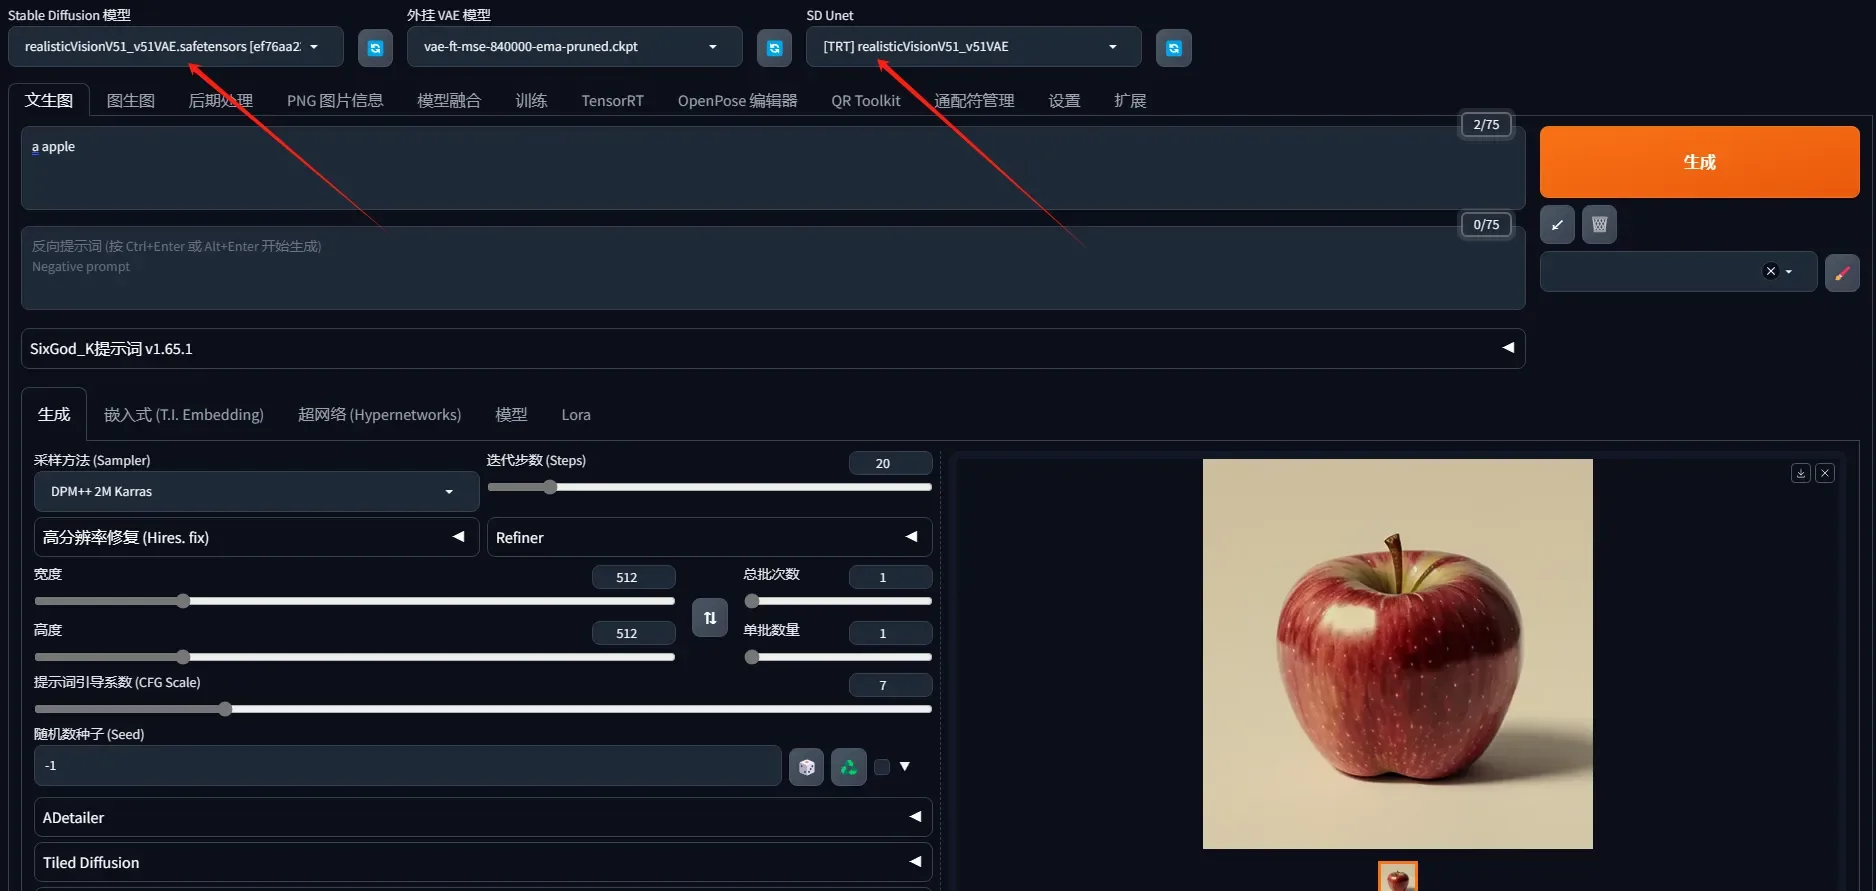
    使用的时候选择对应的加速模型

    注意,第一次生成的时候速度会有些慢。

    二、适配Stable Diffusion的TensorRT引擎

    现在,让我们深入了解如何将Stable Diffusion模型与TensorRT结合,以实现加速。

    2.1 构建TensorRT引擎

    要使用TensorRT加速Stable Diffusion,首先需要将Stable Diffusion模型转换为TensorRT可以高效处理的格式。这一步骤包括以下关键步骤:

    1. 将模型转换为ONNX格式:首先,将Stable Diffusion模型转换为ONNX格式。ONNX是一种开放的深度学习框架中立的中间表示,TensorRT可以从中进行优化。

    2. 使用TensorRT工具构建引擎:接下来,使用TensorRT的工具和API,将ONNX模型转换为TensorRT引擎。TensorRT会对模型进行各种优化,以提高推理性能。

    2.2 优化技巧

    在使用TensorRT时,还有一些优化技巧可以帮助您进一步提高性能,尤其是根据Stable Diffusion的具体需求。

    1. 调整批量大小:通过调整批量大小,您可以在一次推理中处理多个样本。这可以显著提高性能,尤其是在处理大量数据时。

    2. 选择合适的引擎类型:TensorRT提供了两种引擎类型,即动态引擎和静态引擎。动态引擎适用于不同大小的输入,而静态引擎更适合固定大小的输入。根据您的应用需求选择合适的引擎类型。

    三、TensorRT在Stable Diffusion中的实际应用

    现在让我们看看将TensorRT应用于Stable Diffusion后,会带来哪些实际的好处和效果。

    3.1 应用案例

    为了更好地理解TensorRT在Stable Diffusion中的应用,让我们看一个具体的案例。

    案例:生成高分辨率图像

    王大神正在处理一个需要生成高分辨率图像的项目。在使用TensorRT之前,生成一张高分辨率图像可能需要很长时间。但是,一旦将TensorRT引擎应用于Stable Diffusion模型,生成速度显著提升。例如,在以前可能需要数小时的情况下,现在可以在几分钟内生成相同质量的图像。

    这个案例清楚地展示了TensorRT在处理复杂任务时的实际效果,提高了工作效率。

    3.2 用户体验

    除了案例之外,还有一些用户反馈可以展示TensorRT在Stable Diffusion中的实际效果。让我们听听其他用户的声音:

    用户A:在我的研究项目中,我需要大量生成图像,以进行实验和分析。使用TensorRT后,我不仅加快了实验进度,还能够处理更多的数据。这让我的研究更加高效。

    用户B:作为一名游戏开发者,我需要生成逼真的游戏场景。TensorRT让我可以更快地生成各种场景,加速了游戏开发的进程,也提高了游戏的质量。

    结语

    通过使用TensorRT加速Stable Diffusion,工程师和研究人员可以在维持高质量输出的同时显著提升图像生成的速度。这一技术的应用不仅节约了宝贵的时间,还为处理复杂的图像生成任务提供了新的可能性。随着AI技术的不断发展,TensorRT等工具在图像生成领域的应用将越来越广泛。

    如果您也在处理图像生成任务,不妨尝试使用TensorRT来提高效率。它可能会成为您工作中的强大助手,让您更快地实现自己的目标。

  • Electron与浏览器UI:一场关于技术选择的辩论

    Electron与浏览器UI:一场关于技术选择的辩论

    随着技术的不断发展,开发者们在选择工具和框架时常常会面临一些艰难的抉择。在这篇文章中,我们将探讨一个备受争议的话题:为什么一些开发者选择使用Electron构建桌面应用,而不是直接在用户的浏览器中呈现UI界面。

    起源故事:为什么要讨论这个问题?

    在技术领域,我们经常会遇到各种看似无关紧要但实际上引发了广泛讨论的问题。正如一个技术充满热情的自由职业者,王大神,所提出的问题一样:为什么不直接在用户的浏览器中呈现UI界面,而要使用Electron构建一个独立的应用,封装了Chromium浏览器?

    这个问题引发了众多开发者的讨论和观点交流。在这篇文章中,我们将深入探讨这个问题,并分析其中的利弊以及为什么一些开发者可能会做出不同的选择。

    Electron:为何选择?

    Electron是一种开源框架,允许开发者使用HTML、CSS和JavaScript构建跨平台的桌面应用程序。它已经被广泛用于创建一些知名的应用程序,包括Visual Studio Code、Slack和WhatsApp桌面版等。那么,为什么有些开发者偏向于使用Electron呢?

    1. 跨平台兼容性

    一大优势是Electron能够轻松实现跨平台兼容性。开发者只需编写一次代码,然后就可以将应用程序发布到多个平台,包括Windows、macOS和Linux。这种能力极大地简化了应用程序的开发和维护工作。

    2. 安全性和权限

    使用Electron,开发者可以更好地控制应用程序的安全性和访问权限。相对于在浏览器中运行的应用,Electron应用可以更容易地获得操作系统级别的权限,例如访问文件系统。这对于一些需要本地文件访问的应用来说是至关重要的。

    3. 性能优化

    虽然Electron在一些方面可能会占用更多内存,但它允许开发者使用操作系统级别的优化和加速功能,以提高性能。这使得一些需要处理大量数据或复杂操作的应用程序更加高效。

    直接使用浏览器UI:有何利弊?

    然而,正如王大神所提出的问题一样,为什么不直接在用户的浏览器中呈现UI界面呢?这种方法也有其一定的优势和劣势。

    优势:

    1. 兼容性:将UI界面直接在浏览器中呈现可以确保最广泛的兼容性,因为几乎所有现代浏览器都支持HTML、CSS和JavaScript。

    2. 轻量级:浏览器本身是一个相对轻量级的应用,相比之下,Electron应用可能会占用更多的系统资源。

    3. 易于维护:由于浏览器是一个独立的应用,更新和维护UI界面可以更加灵活和简便。

    劣势:

    1. 限制:浏览器中的JavaScript受到一些安全限制,不允许访问操作系统级别的功能,例如文件系统。这可能会限制应用程序的功能。

    2. 用户体验:虽然浏览器是强大的工具,但用户可能更喜欢拥有独立的桌面应用程序,因为它们通常提供更好的用户体验,包括托盘图标、任务栏入口等。

    3. 扩展性:在浏览器中运行的应用程序通常需要更多的工作来实现扩展性,例如处理跨域请求等问题。

    结论

    在Electron与直接使用浏览器UI之间,选择哪种方法取决于具体的应用需求和开发者的偏好。Electron提供了跨平台兼容性、更高的安全性和性能优化,适用于需要本地权限和功能的应用。而直接使用浏览器UI则更加轻量级、兼容性强,适用于一些简单的应用或对兼容性要求较高的场景。

    无论选择哪种方法,开发者都应根据具体需求和用户体验权衡利弊。技术的选择永远是一个有争议的话题,而最终的目标始终是为用户提供出色的应用体验。

  • 结合Chat模型调用外部函数:从理论到实践

    结合Chat模型调用外部函数:从理论到实践

    在人工智能的迅猛发展中,GPT模型的出现如同一颗璀璨的新星,它不仅为我们提供了前所未有的文本生成能力,还赋予了我们将其与其他技术融合的无限可能。想象一下,如果我们可以将GPT模型的强大文本处理能力与外部函数的具体执行相结合,将会打开多么广阔的应用天地!这不仅是技术进步的象征,更是我们迈向更加智能化世界的一大步。因此,学习如何利用Chat Completions API与外部函数相结合,成为了现代技术人必备的技能之一。

    Chat模型与外部函数的结合使用

    背景介绍

    GPT模型通过Chat Completions API提供了与外部函数结合的能力。这意味着我们可以定义一系列函数,通过模型来生成相应的函数参数,进而实现更复杂的任务。这一过程分为两个主要部分:生成函数参数和使用模型生成的参数调用函数。

    准备工作

    首先,需要安装一些必要的库:

    !pip install scipy
    !pip install tenacity
    !pip install tiktoken
    !pip install termcolor 
    !pip install openai
    !pip install requests

    然后,我们定义一个用于发送请求的函数 chat_completion_request,并使用 pretty_print_conversation 函数来优雅地打印对话。

    import requests
    from tenacity import retry, wait_random_exponential, stop_after_attempt
    # ... 其他代码 ...
    
    @retry(wait=wait_random_exponential(multiplier=1, max=40), stop=stop_after_attempt(3))
    def chat_completion_request(...):
        # ... 函数体 ...
    
    def pretty_print_conversation(messages):
        # ... 函数体 ...

    函数参数的生成

    我们可以创建一些函数规格来与假设的天气API接口。例如,我们定义了两个函数:get_current_weather 和 get_n_day_weather_forecast。

    tools = [
        {
            "type": "function",
            "function": {
                "name": "get_current_weather",
                "description": "Get the current weather",
                # ... 参数定义 ...
            }
        },
        {
            "type": "function",
            "function": {
                "name": "get_n_day_weather_forecast",
                "description": "Get an N-day weather forecast",
                # ... 参数定义 ...
            }
        },
    ]

    当模型被提示查询当前天气时,它会根据这些函数规格生成相应的函数参数。

    使用模型生成的参数调用函数

    假设我们有一个SQLite数据库,我们可以定义一些辅助函数来从数据库中提取数据,并将这些数据用作函数规格的一部分。

    import sqlite3
    # ... 数据库连接和辅助函数 ...
    
    def ask_database(conn, query):
        # ... 查询数据库 ...

    然后,我们使用模型生成的参数来调用这些函数,并获取结果。

    messages = []
    # ... 构建消息 ...
    
    chat_response = chat_completion_request(messages, tools)
    # ... 解析和执行函数调用 ...

    通过这种方式,我们可以使GPT模型与实际的数据操作相结合,从而实现更加丰富和实用的功能。

    结语

    通过结合Chat模型和外部函数,我们可以将GPT模型的强大文本生成能力扩展到更广泛的应用领域。无论是天气查询、数据库操作,还是其他更复杂的任务,这种结合使用的方法都将为我们的工作和生活带来前所未有的便利和效率。

  • GPT服务波动:用户体验与AI技术的未来展望

    GPT服务波动:用户体验与AI技术的未来展望

    在数字时代,我们已经习惯了信息的即时获取和处理。从搜索引擎到智能助手,人们对技术的依赖程度日益增加。然而,当我们最依赖它们的时候,它们也可能会出现问题。今晨,众多用户在尝试访问GPT服务时,被一条消息迎接:“We’re experiencing exceptionally high demand. Please hang tight as we work on scaling our systems.” 这不仅仅是一个技术故障的通知,更是对人工智能技术发展的一次深刻反思。

    GPT服务中断:人工智能的考验

    GPT服务的中断并不是一个孤立事件,它反映出了人工智能技术在迅速发展的同时,也面临着诸多挑战。服务的不稳定性可能是由于多种因素造成的,包括硬件故障、软件缺陷、服务器超载或者是维护更新的需要。

    • 用户反馈集锦

      • 有用户表示,尽管遇到了服务中断的问题,但他们依旧对GPT的能力持肯定态度。
      • 一些技术爱好者开始关注OpenAI的状态更新页面,以获取最新的服务信息。
      • 不乏幽默的声音,有人调侃道:“是不是时空穿越者回来干掉GPT了?”
    • 服务恢复的迹象
      尽管服务中断带来了不便,但从用户的实时更新中我们也可以看到,服务的恢复正在逐步进行中。

    • 对服务依赖性的反思
      此次事件也让人们开始思考,当我们对技术的依赖达到一定程度时,一旦出现问题,我们应该如何应对。

    AI技术的快速发展与挑战

    人工智能技术的发展速度之快,超出了许多人的预期。GPT作为人工智能领域的佼佼者,其在语言模型上的应用几乎遍及所有领域。

    • 技术创新的步伐
      GPT的进步不仅体现在用户界面上,更体现在其背后的算法和计算力上。但是,创新的步伐也带来了新的挑战,如何平衡创新速度与用户体验成为了一个问题。

    • 挑战与机遇并存
      每一次技术的故障都是对开发者的挑战,同时也是改进和优化的机遇。从长远来看,这些挑战将推动技术向着更加成熟和稳定的方向发展。

    • 企业的应对策略
      对于企业来说,如何在技术发展的同时保持服务的稳定性,是一个需要长期考虑的问题。

    用户体验与AI服务的未来

    用户体验始终是技术产品成功与否的关键。GPT的服务中断提醒了所有科技公司,无论技术多么先进,如果不能提供稳定可靠的用户体验,就很难赢得用户的长期信任和支持。

    • 用户体验的重要性
      在人工智能服务中,用户体验不仅仅是界面的友好度,更包括服务的稳定性和可靠性。

    • 持续的服务优化
      对于OpenAI等公司来说,持续优化服务,减少服务中断的发生,是提升用户体验的重要途径。

    • 展望未来
      未来的AI服务将会更加智能化和个性化,但同时也应该更加稳定和可靠。

    在本次GPT服务中断事件中,我们看到了技术发展的双刃剑效应。一方面,人工智能技术为我们的生活带来了便利和效率;另一方面,技术的不稳定性也暴露了我们对它的依赖程度。随着技术的不断进步,我们有理由相信,未来的AI服务将会更加强大,同时也会更加稳定和可靠。

  • 在HomePod上使用Python实现Matter语音控制:详细教程

    在HomePod上使用Python实现Matter语音控制:详细教程

    王大神是一个对音乐和技术充满热情的自由职业者,他充分利用自由的生活和工作方式。最近,他遇到了一个技术挑战:如何在HomePod上使用Python实现Matter语音控制。这个挑战是因为Matter的开发信息相对有限,但王大神不轻言放弃。在他的追求下,他探讨了多种方法,并在论坛上与其他技术爱好者进行了讨论。在这篇教程中,我们将详细介绍王大神的探索过程,并提供一个全面的教程,以帮助你实现在HomePod上使用Python进行Matter语音控制的目标。


    探索不同方法

    王大神首先考虑了使用快捷指令来实现这一目标。一位论坛用户建议他可以调用shell,然后从shell中运行Python程序。这个方法看起来很有前景,但王大神想知道是否可以通过快捷指令在HomePod上进行TTS语音或播放音频。用户回答说快捷指令可以让文本被读出来,这对于TTS是可行的。但是,在王大神进一步追问是否需要使用家庭应用程序时,用户建议直接使用快捷指令,因为家庭自动化的功能有限。对于TTS,有朗读文本的模块,还可以指定音频输出设备为HomePod。然而,关于如何调用Matter,用户表示不太清楚,但提出了通过shell从远程主机执行Python程序的方法。这种方法有一些限制,需要iOS / MacOS / iPadOS设备,并且快捷指令只是从这些设备中存储,HomePod本身只是用来启动执行或播放音频。

    王大神还考虑了使用Home Assistant,但他遇到了一些稳定性问题和连接问题。另一个用户也分享了类似的问题,指出苹果的生态系统相对封闭,很多定制性内容不开放,因此没有找到很好的解决方案。


    实现Matter语音控制的步骤

    现在,让我们来详细介绍如何在HomePod上使用Python实现Matter语音控制。以下是步骤:

    步骤1:准备工作

    在开始之前,确保你拥有以下准备工作:

    • 一个HomePod设备
    • 一台运行Python的计算机
    • Matter的相关文档和SDK

    步骤2:创建Python程序

    编写一个Python程序,该程序将连接到HomePod并执行Matter语音控制。你可以使用Matter的SDK来帮助你与HomePod通信。确保程序能够接受语音指令,并执行相应的操作。

    以下是一个简单的示例程序:

    import matter_sdk
    
    def main():
        # 初始化Matter SDK
        matter = matter_sdk.Matter()
    
        # 连接到HomePod
        homepod = matter.connect_to_homepod()
    
        # 接受语音指令
        voice_command = input("请输入语音指令:")
    
        # 执行Matter语音控制
        result = homepod.execute_voice_command(voice_command)
    
        # 打印结果
        print("执行结果:", result)
    
    if __name__ == "__main__":
        main()

    步骤3:测试程序

    运行Python程序并测试它是否能够成功连接到HomePod并执行Matter语音控制。确保你的语音指令被正确识别和执行。

    步骤4:优化和定制

    根据你的需求,优化和定制你的Python程序。你可以添加更多的语音控制功能,处理不同的指令,并改进用户体验。


    结论

    在这篇教程中,我们详细介绍了如何在HomePod上使用Python实现Matter语音控制。尽管Matter的开发信息有限,但通过使用Matter的SDK和一些编程技巧,你可以实现这一目标。王大神的探索过程和经验分享对于想要在HomePod上进行语音控制的人来说将会非常有帮助。希望这篇教程对你有所帮助,并让你能够实现自己的Matter语音控制项目。