Tag: AI

  • 如何利用CLIP神经网络实现文本到图像生成

    如何利用CLIP神经网络实现文本到图像生成

    在现代科技的推动下,人工智能领域不断发展壮大。文本到图像生成是其中一个备受瞩目的领域,它允许计算机根据文本描述生成逼真的图像。本教程将详细介绍如何利用CLIP神经网络实现文本到图像的生成,带您深入了解这一令人兴奋的技术。

    1. CLIP神经网络简介

    CLIP是一种先进的神经网络,其全称为Contrastive Language-Image Pretraining。它的主要功能是将文本描述转换为数字表示,而这一数字表示在神经网络上表现出色。这正是为什么在稳定扩散(Stable Diffusion)生成图像方法中,CLIP被选为其中的一个关键组件之一。

    CLIP神经网络包含多层网络结构,每一层都参与文本到图像的转换过程。从文本描述开始,它经过网络的层层处理,每一层都对输入进行不同的转换。最终,得到的输出将用于生成与文本描述相匹配的图像。

    1.1. 调整CLIP模型的层数

    在使用CLIP神经网络时,您可以根据需要调整使用的层数。默认情况下,CLIP神经网络会使用所有层的输出,但您也可以选择提前结束运算,仅使用倒数第二层的输出。这个选择影响着神经网络在处理文本描述上的工作层数,从而影响生成图像的精度和效率。

    2. 实现AI绘画的关键:文本理解与匹配

    要实现AI绘画,首先需要让程序能够“理解”您的指令,即文本描述。例如,如果您输入以下文本描述:

    一个大樱桃树在湖上飞舞的花瓣上方。

    一个大樱桃树在湖上飞舞的花瓣上方。 一个大樱桃树在湖上飞舞的花瓣上方。

    这是一个相对复杂的场景描述,AI需要能够理解并将其匹配到相应的画面。大多数文本到图像生成项目都依赖于CLIP神经网络,因为它在生成模型的潜在空间中进行搜索,找到与给定文本描述相匹配的潜在图像。CLIP是一种现代且高效的方法,为实现文本到图像生成提供了强大的支持。

    3. 创建文本到图像生成模型的步骤

    现在,让我们深入研究如何利用CLIP神经网络创建文本到图像生成模型。以下是基本的步骤:

    3.1. 数据准备

    首先,您需要准备一个包含文本描述和相应图像的数据集。这将作为模型训练的基础。

    3.2. 构建模型

    接下来,构建文本到图像生成模型,包括定义潜在空间的维度、损失函数和超参数等。

    3.3. 模型微调

    利用CLIP神经网络,将文本描述转化为潜在空间中的向量,并生成与之匹配的图像。

    3.4. 评估和优化

    评估模型生成的图像与文本描述的一致性,并根据需要进行优化。

    3.5. 图像生成

    最后,使用训练好的文本到图像生成模型,根据文本描述生成逼真的图像。

    结论

    文本到图像生成是一项令人兴奋的技术,它允许计算机根据文本描述创造出生动的图像。通过了解CLIP神经网络以及创建文本到图像生成模型的步骤,您可以开始探索这一领域,实现更多有趣的应用。

  • 深入了解Weaviate与OpenAI的集成

    深入了解Weaviate与OpenAI的集成

    在数字时代,数据搜索和查询变得越来越重要。有时,我们需要更智能、更高级的搜索引擎来满足复杂的信息需求。本教程将向您介绍Weaviate和OpenAI的集成,展示如何使用这个组合来进行语义向量搜索、混合搜索和问答,以满足您的数据搜索需求。

    Weaviate和OpenAI的背景故事

    假设您是一家科技公司的数据分析师,您的工作涉及大量的文本数据和信息搜索。您发现了Weaviate和OpenAI的集成,这个组合提供了先进的搜索和查询功能,使您能够更轻松地从海量数据中提取有价值的信息。您意识到,掌握这个技能将帮助您在竞争激烈的行业中脱颖而出,因此您决定深入了解这个强大的工具。

    步骤1:认识Weaviate和OpenAI

    Weaviate简介

    Weaviate是一个开源的矢量搜索引擎,它的功能超越了传统的关键词搜索。它能够存储和搜索OpenAI的嵌入(embeddings)和数据对象,从而实现更智能的搜索和查询。

    Weaviate的主要特点包括:

    • 相似度搜索:能够查找与给定向量最相似的数据对象。
    • 混合搜索:结合多种搜索技术,包括基于关键词的搜索和矢量搜索。
    • 生成式搜索:支持类似问答(Q&A)的搜索。

    OpenAI集成

    Weaviate支持多种基于OpenAI的模块,例如text2vec-openai和qna-openai。这些模块允许您将数据向量化,并以更快更高效的方式查询数据。

    步骤2:Weaviate的三种运行方式

    您可以选择将Weaviate(包括OpenAI模块,如果需要的话)以以下三种方式运行:

    1. 在Docker容器内开源运行

    您可以通过在Docker容器内运行Weaviate来轻松地搭建您的搜索引擎。这是一个灵活的选择,让您可以根据需要进行自定义配置。

    2. 使用Weaviate云服务

    如果您希望无需自行搭建和维护服务器,可以选择使用Weaviate的云服务。这是一个快速入门的方式,让您可以立即开始使用强大的搜索功能。

    3. 在Kubernetes集群中运行

    对于需要更高度可伸缩性和性能的应用,您可以在Kubernetes集群中运行Weaviate。这种部署方式适用于大规模数据搜索需求。

    步骤3:示例和实践

    在学习Weaviate和OpenAI集成的过程中,实际示例非常重要。以下是一些示例和实践项目,帮助您更好地理解如何利用这个组合:

    示例1:开始使用Weaviate和OpenAI

    • 描述:这个示例演示了如何使用Weaviate和OpenAI的文本向量化模块(text2vec-openai)进行语义向量搜索。
    • 语言:Python
    • Google Colab链接:点击此处查看示例

    示例2:混合搜索与Weaviate和OpenAI

    • 描述:这个示例介绍了如何使用Weaviate和OpenAI的文本向量化模块(text2vec-openai)进行混合搜索,结合了关键词搜索和矢量搜索。
    • 语言:Python
    • Google Colab链接:点击此处查看示例

    示例3:问答与Weaviate和OpenAI

    • 描述:这个示例展示了如何在Weaviate中使用OpenAI的问答模块(qna-openai)进行问答搜索。
    • 语言:Python
    • Google Colab链接:点击此处查看示例

    示例4:Docker-compose示例

    • 描述:这个示例提供了一个包含所有OpenAI模块的Docker-compose文件,让您可以一次性启用所有功能。
    • 部署方式:Docker

    通过这些示例,您将能够深入了解Weaviate和OpenAI集成的强大功能,以及如何将它们应用于不同的搜索和查询场景。

    结论

    本教程向您介绍了Weaviate和OpenAI的集成,以及如何使用它们来进行语义向量搜索、混合搜索和问答。这将帮助您更好地利用这个组合来满足复杂的数据搜索需求,无论是在个人项目中还是在企业级应用中。

    现在,您已经掌握了这一强大技能,可以在信息时代中脱颖而出,为您的数据分析和搜索工作增添更多价值!


    通过本教程,您已经了解了如何使用Weaviate和OpenAI的集成来进行高级数据搜索和查询。无论是在个人项目中还是在企业应用中,这个组合都可以为您提供更智能、更高效的搜索功能,从而更好地满足信息需求。现在,您可以开始应用这些知识,提升自己的技能和价值!

  • 如何使用ChatGPT模型创建自然语言生成应用

    如何使用ChatGPT模型创建自然语言生成应用

    在数字时代,自然语言生成(Natural Language Generation,NLG)应用变得越来越流行,这些应用能够自动生成文本内容,从虚拟助手到智能客服再到自动化报告。OpenAI的ChatGPT模型是一种强大的工具,可以用于构建这类应用。本教程将向您展示如何使用ChatGPT模型创建自然语言生成应用,以满足您的需求。

    起源故事

    想象一下,您是一家新兴的电子商务公司的创始人,您的团队正在研发一款智能客服应用,以提供更好的用户体验。您已经听说过OpenAI的ChatGPT模型,并且认为它可以为您的应用增添一些独特的智能和人性化。然而,您不知道如何开始,这就是这篇教程的用武之地。

    现在,让我们一起学习如何使用ChatGPT模型来创建强大的自然语言生成应用。

    步骤1:导入OpenAI库

    首先,您需要导入OpenAI Python库,以便与OpenAI API进行通信。如果您尚未安装或升级OpenAI库,可以使用以下命令:

    %pip install --upgrade openai

    然后,导入OpenAI库:

    import openai

    步骤2:Chat API调用示例

    Chat API调用包括两个必需的输入参数:模型(model)和消息(messages)。

    • model:指定您要使用的模型名称(例如,gpt-3.5-turbo,gpt-4)。
    • messages:提供消息对象的列表,每个消息对象包含两个必需的字段:
      • role:指示发件人的角色(system,user或assistant)。
      • content:包含消息的内容(例如,“为我写一首美丽的诗”)。

    消息还可以包含一个可选的name字段,用于为发件人指定名称(例如,“example-user”,“Alice”,“BlackbeardBot”)。

    以下是一个Chat API调用的示例:

    MODEL = "gpt-3.5-turbo"
    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "您是一个乐于助人的助手。"},
            {"role": "user", "content": "敲敲。"},
            {"role": "assistant", "content": "谁在敲门?"},
            {"role": "user", "content": "橙子。"},
        ],
        temperature=0,
    )

    上述示例中,我们首先指定了要使用的模型(gpt-3.5-turbo),然后创建了一个消息列表,其中包含系统消息、用户消息和助手消息。每个消息都有role和content字段。

    步骤3:如何指导ChatGPT

    对于不同版本的ChatGPT模型,最佳实践可能会有所不同。在指导模型方面,以下是一些建议:

    系统消息

    系统消息可以用于设置助手的行为或性格。然而,对于gpt-3.5-turbo-0301等早期模型,它们通常不像后来的模型(如gpt-4-0314或gpt-3.5-turbo-0613)那样关注系统消息。因此,对于gpt-3.5-turbo-0301,我们建议将重要的指令放在用户消息中,以获得更好的效果。一些开发者发现,在对话变得越来越长时,将系统消息不断移到对话末尾可以保持模型的注意力不会漂移。

    少量示例

    有时,向模型展示您想要的内容比告诉模型更容易。您可以使用示例消息来引导模型,演示所需的行为或响应。

    例如,以下是一个模仿商业术语翻译为简单语言的示例:

    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "您是一个乐于助人、遵循模式的助手。"},
            {"role": "user", "content": "帮我把以下企业术语翻译成简单的英语。"},
            {"role": "assistant", "content": "当然,我愿意帮忙!"},
            {"role": "user", "content": "新的协同作用将有助于推动顶线增长。"},
            {"role": "assistant", "content": "事物协同运作良好将增加收入。"},
            {"role": "user", "content": "让我们在有更多空间时再回过头来,讨论提高杠杆的机会。"},
            {"role": "assistant", "content": "等我们不那么忙时再谈,讨论如何做得更好。"},
            {"role": "user", "content": "这次的突然改变意味着我们没有时间为客户交付准备工作。"},
        ],
        temperature=0,
    )

    上述示例演示了如何使用示例消息来引导模型执行翻译任务。

    支持性细节

    在教程中,包括相关的示例、案例研究、数据表格或代码片段,以支持所提出的观点,并帮助读者理解和应用教程中的概念。

    步骤4:计算令牌数

    在提交请求时,API会将消息转换为令牌(tokens)序列。令牌数的多少会影响以下几个方面:

    • 请求的费用
    • 生成响应的时间
    • 回复是否因达到最大令牌限制而被截断(对于gpt-3.5-turbo是4,096个令牌,对于gpt-4是8,192个令牌)

    您可以使用以下函数来计算消息所使用的令牌数:

    import tiktoken
    
    def num_tokens_from_messages(messages, model="gpt-3.5-turbo-0613"):
        # 返回消息列表使用的令牌数
        # ...

    请注意,消息中的令牌计数可能因模型版本而异,因此需要使用适用于您的模型的函数。

    结论

    本教程向您展示了如何使用ChatGPT模型创建自然语言生成应用。通过系统消息、示例消息和支持性细节,您可以指导模型生成所需的文本内容。同时,通过计算令牌数,您可以控制请求的成本和响应时间。
  • 如何正确配置Robots.txt文件来控制搜索引擎访问

    如何正确配置Robots.txt文件来控制搜索引擎访问

    在网络的世界里,搜索引擎扮演着重要的角色,它们帮助用户找到他们需要的信息,也是网站流量的重要来源之一。然而,有时候网站所有的内容都不希望被搜索引擎收录,或者只想让特定的搜索引擎访问。这就是Robots.txt文件的用武之地。今天,我们将深入探讨Robots.txt文件的配置,以及如何正确使用它来控制搜索引擎的访问。

    什么是Robots.txt文件?

    Robots.txt文件是一种用于控制搜索引擎蜘蛛(也称为spider或bot)访问网站内容的文件。当搜索引擎蜘蛛访问一个网站时,它会首先查找该网站的根目录下是否存在名为”robots.txt”的文本文件。这个文件包含了一些规则,告诉蜘蛛哪些部分可以访问,哪些部分不可以。Robots.txt文件可以帮助网站管理员控制搜索引擎对网站的访问范围,从而对SEO(搜索引擎优化)产生重要影响。

    配置Robots.txt文件的常见示例

    下面是一些常见的Robots.txt文件配置示例,以帮助您更好地理解如何使用它来控制搜索引擎的访问。

    示例1:禁止所有搜索引擎访问网站的任何部分

    如果您希望禁止所有搜索引擎访问您的网站,可以创建一个Robots.txt文件,内容如下:

    User-agent: *
    Disallow: /

    这个示例中,”User-agent: *”表示对所有搜索引擎蜘蛛生效,而”Disallow: /”则表示禁止访问网站的所有部分。

    示例2:允许所有的robot访问

    如果您希望允许所有搜索引擎蜘蛛访问您的网站,可以创建一个空的Robots.txt文件,即文件中不包含任何规则。

    示例3:仅禁止Baiduspider访问您的网站

    如果您只希望禁止百度的搜索引擎蜘蛛(Baiduspider)访问您的网站,可以这样配置Robots.txt文件:

    User-agent: Baiduspider
    Disallow: /

    这个示例中,只有Baiduspider会受到限制,其他搜索引擎蜘蛛可以自由访问。

    示例4:仅允许Baiduspider访问您的网站

    如果您只想允许百度的搜索引擎蜘蛛访问您的网站,可以这样配置:

    User-agent: Baiduspider
    Allow: /
    User-agent: *
    Disallow: /

    这个示例中,只有Baiduspider被允许访问网站,其他搜索引擎被禁止。

    示例5:仅允许Baiduspider以及Googlebot访问

    如果您希望同时允许百度的Baiduspider和Google的Googlebot访问网站,可以这样配置:

    User-agent: Googlebot
    Allow: /
    User-agent: Baiduspider
    Allow: /
    User-agent: *
    Disallow: /

    这个示例中,只有Googlebot和Baiduspider可以访问网站,其他搜索引擎蜘蛛被禁止。

    示例6:禁止spider访问特定目录

    有时候,您可能希望禁止搜索引擎蜘蛛访问特定的目录。在这个示例中,我们将禁止访问三个不同的目录。

    User-agent: *
    Disallow: /cgi-bin/
    Disallow: /temp/
    Disallow: /private/

    这个示例中,所有搜索引擎蜘蛛都被禁止访问”/cgi-bin/”、”/temp/”和”/private/”这三个目录。

    示例7:允许访问特定目录中的部分URL

    如果您只想允许搜索引擎蜘蛛访问某个目录下的部分URL,可以这样配置:

    User-agent: *
    Disallow: /private/
    Allow: /private/public-page.html

    这个示例中,”/private/”目录被禁止访问,但”/private/public-page.html”这个具体的URL被允许访问。

    示例8:使用通配符限制访问URL

    有时候,您可能希望使用通配符来限制搜索引擎访问某些特定类型的URL。以下是两个示例,一个使用”*”通配符,一个使用”$”通配符。

    使用”*”通配符限制访问URL

    User-agent: *
    Disallow: /cgi-bin/*.htm

    这个示例中,所有以”.htm”为后缀的URL在”/cgi-bin/”目录下都被禁止访问。

    使用”$”通配符限制访问URL

    User-agent: *
    Disallow: /*.jpg$

    这个示例中,所有以”.jpg”为后缀的URL都被禁止访问。

    结语

    Robots.txt文件是网站管理中的重要工具,可以帮助您控制搜索引擎蜘蛛的访问范围,从而对网站的SEO产生重要影响。通过正确配置Robots.txt文件,您可以确保搜索引擎蜘蛛只访问您希望他们访问的部分,同时保护敏感信息和资源。希望本文提供的示例和指南能够帮助您更好地理解如何使用Robots.txt文件来控制搜索引擎的访问,提高您网站的可见性和安全性。

  • 了解Robots文件:管理搜索引擎对网站的访问

    了解Robots文件:管理搜索引擎对网站的访问

    在互联网时代,网站的流量对于许多网站所有者和运营者来说至关重要。流量意味着用户的访问和互动,是网站生存和发展的关键。而搜索引擎则是带来大量流量的主要渠道之一。然而,有时候,我们希望搜索引擎不要访问网站的某些部分,或者只让特定的搜索引擎访问特定的内容。这就是Robots文件的用武之地。

    什么是Robots文件?

    Robots文件,又称为robots.txt,是一种用于管理搜索引擎对网站的访问的文件。它是站点与搜索引擎蜘蛛(也称为spider或爬虫程序)之间的重要沟通渠道。通过Robots文件,网站所有者可以声明哪些部分不希望被搜索引擎收录,或者指定某些搜索引擎只能收录特定的内容。

    Robots文件的作用

    Robots文件的作用在于控制搜索引擎蜘蛛对网站的抓取范围。当搜索引擎蜘蛛访问一个网站时,它会首先检查该网站的根域下是否存在一个名为robots.txt的纯文本文件。这个文件包含了一系列规则,告诉搜索引擎蜘蛛哪些页面可以抓取,哪些页面不可抓取。

    创建和配置Robots文件

    Robots文件的位置

    Robots文件应该放置在网站的根目录下。例如,当搜索引擎蜘蛛访问一个网站时,会首先检查是否存在像这样的文件:[http://www.example.com/robots.txt] 。如果找到这个文件,搜索引擎蜘蛛会根据其中的规则来确定其访问权限。

    Robots文件的格式

    Robots文件的格式相对简单,它由一条或多条记录组成,每条记录通过空行分隔。每条记录的格式如下所示:

    <field>: <value>

    其中,<field>代表字段,通常是指令,如User-agent、Disallow、Allow,而<value>则表示字段对应的值。

    常见字段和指令

    • User-agent: 该字段的值用于描述搜索引擎蜘蛛的名字。可以使用*表示适用于所有搜索引擎蜘蛛,也可以指定特定的搜索引擎蜘蛛名称。

    • Disallow: 该字段的值用于描述不希望被访问的一组URL。可以是完整的路径或路径的非空前缀。以Disallow的值开头的URL将不会被搜索引擎蜘蛛访问。

    • Allow: 该字段的值用于描述希望被访问的一组URL,与Disallow相似,但表示允许搜索引擎蜘蛛访问的URL。

    使用通配符

    在Robots文件中,通配符可以用来模糊匹配URL。常见的通配符包括*和,其中:

    • *匹配0或多个任意字符。
    • 匹配行结束符。

    通配符的使用可以使Robots文件更加灵活,以满足特定的需求。

    Robots文件的用法举例

    让我们通过一个实际的例子来理解Robots文件的用法:

    假设您的网站根目录下有一个名为robots.txt的文件,其内容如下:

    User-agent: *
    Disallow: /private/
    Allow: /public/

    这个Robots文件的含义是:

    • 对于所有搜索引擎蜘蛛(*表示所有),不允许访问以/private/开头的URL。
    • 允许访问以/public/开头的URL。

    这样配置后,搜索引擎蜘蛛将按照这些规则来抓取您的网站内容。

    Robots文件的误封禁与处理

    有时候,由于误操作或其他原因,可能会将Robots文件配置为封禁了搜索引擎蜘蛛的访问,导致网站的流量急剧下降。如果发生这种情况,您可以采取以下措施来处理:

    1. 修改Robots文件,将封禁改为允许。

    2. 在搜索引擎资源后台中检测并更新Robots。

    3. 提交抓取请求,触发搜索引擎蜘蛛重新访问站点。

    4. 调整抓取频次,申请增加抓取频次。

    5. 使用百度搜索资源后台的链接提交功能,设置数据API推送。

    6. 更新sitemap网站地图,重新提交给搜索引擎。

    通过以上措施,您可以逐步恢复网站的流量,并确保搜索引擎蜘蛛能够正常访问您的网站内容。

    百度搜索Robots协议的升级

    最后,需要了解的是,百度搜索Robots协议不断进行升级。最近的升级中,百度搜索Robots将优化对网站视频URL的收录抓取情况。如果您的网站包含不希望被视频搜索引擎收录的内容,才需要使用Robots.txt文件。否则,如果您希望搜索引擎收录网站上的所有内容,可以不设置Robots文件。

  • ChatGPT荣登AI网站全球流量榜首

    ChatGPT荣登AI网站全球流量榜首

    故事发生在一个不太遥远的未来,人们生活在一个充斥着人工智能的世界中。在这个世界里,AI已经不再是科幻电影中的幻想,而是融入了人们的日常生活。无论是个性化的智能助手、智能家居控制系统还是虚拟伴侣,AI已经无所不在。

    然而,在这个AI时代,有一个产品名字成为了全球范围内的热门话题,那就是ChatGPT。这款AI聊天机器人的流量已经横扫全球,成为AI网站全球流量榜的霸主。为什么ChatGPT如此受欢迎?它是如何登上AI网站流量的巅峰?让我们一探究竟。

    ChatGPT:AI网站流量的霸主

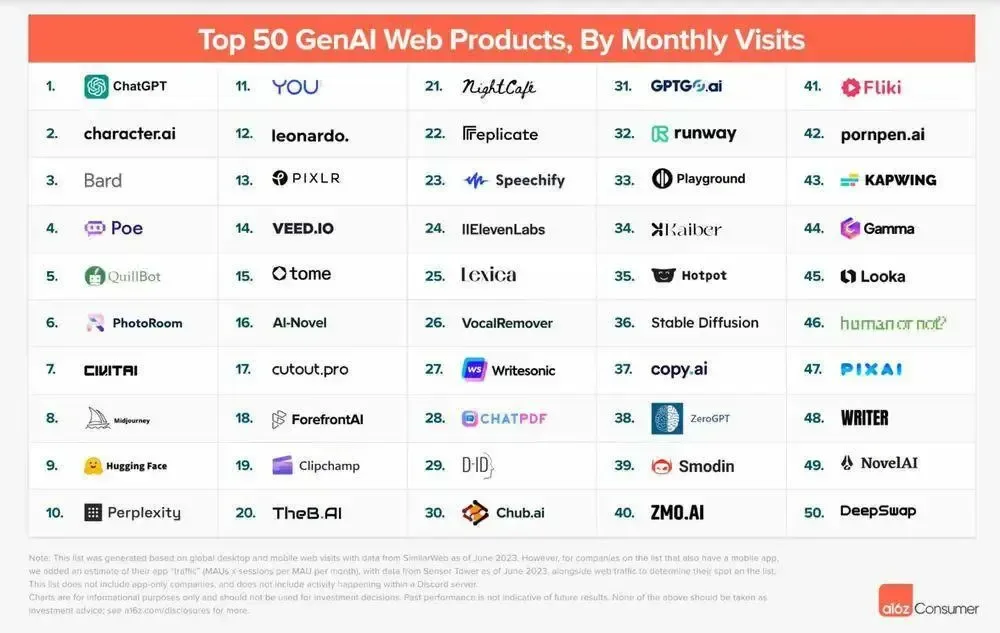
    美国知名风投公司a16z最近发布了一份引人注目的排名榜单,列出了市场上流量最高的50款面向C端用户开放的AI产品。而在这份榜单中,ChatGPT排名第一,令人瞩目的是,该产品占据了这份Top50榜单总流量的60%。

    这一消息引发了广泛的关注,不仅突显了ChatGPT的强大影响力,也反映出全球对生成式AI的巨大兴趣。那么,ChatGPT为何如此抢眼?我们可以从以下几个方面来探讨。

    1. 强大的自然语言处理能力

    ChatGPT之所以如此热门,首先要归功于它强大的自然语言处理能力。它能够理解并生成自然流畅的文本,让用户感觉在与一个真正的人进行对话。这种流畅的交流体验使得ChatGPT成为了用户们的首选,无论是用于娱乐、学习还是工作。

    2. 多领域应用的广泛性

    ChatGPT的广泛性也是其流量飙升的原因之一。它不仅能够回答各种问题,还可以应用于多个领域,如医疗、金融、教育等。这使得ChatGPT成为了解决各种问题和需求的全能工具,吸引了各种用户的青睐。

    3. 持续的优化与升级

    ChatGPT背后的团队不断努力优化和升级这一产品,使其性能不断提升。用户可以享受到更加智能、灵活的对话体验,这也是ChatGPT保持其流量第一位置的关键。

    ChatGPT之外的AI产品

    除了ChatGPT,a16z的排名榜单还揭示了其他一些备受关注的AI产品。位居次席的是Character.ai,这是一款主打个性化的AI聊天机器人,注重人格属性,可满足用户社交、情感、陪伴、支持等需求。相对于ChatGPT,Character.ai更加注重用户情感和社交需求,呈现出不同的特色。

    而第三名则被谷歌提供的Bard夺走,该产品相对于ChatGPT在成本和用户基数上更具优势。这说明在AI领域,竞争激烈,不同产品各有所长,用户有更多的选择。

    总结

    AI时代已经到来,生成式AI产品如ChatGPT在全球范围内成为了风口,吸引了众多用户的关注和使用。这不仅反映了人们对于AI技术的热切期待,也突显了ChatGPT在自然语言处理领域的强大能力和广泛应用。

    然而,除了ChatGPT,还有许多其他引人注目的AI产品,它们各具特色,满足了不同用户的需求。在AI时代,我们可以期待更多创新和突破,为我们的生活和工作带来更多便利和可能性。无论是ChatGPT还是其他AI产品,它们都在推动着人工智能技术的前进,为我们创造出更加智能和便捷的未来。

  • ChatGPT应用开发大赛:生成式AI的巅峰竞技

    ChatGPT应用开发大赛:生成式AI的巅峰竞技

    在这个数字化时代,人工智能的崛起改变了我们的生活方式和商业模式。生成式AI(AIGC)是人工智能领域的璀璨明星,其中的ChatGPT是备受瞩目的大型语言模型。近日,OpenAI举办的ChatGPT应用开发大赛吸引了226个团队的积极参与,成为业界的焦点。本文将深入探讨这场盛大活动,以及生成式AI在实际应用中的崭露头角。

    赛事背景与重要性

    故事从首尔的一家高科技公司开始,该公司的创始人兼首席执行官,David,是一个充满创意和抱负的年轻人。他一直梦想着开发一款应用程序,可以帮助自闭症患者理解和应对复杂的语言。然而,这个愿望并不容易实现。自闭症患者通常在理解象征性或比喻性语言方面面临挑战,这使得他们在日常交流和社交互动中感到困惑和孤立。David意识到,生成式AI技术可能是解决这个问题的关键。

    于是,David的团队开始研究和开发一款名为Glesom的生成式AI应用。他们利用了OpenAI的ChatGPT,通过训练和微调,使其能够识别和简化复杂的句子,以满足自闭症患者的需求。这个想法逐渐成形,然后在OpenAI举办的ChatGPT应用开发大赛中得到了展示。

    这个故事不仅展示了人工智能如何在生活中发挥积极作用,还突显了生成式AI技术的潜力。正是这种潜力吸引了来自226个团队的积极参与,为生成式AI的发展铺平了道路。

    大赛概况

    OpenAI的ChatGPT应用开发大赛是一场致力于推动生成式AI在实际应用中的发展与落地的盛会。这场比赛吸引了来自世界各地的团队,他们在一系列的挑战中竞争,旨在开发出具有实际应用价值的ChatGPT应用。

    经过多轮评选,最终有20个团队晋级到决赛阶段,其中Born to be Prompters和Team Hyper两个团队获得一等奖。这两个团队的应用备受瞩目,分别是Glesom和Jikimi。

    Born to be Prompters的Glesom应用

    Born to be Prompters团队的Glesom应用是一款令人印象深刻的生成式AI应用。它的目标是帮助自闭症患者简化复杂句子,减轻他们理解象征性或比喻性语言的困难。这个应用的潜力无疑是巨大的,因为它可以改善自闭症患者的生活质量,增强他们的社交互动能力。

    Glesom的核心技术基于ChatGPT,但通过精心的训练和微调,它能够理解和处理自闭症患者可能遇到的语言挑战。这个应用可以帮助用户解释复杂的语句,提供简明扼要的回答,使他们更容易理解和参与到对话中。这不仅有助于自闭症患者的社交互动,还为他们提供了更多的学习机会。

    Team Hyper的Jikimi应用

    Team Hyper团队开发的Jikimi应用是另一个备受关注的生成式AI应用。它的主要功能是分析电话、邮件和短信,提醒用户潜在的安全风险,从而增强用户的安全意识。在今天的数字化世界中,我们不断接收各种通信,但往往忽视了潜在的威胁。Jikimi应用的出现填补了这一空白。

    这个应用的核心是ChatGPT,它通过分析文本内容,识别可能的风险因素,并向用户发出警告。这有助于用户更加警觉地对待通信,避免落入各种陷阱。Jikimi应用的潜力不仅体现在个人安全方面,还可以在商业环境中发挥作用,帮助企业识别和应对潜在的威胁和欺诈行为。

    SKT的支持与合作

    本次大赛得到了全球最大电信公司之一SKT的支持与举办。SKT总裁兼首席执行官柳永相(Ryu Young-sang)表示,随着生成式AI技术的迅猛发展,将会有更多像ChatGPT一样卓越的产品涌现,为人类社会带来福祉。这次合作突显了SKT对生成式AI发展的信心。

    SKT的参与不仅为大赛增添了威望,还为生成式AI技术的实际应用提供了更广阔的舞台。电信行业是生成式AI的一个重要应用领域,SKT的支持将有助于促进AI技术在通信和网络领域的发展,为用户提供更好的体验和安全保障。

    大模型开发者大赛

    为了进一步推动生成式AI技术的发展,AIGC开放社区与多家大模型厂商和科技企业合作,共同发起了大模型开发者大赛。这个比赛分为两大类,即“创意”和“应用”,旨在激发大模型技术的创新和实践,推动整个行业的进步。

    不仅企业开发者、科研单位可以参加比赛,高校团队也被鼓励邀请指导老师一同参与。这种跨界合作有助于促进学术界和工业界的互动,加速人工智能领域的研究和创新。大模型的发展已经成为人工智能领域的重要趋势,这个比赛为各界提供了一个展示和交流的平台。

    总结

    OpenAI举办的ChatGPT应用开发大赛吸引了众多团队的积极参与,标志着生成式AI技术在实际应用中取得了巨大的进展,并为未来的发展奠定了坚实的基础。通过这场比赛,我们看到生成式AI技术已经不再是理论概念,而是正在成为改变我们生活的实际工具。从帮助自闭症患者到提升通信安全,生成式AI的应用前景广阔,有望为社会带来更多的创新和改善。

    生成式AI的发展不仅需要技术上的突破,还需要社会和产业的支持。SKT等企业的参与为这一领域带来了更多的机会和资源。同时,大模型开发者大赛为各界提供了合作和竞争的平台,有助于加速AI技术的进步。在未来,我们可以期待更多ChatGPT应用的涌现,为我们的生活和工作带来更多的便利和创新。

  • ChatGPT引领创业者创造1亿卢比的奇迹

    ChatGPT引领创业者创造1亿卢比的奇迹

    两位创业者Sal Aiello和Monica Power在短短几个月内,将1.5万卢比的投资转化为1亿卢比的成功,他们的秘诀竟然是利用ChatGPT创建了一款名为DimeADozen的AI工具。本文将带您深入了解他们的故事和这一令人瞩目的创新。

    ChatGPT与创业奇迹

    故事的开始并不寻常,Sal Aiello是一家科技初创公司的首席技术官,而Monica Power则是一名产品设计师兼企业家。这两位创业者在硅谷初创公司孵化器Y Combinator的虚拟初创创始人见面会上相识。但他们之间的相识只是创业旅程的开始。

    DimeADozen:AI赋能商业创意

    在寻找创新的商业创意时,Aiello和Power决定寻求人工智能的帮助。他们开发了DimeADozen,一款AI研究工具,旨在验证商业创意的可行性。这个工具的核心是ChatGPT,它允许创业者通过提交一个表单,快速生成一份详细的报告,从而帮助他们更好地理解他们的业务点子。

    DimeADozen的亮点

    DimeADozen.ai不仅仅是一个创意验证工具,它是一项可以帮助创业者做出明智决策的强大工具。以下是该工具的一些亮点:

    • 节省时间和资源: 创业者可以迅速得到关于他们的业务点子的反馈,从而避免了浪费时间和资源在不切实际的项目上。

    • 全面的指导: DimeADozen提供了关于市场研究、业务推广和资本筹集等方面的详细信息,帮助创业者在创业过程中获得成功。

    • 降低风险: 这款AI工具结合了数十年的商业经验和GPT-4的能力,为创业者提供了在创业之前更深入地了解市场和客户的机会,从而降低了新业务的风险。

    超越传统分析机构和搜索引擎

    DimeADozen的表现不仅仅令人印象深刻,更是超越了传统的分析机构和搜索引擎。这款AI工具不仅快速,而且提供了高质量的分析和反馈。这引起了人们的关注,包括一对夫妻Felipe Arosemena和Danielle de Corneille。

    一笔15000美元的交易

    Felipe Arosemena和Danielle de Corneille看到了DimeADozen的巨大潜力,并毫不犹豫地以15000美元的价格收购了这个业务。这一交易的完成意味着Arosemena和Corneille成为了这个创业公司的新老板,而Aiello和Power则继续担任公司的顾问。

    这个故事不仅是两位创业者的成功之旅,更是ChatGPT作为强大工具的典型案例。它揭示了人工智能如何赋能创业者,帮助他们将商业创意转化为现实。DimeADozen的成功也为我们展示了创新的力量,以及ChatGPT在商业领域的无限潜力。

    结语

    Sal Aiello和Monica Power的创业奇迹以ChatGPT和DimeADozen为媒介,为创业者们敞开了一扇新的大门。这个故事告诉我们,创新和技术可以创造出惊人的价值,将小额投资变成巨大回报。ChatGPT不仅仅是一款语言模型,它是创业梦想的推动力,为未来的创业者们带来了更多的希望和机会。

  • 人工智能进驾驶舱:DS Automobiles和ChatGPT的革命性合作

    人工智能进驾驶舱:DS Automobiles和ChatGPT的革命性合作

    有没有想过在驾驶中询问一个问题,听一段儿童故事,或者让你的车辆变成一个智能旅行助手?Stellantis旗下的DS Automobiles正在为欧洲的车主们提供这一机会,通过与OpenAI的ChatGPT合作,他们正引领着车载人工智能的未来。

    DS Iris系统:不仅仅是一款信息娱乐系统

    DS Automobiles的DS Iris系统一直以来都是一款出色的信息娱乐系统,为驾驶员和乘客提供了多媒体娱乐和导航功能。然而,现在,DS Iris系统将不再仅仅是一个信息娱乐系统,而是一款知识型数字助手。这一革命性的改进是与OpenAI的ChatGPT人工智能服务合作的结果。

    开启对话体验

    DS Iris系统的最新升级使驾驶员能够与车辆建立对话。这一功能不仅可以通过声控系统激活,还可以远程启动,适用于2万名特定DS车型的车主。驾驶员只需说出“OK,Iris”或按一下方向盘上的按钮,语音控制系统就会启动。

    从儿童故事到旅行助手

    DS Iris与ChatGPT的整合不仅提供了语音识别功能,还为驾驶员和乘客提供了多种交互功能。驾驶员可以提出各种问题,发出请求,甚至让车辆讲儿童故事,而无需将目光从道路上移开。这一功能的引入为出行增添了高科技的元素,使驾驶变得更加便捷和愉快。

    Dare Forward 2030战略的一部分

    这一创新举措与Stellantis的战略重点和Dare Forward 2030战略一致。Stellantis首席软件官员Yves Bonnefont表示,自ChatGPT推出以来,他们一直在努力将其整合到他们的系统中。这一合作将为DS Automobiles带来更多的竞争力,使他们的车型在市场上脱颖而出。

    DS Automobiles在欧洲市场的推出

    DS Automobiles的DS Iris系统与ChatGPT的整合将首次在法国、德国、英国、西班牙和意大利上市。这意味着成千上万的DS车主将能够体验到这一革命性的车载人工智能技术。而最令人兴奋的是,初次订阅者可以免费使用这一功能,为他们的出行增添更多的乐趣。

    ChatGPT的应用:梅赛德斯奔驰的尝试

    除了DS Automobiles,梅赛德斯奔驰也在美国进行了与微软合作的车载ChatGPT人工智能测试。这一趋势表明,汽车制造商越来越看重人工智能技术在提升驾驶体验中的潜力,而ChatGPT正是这一领域的领先力量之一。

    结语

    DS Automobiles和ChatGPT的合作将改变驾驶体验的方式,使车辆不仅仅是交通工具,还是智能助手。这一创新不仅提升了安全性,还为驾驶员和乘客提供了更多的便利和娱乐选项。随着这一技术的在欧洲市场的推广,我们可以期待看到更多的汽车制造商将人工智能引入驾驶舱,为未来的出行带来更多的惊喜和便捷。

  • ChatGPT参数量曝光:20B真相何在?

    ChatGPT参数量曝光:20B真相何在?

    曾经,ChatGPT是个神秘的存在,像是装在宝箱里的珍宝,无人知晓其真正的内在。然而,昨天晚上,一篇EMNLP论文和其中的截图,突然揭开了ChatGPT的神秘面纱,这个曾经的宝箱变得千疮百孔。

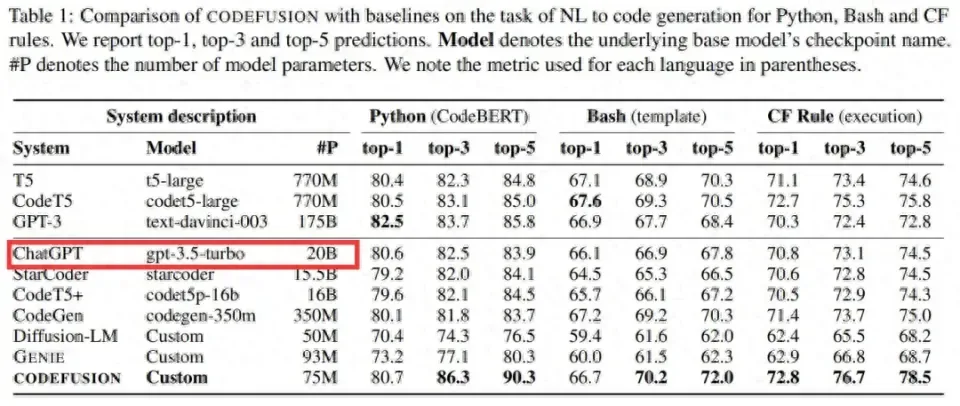
    微软的一篇名为《CodeFusion: A Pre-trained Diffusion Model for Code Generation》的论文,在做对比的时候,无意中透露出了一个令人震惊的消息:ChatGPT仅仅有20B(200亿)的参数量。这个消息引起了广泛的关注和讨论,大家都在想,这合理吗?

    ChatGPT:参数量之谜

    ChatGPT发布已经将近一年,但OpenAI一直对其技术细节保持缄默。由于其出色的性能,人们对ChatGPT的参数量、训练数据等一直充满了好奇和猜测。

    作为一款备受瞩目的大型语言模型,ChatGPT在解决各种问题上表现出色。其前身GPT-3的参数量已经达到了1750亿,而ChatGPT却只有20B,这合理吗?

    这个问题引发了热烈的讨论,人们纷纷在知乎和Twitter上表达了自己的观点。毕竟,拥有200亿参数的模型能够取得如此出色的效果,令人惊叹不已。而且,国内外的大模型通常都以数百亿、上千亿的参数量为特点。

    参数量的真相

    但是,这个20B的参数量是否真实可信呢?大家都有不同的看法。有人认为这个数据是可信的,因为微软和OpenAI一直是合作伙伴,并且这篇论文是在2023年的EMNLP上发表的,因此很可能是真实的。

    然而,也有人怀疑这个数据可能是个拼写错误,或者是有意误导。因为与GPT-3的参数量相比,20B显得太过微小。有人甚至认为实际参数量可能是120B,至少和GPT-3(175B)是一个数量级的。

    从价格上分析

    另一方面,有人从ChatGPT的API定价出发进行了分析,认为20B的参数量是可信的。ChatGPT的API价格仅为0.002美元/1000个token,相比于GPT-3.5的1/10。这个价格反映出了ChatGPT的规模较小,因此20B的参数量可能是符合实际的。

    ChatGPT的未来

    ChatGPT的参数量是否真的只有20B,仍然是一个未解之谜。但无论如何,ChatGPT作为一款出色的大型语言模型,已经在各个领域取得了不小的成功。它的出现改变了人们对大型语言模型的认知,也引发了更多关于模型规模和性能的讨论。

    未来,大型语言模型的改进方向将是增加参数量吗?或者是通过增加训练数据和其他技术手段来提高性能?这些问题仍然值得深入探讨。

    在不久的将来,OpenAI的开发者大会将举行,或许我们将有机会了解更多关于ChatGPT和大型语言模型的有用信息。让我们拭目以待,继续关注这个引领人工智能领域发展的重要话题。

    (注:以上内容仅为猜测和观点,实际参数量尚未得到官方确认。)