
Tag: Python

  • 控制 Windows 窗口程序和获取对应数据的方法

    控制 Windows 窗口程序和获取对应数据的方法

    在数字化时代,我们经常需要与各种窗口应用程序交互,但有时候这些程序并没有提供便捷的接口或者已经停止了维护和开发。在这种情况下,我们仍然可以通过编程的方式来控制这些窗口程序并获取需要的数据。本文将介绍如何使用Golang或Python来实现这一目标。

    步骤 1:准备工作

    在开始之前,您需要做一些准备工作:

    1. 选择编程语言:作者提到了Golang和Python作为优选的编程语言,但其他语言也可以用于此目的。我们将使用Python来进行示范。

    2. 了解目标窗口:首先,您需要详细了解目标窗口的界面和控件,包括窗口标题、类名以及各个控件的位置和标识符。

    步骤 2:找到目标窗口

    要控制一个窗口程序,首先需要找到它的窗口句柄。可以使用FindWindow函数,传入窗口的标题和类名来查找。

    import win32gui
    
    window_title = "目标窗口标题"
    window_class = "目标窗口类名"
    
    hwnd = win32gui.FindWindow(window_class, window_title)

    步骤 3:控制窗口中的控件

    一旦找到了目标窗口的句柄,就可以开始控制窗口中的各个控件。以下是一些示例操作:

    • 选择列表项:如果窗口中有一个列表框,您可以使用SendMessage函数来选择其中的一个项。
    import win32gui
    import win32con
    
    listbox_hwnd = win32gui.FindWindowEx(hwnd, 0, "ListBox", None)
    index_to_select = 0  # 要选择的项的索引
    
    win32gui.SendMessage(listbox_hwnd, win32con.LB_SETCURSEL, index_to_select, 0)
    • 点击按钮:对于按钮控件,您可以模拟点击事件。
    button_hwnd = win32gui.FindWindowEx(hwnd, 0, "Button", None)
    
    # 模拟点击按钮
    win32gui.PostMessage(button_hwnd, win32con.WM_LBUTTONDOWN, 0, 0)
    win32gui.PostMessage(button_hwnd, win32con.WM_LBUTTONUP, 0, 0)
    • 下拉菜单操作:如果窗口中有下拉菜单,您可以使用SendMessage函数来选择菜单项。
    combo_box_hwnd = win32gui.FindWindowEx(hwnd, 0, "ComboBox", None)
    item_to_select = "要选择的菜单项文本"
    
    # 选择包含指定文本的菜单项
    win32gui.SendMessage(combo_box_hwnd, win32con.CB_SELECTSTRING, -1, item_to_select)
    • 获取数据:最后,要获取窗口中的数据,您可以使用GetWindowText函数。
    label_hwnd = win32gui.FindWindowEx(hwnd, 0, "Static", None)
    
    # 获取标签控件的文本
    text = win32gui.GetWindowText(label_hwnd)

    步骤 4:总结

    通过以上步骤,您可以控制Windows窗口程序并获取所需的数据。请注意,这种方法可能需要根据目标窗口的具体情况进行调整和扩展,但基本原理是相似的。

    不管您选择使用Golang还是Python,都需要使用Windows API函数来实现这些操作。请确保在使用之前详细了解这些函数的文档和用法。
  • Eureka:通过编码大型语言模型实现人类水平的奖励设计

    Eureka:通过编码大型语言模型实现人类水平的奖励设计

    在现代科技领域,人工智能(AI)正日益成为不可或缺的一部分。AI不仅在自动化任务中表现出色,还在解决复杂问题方面展现出巨大潜力。但是,将AI应用于一些低级操作任务,如熟练旋转笔尖,似乎是一个不可逾越的挑战。这些任务需要高度的协调和技巧,通常需要人类多年的训练和练习才能精通。

    Eureka:通过编码大型语言模型实现人类水平的奖励设计 Eureka:通过编码大型语言模型实现人类水平的奖励设计

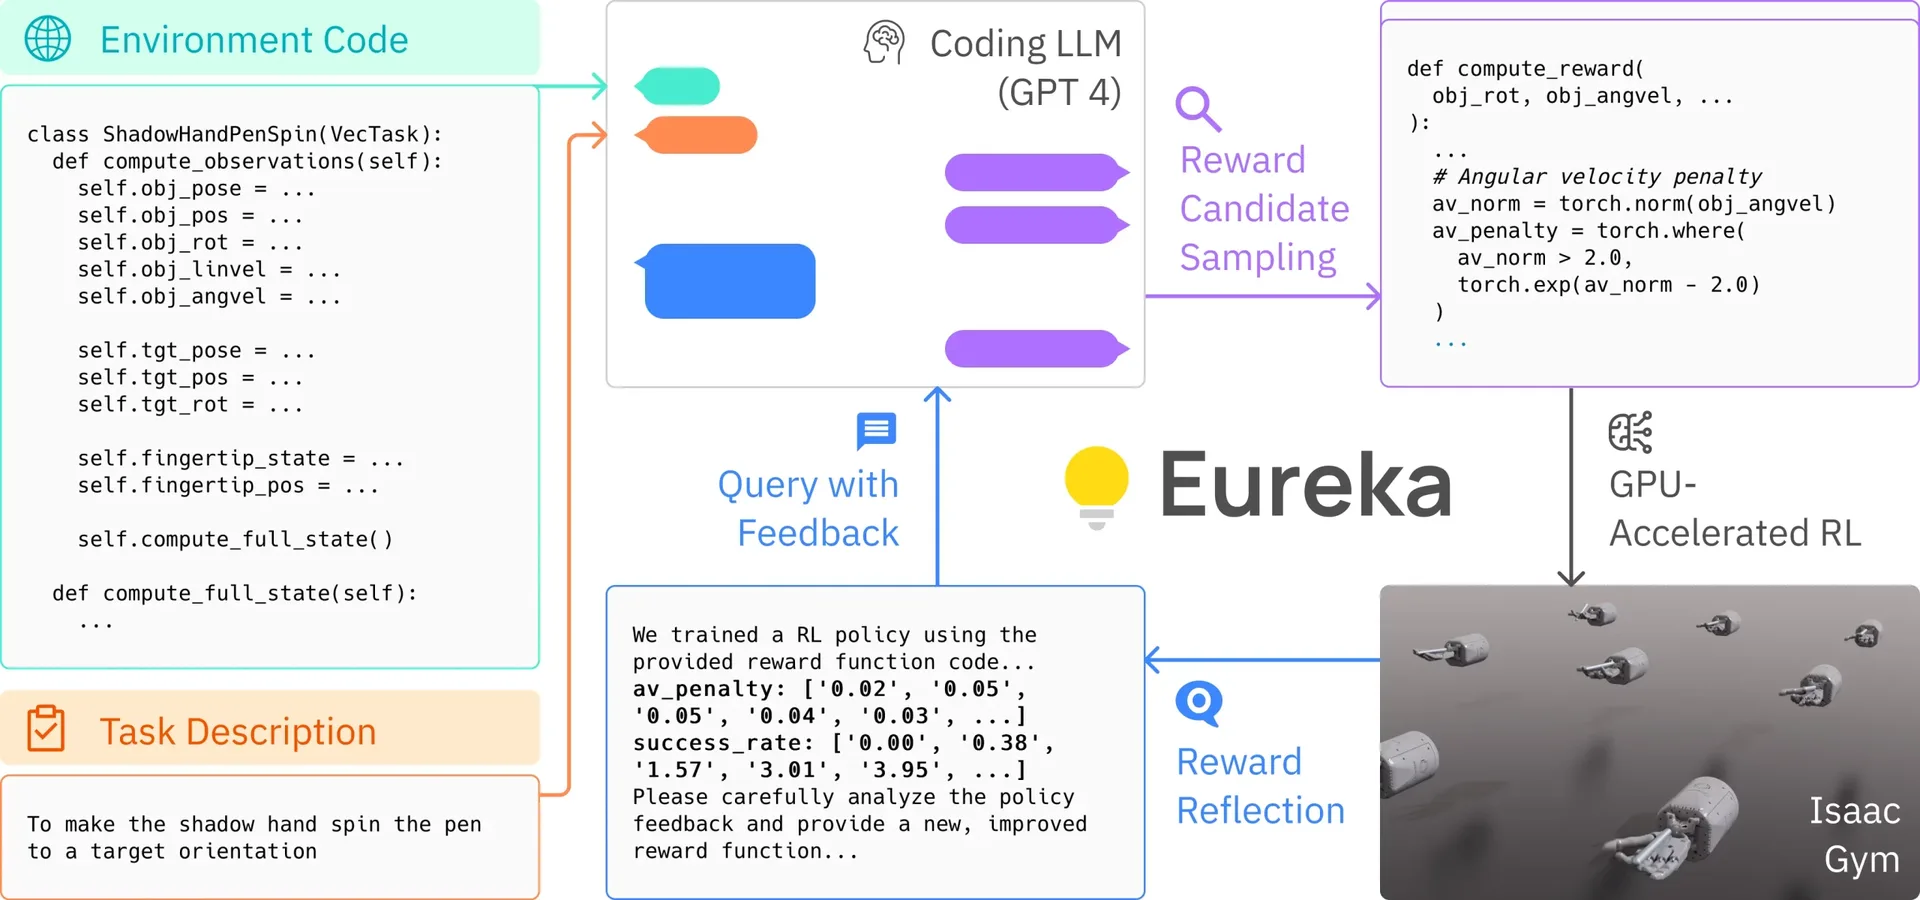
    然而,Eureka项目的诞生改变了这一格局。Eureka是一个由大型语言模型(LLMs)支持的奖励设计算法,旨在使AI达到人类水平的技能。该项目利用了最先进的LLMs(如GPT-4)的出色能力,包括零次生成、代码编写和上下文改进,以进行奖励代码的上下文进化优化。这些生成的奖励可用于通过强化学习让AI获取复杂的技能。

    在Eureka的帮助下,AI能够在不需要任务特定提示或预定义奖励模板的情况下超越专家人工设计的奖励。这一技术突破使得AI在各种任务上表现出色,包括在多种机器人形态下的29个强化学习环境中,Eureka在83%的任务上胜过了人类专家,平均标准化提高率达到52%。同时,Eureka还为人类反馈的强化学习提供了一种新的无梯度方法,以提高生成的奖励的质量和安全性。

    本教程将深入介绍Eureka项目,包括安装、使用指南以及如何在新环境上运行Eureka。如果您有兴趣在强化学习中与AI合作,或者只是想进行一些有趣的尝试,Eureka将为您提供支持,并为您打开广阔的应用前景。

    安装Eureka

    首先,让我们了解如何安装Eureka项目。以下是安装步骤:

    1. 创建一个新的conda环境:

      conda create -n eureka python=3.8
      conda activate eureka
    2. 安装IsaacGym(测试版本为Preview Release 4/4):

      tar -xvf IsaacGym_Preview_4_Package.tar.gz
      cd isaacgym/python
      pip install -e .

      测试安装:

      python examples/joint_monkey.py
    3. 安装Eureka:

      git clone https://github.com/eureka-labs/Eureka.git
      cd Eureka; pip install -e .
      cd isaacgymenvs; pip install -e .
      cd ../rl_games; pip install -e .
    4. Eureka目前使用OpenAI API进行语言模型查询,因此您需要拥有一个OpenAI API密钥。在终端中设置环境变量:

      export OPENAI_API_KEY="YOUR_API_KEY"

    入门指南

    现在,让我们来了解如何使用Eureka。进入eureka目录并运行以下命令:

    python eureka.py env={environment} iteration={num_iterations} sample={num_samples}
    • environment是要执行的任务,选项列在eureka/cfg/env中。
    • num_samples是每次迭代生成的奖励样本数量,默认值为16。
    • num_iterations是要运行的Eureka迭代次数,默认值为5。

    以下是一些尝试Eureka的示例命令:

    python eureka.py env=shadow_hand sample=4 iteration=2 model=gpt-4-0314
    python eureka.py env=humanoid sample=16 iteration=5 model=gpt-3.5-turbo-16k-0613

    每次运行都会在eureka/outputs中创建一个时间戳文件夹,保存Eureka日志以及所有中间奖励函数和关联策略。

    Eureka旋转笔尖演示

    Eureka项目还提供了一个有趣的演示,即旋转笔尖策略。您可以使用以下命令来可视化它:

    cd isaacgymenvs/isaacgymenvs
    python train.py test=True headless=False force_render=True task=ShadowHandSpin checkpoint=checkpoints/EurekaPenSpinning.pth

    在新环境上运行Eureka

    如果您希望在新的环境中运行Eureka,以下是相应的步骤:

    1. 创建一个新的IsaacGym环境,详细说明可以在这里找到。

    2. 验证标准强化学习是否适用于新环境:

      cd isaacgymenvs/isaacgymenvs
      python train.py task=YOUR_NEW_TASK
    3. 在eureka/cfg/env中创建一个新的yaml文件,例如your_new_task.yaml:

      env_name: your_new_task
      task: YOUR_NEW_TASK 
      description: ...
    4. 构建原始环境代码,将用作Eureka上下文的环境代码,以及将Eureka奖励附加到的骨架环境代码:

      cd eureka/utils
      python prune_env.py your_new_task
    5. 尝试Eureka!

      python eureka.py env=your_new_task

    鸣谢与许可证

    Eureka项目受益于多个开源项目的支持,包括IsaacGym和DexterousHands等。此项目根据MIT许可证发布。

    结语

    Eureka项目为将AI应用于复杂任务提供了崭新的可能性。通过大型语言模型的支持,Eureka能够设计出优秀的奖励函数,让AI在各种任务中表现出色。无论您是想与AI合作还是进行有趣的尝试,Eureka都是一个强大的工具,具有广泛的应用前景。不要犹豫,立即尝试Eureka吧!

  • Mojo安装教程:适用于Intel Mac、M1 Mac和Ubuntu

    Mojo安装教程:适用于Intel Mac、M1 Mac和Ubuntu

    大家好,我是王大神。今天,我将为你提供一篇关于安装Mojo的详细教程。Mojo是一门新兴的编程语言,被誉为Python的升级版,由Swift的创始人Chris Lattner开发。本教程将覆盖Intel Mac、M1 Mac和Ubuntu的安装步骤,同时包括VSCode和Mojo插件的配置。让我们一起来解决这个问题吧!

    开篇故事

    在编程领域,时常涌现出新的编程语言,它们为开发者提供了更多的选择。Mojo是其中之一,被誉为Python的进化版,由Chris Lattner亲自打造。Mojo的发展势头迅猛,已经发布了0.4版本,许多人认为它将与Python长期互补和协同发展。所以,如果你想要探索新的编程语言,Mojo绝对值得关注和学习。

    安装Mojo:M1 Mac

    如果你是M1 Mac用户,以下是安装Mojo的避坑指南:

    1. 官方支持:首先,要感谢Mojo官方支持M1 Mac安装。然而,在安装过程中,仍然可能会遇到一些小坑。本教程将帮助你克服这些障碍。

    安装Mojo:Intel Mac和Ubuntu

    对于Intel Mac和Ubuntu用户,以下是安装Mojo的步骤:

    1. Intel Mac安装Mojo:如果你使用Intel Mac,你可以按照本教程中提供的步骤进行Mojo的安装。这将帮助你快速搭建Mojo开发环境。

    可选的Mojo安装方案

    Mojo的安装可以根据你的需求采用不同的方式:

    1. 使用orbstack + Ubuntu虚拟机:你可以选择使用Ubuntu 20.04.6 LTS虚拟机,配合VSCode和Mojo插件,来搭建Mojo开发环境。

    2. 使用orbstack + Ubuntu 22.04 Docker容器:另一种选择是使用Ubuntu 22.04的Docker容器,再结合VSCode、Mojo插件以及dev containers插件。这是一个强大的开发环境配置。

    3. 使用官方提供的Docker镜像:Mojo官方提供了打包好的Docker镜像,你可以与VSCode和dev containers插件一起使用,实现类似的开发环境。

    注意事项:适用于Ubuntu 20

    需要注意的是,本教程也适用于Ubuntu 20的安装,但不建议使用Debian、CentOS等其他发行版,因为这些发行版可能会导致许多错误,解决这些错误会浪费时间并且没有必要。

    安装Mojo:Windows用户

    如果你是Windows用户,可以考虑基于WSL(Windows Subsystem for Linux)和Ubuntu的安装方案,步骤与Intel Mac类似。

    结语

    Mojo是一个备受关注的新兴编程语言,有着与Python不同的特性和优势。通过本教程,你可以轻松安装Mojo,并开始探索这门语言的潜力。无论你是Intel Mac、M1 Mac还是Ubuntu用户,都可以按照本教程的步骤来安装Mojo,为未来的编程之旅做好准备。

    希望这篇教程对你有所帮助。如果你有任何问题或建议,欢迎在评论中留言。愿你享受在Mojo的编程世界中的探索之旅!

  • Python项目的版本兼容性与依赖管理:解决困扰开发者的难题

    Python项目的版本兼容性与依赖管理:解决困扰开发者的难题

    大家好,我是王大神。今天,我要和大家探讨两个在Python项目开发中经常令人困惑的问题:Python版本的兼容性和依赖管理。这两个问题可能让你在尝试运行Python项目时感到头痛,但我将为你提供解决方案和建议。

    开篇故事

    在编程世界中,我们常常需要应对版本兼容性和依赖管理的挑战。正如你在社交媒体上提到的那样,很多Python项目似乎没有明确说明需要在哪个Python版本下运行,而且依赖管理也有时显得混乱。这两个问题让你感到困扰,但幸运的是,有方法可以帮助你解决它们。

    Python项目的版本兼容性

    问题1:版本不兼容

    你提到了一些Python项目没有明确指定所需的Python版本,这确实可能导致问题。不同版本的Python可能具有不同的语法和API,因此在不同版本下运行相同的代码可能会出现错误。这是一个合理的担忧,但并不是所有Python项目都如此。

    解决方案1:文档和注释

    大多数现代Python项目都会在其文档或代码注释中明确指定所需的Python版本。这可以帮助开发者知道项目适用于哪些Python版本。因此,阅读项目的文档和代码注释是一个好的习惯。

    解决方案2:使用虚拟环境

    如果项目没有明确指定Python版本,你可以使用虚拟环境来创建一个特定版本的Python环境,以确保项目在该环境下运行。你可以使用工具如virtualenv或conda来管理虚拟环境。

    解决方案3:查看项目文件

    有时,项目会包含一个名为runtime.txt或pyproject.toml的文件,其中记录了所需的Python版本。这些文件可能位于项目的根目录中。

    Python项目的依赖管理

    问题2:依赖管理混乱

    你还提到了一些Python项目使用requirements.txt来管理依赖,但也有一些项目根本没有这个文件。这确实可能导致依赖管理的混乱。

    解决方案1:使用requirements.txt

    requirements.txt是一种常见的依赖管理方式,尤其适用于较老的项目。你可以在项目根目录中查找此文件,以了解项目所需的依赖。

    解决方案2:新一代依赖管理工具

    除了requirements.txt,还有一些新一代的依赖管理工具,如pipenv和poetry。它们提供了更强大和易于使用的依赖管理功能,包括指定Python版本和管理依赖的版本范围。

    解决方案3:使用Docker

    在某些情况下,你可以考虑使用Docker来创建容器化的项目环境。Docker容器可以包含项目的所有依赖项,从而消除了版本冲突的问题。

    结语

    Python项目的版本兼容性和依赖管理问题确实可能令人困扰,但并非没有解决方法。通过阅读文档和注释,使用虚拟环境,查看项目文件,以及使用新一代依赖管理工具,你可以更轻松地管理Python项目的环境和依赖。

    希望这篇文章对解决Python项目中的版本和依赖问题有所帮助。无论你遇到什么问题,记住,Python社区充满了资源和支持,你不必独自面对挑战。

  • 解决Python版本兼容性问题:Pybind11封装Python接口的高级指南

    解决Python版本兼容性问题:Pybind11封装Python接口的高级指南

    大家好,我是王大神。今天,我要和大家分享一个有关Pybind11封装Python接口的挑战:Python版本的兼容性。如果你曾经在使用Pybind11进行封装时遇到过只能在特定Python版本下运行的问题,那么这篇文章将为你提供解决方案。

    开篇故事

    在编程的道路上,我们常常需要面对各种挑战和困难。最近,我在封装Python接口时遇到了一个问题,这个问题也困扰着许多开发者。问题是,当我使用Python环境为3.7时,封装后的pyd库只能在3.7的Python解释器下运行,而在3.8或其他版本下导入时会报DLL错误。这个问题让我不得不深入研究如何解决Python版本不兼容的困扰。

    Python封装和版本兼容性

    在使用Pybind11进行Python封装时,版本兼容性是一个常见但具有挑战性的问题。不同版本的Python可能会有不同的API和二进制兼容性,这导致了封装后的库在不同Python版本下无法正常运行。

    解决方案1:单独编译

    一种解决方法是为每个目标Python版本单独编译封装库。这意味着你需要为3.7、3.8、以及其他你想支持的版本分别构建库文件。虽然这可以解决兼容性问题,但维护多个版本的库可能会变得复杂。

    解决方案2:预编译Wheel包

    另一种方法是预先编译好所有期望平台和版本的Wheel包。这种方法可以让用户直接安装已编译好的库,而不需要进行编译。这对于提高用户友好性非常有帮助。

    解决方案3:使用Python C接口

    如果你不想为不同版本编译多个库,你还可以考虑使用Python的C接口。有一套被称为Python Limited API的接口可以在不同大版本之间通用,尽管它可能会缺少一些新功能。但是,这种方法会更加复杂和麻烦,不适用于所有情况。

    解决方案4:使用ctypes或cffi

    如果你的接口交互相对简单,你可以考虑使用ctypes或cffi来调用C接口。这样,你可以将C接口暴露为共享库(.so)并在Python中使用它。这是一种简单而有效的方法,尤其适用于简单的接口。

    结语

    Python版本兼容性是Pybind11封装Python接口时的一个挑战,但有多种解决方法可供选择。你可以选择单独编译,预编译Wheel包,使用Python C接口,或者使用ctypes或cffi,具体取决于你的项目需求和偏好。

    希望这篇文章对解决Python版本兼容性问题有所帮助。无论你选择哪种方法,都要确保你的库能够在多个Python版本下顺利运行,以提供更好的用户体验。

  • Python编程的精华:值得关注的项目和编程风格指南

    Python编程的精华:值得关注的项目和编程风格指南

    Python,这门简洁而强大的编程语言,一直以来都备受程序员的喜爱。无论是用于数据分析、Web开发、自然语言处理还是其他领域,Python都有着广泛的应用。在本文中,我们将介绍一些值得关注的Python项目以及编程风格指南,帮助你更好地掌握这门语言。

    项目:Python生态系统的明星

    1. PyPy

    PyPy是Python的一个高性能实现,它通过即时编译技术提供了比标准CPython更快的执行速度。如果你追求Python代码的性能,PyPy绝对值得一试。

    2. Celery

    Celery是一个分布式任务队列库,它让异步任务处理变得容易。无论是在Web应用中处理后台任务还是构建分布式系统,Celery都是一个强大的工具。

    3. Jinja2

    Jinja2是一个现代的、高性能的模板引擎,广泛用于Web开发中。它的语法清晰简单,支持模板继承和条件渲染,是许多Web框架的首选。

    4. Read the Docs

    Read the Docs是一个开源文档托管平台,它为项目提供了自动生成和托管文档的能力。无论你是开源项目的维护者还是用户,Read the Docs都能提供便捷的文档管理。

    5. gevent

    gevent是一个基于协程的网络库,它使得编写异步、高并发的网络应用变得更加容易。如果你需要构建高性能的网络应用,不妨考虑使用gevent。

    6. pyenv

    pyenv是一个Python版本管理工具,它允许你在同一台计算机上管理多个Python版本。这对于开发人员来说非常方便,可以确保不同项目使用的Python版本不冲突。

    7. virtualenv

    virtualenv是一个虚拟环境管理工具,它允许你在同一系统上创建多个隔离的Python环境。这对于项目之间的依赖管理非常有帮助,可以确保不同项目的依赖不冲突。

    8. Stackless Python

    Stackless Python是一个Python变体,它支持更轻量级的线程,使得并发编程更容易。如果你关注多线程编程,Stackless Python可能是一个有趣的选择。

    9. Beautiful Soup

    Beautiful Soup是一个用于解析HTML和XML文档的库,它让网页数据抓取和处理变得更加简单。如果你需要从网页中提取数据,Beautiful Soup是一个强大的工具。

    10. 结巴中文分词

    结巴中文分词是一个流行的中文分词库,用于将中文文本分割成词语。它在自然语言处理领域有着广泛的应用,可以帮助你处理中文文本数据。

    11. Green Unicorn

    Green Unicorn(简称Gunicorn)是一个Python WSGI HTTP服务器,它适用于部署Web应用。Gunicorn具有高性能和稳定性,是许多Web开发者的选择。

    12. Sentry

    Sentry是一个开源的错误追踪工具,它可以帮助你监控和调试生产环境中的错误。无论你是开发人员还是系统管理员,Sentry都是一个有力的工具。

    13. Shovel

    Shovel是一个简单而强大的任务队列库,它基于RabbitMQ。如果你需要处理异步任务,Shovel是一个不错的选择。

    14. Pyflakes

    Pyflakes是一个静态代码分析工具,它用于检查Python代码中的语法错误和潜在的问题。它可以帮助你提高代码质量和可维护性。

    15. pytest

    pytest是一个功能强大的测试框架,它使得编写和运行Python测试变得更加简单。无论你是写单元测试还是集成测试,pytest都是一个出色的选择。

    编程风格指南:写出优雅的Python代码

    除了关注这些优秀的Python项目,编写干净、可读、高效的代码也是至关重要的。以下是一些Python编程风格指南,帮助你在代码中遵循最佳实践:

    1. PEP 8

    PEP 8是Python Enhancement Proposal的缩写,它是Python官方的代码风格指南。遵循PEP 8可以使你的代码具有一致的风格,更容易被其他开发者理解和维护。

    2. Google Python Style Guide

    Google Python Style Guide是Google内部使用的Python代码风格指南,它包含了许多实用的建议和最佳实践。即使你不在Google工作,也可以从中受益。

    3. Code Style from The Hitch

    “The Hitchhiker’s Guide to Python”是一本Python开发的经典指南,它包含了丰富的编码和项目组织建议。这本指南是Python社区的宝藏之一。

    结语

    Python的强大在于它的生态系统和丰富的库,以及编写高质量代码的能力。无论你是一名Python初学者还是经验丰富的开发者,这些项目和编程风格指南都将有助于你更好地掌握这门语言。

  • 2023年10月Python库推荐:助你编程事半功倍

    2023年10月Python库推荐:助你编程事半功倍

    Python,这门炙手可热的编程语言,如今已经成为了众多开发者的首选。它的简洁性、可读性以及丰富的库生态系统,使得Python在各个领域都有着广泛的应用。然而,随着时间的推移,Python库也不断涌现,让人眼花缭乱。在这篇文章中,我们将探讨截止到2023年10月,哪些Python库值得推荐,以助你在编程的道路上事半功倍。

    Python:大家的共识

    首先,让我们明确一点,Python作为一门多用途的编程语言,它的魅力在于其适用于各种不同的领域。因此,我们将从多个领域中挑选出一些最受欢迎和最有用的Python库。无论你是数据科学家、Web开发者、机器学习工程师还是网络爬虫专家,这篇文章都将为你提供一些有用的建议。

    数据科学和机器学习领域

    1. NumPy

    在数据科学领域,NumPy是一项不可或缺的库。它提供了高性能的多维数组对象,以及用于处理这些数组的各种工具。NumPy是许多其他数据科学库的基础,如Pandas和SciPy。

    2. Pandas

    如果你需要进行数据处理和分析,Pandas是你的得力助手。它提供了灵活的数据结构,如DataFrame,使数据清洗和转换变得更加容易。无论是数据的载入、清理、筛选还是分组,Pandas都能轻松胜任。

    3. Matplotlib 和 Seaborn

    可视化是数据科学的重要组成部分,Matplotlib和Seaborn是两个出色的库。Matplotlib提供了广泛的绘图选项,而Seaborn则让统计数据可视化变得更加简单。

    4. Scikit-learn

    如果你涉足机器学习领域,Scikit-learn是一个不可或缺的工具。它提供了各种机器学习算法,包括分类、回归、聚类等,以及用于模型评估和选择的工具。

    Web开发领域

    5. Flask 和 Django

    对于Web开发,Flask和Django都是极为受欢迎的框架。Flask简洁而轻量,适合小型项目和快速原型开发。而Django则提供了强大的功能集,适用于大型Web应用的开发。

    6. SQLAlchemy

    无论你选择Flask还是Django,数据库都是一个关键组成部分。SQLAlchemy是一个强大的SQL工具包,它为Python开发人员提供了灵活的数据库访问功能。

    7. FastAPI

    FastAPI是一个新兴的Web框架,它基于Python 3.6+的类型提示,让你能够快速构建高性能的API。它的速度和易用性使其在Web开发社区中备受瞩目。

    自然语言处理领域

    8. NLTK 和 SpaCy

    自然语言处理是一个令人兴奋的领域,NLTK和SpaCy都是用于文本处理和分析的重要工具。NLTK提供了大量的自然语言处理功能,而SpaCy则以其速度和简单性而著称。

    网络爬虫领域

    9. Scrapy

    如果你需要从网站上爬取数据,Scrapy是一个强大的网络爬虫框架。它提供了灵活的配置选项和高性能的抓取功能,让你可以轻松地构建爬虫应用。

    网络请求领域

    10. HTTPx

    HTTPx是一个优秀的HTTP客户端库,特别是在异步编程方面表现出色。它的性能和功能使其成为处理HTTP请求的首选工具。

    这些只是冰山一角,Python库的选择取决于你的具体需求和项目。无论你是一名新手还是一名经验丰富的开发者,都可以在Python库的世界中找到适合自己的工具。

    结语

    Python是一门多才多艺的编程语言,它的库生态系统丰富多彩,满足了各种领域的需求。在2023年10月,我们为你推荐了一些在数据科学、Web开发、自然语言处理、网络爬虫等领域中备受欢迎的Python库。希望这些推荐能够助你在编程之路上取得更大的成功。

  • 教程:如何管理和下载大量的二进制文件存储在HDF5中

    教程:如何管理和下载大量的二进制文件存储在HDF5中

    在今天的数字化时代,我们经常需要处理大量的二进制文件,尤其是在科学计算和数据分析领域。有时,我们需要将这些文件存储在一起,并能够在需要时方便地管理和下载其中的一部分数据。本教程将介绍如何使用HDF5(层次数据格式第五版)来有效地管理大量的二进制文件,并实现根据需求部分下载数据的功能。

    什么是HDF5?

    HDF5,全称为Hierarchical Data Format version 5,是一种灵活的文件格式和数据模型,用于存储和组织大量的科学数据。它具有多层次的数据结构,支持元数据和数据的组织,适用于各种类型的数据,包括多维数组、图像、文本和二进制文件。

    HDF5的一个关键特性是它支持多种数据压缩和分块存储技术,这使得它成为管理和存储大量二进制文件的理想选择。

    业务场景

    假设你的业务需要将大量的二进制文件存储在云端,这些文件是由计算任务的求解器生成的。每个任务的计算结果可能包含多个二进制文件,这些文件需要被集中管理,同时,你也希望能够根据需要只下载其中的一部分数据,而不必下载整个文件。你的云存储解决方案是腾讯云对象存储(COS)。

    使用HDF5管理和下载二进制文件

    以下是如何使用HDF5来管理和下载大量二进制文件的步骤:

    步骤1:安装HDF5库

    首先,你需要安装HDF5库。你可以使用常见的Python库如h5py或PyTables来与HDF5文件进行交互。安装这些库通常只需要几个简单的命令。

    pip install h5py

    步骤2:创建HDF5文件

    使用HDF5库创建一个新的HDF5文件,这个文件将用于存储二进制文件和相关的元数据。

    import h5py
    
    # 创建一个HDF5文件
    file = h5py.File('my_data.h5', 'w')

    步骤3:存储二进制文件和元数据

    将每个计算任务生成的二进制文件存储在HDF5文件中,并记录相关的元数据,如文件名、大小和其他信息。你可以使用HDF5的数据集(Dataset)来存储二进制数据。

    # 存储二进制文件
    binary_data = b'Your binary data here'
    file.create_dataset('task1/file1.bin', data=binary_data)
    
    # 记录元数据
    file['task1/file1.bin'].attrs['filename'] = 'file1.bin'
    file['task1/file1.bin'].attrs['size'] = len(binary_data)

    步骤4:部分下载数据

    要实现根据需要部分下载数据,你可以使用HDF5的分片(Chunking)和压缩功能。首先,将二进制文件分成较小的块(chunk),然后根据需要只下载所需的块。

    # 创建一个数据集并启用分片和压缩
    dset = file.create_dataset('task1/file1.bin', shape=(data_size,), dtype='int16', chunks=(chunk_size,), compression='gzip')
    
    # 下载所需的数据块
    start_index = 0
    end_index = 1000
    data_slice = dset[start_index:end_index]

    步骤5:关闭HDF5文件

    在完成所有操作后,记得关闭HDF5文件以确保数据的完整性。

    file.close()

    结语

    使用HDF5来管理和下载大量二进制文件是一种高效的方法,特别适用于需要存储和处理科学计算和数据分析结果的业务场景。通过合理使用HDF5的分片和压缩功能,你可以实现根据需求部分下载数据,而不必下载整个文件,从而节省时间和带宽。

    希望这个教程对你有所帮助,让你更好地管理和利用大量的二进制文件数据。现在,你可以尝试使用HDF5来优化你的业务流程,提高数据管理的效率。

  • 项目介绍:用Jupyter Notebook实现Python与Java的互操作性

    项目介绍:用Jupyter Notebook实现Python与Java的互操作性

    在当今数字化的世界里,编程已经成为了无处不在的技能。无论是数据科学家、软件工程师还是研究人员,都需要在日常工作中处理各种编程任务。然而,有时候我们会陷入一个窘境:如何将不同编程语言的代码协同工作,或者如何快速地在不同语言之间切换?这就是我们今天要介绍的项目的核心问题。

    假设你是一个数据科学家,你在Java中编写了一段复杂的数据处理代码,但你想要使用Python来绘制结果的图表。这似乎是一个挑战,因为Python和Java是两种完全不同的编程语言。但别担心,有一个神奇的工具可以帮助你解决这个问题,那就是Jupyter Notebook。

    什么是Jupyter Notebook?

    Jupyter Notebook是一个交互式的编程环境,最初是为Python开发的,但后来也支持了其他编程语言。它的主要特点是将代码和文本分为不同的单元格(Cell),并且这些单元格的执行环境是持久的,也就是说你可以在其中保存变量并随时执行特定的代码单元格。这为快速调整代码和即时查看结果提供了极大的便利性。

    与此同时,Jupyter Notebook还支持Markdown文本,这意味着你可以在同一个文档中编写代码和文档,使得代码的解释和注释变得非常容易。这个特性对于数据分析、机器学习和科学研究非常有用,因为你可以在同一个文档中记录你的思考过程、实验结果和结论。

    Jupyter Notebook的应用领域

    现在,让我们深入探讨Jupyter Notebook的应用领域,以便更好地理解为什么它是一个如此强大的工具。

    1. 数据分析与可视化

    Jupyter Notebook最常见的用途之一是数据分析。数据科学家可以使用它来导入、清洗和分析数据,并生成数据可视化图表。Python中有丰富的数据分析库,如Pandas、NumPy和Matplotlib,而Jupyter Notebook可以将这些库与交互式环境结合起来,使数据探索变得更加容易。

    2. 机器学习和深度学习

    对于机器学习和深度学习工程师来说,Jupyter Notebook是一个不可或缺的工具。你可以在Notebook中编写、测试和调整机器学习模型,同时使用Markdown文本记录模型的性能和改进方向。这种集成编程和文档的方式使得项目管理和团队协作更加高效。

    3. 多语言编程

    Jupyter Notebook并不局限于Python。它支持多种编程语言,包括但不限于R、Julia、C/C++和CUDA。这意味着你可以在同一个Notebook中混合使用不同的编程语言,解锁了更多可能性。如果你想在Java中编写一些功能,然后在Python中进行数据可视化,Jupyter Notebook可以轻松帮你实现这一目标。

    4. 在线IDE

    有些人将Jupyter Notebook视为一种在线集成开发环境(IDE),因为它不仅可以编辑和执行代码,还可以记录和分享工作。这对于教育、远程协作和项目管理非常有用。

    5. 探索性编程

    Jupyter Notebook非常适合用于探索性编程,也就是那些需要不断试验和调整的任务。你可以逐步执行代码单元格,观察每一步的结果,并根据需要进行修改。这种灵活性使得快速原型开发和实验变得非常容易。

    6. 科研与文献编写

    对于科研人员来说,Jupyter Notebook是一个理想的工具,因为它允许将代码、实验结果和文献综述集成在一起。你可以在同一个文档中编写科研报告,并使用数据可视化来支持你的论点。

    为什么选择Jupyter Notebook?

    或许你现在会问,为什么要选择Jupyter Notebook而不是其他编程工具?下面是一些选择Jupyter Notebook的理由:

    • 交互性: Jupyter Notebook允许你逐步执行代码,查看每一步的结果。这种实时反馈可以帮助你更快地调试和优化代码。

    • 文档记录: 你可以使用Markdown文本编写详细的文档,记录你的思考过程、实验结果和结论。这对于项目管理和协作非常有帮助。

    • 多语言支持: Jupyter Notebook支持多种编程语言,因此你可以在一个文档中集成不同语言的代码。

    • 可视化: 通过支持的可视化库,如Matplotlib和Seaborn,你可以轻松创建各种图表和图形。

    • 在线共享: 你可以将Jupyter Notebook文档分享给他人,并且他们可以在浏览器中打开并运行代码,无需额外的安装。

    如何在Jupyter Notebook中实现Python与Java的互操作性?

    现在,让我们回到最初的问题:如何在Jupyter Notebook中实现Python与Java的互操作性?这其实非常简单,以下是一些步骤:

    1. 安装Jupyter Notebook:首先,你需要安装Jupyter Notebook。你可以使用Python的包管理器pip来安装它。运行以下命令:

      pip install jupyter
    2. 启动Jupyter Notebook:在终端中运行以下命令以启动Jupyter Notebook:

      jupyter notebook

      这将在浏览器中打开Jupyter Notebook的界面。

    3. 创建一个新的Notebook:在Jupyter Notebook的界面中,点击”New”按钮,然后选择一个支持Java的Kernel。通常,你可以选择”Java”或”IRkernel”,具体取决于你的需求。

    4. 编写Python和Java代码:在新创建的Notebook中,你可以在不同的代码单元格中编写Python和Java代码。Python代码将在Python Kernel中执行,而Java代码将在Java Kernel中执行。

    5. 互操作性:你可以在Python代码中调用Java代码,并将结果传递给Python。这样,你就可以在Python中使用Java编写的函数或库。

    以下是一个简单的示例,展示了如何在Jupyter Notebook中使用Python和Java进行互操作:

    # Python代码单元格
    print("Hello from Python!")
    
    # Java代码单元格
    %%java
    public class HelloWorld {
        public static void main(String[] args) {
            System.out.println("Hello from Java!");
        }
    }

    这个示例中,我们在Python代码单元格中打印了一条消息,然后在Java代码单元格中打印了另一条消息。你可以看到,Python和Java代码可以在同一个Notebook中无缝交互。

    结语

    Jupyter Notebook是一个强大的工具,它不仅可以帮助你在数据科学和编程任务中更高效地工作,还可以实现不同编程语言的互操作性。无论你是数据科学家、机器学习工程师还是科研人员,Jupyter Notebook都值得你一试。它的交互性、文档记录和多语言支持使其成为一个不可或缺的工具。

    无论你是想在Python中绘制Java生成的数据图表,还是需要在不同编程语言之间灵活切换,Jupyter Notebook都能满足你的需求。不要再为不同编程语言之间的交互性问题而烦恼,让Jupyter Notebook来帮助你!

    现在,你已经了解了Jupyter Notebook的强大之处,为什么不亲自尝试一下呢?安装它,创建一个新的Notebook,开始探索它的无限可能性吧!

  • ReMax算法:简单、高效、有效的大型语言模型对齐方法

    ReMax算法:简单、高效、有效的大型语言模型对齐方法

    在现代科技的浪潮中,大型语言模型(Large Language Models,LLMs)如GPT-3、GPT-4等已经成为自然语言处理和人工智能领域的璀璨明星。它们能够自动生成文本、回答问题、进行翻译,乃至于模拟人类的对话,这一切都离不开它们在数十亿、数百亿参数的庞大模型支持下。然而,这些强大的模型并非完美无缺,它们在某些情况下会出现不准确、不合理的问题,甚至偏向性言论。为了克服这些问题,研究人员不断提出改进方法,而今天我们将介绍的就是一项重要的改进——ReMax算法。

    ReMax算法简介

    ReMax算法源自于一篇名为《ReMax: A Simple, Effective, and Efficient Method for Aligning Large Language Models》的研究论文。这个算法为大型语言模型的对齐问题提供了一种简单、高效、有效的解决方案。与强化学习对齐方法中的PPO算法相比,ReMax更加轻便,能够显著减少GPU内存占用,并在大型模型上运行更快。

    为什么选择ReMax?

    • 简单、高效、有效:ReMax算法被证明在对齐大型语言模型时非常有效,同时其实现也非常简单,不需要复杂的设置和调整。

    • 节省GPU内存:相对于传统的PPO算法,ReMax可以节省高达50%的GPU内存,这意味着您可以在相同硬件上运行更大的模型或者更多任务。

    • 快速运行:ReMax的计算效率高,因此在大型模型上的训练和对齐过程更加迅速。

    接下来,我们将介绍如何使用ReMax算法来对齐大型语言模型。

    如何使用ReMax算法

    准备工作

    首先,您需要准备Python环境。您可以使用提供的environment.yml文件来设置Anaconda环境。

    conda env create -f environment.yml
    conda activate llm

    步骤1:有监督微调(SFT)

    第一步是进行有监督微调。具体来说,您需要执行以下命令:

    cd step1_supervised_finetuning
    
    # 对于OPT(1.3B)
    bash training_scripts/opt/run_opt_1.3b.sh
    
    # 对于Llama2(7B)
    bash training_scripts/llama2/run_llama2_1.3b.sh

    步骤2:奖励模型微调

    第二步是进行奖励模型的微调。执行以下命令:

    cd step2_reward_model_finetuning
    
    # 对于OPT(1.3B)
    bash training_scripts/opt/run_opt_1.3b.sh
    
    # 对于Llama2(7B)
    bash training_scripts/llama2/run_llama2_1.3b.sh

    步骤3:强化学习对齐(RLHF)

    第三步是进行强化学习对齐。执行以下命令:

    cd step3_rlhf_finetuning
    
    # 对于OPT(1.3B)
    bash training_scripts/opt/run_opt_1.3b.sh
    
    # 对于Llama2(7B)
    bash training_scripts/llama2/run_llama2_1.3b.sh

    致谢

    我们的代码在很大程度上基于DeepSpeed-Chat的基础上开发而来。请按照DeepSpeed-Chat中的详细说明进行操作。

    引用

    如果您发现本代码对您有帮助,请按照以下格式引用我们的论文:

    @article{li2023remax,
      title     = {ReMax: A Simple, Effective, and Efficient Method for Aligning Large Language Models},
      author    = {Li, Ziniu and Xu, Tian and Zhang, Yushun and Yu, Yang and Sun, RUoyu and Luo, Zhi-Quan},
      booktitle = {arXiv preprint arXiv:2310.10505},
      year      = {2023},
    }

    通过ReMax算法,我们可以更加高效地对齐大型语言模型,提高其性能和可靠性,为自然语言处理领域的发展贡献一份力量。