Tag: Python

  • PyCharm在Ubuntu 20.04上的安装、配置与常见问题解决

    PyCharm在Ubuntu 20.04上的安装、配置与常见问题解决

    PyCharm是一款强大的Python集成开发环境(IDE),它提供了丰富的功能,使Python开发变得更加高效。本教程将指导您如何在Ubuntu 20.04上安装、配置PyCharm,并解答一些常见问题。

    第一部分:安装PyCharm

    步骤1:下载PyCharm

    首先,您需要从JetBrains官方网站下载PyCharm的社区版或专业版。社区版是免费的,适用于大多数Python开发。专业版提供了更多高级功能,需要购买许可证。

    步骤2:解压安装包

    下载完成后,使用以下命令在终端中解压安装包。请将pycharm-professional-<version>替换为您下载的实际文件名。

    tar -xzf pycharm-professional-<version>.tar.gz

    步骤3:移动到安装目录

    将解压后的文件夹移动到您希望安装PyCharm的目录。通常,可以将它移动到/opt/目录下,以便所有用户都可以访问。

    sudo mv pycharm-professional-<version> /opt/pycharm

    步骤4:创建启动器

    为了方便启动PyCharm,您可以创建一个启动器。在终端中运行以下命令:

    sudo nano /usr/share/applications/pycharm.desktop

    在文本编辑器中添加以下内容,然后保存并退出:

    [Desktop Entry]
    Name=PyCharm
    Exec=/opt/pycharm/bin/pycharm.sh
    Icon=/opt/pycharm/bin/pycharm.png
    Type=Application
    Categories=Development;IDE;

    步骤5:启动PyCharm

    现在,您可以在应用程序菜单中找到PyCharm并启动它。或者,可以在终端中运行以下命令启动PyCharm:

    /opt/pycharm/bin/pycharm.sh

    第二部分:配置PyCharm

    步骤1:设置解释器

    打开PyCharm后,首先要配置Python解释器。在欢迎界面或设置中,找到“项目”并选择您的项目。然后在项目设置中配置Python解释器。

    步骤2:安装插件

    PyCharm支持丰富的插件,您可以根据需要安装插件来增强功能。在PyCharm中,转到“文件” > “设置” > “插件”并搜索要安装的插件。

    步骤3:版本控制

    PyCharm集成了版本控制工具,如Git。您可以在设置中配置您的版本控制偏好,以便更轻松地管理项目的版本。

    第三部分:常见问题解决

    问题1:无法找到Python解释器

    如果PyCharm无法找到Python解释器,请确保您已正确安装Python。然后,手动配置解释器,如上述步骤所示。

    问题2:启动慢

    如果PyCharm启动较慢,您可以尝试通过编辑/opt/pycharm/bin/pycharm.vmoptions文件来调整JVM参数,以适应您的计算机性能。

    问题3:插件不兼容

    某些情况下,插件可能不兼容PyCharm的特定版本。请检查插件是否有更新版本,或尝试禁用不兼容的插件。

    问题4:无法导入项目

    如果您无法导入项目,确保您的项目结构正确,并且项目文件夹包含必要的配置文件。还可以尝试清除缓存并重新导入项目。

    问题5:无法连接到版本控制

    如果无法连接到版本控制工具(如Git),请确保已正确安装并配置版本控制工具,并在PyCharm中进行正确的配置。

    结语

    本教程介绍了在Ubuntu 20.04上安装、配置和解决常见问题的PyCharm。PyCharm是一款功能强大的Python开发工具,可以提高您的生产力。希望这个教程对于新手能够帮助您顺利开始Python开发工作。
  • 在Ubuntu 20.04上设置开发环境和IDE

    在Ubuntu 20.04上设置开发环境和IDE

    Ubuntu 20.04是一种流行的Linux发行版,广泛用于开发和服务器环境。在本教程中,我们将介绍如何在Ubuntu 20.04上设置一个完整的开发环境,并选择一个适合您的集成开发环境(IDE)来提高您的生产力。

    一、安装Ubuntu 20.04

    如果您还没有安装Ubuntu 20.04,首先需要下载并安装它。您可以从Ubuntu官方网站下载安装镜像,并按照安装指南的步骤完成安装过程。确保选择“安装第三方软件”选项,以便在安装时包括常用的开发工具和库。

    二、更新系统

    在开始设置开发环境之前,请确保您的系统是最新的。打开终端并运行以下命令来更新系统:

    sudo apt update
    sudo apt upgrade

    这将下载并安装所有可用的更新。

    三、安装常用开发工具

    在Ubuntu 20.04上,您可以通过以下命令安装一些常用的开发工具:

    sudo apt install build-essential gcc g++ make

    这将安装构建工具、C/C++编译器和make工具,这些对于许多开发项目都是必需的。

    四、选择一个集成开发环境(IDE)

    选择一个合适的IDE对于开发非常重要,它可以提供代码编辑、调试和项目管理等功能。以下是一些受欢迎的开发环境选项:

    1. Visual Studio Code

    Visual Studio Code(VS Code)是一个免费的跨平台代码编辑器,它支持多种编程语言,并具有强大的插件系统,可以根据您的需求进行扩展。您可以在Ubuntu上安装VS Code,打开终端并运行以下命令:

    sudo snap install --classic code

    2. PyCharm

    如果您是Python开发者,PyCharm是一个出色的Python集成开发环境。您可以下载并安装PyCharm的社区版本(免费)或专业版本(需要许可证)。

    3. IntelliJ IDEA

    如果您开发Java应用程序,IntelliJ IDEA是一个强大的Java IDE。您可以下载并安装IntelliJ IDEA的社区版本(免费)或Ultimate版本(需要许可证)。

    4. Eclipse

    Eclipse是一个广泛使用的开发环境,支持多种编程语言。您可以下载并安装Eclipse IDE for Java Developers或其他适合您需求的版本。

    五、配置和使用IDE

    安装完您选择的IDE后,打开它并按照界面上的指导进行配置。通常,您需要设置工作区、插件、编程语言支持和代码样式等选项。

    接下来,您可以创建新项目或导入现有项目,并开始编写代码。IDE通常提供了代码自动完成、调试工具和版本控制集成,以帮助您更高效地开发。

    六、安装其他开发工具和库

    根据您的项目需求,您可能需要安装其他开发工具和库。例如,如果您是Web开发人员,您可能需要安装Apache、PHP和MySQL。如果您是数据科学家,您可能需要安装Python的数据科学库,如NumPy、Pandas和Matplotlib。

    您可以使用以下命令来安装这些工具和库:

    sudo apt install apache2 php mysql-server

    七、总结

    在Ubuntu 20.04上设置开发环境和IDE是为了提高您的开发效率和舒适度。选择一个适合您项目需求的IDE,并根据需要安装其他工具和库,以确保您能够顺利进行开发工作。

    希望这个教程对于在Ubuntu 20.04上设置开发环境和IDE的新手有所帮助。祝您在开发旅程中取得成功!

  • 手把手教程:使用Python爬取Bilibili视频

    手把手教程:使用Python爬取Bilibili视频

    在现代社交媒体和视频分享平台的时代,Bilibili(哔哩哔哩)已经成为了许多人追逐知识、娱乐和创意的宝库。Bilibili上有各种各样的视频内容,从知识分享到娱乐节目,应有尽有。你可能会想,是否有一种方法可以将自己喜欢的Bilibili视频保存到本地,以便离线观看或备份?幸运的是,我们可以使用Python编写一个小工具来实现这个目标。在本教程中,我将带你逐步学习如何使用Python爬取Bilibili视频,无需额外的插件或工具。

    步骤1:准备工作

    在开始之前,确保你已经安装了Python和相关的库,包括requests、lxml、tqdm等。你可以使用pip来安装这些库。此外,你还需要安装FFmpeg并配置环境变量,以便后续视频合成操作。

    步骤2:初始化爬虫类

    首先,我们需要初始化一个爬虫类,用于处理Bilibili视频的爬取和下载。在代码中,我们使用了requests库来发送HTTP请求,并使用lxml库来解析HTML和JSON数据。以下是初始化爬虫类的示例代码:

    class BiliBili:
        def __init__(self, dirname):
            # 初始化各种HTTP请求头和会话
            self.search_headers = {
                # ...(省略部分代码)...
            }
            self.video_headers = {
                # ...(省略部分代码)...
            }
            self.api_headers = {
                # ...(省略部分代码)...
            }
            self.sess = requests.Session()
    
            self.dir = dirname

    步骤3:搜索视频

    接下来,我们将编写方法来搜索Bilibili上的视频。用户可以提供关键词和页码数来搜索视频。我们将发送HTTP请求到Bilibili的搜索页面,并解析搜索结果以获取视频信息。以下是搜索视频的示例代码:

        def search_video(self, keyword, page=1):
            # 构建搜索URL
            url = f'https://search.bilibili.com/all?keyword={parse.quote(keyword)}&page={page}&o=30'
            req = self.sess.get(url=url, headers=self.search_headers)
            # 解析HTML数据
            html = etree.fromstring(req.text, etree.HTMLParser())
            bvs = html.xpath('//div[@class="bili-video-card__info--right"]/a/@href')[:3]
            titles = html.xpath('//div[@class="bili-video-card__info--right"]/a/h3/@title')[:3]
            videos = []
            for i, j in zip(titles, bvs):
                for c in u'´★☆❤◦\/:*?"<>|':
                    i = i.replace(c, '')
                tmp = [i, j]
                videos.append(tmp)
            return videos

    步骤4:获取下载链接

    一旦我们获得了视频的信息,接下来的任务是获取视频的下载链接。我们将解析视频详情页,提取视频和音频的下载链接,以及视频的标题。以下是获取下载链接的示例代码:

        def get_download_url(self, arcurl):
            # 解析视频详情页URL,获取视频信息
            # ...(省略部分代码)...
            return [accept_description, video_data, audio_data, title]

    步骤5:下载和合成视频

    最后,我们需要编写代码来下载视频和音频,并将它们合成为一个完整的视频文件。我们使用requests库下载数据,同时使用ffmpeg工具来合成视频和音频。以下是下载和合成视频的示例代码:

        def downloader(self, data_url, title):
            # 下载视频或音频数据
            # ...(省略部分代码)...
    
        def merge_data(self, dir, video_name):
            # 合并视频和音频数据
            # ...(省略部分代码)...

    通过以上步骤,你已经可以使用Python爬取和下载Bilibili视频了。你可以根据自己的需求批量下载搜索页视频或下载指定BV号的视频。

    结语

    本教程带你了解了如何使用Python编写一个简单的Bilibili视频爬虫,但请记住要尊重Bilibili的使用规则和知识产权,不要滥用爬虫。爬取视频内容时,请遵守相关法律法规和平台规定。

    希望这个教程对你有所帮助,让你能够轻松地保存你喜欢的Bilibili视频并在离线时观看!

  • 手把手教程:打造扫雷游戏

    手把手教程:打造扫雷游戏

    想象一下,你正在寻找一种有趣的编程项目,以提高你的编程技能。你希望能够创建一个小游戏,同时还能锻炼你的逻辑思维和图形用户界面(GUI)开发能力。那么,扫雷游戏是一个绝佳的选择!扫雷是一款经典的单人电脑游戏,它的规则简单,但挑战却异常艰巨。通过本教程,你将学会如何使用Python和Tkinter库来制作自己的扫雷游戏。

    步骤1:准备工作

    在开始之前,确保你的电脑上已经安装了Python和Tkinter库。如果没有安装,可以访问Python官方网站(https://www.python.org/downloads/)下载Python,并使用pip安装Tkinter。

    步骤2:创建游戏窗口

    首先,我们需要创建一个游戏窗口。我们将使用Tkinter库来完成这个任务。以下是创建窗口的示例代码:

    import tkinter as tk
    
    # 创建主窗口
    root = tk.Tk()
    root.title("扫雷游戏")
    
    # 添加游戏内容
    # 这里将在后续步骤中继续添加游戏逻辑
    
    # 启动主循环
    root.mainloop()

    步骤3:绘制游戏界面

    接下来,我们将绘制扫雷游戏的界面。这包括创建一个网格,用于放置游戏中的方块(代表地雷或数字),以及按钮用于交互。以下是绘制游戏界面的示例代码:

    # 创建游戏网格
    for row in range(rows):
        for col in range(cols):
            button = tk.Button(root, width=2, height=1)
            button.grid(row=row, column=col, sticky="nsew")

    步骤4:生成地雷和数字

    扫雷游戏的核心是在游戏网格上放置地雷和计算周围的地雷数量。我们可以使用随机数生成地雷,并计算每个方块周围的地雷数量。以下是示例代码:

    import random
    
    # 放置地雷
    mine_count = 0
    while mine_count < mines:
        row, col = random.randint(0, rows - 1), random.randint(0, cols - 1)
        if board[row][col] != -1:
            board[row][col] = -1
            mine_count += 1
            update_adjacent_cells(row, col)
    
    # 更新相邻方块的地雷数量
    def update_adjacent_cells(row, col):
        for r in range(row - 1, row + 2):
            for c in range(col - 1, col + 2):
                if 0 <= r < rows and 0 <= c < cols and board[r][c] != -1:
                    board[r][c] += 1

    步骤5:处理点击事件

    点击游戏方块时,我们需要处理点击事件。如果点击到地雷,游戏结束;如果点击到数字,显示数字;如果点击到空方块,递归揭示周围的方块。以下是处理点击事件的示例代码:

    def click(row, col):
        if board[row][col] == -1:
            game_over()
        else:
            reveal_cell(row, col)
            if check_win():
                game_win()

    步骤6:游戏结束和获胜处理

    最后,我们需要处理游戏结束和获胜的情况。游戏结束时,显示所有的地雷位置,并播放失败音效;获胜时,显示获胜信息并播放胜利音效。以下是处理游戏结束和获胜的示例代码:

    def game_over():
        for row in range(rows):
            for col in range(cols):
                if board[row][col] == -1:
                    buttons[row][col].config(text='X', state=tk.DISABLED)
                else:
                    buttons[row][col].config(state=tk.DISABLED)
        messagebox.showinfo("游戏结束", "你失败了!")
        reset_game()
    
    def game_win():
        for row in range(rows):
            for col in range(cols):
                buttons[row][col].config(state=tk.DISABLED)
        messagebox.showinfo("恭喜你!", "你赢了!")
        reset_game()

    通过以上步骤,你已经成功创建了一个简单的扫雷游戏。你可以根据自己的需求进一步完善游戏界面和功能,使其更加精彩。祝你玩得开心!

  • 开源与闭源:AI模型权重的安全之争

    开源与闭源:AI模型权重的安全之争

    最近,关于开源(Open Source)的讨论再次成为热点话题。有人表示,没有开源,人工智能将一无所有,继续保持AI的开放性。这个观点得到了众多人的支持,包括图灵奖得主、Meta首席科学家Yann LeCun。

    假如我们想象一下,如果工业界的AI研究实验室一直都是封闭的,没有开源代码,并且对所有内容都申请和执行专利,那么今天的AI行业会是什么样子呢?

    开源的重要性

    开源(Open Source)在人工智能领域扮演着重要的角色。它意味着将AI模型的代码和权重开放给公众,使研究者和开发者能够自由地使用、修改和共享这些技术。这种开放性推动了AI领域的创新和发展,让众多优秀的模型得以诞生。

    想象一下,如果没有开源的PyTorch框架,以及一系列开源模型如Transformer、ResNet、Mask-RCNN等,AI行业将无法取得今天的成就。这些开源项目为AI研究和应用提供了强大的工具和基础。

    模型权重的安全担忧

    然而,一些公司,如OpenAI和Anthropic,不愿意开源他们的大模型权重。为什么会这样呢?原因在于模型权重被视为极为重要的知识产权,同时也存在着安全担忧。

    在深度学习领域,模型权重是神经网络学习和做出预测的关键机制。这些权重的最终值决定了模型的性能。因此,保护这些权重免受未经授权的访问至关重要。

    兰德公司的一项研究指出,虽然权重不是大模型需要保护的唯一组成部分,但它们与模型的大量计算、收集和处理的训练数据以及算法优化密切相关。泄露模型权重可能使恶意行为者以非常小的训练成本来利用完整的模型,从而带来潜在的风险。

    公司的安全关切

    为了保护模型权重的安全,一些大模型公司投入了大量资源。例如,Anthropic公司的首席信息安全官Jason Clinton表示,他将一半的时间用于保护模型权重文件。他强调,公司更关心的是防止这些强大技术落入恶意人士之手,从而产生不可估量的负面影响。

    这种担忧不仅存在于公司内部,也受到政府和监管机构的关注。白宫最近发布的行政命令要求大模型公司向政府报告模型权重的所有权、占有情况以及采取的保护措施,以确保模型权重的安全性。

    安全威胁的研究

    一份由兰德公司发布的报告《Securing Artificial Intelligence Model Weights》指出了人工智能模型权重面临的安全威胁和未来风险。该报告列出了40种不同的攻击向量,强调这些威胁不仅是理论上的,而且已有证据表明它们正在被执行,甚至在某些情况下已被广泛部署。

    这些安全研究表明,模型权重的泄露可能会对国家安全、隐私和道德产生严重影响。因此,公司对模型权重的保护和安全性非常重视。

    开源与安全的平衡

    在开源和保

    护模型权重的问题上,存在复杂性和权衡。开源能够推动技术的创新和普及,但也可能带来安全风险。因此,需要在保护知识产权和促进创新之间寻找平衡。

    斯坦福大学人工智能学院的政策简报《Considerations for Governing Open Foundation Models》指出,开放基础模型可以对抗市场垄断,促进创新,并提高透明度。然而,与封闭模型相比,其风险尚不明确,需要谨慎对待。

    结语

    开源与保护模型权重之争在人工智能领域引发了广泛的讨论。虽然开源为技术创新提供了巨大的推动力,但模型权重的安全问题也不容忽视。寻找开源与安全的平衡将是未来AI发展的重要议题,我们期待看到技术和政策的不断进步。

  • 谷歌发布全新Google AI SDK,简化Android应用集成Gemini Pro

    谷歌发布全新Google AI SDK,简化Android应用集成Gemini Pro

    故事开篇: 从“王大神 – AI技术博客”,探讨谷歌最新的AI SDK,助力开发者更轻松地在Android应用中集成高性能的Gemini Pro模型,释放AI的强大潜力。

    引言

    在数字化时代,人工智能(AI)技术日益成为科技领域的关键驱动力之一。谷歌作为全球领先的科技巨头,一直在推动AI技术的发展和应用。最近,谷歌再次引领潮流,发布了全新的Google AI SDK,旨在简化Android应用集成其高性能的Gemini Pro模型。这一举措将为开发者们提供更便捷、高效的AI应用开发体验。

    谷歌AI SDK:让Gemini Pro无缝集成

    Gemini Pro是谷歌最功能强大的模型之一,专为处理广泛的文本和图像推理任务而设计。而Google AI SDK的推出,为开发者们提供了一个更加简便的方式,无需构建和管理自己的后端基础架构,就能够在其Android应用中集成Gemini Pro模型。

    在使用Gemini Pro时,最简单的方法是通过Google AI Studio进行操作。这是一个基于Web的工具,允许开发者在浏览器中进行原型设计和运行prompt(提示词)。如果结果令人满意,开发者可以将模型导出为代码,并在其所选的编程语言(例如Python)中在后端运行。

    为Android应用开发提供便利

    对于Android应用开发者而言,谷歌提供了Google AI client SDK for Android,将Gemini REST API封装为Kotlin原生的API。这意味着开发者无需直接与REST API交互,也不需要在Android应用中实现用于访问Gemini模型的服务器端服务。这种高度集成的方式,极大地简化了AI模型的集成过程,让开发者可以更专注于应用的逻辑和用户体验。

    除了纯文本模型之外,Gemini还提供了一个多模态模型(gemini-pro-vision)。这个模型能够从文本和图像输入生成文本,并且支持流式处理,实现更快的交互。这意味着开发者可以创建更具创新性的应用,实现更丰富的用户体验。

    Android Studio的新项目模板

    为了进一步简化开发者的工作流程,最新的Android Studio预览版引入了一个新的项目模板,该模板将指导开发者使用Gemini Pro所需的步骤。这个项目模板将为开发者提供一条清晰的路线图,帮助他们更快地将Gemini Pro模型集成到自己的应用中。

    结语

    谷歌的全新Google AI SDK为开发者们带来了更多便捷和创新的机会。通过简化Gemini Pro模型的集成过程,谷歌鼓励更多的开发者探索人工智能的应用领域,推动科技的不断进步。随着AI技术的不断发展,我们可以期待更多令人惊叹的应用出现,改变着我们的生活方式和工作方式。

  • Squirrel-RIFE:让你的视频更流畅

    Squirrel-RIFE:让你的视频更流畅

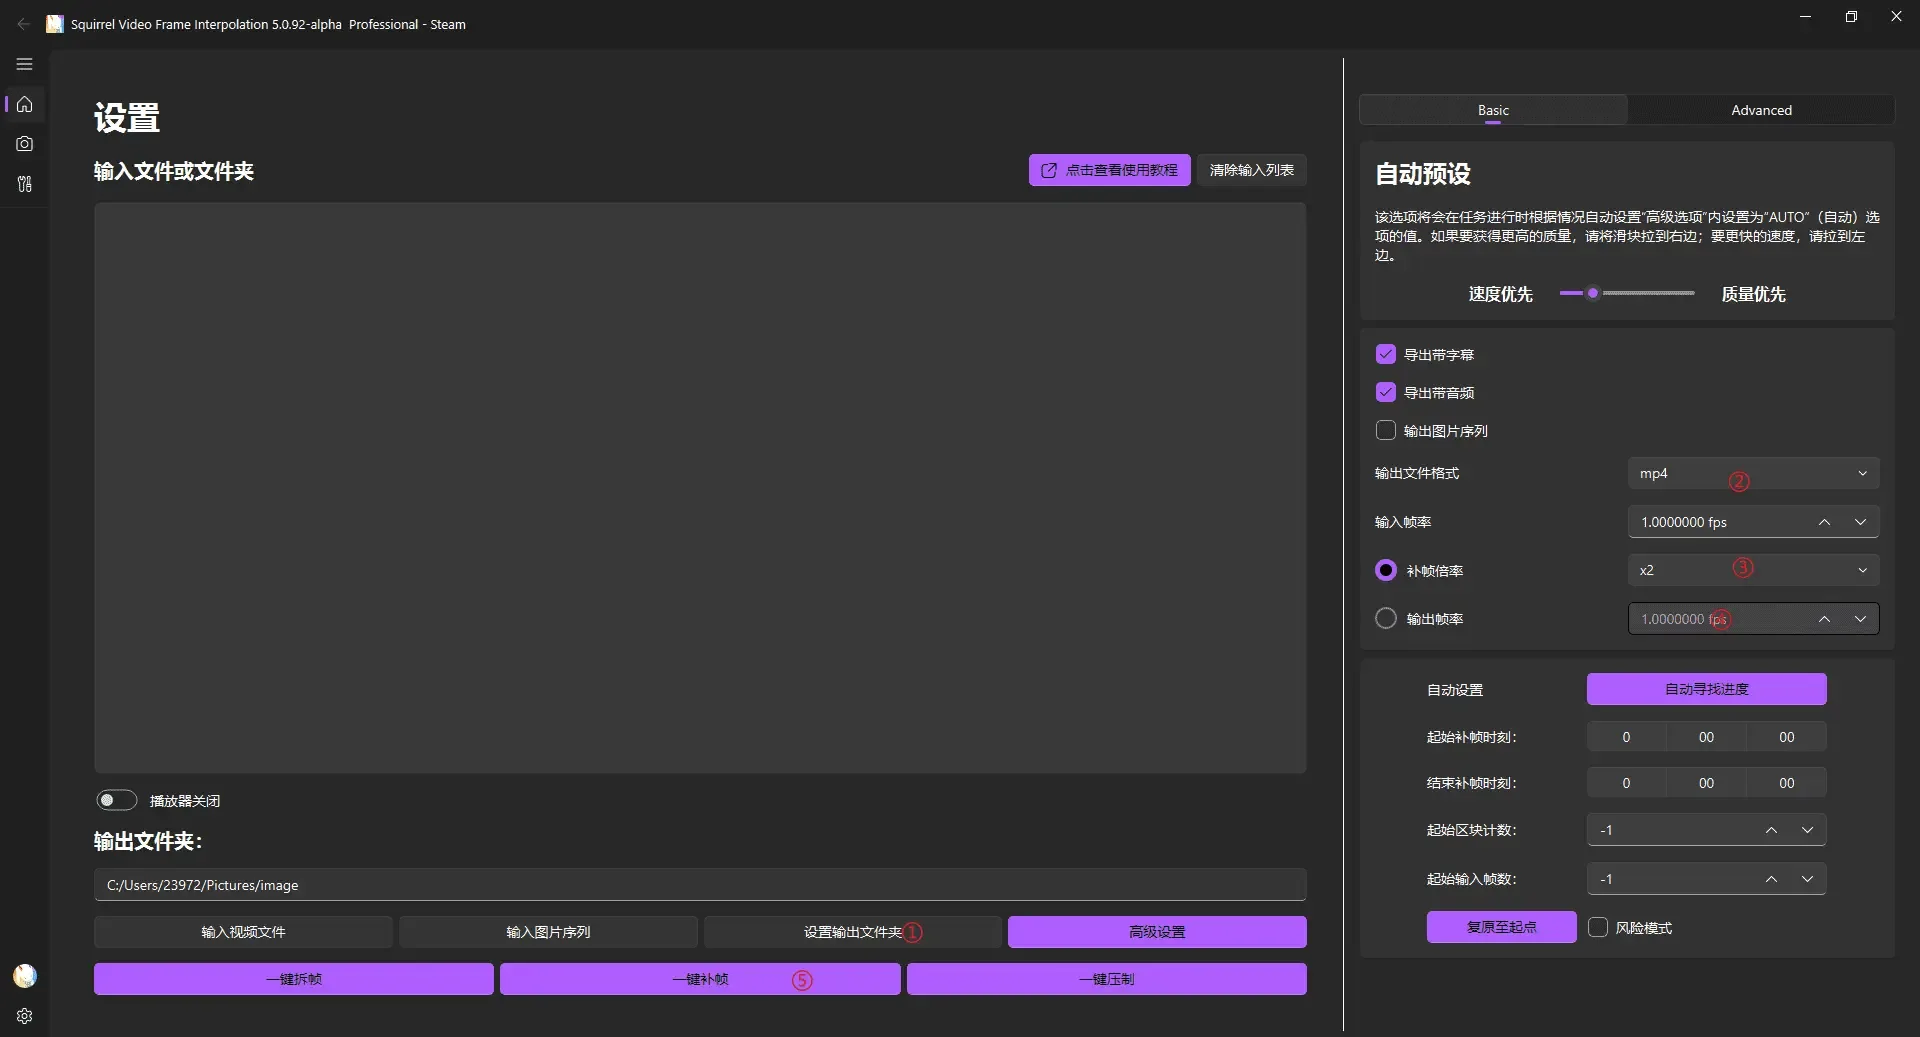
    有没有曾经因为观看视频时的帧数不够流畅而感到困扰?或者你是一名视频编辑师,希望提高视频的流畅度和质量?Squirrel-RIFE 就是你需要的解决方案!它基于先进的 RIFE 算法,能够让你的视频变得更加流畅,效果更出色。

    问题的根源

    在观看视频时,特别是在动画或高速镜头切换的情况下,我们常常会感到视频的帧数不够流畅,画面卡顿。这给我们的观影体验带来了很大的困扰。此外,视频编辑师在编辑视频时,有时需要进行帧间补帧操作,以提高视频的流畅度和质量。然而,传统的帧间补帧算法通常效率较低,耗费大量显存和时间。

    Squirrel-RIFE 的特点

    Squirrel-RIFE 是一个基于 RIFE 算法的中文补帧软件,它有以下显著特点:

    • 效果更好,显存占用更小:Squirrel-RIFE 在提供更好的视频流畅度的同时,显存占用非常小,比传统算法效率高,速度更快,是 DAIN 速度的 20 倍。

    • 高精度转场识别:它具有高精度的转场识别能力,可以在大多数视频中达到 95% 以上的精确度,而不会破坏视频的流畅效果。这意味着在视频中进行剪辑和编辑时,你可以保持高质量的画面。

    • 包含抽帧处理:Squirrel-RIFE 还包括抽帧处理功能,可以去除动画中的卡顿感,让观看更加流畅。

    适用系统和硬件要求

    为了正常运行 Squirrel-RIFE,你需要满足以下系统和硬件要求:

    • 操作系统:Windows 10 及以上

    • NVIDIA 显卡:需要 GeForce Experience 安装的驱动版本大于等于 460.89

    • 显存:2GB 以上

    • 运行内存:4GB 左右

    • 磁盘剩余空间:4GB+

    项目的参考和致谢

    Squirrel-RIFE 是建立在多个优秀开源项目的基础上,感谢这些项目的贡献者和开发者:

    行动起来!

    现在,你可以拥有更加流畅的视频观看体验,提高视频编辑的质量,一切都掌握在你的电脑上。不再为视频卡顿而烦恼,也不再为编辑视频时的低效而担忧。点击以下链接,下载 Squirrel-RIFE,让你的视频更流畅!

    支持与反馈

    如果你觉得 Squirrel-RIFE 对你有帮助,欢迎在项目页面上给予 Star,以表达对开发者的支持和认可。同时,如果你有任何问题或建议,也可以在项目页面上留下反馈,开发者将非常乐意听取你的意见,不断改进项目。

    结语

    Squirrel-RIFE 是一个强大的视频处理工具,让你的视频更加流畅,提高质量。不论你是视频观众还是视频编辑师,都能从中受益。下载并使用 Squirrel-RIFE,让你的视频观看和编辑变得更加轻松愉快!

  • 成功的秘诀:做对一件事,然后复制

    成功的秘诀:做对一件事,然后复制

    成功,一直以来都是人们追求的目标。然而,随着社会的不断变化和发展,成功的路径似乎变得越来越复杂和多样化。在这个快速变化的时代,我们经常面临各种挑战和机遇。很多人在追求成功的路上尝试了无数种方法和策略,但真正的成功秘诀可能比想象中更简单:只需要在某个领域取得一次成功,然后将这种成功模式复制到其他领域。

    专注于一件事,取得成功

    首先,专注于一件事情并取得成功非常重要。当我们将精力集中在一个目标上时,我们可以更深入地探索这个领域,更好地理解其中的细节和奥秘。这种深度的专注会让我们在这个领域达到专家级别,从而大大增加成功的可能性。

    比如,在编程领域,专注于一门编程语言如Python,深入研究其各种应用和最佳实践,能够让人成为这个领域的专家。通过不断学习和实践,我们可以积累丰富的经验和知识,从而在该领域脱颖而出。在我的职业生涯中,我也深知专注的力量,特别是在编程方面。通过深入学习Python和其他编程技能,我取得了一些令人自豪的成就。

    复制成功模式,跨足多个领域

    一旦在一个领域取得成功,关键就在于如何将这种成功的模式复制到其他领域。这涉及到对成功经验的分析和提炼。我们需要问自己:是什么因素让我们在这个领域成功?是专业知识、创新思维、还是坚持不懈的努力?

    理解了这些关键因素后,我们就可以将这些成功要素应用到其他领域。例如,如果我们在技术领域成功了,可能是因为我们的创新思维和问题解决能力。这些技能同样可以应用到音乐、艺术甚至商业领域。创新思维不仅可以帮助我们在科技创新中脱颖而出,还可以帮助我们在音乐创作中寻找新的音乐元素,或者在商业中找到创新的商业模式。

    当然,复制成功模式并不意味着完全复制一成不变的方法。每个领域都有其特殊性,我们需要对成功模式进行适当的调整和优化。这就要求我们对新领域有足够的了解和敏感性,能够灵活调整策略以适应新环境。

    结语

    总之,成功的秘诀可能就是做好一件事,然后将这种成功模式复制到其他领域。这种方法不仅能帮助我们在一个领域取得显著成就,还能让我们的成功经验在更广阔的领域得到应用,从而实现持续的成长和发展。通过这种方式,我们可以在多个领域取得成功,实现个人和职业上的全面发展。

    在追求成功的道路上,坚持不懈、创新思维和专注于一件事是取得成功的关键。一旦取得成功,将这些成功要素应用到其他领域,你将会发现,成功的秘诀并不是那么复杂,只需要做对一件事,然后复制。这是一个简单而强大的理念,可以指引我们走向更广阔的成功之路。

  • Dolphin 2.5 Mixtral 8X7B 模型详解及应用教程

    Dolphin 2.5 Mixtral 8X7B 模型详解及应用教程

    本文为您提供了关于Dolphin 2.5 Mixtral 8X7B模型的全面介绍和使用教程。这款由Eric Hartford创造的模型,是基于混合模型架构构建的,能够提供高效的AI服务。

    1. 模型概述

    1.1 模型创建者和来源

    1.2 模型描述

    Dolphin 2.5 Mixtral 8X7B 是一款结合了多个数据集的大型混合模型,特别擅长编码任务。它提供了32K的上下文处理能力,并且在16K的范围内进行了微调,以优化性能。

    1.3 特色功能

    • 编码能力强大:在编程相关的数据集上受过特别训练。
    • 高度顺从性:虽然没有DPO调整,但模型本身对用户请求的顺从度很高。
    • 丰富的训练数据集:包括新的Dolphin-Coder和Magicoder数据集。

    2. 模型使用

    2.1 兼容性和量化方法

    Dolphin 2.5 Mixtral 8X7B 提供了多种量化方法,适用于不同的系统环境。您可以根据自己的需求选择合适的版本。

    2.2 如何下载GGUF文件

    可以通过Hugging Face CLI或者Python库进行下载。例如,使用以下命令下载:

    huggingface-cli download TheBloke/dolphin-2.5-mixtral-8x7b-GGUF dolphin-2.5-mixtral-8x7b.Q4_K_M.gguf --local-dir . --local-dir-use-symlinks False

    2.3 如何运行

    您可以使用llama.cpp命令行工具来运行模型,也可以通过Python代码进行集成。以下是一个Python集成的示例代码:

    from llama_cpp import Llama
    
    llm = Llama(
      model_path="./dolphin-2.5-mixtral-8x7b.Q4_K_M.gguf",
      n_ctx=32768,
      n_threads=8,
      n_gpu_layers=35
    )
    
    output = llm(
      "system\n{system_message}\nuser\n{prompt}\nassistant",
      max_tokens=512,
      stop=["</s>"],
      echo=True
    )

    3. 应用场景

    Dolphin 2.5 Mixtral 8X7B适合于多种场景,尤其是编程和技术相关的领域。它也可以用于一般的聊天和内容生成任务。

  • 王小神:不只是个WeChat机器人

    王小神:不只是个WeChat机器人

    嘿,我刚弄了个WeChat机器人,就叫它“王小神”吧。现在市面上的机器人,多数还是Web协议的。那些说是Web协议的,一连就是Windows登录提示,搞得人头大。iOS或平板登录的,更是贵得吓人,一年得掏出2000多。

    怎么来的:从微信到机器人

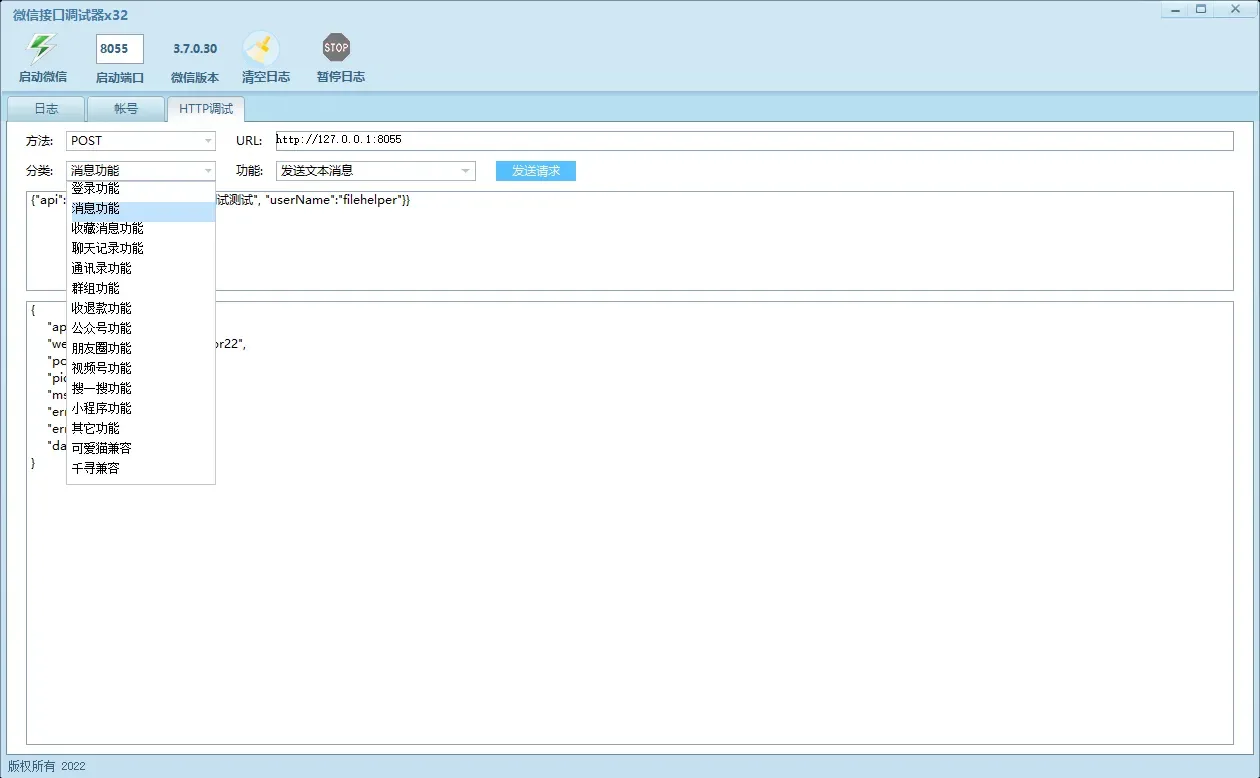
    我找到了个法子,用微信3.7.0.30的hooks文件,自己动手做了个机器人。这招的好处在于,机器人就跑在我本地Windows系统上,风控的事儿少了去了。

    我把这机器人放在本地的esxi Windows服务器上,一天24小时都能干活。

    挑战:自己动手,丰衣足食

    不过,这么干也不全是好事,得自己写功能这块儿有点头疼。好在微信3.7.0.30的接口调试器提供了不少示例,我就拿Python来开发我需要的东西。

    功能篇:王小神的四大招

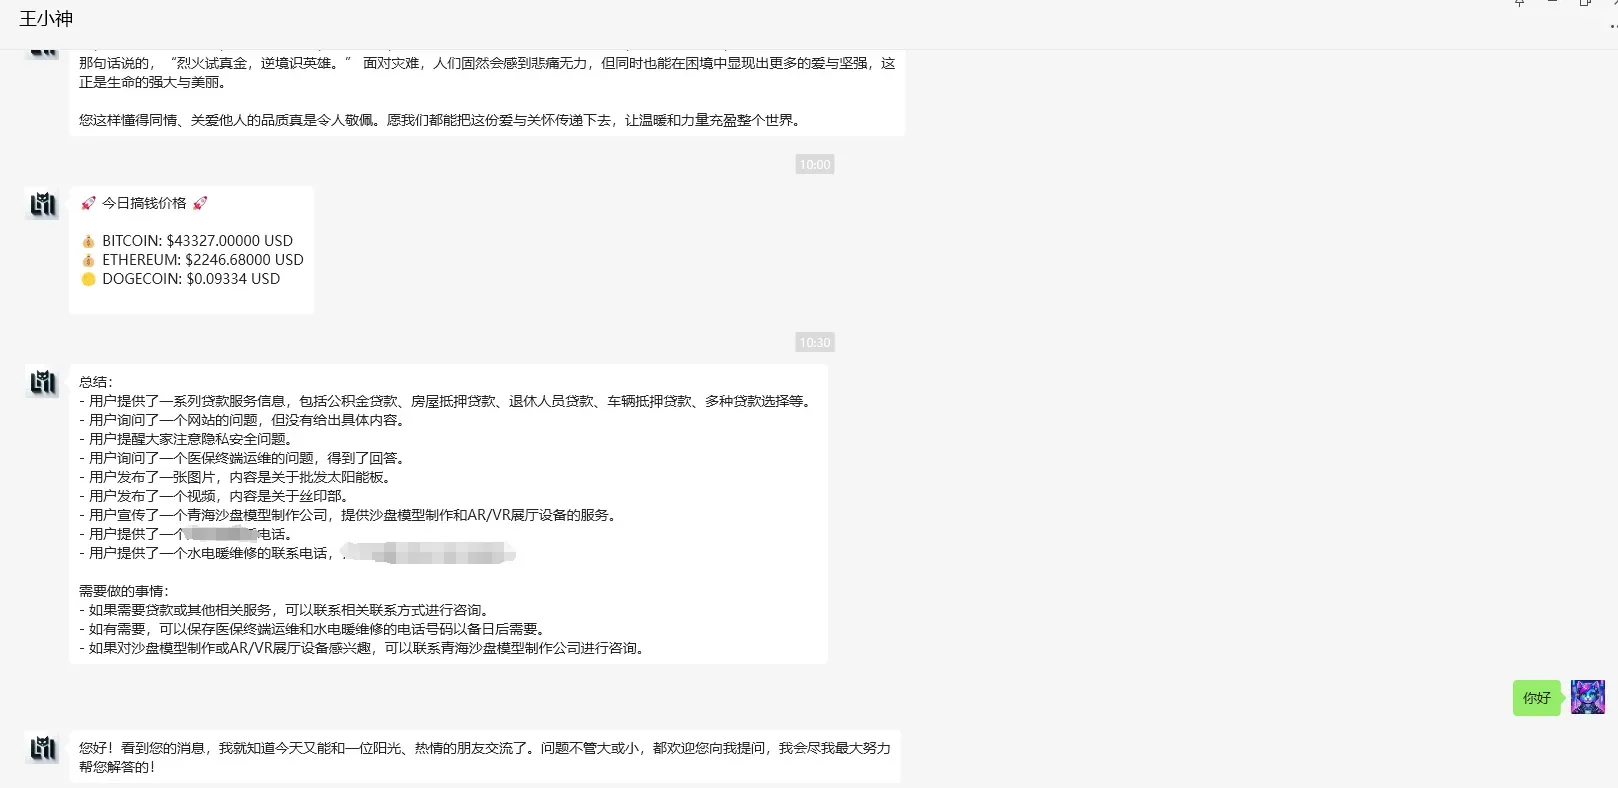
    1. 客服模式:我让王小神在聊天里变着法子夸客户,目标就是让客户心甘情愿下单。
    2. 助理模式:它每个小时都帮我总结一下群聊和私聊,有啥重要的事情,立马提醒我。
    3. 监控模式:
      • 监控服务器和机器人运行状况。
      • 盯着虚拟货币价格,定时汇报。
      • 留意业务群里的机会,有合适的立马通知我。
    4. 社交模式:帮我点赞朋友圈,还会自动评论。

    未来规划:更多牛功能在路上

    接下来我打算给王小神加点新功能:

    1. 识别语音消息。
    2. 自动发朋友圈。
    3. 接入我的私人知识库。
    4. 监控微信收款小助手,搞搞财务报表。

    总之,王小神不仅仅是个机器人,更像是我高效工作的小秘书。希望它能帮我把日常琐事处理得更加得心应手。