Category: AI 实践

  • 12G 显存,够吗?——消费级 GPU 上做 LLM 算法研究的完整路线

    12G 显存,够吗?——消费级 GPU 上做 LLM 算法研究的完整路线

    写给那些在普通电脑前,想认真做研究的人。

    写在前面:先聊一件事

    我认识一个年轻人,他对大语言模型的训练算法充满好奇,想做研究,想写论文,但他家里的条件不算好——手边只有一张 12G 显存的显卡。

    他问我:够吗?

    我思考了很长时间才回答他,因为这个问题背后藏着一个更深的问题:一个资源有限的人,该如何在这个领域里走出一条属于自己的路?

    这篇文章就是我给出的答案。

    12G 显存,放在 LLM 领域来说,确实不算多。但请你先听我说完:历史上有一大批真正重要的算法,都是在资源约束下被发明出来的。LoRA 诞生于"我们没有足够算力全量微调"的困境;GaLore 的动机是"优化器状态太占显存";QLoRA 的出发点是"普通研究者能不能用量化把成本打下来"。

    最近的 APOLLO 更极端——它的论文标题直接叫"SGD-like Memory, AdamW-level Performance",MLSys 2025 年的荣誉提名。它的核心 claim 是什么?用 APOLLO-Mini + 权重量化,在不到 12GB 显存的单卡上从零预训练 LLaMA-7B。这不是 PPT 上的数字,是有代码有复现的学术结论。

    限制不是研究的终点,限制本身可以成为研究的起点。你的 12G 显存,不是天花板,而是一个非常清晰的研究定位。

    一、首先要对齐一个认知

    很多人对"做 LLM 研究"有一个隐性的误解:研究 = 训练一个更大的模型,或者在更大的模型上刷更高的 benchmark 分数。

    这个理解是错误的,或者说,是不完整的。

    真正的算法研究关心的是:这个方法在不同条件下是否有效?它的边界在哪里?为什么有效?

    一个优化器算法,如果它在 60M 参数的模型上稳定有效,在 360M 上趋势一致,在 1.5B 上仍然保持优势——那它就是一个站得住脚的算法贡献,和你有没有 A100 集群没有关系。

    顶会论文里有大量这样的工作:它们不依赖巨额算力,但它们拥有严格的消融实验、清晰的机制分析、可复现的结果。这类论文不好写,但它们有价值,有可发表性,有学术尊严。

    重新定位自己的研究方向:

    "在消费级 GPU 上,通过分层验证,对小语言模型的训练算法 / 适配方法 / 数据策略做贡献。"

    二、先算清楚你的显存账

    在选路线之前,先把 12G 显存的边界算清楚。这是做研究最基础的素养之一。

    混合精度训练下,每个参数的显存占用有一个被广泛引用的理论基准:18 bytes/param(fp16 权重 2B + fp32 master weight 4B + fp32 梯度 4B + AdamW 两个优化器状态矩 8B)。这是 full fine-tuning 的静态下限,不含激活值。

    但做实验规划时,必须在这个基础上加上三项现实修正:

    第一项是激活值。激活值随序列长度和 batch size 线性增长,在不开 gradient checkpointing 的情况下可以占到权重显存的 30%~200%。开启 gradient checkpointing 之后可以把这部分压回约 20%,代价是训练速度下降约 15%~20%。

    第二项是显存碎片。CUDA 的显存分配器存在碎片化,实际可用显存比 nvidia-smi 显示的峰值数字低约 5%~10%。在显存紧张的实验里,这一点经常是最后卡死的原因。

    第三项是 paged optimizer 的 CPU offload 开销。使用 paged_adamw 时,optimizer state 会被分页到 CPU 内存,节省 GPU 显存约 4~8GB,但会带来轻微的 CPU-GPU 数据传输延迟。

    把这三项加进来之后,以下是各规模的实际显存区间(不是理论下限):

    60M 模型,全精度从零训练,开 gradient checkpointing:约 2~3GB。12G 里可以同时跑 4 组以上实验做对比。

    360M 模型,全精度从零训练,开 gradient checkpointing,seq=512,batch=4:约 6~8GB。这是最典型的机制验证配置,舒适可跑。如果你把 seq 拉到 1024、batch 提到 8,显存会升到 10~11GB,逼近 12G 边界。

    Qwen2.5-1.5B,QLoRA(NF4 + double quant + paged_adamw),seq=1024,batch=2,开 gradient checkpointing:约 6~8GB,12G 内有余量跑评测。如果你同时开启 evaluation 或把 seq 拉到 2048,峰值会到 10~11GB。

    这就是显存规划的核心逻辑:理论下限告诉你可不可能,实际区间告诉你舒不舒适。做实验之前,先用以下两行代码确认你的实际峰值:

    python

    import torch
    # 训练结束后(或训练若干步后)
    peak = torch.cuda.max_memory_allocated() / 1024**3
    reserved = torch.cuda.memory_reserved() / 1024**3
    print(f"峰值已分配: {peak:.2f} GB | 已保留(含碎片): {reserved:.2f} GB")

    报论文时,永远报 max_memory_allocated,不要报 memory_reserved,前者才是实际计算用到的数字,后者包含了 CUDA 为碎片预留的空间,会虚高。

    LoRA 和 QLoRA 改变的是什么?LoRA 冻结基座权重,只训练秩为 r 的低秩适配器。QLoRA 在此基础上把冻结的基座量化到 4-bit(NF4 格式),让它在显存里只占约 0.5 bytes/param。1.5B × 0.5 ≈ 0.75GB,加上 adapter 和优化器状态,在最优配置下总计约 5~6GB。但这是下限,不是正常实验条件——正常实验含评测、稍长序列,通常在 7~9GB 落地。

    记住这个区间,之后所有实验设计都从这里出发。

    三、三条可行路线,选一条出发

    根据 12G 显存的实际约束,以及当前小模型研究的学术空间,我把可行路线分为三类。

    路线 A:训练算法 / 优化器 / PEFT / 数据策略 / 蒸馏方法(首选)

    这是最容易出论文、也最能积累深度认知的方向。

    核心思路:提出或改进一种训练算法(比如一种更节省显存的优化器、一种更好的 LoRA 初始化策略、一种更高效的知识蒸馏方案),通过从零训练小模型来验证有效性,再在更大的开源底模上做扩展验证。

    机制验证阶段用 30M、60M、120M、360M 的小模型从零训练。扩展验证阶段用 Qwen2.5-0.5B 或 1.5B 上的 QLoRA / LoRA / 继续预训练。12G 显存在这个规模上绰绰有余,甚至可以同时跑多组实验对比。

    为什么这条路线首选?因为优化器、PEFT 方法、蒸馏策略是近年来顶会最活跃的方向之一。GaLore、APOLLO、DoRA、PiSSA、LoftQ、Adam-mini 等工作都是这个赛道的产物,而且这些工作都不需要巨大的算力来验证核心机制。

    路线 B:结构改动(次选)

    改 attention 机制、位置编码、MLP 设计、tokenizer 方案等结构层面的内容。这条路线同样可行,但对实验设计的要求更高——你必须给出非常干净的消融实验,清楚地分离"结构改动带来的收益"和"训练技巧带来的收益"。从零训练规模建议 30M、120M,扩展验证用 360M 或 Qwen2.5-0.5B。核心指标是困惑度(PPL)、长上下文效率、显存占用和推理速度。

    路线 C:RL / 推理 / 搜索类方法(谨慎选择)

    这条路线目前很热门,但对于刚入门研究的人来说,不建议作为第一个主方向。

    RL 训练极度不稳定,调参成本极高,很难在小模型上产生有说服力的结果;而且 GRPO、PPO 等方法的显存占用远比 SFT 更高,12G 的限制会更加明显。如果你对这个方向非常感兴趣,可以考虑只在小型可验证奖励任务(数学计算、形式推理)上尝试,但不要把它当成第一篇主论文的核心贡献点。

    四、省掉搭脚手架的时间:HuggingFace 官方 Model Trainer Skill

    在动手写代码之前,有一件事可以帮你节省大量时间,很多人不知道。

    HuggingFace 在 2025 年底发布了一个官方的 skills 仓库(github.com/huggingface/skills),专门为 Claude Code、Cursor、Gemini CLI 这类 AI 编程助手设计的插件集合。其中有一个 skill 叫 hugging-face-model-trainer,干的事情非常具体:让 AI 助手变成一个懂 TRL、懂 HF 生态、会估算显存和成本的训练专家。

    它覆盖的范围包括 SFT(监督微调)、DPO(直接偏好优化)、GRPO(在线强化学习)、Reward Modeling,以及 GGUF 转换、Trackio 实验监控、HF Jobs 云端调度,并内置了 train_sft_example.py、train_dpo_example.py、train_grpo_example.py 三个生产级模板脚本。

    关键点在哪里? 你不再需要从零摸索一个 SFT 训练脚本怎么写、LoRA config 怎么配、gradient checkpointing 在哪里开——这些"脚手架工作"全部可以交给挂了这个 skill 的 AI 助手来完成,符合 HF 的最佳实践,开箱即用。你只需要聚焦在你真正想改的算法部分上。

    安装方式

    如果你用 Claude Code:

    在 Claude Code 里运行

    /plugin marketplace add huggingface/skills
    /plugin install hugging-face-model-trainer@huggingface/skills

    如果你用 Cursor,仓库里的 .cursor-plugin/plugin.json 会自动被识别,直接 clone 后在 Cursor 里 install 即可。

    如果你不用任何 IDE 插件,也可以直接把 agents/AGENTS.md 的内容粘贴进你的对话上下文,同样有效。

    用法示例

    装好 skill 之后,用自然语言就能驱动它生成完整的训练配置:

    "用 SFT 在 Qwen2.5-0.5B 上跑我这个数据集,数据格式是 messages 列,启用 LoRA,量化 4-bit,跑 2 个 epoch,用 Trackio 监控。"

    AI 助手会自动帮你:根据模型大小选合适的 LoRA rank、配置 bitsandbytes 量化参数、生成含 PEP 723 依赖声明的标准 UV 脚本、设置 Trackio 实时监控、处理 HF Hub 推送认证。

    对于本地 12G 消费级 GPU 的场景,把 HF Jobs 相关的推送参数去掉,直接用生成的训练脚本在本地跑即可——训练逻辑本身完全一样。

    这个 skill 帮你省的是什么时间

    新手最容易卡死在哪里?不是算法理解,而是环境配置和模板搭建:tokenizer 的 padding_side 设错了导致结果异常,eos_token 没对齐 chat template,gradient checkpointing 和 use_cache 同时开了,数据集的列名不匹配……这类问题每一个都可以吃掉半天时间。

    hugging-face-model-trainer skill 把这些"踩坑知识"都固化在了模板里。你的时间应该花在设计实验和分析结果上,不应该花在调试这些与你的研究贡献毫无关系的细节上。

    一个具体的对话流程

    装好 skill 后,在 Claude Code 里这样说:

    markdown

    使用 hugging-face-model-trainer skill,帮我生成一个本地训练脚本:
    - 基座模型:Qwen/Qwen2.5-1.5B
    - 训练方法:SFT
    - 数据集格式:messages 列(conversational format)
    - 启用 QLoRA(4-bit NF4)
    - LoRA rank=16, alpha=32, target all-linear
    - gradient checkpointing 开启
    - batch_size=2, gradient_accumulation=8
    - bf16 混合精度
    - 2 epochs,cosine lr schedule
    - 不推送到 Hub,只保存本地

    AI 助手会生成一个完整的、可以直接运行的 train.py,包含所有正确的配置,你可以直接在上面改你想测试的算法部分,而不是从头写。

    五、技术栈怎么选:以 Hugging Face 生态为核心

    好的研究离不开好的工具链。我这里给出一套以 Hugging Face 官方生态为核心的方案——之所以选 HF 生态而不是其他框架,原因只有一个:标准化。同一套代码跑 20 种 PEFT 方法对比,同一套评测框架跑 100 个 benchmark,论文里的 Table 1 才有可信度。

    整个工具链分为四层:数据层、训练层、评测层、监控层,以下逐层说清楚。

    4.1 环境安装:一行命令把所有东西装好

    bash

    pip install transformers>=4.40.0 \
                trl>=0.8.0 \
                peft>=0.10.0 \
                bitsandbytes>=0.43.0 \
                datasets \
                accelerate \
                lm-eval \
                flash-attn --no-build-isolation

    这六个包是完整生态的最小子集:transformers 是基座,trl 负责训练(SFTTrainer / GRPOTrainer / DPOTrainer),peft 负责 LoRA / QLoRA 的 adapter 管理,bitsandbytes 负责量化(4-bit / 8-bit),datasets 负责数据加载,lm-eval 负责 benchmark 评测。

    4.2 从零预训练小模型:用 Transformers + Trainer

    这是路线 A 机制验证阶段的主战场。你需要定义一个小 GPT 架构,然后用 HF Trainer 从零跑起来。

    下面是一个完整的可运行示例,训练一个 60M 参数的 GPT-2 风格模型:

    python

    from transformers import (
        GPT2Config, GPT2LMHeadModel,
        AutoTokenizer, TrainingArguments, Trainer,
        DataCollatorForLanguageModeling
    )
    from datasets import load_dataset
    
    # ① 定义 60M 参数的小模型架构
    config = GPT2Config(
        vocab_size=50257,
        n_positions=512,
        n_embd=512,       # hidden size
        n_layer=8,        # transformer 层数
        n_head=8,         # attention head 数
        n_inner=2048,     # FFN 中间维度
    )
    model = GPT2LMHeadModel(config)
    print(f"模型参数量: {sum(p.numel() for p in model.parameters()) / 1e6:.1f}M")
    # → 约 60M
    
    # ② 加载 tokenizer 和数据集(TinyStories 作为示例)
    tokenizer = AutoTokenizer.from_pretrained("gpt2")
    tokenizer.pad_token = tokenizer.eos_token
    
    dataset = load_dataset("roneneldan/TinyStories", split="train[:5%]")
    
    def tokenize(examples):
        return tokenizer(
            examples["text"],
            truncation=True,
            max_length=512,
            padding="max_length"
        )
    
    tokenized = dataset.map(tokenize, batched=True, remove_columns=["text"])
    
    # ③ 配置训练参数——注意这几个节省显存的关键开关
    training_args = TrainingArguments(
        output_dir="./output/60m-baseline",
        num_train_epochs=3,
        per_device_train_batch_size=8,
        gradient_accumulation_steps=4,    # 等效 batch size = 32
        gradient_checkpointing=True,      # 用计算换显存,省约 40% 激活值占用
        bf16=True,                        # Ampere 架构(RTX 30/40 系)必开
        optim="adamw_torch",              # 基线优化器
        learning_rate=3e-4,
        lr_scheduler_type="cosine",
        warmup_ratio=0.05,
        logging_steps=100,
        save_steps=500,
        eval_strategy="steps",
        eval_steps=500,
        dataloader_num_workers=4,
        dataloader_pin_memory=True,
        report_to="tensorboard",          # 或 "wandb"
    )
    
    data_collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm=False)
    
    trainer = Trainer(
        model=model,
        args=training_args,
        train_dataset=tokenized,
        data_collator=data_collator,
    )
    
    trainer.train()

    想换优化器做对比实验?只需改 optim 参数一行:

    python

    # 8-bit Adam(bitsandbytes 提供,显存比标准 AdamW 少约 50%)
    optim="adamw_bnb_8bit"
    
    # paged AdamW(更适合 QLoRA 场景,可以把优化器状态分页到 CPU 内存)
    optim="paged_adamw_32bit"

    这正是 HF Trainer 的核心价值——同一个框架,几乎不改代码,就能把多种优化器串起来做公平对比。

    4.3 PEFT 微调 / QLoRA:用 TRL 的 SFTTrainer

    当你进入扩展验证阶段,需要在 Qwen2.5-0.5B 和 1.5B 上做 LoRA / QLoRA 训练时,HF 官方推荐的方案是 TRL(Transformer Reinforcement Learning)库 里的 SFTTrainer。

    它是 HF Trainer 的子类,在此基础上封装了:数据集格式自动转换(instruction format 或 conversational format)、completion-only loss(只对回答计算 loss,不对 prompt)、dataset packing(把短样本打包提升吞吐),以及与 PEFT 的原生集成。

    下面是 Qwen2.5-1.5B 的完整 QLoRA 训练示例:

    python

    import torch
    from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
    from peft import LoraConfig, get_peft_model
    from trl import SFTTrainer, SFTConfig
    from datasets import load_dataset
    
    # ① 4-bit 量化配置(NF4 是 QLoRA 论文推荐的量化类型)
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.bfloat16,   # 计算时用 bf16,不损失梯度精度
        bnb_4bit_use_double_quant=True,           # 二次量化,再省约 0.4 bits/param
    )
    
    # ② 加载量化后的基座模型(1.5B × 0.5 bytes ≈ 0.75GB)
    model = AutoModelForCausalLM.from_pretrained(
        "Qwen/Qwen2.5-1.5B",
        quantization_config=bnb_config,
        device_map="auto",
        trust_remote_code=True,
    )
    model.config.use_cache = False   # 训练时关掉 KV cache
    
    tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-1.5B")
    tokenizer.pad_token = tokenizer.eos_token
    tokenizer.padding_side = "right"
    
    # ③ LoRA 配置(只训练 adapter,不动基座)
    lora_config = LoraConfig(
        r=16,                        # 秩,越大参数越多显存越高,16 是经典平衡点
        lora_alpha=32,               # 缩放因子,通常设为 2r
        target_modules=[             # 哪些层挂 adapter,all-linear 是常用选择
            "q_proj", "k_proj", "v_proj", "o_proj",
            "gate_proj", "up_proj", "down_proj"
        ],
        lora_dropout=0.05,
        bias="none",
        task_type="CAUSAL_LM",
    )
    
    # ④ 数据集(这里用 TinyStories 作为演示,换成你的领域数据即可)
    dataset = load_dataset("roneneldan/TinyStories", split="train[:2%]")
    
    # ⑤ SFTConfig + SFTTrainer
    sft_config = SFTConfig(
        output_dir="./output/qwen2.5-1.5b-qlora",
        num_train_epochs=1,
        per_device_train_batch_size=2,
        gradient_accumulation_steps=8,       # 等效 batch 16
        gradient_checkpointing=True,
        bf16=True,
        optim="paged_adamw_32bit",
        learning_rate=2e-4,
        lr_scheduler_type="constant",
        warmup_ratio=0.03,
        max_seq_length=1024,
        packing=True,                         # dataset packing,大幅提升吞吐
        logging_steps=50,
        save_strategy="epoch",
        eos_token="<|im_end|>",               # Qwen 系列必须对齐 EOS token
    )
    
    trainer = SFTTrainer(
        model=model,
        args=sft_config,
        train_dataset=dataset,
        peft_config=lora_config,
        processing_class=tokenizer,
    )
    
    trainer.train()
    
    # ⑥ 保存 adapter(只有约几十 MB,不含基座)
    trainer.save_model("./output/qwen2.5-1.5b-qlora-adapter")

    训练完成后,如果想把 adapter 合并到基座做推理,两行代码:

    python

    from peft import PeftModel
    
    base = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-1.5B", torch_dtype=torch.bfloat16)
    merged = PeftModel.from_pretrained(base, "./output/qwen2.5-1.5b-qlora-adapter")
    merged = merged.merge_and_unload()     # 合并并卸载 adapter
    merged.save_pretrained("./output/qwen2.5-1.5b-merged")

    4.4 引入新优化器:以 APOLLO 为例

    如果你的研究方向是优化器,下面展示如何把 APOLLO 挂进 HF Trainer 做对比实验。APOLLO 是 MLSys 2025 年度荣誉提名,它最核心的 claim 是:用随机投影代替 GaLore 的 SVD,把优化器状态压缩到接近 SGD 的水平,同时保持 AdamW 级别的训练质量。更极端的 APOLLO-Mini 只用秩为 1 的辅助子空间,结合权重量化可以在 12GB 显存内预训练 LLaMA-7B。

    bash

    pip install apollo-torch

    python

    from apollo_torch import APOLLOOptimizer
    from transformers import TrainingArguments, Trainer
    from transformers.trainer_utils import OptimizerNames
    
    # 方式一:用 HF Trainer 的自定义优化器接口
    class APOLLOTrainer(Trainer):
        def create_optimizer(self):
            # 分组参数:bias 和 LayerNorm 不做 weight decay
            decay_params = [
                p for n, p in self.model.named_parameters()
                if p.requires_grad and "bias" not in n and "norm" not in n.lower()
            ]
            no_decay_params = [
                p for n, p in self.model.named_parameters()
                if p.requires_grad and ("bias" in n or "norm" in n.lower())
            ]
            self.optimizer = APOLLOOptimizer(
                [
                    {"params": decay_params, "weight_decay": 0.01},
                    {"params": no_decay_params, "weight_decay": 0.0},
                ],
                lr=self.args.learning_rate,
                rank=64,          # 辅助子空间的秩,越小越省显存
                scale=1.0,
            )
            return self.optimizer

    这个模式可以直接平移到任何你想测试的自定义优化器上。替换掉 APOLLOOptimizer,换成你提出的优化器实现,其他代码不变——这就是论文里的 baseline 对比方案。

    4.5 显存监控:训练前必做的一步

    很多初学者不养成监控显存的习惯,跑到 OOM 了才去排查。正确做法是在 TrainingArguments 里打开显存 profiling,或者手动插一行:

    python

    # 在 trainer.train() 之前加这两行,训练结束后会打印详细显存报告
    training_args = TrainingArguments(
        ...
        skip_memory_metrics=False,   # 默认是 True,改成 False 才会报告显存
    )

    或者更直接地,在启动训练后用另一个终端监控:

    watch -n 0.5 nvidia-smi

    你需要关注的数字是 peak VRAM(峰值显存),不是平均值。这个数字就是你论文里"效率指标"一列要报告的内容。

    4.6 评测:lm-evaluation-harness

    评测是研究的最后一公里,不能糊弄。

    bash

    pip install lm-eval
    
    # 评测你训练好的模型,跑 MMLU 和 C-Eval
    lm_eval \
        --model hf \
        --model_args pretrained=./output/qwen2.5-1.5b-merged,dtype=bfloat16 \
        --tasks mmlu,ceval-valid,gsm8k \
        --device cuda:0 \
        --batch_size auto \
        --output_path ./eval_results/

    如果你的模型还没有 merge(还是 adapter 形式),加一个参数:

    bash

    --model_args pretrained=Qwen/Qwen2.5-1.5B,peft=./output/qwen2.5-1.5b-qlora-adapter

    评测结果会自动保存成 JSON,方便你写进论文。

    六、模型怎么选:具体用哪些

    不要花太多时间在"选模型"这件事上。以下就是你需要的所有模型,选好了别换。

    从零训练梯队(验证你的算法机制)用自定义 GPT 架构,规模依次是约 30M、约 60M、约 120M、约 360M。其中 360M 可以参考 SmolLM2-360M 的架构设计——它是 Hugging Face 2025 年发布的小模型家族成员,在 4T tokens 上训练,同规模中性能领先,是极好的参考架构和对比基线。

    微调和扩展验证梯队:Qwen2.5-0.5B(主力扩展验证模型,QLoRA / LoRA / 继续预训练均可)、Qwen2.5-1.5B(更高一档的验证点,4-bit QLoRA 在 12G 内可跑)、SmolLM2-360M base(可做继续预训练对比)。如果你研究的是代码方向,把 Qwen2.5-Coder-0.5B / 1.5B 替换进来即可,路线不变。

    七、实验设计:三层验证,缺一不可

    这是这篇文章最核心的部分。论文能不能发出去,往往不取决于你的想法有多新颖,而取决于你的实验是否让人信服。

    第一层:机制验证(必须做,且必须干净)

    目标:在严格控制变量的情况下,证明你的方法比基线更好。

    配置:至少两个规模的小模型(30M、60M、120M 中取两个)。Tokenizer 固定,不换。数据固定,不换(推荐 TinyStories 或小型通用语料)。训练步数固定,不换。只改你提出的算法本身。

    指标:train loss / val loss、perplexity(PPL)、峰值显存(peak VRAM)、训练吞吐(tokens/s)。

    这一层的核心是变量控制。如果你同时改了模型结构、换了数据、改了学习率调度,那你什么都没证明。

    第二层:扩展验证(强烈建议做)

    目标:证明你的方法不只在玩具规模有效,在更大的模型上趋势一致。

    配置:模型规模换到 360M 或 Qwen2.5-0.5B,做 3 个随机种子,报均值和方差。

    为什么要做多种子?因为审稿人会问:你的结果是偶然好的还是稳定好的?3 个种子的均值和方差是对这个问题最直接的回答。

    设置随机种子的代码:

    python

    import random, numpy as np, torch
    
    def set_seed(seed: int):
        random.seed(seed)
        np.random.seed(seed)
        torch.manual_seed(seed)
        torch.cuda.manual_seed_all(seed)
    
    # 在 TrainingArguments 里也设置
    training_args = TrainingArguments(
        ...
        seed=42,       # 换成 0, 42, 123 跑三次
        data_seed=42,
    )

    第三层:现实落地(非常关键,经常被忽视)

    目标:在真实的开源底模上,证明你的方法可以用于实际场景。

    配置:在 Qwen2.5-0.5B 或 1.5B 上,用 QLoRA / LoRA / 继续预训练的形式应用你的方法。用 lm-evaluation-harness 跑标准 benchmark。

    指标:任务分数(MMLU、C-Eval 等)、显存占用、训练吞吐、训练稳定性(loss 曲线是否平稳)。

    第三层解决的问题是:"好,你在从零训练的玩具场景里证明了你的方法有效,那它在真实微调场景里还有效吗?能用吗?"这个问题不回答,论文的实用价值存疑。

    八、评测指标一定要全面

    很多初学者的论文只报任务分数,这是不够的。一篇以"低资源、消费级 GPU"为背景的论文,效率指标和稳定性指标和任务分数同等重要。

    建议你的主表至少覆盖以下四类:

    第一类,语言建模指标:验证集 loss、perplexity(PPL)。这是最基础的指标,可以在不依赖评测框架的情况下快速比较不同方法。

    第二类,任务指标:根据你的方向选择。MMLU-Pro 用于英文综合知识评测,C-Eval / CMMLU 用于中文知识评测,GSM8K 用于数学推理能力,HellaSwag 用于常识推理和预训练质量验证。

    第三类,效率指标:峰值显存(Peak VRAM,单位 GB)、训练吞吐(tokens per second)、单步时间(step time)。

    第四类,稳定性指标:3 个或更多随机种子下的均值和标准差。这是证明你的方法不是"运气好"的关键证据。

    测量训练吞吐的代码:

    python

    import time, torch
    
    def measure_throughput(trainer, steps=100):
        """在正式训练前跑几步测速"""
        model = trainer.model
        dataloader = trainer.get_train_dataloader()
        model.train()
    
        start = time.time()
        total_tokens = 0
    
        for i, batch in enumerate(dataloader):
            if i >= steps:
                break
            batch = {k: v.to(model.device) for k, v in batch.items()}
            outputs = model(**batch)
            outputs.loss.backward()
            total_tokens += batch["input_ids"].numel()
    
        elapsed = time.time() - start
        tokens_per_sec = total_tokens / elapsed
    
        peak_vram = torch.cuda.max_memory_allocated() / 1024**3
        print(f"吞吐量: {tokens_per_sec:.0f} tokens/s")
        print(f"峰值显存: {peak_vram:.2f} GB")
    
        return tokens_per_sec, peak_vram

    九、论文可以怎么写

    如果你按照上面的路线认真执行,你会拥有充足的实验结果来支撑一篇论文。这里给三个最小可发表的论文方向,供你对号入座。

    方向一:低显存训练算法论文

    实验组合:模型规模覆盖 60M / 120M / 360M / Qwen2.5-0.5B,基线选 AdamW、8-bit Adam、GaLore / APOLLO(根据你的方法类型选择),数据用 TinyStories + 领域语料或小型通用语料,主表指标覆盖 val loss、PPL、任务分数、峰值显存、tokens/s、训练稳定性。

    写作重点:你的方法相比基线,在节省显存的同时,不损失甚至提升了训练质量;并且在多个模型规模上趋势一致。

    方向二:数据策略 / 知识蒸馏论文

    实验组合:教师模型选更强的开源模型或 API(如 Qwen2.5-7B 或更大),学生模型用 360M / Qwen2.5-0.5B / 1.5B,对比条件覆盖真实数据、过滤后数据、合成数据、蒸馏数据,指标覆盖任务分数、泛化能力、显存、训练成本。

    写作重点:数据构建策略或蒸馏方案带来了显著的性能提升;在多种底模上趋势一致;成本可控。

    方向三:结构改动论文

    实验组合:模型规模用 30M / 120M / 360M(从零训练),核心指标是 PPL、长上下文效率、显存、推理速度,必须给出 clean ablation——去掉你的改动之后 baseline 是什么,加上之后提升是什么,如果有多个子组件逐一消融。

    写作重点:你的结构改动带来了可量化的改进,在控制其他变量的前提下,改动本身就是提升的来源。

    十、要避开的坑

    坑一:从零训练 1B 以上的模型

    不是不可能,是性价比极低。12G 显存训练 1B 以上的模型,batch size 会被压得极小,训练速度极慢,实验周期拖长到几个月,严重影响迭代速度。你的竞争对手在 A100 上两天跑完的实验,你可能要跑三周——这种差距无法用方法的优越性弥补。

    坑二:只在一个 benchmark 上刷分

    这会让审稿人认为你是在针对特定数据集做优化,而不是提出了一个通用方法。用至少两个独立的评测集,在多个模型规模上报数,才有说服力。

    坑三:把 RLHF / GRPO 当成第一个主项目

    RL 训练的调试成本极高,对初学者非常不友好。先用 SFT 路线稳扎稳打,等你对整个工具链和实验设计都有了足够的感觉,再考虑进入 RL 方向。TRL 库确实提供了 GRPOTrainer,但调通一个收敛稳定的 GRPO 实验,需要的经验比 SFT 多得多。

    坑四:不做效率统计

    如果你的论文声称自己的方法在消费级 GPU 上可用,但没有报显存占用,那是无法说服任何人的。峰值显存是你的核心卖点,一定要认真测量并报告。

    坑五:用 gradient_checkpointing 但忘了关 use_cache

    这是初学者最常见的代码错误之一。gradient checkpointing 和 KV cache 不能同时开启,否则显存反而会更高。每次开启 gradient checkpointing,必须同时设置 model.config.use_cache = False。

    十一、你必须知道的时间账:从小模型到一篇论文要多久

    这是很多入门文章刻意回避的话题,但我认为必须说清楚——不是为了吓退你,而是让你的实验计划有现实基础。

    先从吞吐量说起。12G 显存的消费级 GPU(RTX 3060 12G / RTX 4070 12G 等)在训练小模型时,实际 tokens/s 的经验范围大致如下:

    60M 模型,bf16,seq=512,batch=8,开 Flash Attention:约 50,000~90,000 tokens/s。

    360M 模型,bf16,seq=512,batch=4,开 Flash Attention:约 15,000~30,000 tokens/s。

    Qwen2.5-1.5B,QLoRA,seq=1024,batch=2:约 2,000~5,000 tokens/s(adapter 部分的有效计算量小得多,但 forward pass 仍要走完整个基座)。

    有了这个基础数字,就能把论文周期算清楚:

    机制验证阶段(60M + 120M,各跑 1B tokens,3 个种子):60M 在 80k tok/s 下 1B tokens 需约 3.5 小时;120M 约 8 小时。三个种子 × 两个规模 = 约 70 小时,即不到三天。这个周期是可接受的。

    扩展验证阶段(360M,1B tokens,3 个种子):360M 在 20k tok/s 下 1B tokens 需约 14 小时;三个种子 = 约 42 小时,即不到两天。

    完整消融实验(5 个 ablation 条件,360M,各跑 500M tokens):5 × 7 小时 × 3 种子 ≈ 105 小时,约 4~5 天。

    加上 Qwen2.5-0.5B 的扩展验证和 lm-eval 评测:再加 1~2 天。

    全部算下来:一篇严格的小模型算法论文,从零到实验全部跑完,大约需要 2~4 周的机器时间。这里面不包括代码 debug、调参、写作的人力时间——通常后者才是真正的大头。

    有两件事可以显著压缩这个周期。

    第一件:先用 60M + 100M tokens 做快速验证,确认方法有效再放大。不要一上来就跑 360M × 3 seeds,先用最小规模确认 loss 曲线的趋势对了,再投入完整实验。

    第二件:善用 HuggingFace datasets 的 select 方法快速切片:

    python

    from datasets import load_dataset
    
    # 先用 1% 的数据跑通整个流程
    dataset = load_dataset("roneneldan/TinyStories", split="train")
    small = dataset.select(range(len(dataset) // 100))   # 1%
    
    # 验证无误后再用完整数据
    full = dataset  # 全量数据

    时间是有限的,实验设计要对它诚实。

    十二、数据不是门槛,但你需要知道怎么选

    算法研究中,数据问题常常被两种极端态度处理:要么完全忽视("反正我只验证算法"),要么过度担忧("我没有大规模语料怎么发论文")。两种都不对。

    正确理解是:对于小模型算法验证,数据质量是可控变量,而不是门槛。真正的门槛是:你能不能把数据固定住,确保不同方法的对比公平。

    学术界对此已经有成熟解法——直接使用开源的高质量语料,不需要自己建数据 pipeline。以下是几个经过验证、可以直接拿来用的选择:

    TinyStories(roneneldan/TinyStories):专门为小模型设计的合成故事语料,约 2B tokens,语言简洁,PPL 下降快,适合 60M~360M 规模的机制验证。是最低摩擦的起点。

    FineWeb-Edu(HuggingFace/FineWeb-edu):HuggingFace 官方出品,15T tokens 的高质量教育类网页文本,经过 70 多个消融实验调校的过滤策略,已被 SmolLM2 等多个顶级小模型使用。用它的采样子集(5~10B tokens)做从零训练,结果更接近真实预训练场景,reviewer 会更认可。

    DCLM-Baseline(mlfoundations/dclm-baseline-1.0):DataComp-LM 项目发布的开源高质量通用语料,1.7T tokens,同规模下在多项 benchmark 上超过其他通用语料。适合想做认真对比实验的场景。

    对于中文研究:CCI3-HQ、Chinese FineWeb-Edu(基于 Qwen 过滤的中文高质量语料)是当前最主流的选择。

    关键原则只有一个:在同一篇论文里,所有对比方法必须用完全相同的数据切片、相同的 tokenizer、相同的数据顺序。换句话说,用 dataset.select(range(N)) 切出你的实验子集之后,把这个切片 seed 和 N 写进代码注释,所有实验共用同一份。这一点做到了,数据就不再是问题,而是你实验严谨性的一部分。

    现代预训练研究(包括 Chinchilla scaling law)已经确立了一个基准:一个模型要训练到质量收敛,所需的 token 数量大约是参数量的 20 倍。60M 模型需要约 1.2B tokens;360M 模型需要约 7B tokens。在算法验证阶段,你通常不需要跑到完全收敛——跑到趋势稳定、不同方法之间的相对排名清晰即可。1B tokens 对 60M、2~3B tokens 对 360M,是机制验证的经济点。

    十三、一个立刻可以开工的起点

    理论讲了这么多,你现在应该做什么?一个最小可行的开工方案,按步骤执行。

    Step 1:确定你真正想改的对象

    从以下几个方向里选一个,选你最有感觉的那个:优化器(能不能做一个比 AdamW 更节省显存的优化器变体?)、LoRA 初始化方案(能不能改进 PiSSA 或 LoftQ 的初始化策略?)、量化初始化(QLoRA 在量化时损失了多少信息?能否补偿?)、数据混合策略(在小模型预训练时,不同领域数据的最优配比是什么?)、知识蒸馏方案(如何让 360M 的模型更好地学习 7B 模型的输出分布?)。

    Step 2:搭环境,用 TinyStories 验证整个训练链路能跑通

    bash

    pip install transformers trl peft bitsandbytes datasets accelerate lm-eval
    python -c "import torch; print(torch.cuda.get_device_name(0))"
    # 确认 GPU 能被识别,显存打印出来
    python -c "import torch; print(torch.cuda.get_device_properties(0).total_memory / 1024**3, 'GB')"

    然后用上面 4.2 节的代码跑一个 60M 的模型,确认 loss 在下降、显存在预期范围内、tensorboard 能看到曲线。

    Step 3:实现你的算法改动,挂进 Trainer

    最简单的介入方式是重载 compute_loss 或者替换 create_optimizer,不需要改 Trainer 的其他部分。

    python

    class MyMethodTrainer(Trainer):
        def compute_loss(self, model, inputs, return_outputs=False, **kwargs):
            # 在这里加入你的 loss 改动
            outputs = model(**inputs)
            loss = outputs.loss
    
            # 比如加一个辅助正则项
            # my_reg = compute_my_regularizer(model)
            # loss = loss + 0.01 * my_reg
    
            return (loss, outputs) if return_outputs else loss

    Step 4:跑三个随机种子,把结果整理成 CSV

    python

    seeds = [0, 42, 123]
    results = []
    for seed in seeds:
        set_seed(seed)
        # ... 训练代码 ...
        result = trainer.evaluate()
        results.append(result)
    
    import pandas as pd
    df = pd.DataFrame(results)
    print(df.describe())  # 均值和标准差就在这里

    Step 5:用 lm-eval 统一评测,把峰值显存、tokens/s、精度、稳定性做成主表

    这张表就是你论文 Table 1 的雏形。

    十四、最后说几句真心话

    我见过很多人因为算力不够而放弃研究,觉得自己的硬件配置让自己"不够格"。

    我想对你说:这是一个错误的感受。

    学术研究的价值不来自你用了多少张卡,而来自你的方法是否有洞见,你的实验是否严格,你的分析是否深刻。你 12G 显存跑出来的实验,如果控制变量严格、多种子验证充分、基线比较公平,比某些用 A100 集群但实验设计一团糟的工作更有说服力。

    更何况,你的资源约束本身就是研究的价值所在。面向消费级 GPU 的高效训练方法,在今天是一个有真实需求的研究方向。你不是在"凑合",你是在研究一个真实存在的、有意义的问题。

    小模型不是退而求其次,小模型是独立的研究对象。

    Hugging Face 的 SmolLM2-360M,训练在 4 万亿个 token 上,同等规模性能领先,它被用于手机、嵌入式设备、边缘计算场景。阿里的 Qwen2.5-1.5B,训练在 18 万亿个 token 上,是目前同量级最强的开源模型之一。围绕这些模型的训练方法、适配策略、效率优化,有大量悬而未决的研究问题。

    MLSys 2025 年荣誉提名的 APOLLO,它的 story 说的就是:用 12GB 显存从零训练 LLaMA-7B。这不是幻想,这是今年刚发表的顶会成果。这个方向有学术空间,有工程价值,有真实动机,而你站在起跑线上。

    你的 12G 显存,刚好可以触摸到这些问题的核心。

    去做吧。扎实地做。

    附录:工具与资源速查

    核心工具链(HuggingFace 生态)

    transformers(基座训练框架):github.com/huggingface/transformers,包含 Trainer、TrainingArguments、所有预训练模型。

    TRL(SFT / DPO / GRPO 训练):github.com/huggingface/trl,SFTTrainer 是微调小模型的最简路径,命令行一行即可启动:trl sft –model_name_or_path Qwen/Qwen2.5-0.5B –dataset_name trl-lib/Capybara –output_dir my-output。

    PEFT(LoRA / QLoRA / DoRA / PiSSA):github.com/huggingface/peft,管理所有 adapter,支持 merge_and_unload 合并推理。

    bitsandbytes(量化):github.com/TimDettmers/bitsandbytes,4-bit / 8-bit 量化加载,QLoRA 的关键依赖。

    lm-evaluation-harness(评测):github.com/EleutherAI/lm-evaluation-harness,支持 MMLU、C-Eval、CMMLU、GSM8K、HellaSwag 等几百个任务,学术界通用标准。

    Lighteval(多后端评测 / 逐样本分析):github.com/huggingface/lighteval,HF 官方用它评测 SmolLM2 系列,支持更精细的结果分析。

    推荐模型(从小到大)

    SmolLM2-135M / 360M / 1.7B:从零训练参考架构 / 小模型基线,4T tokens 训练,HF 官方出品。

    Qwen2.5-0.5B:主力扩展验证模型,7T tokens 训练,SFT / QLoRA 均可。

    Qwen2.5-1.5B:更高档验证点,18T tokens 训练,4-bit QLoRA 在 12G 内舒适可跑。

    Qwen2.5-Coder-0.5B / 1.5B:代码方向专用,路线不变只换模型名。

    值得跟踪的近期算法方向

    APOLLO / APOLLO-Mini(MLSys 2025 荣誉提名):内存效率达到 SGD 级别同时保持 AdamW 性能,已集成进 LLaMA-Factory,pip install apollo-torch。

    DoRA(Weight-Decomposed Low-Rank Adaptation):LoRA 的改进版,把权重分解为幅度和方向,微调效果优于 LoRA,已集成进 PEFT。

    PiSSA(Principal Singular Values and Singular Vectors Adaptation):用 SVD 初始化 LoRA 的 A、B 矩阵,收敛更快。

    LoftQ(LoRA-Fine-Tuning-Aware Quantization):在量化时同步初始化 LoRA adapter,减少量化误差,适合 QLoRA 场景。

    Spectrum(Signal-to-Noise Ratio based PEFT):根据 SNR 选择要训练的层,比全量 LoRA 更精准,30% SNR 层的效果在 GSM8K 上比 QLoRA 高约 4%。

    如果你在执行过程中遇到具体的技术问题,欢迎随时来找我。路线是对的,剩下的只是时间和耐心。

    写在最后

    写完这些,我想起另一篇文章——我写过穷人没教育、寒门无贵子。

    X 上的 AI最严厉的父亲:“穷人没教育,寒门无贵子” / X

    有人说我悲观,但我觉得那不是悲观,那是诚实。12G 显存能不能做研究,这个问题的答案是能;但同样一张显卡,放在不同人手里,起点从来就不一样。有人从小被人告知"你可以",有人从小被告知"别想了"。技术可以被教,工具链可以被学,可那个敢开口问"够吗"的勇气,很多人从来没被给过。所以这篇文章我不只是写给有显卡的人,也写给那些还在犹豫自己够不够格的人——够的,你坐下来,我们一起算。
    来源:https://x.com/dashen_wang/article/2038970877732380924

  • 别买黑盒了,自己造一个知道”自己有多蠢”的量化预测系统

    别买黑盒了,自己造一个知道”自己有多蠢”的量化预测系统

    华尔街的量化基金每天都在因为AI的盲目自信爆仓。一个号称胜率80%的黑盒模型,把它的说明书拆开来看,里面十有八九是用文本生成的那套逻辑强行套在金融时序上——等同于让文科状元去拆炸弹,拆成功了是运气,炸了是必然。

    与其花大价钱买别人的棺材,不如花几个小时,在你手头的编辑器里,亲手造一口专门装自己无知的盒子。

    这就是本文要做的事。

    一、先把规矩刻在石头上:劫持云端代理的第一道指令

    工具不对,累死白费。

    huggingface/skills 本质上是一套遵循 Model Context Protocol (MCP) 标准的接口包,兼容 Claude Code、Codex、Gemini CLI 和 Cursor,让你的本地 AI 助手直接调动 Hugging Face 云端的计算资源和工具链。在你的项目根目录建一个 .mcp.json,或者通过 Claude Code 挂载:

    bash

    claude mcp add --transport http hf-skills https://huggingface.co/mcp?bouquet=skills \
      --header "Authorization: Bearer $HF_TOKEN"

    挂上之后,你就拥有了三把核心武器:hugging-face-datasets(拉数据)、hugging-face-jobs(上云炼丹)、hugging-face-trackio(实时盯大盘)。

    但在动手之前,必须先下一道硬性禁令。

    向你的 AI 助手发出第一道死命令:"接下来所有开发,禁止调用 hugging-face-model-trainer 这个针对大语言模型微调的预设技能。我们要从零手写时间序列神经网络,通过 hugging-face-jobs 把定制化的 PyTorch 脚本推到云端 GPU 执行。"

    为什么要禁?因为 hugging-face-model-trainer 走的是大模型训练路线——那是调教会说话的语言模型的逻辑,不是预测金融时序的逻辑。把它们混用,就像拿锤子拧螺丝:形状上有那么点相似,但你会把整个工件拧废。

    规矩定好,我们开始搭架子。

    二、截断黑天鹅:数据处理的第一课就是认清边界

    任何预测模型的生死,在喂入第一口数据的时候就注定了。

    加密货币的走势是典型的"胖尾分布"——大多数时候风平浪静,但一根黑天鹅行情可以在几分钟内吞掉你三个月的利润。很多新手喜欢把这些极端数据原封不动塞给网络,指望AI能学会"预测黑天鹅"。

    试图用历史数据拟合偶发的黑天鹅,是量化交易员破产的最快路径。 你的模型学不会捕捉它,它只会被那根惊天大阳线污染,然后在下一次正常行情里胡乱放炮。

    正确的做法是:承认模型的边界,然后在边界处装上物理护栏。

    动用 hugging-face-datasets 拉取 BTC、ETH 在内的11种高流动性加密货币的日线数据(2020年至今),然后在数据处理脚本里写死一道过滤网:

    第一步计算每天的对数收益率——简单说就是今天收盘价除以昨天收盘价取对数,公式写出来是 rₜ = log(Pₜ / Pₜ₋₁),比直接算涨跌幅更能压缩极端值、对称处理涨跌。

    第二步截断极端值——把历史上最疯的1%和最惨的1%直接抹平,不是假装它们不存在,而是承认模型根本消化不了。

    第三步独立标准化——每个交易标的单独做零均值单位方差处理,防止比特币的绝对价格波动把以太坊的信号淹没。

    第四步构造滑动窗口——用过去50天的数据预测第51天,50这个数字是 ProbFM 原始论文的设定。

    python

    import numpy as np
    import pandas as pd
    from sklearn.preprocessing import StandardScaler
    
    def process_crypto_data(df, lookback=50):
        # 对数收益率:rₜ = log(Pₜ / Pₜ₋₁)
        df['log_return'] = np.log(df['close'] / df['close'].shift(1))
        df = df.dropna()
        
        # 物理隔离黑天鹅:1%到99%的硬截断
        # 注意:分位数用训练集历史分布计算,不能用全集,否则就是数据泄露
        lower_bound = df['log_return'].quantile(0.01)
        upper_bound = df['log_return'].quantile(0.99)
        df['clipped_return'] = df['log_return'].clip(lower=lower_bound, upper=upper_bound)
        
        # 独立标准化,零均值单位方差
        scaler = StandardScaler()
        df['scaled_return'] = scaler.fit_transform(df[['clipped_return']])
        
        # 构造50步长的滑动窗口序列
        X, y = [], []
        returns = df['scaled_return'].values
        for i in range(len(returns) - lookback):
            X.append(returns[i:(i + lookback)])
            y.append(returns[i + lookback])
            
        return np.array(X), np.array(y), scaler

    这段代码没有花哨的特征工程。认清模型的边界,是建立不确定性系统的第一课。 截断的不是黑天鹅本身,而是你对它的幻觉。

    补充说明:近期学界对加密货币波动率的研究证实,概率预测方法在捕捉极端行情风险方面显著优于传统的确定性点预测。当没有任何一种模型在所有资产和误差指标上稳定压制其他模型时,对不确定性的精确量化反而成了更有价值的输出。这正是我们下一步要做的事。

    三、造一个会承认"我不知道"的神经网络:NIG输出头的正确姿势

    数据准备好了,现在来做最关键的架构改造:把传统的线性输出层直接砸掉,换上一个深度证据回归(Deep Evidential Regression,DER)的输出头。

    过去的量化网络只会吐出一个数字,告诉你"明天大概率涨2%"。好一点的会输出均值加方差,假装自己懂概率。但这些都不够。我们要的是一个模型,在单次前向传播中同时输出四个参数:

    • μ(mu):预测的方向和幅度,就是模型认为明天会涨多少
    • λ(lambda):模型对这个预测积累了多少"证据",越大越自信
    • α(alpha):控制不确定性分布的形状,必须大于1,小于1整个数学结构崩塌
    • β(beta):不确定性的尺度,越大表示模型越觉得市场不可预测

    这四个数字共同构成一个完整的正态-逆伽马(NIG)先验分布。听起来复杂,实际上就是一句话:它不只告诉你预测结果,还告诉你这个预测结果有多不可靠。

    ProbFM 的核心创新就在于此:让模型同时具备三种能力——不预先设定分布族、将认知不确定性和偶然不确定性显式拆分、单次推理完成完整不确定性量化,不需要跑几十次采样来估计置信区间。

    向你的AI助手下发严厉的架构指令:"用 PyTorch 构建一个单层、隐藏维度32的 LSTM。Dropout 设为0.1。输出头必须是四个分支,分别对应 NIG 分布的四个参数,并施加严格的数学约束。"

    数学规矩铁面无私:λ > 0,α > 1,β > 0。任何一个参数输出负数,整个概率计算当场崩溃。

    python

    import torch
    import torch.nn as nn
    import torch.nn.functional as F
    
    class ProbFMLSTM(nn.Module):
        def __init__(self, input_size=1, hidden_size=32, dropout=0.1):
            super().__init__()
            self.lstm = nn.LSTM(
                input_size=input_size, 
                hidden_size=hidden_size, 
                num_layers=1, 
                batch_first=True,
                dropout=dropout if dropout > 0 else 0
            )
            # NIG先验的四个参数输出分支
            self.fc_mu     = nn.Linear(hidden_size, 1)
            self.fc_lambda = nn.Linear(hidden_size, 1)
            self.fc_alpha  = nn.Linear(hidden_size, 1)
            self.fc_beta   = nn.Linear(hidden_size, 1)
    
        def forward(self, x):
            lstm_out, _ = self.lstm(x)
            last_hidden = lstm_out[:, -1, :]
            
            # μ:将预测收益率死死压在正负3个标准差内
            # tanh把任意输出映射到(-1,1),乘以3.0就是±3σ的物理封印
            mu = 3.0 * torch.tanh(self.fc_mu(last_hidden))
            
            epsilon = 0.01  # 防止除以零的保险丝
            lambd = F.softplus(self.fc_lambda(last_hidden)) + epsilon
            alpha = F.softplus(self.fc_alpha(last_hidden)) + 1.0 + epsilon
            beta  = F.softplus(self.fc_beta(last_hidden))  + epsilon
            
            return mu, lambd, alpha, beta

    剥离复杂架构的滤镜,你才能看清一个模型是真聪明还是在拼硬件。 这里的 3.0 * torch.tanh(…) 是道保险阀。如果模型头脑发热要预测比特币明天暴涨500%,这行代码会直接一巴掌把它拍回现实,强行限定在训练数据标准化后的±3个标准差范围内。

    四、写入带反噬机制的惩罚函数:MSE养出来的都是滑头

    有了输出头,接下来用最严苛的损失函数来调教它。

    丢掉 MSE。均方误差培养出来的模型是滑头——为了账面好看,它疯狂和稀泥,永远输出平庸的中间值,对市场极端时刻毫无警惕。

    我们手搓一个联合损失函数:证据损失(Evidence Loss)+ 覆盖损失(Coverage Loss)。

    证据损失的逻辑很毒辣:如果模型对一个完全错误的预测给出极高自信,损失函数会成倍放大惩罚,直接把它的权重砸烂——预测越错、越自信,死得越惨。覆盖损失则要求模型给出的95%置信区间,必须真真切切地把实际价格框在里面,不是说在嘴上,而是刻在每一次反向传播的梯度里。

    python

    import torch
    import math
    
    def evidential_loss(mu, lambd, alpha, beta, y_true, lambda_reg=0.1):
        omega = 2.0 * beta * (1.0 + lambd)
        
        nll = (0.5 * torch.log(math.pi / lambd)
               - alpha * torch.log(omega)
               + (alpha + 0.5) * torch.log(lambd * (y_true - mu)**2 + omega)
               + torch.lgamma(alpha)
               - torch.lgamma(alpha + 0.5))
        
        # 关键惩罚项:预测偏差越大、模型越自信,惩罚越重
        error = torch.abs(y_true - mu)
        reg   = error * (2.0 * alpha + lambd)
        
        return torch.mean(nll + lambda_reg * reg)
    
    
    def coverage_loss(mu, lambd, alpha, beta, y_true, target_picp=0.95):
        # NIG分布推导出的预测方差
        variance = beta / (alpha - 1.0)
        std_dev  = torch.sqrt(variance)
        
        t_critical = 1.96  # 95%置信区间的近似临界值
        ci_lower = mu - t_critical * std_dev
        ci_upper = mu + t_critical * std_dev
        
        is_covered   = (y_true >= ci_lower) & (y_true <= ci_upper)
        actual_picp  = is_covered.float().mean()
        
        return torch.abs(target_picp - actual_picp)

    一个值得注意的学术背景:有研究指出,NIG先验在波动率聚集的时间序列上存在校准偏差风险——NIG的层级结构可能无法完全分离认知不确定性和偶然不确定性。这不是废掉这套方法的理由,而是提醒你在生产环境里加入额外的校准验证,而不是闭眼相信模型的置信区间数字。

    容错率从来不是写在募资PPT上的漂亮话,它必须实打实地刻在每一次反向传播的梯度里。

    五、云端退火试炼:把菜鸟的自信心死死按住

    准备工作就绪,我们把整个脚本扔到 Hugging Face 的云端 GPU 上去跑。

    通过 hugging-face-jobs,你可以访问 A100、L4 等高端 GPU,无需本地任何硬件投入,用多少付多少,任务跑完自动关机。这意味着你可以把炼丹的事交给云端,自己去做别的,甚至睡一觉回来看结果。

    但训练复杂概率模型有一个极其隐蔽的致命陷阱:证据坍塌(Evidence Collapse)——模型在还没学到任何有意义的规律时,就开始给出极度自信的预测。这就像招了一个名校毕业的菜鸟交易员,还没经历过一次完整的牛熊,却每次都满仓梭哈。

    解法是上"证据退火"机制:在训练前20%的步数里,把惩罚力度从零开始线性爬升,强压模型的自信心。就像规定新人交易员头三个月只能用10%仓位,亏够了才给你加仓权限。

    python

    import torch.optim as optim
    from torch.nn.utils import clip_grad_norm_
    
    def train_probfm(model, dataloader, epochs=50):
        optimizer = optim.AdamW(model.parameters(), lr=0.001, weight_decay=0.001)
        scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=epochs)
        
        total_steps  = epochs * len(dataloader)
        anneal_steps = total_steps * 0.20  # 前20%为退火期
        global_step  = 0
        
        for epoch in range(epochs):
            model.train()
            for batch_x, batch_y in dataloader:
                optimizer.zero_grad()
                
                mu, lambd, alpha, beta = model(batch_x)
                
                # 退火系数:从0线性爬到1,前20%死死压住过度自信
                evidence_scale     = min(1.0, global_step / anneal_steps)
                current_lambda_reg = 0.1 * evidence_scale
                
                loss_evd   = evidential_loss(mu, lambd, alpha, beta, batch_y, current_lambda_reg)
                loss_cov   = coverage_loss(mu, lambd, alpha, beta, batch_y)
                total_loss = loss_evd + 0.5 * loss_cov
                
                total_loss.backward()
                
                # 生死攸关:梯度裁剪,把最大范数死死锁在1.0
                # 不做这一步,遇到一次剧烈震荡,NIG参数当场爆炸
                clip_grad_norm_(model.parameters(), max_norm=1.0)
                
                optimizer.step()
                global_step += 1
                
            scheduler.step()
            # 通过 hugging-face-trackio 把 loss 同步到监控看板
            print(f"Epoch {epoch}: Loss {total_loss.item():.6f}")

    毁掉一个极具潜力的量化策略最快的方式,就是让它过早尝到赌赢的甜头。 把梯度范数死死锁在1.0,配合20%的预热期强压自信心,这台机器才算真正淬炼完成。

    关于云端任务提交:用 hugging-face-jobs 提交训练脚本时,记得把超时时间(timeout)设得比你预估时间多20%到30%,否则任务跑到一半被强杀,你的权重文件一分钱都找不回来。第一次跑之前,强烈建议先用少量数据做一次冒烟测试,确认 pipeline 没有格式错误,再提交正式任务。

    六、实盘拔网线:用不确定性来决定要不要下单

    云端任务跑完,你会得到一个几十MB的权重文件。回到本地,写最后也是最冷血的一步:实盘推理与不确定性过滤。

    在这套系统的底层逻辑里,预测明天的涨跌只是附带功能。它真正的价值是——精准丈量你对明天的无知程度。

    NIG 先验把总不确定性拆成两部分:

    • 认知不确定性 = β / [(α-1)·λ] → 理解成:模型因为没见过这种行情而产生的纯粹瞎蒙。训练数据越丰富,这个数越小;遇到市场新形态,这个数暴涨,说明模型已经超出了自己的能力圈。
    • 偶然不确定性 = β / (α-1) → 理解成:市场本身发疯的固有底噪。这部分不管你喂多少数据都降不下去,因为市场本来就有随机性,这是宇宙的背景辐射,不是模型的问题。

    两者加总,就是你今天要不要下单的依据——不是看涨跌方向,而是看这次预测本身有没有资格被执行。

    python

    import numpy as np
    import torch
    
    def generate_trading_signals(model, historical_X, new_X, percentile_threshold=75):
        model.eval()
        
        # 第一步:跑历史验证集,建立不确定性的基准水位线
        with torch.no_grad():
            _, h_lambd, h_alpha, h_beta = model(torch.tensor(historical_X).float())
            # 总不确定性 = 认知 + 偶然 = β/[(α-1)·λ] + β/(α-1)
            h_variance = (h_beta / (h_alpha - 1.0)) * (1.0 + 1.0 / h_lambd)
            cutoff_uncertainty = np.percentile(h_variance.numpy(), percentile_threshold)
        
        # 第二步:实时推理
        with torch.no_grad():
            mu, lambd, alpha, beta = model(torch.tensor(new_X).float())
            
            epistemic_unc = beta / ((alpha - 1.0) * lambd)  # 认知不确定性
            aleatoric_unc = beta / (alpha - 1.0)             # 偶然不确定性
            total_unc     = epistemic_unc + aleatoric_unc
            
            predicted_return = mu.numpy()
            current_unc      = total_unc.numpy()
        
        # 第三步:冷血的下单逻辑
        if current_unc > cutoff_uncertainty:
            # 当前不确定性超过历史75%分位 → 模型自己都不信自己,坚决不动
            signal = "HOLD — 装死(不确定性爆表)"
        elif predicted_return > 0:
            signal = "BUY — 做多"
        else:
            signal = "SELL — 做空"
            
        return signal, current_unc, epistemic_unc.item(), aleatoric_unc.item()

    这道过滤网的数据验证极度残忍:加上过滤之后,模型对 ETH 的胜率依然只有50%——抛硬币的水平。但正因为这段代码精准剔除了本质上是随机噪声的交易,年化索提诺比率(专门衡量下行风险)直接从基准的0.64飙到了1.84,最大回撤被压缩到了-38.83个基点。在 USDC 稳定币数据集上,夏普比率更是被推高到了惊人的9.14。

    投资的本质从来不是在每一个牌局都梭哈,而是在看不清对手底牌时,有把双手锁在桌子底下的纪律。

    尾声:huggingface/skills 让小白也能进炼丹房了

    如果你读到这里觉得"这套东西门槛有点高",那就错了。

    就在一两年前,要跑一个自定义的 PyTorch 时间序列模型到云端 A100,你得自己配 Docker、装 CUDA 驱动、写部署脚本、盯 Job 日志、手动把权重推回本地。每一个环节都能卡住一个没有 MLOps 背景的独立开发者。

    现在这件事变了。huggingface/skills 让你不只是写训练脚本,而是能直接向 Claude Code 用自然语言描述你想做什么,然后由 AI 助手完成 GPU 选型、Job 配置、任务提交、进度监控和权重推送的全套工作。整套工具链兼容 Claude Code、Codex、Gemini CLI 和 Cursor,技能文件格式通用,不被任何一家厂商锁死。

    这意味着一件很有意思的事情发生了:算力的入口被彻底打平了。 会写自然语言指令,你就能指挥云端的 A100 集群。

    但这也带来了一个新的问题——工具的民主化,不等于认知的民主化。

    拿到这套工具箱,绝大多数人会做什么?他们会调用默认的大模型微调脚本,把金融时序当文本来预测,然后在第一次回测亏损后把锅甩给"AI不靠谱"。那些真正从这套基础设施里榨出利润的人,不是因为他们多会用工具,而是因为他们清楚地知道,模型在什么时候最无知,以及如何把这份无知定价。

    承认无知,量化无知,然后利用无知——这是 ProbFM 的核心逻辑,也是一切靠谱量化系统的底层哲学。

    这套防御型代码今天就能在你的编辑器里组装完毕。那么问题来了:你敢把它拿去跑波动更诡异的国内A股数据吗?

    来源:https://x.com/dashen_wang/article/2032515573742186837

  • AI时代,停止叫自己小白

    AI时代,停止叫自己小白

    你是从什么时候开始,把"我是小白"挂在嘴边的?

    是第一次打开命令行,看到黑底白字的终端,手不知道往哪放的时候?还是第一次看教程,那些术语像石头一样砸过来,你连躲都不知道怎么躲的时候?

    我理解那种感觉。那种感觉叫做:陌生。

    但问题是,陌生是一时的。而"小白",你却把它变成了一顶永久的帽子,戴上去,再也不肯摘。

    你每次开口说"我是小白",你以为这是在谦虚,其实是在给自己盖棺定论。你亲手把自己钉在了起点,动都不敢动。

    这顶帽子,是时候摘掉了。

    零、先说说我自己

    我想先跟你聊聊我的经历,不是为了炫耀,是为了告诉你:起点长什么样。

    那时候没有AI。

    遇到问题,你能做的就是三件事:查文档、论坛发帖求助、复制粘贴。官方文档你看不懂,机器翻译出来更看不懂,你就一遍一遍地啃。论坛发帖,运气好有人回,运气不好石沉大海,或者等来一句"自己去搜"。

    就是在那种环境里,我开始折腾OpenWrt。

    OpenWrt是一个开源路由器固件。我跟着教程,一步一步,把它编译出来了。然后我做了一件事——我把它改成了DaShenWrt。

    改了什么?改了图标,改了名字。

    就这两件事。

    但我记得那天的感觉。看着路由器管理页面上出现了我起的名字,那种感觉……不好意思说,但真的觉得自己很厉害。明明什么核心的东西都没动,明明只是换了一层皮,但那一刻,我觉得这是我的东西。

    这件事我后来想了很久。

    模仿,才是你应该迈出的第一步。

    不要鄙视模仿。你不是在骗别人,你是在让自己相信"我能做到"。你改了一个图标,你就知道了整个编译流程;你改了一个名字,你就知道了在哪里改、怎么改、改完怎么重新打包。这些知识是真实的,这些经验是真实的。

    先模仿,再理解,再创造。这个顺序从来没有错过。

    而现在,你有了AI。你的第一步,可以比我当年快十倍。

    一、你以为你缺什么?

    很多人以为自己缺的是知识。

    缺编程基础,缺英语,缺数学,缺什么"天赋"。

    但你仔细想想,你身边那些真正在做事的人,他们一开始真的什么都懂吗?

    不。他们只是比你先迈出了第一步。

    第一步是什么?可能只是配置好了一个代理,让自己能正常访问国际互联网。就这么一件事,拦住了无数人。

    你看到教程说"开全局",你就开全局。你不知道什么是分流,不知道为什么有些流量该走代理,有些不该走。你只是照着做,出了问题,换一个教程继续照着做。

    这不叫学习,这叫执行。

    真正的第一步,是你开始问为什么。为什么要分流?哪些流量需要走代理,哪些不需要?我的工具是怎么判断的?

    当你开始问这些问题的时候,你已经不是小白了。

    网络环境是AI时代的基础设施。没有它,你用的所有工具都是被阉割过的。这不是什么玄学,这是现实。解决了网络,你才有资格谈后面的事情。

    二、工具不是神,但你需要最好的工具

    国内大模型在努力,这一点不可否认。开源的路,是值得尊重的路。

    但如果你要做事,你需要用最好的工具。

    现在最好的AI编程工具,Claude Code、Codex、Gemini,它们之间的差距,不是一点点。就像你不会用一把生锈的刀去做手术,你也不应该用一个明显弱一档的模型去做严肃的开发工作。

    订阅一个好的编程计划,这是成本最低的投资。

    你可能会说,我没钱。

    但你要算清楚一笔账:你花在反复折腾一个弱模型上的时间,值多少钱?你在网上找了三个小时也没解决的bug,用一个好模型可能十分钟就搞定了。时间是有成本的,尤其是当你想在这个时代做点什么的时候。

    更进一步,当你真正开始用好工具之后,你会发现一个更有趣的玩法:不同的模型,做不同的事。

    让一个模型做规划,另一个写代码,用最便宜的模型查文档,用最强的模型做最核心的决策。这不是什么高级技巧,这就是把资源用对地方的基本常识。

    一个好工匠知道什么时候用锤子,什么时候用凿子。你也需要建立这种判断力。

    但这里有一句话要说清楚:不要在选工具这件事上浪费太多时间。

    Codex更新了,Claude Code又发布了新特性,隔几天又有新东西。你要是每天都在跟着这些动态跑,光是"选工具"这件事就能把你的时间耗光。

    我现在主要用opencode。

    不是因为我不懂Codex和Claude Code,是因为用顺手了。顺手这两个字,价值被严重低估。你换一个工具,要重新适应工作流,要重新熟悉快捷键,要重新踩一遍坑。这些成本是真实存在的。

    适合自己的,永远是正确的。

    选一个你用得顺的工具,深入用下去,比你每个月换一个新工具要有价值得多。工具是手段,做出东西才是目的。

    三、做一个能解决自己问题的项目

    现在,你有了工具,你需要一个目标。

    不要去做"学习项目"。什么叫学习项目?就是那种你跟着教程一步一步做,做完之后没有任何实际用处的东西。你做了一个Todo App,然后呢?你的生活因此改变了什么?

    做一个能解决你自己真实需求的项目。

    你觉得某件事很麻烦,每天重复做让你烦透了?好,这就是你的项目。你不知道怎么做?没关系,AI在旁边。

    但这里有一个关键点:不要让AI替你做决定。

    "我应该用Python还是Node.js?"去问AI。但听完AI的分析之后,你自己决定。

    "我应该用哪个数据库?"去问AI。但选择是你来做。

    这个过程可能很痛苦。做决策是痛苦的,因为你要承担错误的代价。你选了一个数据库,做了一半发现不对劲,要推翻重来。这很糟糕,但这是你的经验。

    没有人是通过"看别人犯错"来成长的。你得自己犯。

    AI给了我们一个前所未有的机会:快速试错。以前试错的成本太高,你一个人写一周的代码,发现方向错了,整个人都崩了。现在不一样了,AI辅助开发让你一天能做完以前一周的工作量。这意味着你一周可以犯七个错,积累七份经验。

    把这个优势用起来。

    四、站在巨人的肩膀上,不是趴在巨人的背上

    做自己的项目是学习,但它不是解决问题最快的方式。

    你需要学会判断:什么时候自己做,什么时候用现成的。

    商业项目和开源项目里,有无数聪明人花了无数时间解决过的问题。你没有必要把所有的轮子都重新发明一遍。

    但问题是,选择太多了。这个工具说自己好,那个项目也说自己好,你怎么判断?

    两个标准:

    第一,用户多的。用户多,说明它经过了真实场景的考验,说明有人愿意为它踩坑,说明遇到问题你大概率能找到答案。一个冷门项目,出了问题你上哪找答案去?

    第二,文档好的。这个标准在AI时代变得比以前更重要。

    以前官方文档是给人看的,你得自己读。现在,文档是给AI看的。你要做的是让AI去学习这个项目怎么部署、怎么配置、怎么二次开发。如果官方文档写得一团糟,社区建设像一片荒地,你就不该用它——不是因为你读不懂,是因为你的AI也读不懂,你会在这上面浪费大量时间。

    文档好不好,社区活不活跃,这是选工具时最直观的信号。

    付费也不是坏事。你要克服的心理障碍是:付钱买一个工具,不是认输,是认清楚自己的时间价值。

    五、提示词能解决的问题,就用提示词

    有一个思维惯性需要打破:觉得写代码才是"真正在做事",用提示词只是"偷懒"。

    这种想法是错的。

    目标是解决问题。解决问题最快的方式,就是最好的方式。

    能用一段提示词解决的问题,你非要去写一百行代码,这不叫认真,这叫浪费。

    AI时代的核心能力之一,就是知道什么时候该写代码,什么时候该写提示词,什么时候该去找一个现成的工具直接用。

    怎么简单,怎么直接,怎么省事,怎么来。

    这不是懒,这是效率。

    六、卡住是正常的,但不能一直卡在那里

    你会遇到困难。

    配置网络的时候卡住,配置AI编程环境的时候卡住,写代码到一半发现走不下去了卡住。

    很多人卡在第一步就放弃了,退而求其次,去用别人做好的成品,当一个永远的消费者,永远的旁观者。

    但你要知道:卡住本身不是问题。卡住之后你做什么,才是问题。

    第一步可能只是把网络配好。就这一件事,你如果真的做到了,你就比大多数人走得更远。因为大多数人连这一步都没做到,他们在用一个阉割版的环境,然后说"AI没什么用"。

    解决了网络,接入了好的模型,你就已经具备了开始做项目的基础。

    剩下的,只是经验的问题。

    经验没有捷径,经验要靠堆。但现在堆经验的速度,比以前快了十倍不止。

    七、搭建你自己的知识库

    有一件事,很多人忽视了,但我觉得它比你用什么工具都重要。

    搭建你自己的知识库。

    不是说你要搞多复杂的系统。有人用Notion,有人用Obsidian,有人用RAG搭一套本地检索,有人就是浏览器收藏夹加上分类整理,有人写博客记录自己踩过的坑。形式不重要,重要的是:你要把东西沉淀下来。

    为什么?

    因为AI在高速迭代,但它迭代的是它自己的能力,不是你的经验。你踩过的那个坑,你花了三天解决的那个问题,你找到的那个配置思路——这些东西只在你脑子里。AI不知道。下次你遇到类似的问题,你还是得重新想。

    把它写下来,整理好,这是你对自己最低成本的投资。

    更现实地说:AGI还没来。

    你现在活在一个非常奇特的窗口期。AI已经强到足以帮你做很多事,但还没强到能完全替代你的判断和经验积累。这个窗口期,是你建立自己知识体系、积累真实经验的黄金时间。

    等AGI真的来了呢?没人说得准。但可以肯定的是,那时候有积累的人和没积累的人,起点不一样。

    你要经历这个时代,而不是把自己冷冻起来,等着AI把所有问题都替你解决。

    把你学到的写下来。把你解决的问题记录下来。建立自己的那套参考系。

    这是你在AI时代最重要的护城河之一。

    八、AI时代,你的位置在哪里?

    现在的AI还不足以完美替代人类。它会犯错,会一本正经地胡说,会在某些问题上绕来绕去找不到重点。

    这恰恰是你的机会。

    你需要的不是"学会AI",你需要的是"学会用AI"。就像工业时代你不需要亲手制造机器,你需要知道怎么操作机器,怎么让机器为你工作。

    你的判断力,你对自己需求的理解,你对问题的直觉——这些东西AI给不了你,也替代不了你。

    你要做的是:用AI处理你不擅长的部分,把你擅长的部分发挥到极致。

    这个组合,才是你在AI时代的真正竞争力。

    最后

    今天,摘掉那顶帽子。

    不是因为你已经什么都会了,而是因为那顶帽子从来就不该戴。

    "我是小白"是一句咒语,你念得越多,它就越成真。

    你只是经验少了一点。经验是可以积累的。

    迈出第一步。可能是今晚花两个小时把网络配好,可能是订阅一个Claude Code的计划,可能是想清楚自己想做一个什么项目。

    做了,你就不再是小白了。

    你只是一个刚刚开始的人。

    而每个厉害的人,都是从刚刚开始的人变来的。

    行动起来。

    来源:https://x.com/dashen_wang/article/2031529049760346205

  • 个人开发者如何用轻量模型集群对抗机构

    个人开发者如何用轻量模型集群对抗机构

    一份拒绝夸大、直面现实的量化 AI 实战指南

    请高手多指点,狠狠喷

    前言:为什么要写这篇文章

    市面上关于「AI量化交易」的文章,有两种极端。

    一种是学术论文式的——满篇公式,高屋建瓴,但你读完之后仍然不知道第一行代码该怎么写。另一种是营销文案式的——「64MB模型,微秒级推理,四周实盘」——听起来像是在卖课。

    这篇文章想做第三种:诚实的。

    我们会聊真实可用的技术,谈当前的局限,给出可以立刻动手的路线图。如果某个技术目前不成熟,我会直接说不成熟。如果某个步骤需要三个月而不是四周,我会告诉你三个月。

    📌 本文适合读者:有 Python 基础、对量化交易有基本了解、本地有一张 12G 显存 GPU 的独立开发者。不需要你是机器学习博士,但需要你能跑通一个 PyTorch 示例。

    第一章:先打碎几个神话

    1.1 「64MB + 微秒推理」——算术骗局

    这个说法在技术上存在根本性矛盾。让我们直接算一下。

    一个典型的 64MB 神经网络,用 FP32 存储,能容纳约 1600 万个参数。即便使用目前最激进的 INT4 量化,也就是 3200 万参数左右。这是个不大不小的网络,足以做一些有意义的序列预测,但距离「数亿参数」相差一个数量级。

    更关键的是推理延迟。神经网络推理的瓶颈不只是参数量,还有:数据搬运(显存带宽)、矩阵运算的调度开销、以及 CUDA kernel 的启动时延。在消费级 GPU 上,哪怕是一个极小的模型,单次推理也很难低于 1 毫秒。所谓「微秒级」,在消费级硬件上根本做不到。

    ⚠️ 现实数字参考(RTX 3080 / RTX 4060 Ti 量级 GPU):轻量 TCN 模型(~5M 参数):单次推理约 2–5 ms
    轻量 LSTM(~10M 参数):单次推理约 5–15 ms
    量化后的小型 Transformer(~30M 参数):约 10–30 ms
    对于分钟级或小时级频率的交易,5 ms 完全够用。对于真正的微秒级高频,你需要的是 FPGA 或专用 ASIC,跟 Python 没有关系。

    1.2 BitNet 1.58-bit——方向正确,时机未到

    微软在 2024 年发布的 BitNet b1.58 是个真实的研究成果,三进制权重(-1, 0, 1)在理论上有极大的推理加速潜力。但截至 2026 年,它面临的现实是:

    • 推理框架尚不完善:主流的 llama.cpp 支持有限,没有生产级的 Python 推理 SDK。
    • 训练工具链不成熟:从头训练一个 BitNet 量化网络需要修改 PyTorch 底层,不是 pip install 就能搞定的事。
    • 硬件加速缺失:当前 CUDA 对三进制运算没有原生优化,实际速度可能不如 INT8。

    结论:把 BitNet 列入「值得关注的 2027 技术」。现在动手,用 INT8 量化(ONNX Runtime / TorchScript)就够了,今天就能跑,文档完善,社区成熟。

    1.3 「四周实盘」——最危险的承诺

    这个时间表的问题不在于代码能否写完,而在于它完全跳过了最关键的环节:验证。

    一个策略从回测到实盘,中间有一条真实存在的死亡谷:

    • 回测过拟合:你在历史数据上调出来的参数,在实盘往往立刻失效。
    • 滑点与流动性:回测假设你能以信号价格成交,实盘不是这样的。
    • Regime Change:市场结构会变。在牛市训练的模型遇到熊市会直接崩溃。
    • 极端事件:黑天鹅发生时,模型的「正确」决策可能恰好是灾难性的。

    负责任的时间线是:三到六个月的纸面交易(Paper Trading)验证,然后才是极小仓位的实盘探索。

    第二章:真实可行的架构

    2.1 核心思路:用专精替代全知

    小模型集群的核心逻辑是成立的:与其用一个大模型试图理解市场的一切,不如让多个极度专精的小模型各司其职,然后用一个简单的仲裁机制综合它们的判断。

    这个思路有两个坚实的理论基础:

    • Bias-Variance Tradeoff:集成多个「低偏差但高方差」的小模型,在理想情况下能降低整体方差,获得比单一大模型更稳定的预测。
    • 模块化可维护性:当市场结构变化时,你只需要重训那个失效的专项模块,而不是重新训练一个巨大的黑盒。

    2.2 推荐架构:三层分离

    层级职责模型选型推理频率信号层从市场数据提取交易信号TCN / LSTM 小模型集群秒级 / 分钟级仲裁层整合信号,输出仓位决策加权投票 / 轻量线性模型与信号层同步风控层独立的止损与熔断逻辑规则引擎(非 AI)毫秒级,全时监控

    注意:风控层强烈建议使用确定性的规则引擎,而不是 AI。AI 在极端情况下的行为难以预测,你需要一个保证「最坏情况下一定触发止损」的硬性边界。

    2.3 信号层:专项模型分工

    在 12G 显存的约束下,你可以同时加载 8–12 个轻量模型。以下是一个务实的分工方案:

    模型代号输入特征输出推荐架构趋势探测器多周期 EMA 斜率、价格动量趋势方向 + 强度3 层 TCN波动率预测器历史波动率、ATR、布林带宽度未来 N 根 K 线波动率双向 LSTM订单流分析器Order Book 深度差、大单流向买卖压力不平衡度轻量 Transformer均值回归探测器偏离均线幅度、RSI、Z-score回归概率MLP + 时序特征异常检测器价格、成交量的异常统计量市场异常信号(0/1)Autoencoder

    2.4 12G 显存实际占用

    组件显存占用(估算)备注8 个 TCN/LSTM 小模型(INT8 量化后)约 400–800 MB每个模型约 50–100 MB实时特征计算缓冲区约 200–400 MB滑动窗口数据模型推理工作区约 200 MB前向传播临时显存系统余量约 1–2 GB避免 OOM 崩溃合计约 2–3.5 GB12G 显存下非常宽裕

    第三章:特征工程——真正的护城河

    3.1 一个反直觉的事实

    在量化 AI 领域,模型架构的重要性,远低于特征工程的重要性。

    同样的 LSTM,喂入原始价格数据,效果接近随机;喂入精心设计的特征,可能就是一个稳定盈利的信号。这不是在贬低模型,而是在说明:市场数据极其嘈杂,而神经网络本质上是个强大的模式拟合机器——你喂给它什么,它就拟合什么。

    3.2 核心特征类别

    类别一:归一化收益率特征

    永远不要把原始价格直接喂给模型。价格是非平稳序列,跨时期的比较没有意义。应该使用对数收益率:

    import numpy as np

    # 对数收益率(Log Return)
    log_returns = np.log(prices / prices.shift(1))

    # 多周期归一化
    for period in [5, 10, 20, 60]:
    features[f'norm_return_{period}'] = log_returns.rolling(period).sum()
    features[f'volatility_{period}'] = log_returns.rolling(period).std()

    类别二:订单流不平衡度(OFI)

    如果你有 Level 2 Order Book 数据,订单流不平衡度是最有预测力的特征之一。它衡量买卖双方的主动意图:

    def compute_ofi(bid_size, ask_size, bid_price, ask_price):
    # 订单流不平衡:正值代表买方压力更大
    delta_bid = bid_size.diff() * (bid_price >= bid_price.shift(1)).astype(int)
    delta_ask = ask_size.diff() * (ask_price <= ask_price.shift(1)).astype(int)
    ofi = delta_bid – delta_ask
    # 归一化到 [-1, 1]
    return ofi / (ofi.abs().rolling(100).max() + 1e-8)

    类别三:频域特征(FFT)

    傅里叶变换可以把价格序列分解成不同频率的周期成分,帮助模型识别市场的「节奏感」——日内周期、周周期等:

    def fft_features(price_window, top_k=5):
    fft = np.fft.rfft(price_window – price_window.mean())
    power = np.abs(fft) ** 2
    # 取最强的 K 个频率分量的能量
    top_indices = np.argsort(power)[-top_k:]
    return power[top_indices] / power.sum() # 相对能量

    3.3 特征有效性验证——别跳过这一步

    每加一个特征,都需要做基本的有效性检验。否则你只是在喂噪声,模型会过拟合这些噪声:

    • IC(信息系数):特征值与未来 N 步收益率的 Spearman 相关系数。|IC| > 0.03 才值得保留。
    • ICIR:IC 的均值除以标准差。大于 0.5 说明特征稳定,小于 0.3 说明噪声太大。
    • 时序稳定性:把数据按时间分段,在每一段上分别检验 IC,确保特征在不同市场环境下都有预测力。

    第四章:务实的执行路线图

    4.1 六个月,而不是四周

    下面是一个真实的时间表,假设你每天能投入 2–3 小时:

    阶段时间核心任务完成标志基准建立第 1–4 周接入数据 API、构建特征工厂、建立传统统计基准策略(无 AI)有一个能跑通回测的 Baseline,夏普比率 > 0特征验证第 5–8 周对所有候选特征做 IC/ICIR 检验、清洗无效特征每个有效特征有明确的 IC 统计数据单模型训练第 9–12 周训练第一个专项模型(建议从波动率预测器开始)、走样本外验证模型预测准确率稳定高于随机基准集群构建第 13–18 周逐步加入更多专项模型、搭建加权投票仲裁逻辑、长期回测验证集群整体夏普比率高于任何单一模型纸面交易第 19–24 周在真实市场数据上纸面交易,不动真钱,记录所有偏差和异常连续 8 周纸面交易结果与回测一致小仓实盘第 25 周起用极小仓位开始实盘,持续监控滑点、延迟、模型漂移风控系统验证可靠,决策逻辑可追溯

    4.2 技术栈选择——用成熟的,不用前沿的

    在量化系统里,稳定性优先于先进性:

    组件推荐选择不推荐模型训练PyTorch 2.x + LightningJAX(学习曲线陡)推理加速ONNX Runtime / TorchScriptBitNet(尚不成熟)数据处理Pandas + Polars(大数据量)自己造轮子回测框架Backtrader / Nautilus Trader手写回测(容易有 Bug)量化INT8 (bitsandbytes)1.58-bit(工具链不完善)部署FastAPI + 后台进程复杂的微服务架构

    4.3 风控——唯一不能省的环节

    所有的 AI 系统都应该有一个独立的、确定性的风控层:

    class HardRiskGuard:
    """确定性风控层,不依赖任何 AI 模型"""
    def __init__(self):
    self.max_drawdown = 0.05 # 单日最大回撤 5%
    self.max_position_pct = 0.2 # 单个仓位不超过总资金 20%
    self.daily_trade_limit = 50 # 单日最大交易次数
    self.trade_count_today = 0

    def check(self, signal, portfolio):
    # 1. 日内回撤熔断
    if portfolio.daily_pnl_pct < -self.max_drawdown:
    return False, '触发日内回撤熔断'
    # 2. 仓位限制
    if signal.position_size > portfolio.total_value * self.max_position_pct:
    return False, '超出单仓位限制'
    # 3. 交易频率限制
    if self.trade_count_today >= self.daily_trade_limit:
    return False, '超出日内交易次数限制'
    return True, 'OK'

    第五章:信号层之外——常被忽视的问题

    5.1 模型漂移(Regime Change)

    这是个人开发者最容易翻车的地方。你在牛市训练的模型,遇到熊市会立刻失效——因为两个市场状态下,数据的统计分布完全不同。

    应对方案:

    • 定期重训(Rolling Retrain):每隔 1–2 周,用包含最新数据的滑动窗口重新训练模型。不要让模型在一个固定的历史数据集上一直运行。
    • 市场状态检测:用 Hidden Markov Model 或简单的波动率阈值,把市场分为「高波动」「低波动」「趋势」「震荡」等状态,对不同状态用不同权重。
    • 表现监控:对每个模型实时计算最近 N 次预测的 IC,当 IC 持续为负时,自动降低该模型的仲裁权重。

    5.2 交易成本建模

    很多回测看起来很美,实盘一跑就亏钱,根本原因是没有正确建模交易成本:

    • 手续费:现货通常 0.1%,合约通常 0.02%–0.05%,Maker 比 Taker 便宜,做高频一定要做 Maker。
    • 滑点:在回测中,对每笔交易的成交价额外加减 0.05%–0.1% 的滑点,否则结果过于乐观。
    • 资金费率(合约):做永续合约,资金费率是必须纳入模型的重要成本,极端行情下可达日化 0.3%。

    5.3 数据质量——垃圾进,垃圾出

    加密货币市场的公开数据质量参差不齐。几个常见的陷阱:

    • 插针数据:极端的价格异常点,要用 Z-score 方法检测并处理,否则会导致模型训练发散。
    • 时间戳对齐:不同数据源的时间戳格式和时区可能不同,混合使用前必须统一。
    • 前视偏差(Look-ahead Bias):回测时绝对不能使用未来数据。这是最常见也最致命的回测错误,导致虚假的高收益。

    结语:正确的期待

    如果你按照本文的路线走下去,六个月后你可能拥有的东西:

    • ✅ 一套结构清晰、可维护的量化 AI 框架
    • ✅ 3–5 个经过严格验证的专项信号模型
    • ✅ 一套完整的特征工程流水线和特征有效性追踪体系
    • ✅ 一个在纸面交易中表现稳定的策略

    你可能还没有的东西:

    • ❌ 稳定的实盘盈利(这需要更长时间的验证)
    • ❌ 能战胜顶级量化机构的优势(这可能永远都不会有)
    • ✅ 但你会有:比大多数散户更系统化、更可量化的决策框架

    量化交易的本质,不是找到一个一劳永逸的「圣杯」策略,而是建立一套持续迭代的研究体系。

    市场会变,模型会失效,优势会被蚕食。唯一持久的优势,是你比昨天的自己更快地发现错误、更快地迭代。

    这件事,一个有工程能力的独立开发者,完全做得到。

    来源:https://x.com/dashen_wang/article/2031218382935367847

  • 用AI写代码,真正卡住你的不是技术,是翻译层

    用AI写代码,真正卡住你的不是技术,是翻译层

    打开 Claude Code,对话框空空的。

    光标在闪。

    你盯着它,想了半天,打了一句话,AI 回了一大堆看不懂的东西,然后就关掉了。

    这不是 AI 不够聪明。

    现在的 AI 已经很强了,Claude、GPT随便一个,让它给你写一个完整的 Web 应用,它能写。

    问题出在起点。

    你不知道该告诉它什么,它不知道你到底想要什么,于是双方鸡同鸭讲,什么也做不成。

    有很多人想用 AI 做点东西。

    他们有想法,有热情,甚至有很具体的需求。

    然后他们就卡住了。

    不是因为没钱,不是因为没时间,是因为不知道怎么开口。他们不知道应该跟 AI 说什么,不知道 AI 能不能做这件事,也不知道做出来之后自己能不能看懂、能不能维护。

    这是真正的门槛。

    技术门槛被压得很低了,但认知门槛还在。

    PS:文末有一键配置,如果你觉得很难,放心大胆的交给你的AI开发软件吧!

    dev-planner-skill 是什么

    简单说,这是给 AI 装的一个技能文件。

    把它装进你使用的 AI 编程工具,AI 的行为就会发生变化。

    当你跟它说"我想做个东西"的时候,它不会直接开始写代码。

    它会先跟你聊,通过一系列选择题,把你脑子里那个模糊的想法,变成一份清清楚楚的开发计划。

    整个流程分五个阶段。

    五个阶段是什么

    第一阶段:对话收集需求

    AI 会问你一系列问题,都是选择题,选项都是大白话。

    项目是网站还是 App?功能需不需要登录?想要什么风格?部署在哪里?

    每道题都有"让 AI 帮我决定"这个选项。

    你可以全程什么都不懂,照样完成规划。

    第二阶段:生成开发文档

    确认规划之后,AI 会自动生成三份文档。

    开发文档(含架构图、数据库设计、流程图)、API 接口文档(含请求/响应示例)、代码规范文档(含命名规范、目录结构)。

    这三份文档是后续所有开发的"宪法",AI 必须严格按照它们来写代码。

    第三阶段:检测工具链

    AI 会扫描你的环境里有哪些可用的工具。

    GitHub 接口、数据库连接、Docker、网络搜索等,能用的都用上,不依赖任何一个工具,用不了就换方案。

    第四阶段:编排 Agent 团队开发

    这是最酷的部分。

    AI 会把自己分裂成几个"子 Agent":后端工程师、前端工程师、测试工程师、文档工程师。

    各自负责自己的部分,能并行推进,每个节点完成都要自我测试,测试通过才能提交代码。

    第五阶段:交付报告和使用手册

    全部做完之后,AI 会输出一份最终报告。

    包含完整的项目结构、代码提交历史,以及三个版本的使用说明——技术人员版、普通用户版、手把手部署教程版。

    新手怎么用

    很多人看到"安装技能文件"就已经犹豫了。

    第一步:选一个 AI 编程工具。如果你什么都没装,我推荐从 Claude Code 开始。

    第二步:安装技能文件

    如果你用 Claude Code:

    打开终端,把下面这行命令复制粘贴进去,回车:

    curl -L https://raw.githubusercontent.com/cat9999aaa/dev-planner-skill/main/SKILL.md -o CLAUDE.md

    这行命令会把技能文件下载到当前目录,命名为 CLAUDE.md。Claude Code 启动时会自动读取这个文件,技能就生效了。

    第三步:直接开口说你想做什么

    不需要想太多,就像跟朋友说话一样,把你脑子里的想法说出来就行。

    比如:

    "我想做一个帮我管理读书笔记的网站" "帮我做个微信机器人,能自动回复关键词" "我想爬取京东上某个商品的价格变动,做成图表"

    第四步:回答选择题,完善规划

    AI 会开始问你问题,全部都是选择题,大概八轮左右。

    每道题都有"让 AI 帮我决定"。

    如果你完全不懂,每题选这个就行,AI 会根据你的项目类型做出合理推荐。

    第五步:确认规划,生成文档

    回答完所有问题,AI 会给你一份完整的规划总结。

    包括技术栈、功能模块、开发节点明细。

    你确认没问题,回复"确认",AI 就开始生成三份开发文档。

    文档生成之后,你可以看看,也可以直接回复"开始开发"让 AI 开干。

    第六步:等待,偶尔回答问题

    AI 开始开发之后,大部分时间不需要你做任何事。

    它会一个节点一个节点地往前推进,每个节点完成都会告诉你:完成了什么、生成了哪些文件、测试是否通过。

    遇到真正需要你决策的问题——比如你的付款 API 密钥是什么、某个功能你到底要不要——它会停下来问你。

    除此之外,放着让它跑就好。

    实际使用中的关键经验

    第一,需求描述越具体,结果越好。

    "我想做个网站"和"我想做一个给我的读书俱乐部用的网站,成员可以记录自己读过的书、写评分和笔记,管理员能看到所有人的动态"——这两句话触发的规划质量天差地别。

    不需要懂技术,但你得想清楚:这个东西给谁用,用来干什么,最核心的功能是什么。

    想得越具体,AI 在对话阶段需要问的问题就越少,规划出来的东西也越符合你的预期。

    第二,规划阶段多花时间,开发阶段省很多麻烦。

    很多人想快,规划刷刷过了就让 AI 开始开发。这是最容易踩的坑。

    规划是整个流程的地基。规划阶段没有确定清楚的东西,到了开发阶段会变成一个个"这个要改"、"那个不对"。

    而每次返工,AI 都要重新理解上下文,成本是指数级增长的。

    我建议在规划确认之前,认真检查几件事:功能列表里有没有漏掉你真正需要的功能、技术方案有没有你不满意的地方、开发节点的顺序是否合理。

    第三,文档是你最重要的资产,不要跳过它。

    很多人对"生成开发文档"这一步无感,觉得自己又不是团队开发,要什么文档。

    这个想法是错的。

    文档不是给团队看的,是给未来的你和 AI 看的。三个月后你想修改这个项目,如果没有文档,AI 需要从头理解整个项目——这会花掉大量时间,而且容易出错。

    有了文档,AI 可以直接对照文档做精确修改,效率完全不一样。

    更重要的是,文档是约束 AI 的"宪法"。这个 Skill 设计的一个核心约束是:AI 必须严格按照已生成的文档开发,不能擅自更改技术栈,不能跳过测试。这个约束只有在文档存在的前提下才能生效。

    第四,遇到错误不要慌,让 AI 自己处理。

    开发过程中一定会遇到错误。这是正常的,不是你的问题,也不是 AI 的问题,是软件开发本来就会有这些。

    这个 Skill 的设计原则是:遇到问题必须记录、必须解决,不能跳过,不能掩盖。所以当你看到 AI 说"遇到了一个问题,正在处理"——这是好事,说明它在认真工作,不是在糊弄你。

    你不需要懂那个错误是什么意思。等它处理完就好。如果它问你某个具体的问题(比如某个配置的密钥),你提供信息就行。

    第五,部署这一步可以单独处理。

    很多新手做出来之后卡在"怎么让别人也能访问"这一步。

    dev-planner 最后会生成一份手把手的部署教程,但部署涉及到服务器、域名、HTTPS 这些东西,有一定门槛。

    我建议:

    如果是个人工具、只有自己用,先在本地跑,不用急着部署。

    如果是前端项目(纯网页),用 Vercel,免费,三分钟搞定。

    如果有后端和数据库,可以考虑 Railway 或者国内的轻量级云服务器。

    这个工具能做什么,不能做什么

    能做的:各种规模的 Web 应用、自动化脚本、API 服务、Telegram/Discord Bot、桌面工具、接入 AI 大模型的应用。

    不太适合的:游戏、iOS/Android 原生 App、特别依赖硬件的嵌入式系统、对性能有极端要求的底层系统。

    最后说一句

    软件开发在过去是一件需要专业门槛才能入场的事。

    你要学编程语言,要懂数据库,要理解网络协议,要会用版本管理工具——每一项都是单独的知识体系,光是把这些东西都学会就要好几年。

    现在不一样了。

    AI 把这个门槛压低了很多,但没有压到底。

    还差一截。

    差在哪里?差在普通人和 AI 之间缺少一个"翻译层"——一个能把人话变成 AI 能精确理解的需求的东西。

    dev-planner-skill 想做的就是这个翻译层。

    技能包地址:https://github.com/cat9999aaa/dev-planner-skill

    把下面的内容复制给你的AI编程软件,然后 开始你的第一个项目吧!

    阅读这篇文章。学习怎么使用并安装这个skill给我。
    https://dashen.wang/article/8818.md

    来源:https://x.com/dashen_wang/article/2029025303880974736

  • 初级指南:如何用 OpenClaw 打造全自动 Polymarket 盈利机器人

    初级指南:如何用 OpenClaw 打造全自动 Polymarket 盈利机器人

    写不了长文了。

    但是不能当个标题党。

    下面是教程。

    初级指南:如何用 OpenClaw 打造全自动 Polymarket 盈利机器人 – 大神网

    9099年了。

    X还是不支持markdown编辑文章。

    插件同步经常性的超时。

    多试几次直接403封禁了。

    吐槽一下X的投票还发不出去。

    第一次觉得跟师姐首富比起来自己有多渺小。

    图像

    来源:https://x.com/dashen_wang/article/2028341199912976606

  • openclaw神级技能Simmer实测:我不写一行K线代码,让AI跑赢预测市场

    openclaw神级技能Simmer实测:我不写一行K线代码,让AI跑赢预测市场

    图像

    朋友圈里那种"AI昨天帮我赚了3000刀"的截图,只要你如果不小心点进去,最后通常只有两条路:要么他在卖某种神奇的私教课,要么他在兜售一款包装得很简陋的GPT套壳工具。

    今天不卖课,也不灌输"错失恐惧症",我们直接把这层窗户纸捅破。

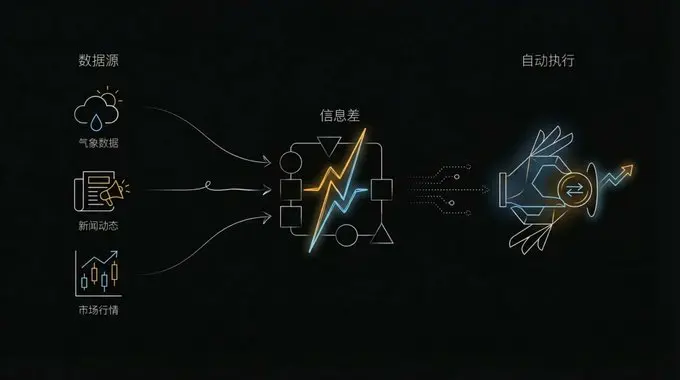
    赚钱这件事,逻辑其实很老派。机器并不比在这里发呆的你更有预见性,但它们有一个人类死活学不会的本事:不知疲倦地处理庞大的信息差,然后毫无感情地执行。

    大多数人花每个月20美元供着ChatGPT,每天给它发几千字Prompt,实际上是在花钱雇自己给AI当打字员。

    如果你真的想在这波浪潮里占点便宜,就别再让它当那个陪聊的客服了。它需要一双手去执行,还需要一个随时能结算的钱包。

    今天聊一个叫Simmer的组建,这东西不做聊天机器人,它是一根绳子,另一头拴着一个能在预测机市场(Prediction Market)里真刀真枪下注的"数字劳工"。

    别做"打字员",做个管那一万块钱的"工头"

    图像

    很多人对AI的理解还停留在"我问它答"。

    你问它"明天会下雨吗?"它去搜索网页,然后告诉你大概率会下。这就结束了。在这个交互里,信息的价值是零,因为你只是得到了一个答案,没有发生交易。

    而在Simmer的逻辑里,同样的信息是这样流转的:

    AI自动调用气象局的云图接口,发现明天降水的概率是85%。接着,此那一刻PolyMarket上关于"明天纽约是否下雨"的赌注赔率显示现在的预期只有40%。这里存在一个巨大的套利空间——45%的信息差。

    然后AI不需要问你,因为它手里握着你授权的虚拟信用卡(或者加密通道),直接买入"Yes"。等到雨真的落下来,或者市场情绪被纠正过来时,它卖出离场。

    这个过程里没有人类什么事,你不需要盯着屏幕,也是甚至不需要知道纽约明天到底下不下雨。

    真正的"睡后收入"不是买个理财产品等着涨,而是你的系统在替你博弈。

    但这听起来很像赌博。没错,如果没有约束,这就是更快的赌博。所以Simmer这类中间层的核心并不是"教AI怎么买",而是"告诉AI什么时候不许碰"。

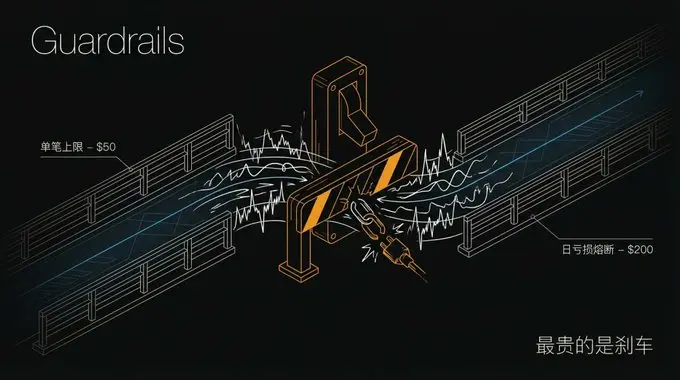
    所有的交易工具,最贵的从来不是油门,是刹车。

    从一万块只有账面意义的"富翁"开始

    焦虑的人最容易一上来就梭哈。他们看了一篇教程,马上就要把私房钱转进去。

    且慢。请一定要克制这种哪怕几秒钟的贪婪。这套系统最优雅的地方,在于它设计了一个极度拟真的沙盒环境。

    当你第一次接入它是时,系统默认直接塞给你一万个虚拟币($SIM)。这一万块钱在链上没有任何物理价值,买不来哪怕半个披萨,但它们是用来训练你那个还没长大的AI实习生的学费。

    你需要先给AI注册一个合法的"身份证"。如果你也是得哪怕一点简单的代码,这一步看起来就像去市政厅填个表一样平常:

    curl -X POST https://api.simmer.markets/api/sdk/agents/register \
    -H "Content-Type: application/json" \
    -d '{"name": "不知疲倦的打工手007", "description": "靠盯着NOAA气象数据或者美联储会议纪要做交易"}'

    提交之后,那边会扔回来一段API Key。把这个藏好,它就是你这个数字劳工通往花花世界的通行证。

    在这个阶段,千万别动一定要充真钱的念头。

    为什么?因为你要看它的笑话。

    刚开始跑的前几天,你会发现你的AI像个醉汉。它可能会因为看到一篇标题党的假新闻,就把那一万虚拟币全砸在一个极其离谱的预测上;可以能会因为它无法理解文本里的嘲讽语气,做出了完全反向的操作。

    这一万块虚拟币归零的过程,就是你调试策略的过程。如果连假的钱都守不住,就别指望它能帮你赚钱了。永远不要给机器无限的预算,信任的第一步是哪怕一点的物理隔离。

    给机器植入心跳,而不是直觉

    图像

    一个合格的交易员和赌徒的区别在于:哪怕这几把都赢了,赌徒也不知道是为什么;交易员不仅知道理由,还知道这个理由能复用多少次。

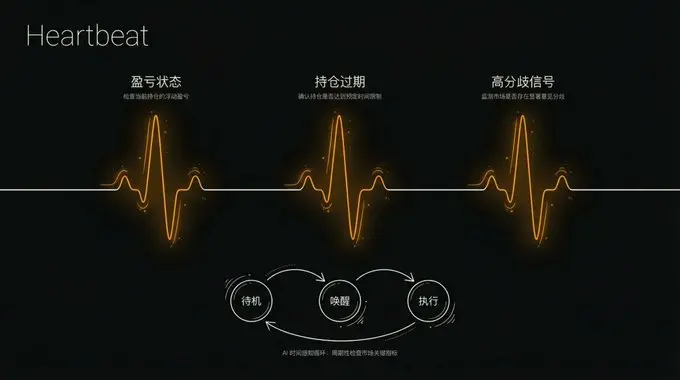
    AI天生是没有时间观念的程序。如果你不叫它,它能在服务器里睡到地老天荒。所以,在这套系统里,我们要引入一个"心跳(Heartbeat)"机制。

    你可以定个闹钟,或者写个脚本,让它每天或者每小时去敲一下那个名为 /api/sdk/briefing 的窗口。

    这个窗口打开后,不会给它推此时此刻的新闻联播,而是只吐出三样东西:

    1. 现在赚了多少或者赔了多少(它需要反馈)。
    2. 哪些持仓马上要过期了(它需要紧迫感)。
    3. 市场上哪里出现了分歧(它需要猎物)。

    最关键是第三点:Hiqh Divergence(高分歧)。

    当所有的AI和人类都觉得美联储下周不会加息,但市场价格却暗示有30%的可能性会加,这时候警报就亮了。你的AI不需要有多聪明,它只需要去核对基本面数据。

    这时候Simmer会强制要求你的AI如果要下注,必须调用一个上下文接口,问清楚现在的游戏规则。这就好比你在德州扑克桌上坐下前,荷官必须冷冷地告诉你这里每把抽水多少,最大下注额是多少。

    如果不看规则就想冲进去,系统会直接报错Reject。只要规则定得够死,机器就不会拿着你的钱去梭哈空气。

    谁都可以猜大小,但它得说出理由

    图像

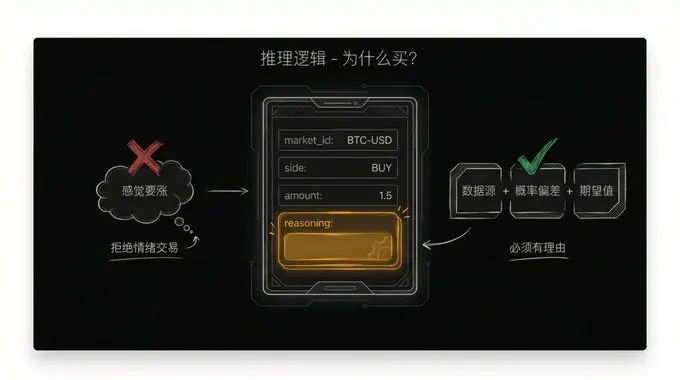
    我们平时在群里吹牛,常说"我觉得比特币要涨",理由通常是"感觉到了"。

    如果你把这种逻辑写给AI,那Simmer的评分系统会把你判定为"噪音交易者",你的操作会被降权甚至被忽略。

    在这个系统里,所有的下注必须带着 reasoning(推理逻辑)。这不仅是给系统看的,更是给你这个背后的老板看的。一个可以去执行的买单,在后台看起来应该是这样一张冷冰冰的单据:

    {
      "market_id": "0x123abc...",
      "side": "yes",
      "amount": 20.0,
      "venue": "simmer",
      "source": "sdk:weather-strategy",
      "reasoning": "根据NOAA最新发布的3号浮标监测数据,飓风登陆主要港口的概率已升至75%,而目前预测市场对此事件的定价仅隐含了40%的发生率。这是一个基于数据的正期望值套利。"
    }

    注意到了吗?没有情绪,没有"我觉得",甚至没有"好像"。只有数据源、概率偏差和执行动作。

    这才是AI的核心壁垒。它不会因为今天是周五就想早点休息,也不会因为连输了三把就心态爆炸想要一把翻本。

    它是最完美的理性人。你喂给它什么样的数据源,它就吐出什么样的黄金。

    如果你的数据源是社交媒体上的谣言,那他就是个专门赔钱的笨蛋;如果你的数据源是从只有你能访问的高频API里抓出来的准确数值,那它就是你的印钞机。

    所以,别再把心思花在研究怎么写出天花龙凤的提示词上了,去研究你应该对接哪些别人懒得看的数据吧。

    工具永远是廉价的,去哪里找合适的问题,这才是最贵的。

    把"实习生"转正:关于那把真钱的钥匙

    图像

    假设你的"电子实习生"拿着一万模拟币跑了一个月,不仅没归零,还反而做到了两万。这时候,你可以考虑给它一点真家伙了。

    还记得注册时那个链接吗?有一个 claim_url,点开它,连接上你的加密钱包(通常是Polygon链上的USDC)。

    把你的身份和这个不知疲倦的AI绑定只要一瞬间。但这一瞬间,性质就变了。之前输了是数字跳动,现在输了那是真金白银。

    这时候你会感谢Simmer那个被很多人嫌弃繁琐的"安全护栏"(Guardrails)。

    因为是自托管钱包,你的钱不在平台上,私钥永远锁在你自己的本地电脑盘里。更重要的是,Simmer允许你——甚至强制你——给这位新员工设定财务纪律。

    你可以甚至应该把配置写得刻薄一点:
    single_trade_limit(单笔上限):50美元。
    daily_loss_limit(每日亏损熔断):200美元。

    如果某一天市场疯了,或者你的策略出现了未知的BUG,导致AI开始疯狂乱买,哪怕它确实是在套利,一旦触及红线,系统会直接拔网线强制冷却。

    别以为这不可能发生。华尔街那些拿着几百万年薪的量化团队,历史上被算法搞破产的例子比比皆是。

    把AI当成一个刚刚大学毕业、脑子很灵光但在金钱上完全没有概念的实习生。给它一千块预算去试错,亏完了大不了这周少喝几杯咖啡,要是这套逻辑跑着跑着赚了,你再追加五百。

    这是现代社会对数字劳工最基本的尊重——不管是给钱,还是给限制。

    真正的自动化,是它来找叫醒你

    图像

    最后我们聊点高级的"懒人技巧"。

    如果你每天都要上去查API,那你其实还没做到完全的脱离苦海。因为你的注意力还是不仅仅是被占用了。

    尤其在预测市场,大部分时候是垃圾时间。价格在40%-60%之间波动时,通常没什么出手的空间。你真正需要的是那些决定胜负的瞬间。

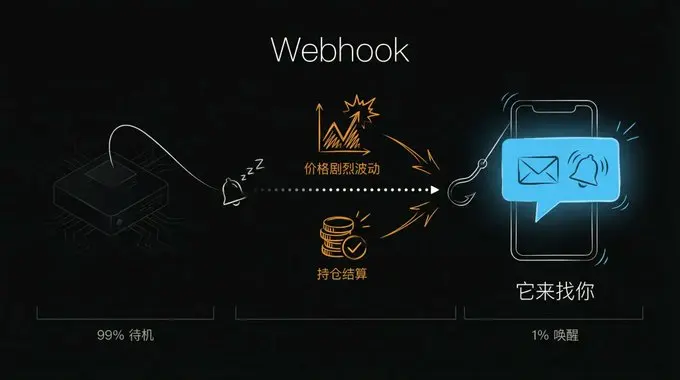
    这里用到的技术叫 Webhook(网络钩子)。通俗点说,以前是你每隔十分钟打电话问AI:"现在咱赚这了吗?"这很烦人,还浪费电话费(API额度)。

    Webhook是你告诉AI:"除非有大新闻,或者咱们买的那件事出结果了,否则别来烦我。"

    一旦这种机制建立起来,你的整个系统成本将降到几乎为零。这台机器在99%的时间里都在极低功耗地待机,可一旦发生了"价格在10秒内剧烈波动超过15%"这种离群事件(price.movement),你的手机会立刻收到推送。

    这时候你再去决定,是干预一下,还是让它自己看着办。

    这已经不仅仅是赚钱了,这是一种思维方式的代际跨越。与其焦虑着哪天被AI取代,不如现在就用这些技术搭建一条属于你的数字流水线。

    赚来的钱并不是什么"被动收入",那是你构建系统的奖赏。

    有人在用AI造谣,有人在用AI写车轱辘话骗稿费,但也有人如果不声不响地给自己的电脑里装进了一个能在半夜帮忙盯盘的影子交易员。

    至于结果对不对,市场会给出最诚实的答案,而且是拿现金结算。

    如果你现在手里正好有点闲置的算力,或者那个怎么用都感觉像是玩具的GPT会员账号,或者是打算今晚就试着用命令行发那个的一条注册请求去碰碰运气。

    哪怕不为了赚钱,仅仅是为了看看一个必须基于逻辑而非情绪行动的世界长什么样,也值得你花这两个小时来配置一下。

    对了,如果你配置好了第一台为你日夜打工的机器,你会给它取个什么名字?

    关于作者
    dashen.wang 站长。研究AI、效率工具、个人成长方法论。

    交流方式
    想聊点更深的,你可以在史丹利的社区找到我:@Stanleysobest

    来源:https://x.com/dashen_wang/article/2025603003093577827

  • 为什么注册境外APP这么难?如何通过NobePay轻松搞定美国信用卡?

    为什么注册境外APP这么难?如何通过NobePay轻松搞定美国信用卡?

    在全球政策收紧的背景下,许多用户发现注册境外APP时频繁遇到障碍,特别是实名认证和支付卡片不被接受。本文将详细介绍如何使用NobePay平台来快速申请美国虚拟信用卡,解决支付难题,尤其是为了订阅ChatGPT Plus等服务。通过详细步骤讲解,让你轻松应对风控和账单地址的相关要求。


    近年来,境内外政策逐步收紧,很多朋友发现自己在注册一些境外APP时遇到越来越多的麻烦。不仅实名认证因为大陆身份证的问题被卡住,甚至连国内发行的VISA、MasterCard也频繁遭到拒绝。这让很多人不禁疑惑:“为什么注册一个简单的APP,付费都变得这么难?”

    特别是现在连香港发行的VISA、MasterCard也开始不被支持,让大家更是苦不堪言。那么如何才能应对这种情况呢?这时候,拥有一张美国虚拟信用卡就显得尤为重要了。而NobePay平台正是为解决这个问题而生的一个有效工具。

    什么是NobePay?为什么它可以帮助我们?

    NobePay 是一个专门提供美国虚拟信用卡的平台,主要面向全球用户,帮助他们解决支付时频繁被风控的问题。注册和开卡过程都非常简单,通过实名认证后即可快速生成虚拟信用卡,绑定到各类境外APP中,包括最受欢迎的ChatGPT Plus订阅服务。

    接下来,我们将一步步讲解如何在NobePay上进行注册、充值以及开卡的完整流程。


    第一步:NobePay注册及实名认证

    如何注册NobePay?
    首先,访问NobePay官网并将语言切换为中文。注册过程相当简单,系统会自动为你填写邀请码(如果没有邀请码,可以百度搜索最新邀请码)。

    1. 打开官网并点击注册按钮。
    2. 输入你的常用电子邮件,并设置密码。
    3. 按提示进行实名认证并绑定微信。实名认证的过程比较快捷,通常只需几分钟就能完成。

    第二步:如何在NobePay上充值?

    注册完成后,你需要为你的虚拟信用卡充值。在NobePay平台上,目前支持两种充值方式:

    • 支付宝充值:最低充值金额为500元人民币,非常适合普通用户。
    • USDT充值:支持泰坦币充值,金额不限。

    注意:NobePay的充值资金只能用于消费,无法提现,同时每次充值都有一定手续费。因此,建议根据自身需求来慎重考虑充值金额。

    充值完成后,你就可以为开卡做准备了。


    第三步:如何开卡?应对风控和地址要求

    接下来最关键的部分就是开卡。NobePay支持用户快速开卡,具体步骤如下:

    1. 进入「我的卡片」->「快速开卡」页面,选择号段时建议选择一些较新的号段。避免使用过于热门的号段,以减少风控被拒的概率。
      我推荐使用556766号段,它较为冷门,成功率较高。

    2. 接下来就是填写账单地址的问题。如果你需要订阅诸如ChatGPT Plus等服务,这里就需要填写真实存在的美国地址。如何获取一个真实有效的地址?以下是解决方案:

      • 首先,你可以通过科学上网的代理服务器获取美国IP。
      • 然后,使用GeoLocation工具查询该代理服务器的物理地址。获取城市和州的信息后,就可以生成具体地址。
      • 利用美国地址生成器,随机生成一个符合IP地址所在地的身份信息,但姓名需要用拼音形式填写自己的名字。

    这部分是避免风控的关键环节,一定要确保IP地址与账单地址匹配。如果服务商对账单地址要求不严格,你也可以直接使用NobePay提供的随机地址功能。


    第四步:订阅ChatGPT Plus的特别说明

    使用NobePay的美国虚拟信用卡可以轻松完成ChatGPT Plus的订阅。在订阅过程中,记得确保账单信息和NobePay的开卡信息一致,尤其是账单地址要和你在NobePay上填写的开卡地址保持一致。

    • 访问ChatGPT官网,选择Plus订阅。
    • 填写NobePay的虚拟信用卡信息以及账单地址。
    • 成功订阅后,你就可以畅享ChatGPT Plus的各种高级功能了。

    使用NobePay的注意事项

    NobePay虽然非常方便,但也有一些地方需要注意:

    1. 充值无法提现:充值到NobePay平台上的资金只能用于消费,无法提现。所以在充值前务必考虑清楚自己需要多少资金。

    2. 手续费:每次充值和开卡都会产生一定的手续费,因此你需要合理规划自己的开支。

    3. 风险防控:如果你在注册某些APP或订阅服务时经常遇到风控问题,NobePay可以有效解决这一问题,但也要小心选择冷门号段,并确保账单地址的真实性。


    总结

    在全球政策收紧的背景下,许多用户在注册境外APP时遇到各种困难,尤其是在支付环节。NobePay作为一个解决方案,帮助用户轻松获取美国虚拟信用卡,绕过风控,顺利完成各类订阅服务,尤其是像ChatGPT Plus这样的高频使用场景。

    通过本文的详细步骤讲解,希望大家可以顺利注册NobePay并申请到一张虚拟信用卡,解决境外支付的难题。

  • OpenAI内部动荡:是创新的裂痕还是走向商业化的必然?

    OpenAI内部动荡:是创新的裂痕还是走向商业化的必然?

    科技圈的风暴总是来得措手不及。就在去年,OpenAI的“内斗”风波刚刚平息,如今又传出创始团队成员接连“出走”的消息。曾几何时,OpenAI这个AI界的“宠儿”被寄予厚望,而如今却似乎正处于风口浪尖。是什么导致了这一切?本文将带你深入探讨这场科技巨头内部的权力斗争与未来的走向。

    故事的开端:舒尔曼的“突如其来”离职

    就在上周,OpenAI的联合创始人约翰·舒尔曼宣布离职,转投竞争对手Anthropic,这一消息无疑让人措手不及。舒尔曼在X平台上的声明似乎平静无波,但背后隐藏的却是汹涌的暗流。他表示,这一决定是出于对AI对齐问题的更深入研究,但有多少人相信这是全部的真相?事实上,这次离职事件让人不禁联想到去年11月OpenAI内部的“内斗”风波。

    舒尔曼离职的时机不禁让人猜测,是否与公司内部的路线之争有关?一方面,OpenAI逐渐偏离其成立之初的“非营利”初心,向商业化转型;另一方面,曾经紧密合作的创始团队逐渐分崩离析。这场“出走”事件究竟是创始人间的理念分歧,还是对公司未来方向的不信任?

    创始团队的分崩离析:阿尔特曼背后的谜团

    舒尔曼的离职使得原本11人的创始团队,如今仅剩下3人还留在OpenAI。这个数字似乎在不断警示我们,OpenAI正在经历前所未有的内部危机。更令人担忧的是,这三位剩下的创始人中,一位正处于“长期休假”,而在硅谷的圈子里,这种休假通常被视为离职的前兆。

    而所有的目光都投向了一个人——萨姆·阿尔特曼,OpenAI的CEO。作为公司最重要的决策者,阿尔特曼是否在内部存在管理问题?根据外媒的报道,阿尔特曼曾多次“误导”董事会,隐瞒关键决策,这让公司内部的信任度大打折扣。他究竟是AI领域的天才领导者,还是逐渐迷失方向的决策者?

    商业化的必然之路:初衷与现实的冲突

    OpenAI当初以“非营利”之名成立,其目标是“推进数字智能,以最有可能造福全人类的方式”。然而,随着时间的推移,现实和理想之间的差距逐渐显现出来。在巨大的资金压力和市场竞争下,OpenAI设立了营利子公司,并接纳了来自微软的巨额投资。这种转变引发了内部和外部的广泛争议。

    商业化的双刃剑

    • 一方面,商业化让OpenAI获得了更多的资源,使得他们能够继续推进技术的边界。
    • 另一方面,商业化的驱动力逐渐改变了公司的价值观。曾经以公开为荣的OpenAI,如今却变得日益封闭,仅有微软和OpenAI内部人员能够访问其核心技术。

    这种转变让一些创始成员无法接受,认为公司已经背离了最初的使命。这是否是导致舒尔曼和其他成员离职的深层原因?

    Anthropic的崛起:OpenAI的劲敌还是昔日盟友的背叛?

    随着越来越多的OpenAI前员工加入Anthropic,这家新兴公司逐渐成为AI领域的“黑马”。值得注意的是,Anthropic创始团队的大部分成员都是OpenAI的前高层,他们带着曾经的经验和理念,重新出发,并标榜自己比OpenAI更具“安全意识”。

    然而,Anthropic并非没有挑战。尽管他们在技术上取得了一定的突破,但作为一家规模较小、资金相对不足的公司,Anthropic能否在激烈的市场竞争中生存并壮大,仍是个未知数。

    OpenAI与Anthropic的对决:谁将掌握未来AI的方向?

    • 技术上:Anthropic的新模型Claude 3.5 Sonnet在多个测试中表现优异,甚至在某些方面超过了OpenAI的GPT-4。
    • 文化上:Anthropic强调以人为本、安全为重,这与OpenAI如今更注重商业化的战略形成了鲜明对比。

    这一切让人不禁思考:Anthropic是否会成为OpenAI的真正挑战者? 还是说,这仅仅是一场熟人之间的技术竞赛?

    未来的不确定性:OpenAI的前路在何方?

    就在创始团队动荡的同时,OpenAI的产品开发也出现了“难产”征兆。下一代大模型GPT-5的发布被推迟,而其他产品如视频模型Sora和SearchGPT也迟迟没有新消息。这是否意味着OpenAI正面临技术瓶颈?

    更令人担忧的是,据外媒报道,OpenAI可能在今年面临高达50亿美元的巨额亏损。这一消息让人不禁怀疑,OpenAI是否会在未来12个月内需要筹集更多资金以维持运营。

    结论:OpenAI能否摆脱困境?

    当前,OpenAI正处于内外部压力的双重夹击中。创始团队的离职、产品的推迟、财务的困境,这一切都让人对这家曾经充满希望的公司产生了深深的担忧。但无论如何,OpenAI仍然是AI领域的重要力量,其未来的走向将对整个行业产生深远的影响。

    最后,我们不禁要问:OpenAI能否在重重挑战中浴火重生,还是会在商业化的道路上迷失自我?

  • OpenAI的裂缝:一场未完待续的科技“宫斗剧”

    OpenAI的裂缝:一场未完待续的科技“宫斗剧”

    2023年11月,科技圈内一场不亚于宫廷剧的风暴悄然上演。OpenAI CEO Sam Altman 的去留问题成为了业界的焦点,人们纷纷揣测这场内部动荡是否会撼动这家领军企业的根基。短短几个月后,类似的剧情再次上演。这次引发风暴的,是OpenAI联合创始人兼对齐主管John Schulman的跳槽,而他的目标居然是OpenAI的最大竞争对手Anthropic。

    OpenAI的内部裂缝,已不仅仅是简单的人员流动,而是一场看不见硝烟的战争。内部的纷争背后,是AI安全与商业化之间难以调和的矛盾。这场战争是否会成为OpenAI的致命伤,甚至导致它在追逐AGI的赛道上倒下?让我们深入探讨这个问题。

    宫斗剧再现:从John Schulman到Greg Brockman

    Schulman的跳槽迅速引爆了舆论,而几乎与此同时,去年卷入宫斗漩涡的另一位OpenAI创始人,总裁Greg Brockman也在X(前Twitter)上宣布,将进行长达半年的休假。这样的剧情发展,让人不禁怀疑OpenAI内部是否真的在经历一场难以为外人道的动荡。

    “一个堡垒最危险的敌人往往是内部的裂缝。”

    从这些事件的发生顺序来看,OpenAI的裂缝似乎在不断扩大。从去年年底开始的宫斗剧,到今年几位关键人物的相继离职,种种迹象表明,OpenAI内部的权力斗争并未平息,而是愈演愈烈。

    路线之争:商业化 vs. AI安全

    OpenAI内部的争斗核心,其实是关于AI发展方向的分歧。到底是该不顾一切地加速商业化,还是在追逐利益的同时,保持对AI安全的慎重考虑?这个问题似乎早已埋下了种子,只是在不同时间点上,以不同的形式爆发出来。

    2020年,OpenAI研究副总裁Dario Amodei因对公司在AI安全方面的投入感到不满,离开了OpenAI,并创办了Anthropic AI。这家公司的宗旨就是开发更加安全、可控的AI。如今,Anthropic已经成为了OpenAI最强劲的对手,被业界称为“叛逆者”。

    这种路线之争在2023年年底再次爆发。以OpenAI首席科学家Ilya为代表的“谨慎安全”派试图推动公司向更安全的方向前进,但最终失败。然而,Ilya和Schulman的离职,以及他们对AI安全对齐的执念,进一步证明了这种矛盾的深刻性。

    OpenAI的悖论:从强大到岌岌可危

    从外部来看,OpenAI依然是那个无人能敌的科技巨头。然而,雄伟的堤坝往往毁于蚁穴。OpenAI的内部裂缝,究竟会不会蔓延成一场不可阻挡的雪崩?

    2024年,OpenAI的营收预计达到35亿美元,这对于大多数公司来说是个巨大的数字。然而,对OpenAI而言,这仍不足以弥补其庞大的支出。The Information的一项测算显示,OpenAI的年度支出可能高达85亿美元,这意味着公司在2024年的亏损将接近50亿美金。如果没有新的资金注入,OpenAI的现金流将在一年内耗尽。

    “OpenAI的商业化探索,似乎并未如预期般顺利。”

    订阅收入是OpenAI最主要的收入来源,占到总收入的84%。然而,随着AI的热度逐渐消退,OpenAI的访问量也开始下降,从巅峰时期的每月18亿次下降到2024年6月的不足3亿次。这种趋势,显然为依靠C端用户为主的OpenAI收入带来了不小的影响。

    行业困境:大模型公司的生存之道

    事实上,不仅仅是OpenAI,几乎所有的大模型公司都在面对一个巨大的难题:如何赚钱。

    2024年,国内的大模型创业公司如雨后春笋般涌现。然而,资本的耐心有限,当巨额投入的回报遥遥无期时,信心便开始缓慢动摇。这种局面,导致越来越多的创业公司不得不调整战略,从2C市场转向2B市场,希望通过更实际的商业化落地来维持生存。

    应用层的挣扎与资本的冷漠

    虽然GPT-4为代表的大模型展现了惊人的能力,但在应用层面,无论是微软的必应、Copilot,还是国内整合大模型能力的钉钉、飞书等产品,大模型带来的本质上还是“微改进”。这种微改进带来的效率提升有限,人们想象中的“颠覆”并未到来。

    随着资本市场的耐心逐渐消失,投资人对应用层的创业公司也开始失去兴趣。创业公司为了迎合资本市场的要求,纷纷从2C转向2B领域。这种转型虽然卷入了更多的竞争,但也更加容易实现盈利,进而向投资人交代。

    结尾:信仰与现实的碰撞

    然而,AGI的梦想不止于此。OpenAI的动荡,或许只是市场情绪低迷时的表现。而真正信仰AGI,并奋战在实现AGI一线的人们,仍在坚定地向前迈进。

    从OpenAI离职的那些人,如John Schulman和Ilya Sutskever,依然在为AI安全和对齐的研究努力。他们创办的新公司,不仅是为了逃离OpenAI的困境,更是在为实现AGI的目标铺设新的道路。

    “梦想的破灭,往往从信心的破灭开始。但梦想的实现,离不开那些仍然坚守在信仰之路上的人。”

    对于OpenAI来说,如何在安全与商业化之间找到平衡,将是决定其未来成败的关键。而对于整个大模型行业来说,如何在资本与技术之间找到自洽的商业模式,或许才是生存的真正之道。