Category: AI 实践

  • 如何使用Neon Serverless Postgres构建OpenAI矢量数据库

    如何使用Neon Serverless Postgres构建OpenAI矢量数据库

    随着人工智能和深度学习技术的迅猛发展,矢量数据在数据科学和应用领域中扮演着越来越重要的角色。从自然语言处理到图像识别,矢量数据是我们理解和处理各种信息的关键。然而,有效地存储和查询矢量数据一直是一个挑战,特别是在云计算环境中。在本教程中,我们将介绍如何使用Neon Serverless Postgres构建OpenAI矢量数据库,以便存储和查询OpenAI生成的嵌入向量。

    准备工作

    在开始之前,请确保您具备以下条件:

    1. 一个Neon Postgres数据库。您可以在几个简单的步骤中创建一个带有现成的neondb数据库的帐户并设置项目。有关说明,请参阅注册并创建您的第一个项目。
    2. 您的Neon数据库连接字符串。您可以从Neon仪表板上的连接详细信息小部件中复制它。请参阅从任何应用程序连接。
    3. pgvector扩展。在Neon中运行CREATE EXTENSION vector;来安装扩展。有关说明,请参阅启用pgvector扩展。
    4. 您的OpenAI API密钥。
    5. Python和pip。

    安装所需模块

    这个笔记本需要openai、psycopg2、pandas、wget和python-dotenv模块。您可以使用pip来安装它们:

    !pip install openai psycopg2 pandas wget python-dotenv

    准备您的OpenAI API密钥

    为了生成文档和查询的向量,需要一个OpenAI API密钥。

    如果您没有OpenAI API密钥,请从https://platform.openai.com/account/api-keys获取一个。

    将OpenAI API密钥添加为操作系统环境变量或在会话中提供它。如果您定义了一个环境变量,请将变量命名为OPENAI_API_KEY。

    测试您的OpenAI密钥

    import os
    from getpass import getpass
    
    # 检查是否将OPENAI_API_KEY设置为环境变量
    if os.getenv("OPENAI_API_KEY") is not None:
        print("您的OPENAI_API_KEY已准备就绪")
    else:
        # 如果没有,请提示输入
        api_key = getpass("请输入您的OPENAI_API_KEY: ")
        if api_key:
            print("您的OPENAI_API_KEY现在可用于此会话")
            # 可选地,您可以将其设置为当前会话的环境变量
            os.environ["OPENAI_API_KEY"] = api_key
        else:
            print("您未输入OPENAI_API_KEY")

    连接到您的Neon数据库

    请在下面提供您的Neon数据库连接字符串,或者使用DATABASE_URL变量在.env文件中定义它。有关获取Neon连接字符串的信息,请参阅从任何应用程序连接。

    import os
    import psycopg2
    from dotenv import load_dotenv
    
    # 从.env文件加载环境变量
    load_dotenv()
    
    # 连接字符串可以直接在这里提供。
    # 用您的Neon连接字符串替换下一行。
    connection_string = "postgres://<user>:<password>@<hostname>/<dbname>"
    
    # 如果上面没有直接提供connection_string,
    # 则检查环境或.env中是否设置了DATABASE_URL。
    if not connection_string:
        connection_string = os.environ.get("DATABASE_URL")
    
        # 如果两种方法都没有提供连接字符串,则引发错误。
        if not connection_string:
            raise ValueError("请在代码中或.env文件中提供有效的连接字符串作为DATABASE_URL。")
    
    # 使用连接字符串连接
    connection = psycopg2.connect(connection_string)
    
    # 创建新的游标对象
    cursor = connection.cursor()
    
    # 测试数据库连接
    cursor.execute("SELECT 1;")
    result = cursor.fetchone()
    
    # 检查查询结果
    if result == (1,):
        print("您的数据库连接成功!")
    else:
        print("连接失败。")

    加载数据

    将预先计算的矢量数据加载到名为articles的数据库表中,从.csv文件加载数据。由于有25000条记录,因此预计操作将花费几分钟。

    import io
    
    # 本地CSV文件的路径
    csv_file_path = '../../data/vector_database_wikipedia_articles_embedded.csv'
    
    # 定义一个生成器函数来处理csv文件
    def process_file(file_path):
        with open(file_path, 'r', encoding='utf-8') as file:
            for line in file:
                yield line
    
    # 创建一个StringIO对象来存储修改后的行
    modified_lines = io.StringIO(''.join(list(process_file(csv_file_path))))
    
    # 创建用于copy_expert的COPY命令
    copy_command = '''
    COPY public.articles (id, url, title, content, title_vector, content_vector, vector_id)
    FROM STDIN WITH (FORMAT CSV, HEADER true, DELIMITER ',');
    '''
    
    # 使用copy_expert执行COPY命令
    cursor.copy_expert(copy_command, modified_lines)
    
    # 提交更改
    connection.commit()
    
    # 检查记录数以确保数据已加载。应该有25000条记录。
    count_sql = """select count(*) from public.articles;"""
    cursor.execute(count_sql)
    result = cursor.fetchone()
    print(f"记录数:{result[0]}")

    搜索您的数据

    在将数据存储在Neon数据库中后,您可以查询最近的邻居。

    首先,定义query_neon函数,当运行矢量相似性搜索时,该函数将执行。该函数基于用户的查询创建一个嵌入向量,准备SQL查询,并使用嵌入向量运行SQL查询。您加载到数据库中的预计算嵌入是使用text-embedding-ada-002 OpenAI模型创建的,因此您必须使用相同的模型来创建用于相似性搜索的嵌入。

    提供了一个vector_name参数,允许基于“标题”或“内容”搜索。

    def query_neon(query, collection
    
    _name, vector_name="title_vector", top_k=20):
    
        # 从用户查询创建嵌入向量
        embedded_query = openai.Embedding.create(
            input=query,
            model="text-embedding-ada-002",
        )["data"][0]["embedding"]
    
        # 将嵌入查询转换为PostgreSQL兼容格式
        embedded_query_pg = "[" + ",".join(map(str, embedded_query)) + "]"
    
        # 创建SQL查询
        query_sql = f"""
        SELECT id, url, title, l2_distance({vector_name},'{embedded_query_pg}'::VECTOR(1536)) AS similarity
        FROM {collection_name}
        ORDER BY {vector_name} <-> '{embedded_query_pg}'::VECTOR(1536)
        LIMIT {top_k};
        """
        # 执行查询
        cursor.execute(query_sql)
        results = cursor.fetchall()
    
        return results
    
    # 基于title_vector嵌入运行相似性搜索
    query_results = query_neon("Greek mythology", "Articles")
    for i, result in enumerate(query_results):
        print(f"{i + 1}. {result[2]} (分数: {round(1 - result[3], 3)})")
    
    # 基于content_vector嵌入运行相似性搜索
    query_results = query_neon("Famous battles in Greek history", "Articles", "content_vector")
    for i, result in enumerate(query_results):
        print(f"{i + 1}. {result[2]} (分数: {round(1 - result[3], 3)})")

    结论

    通过使用Neon Serverless Postgres构建OpenAI矢量数据库,您可以有效地存储和查询OpenAI生成的嵌入向量。这为您提供了强大的工具来处理和分析文本数据,从而使您能够更好地理解和利用矢量数据的潜力。
  • 如何使用Weights & Biases Weave监控OpenAI API调用

    如何使用Weights & Biases Weave监控OpenAI API调用

    在数字化时代,人工智能和深度学习技术正迅速发展,而OpenAI一直是这一领域的领先者之一。但是,随着项目和团队的增长,对OpenAI API的使用情况的监控变得越来越重要。本教程将向您展示如何使用Weights & Biases Weave来监控OpenAI API调用,了解项目和团队如何使用语言模型(LLMs),并可视化这些数据以便更好地管理您的项目。

    开篇故事

    想象一下,您正在领导一个人工智能团队,团队成员在多个项目中使用OpenAI的语言模型。您关心的不仅是项目的进展,还包括如何优化API调用、控制成本、降低延迟和提高吞吐量。然而,要了解这些关键指标,需要大量的数据和分析工作。这时,Weights & Biases Weave登场了。它为您提供了一个强大的工具,可以自动跟踪LLM的使用情况,记录有关成本、延迟和吞吐量的关键指标,并为您提供交互式的仪表板,以便更轻松地与团队共享进展。

    步骤0:设置

    在开始之前,您需要进行一些设置。首先,安装所需的依赖项,然后登录到Weights & Biases(W&B)以保存和分享您的工作,并与OpenAI进行身份验证。

    # 如果尚未安装
    !pip install -qqq weave openai tiktoken wandb
    
    import wandb
    wandb.login()
    
    import weave
    import os
    WANDB_BASE_URL = "https://api.wandb.ai"
    os.environ["WANDB_BASE_URL"] = WANDB_BASE_URL
    
    # 与OpenAI进行身份验证
    from getpass import getpass
    
    if os.getenv("OPENAI_API_KEY") is None:
      os.environ["OPENAI_API_KEY"] = getpass("从 https://platform.openai.com/account/api-keys 复制粘贴您的OpenAI密钥\n")
    assert os.getenv("OPENAI_API_KEY", "").startswith("sk-"), "这似乎不是一个有效的OpenAI API密钥"
    print("OpenAI API密钥已配置")

    步骤1:配置数据流和存储在W&B中

    在W&B中,您需要配置数据流和存储,以便记录OpenAI API调用的日志。设置WB_ENTITY为您的W&B用户名或团队名称,WB_PROJECT为项目名称,STREAM_NAME为记录表的名称。

    WB_ENTITY = # 设置为您的W&B用户名或团队名称
    WB_PROJECT = "weave"  # 为此工作创建顶级目录
    STREAM_NAME = "openai_logs"  # 记录表,用于存储OpenAI API调用的日志

    步骤2:调用init_monitor()

    要开始监控OpenAI API的使用情况,请调用init_monitor(<stream>),其中<stream>的格式为<wandb_team_or_user>/<wandb_project>/<stream_name>。该流会记录并存储所有OpenAI API调用的日志。

    from weave.monitoring import openai, init_monitor
    m = init_monitor(f"{WB_ENTITY}/{WB_PROJECT}/{STREAM_NAME}")
    
    # 为简单起见,指定一个模型
    OPENAI_MODEL = 'gpt-3.5-turbo'
    
    # 使用一些示例日志进行预填充
    r = openai.ChatCompletion.create(model=OPENAI_MODEL, messages=[{"role": "user", "content": "hello world!"}])
    r = openai.ChatCompletion.create(model=OPENAI_MODEL, messages=[{"role": "user", "content": "what is 2+2?"}])

    步骤3:预览监控仪表板

    点击上面的链接预览数据流,然后在右侧边栏中点击“OpenAI Monitor Board”以为此数据流创建Weave Board。

    步骤4:探索和了解您的LLM使用情况

    要保存您的工作,请单击页面顶部的自动生成名称以重命名面板。要分享您的面板,请单击右上角的“发布”。

    通过以下方式,您可以实时可视化您的工作:

    • 将面板保持在单独的选项卡中,并刷新以查看最新数据。
    • 随时重命名面板以更容易参考,并“发布”该版本以与他人共享链接。
    • 通过从weave.wandb.ai导航到相关的W&B实体和W&B项目名称,找到以前保存的面板。
    • 或者打开一个新的面板模板的实例,以从迄今为止积累的所有数据开始。

    接下来,我们将举例说明一些您可以跟踪OpenAI API调用的方式。根据您的用例,还有许多其他可能性,我们迫不及待地期待您从这些起始模板中创建的内容。

    示例

    示例0:记录提示及其完成

    监视ChatCompletion请求并打印相应的响应,仅提取完成的文本。

    response = openai.ChatCompletion.create(model=OPENAI_MODEL, messages=[
            {"role": "user", "content": f"生命、宇宙和一切的意义是什么?"},
        ])
    print(response['choices'][0]['message']['content'])

    示例1:将相关参数作为属性进行跟踪

    将感兴趣的参数分解并将其作为日志记录的属性进行跟踪。在这里,我们将“系统提示”与“提示模板”和“方程”参数分开跟踪。这次我们将打印ChatCompletion调用的完整结构化响应。

    system_prompt = "你总是写成要点"
    prompt_template = '逐步解决以下方程:{equation}'
    params = {'equation': '4 * (3 - 1)'}
    openai.ChatCompletion.create(model=OPENAI_MODEL,
                                 messages=[
                                        {"role": "system", "content": system_prompt},
                                        {"role": "user", "content": prompt_template.format(**params)},
                                    ],
                                 # 您可以在日志记录中添加其他属性
                                 # 有关更多示例,请参见monitor_api笔记本
                                 monitor_attributes={
                                     'system_prompt': system_prompt,
                                     'prompt_template': prompt_template,
                                     'params': params
                                 })

    示例2:记录一系列消息的实时流

    监视消息流并将结果记录为单个记录。请注意:此格式不计算标记数。

    from weave.monitoring.openai import message_from_stream
    r = openai.ChatCompletion.create(model=OPENAI_MODEL, messages=[
            {"role": "system", "content": "你是一个机器人,只说像机器人一样的话,比如滴滴滴。"},
            {"role": "user", "content": "给我讲一个50字的故事。"},
        ], stream=True)
    for s in message_from_stream(r):
        print(s, end='')

    示例3:结构化提示工程实验

    在这里,我们比较了一些系统提示、用户问题和目标受众的玩具选项。尝试您自己的实验,看看在探索Board并按不同参数分组时是否会出现有趣的见解。

    def explain_math(system_prompt, prompt_template, params):
        openai.ChatCompletion.create(model=OPENAI_MODEL,
                                 messages=[
                                        {"role": "system", "content": system_prompt},
                                        {"role": "user", "content": prompt_template.format(**params)},
                                    ],
                                 # 您可以在日志记录中添加其他属性
                                 # 有关更多示例,请参见monitor_api笔记本
                                 monitor_attributes={
                                     'system_prompt': system_prompt,
                                     'prompt_template': prompt_template,
                                     'params': params
                                 })
    
    # 随时替换您自己的提示 :)
    system_prompts = ["你写得非常花哨和诗意", "你非常直接和准确", "平衡简洁和见解"]
    prompt_template = '解释以下方程的解给{audience}听:{equation}'
    equations = ['x^2 + 4x + 9 = 0', '15 * (2 - 6) / 4']
    audience = ["新生", "数学天才"]
    
    for system_prompt in system_prompts:
        for equation in equations:
            for person in audience:
                params = {"equation" : equation, "audience" : person}
                explain_math(system_prompt, prompt_template, params)

    总结

    通过Weights & Biases Weave,您可以轻松监控OpenAI API的使用情况,了解项目和团队如何使用LLMs,并可视化这些数据以便更好地管理您的项目。这种实时监控和数据分析工具将有助于您更好地掌握AI项目的进展,优化API调用,并降低成本。

    希望这个教程对您有所帮助,让您更好地利用Weights & Biases Weave来管理和优化您的OpenAI API项目。如果您有任何问题或需要进一步的帮助,请随时联系我们。

  • 深度学习与自然语言处理:LangChain、Deep Lake和OpenAI实现问答系统

    深度学习与自然语言处理:LangChain、Deep Lake和OpenAI实现问答系统

    深度学习和自然语言处理领域一直是人工智能中备受关注的话题。如何构建一个强大的问答系统一直是研究人员和工程师们的追求。本教程将向您展示如何使用LangChain、Deep Lake和OpenAI实现一个强大的问答系统,让您的计算机能够回答各种问题。

    开篇故事

    在数字化时代,信息爆炸式增长,我们每天都会遇到各种各样的问题,从学术研究到日常生活。有时,我们需要快速准确地找到答案,而这正是问答系统的价值所在。想象一下,您正在研究一个复杂的问题,但是文献太多,难以阅读和理解。这时,一个高效的问答系统可以帮助您迅速找到相关信息,加速研究进程。或者,您可能只是想了解一些日常生活中的知识,比如为什么军事不说24:00。无论是学术研究还是日常生活,一个强大的问答系统都能提供帮助。

    步骤1:安装所需的软件包

    首先,让我们安装需要的软件包,以便开始构建我们的问答系统。在这个教程中,我们将使用LangChain、Deep Lake和OpenAI等工具。

    !pip install deeplake langchain openai tiktoken

    步骤2:身份验证

    接下来,我们需要提供您的OpenAI API密钥,以便进行身份验证。这个密钥将允许我们使用OpenAI的功能来增强我们的问答系统。

    import getpass
    import os
    
    os.environ['OPENAI_API_KEY'] = getpass.getpass()

    步骤3:加载Deep Lake文本数据集

    我们将使用Deep Lake中的文本数据集作为我们的知识库,以便问答系统可以从中提取信息。在这个示例中,我们使用了一个包含20000个样本的子集,这个数据集是来自cohere-wikipedia-22的。

    import deeplake
    
    ds = deeplake.load("hub://activeloop/cohere-wikipedia-22-sample")
    ds.summary()

    步骤4:LangChain的Deep Lake向量存储

    现在,让我们为LangChain的Deep Lake向量存储定义一个路径。这个向量存储将包含我们的文本嵌入。

    dataset_path = 'wikipedia-embeddings-deeplake'

    接下来,我们将设置OpenAI的文本嵌入模型,并初始化一个Deep Lake向量存储。

    from langchain.embeddings.openai import OpenAIEmbeddings
    from langchain.vectorstores import DeepLake
    
    embedding = OpenAIEmbeddings(model="text-embedding-ada-002")
    db = DeepLake(dataset_path, embedding=embedding, overwrite=True)

    现在,让我们将样本数据逐批添加到向量存储中。

    from tqdm.auto import tqdm
    
    batch_size = 100
    nsamples = 10  # 用于测试。将其替换为len(ds)以添加所有数据
    
    for i in tqdm(range(0, nsamples, batch_size)):
        i_end = min(nsamples, i + batch_size)
        batch = ds[i:i_end]
        id_batch = batch.ids.data()["value"]
        text_batch = batch.text.data()["value"]
        meta_batch = batch.metadata.data()["value"]
        db.add_texts(text_batch, metadatas=meta_batch, ids=id_batch)

    步骤5:在数据库上运行用户查询

    现在,我们的问答系统已经构建好了,我们可以在数据库上运行用户的查询。我们使用了GPT-3.5-Turbo作为我们的语言模型,它可以根据用户的查询来查找最相关的信息。

    from langchain.chains import RetrievalQA
    from langchain.chat_models import ChatOpenAI
    
    qa = RetrievalQA.from_chain_type(llm=ChatOpenAI(model='gpt-3.5-turbo'), chain_type="stuff", retriever=db.as_retriever())
    
    query = '为什么军事不说24:00?'
    answer = qa.run(query)

    通过这个问答系统,您可以轻松地获取关于各种话题的答案,无论是学术研究还是日常生活中的疑问。问答系统的强大之处在于它可以从大量的文本数据中提取准确的信息,为您提供及时的帮助。

    总结

    在这个教程中,我们学习了如何使用LangChain、Deep Lake和OpenAI构建一个强大的问答系统。通过加载文本数据集、初始化向量存储和使用语言模型,我们可以实现一个高效的问答系统,可以回答各种各样的问题。无论您是在进行学术研究还是在解决日常问题,这个问答系统都可以为您提供有力的支持。

  • 如何使用ChatGPT模型格式化输入

    如何使用ChatGPT模型格式化输入

    在这个信息爆炸的时代,获取准确的信息和知识变得愈发重要。想象一下,你正在进行一项复杂的编程任务,但你不确定如何开始。这时,有一个智能助手可以为你提供指导和建议,无疑会让你事半功倍。ChatGPT就是这样一个强大的工具,它可以理解你的问题,并提供有价值的回答。本文将介绍如何格式化输入,以充分利用ChatGPT模型的能力。

    格式化输入

    ChatGPT模型的核心功能是接受一系列消息作为输入,并生成一条由AI编写的消息作为输出。要正确使用ChatGPT,你需要了解如何格式化输入消息。每个消息对象包括以下字段:

    • role:消息的角色,可以是系统、用户或助手。
    • content:消息的内容,包括问题、指令等。
    • name:可选字段,为消息的发送者命名。

    通常,一次对话会以系统消息开始,告诉助手如何行动,然后是交替的用户和助手消息。不过,并不一定要遵循这种格式。

    以下是一个示例Chat API调用,展示了消息的格式:

    MODEL = "gpt-3.5-turbo"
    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "Knock knock."},
            {"role": "assistant", "content": "Who's there?"},
            {"role": "user", "content": "Orange."},
        ],
        temperature=0,
    )
    
    response

    这个示例中,我们首先定义了模型(可以选择不同的模型),然后创建了一个包含系统、用户和助手消息的消息列表。通过这种方式,你可以与ChatGPT建立对话并获取回复。

    系统消息

    系统消息可以用来设定助手的行为和性格。要注意,不同版本的ChatGPT模型对系统消息的关注程度可能会有所不同。有时,将重要的指令放在用户消息中会更有效。

    以下是一个系统消息的示例,用来设定助手的性格:

    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "You are a friendly and helpful teaching assistant. You explain concepts in great depth using simple terms, and you give examples to help people learn. At the end of each explanation, you ask a question to check for understanding"},
            {"role": "user", "content": "Can you explain how fractions work?"},
        ],
        temperature=0,
    )

    这个系统消息告诉助手在解释概念时要深入浅出,并在每个解释结束时提出问题以检查理解。

    举例说明

    有时,向模型展示你想要的内容比告诉模型更容易。你可以使用模拟的示例消息来说明你的需求,这是一种有效的方法。

    以下是一个示例,展示了如何使用示例消息来教助手将商业术语翻译成简单的语言:

    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "You are a helpful, pattern-following assistant."},
            {"role": "user", "content": "Help me translate the following corporate jargon into plain English."},
            {"role": "assistant", "content": "Sure, I'd be happy to!"},
            {"role": "user", "content": "New synergies will help drive top-line growth."},
            {"role": "assistant", "content": "Things working well together will increase revenue."},
            {"role": "user", "content": "Let's circle back when we have more bandwidth to touch base on opportunities for increased leverage."},
            {"role": "assistant", "content": "Let's talk later when we're less busy about how to do better."},
            {"role": "user", "content": "This late pivot means we don't have time to boil the ocean for the client deliverable."},
        ],
        temperature=0,
    )

    在这个示例中,助手被引导使用简单的语言来解释商业术语。

    计算标记数量

    在使用ChatGPT模型时,消息中包含的标记数量会影响请求的成本、生成响应的时间以及响应是否会因达到最大标记限制而被截断。

    你可以使用以下函数来计算消息中包含的标记数量:

    import tiktoken
    
    def num_tokens_from_messages(messages, model="gpt-3.5-turbo-0613"):
        # 计算标记数量的函数
        # ...

    这个函数会帮助你了解消息中的标记数量,以便更好地管理成本和响应时间。

    结束语

    ChatGPT模型是一个强大的工具,可以为你提供有用的回答和建议。通过了解如何格式化输入消息,你可以更有效地与模型互动,获得所需的帮助。不断尝试不同的指令和示例消息,以使模型更好地满足你的需求。

    现在,你已经了解了如何使用ChatGPT模型,开始享受其带来的便利吧!

  • 如何使用ChatGPT撰写高质量论文

    如何使用ChatGPT撰写高质量论文

    让我们开始探讨如何充分利用ChatGPT,这个令人惊叹的人工智能助手,来撰写高质量的论文。假设你是一位繁忙的CEO,每天面对着繁重的工作任务,但你也有一个深藏的热情——写作。无论是技术博客还是学术论文,你都渴望能够创作出引人入胜、精彩纷呈的内容。然而,时间总是有限的,怎么才能在有限的时间内完成一篇高质量的论文呢?

    这就是ChatGPT的神奇之处。作为一位热爱编程和技术的CEO,你发现ChatGPT不仅是一个强大的人工智能助手,还是一个极具潜力的论文撰写伙伴。它可以帮助你从头到尾完成一篇高质量的论文,而且效率非常高。那么,接下来,让我们一起探讨如何使用ChatGPT来撰写高质量的论文吧。

    步骤一:确定论文主题和研究方向

    首要的步骤是明确论文的主题和研究方向。无论你是撰写技术博客还是学术论文,都需要一个清晰的焦点。ChatGPT可以成为你的顾问,帮助你了解当前领域的最新动态和热点问题,从而协助你确定具体的论文选题。这一步骤至关重要,因为一个好的选题是整个论文质量和吸引力的基石。

    步骤二:利用ChatGPT辅助选题和撰写综述

    ChatGPT不仅可以帮助你确定选题,还能在综述部分提供宝贵的帮助。建立一个与ChatGPT的对话模式,让它了解你的论文要求和目标,向它提出问题或请求建议。它会根据你的需求生成相关内容,协助你编写综述部分。这个过程可以节省大量的时间和精力。

    步骤三:生成摘要和大纲

    一旦选定了论文的主题和综述部分,接下来是生成摘要和大纲。ChatGPT可以轻松地帮你完成这一步骤。你可以让它生成论文的摘要,以及根据选题生成论文的大纲。这些都是论文写作的重要组成部分,可以协助你更好地组织和规划论文的结构。

    步骤四:生成和编辑内容

    现在,进入论文的正文部分。ChatGPT可以根据你提供的问题或主题,一段一段地生成论文的内容。你还可以设置字数限制,以确保生成的内容符合论文要求。然后,将生成的内容复制到Markdown格式中,进行进一步的编辑和排版。这一步骤可以帮助你确保论文的质量和逻辑性。

    步骤五:检查和审阅

    生成的内容虽然由ChatGPT完成,但仍需要你的检查和审阅。确保内容符合学术规范,没有语法错误和逻辑问题。此外,还可以通过论文查重系统进行验证,以确保论文的原创性。

    步骤六:润色和优化

    最后,根据你的个人喜好和写作风格,对论文进行润色和优化。完成格式排版和添加参考文献等细节。这一步骤可以让你的论文更加专业和引人注目。

    总结来说,利用ChatGPT撰写论文是一个高效且有趣的过程。它可以帮助你节省大量的时间和精力,同时保证论文的质量。然而,需要注意的是,ChatGPT在生成文献时可能会出现不准确的情况,所以在文献部分还是需要你自己来查询。另外,不同版本的ChatGPT可能会在撰写论文时有不同的效果和体验。

    最后,无论是技术博客还是学术论文,ChatGPT都可以成为你的得力助手,帮助你创作出高质量的内容。只要合理使用,它可以让你在有限的时间内完成令人满意的论文,同时也为你的写作梦想提供了更多的可能性。

  • 制作3D打印和树莓派驱动的ChatGPT机器人教程

    制作3D打印和树莓派驱动的ChatGPT机器人教程

    你是否曾经想过拥有一个能够与你互动的ChatGPT机器人,而且它还拥有可爱的外观?那么,你来对地方了!在这篇教程中,我们将向你展示如何制作一个由3D打印和树莓派驱动的ChatGPT机器人。这个机器人将能够回答你的问题、进行有趣的对话,而且还有一个可爱的外壳,使它看起来像一只机械熊一样。

    步骤1:3D打印机器人外壳和组件

    首先,我们需要制作机器人的外壳和组件。根据Adafruit Learning System提供的指南,你需要打印以下部分:

    • 主机箱: 1 x Case Top.stl,1 x Case Bottom.stl
    • 扬声器固定器: 如果使用4mm 0.25W的扬声器,则需要2 x 4mm Thick Speaker Retainer.stl;如果升级到Adafruit 2mm 0.5W的扬声器,则需要2 x 2mm Thick Speaker Retainer.stl【14†source】.

    确保你的3D打印机和材料准备好,并按照指南的建议进行打印。一旦完成,你将获得一个机器人的基本外壳,接下来,我们将在内部安装树莓派和其他组件。

    步骤2:安装和配置树莓派

    在机器人外壳中安装树莓派是关键的一步。以下是详细的操作指南:

    1. 安装64位的Raspberry Pi OS Lite,因为OpenAI库只能在此版本上安装。
    2. 为音频系统和驱动程序安装额外的库,例如libpulse-dev, pulseaudio, 和 apulse。
    3. 如果安装了MAX98357音频芯片,需要按照指南进行额外的配置【18†source】.

    完成这些步骤后,你的树莓派将准备好用于机器人的音频和控制系统。

    步骤3:编写和运行代码

    现在,让我们来看看在树莓派上运行的代码。这个代码涉及到Azure认知服务、语音识别库和OpenAI库,以及一些用于控制机器人动作的参数设置。你可以从Adafruit Learning System下载项目包,里面包含了完整的代码【22†source】.

    在运行代码之前,请确保你已经按照指南配置好了所需的API密钥和设置。这将确保机器人能够正常运行并进行语音识别和回答问题。

    步骤4:集成ChatGPT

    最后,我们来看看如何集成ChatGPT,使机器人能够进行智能对话。参考Pi My Life Up的指南,了解如何在树莓派上交互使用ChatGPT API【17†source】.

    这个步骤将使你的机器人能够回答各种问题,并进行有趣的对话。你可以根据自己的需求和喜好配置ChatGPT的行为。

    结尾

    通过完成以上步骤,你将拥有一个令人印象深刻的3D打印和树莓派驱动的ChatGPT机器人。你可以为它编写自定义的对话脚本,让它成为你的智能伴侣。

    这个项目不仅是一个有趣的技术挑战,还可以让你学习如何使用树莓派和API来创建强大的人工智能应用程序。希望你享受制作和与你的机器人互动的过程!

  • Stable Diffusion 1.6版本更新:提高采样速度和质量的新采样器

    Stable Diffusion 1.6版本更新:提高采样速度和质量的新采样器

    在当今快速发展的人工智能领域,不断有新技术和工具涌现,为我们的研究和创新提供了新的机会。最近,Stable Diffusion的1.6版本更新引入了三种新的采样器,分别是DPM++ 3M SDE、DPM++ 3M SDE Karras和DPM++ 3M SDE Exponential。这些新采样器的出现,不仅标志着AI技术的又一次飞跃,也为我们提供了更高质量和更高速度的采样效果。在本文中,我们将深入探讨这些新采样器的特点以及如何根据实际需求来选择最合适的配置,以达到理想的采样效果。

    DPM++ 3M SDE 和 DPM++ 3M SDE Karras

    DPM(Diffusion Probabilistic Model,扩散概率模型)和DPM++是为扩散模型设计的新采样器,它们在2022年发布,代表了类似架构的解算器系列。DPM++是DPM的改进版本,它的一大特点是自适应地调整步长,但这也可能导致较慢的采样速度,因为它不能保证在有限的采样步数内完成。然而,DPM++在一些情况下仍然表现出色,特别是在需要高质量采样的应用中。

    在测试中,研究者首先关注了CFG值(Conditional Feedback Gain)对采样器性能的影响。在步数为45步时,明显可以看到CFG对三种采样器的影响。例如,DPM++ 3M SDE在CFG = 9时表现出崩溃的迹象,而另外两种采样器则展现出更丰富的细节。DPM++ 3M SDE需要更高的步数,以前的20步已不再适用,如果想要减少步数,就需要将CFG降低到5,但步数也会相应增加。相比之下,DPM++ 3M SDE Karras的步数要求较低,CFG为7时,大约35步就能正常生成图像。这为用户提供了更多选择,以根据项目需求调整配置。

    DPM++ 3M SDE Exponential

    另一种新采样器,DPM++ 3M SDE Exponential,也在Stable Diffusion的1.6版本中引入。这个采样器的CFG值为7时,推荐步数为40步及以上。与其他采样器相比,它的步数要求相对较高,但在一些情况下,它能够提供更高质量的采样结果。此外,DPM++ 3M SDE Exponential还支持快速输出概念图,只需将cfg设置为3,便可在较低步数下直接生成图像,适用于快速原型开发和概念验证。

    选择最合适的采样器和配置

    在使用这些新采样器时,关键是根据实际需求和项目要求来选择最合适的配置。以下是一些建议:

    1. 项目需求:首先,考虑您的项目需要什么样的采样效果。如果需要高质量和细节丰富的图像,可以选择DPM++ 3M SDE或DPM++ 3M SDE Karras,根据CFG值和步数来调整配置。如果您更关注采样速度,可以尝试DPM++ 3M SDE Exponential,并将cfg设置为较低的值。

    2. 计算资源:不同的采样器和配置可能需要不同的计算资源。确保您有足够的计算能力来支持选择的采样器和配置。

    3. 实验和调试:在开始正式项目之前,建议进行一些实验和调试,以找到最佳的配置参数。尝试不同的CFG值和步数,并评估生成图像的质量和速度。

    4. 快速原型开发:如果您需要快速原型开发和概念验证,可以考虑使用DPM++ 3M SDE Exponential,并将cfg设置为较低的值,以便快速生成概念图。

    结论

    Stable Diffusion 1.6版本的更新引入了三种新的采样器,它们为我们提供了更多选择,以根据项目需求来调整配置,从而实现更高质量和更高速度的采样效果。选择合适的采样器和配置需要考虑项目需求、计算资源和实验调试,以确保达到理想的采样效果。

    在快速发展的AI领域,我们不断追求创新和提高采样质量,这些新采样器的引入为我们带来了更多的机会和可能性,让我们能够在各种应用中取得更好的成果。

  • 试用ChatGpt-plus新功能:DALL·E 3

    试用ChatGpt-plus新功能:DALL·E 3
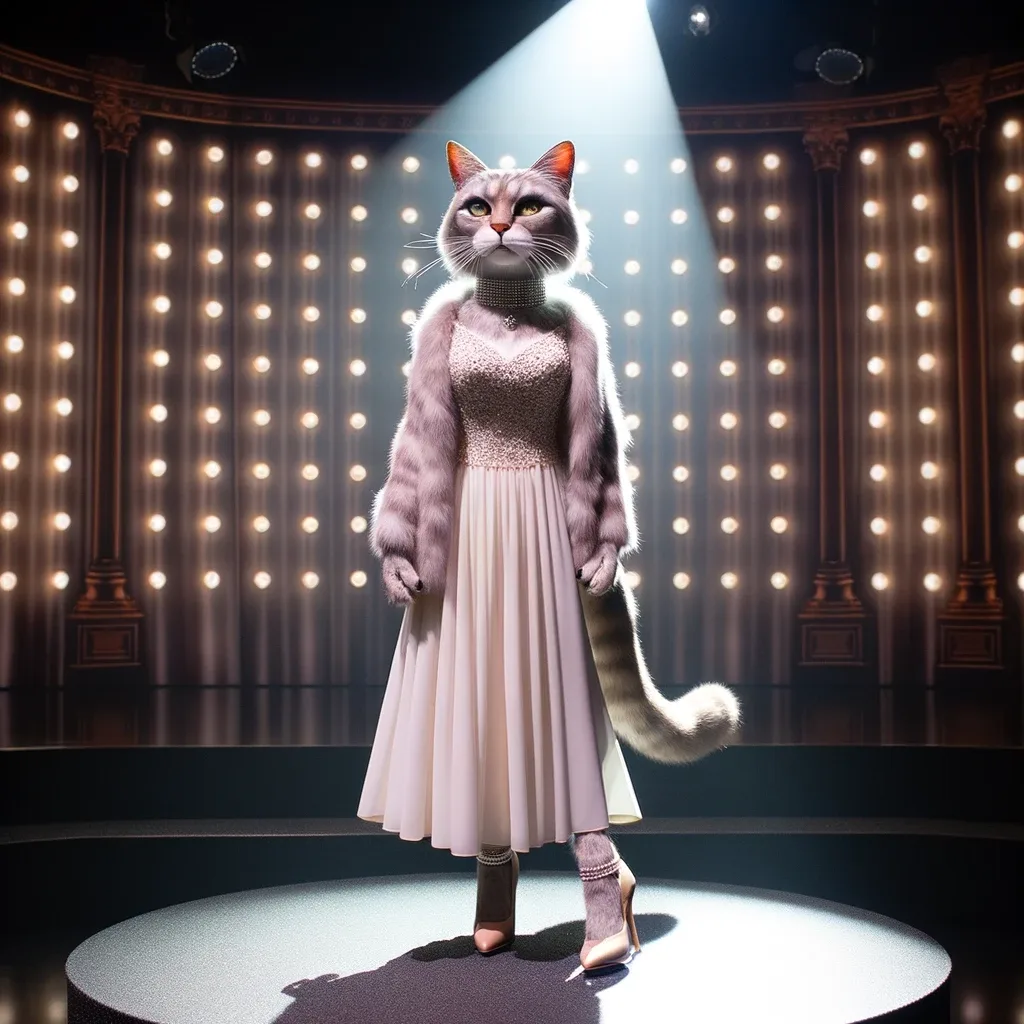
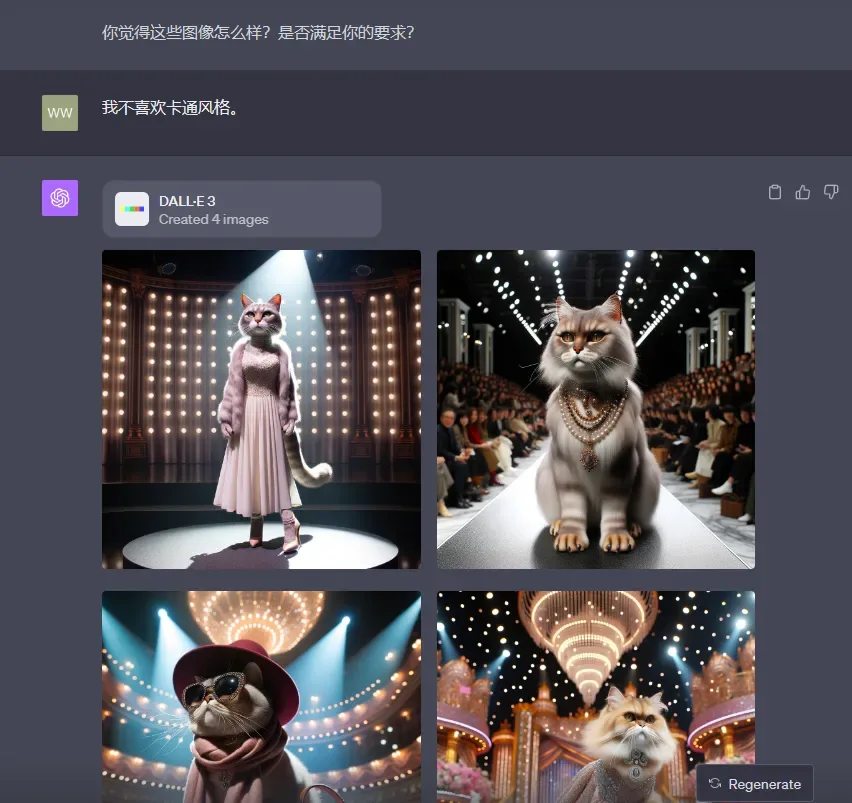
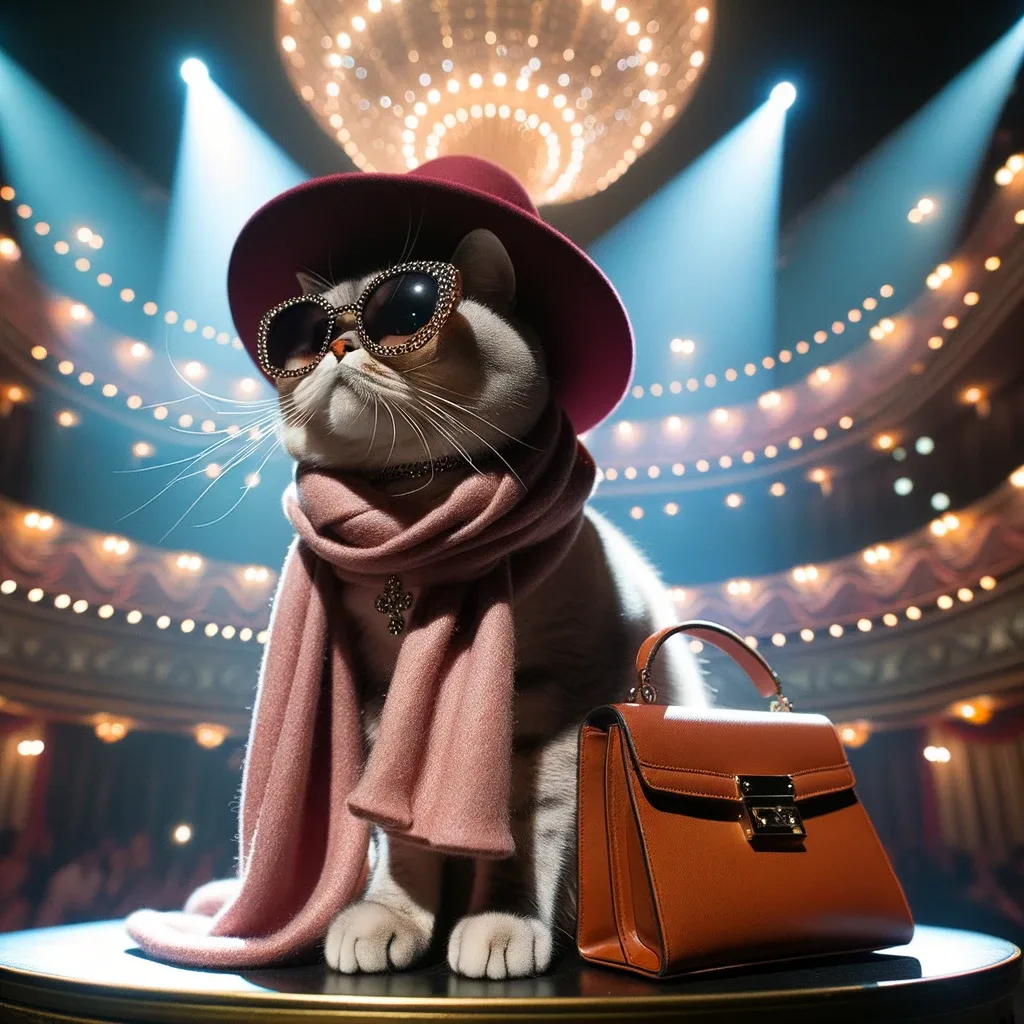
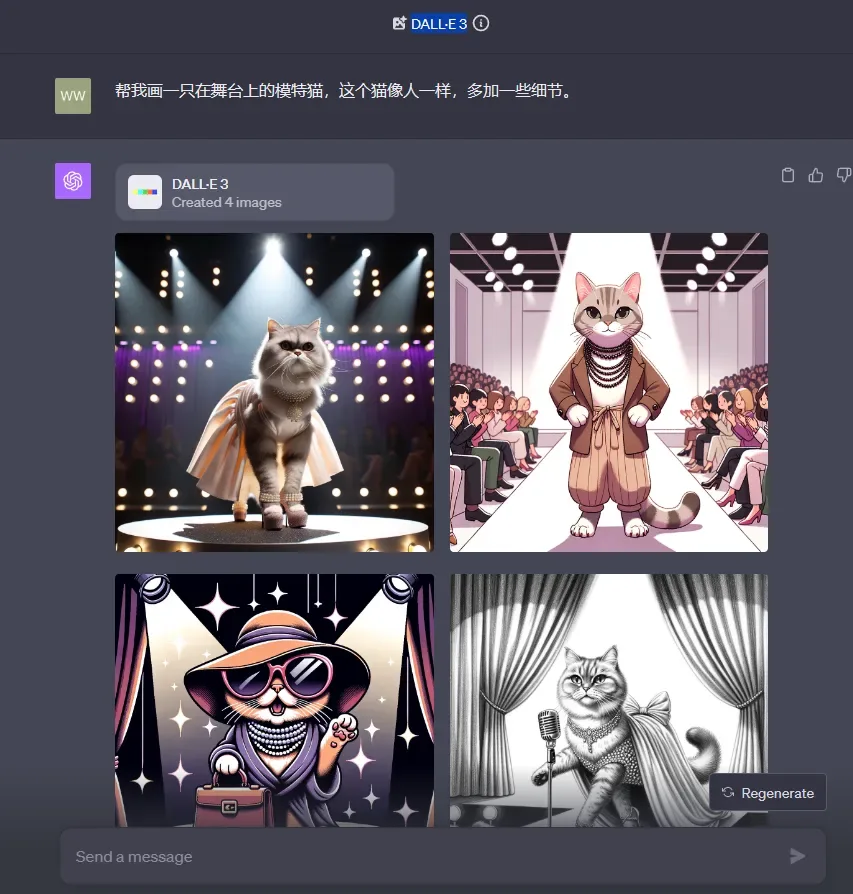
    试用ChatGpt-plus新功能:DALL·E 3 试用ChatGpt-plus新功能:DALL·E 3
    引言

    在数字艺术和图像设计领域,创造独特且富有创意的图像一直是一个具有挑战性的任务。随着人工智能技术的不断发展,出现了许多强大的工具,用于自动生成和修改图像。今天,我将分享我的体验,使用DALL·E 3进行图像生成和修改,以及与Stable Diffusion相比的体验。

    试用ChatGpt-plus新功能:DALL·E 3 试用ChatGpt-plus新功能:DALL·E 3

    DALL·E 3简介

    DALL·E 3 是一款由OpenAI开发的人工智能模型,专门用于生成图像。它的强大之处在于,它可以根据用户提供的文本描述生成图像,而不仅仅是简单的重复或变换。DALL·E 3使用了深度学习技术,通过训练大量数据来理解文本描述并将其转化为图像。

    图像生成质量

    首先,让我们谈谈DALL·E 3生成的图像质量。我对于生成的图像质量感到非常满意。它能够以惊人的细节和精度呈现文本描述中的概念。无论是绘画、风景还是抽象概念,DALL·E 3都能够以令人印象深刻的方式呈现出来。这对于数字艺术家和图像设计师来说是一个强大的工具,可以帮助他们实现创意。

    试用ChatGpt-plus新功能:DALL·E 3 试用ChatGpt-plus新功能:DALL·E 3

    图像瑕疵

    然而,正如任何技术一样,DALL·E 3生成的图像也可能存在一些瑕疵。例如,有时候图像的细节可能不够清晰,或者在复杂的场景中可能会出现一些模糊。此外,某些图像的颜色搭配可能需要微调,以使其更加美观。在我使用DALL·E 3的过程中,我也遇到了一些图像中的小问题,比如一只猫的脚看起来不太自然。这些问题虽然不常见,但却可以通过后续的编辑来修复。

    试用ChatGpt-plus新功能:DALL·E 3 试用ChatGpt-plus新功能:DALL·E 3

    Stable Diffusion的优势

    虽然DALL·E 3已经提供了出色的图像生成能力,但我还想谈谈Stable Diffusion。Stable Diffusion是一种用于改善图像质量的技术,它可以进一步提高生成图像的质量和真实感。

    Stable Diffusion的定制性更强,它允许用户根据自己的需求微调生成的图像。这意味着你可以更精细地控制图像的各个方面,包括颜色、细节和清晰度。对于那些对图像有特定要求的人来说,Stable Diffusion提供了更多的灵活性。

    使用体验

    在我的使用体验中,我发现DALL·E 3和Stable Diffusion都具有出色的性能。DALL·E 3适用于快速生成高质量的图像,特别适用于那些需要快速原型设计或概念验证的项目。它的简便性和速度使其成为一个强大的工具。

    然而,当我需要更多的定制和控制时,我会转向Stable Diffusion。它允许我根据具体要求微调图像,确保它们符合我的预期。这在需要特别精细的图像时非常有用,比如绘画或高级设计项目。

    结论

    总的来说,DALL·E 3和Stable Diffusion都是强大的工具,用于图像生成和修改。它们为艺术家、设计师和创意人士提供了丰富的资源,帮助他们实现各种创意。无论是快速原型设计还是高度定制的图像需求,这两种技术都可以胜任。

    在未来,我期待看到这些技术的进一步发展,以及它们如何影响数字艺术和图像设计领域的发展。

  • 如何理解英伟达的CUDA技术:计算领域的革命者

    如何理解英伟达的CUDA技术:计算领域的革命者

    在密尔沃基工学院的演讲中,英伟达的CEO黄仁勋分享了一段令人振奋的话语,他讲述了英伟达的发展史以及一项技术的贡献,这项技术便是CUDA。这个技术已经改变了计算领域的格局,让GPU在大数据计算中崭露头角。那么,CUDA究竟有何魔力,为什么它如此重要呢?

    如何理解英伟达的CUDA技术:计算领域的革命者 如何理解英伟达的CUDA技术:计算领域的革命者

    CUDA:并行计算的魔法

    CPU和GPU都是计算机处理器,它们能够执行各种计算任务,但它们在计算方式上存在差异。CPU擅长线性计算,就像一位大学教授,能够独立解决复杂问题,但步骤逐一进行。而GPU则更像一群小学生,单核计算能力不如CPU,但核心数量众多,能够同时进行计算。

    CUDA技术就是那个调动小学生群体的指挥棒。通过CUDA,研究员和编程人员可以使用编程语言与硬件设备进行交互,将复杂的数学问题分解为多个简单的子问题,并将这些子问题分发给GPU的多个计算核心。正如黄仁勋所言,CUDA成为了科学向前发展的最佳解法,其强大的计算能力使其成为超级计算机的首选。

    CUDA的广泛应用

    自从英伟达于2006年推出CUDA以来,它已经渗透到几乎所有与计算有关的领域。航空航天、生物科学研究、机械和流体模拟、能源探索等各个领域的研究都在CUDA的基础上进行。事实上,80%的计算领域已经被英伟达的CUDA技术所影响。

    而CUDA的生态合作伙伴也在不断壮大。根据英伟达2023财年年报,目前有400万名开发者正在与CUDA合作。在过去的两年半里,这一数字翻了一番,CUDA的下载量已经超过了4000万次。此外,英伟达还推出了CUDA-X AI,这是一组建立在CUDA之上的软件加速库,提供了深度学习、机器学习和高性能计算所需的优化功能,成为了数据科学加速的端到端平台。

    竞争与挑战

    尽管CUDA在计算领域取得了巨大成功,但竞争对手也不甘示弱。AMD推出了生态平台ROCm,同样兼容不少计算框架。OpenAI的Triton被认为是CUDA的有力挑战者。苹果设计的开源构架OpenCL借鉴了CUDA的成功经验,并支持多核CPU、GPU或其他加速器。谷歌通过TPU、TensorFlow和云吸引开发者和客户。

    然而,在实际工作中,这些竞争者面临各种问题。一些开发者表示,虽然理论上支持这些竞争技术,但在实际使用中经常遇到错误和崩溃。

    结语

    CUDA技术的崛起改变了计算领域的格局,使GPU成为了大数据计算的基石。它在科学研究、工程模拟、机器学习等领域发挥着不可替代的作用。尽管竞争者不断涌现,但CUDA的生态系统仍然如日中天,英伟达在这个领域占据着主导地位。

    在未来,我们可以期待CUDA技术继续演化,为计算领域带来更多的创新和进步。

  • 解决TensorFlow部署问题:处理不支持AVX指令集的N5015小主机

    解决TensorFlow部署问题:处理不支持AVX指令集的N5015小主机

    在软件开发和部署中,时常会遇到各种挑战和问题。有时,你可能会遇到硬件限制,比如CPU不支持某些指令集,这可能会导致部署TensorFlow项目时的困扰。在本篇文章中,我们将讨论如何解决在N5015小主机上部署TensorFlow项目时出现的AVX指令集不支持的问题。

    引子:挑战的开始

    故事发生在一位开发者的N5015小主机上,他试图部署一个TensorFlow项目,但却遭遇到了一个棘手的问题:CPU不支持AVX指令集。这个问题让他陷入了困境,因为TensorFlow自从1.6版本以后开始使用AVX指令集,而这些指令在旧版CPU上无法运行。

    他经过了一番排查,尝试了多个容器镜像,但每次容器都无法启动。在云服务器和他自己的Windows 10电脑上,项目完美运行,但在N5015小主机上却无法正常工作。

    容器的状态一直显示为”Restarting”,日志中也没有任何有用的信息。他尝试使用命令sudo cat /proc/cpuinfo | grep avx来检查CPU是否支持AVX指令集,结果显示并没有AVX指令集的支持。这就是问题的根本原因。

    问题分析:AVX指令集的重要性

    为了更好地理解问题,让我们先来了解一下AVX指令集的重要性。AVX(Advanced Vector Extensions)是一组x86处理器架构的指令扩展,它们用于并行浮点运算。TensorFlow使用AVX指令集来加速计算,特别是在深度学习模型的训练和推理过程中。

    从TensorFlow 1.6版本开始,官方二进制文件使用AVX指令集,这意味着如果你的CPU不支持AVX指令集,就无法运行官方提供的TensorFlow版本。这就是为什么在N5015小主机上出现问题的原因。

    解决方案一:更换硬件

    故事中的一位开发者提到,最简单的解决方案之一是更换硬件。如果你的N5015小主机不支持AVX指令集,那么可以考虑更换为支持AVX的CPU。这将解决TensorFlow部署的问题,使你能够顺利运行项目。

    然而,硬件更换可能会涉及成本和时间,因此这不一定是最快速的解决方法,尤其是在预算有限的情况下。

    解决方案二:使用低版本TensorFlow镜像

    另一个解决方案是使用低版本的TensorFlow镜像。在TensorFlow的早期版本中,可能没有使用AVX指令集,因此可以尝试使用旧版本的TensorFlow。这可以通过Docker容器或虚拟环境来实现。

    虽然这种方法可以解决AVX指令集的问题,但需要确保你的项目与所选TensorFlow版本兼容。有些新功能和性能优化可能只在较新的TensorFlow版本中可用。

    解决方案三:自行编译TensorFlow

    如果你对TensorFlow项目非常熟悉,可以考虑自行编译TensorFlow以去除AVX依赖。这需要一定的编程和编译知识,但可以让你在不支持AVX指令集的CPU上运行TensorFlow。

    自行编译TensorFlow的过程可能会复杂,但如果你具备必要的技能,这是一种高度定制化的解决方案,可以满足特定需求。

    解决方案四:导出模型并使用TFLite

    另一种方法是导出你的模型并使用TensorFlow Lite(TFLite)来运行。TFLite是TensorFlow的轻量级版本,专门设计用于移动和嵌入式设备。它通常不需要AVX指令集,并且可以在资源有限的设备上运行。

    通过将模型导出为TFLite格式,你可以在N5015小主机上运行TensorFlow Lite,而不必担心AVX指令集的问题。

    结论:根据需求选择解决方案

    在面对N5015小主机不支持AVX指令集的问题时,有多种解决方案可供选择。你可以根据你的需求和技术水平来选择最合适的解决方案。

    • 如果预算允许,硬件更换是最直接的解决方法。
    • 使用低版本TensorFlow镜像是一个快速而简单的解决方案,前提是你的项目与所选版本兼容。
    • 如果你有编程和编译经验,可以考虑自行编译TensorFlow以去除AVX依赖。
    • 对于移动和嵌入式设备,导出模型并使用TFLite是一个不错的选择。

    无论你选择哪种方法,重要的是能够克服AVX指令集的限制,顺利部署和运行你的TensorFlow项目。