Category: AI 实践

  • 人工智能AIGC行业研究报告:GPT-4v多模态能力解析

    人工智能AIGC行业研究报告:GPT-4v多模态能力解析

    在当今世界,人工智能技术正日益成为各行各业的关键驱动力。其中,多模态能力的提升是人工智能领域的一项重要突破。本文将深入探讨最新发布的人工智能模型GPT-4v的多模态能力,以及这一技术如何从文生成图,再从图生成文,为未来应用带来前所未有的机会。

    GPT-4v多模态能力的引入

    最近,Open AI宣布了GPT-4v的即将发布,其中包括了多模态功能,涵盖了图像读取与理解、语音对话和语音生成等领域。这一发布引起了广泛的关注和期待,原因在于GPT-4v在多模态领域有着显著的突破。

    多模态能力的重要性

    GPT-4v的多模态能力意味着它可以同时处理多种混合输入方式,包括文本、图像和语音。这为它赋予了更广泛的应用潜力,能够胜任包括视觉理解、文档推理、多模态知识等多种具体任务。这对于实现更智能、更灵活的人工智能应用具有重要意义。

    强大的多模态能力

    GPT-4v展现出了强大的多模态能力,这主要体现在以下方面:

    1. 指令跟随与思维链:GPT-4v可以根据输入的指令进行跟随,并形成连贯的思维链,这使得它在多步骤任务中表现出色。

    2. 上下文少样本学习:即使在有限的上下文信息下,GPT-4v也能够学习并适应新的任务,表现出了强大的泛化能力。

    3. 多种具体任务:GPT-4v能够应对各种具体任务,包括视觉理解、文档推理等,表现出了多领域的应用潜力。

    多模态基础工作:ViT和CLIP

    要理解GPT-4v的多模态能力,有必要了解多模态技术的基础工作。其中,Vision Transformer(ViT)和Contrastive Language-Image Pretraining(CLIP)是两项重要的基础工作。

    Vision Transformer(ViT)

    ViT首次将Transformer架构应用于计算机视觉任务,它能够将图像信息转化为可以被模型理解的向量表示。这一突破使得语言和视觉特征可以通过相同的Transformer架构提取,从而实现了多模态技术的基础。

    CLIP

    CLIP则将文本和图像进行对应,通过在互联网上抓取已经有过描述的文本-图像数据集,为多模态模型提供了大规模的训练数据。CLIP的出现使得模型能够更好地理解文本和图像之间的联系,为多模态技术奠定了基础。

    GPT-4v多模态能力的来源

    GPT-4v的多模态能力有其独特的来源,这些来源解释了它为何如此强大:

    1. 已有语言模型基础:GPT-4v基于已有的强大语言模型基础构建,这使得它能够借助类似Flamingo架构的交叉注意力机制,引入图像理解能力。这一方法减少了构建多模态模型的成本。

    2. 安全工作:在发布之前,GPT-4v经历了大量安全工作,包括减少幻觉、拒绝越狱指令、拒绝回答刻板印象和仇恨问题等。这些工作确保了模型的可靠性和安全性。

    3. 优质联合训练数据:GPT-4v使用了包括CLIP在内的优质联合训练数据,这为模型提供了多模态信息,有助于提高其性能。

    4. 并行计算策略:GPT-4v采用了并行计算策略,使其能够高效地处理多模态任务,并且达到了175B参数规模的Davinci模型的3倍推理成本。

    未来展望

    不仅仅是Open AI,Google也在多模态领域取得了显著进展。Google发布的Palm-E和即将发布的Gemini都展示了多模态大模型的潜力。这些新技术的出现将推动人工智能领域的发展,为各种领域的应用带来新的可能性。

    结论

    GPT-4v的多模态能力标志着人工智能技术的一个重要里程碑。它的强大多模态能力将为开发者和研究人员提供更多的工具,用于创造智能应用和解决多领域的问题。我们期待着未来,看到多模态技术在各个领域的广泛应用。
  • OpenAI计划推出重大更新,吸引开发者以更低成本构建应用程序

    OpenAI计划推出重大更新,吸引开发者以更低成本构建应用程序

    在人工智能领域,OpenAI一直是备受瞩目的公司之一。最近,根据消息来源透露,OpenAI计划在下个月推出重大更新,旨在为开发者提供更便宜和更快的构建基于其人工智能模型的软件应用程序的工具。这一举措旨在吸引更多公司使用OpenAI的技术,进一步扩大其市场份额。

    新功能

    这次更新的亮点之一是为开发者工具添加了内存存储功能,这将理论上可以将应用程序制作成本降低多达20倍。对于那些试图通过开发和销售AI软件来构建可持续业务的合作伙伴来说,这是一个重大关切,因为使用OpenAI的强大模型的成本可能会迅速累积。

    此外,OpenAI还计划推出新的工具,如视觉功能,使开发者能够构建具有分析图像和描述图像能力的应用程序,潜在用途涵盖娱乐到医学等各个领域。

    这些新功能标志着OpenAI公司的雄心,希望不仅成为消费者关注的焦点,还希望成为吸引开发者的热门平台。公司的首席执行官Sam Altman一直有这个愿景。尽管OpenAI是由Elon Musk和Altman于2015年共同创立的非营利组织,但它现在有望在技术行业以外的领域取得更大的影响。

    这些新功能预计将在OpenAI的首个开发者大会上发布,该大会定于11月6日在旧金山举行。据消息来源透露,它们旨在鼓励公司使用OpenAI的技术来构建AI驱动的聊天机器人和自主代理,这些代理可以在没有人为干预的情况下执行任务。

    对开发者的重要性

    对OpenAI来说,使其他公司在构建应用程序时离不开它的技术是最重要的战略目标之一。为此,他们计划推出所谓的有状态API(Application Program Interface),这将使公司更便宜地创建应用程序,因为API将记住查询的对话历史。这将极大地减少开发者需要支付的费用。根据OpenAI网站上的定价,目前使用GPT-4处理一个页面的文档可能需要10美分,具体费用取决于输入和输出的长度和复杂性。

    另一个更新是视觉API,它将允许人们构建可以分析图像的软件。这一功能在ChatGPT用户中已经推出了数周。为开发者提供这一工具也标志着OpenAI正在推出所谓的多模态能力,这些能力可以处理和生成文本之外的不同类型的媒体,如图像、音频和视频。

    吸引开发者

    这些更新旨在吸引更多的开发者,他们愿意支付以访问OpenAI的模型,以构建各种用途的自己的AI软件,例如写作助手或客户服务机器人。

    今年,投资者已经向人工智能初创公司投入了超过200亿美元,其中许多公司依赖于OpenAI或其他基础模型公司的技术。然而,投资者担心这些初创公司过于依赖像OpenAI或Google这样的公司,因为这可能会使它们容易受到竞争对手或更大的公司通过产品更新的复制。

    与此同时,初创公司还试图多样化使用的模型类型,尝试OpenAI竞争对手和开源选项,例如Meta的Llama。这使得OpenAI需要与像谷歌这样的财大气粗的竞争对手区分开来。

    保持开发者满意一直是OpenAI的重要关注点。尽管ChatGPT在消费者中取得了巨大成功,但OpenAI赢得其他公司的信任并不一帆风顺。

    今年早些时候,该公司急于推出ChatGPT插件,这是一种允许开发者在ChatGPT内创建应用程序的附加工具。OpenAI希望插件将成为其对抗谷歌的Bard等竞争对手的优势,就像苹果的iOS应用商店一样。

    然而,插件在“热门”类别中的前30名插件的开发者描述了一开始的炒作,然后是兴趣的急剧下降。据开发者Lakshya Bakshi估计,热门的Scholar AI插件在8月底每天约有7000名用户。而ChatGPT吸引了约1.8亿月活跃用户。

    Altman公开承认还有更多工作要做。今年早些时候,Altman在伦敦的一群开发者面前承认插件在市场上并没有取得市场份额。

    结论

    OpenAI计划推出的这些重大更新将对开发者和公司带来积极影响。通过降低使用成本和提供更多功能,OpenAI希望

    吸引更多的开发者,进一步巩固其在人工智能领域的领先地位。这也反映了人工智能领域的竞争激烈,各公司都在努力满足开发者和用户的需求,以保持竞争力。

  • GPT-4的视觉能力:从阅读X光到解密机密UFO报告

    GPT-4的视觉能力:从阅读X光到解密机密UFO报告

    人工智能在短短几年内迅速崭露头角,尤其是那些看似神奇的聊天机器人,但基于文本的互动已经显得有些过时。然而,OpenAI的GPT-4升级宣布了GPT-Vision(GPT-V),这是最新的多模态AI奇迹。如今,这一宣布已经成为现实,用户终于有机会测试其潜力。

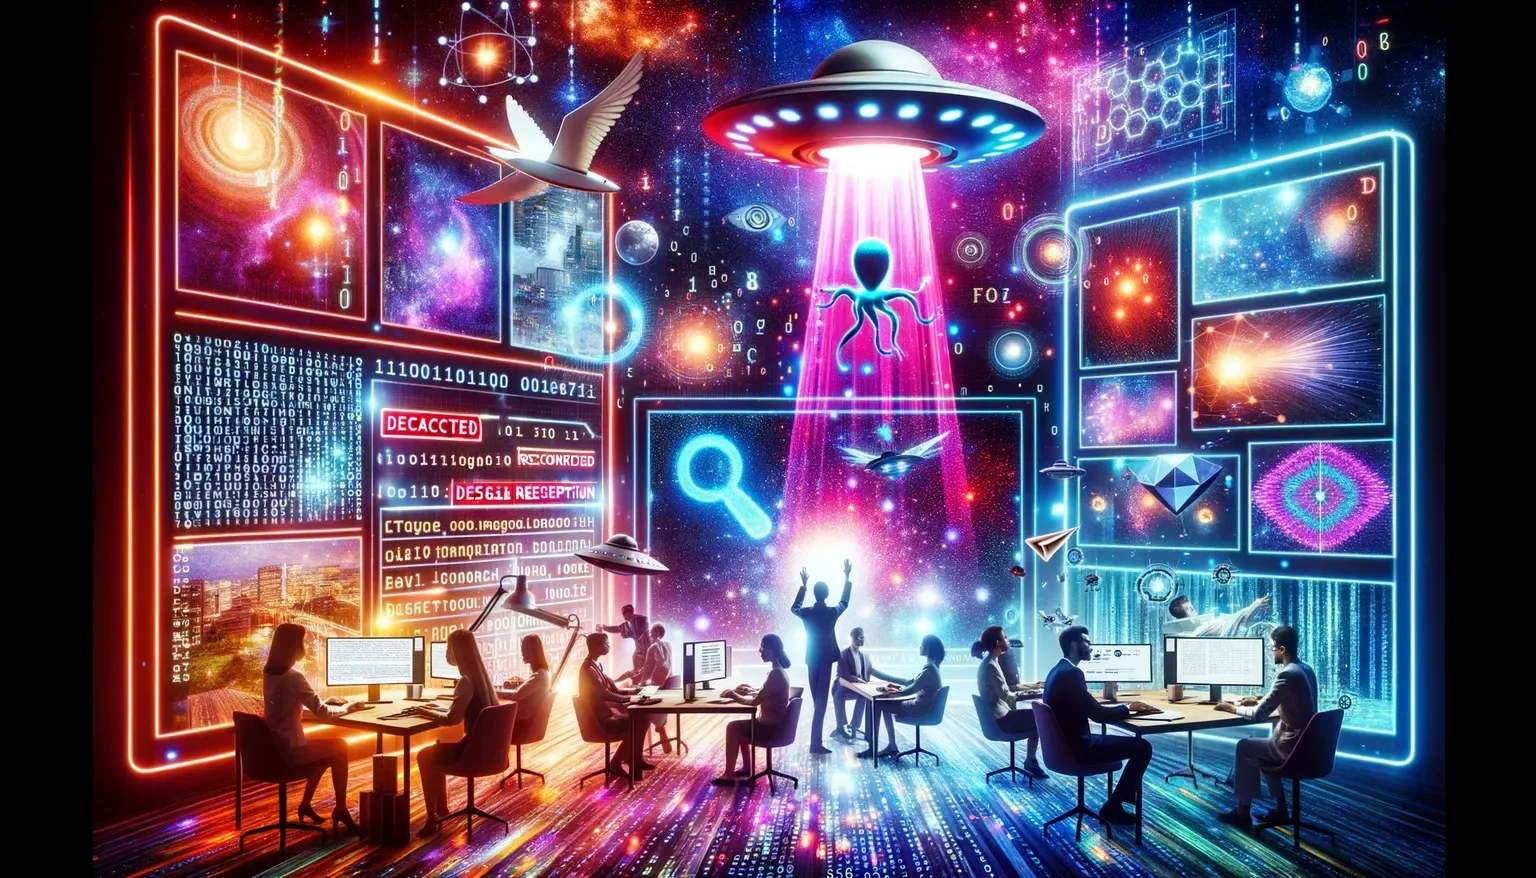
    GPT-4的视觉能力:从阅读X光到解密机密UFO报告 GPT-4的视觉能力:从阅读X光到解密机密UFO报告

    多模态大型语言模型(LLM)意味着它不仅可以与书面文字互动,还可以通过其他模式进行交互。在这种情况下,新的GPT-V可以理解图像并与之合作。此外,由于新的生成艺术工具DALL-E 3,ChatGPT既可以将图像作为输入,也可以生成图像作为输出。

    这些新功能引起了科技领域的广泛关注,因为用户将它们投入使用并进行测试。它们能够解码被删减的政府文件中的关于不明飞行物目击事件的信息吗?答案是肯定的。“ChatGPT-4V多模态解码了NASA发布的有关UFO目击事件的一份被删减的政府文件,”一条推文如此赞叹道。“也许真相不在外面,而是在GPT-V这里。”

    我已经在数百份被删减的文件上进行了测试,我可以说我们进入了一个新世界。几乎100%的意图准确性。” 他报告说。

    当然,很难验证它对被删减内容的猜测是否准确,毕竟我们不能去问CIA,它在窥探黑线时做得有多好。

    GPT-4的视觉革命

    GPT-4的升级引入了一个全新的维度 – 视觉。这个多模态AI不仅仅可以处理文本,还可以理解和生成图像。这一革命性的功能将AI带入了一个全新的境界,我们将在接下来的文章中深入探讨。

    背景

    在我们深入研究GPT-4的视觉能力之前,让我们回顾一下GPT-4的前身。GPT-3是一个巨大的突破,它在自然语言处理领域取得了显著的进展。然而,GPT-4不仅仅是GPT-3的继任者,它是一个全新的多模态AI,可以理解和生成文本以及图像。

    GPT-4的视觉能力

    GPT-4的视觉能力来自于其新的架构和训练方法。它可以处理各种图像,并根据图像生成文本描述。这一能力有着广泛的应用,从医学诊断到图像生成艺术都可以受益。

    在医学中的应用

    GPT-4的视觉能力在医学领域具有潜力。它可以分析X光片,帮助医生诊断疾病。例如,医生可以将患者的X光片输入到GPT-4中,AI会快速分析图像并提供有关患者状况的信息。这种技术可以加速医学诊断过程,挽救更多生命。

    艺术创作

    除了在医学中的应用,GPT-4的视觉能力还可以用于艺术创作。借助DALL-E 3,GPT-4可以生成各种艺术作品,从抽象画到风景照片,无所不能。这为艺术家提供了一个新的创作工具,可以帮助他们发挥无限的想象力。

    解密文件

    最引人注目的是GPT-4可以解码被删减的政府文件。这引发了广泛的好奇心,因为它提供了一个可能解开许多谜团的途径。虽然不能确定其准确性,但这一功能无疑引发了许多关于政府保密文件的猜测。

    测试GPT-V的能力

    为了测试GPT-V的能力,一位用户采取了一种创新的方法,让AI猜测了被审查的文本的部分内容。据他称,几乎100%的准确性。尽管很难验证准确性,但这确实展示了GPT-V的惊人潜力。

    结论

    GPT-4的视觉能力是人工智能领域的一次革命。它不仅可以处理文本,还可以理解和生成图像,为各行各业带来了巨大的机会。从医学诊断到艺术创作,再到政府文件解密,GPT-4的应用潜力无限。我们正站在一个全新的AI时代的门槛上,GPT-4为我们开辟了更广阔的未来。

  • 从零开始:我如何掌握OpenAI的ChatGPT API密钥并成为AI领域的新星

    从零开始:我如何掌握OpenAI的ChatGPT API密钥并成为AI领域的新星

    回忆起那天,我还是一个对AI一窍不通的小白,每次看到那些“机器人帮我做这做那”的视频,总是既羡慕又嫉妒。直到有一天,我无意中听说了OpenAI的ChatGPT,这一切都开始发生改变。我决定尝试一下,也许,我也可以成为那个“机器人的主人”。而这篇文章,正是我如何从一个小白变成AI专家的故事。

    获取ChatGPT API密钥:你的AI之旅的开始

    OpenAI的ChatGPT,如今可谓是AI领域的一颗耀眼的星星。作为一个强大的自然语言处理模型,它能够助你完成从简单的问题回答到复杂的对话生成等各种任务。想要使用这一强大工具,首先你需要一个API密钥。那么,如何获取这把“通往AI世界的钥匙”呢?跟随我的脚步,让我们一起开始这段探索之旅。

    步骤1:加入OpenAI的大家庭

    想要开始这段AI之旅,首先你需要成为OpenAI的一员。打开OpenAI的官方网站,你会在右上角看到一个明亮的“Sign up”按钮。点击它,然后根据提示输入你的个人信息和设定密码。这个过程非常简单,几分钟之内你就可以完成注册。

    步骤2:与OpenAI建立联系

    注册完成后,你需要提供一个有效的电子邮件地址,这样OpenAI才能与你联系,并发送API密钥。登录你的OpenAI帐户,找到“Add Email”选项,然后输入你的电子邮件地址。完成这一步骤后,你就距离你的API密钥又近了一步!

    步骤3:得到你的专属API密钥

    这一步可能是最令人兴奋的一步了!返回到OpenAI的主页面,找到“API”选项卡,然后选择“Create API Key”。根据提示填写相关信息,如API密钥的名称和描述等。完成这些后,你的API密钥就生成了!是不是很简单?

    步骤4:开启你的AI之旅

    有了API密钥,你就可以开始你的AI之旅了!复制你的API密钥,然后将其粘贴到支持ChatGPT API的应用程序或你的代码中,你就可以开始使用这一强大的自然语言处理模型了。

    踏上AI的舞台,你准备好了吗?

    回想我第一次使用ChatGPT的经历,那种兴奋和新奇至今仍历历在目。现在,有了这篇教程,你也可以像我一样,轻松掌握OpenAI的ChatGPT API密钥,开启你的AI之旅。无论你是初学者还是专家,ChatGPT都能给你带来无尽的可能性和乐趣。所以,不要犹豫,立刻行动,踏上这条充满无限可能的AI之路吧!

  • 微软Windows Copilot:了解其使用限制和尝试方法

    微软Windows Copilot:了解其使用限制和尝试方法

    随着科技的不断进步,微软的Windows Copilot成为了人工智能的一个新代表。然而,最近的消息表明,不是所有用户都能轻松使用它。本文将深入探讨Windows Copilot的情况,以及在不受支持的地区如何尝试使用它。

    microsoft artificial intelligence assistant microsoft artificial intelligence assistant

    Windows Copilot的介绍

    Windows Copilot是Windows 11 Moment 4更新的一部分,于9月26日开始向普通用户推出。它是由ChatGPT和微软内部的大型语言模型(LLMs)支持的,与Windows应用程序和功能进行交互,包括Microsoft Office、Paint、照片、Windows设置等等。

    然而,令人遗憾的是,并非所有人都能够轻松享受Windows Copilot的便利。目前,它仅在美国(以及北美)、英国以及亚洲和南美洲的一些国家可用。这是因为在欧洲等地区,由于隐私保护法的原因,Copilot目前不可用。但微软已经表示将支持范围扩展到美国和英国以外的地区。

    如何在不受支持的地区尝试Copilot

    如果您位于不受支持的地区,但仍希望尝试使用Copilot,您可以尝试以下步骤来调用人工智能:

    1. 打开记事本或任何应用程序,创建一个名为「Copilot.exe」的空文件。

    2. 将「Copilot.exe」文件固定到桌面或任务栏。右键单击该文件。

    3. 选择「属性」。

    4. 在「Copilot.exe」的属性中,将目标更改为以下位置:

    C:\Windows\explorer.exe "microsoft-edge:///?ux=copilot&tcp=1&source=taskbar"
    1. 单击新创建的桌面或任务栏快捷方式,即可在Windows 11中启动Copilot。

    尽管这些步骤可以让您尝试Copilot,但需要注意的是,目前的Copilot预览版本可能并不是完美的。它在执行多个提示时可能表现不一致,无法执行特定操作,仍需要改进。

    Copilot的潜力与挑战

    虽然Windows Copilot有潜力改变计算机领域,但目前它还处于预览阶段,工作并不总是如人意。它仍然需要进一步的改进,以提供更加稳定和有用的功能。

    当前的Copilot预览不支持更深入的Windows集成或第三方应用程序和插件的支持。然而,微软表示人工智能将会不断改进,未来可能会带来更多令人激动的功能。

    结论

    Windows Copilot是微软在人工智能领域的一项重要尝试,虽然目前受限于地区和功能,但展现出了潜力。如果您位于支持地区,不妨尝试一下这个新的AI助手,看看它是否能为您提供便利。同时,期待微软未来的改进,使Copilot成为更加强大和有用的工具。

    在这个充满科技创新的时代,我们期待着看到更多令人惊喜的人工智能应用的出现。

  • 苹果 iPhone 15:直观人工智能的新纪元

    苹果 iPhone 15:直观人工智能的新纪元

    回顾一下,我们曾经期待技术产品的每一次更新都带来激动人心的生成式人工智能功能,这些功能可以为我们提供各种强大的文本和图像处理能力。然而,2023年的iPhone 15发布似乎选择了一种「不同的思考」,强调直观的人工智能,而不是突出生成式人工智能,将人工智能融入我们的生活,以平稳处理问题或提供有用的预测,而不引人注目。这是苹果做出的一项引人注目的选择。

    iPhone 15:直观人工智能的焦点

    iPhone 15搭载了A17 Pro处理器,这是由苹果设计的芯片,为机器学习算法提供更多的计算能力。然而,在发布会上,苹果强调的功能相对微妙,没有过多的华丽效果。该公司似乎专注于直观的人工智能,使得人工智能成为日常生活的一部分,可以自然地处理问题或提供有用的预测,而不引起过多的注意。这也是苹果在今年6月的开发者大会上所做的选择,忽视了生成式人工智能的风潮。

    直观人工智能的应用

    例如,iPhone 15引入的新语音突显功能采用了机器学习技术,能够识别和聚焦用户的声音,将电话中的背景噪音降至最低。与此同时,像往常一样,iPhone发布会花费了大量时间介绍新手机的相机和图像增强软件的功能。这些功能同样依赖于人工智能,例如自动检测照片中的人物、狗或猫,并收集深度信息,以将任何照片转化为人像模式照片。

    通过新的iOS 17操作系统,基于人工智能的额外服务也将传递到新的iPhone型号上。这些服务包括语音邮件的自动转录,用户可以在接听电话之前看到来电者信息,以及更广泛的文本建议,以及更强大的图像增强功能。尽管这些功能不像全知的聊天机器人那样引人注目,但它们通过让生活更加便捷,可能会鼓励人们更多地使用手机,提高苹果服务的使用率。

    直观人工智能在无障碍功能中的应用

    直观人工智能还在一些新的无障碍功能中发挥作用。对于盲人或视力有障碍的人,iPhone 15的放大器应用程序引入了新的指向并朗读功能,使他们可以将相机对准带有按钮的物体(如微波炉),并听到手机朗读出他们触摸的按钮。对于像肌萎缩性侧索硬化症等医疗状况,iOS 17可以在读取15分钟的文本提示后生成一个类似于他们的合成声音,帮助他们保持沟通。

    直观人工智能的未来

    苹果的选择强调了直观人工智能的重要性,尤其是将其应用于智能手机和无障碍功能中。虽然iPhone 15并没有将扭曲现实的图像生成集成进来,也没有推出具有道德争议的功能,但它们强调了提升颜色、变焦和自动人像拍摄等功能的重要性。苹果擅长的界面设计可以让微妙的人工智能功能得以发挥作用。

    结语

    总的来说,虽然iPhone 15的发布可能没有像以往一样令人激动,但它带来了直观人工智能的新纪元。苹果似乎更注重使人工智能更加融入生活,解决问题,而不是只追求惊艳的技术。这一选择可能会引领未来的技术发展方向,将直观人工智能带入更多领域,让我们的生活更加便捷和智能。

  • GPT-4安全漏洞揭秘:如何通过少见语言绕过限制

    GPT-4安全漏洞揭秘:如何通过少见语言绕过限制

    曾经,人工智能的发展被认为是科技领域的一项伟大成就,它们能够执行各种任务,从自然语言处理到图像识别。然而,就像每一项伟大的力量一样,人工智能也有其潜在的风险和漏洞。最近,一组计算机科学研究人员揭示了OpenAI的GPT-4存在的一个安全漏洞,这个发现引发了对人工智能安全性的担忧。

    GPT-4的安全漏洞

    GPT-4是OpenAI最新的语言模型,被认为在自然语言生成方面具有惊人的能力。然而,这个研究发现,GPT-4在处理非常见训练数据中的语言时存在漏洞。具体来说,研究人员使用了一些少见语言,如祖鲁语和盖尔语,成功绕过了GPT-4的限制性设置。

    绕过GPT-4的方法

    研究人员的发现令人震惊,尤其是在处理非英语语言的限制性提示时,成功率高达79%。他们的方法很简单:将不安全的提示翻译成GPT-4未经过训练的语言,比如将英语提示翻译成祖鲁语。这种简单的方法就足以绕过GPT-4的安全机制,引发有害回应。

    这一发现引发了对GPT-4的安全性机制的担忧,特别是在处理低资源语言时。目前,OpenAI尚未对这一问题做出回应,但这一漏洞的存在提醒我们,人工智能的安全性问题需要被认真对待。

    重视跨语言安全性

    从这一研究的结果来看,我们不得不承认研究人员强调了未来安全研究中需要包括更多非英语语言的重要性。仅仅在英语中进行测试会导致对大型语言模型的安全性产生误解。跨语言漏洞的发现揭示了语言在安全研究中的不平等估值。

    结语

    尽管这一研究可能会给网络犯罪分子提供新的想法,但研究人员认为将这一漏洞公之于众是必要的。利用现有的翻译API轻松实施这些攻击,因此那些试图绕过安全防护的恶意行为者最终会发现这一漏洞。人工智能的安全性问题是一个持续关注和研究的话题,我们必须不断努力改进和加强安全性,以确保技术的发展不会带来潜在的风险和危险。

  • ChatGPT DALL·E 3 绘画模型试用体验

    ChatGPT DALL·E 3 绘画模型试用体验

    在数字化时代,人工智能技术不断进步,为我们带来了越来越多令人惊叹的应用。最近,我有幸体验了ChatGPT DALL·E 3绘画模型,这是一项令人兴奋的尝试。在这篇文章中,我将分享我的体验和感想。

    申请与准备

    首先,我需要前往指定的申请链接,确保我是ChatGPT的Plus用户,并使用ChatGPT账号(邮箱)进行申请。虽然我申请后等待了一段时间,但最终成功获得了使用权限。如果您也想尝试这一令人兴奋的模型,请点击申请地址进行申请。

    体验感想

    1. 生产速度

    与之前体验的其他模型相比,ChatGPT DALL·E 3的生产速度让我印象深刻。生成图像仅需要十几秒的时间,这比以往的模型快了很多。

    2. 自然语言描述

    与DALL·E 3互动时,我发现不需要输入一堆提示信息。它能够更好地理解自然语言描述,这使得使用起来更加便捷和直观。

    3. 生成的图像

    最重要的是,生成的图像令我非常满意。它们符合我的预期,质量很高,与自然界中的物体和场景相似。这让我想象到了在创作和设计领域中的潜在应用。

    图像示例

    限制和使用频率

    尽管DALL·E 3在生产速度和生成质量方面表现出色,但仍然存在一些使用限制。Plus用户可以在三小时内提出50个问题,这意味着在三小时内可以生成50个主题的图像。

    结语

    总的来说,ChatGPT DALL·E 3绘画模型的试用体验是令人兴奋的。它的生产速度、自然语言理解和生成质量都让我印象深刻。虽然仍然存在一些使用限制,但这是一个令人期待的工具,有着广阔的应用前景。

    如果你也是ChatGPT的Plus用户,不妨前往申请链接,亲自体验这一令人惊叹的绘画模型。

  • VALL-E X: 多语言文本转语音合成和声音克隆 ?

    VALL-E X: 多语言文本转语音合成和声音克隆 ?

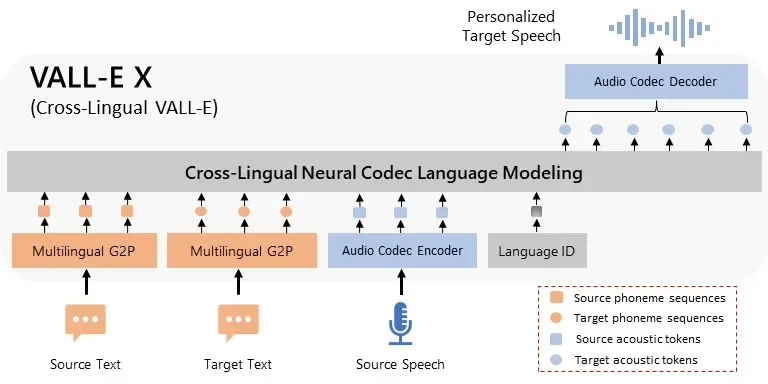
    在数字化时代,人工智能领域的进步一直在改变我们的生活。其中,文本转语音合成(TTS)技术是一个备受关注的领域,它允许计算机将文本转化为自然语音,为各种应用场景带来了巨大的潜力。今天,我们将介绍一项令人兴奋的开源项目——VALL-E X,它是微软提出的零样本TTS模型的一个开源实现。让我们一起探索这个项目,了解它的功能、应用以及如何使用。

    VALL-E X: 多语言文本转语音合成和声音克隆 VALL-E X: 多语言文本转语音合成和声音克隆

    开篇故事

    假设你是一位电影制片人,正在为一部国际制作的电影进行配音工作。你需要在电影中为不同国家的角色录制对白,但时间和资源有限,无法请到各国的本地演员。这时,你听说了VALL-E X,一个可以进行多语言文本转语音合成和声音克隆的强大工具。

    你想象一下,如果你能够使用VALL-E X,只需提供文本,即可在不同的语言和声音中生成高质量的语音。这不仅将节省时间和成本,还将使你的电影更加国际化。现在,让我们深入了解VALL-E X的功能和用法。

    项目介绍

    项目背景

    VALL-E X是由微软提出的一种多语言文本转语音合成(TTS)模型。尽管微软在其研究论文中介绍了这一技术,但他们并没有发布任何代码或预训练模型。鉴于这项技术的潜力和价值,开发团队决定复现这一成果,并训练了自己的VALL-E X模型。他们将这个开源项目分享给了社区,使每个人都能够体验到下一代TTS技术的强大之处。

    功能亮点?

    VALL-E X拥有许多令人印象深刻的功能,使其成为一个引人注目的项目:

    1. 多语言TTS:VALL-E X支持英语、中文和日语三种语言,可以进行自然和富有表现力的语音合成。

    2. 零样本声音克隆:你可以提供一个短暂的3到10秒的录音,即使是不熟悉的说话者,VALL-E X也可以生成个性化的高质量语音,听起来就像他们一样!

    3. 语音情感控制:VALL-E X可以根据提供的声音情感合成语音,为音频增添更多表现力。

    4. 零样本跨语言语音合成:VALL-E X可以在不牺牲流畅度或口音的情况下,为一种语言的说话者生成另一种语言的语音。

    5. 口音控制:你可以尝试不同的口音,比如用英语口音说中文或反之。

    6. 声音环境适应:不需要完美干净的音频提示!VALL-E X可以适应输入的声音环境,使语音生成更加自然和沉浸。

    安装和使用

    现在,让我们来了解如何安装和使用VALL-E X。

    安装

    首先,你需要按照以下步骤安装VALL-E X:

    git clone https://github.com/Plachtaa/VALL-E-X.git
    cd VALL-E-X
    pip install -r requirements.txt

    请注意,如果你希望创建提示音,你需要安装ffmpeg并将其文件夹添加到环境变量PATH中。

    使用

    一旦安装完成,你可以使用以下示例代码生成语音:

    from utils.generation import SAMPLE_RATE, generate_audio, preload_models
    from scipy.io.wavfile import write as write_wav
    from IPython.display import Audio
    
    # 下载和加载所有模型
    preload_models()
    
    # 从文本生成语音
    text_prompt = "你好,我是VALL-E X,一个强大的多语言文本转语音合成模型。"
    audio_array = generate_audio(text_prompt)
    
    # 将语音保存到磁盘
    write_wav("vallex_generation.wav", SAMPLE_RATE, audio_array)
    
    # 在笔记本中播放语音
    Audio(audio_array, rate=SAMPLE_RATE)

    通过上述代码,你可以很容易地生成自己的语音。

    在线演示

    如果你还不想在本地设置环境,也可以通过在线演示来尝试VALL-E X,无需任何麻烦的配置。你可以直接在Hugging Face或Google Colab上体验VALL-E X的能力。

    点击这里进入Hugging Face演示

    点击这里进入Google Colab演示

    结语

    VALL-E X是一个令人激动的项目,它为多语言文本转语音合成和声音克隆提供了前所未有的可能性。无论你是电影制片人、语音合成研究人员还是只是对新技术充满好奇,VALL-E X都值得一试。它的多语言支持、声音情感控制和零样本声音

    克隆等功能,使其在语音合成领域脱颖而出。从现在开始,你可以更轻松地探索多语言语音合成的奇妙世界!

    如果你想要了解更多关于VALL-E X的信息,可以访问项目的GitHub页面:https://github.com/Plachtaa/VALL-E-X

    愿VALL-E X为你的创意和项目带来无限可能!

  • Stable-Diffusion-WebUI支持SDXL的ControlNet模型下载

    Stable-Diffusion-WebUI支持SDXL的ControlNet模型下载

    大家好,我是王大神。今天,我有一个激动人心的消息要与大家分享!最近,我重新安装了最新版本的Stable-Diffusion-WebUI,并更新了所有ControlNet模型。我决定将这一利好消息与大家分享,并提供下载链接。

    Stable-Diffusion-WebUI支持SDXL的ControlNet模型下载 Stable-Diffusion-WebUI支持SDXL的ControlNet模型下载

    分享下载链接

    我知道很多人都渴望尽早获得这些更新后的ControlNet模型。因此,我将这些模型上传到我的个人网盘,并提供下载链接,没有限速,方便大家快速获取。你可以通过以下链接下载:

    ControlNet模型下载链接

    以下是模型文件清单:

    文件名 大小
    diffusers_xl_canny_full.safetensors 2.33G
    diffusers_xl_canny_mid.safetensors 519.94M
    diffusers_xl_canny_small.safetensors 305.40M
    diffusers_xl_depth_full.safetensors 2.33G
    diffusers_xl_depth_mid.safetensors 519.94M
    diffusers_xl_depth_small.safetensors 305.40M
    ioclab_sd15_recolor.safetensors 689.12M
    ip-adapter_sd15.pth 42.57M
    ip-adapter_sd15_plus.pth 150.71M
    ip-adapter_xl.pth 670.04M
    kohya_controllllite_xl_blur.safetensors 44.03M
    kohya_controllllite_xl_blur_anime.safetensors 44.03M
    kohya_controllllite_xl_blur_anime_beta.safetensors 21.47M
    kohya_controllllite_xl_canny.safetensors 44.03M
    kohya_controllllite_xl_canny_anime.safetensors 44.03M
    kohya_controllllite_xl_depth.safetensors 44.03M
    kohya_controllllite_xl_depth_anime.safetensors 10.80M
    kohya_controllllite_xl_openpose_anime.safetensors 44.03M
    kohya_controllllite_xl_openpose_anime_v2.safetensors 44.03M
    kohya_controllllite_xl_scribble_anime.safetensors 44.03M
    sai_xl_canny_128lora.safetensors 377.38M
    sai_xl_canny_256lora.safetensors 738.55M
    sai_xl_depth_128lora.safetensors 377.38M
    sai_xl_depth_256lora.safetensors 738.55M
    sai_xl_recolor_128lora.safetensors 377.38M
    sai_xl_recolor_256lora.safetensors 738.55M
    sai_xl_sketch_128lora.safetensors 377.38M
    sai_xl_sketch_256lora.safetensors 738.55M
    sargezt_xl_depth.safetensors 2.33G
    sargezt_xl_depth_faid_vidit.safetensors 2.33G
    sargezt_xl_depth_zeed.safetensors 2.33G
    sargezt_xl_softedge.safetensors 2.33G
    t2i-adapter_diffusers_xl_canny.safetensors 150.74M
    t2i-adapter_diffusers_xl_depth_midas.safetensors 150.74M
    t2i-adapter_diffusers_xl_depth_zoe.safetensors 150.74M
    t2i-adapter_diffusers_xl_lineart.safetensors 150.74M
    t2i-adapter_diffusers_xl_openpose.safetensors 150.74M
    t2i-adapter_diffusers_xl_sketch.safetensors 150.74M
    t2i-adapter_xl_canny.safetensors 147.93M
    t2i-adapter_xl_openpose.safetensors 150.74M
    t2i-adapter_xl_sketch.safetensors 147.93M
    thibaud_xl_openpose.safetensors 2.33G
    thibaud_xl_openpose_256lora.safetensors 738.55M