Tag: Python

  • 用Avatarify Python打造虚拟存在的革命:终极逼真化身解决方案

    用Avatarify Python打造虚拟存在的革命:终极逼真化身解决方案

    在数字化存在和现实之间的界限日渐模糊的今天,人们对于更个性化、真实的虚拟互动的渴望促成了一系列突破性的创新。其中的佼佼者便是Avatarify Python,这项技术为你的数字化身注入了生命,让你能够实时体现逼真的化身,精准反映出你的每一个表情。想象一下,在视频会议中,你不仅仅以自己的身份出现,还能以动态化身的形式参与,展示你的每一个细微表情,增加了之前只存在于科幻小说中的互动层面。

    数字化新纪元的曙光

    想象这样一个场景:你即将加入一个在线会议,不再是使用那些静态的个人图片,而是选择了一个能够模仿你的手势和表情的逼真化身。随着会议的进行,你的化身会微笑、皱眉,进行表达,正如你自己一样,吸引了你同事的注意和想象。这不仅仅是对未来的一瞥;这是Avatarify Python所实现的现实。

    Avatarify Python简介

    Avatarify Python是一款使用First Order Motion Model创建视频会议用逼真化身的先进工具。它专为技术爱好者和DIY项目的熟手设计,因为它需要手动设置。然而,对于寻求更易用版本的用户,Avatarify桌面版提供了一个无需复杂安装的简化体验。

    核心特性与优势:

    • 逼真化身:Avatarify Python在化身动画的真实感上提供了无与伦比的体验,甚至能反映最微小的表情变化。
    • 定制化:按下一个按钮,你就可以在不同化身之间切换,甚至可以选择完全独一无二的StyleGAN生成的面孔。
    • 多平台支持:无论你是使用Windows、Linux,还是在移动设备上,Avatarify都有解决方案。
    • 社区与支持:通过邀请链接加入活跃的Slack社区,分享见解并获得支持。

    谁将从Avatarify Python中获益?

    Avatarify Python服务于广泛的受众,从技术爱好者和开发人员到创意专业人士和教育工作者。如果你是一个欣赏技术与创造力交叉点的人,这个项目就是为你量身定做的。

    与Avatarify互动:

    • 开发者可以深入代码,贡献并定制体验。
    • 教育工作者可以使用能够抓住学生注意力的化身,使在线学习变得更加引人入胜。
    • 创意专业人士可以在拥挤的数字空间中增加创造力的层面,脱颖而出。

    踏入Avatarify的世界

    拥有Avatarify Python,你可以无限地探索。以下是加入这场革命的方式:

    1. 对技术感兴趣的用户:遵循安装说明开始使用Avatarify Python。
    2. 追求便捷的用户:探索Avatarify桌面版,享受无忧的安装体验。
    3. 创新者:在GitHub上为项目贡献力量。

    与Avatarify一起拥抱未来

    总结时,我们可以清晰地看到,Avatarify Python不仅仅是一项技术进步;它是一种全新的数字表达方式。随着从Docker支持到iOS和Android应用的每一次更新,Avatarify变得更加容易获得和多样化。

    你的下一步:

    数字领域在进化,有了Avatarify Python,你不仅仅是跟上潮流;你正在引领潮流。那么,为什么等待?立即投入,将你的在线互动转变为真正非凡的体验。
  • Python环境下安装PEFT库的终极指南

    Python环境下安装PEFT库的终极指南

    在快速发展的信息时代,编程已成为一个重要技能,Python作为编程领域的一颗璀璨之星,以其简洁明了的语法和强大的库支持,成为众多开发者的首选语言。对于喜欢挑战性算法和数据处理任务的你来说,PEFT(Python Efficient Frontier Toolkit)是一个不可或缺的工具。它帮助分析者和投资者构建有效边界,优化投资组合,但首先,我们需要了解如何在Python环境中正确安装PEFT。

    开篇故事

    张华是一名金融分析师,他在构建客户投资组合时,经常需要进行复杂的计算来预测投资的风险与回报。这些工作传统上是手动完成的,效率低下且容易出错。有一天,他了解到通过使用PEFT,可以在Python环境中自动完成这些计算,大幅提高了他的工作效率。通过这篇教程,张华和你一样,将学会如何安装并运用PEFT,让数据分析变得更加简单高效。

    安装前的准备

    在安装PEFT之前,我们需要确保Python环境已经搭建好,并且可以正常使用。

    确认Python环境

    1. 打开终端或命令提示符。
    2. 输入 python --version 或 python3 --version(取决于你的系统)。
    3. 确保Python的版本是3.x(PEFT支持的Python版本)。

    创建虚拟环境(可选)

    为了避免潜在的库版本冲突,建议在虚拟环境中安装PEFT:

    python -m venv peft-env

    激活虚拟环境:

    • 在Windows上:
    peft-env\Scripts\activate
    • 在Unix或MacOS上:
    source peft-env/bin/activate

    安装PEFT库

    有了Python环境后,接下来的步骤是安装PEFT库。

    使用pip进行安装

    在终端或命令提示符中,运行以下命令来安装PEFT:

    pip install peft

    验证安装

    安装完成后,进行简单的验证以确保PEFT已正确安装:

    python -c "import peft; print(peft.__version__)"

    如果能够输出版本号,那么恭喜你,PEFT库已成功安装。

    使用PEFT进行数据分析

    安装完PEFT后,你可以开始使用它来进行数据分析了。

    导入PEFT库

    在Python脚本中导入PEFT库,以便使用其功能:

    import peft

    创建有效边界

    使用PEFT可以帮助你计算并绘制资产的有效边界:

    # 示例:使用PEFT计算有效边界
    import numpy as np
    import peft
    
    # 假设有一组预期收益率和协方差
    returns = np.array([0.12, 0.18, 0.14])
    cov = np.array([
      [0.1, 0.03, 0.05],
      [0.03, 0.2, 0.06],
      [0.05, 0.06, 0.15]
    ])
    
    # 使用PEFT创建有效边界
    ef = peft.EfficientFrontier(returns, cov)
    ef.plot()

    结语

    现在你已经掌握了在Python环境下安装PEFT的方法,并了解了如何使用它进行简单的数据分析。PEFT作为一个强大的工具,可以帮助你在数据分析和金融建模方面取得更高效的成果。记得实践是学习的捷径,不断尝试和探索PEFT库的其他高级功能,你将能够在工作中解决更复杂的问题。

  • ChatGPT for Bot:多语言聊天机器人

    ChatGPT for Bot:多语言聊天机器人

    想象一下拥有一个多语言支持的多功能聊天机器人,它可以集成到各种平台上。这正是ChatGPT for Bot提供的功能!无论您需要一个聊天机器人来娱乐您的社群、协助任务,还是仅仅是想要有趣的对话,这个项目都为您提供了一个灵活且可定制的解决方案。让我们深入了解ChatGPT for Bot的世界,发现它如何改变您的聊天体验。

    认识ChatGPT for Bot

    ChatGPT for Bot ChatGPT for Bot

    ChatGPT for Bot是一个强大的聊天机器人解决方案,利用各种语言模型提供智能和引人入胜的对话。无论您需要一个聊天机器人来娱乐您的社群、协助任务,还是仅仅是想要有趣的对话,这个项目都提供了一个灵活和可定制的解决方案。

    关键功能

    多语言支持

    ChatGPT for Bot具有多语言支持,使其适用于全球受众。无论您的社群使用哪种语言,这个聊天机器人都可以轻松进行对话。

    关键词触发回复

    您可以设置特定的关键词来触发聊天机器人的回应。这允许进行动态交互和个性化对话。

    多账号支持

    轻松管理多个账号。无论您需要该机器人在各种平台上运行,这个项目都可以应对。

    使用百度AI进行内容审核

    通过内置的百度AI内容审核,确保共享的内容是安全和适当的。

    个性化定制

    为您的机器人赋予独特的个性,使互动更具吸引力和趣味。

    平台兼容性

    ChatGPT for Bot支持流行的平台,如Mirai、go-cqhttp、Telegram,甚至是微信。

    HTTP API用于Web集成

    使用HTTP API功能,将聊天机器人集成到您的网站或应用程序中。

    支持ChatGPT Plus和ChatGPT API

    借助ChatGPT Plus和ChatGPT API的支持,享受高级ChatGPT功能。

    其他聊天模式

    使用各种聊天模式进行对话,包括Bing Chat、Google Bard、poe.com、文心一言和ChatGLM-6B。

    入门指南

    设置ChatGPT for Bot非常简单,有多种部署选项可供选择。无论您是使用Linux服务器还是Windows,您都会找到适合您需求的部署方法。查看安装指南以获得逐步操作说明。

    用于Web集成的HTTP API

    如果您希望将ChatGPT for Bot集成到您的网站或应用程序中,只需在config.cfg文件中添加HTTP API配置即可。这将为基于Web的交互打开了无限的可能性。

    加载预设以获得独特的聊天体验

    您是否希望您的聊天机器人具有特定的个性或风格?ChatGPT for Bot允许您加载预设以自定义机器人的回应方式。无论您想要“猫娘”风格还是更“正常”的风格,预设提供了无尽的可能性。

    文字转图片和文字转语音

    ChatGPT for Bot可以自动将文本消息转换为图像或语音,确保您的消息始终可以传递,即使在困难的情况下也是如此。

    类似的项目

    如果您对类似的项目感兴趣,请考虑查看这些值得关注的项目:

    支持我们

    如果您发现这个项目有帮助,请在GitHub上给它一个星星。您的支持激励我们不断改进和扩展这个项目。

    结论

    ChatGPT for Bot是一个强大而灵活的聊天机器人解决方案,可以增强您的在线社群、提供帮助,并提供有趣的对话。凭借其多语言支持、丰富的功能集和简单的部署选项,它是任何希望创建引人入胜的聊天体验的人必备的工具。

    立即探索ChatGPT for Bot,发现智能和互动聊天机器人交互的潜力!

  • VMAF – 视频多方法评估融合

    VMAF – 视频多方法评估融合

    想象一下,您正在准备享受一个舒适的电影之夜,迫不及待地等待您最喜欢的电影开始播放。灯光已调暗,爆米花已准备好,您舒适的毯子也已摊开。但是一旦电影开始,您注意到有些不对劲。视频质量很差,正在破坏您的电影体验。我们都曾经历过这种情况,当我们希望获得流畅的观看体验时,恼火于差劲的视频质量。

    介绍一下 VMAF – 视频多方法评估融合,这是由Netflix开发的获得艾美奖的感知视频质量评估算法。VMAF旨在彻底改变我们评估和提升视频质量的方式,确保您再也不必忍受次级的流媒体体验。

    VMAF 的必要性

    您是否曾经想过为什么有些视频看起来很棒,而其他一些则达不到您的期望?视频质量是一个受多种因素影响的复杂指标,如压缩、分辨率和编码技术。传统的质量度量标准如PSNR(峰值信噪比)和SSIM(结构相似性指数)虽然有所帮助,但在准确评估视频质量方面存在一定局限性。

    VMAF进驻并填补了这一差距。它通过模拟人类视觉系统如何感知图像和视频来评估视频质量。它考虑了颜色准确性、纹理和运动等因素,提供了更全面和准确的视频质量衡量。

    项目优势

    1. 艾美奖获奖的准确性

    VMAF因其在评估视频质量方面的卓越性能而获得艾美奖。Netflix,全球领先的流媒体平台之一,信任它确保其内容达到最高质量标准。

    2. 全面的指标

    VMAF不止于一个度量标准。它提供了一套质量评估方法,包括PSNR、PSNR-HVS、SSIM、MS-SSIM和CIEDE2000,让您全面了解视频质量。

    3. 开源且易于获取

    VMAF是开源的,所有人都可以免费访问。无论您是视频流媒体平台、内容创作者还是开发人员,您都可以将VMAF无缝集成到您的工作流程中,无需任何许可证障碍。

    4. Python集成

    附带VMAF的Python库允许您训练和测试自定义的VMAF模型,使其适应您的特定需求。

    5. 速度优化

    VMAF不断改进,最新的努力集中在速度优化方面。您可以信任它快速高效地评估视频质量。

    开始使用VMAF

    对于开发人员:

    • 如果您是开发人员,C库libvmaf提供了一个强大的接口,可将VMAF集成到您的代码中,使您能够无缝集成视频质量评估到您的应用程序中。

    对于内容创作者:

    • 内容创作者可以使用命令行工具vmaf,它提供了一个完整的算法实现,可轻松部署到生产环境中。它还包括辅助功能,如PSNR、SSIM和MS-SSIM评估。

    对于流媒体平台和电影制片人:

    • 流媒体平台和电影制片人可以在FFmpeg中使用VMAF作为过滤器,通过简单的命令配置以确保其内容具有最高的视频质量。

    对于所有人:

    • 无论您的背景如何,您都可以探索附带的Python库,该库提供了各种包装类和脚本,用于各种任务,从测试VMAF模型到数据可视化。

    今天就尝试VMAF

    您是否准备将您的视频质量评估提升到一个新水平?VMAF就是您的答案。加入那些信任VMAF以提供出色视频质量的内容创作者、开发人员和流媒体平台的行列。

    访问VMAF GitHub存储库以获取最新更新、文档和代码。深入感知视频质量评估的世界,提升您的流媒体体验。

    不要为次级视频质量妥协。选择VMAF,确保您的观众每次都能享受到最佳的内容。

  • 深入了解Weaviate与OpenAI的集成

    深入了解Weaviate与OpenAI的集成

    在数字时代,数据搜索和查询变得越来越重要。有时,我们需要更智能、更高级的搜索引擎来满足复杂的信息需求。本教程将向您介绍Weaviate和OpenAI的集成,展示如何使用这个组合来进行语义向量搜索、混合搜索和问答,以满足您的数据搜索需求。

    Weaviate和OpenAI的背景故事

    假设您是一家科技公司的数据分析师,您的工作涉及大量的文本数据和信息搜索。您发现了Weaviate和OpenAI的集成,这个组合提供了先进的搜索和查询功能,使您能够更轻松地从海量数据中提取有价值的信息。您意识到,掌握这个技能将帮助您在竞争激烈的行业中脱颖而出,因此您决定深入了解这个强大的工具。

    步骤1:认识Weaviate和OpenAI

    Weaviate简介

    Weaviate是一个开源的矢量搜索引擎,它的功能超越了传统的关键词搜索。它能够存储和搜索OpenAI的嵌入(embeddings)和数据对象,从而实现更智能的搜索和查询。

    Weaviate的主要特点包括:

    • 相似度搜索:能够查找与给定向量最相似的数据对象。
    • 混合搜索:结合多种搜索技术,包括基于关键词的搜索和矢量搜索。
    • 生成式搜索:支持类似问答(Q&A)的搜索。

    OpenAI集成

    Weaviate支持多种基于OpenAI的模块,例如text2vec-openai和qna-openai。这些模块允许您将数据向量化,并以更快更高效的方式查询数据。

    步骤2:Weaviate的三种运行方式

    您可以选择将Weaviate(包括OpenAI模块,如果需要的话)以以下三种方式运行:

    1. 在Docker容器内开源运行

    您可以通过在Docker容器内运行Weaviate来轻松地搭建您的搜索引擎。这是一个灵活的选择,让您可以根据需要进行自定义配置。

    2. 使用Weaviate云服务

    如果您希望无需自行搭建和维护服务器,可以选择使用Weaviate的云服务。这是一个快速入门的方式,让您可以立即开始使用强大的搜索功能。

    3. 在Kubernetes集群中运行

    对于需要更高度可伸缩性和性能的应用,您可以在Kubernetes集群中运行Weaviate。这种部署方式适用于大规模数据搜索需求。

    步骤3:示例和实践

    在学习Weaviate和OpenAI集成的过程中,实际示例非常重要。以下是一些示例和实践项目,帮助您更好地理解如何利用这个组合:

    示例1:开始使用Weaviate和OpenAI

    • 描述:这个示例演示了如何使用Weaviate和OpenAI的文本向量化模块(text2vec-openai)进行语义向量搜索。
    • 语言:Python
    • Google Colab链接:点击此处查看示例

    示例2:混合搜索与Weaviate和OpenAI

    • 描述:这个示例介绍了如何使用Weaviate和OpenAI的文本向量化模块(text2vec-openai)进行混合搜索,结合了关键词搜索和矢量搜索。
    • 语言:Python
    • Google Colab链接:点击此处查看示例

    示例3:问答与Weaviate和OpenAI

    • 描述:这个示例展示了如何在Weaviate中使用OpenAI的问答模块(qna-openai)进行问答搜索。
    • 语言:Python
    • Google Colab链接:点击此处查看示例

    示例4:Docker-compose示例

    • 描述:这个示例提供了一个包含所有OpenAI模块的Docker-compose文件,让您可以一次性启用所有功能。
    • 部署方式:Docker

    通过这些示例,您将能够深入了解Weaviate和OpenAI集成的强大功能,以及如何将它们应用于不同的搜索和查询场景。

    结论

    本教程向您介绍了Weaviate和OpenAI的集成,以及如何使用它们来进行语义向量搜索、混合搜索和问答。这将帮助您更好地利用这个组合来满足复杂的数据搜索需求,无论是在个人项目中还是在企业级应用中。

    现在,您已经掌握了这一强大技能,可以在信息时代中脱颖而出,为您的数据分析和搜索工作增添更多价值!


    通过本教程,您已经了解了如何使用Weaviate和OpenAI的集成来进行高级数据搜索和查询。无论是在个人项目中还是在企业应用中,这个组合都可以为您提供更智能、更高效的搜索功能,从而更好地满足信息需求。现在,您可以开始应用这些知识,提升自己的技能和价值!

  • 如何使用ChatGPT模型创建自然语言生成应用

    如何使用ChatGPT模型创建自然语言生成应用

    在数字时代,自然语言生成(Natural Language Generation,NLG)应用变得越来越流行,这些应用能够自动生成文本内容,从虚拟助手到智能客服再到自动化报告。OpenAI的ChatGPT模型是一种强大的工具,可以用于构建这类应用。本教程将向您展示如何使用ChatGPT模型创建自然语言生成应用,以满足您的需求。

    起源故事

    想象一下,您是一家新兴的电子商务公司的创始人,您的团队正在研发一款智能客服应用,以提供更好的用户体验。您已经听说过OpenAI的ChatGPT模型,并且认为它可以为您的应用增添一些独特的智能和人性化。然而,您不知道如何开始,这就是这篇教程的用武之地。

    现在,让我们一起学习如何使用ChatGPT模型来创建强大的自然语言生成应用。

    步骤1:导入OpenAI库

    首先,您需要导入OpenAI Python库,以便与OpenAI API进行通信。如果您尚未安装或升级OpenAI库,可以使用以下命令:

    %pip install --upgrade openai

    然后,导入OpenAI库:

    import openai

    步骤2:Chat API调用示例

    Chat API调用包括两个必需的输入参数:模型(model)和消息(messages)。

    • model:指定您要使用的模型名称(例如,gpt-3.5-turbo,gpt-4)。
    • messages:提供消息对象的列表,每个消息对象包含两个必需的字段:
      • role:指示发件人的角色(system,user或assistant)。
      • content:包含消息的内容(例如,“为我写一首美丽的诗”)。

    消息还可以包含一个可选的name字段,用于为发件人指定名称(例如,“example-user”,“Alice”,“BlackbeardBot”)。

    以下是一个Chat API调用的示例:

    MODEL = "gpt-3.5-turbo"
    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "您是一个乐于助人的助手。"},
            {"role": "user", "content": "敲敲。"},
            {"role": "assistant", "content": "谁在敲门?"},
            {"role": "user", "content": "橙子。"},
        ],
        temperature=0,
    )

    上述示例中,我们首先指定了要使用的模型(gpt-3.5-turbo),然后创建了一个消息列表,其中包含系统消息、用户消息和助手消息。每个消息都有role和content字段。

    步骤3:如何指导ChatGPT

    对于不同版本的ChatGPT模型,最佳实践可能会有所不同。在指导模型方面,以下是一些建议:

    系统消息

    系统消息可以用于设置助手的行为或性格。然而,对于gpt-3.5-turbo-0301等早期模型,它们通常不像后来的模型(如gpt-4-0314或gpt-3.5-turbo-0613)那样关注系统消息。因此,对于gpt-3.5-turbo-0301,我们建议将重要的指令放在用户消息中,以获得更好的效果。一些开发者发现,在对话变得越来越长时,将系统消息不断移到对话末尾可以保持模型的注意力不会漂移。

    少量示例

    有时,向模型展示您想要的内容比告诉模型更容易。您可以使用示例消息来引导模型,演示所需的行为或响应。

    例如,以下是一个模仿商业术语翻译为简单语言的示例:

    response = openai.ChatCompletion.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "您是一个乐于助人、遵循模式的助手。"},
            {"role": "user", "content": "帮我把以下企业术语翻译成简单的英语。"},
            {"role": "assistant", "content": "当然,我愿意帮忙!"},
            {"role": "user", "content": "新的协同作用将有助于推动顶线增长。"},
            {"role": "assistant", "content": "事物协同运作良好将增加收入。"},
            {"role": "user", "content": "让我们在有更多空间时再回过头来,讨论提高杠杆的机会。"},
            {"role": "assistant", "content": "等我们不那么忙时再谈,讨论如何做得更好。"},
            {"role": "user", "content": "这次的突然改变意味着我们没有时间为客户交付准备工作。"},
        ],
        temperature=0,
    )

    上述示例演示了如何使用示例消息来引导模型执行翻译任务。

    支持性细节

    在教程中,包括相关的示例、案例研究、数据表格或代码片段,以支持所提出的观点,并帮助读者理解和应用教程中的概念。

    步骤4:计算令牌数

    在提交请求时,API会将消息转换为令牌(tokens)序列。令牌数的多少会影响以下几个方面:

    • 请求的费用
    • 生成响应的时间
    • 回复是否因达到最大令牌限制而被截断(对于gpt-3.5-turbo是4,096个令牌,对于gpt-4是8,192个令牌)

    您可以使用以下函数来计算消息所使用的令牌数:

    import tiktoken
    
    def num_tokens_from_messages(messages, model="gpt-3.5-turbo-0613"):
        # 返回消息列表使用的令牌数
        # ...

    请注意,消息中的令牌计数可能因模型版本而异,因此需要使用适用于您的模型的函数。

    结论

    本教程向您展示了如何使用ChatGPT模型创建自然语言生成应用。通过系统消息、示例消息和支持性细节,您可以指导模型生成所需的文本内容。同时,通过计算令牌数,您可以控制请求的成本和响应时间。

  • 教程:使用Python批量注册自建邮箱账户

    教程:使用Python批量注册自建邮箱账户

    有时候,我们可能需要大量的邮箱账户,用于各种目的,比如测试、订阅、或者是其他项目。在这种情况下,手动一个一个注册邮箱账户会非常繁琐和耗时。但幸运的是,我们可以利用Python编写脚本来自动化这个过程,而且最好的方式之一就是自建邮箱。本教程将向您展示如何使用Python编写脚本来批量注册自建邮箱账户。

    背景故事

    假设您正在开发一个社交媒体分析工具,需要大量的测试账户来模拟用户行为。您不想使用现有的邮箱服务提供商的账户,因为这些账户可能受到各种限制,而且难以控制。因此,您决定自建邮箱账户,以便完全掌控账户的创建和管理过程。

    准备工作

    在开始编写Python脚本之前,您需要进行一些准备工作:

    1. 域名和服务器: 您需要拥有一个域名和一个邮件服务器,以便创建自建邮箱。您可以选择购买域名并设置邮件服务器,或者使用已有的域名。

    2. Python安装: 确保您的计算机上已经安装了Python。您可以从官方网站下载并安装最新版本的Python。

    3. 第三方库: 安装Python的smtplib和email库,这些库将帮助您发送电子邮件。

    编写Python脚本

    以下是一个简单的Python脚本示例,用于批量注册自建邮箱账户。在这个示例中,我们使用了Python的smtplib库来连接到邮件服务器,并使用email库来创建和发送注册邮件。

    import smtplib
    from email.mime.text import MIMEText
    from email.mime.multipart import MIMEMultipart
    
    # 邮件服务器的配置
    smtp_server = 'your_smtp_server.com'
    smtp_port = 587
    smtp_username = 'your_username'
    smtp_password = 'your_password'
    
    # 创建邮件服务器连接
    server = smtplib.SMTP(smtp_server, smtp_port)
    server.starttls()
    server.login(smtp_username, smtp_password)
    
    # 批量注册邮箱账户
    num_accounts = 10  # 想要注册的邮箱账户数量
    
    for i in range(1, num_accounts + 1):
        # 生成随机的邮箱地址
        email_address = f'user{i}@your_domain.com'
    
        # 创建邮件
        message = MIMEMultipart()
        message['From'] = smtp_username
        message['To'] = email_address
        message['Subject'] = 'Welcome to Our Service'
    
        # 邮件正文
        body = f'Hello, user{i}! Welcome to our service. Your email address is: {email_address}'
        message.attach(MIMEText(body, 'plain'))
    
        # 发送邮件
        server.sendmail(smtp_username, email_address, message.as_string())
        print(f'Registered account {i}: {email_address}')
    
    # 关闭服务器连接
    server.quit()

    请注意,您需要将脚本中的SMTP服务器配置、用户名和密码替换为您自己的信息。此外,您还可以根据需要自定义邮件的正文内容和格式。

    执行脚本

    当您完成脚本的编写并保存为.py文件后,您可以在命令行中执行它。确保您的计算机连接到互联网,并且您的邮件服务器配置正确。

    运行脚本后,它将会自动创建指定数量的自建邮箱账户,并向每个账户发送欢迎邮件。您可以在代码中自定义邮件的内容,以适应您的特定需求。

    结论

    通过使用Python编写脚本,您可以轻松地批量注册自建邮箱账户,以满足各种需求,无论是用于测试、订阅还是其他项目。这种自动化的方法不仅节省了时间,还可以确保您完全掌控账户的创建和管理过程。希望本教程对您有所帮助,让您能够更有效地管理和利用邮箱账户。

  • 抖音WebSocket二进制解码教程:解密抖音视频流的神秘面纱

    抖音WebSocket二进制解码教程:解密抖音视频流的神秘面纱

    抖音,作为全球热门的社交媒体平台,吸引了数以亿计的用户,每天都在分享各种各样的视频内容。你可能曾经想过,这些视频是如何在抖音上实时传输和播放的?答案之一就是WebSocket。WebSocket是一种用于实时通信的协议,而抖音正是借助WebSocket来传输视频流的。但是,这些视频流通常以二进制格式呈现,需要解码才能正常播放。

    本教程将向你展示如何使用Python来解码抖音WebSocket传输的二进制数据,以便你可以深入了解视频流的内容并进行进一步处理。

    解密抖音WebSocket的奥秘

    在我们深入讨论如何解码抖音WebSocket传输的二进制数据之前,让我们先了解一下WebSocket是什么以及为什么它在抖音中如此重要。

    什么是WebSocket?

    WebSocket是一种用于实时通信的网络协议,它允许客户端和服务器之间建立持久的双向连接。与传统的HTTP请求-响应模型不同,WebSocket连接保持打开状态,使得数据可以在客户端和服务器之间实时双向传输。这使得WebSocket成为处理实时数据流的理想选择,正如抖音中的视频流一样。

    抖音和WebSocket

    抖音是一个以视频为主要内容的社交媒体平台,用户可以上传、分享和观看各种各样的短视频。为了实现实时播放和互动功能,抖音使用了WebSocket来传输视频流和其他数据。视频流通常以二进制格式发送到客户端,因此我们需要解码它们才能正常播放。

    解码抖音WebSocket的二进制数据

    现在,让我们深入研究如何解码抖音WebSocket传输的二进制数据。我们将使用Python来完成这个任务。首先,你需要确保你的Python环境已经安装了必要的库,包括websocket-client和struct。

    import websocket
    import struct

    连接到抖音WebSocket

    首先,我们需要建立与抖音WebSocket服务器的连接。你需要知道抖音WebSocket的服务器地址,通常是一个URL,以及相关的WebSocket协议版本。

    ws_url = "wss://ws.aweme.snssdk.com/websocket"
    ws = websocket.create_connection(ws_url, subprotocols=["chat"])

    接收和解析二进制数据

    一旦连接建立成功,你可以开始接收抖音WebSocket发送的二进制数据。通常,抖音会以二进制帧的形式发送数据,我们需要解析这些帧以获取视频流或其他信息。

    while True:
        binary_data = ws.recv()
        # 解析二进制数据
        parse_binary_data(binary_data)

    解析二进制数据

    解析二进制数据是本教程的关键部分。抖音使用一种特殊的格式来打包视频流和其他信息,通常需要一些独特的处理来解码它。这里我们使用struct库来解析二进制数据。

    def parse_binary_data(binary_data):
        # 假设二进制数据以特定格式打包
        # 这里的示例格式可能与实际不符,需要根据实际情况进行调整
        data = struct.unpack("<IHH", binary_data)
        # 进一步处理解析出的数据
        process_data(data)

    处理解析后的数据

    最后,根据你的需求,你可以进一步处理解析后的数据。这可能涉及到将视频流保存到文件、提取关键信息或执行其他自定义操作。

    def process_data(data):
        # 处理解析后的数据
        # 这里可以根据需要执行各种操作
        video_stream = data[0]
        # 这里假设第一个元素是视频流数据,可以进一步处理或保存
        # ...

    总结

    通过本教程,你学会了如何连接到抖音WebSocket服务器,接收和解析二进制数据,以及处理解析后的数据。这将为你提供解密抖音视频流的能力,让你能够更深入地了解和处理这些有趣的内容。

    请注意,本教程中的代码示例仅供参考,实际情况可能因抖音的更新而有所变化。你需要根据最新的抖音WebSocket协议和数据格式来调整代码。

    希望这个教程对你有所帮助,让你更好地理解抖音背后的技术奥秘,并在自己的项目中应用这些知识。

    Happy coding! ?

  • 王大神2023年工作总结

    王大神2023年工作总结

    2023年即将结束,我在此分享我的工作总结,以便于回顾这一年我们共同努力和成长的轨迹。这一年对我来说,是挑战与机遇并存的一年,也是收获满满的一年。

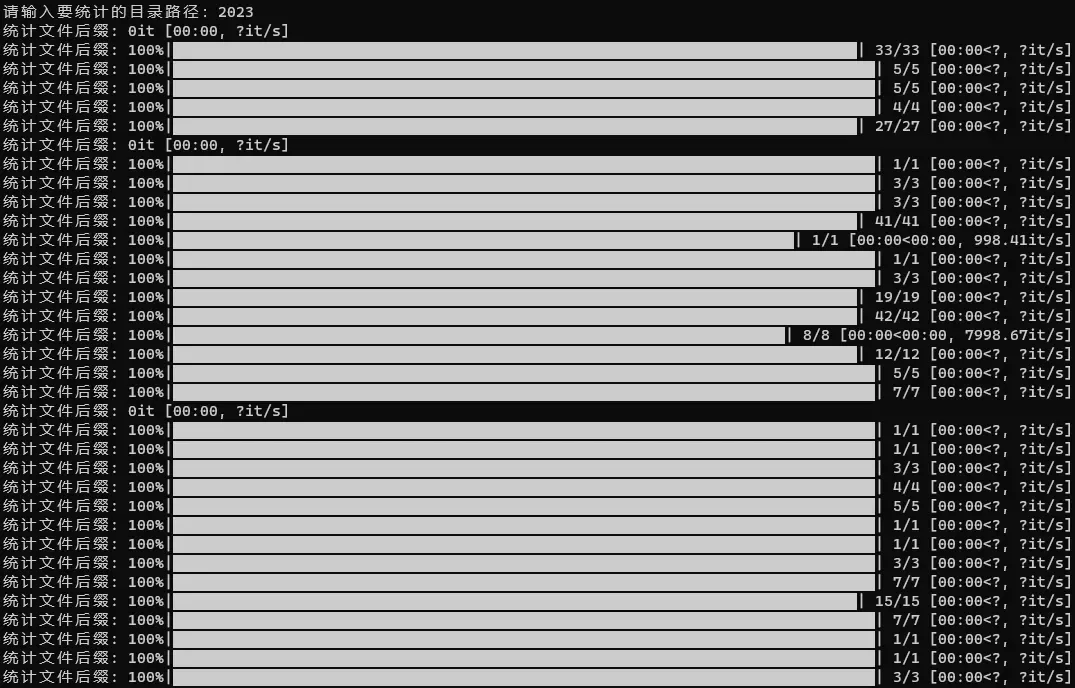
    既然是总结,当然要有数据了,于是写代码分析自己今年的工作量:

    代码放在文末,需要的复制粘贴即可。

    然后写一篇分析报告:

    一、图像处理与设计

    今年,我共创建了2400个PNG格式图像,940个JPG和JPEG格式图像,以及大量其他格式的图像文件,包括GIF、WEBP等,这反映了我的主要工作之一是图像处理与设计。通过使用高级编辑软件如Photoshop(由PSD文件可见),我不仅提高了工作效率,也在视觉效果上达到了更高的专业标准。

    二、文档创作与管理

    文档创作与管理是我今年工作的另一大板块。我共产出了超过4000个文档类文件,包括Word、PDF以及演示文稿等。其中,PDF文件的大量产出(2979个)凸显了我们的内容共享与输出能力。这些文件覆盖了项目报告、市场分析、研究论文等多个领域,彰显了我们在知识管理和文档输出方面的专业性。

    三、软件与网页开发

    在软件开发方面,我创建了278个Python脚本,以及一定数量的JSON、JavaScript、CSS和HTML文件,这说明我参与了多个软件和网页开发项目。Python的大量使用表明了在自动化和数据处理方面的深入工作。此外,IPython笔记本的使用也指向了我在数据科学和教育领域的努力。

    四、三维模型设计

    我在三维建模和设计方面也有所涉猎,从SKP到OBJ,再到FBX文件,我在这一领域的工作虽不如其他领域频繁,但也体现了我的多元技能和对新技术的探索精神。

    五、音频处理与视频制作

    音频文件的编辑与制作同样是我今年工作的重点。我共处理了587个音频文件,包括MP3、WAV、FLAC等格式,这展现了我的音频制作能力。此外,视频文件的编辑也占据了我的部分工作时间,其中MP4格式的文件数量最多。

    六、数据分析与演示

    在数据处理和分析方面,我使用Excel进行了大量的数据整理与分析工作,生成了716个XLSX文件和52个XLS文件。演示文稿的制作也是我的日常工作之一,我在这一年里制作了81个PPT和PPTX格式的文件。

    代码分享

    用于统计文件后缀和大小的python脚本

    首先安装需要的模块

    pip install tqdm

    然后,复制粘贴这个代码,等待数据生成完毕:

    import os
    from tqdm import tqdm
    
    def calculate_folder_size(folder_path):
        total_size = 0
        for dirpath, dirnames, filenames in os.walk(folder_path):
            for filename in tqdm(filenames, desc="计算文件大小"):
                file_path = os.path.join(dirpath, filename)
                total_size += os.path.getsize(file_path)
        return total_size
    
    def count_file_extensions(folder_path):
        extension_count = {}
        for dirpath, dirnames, filenames in os.walk(folder_path):
            for filename in tqdm(filenames, desc="统计文件后缀"):
                file_extension = os.path.splitext(filename)[-1].lower()
                if file_extension:
                    extension_count[file_extension] = extension_count.get(file_extension, 0) + 1
        return extension_count
    
    def main():
        folder_path = input("请输入要统计的目录路径:")
        if not os.path.exists(folder_path):
            print("指定的目录不存在。")
            return
    
        extension_count = count_file_extensions(folder_path)
        total_size = calculate_folder_size(folder_path)
    
        print("文件后缀名统计:")
        for extension, count in extension_count.items():
            print(f"{extension}文件:{count}个")
    
        total_size_mb = total_size / (1024 * 1024)
        print(f"合计:{total_size_mb:.2f}MB")
    
    if __name__ == "__main__":
        main()

    最后输出表格

    文件后缀名 数量
    .png文件 2400个
    .jpg文件 914个
    .txt文件 666个
    .md文件 59个
    .apk文件 3个
    .mp3文件 74个
    .bat文件 9个
    .py文件 278个
    .json文件 20个
    .skb文件 1个
    .skp文件 2个
    .log文件 2个
    .mp4文件 264个
    .avi文件 10个
    .doc文件 187个
    .zip文件 57个
    .xlsx文件 716个
    .docx文件 936个
    .pdf文件 2979个
    .html文件 22个
    .gif文件 21个
    .ini文件 3个
    .mtl文件 10个
    .obj文件 11个
    .stl文件 31个
    .css文件 17个
    .ttf文件 6个
    .js文件 16个
    .pyc文件 20个
    .todolist文件 1个
    .xls文件 52个
    .iml文件 2个
    .xml文件 26个
    .map文件 20个
    .wav文件 470个
    .conf文件 5个
    .webp文件 689个
    .pptx文件 49个
    .tmp文件 194个
    .wps文件 8个
    .crdownload文件 11个
    .caj文件 6个
    .ppt文件 32个
    .cfg文件 1个
    .9)文件 1个
    .awb文件 2个
    .m4a文件 11个
    .aac文件 33个
    .lnk文件 63个
    .flac文件 33个
    .accdb文件 1个
    .svg文件 13个
    .ico文件 2个
    .psd文件 4个
    .exe文件 11个
    .3ds文件 3个
    .jpeg文件 26个
    .eps文件 2个
    .rpy文件 1个
    .rpyc文件 1个
    .pkf文件 130个
    .gz文件 2个
    .ts文件 1个
    .tif文件 1个
    .pat文件 1个
    .m4v文件 1个
    .blend文件 4个
    .rar文件 2个
    .dwg文件 2个
    .srt文件 1个
    .plist文件 1个
    .7z文件 1个
    .fbx文件 2个
    .un~文件 1个
    .yml文件 6个
    .psb文件 1个
    .mov文件 2个
    .reg文件 1个
    .yaml文件 4个
    .ipynb文件 7个
    .hjson文件 4个
    .sample文件 39个
    .idx文件 3个
    .pack文件 3个
    .下载文件 4个
    .jfif文件 48个
    .csv文件 42个
    .php文件 3个
    .thmx文件 2个
    .dotx文件 2个
    .pub文件 1个
    .tex文件 1个
    .livp文件 1个
    .spec文件 1个
    .jpeg-workdetailbodyorigin文件 1个
    .toc文件 7个
    .manifest文件 1个
    .pkg文件 1个
    .pyz文件 1个
    .sh文件 1个
    .ovobj文件 2个

    怎么样,我的工作总结写完了,你要不要也总结一下?

  • 如何使用Python编写网页爬虫爬取京东商品信息并进行数据可视化

    如何使用Python编写网页爬虫爬取京东商品信息并进行数据可视化

    在数字时代,数据是至关重要的资源。无论是企业还是个人,都需要从各种渠道获取数据,并进行分析和可视化,以便更好地了解市场趋势和用户需求。本教程将介绍如何使用Python编写一个简单但强大的网页爬虫,以爬取京东商品信息,并将爬取到的数据进行可视化展示。无论你是对数据分析感兴趣,还是想要了解某一特定商品的市场情况,这个教程都将对你有所帮助。

    1. 起始故事

    假设你是一名电商从业者,你经营着一家在线商店。你一直在寻找一种方法,可以更好地了解市场上同类商品的价格、销量和用户评价等信息,以便更好地定价和推广你的产品。你可能会花费大量时间手动浏览京东等电商网站,记录商品信息,但这种方法非常耗时且容易出错。因此,你决定尝试使用Python编写一个网页爬虫来自动获取商品信息,并进行数据分析和可视化,以便更好地了解市场动态。

    2. 编写网页爬虫

    在这一部分,我们将介绍如何使用Python编写网页爬虫,来爬取京东商品信息。以下是关键部分的核心代码示例:

    import time
    import pandas as pd
    from selenium import webdriver
    from selenium.webdriver.common.by import By
    from selenium.webdriver.common.keys import Keys
    
    if __name__ == "__main__":
        word = input("请输入要爬取的商品名称")
        page_size = int(input("请输入要爬取的页数"))
    
        # 创建一个浏览器驱动器的对象
        driver = webdriver.Edge()
        # 通过驱动器去打开京东的首页
        driver.get("https://www.jd.com")
        time.sleep(2)
    
        # 找到搜索框
        input_box = driver.find_element(By.ID, "key")
        input_box.send_keys(word)
        input_box.send_keys(Keys.ENTER)
    
        names, prices, commits, shops = [], [], [], []
    
        for i in range(page_size):
            # 将滚动条拖到最下面
            driver.execute_script('window.scrollTo(0,document.body.scrollHeight)')
            # 停顿3秒,等待数据刷新
            time.sleep(3)
            good_list = driver.find_elements(By.XPATH, '//*[@id="J_goodsList"]/ul/li')
            # 遍历每页所需爬取的内容
            for good in good_list:
                price = good.find_element(By.CLASS_NAME, "p-price").text,
                name = good.find_element(By.CLASS_NAME, "p-name").text,
                commit = good.find_element(By.CLASS_NAME, "p-commit").text,
                shop = good.find_element(By.CLASS_NAME, "p-shop").text
                # 将爬取的数据赋值给空列表中
                names.append(name[0])
                prices.append(price[0])
                commits.append(commit[0])
                shops.append(shop)
    
            driver.find_element(By.CLASS_NAME, "pn-prev").click()
            # 停顿3秒,等待数据刷新
            time.sleep(3)
    
        df = pd.DataFrame(
            {
                "价格": prices,
                "标题": names,
                "评论数": commits,
                "出版社": shops
            })
        df.to_excel("商品信息.xlsx")

    上述代码中,我们使用了Selenium库来模拟浏览器操作,打开京东网站并搜索指定的商品。然后,我们通过定位HTML元素的方式,获取商品的名称、价格、评论数和店铺信息,并将这些信息存储在一个Pandas DataFrame中,最终将数据保存为Excel文件。

    3. 数据可视化

    爬取到数据后,下一步是进行数据可视化,以便更好地理解和分析数据。我们将使用Pyecharts库来创建一个简单的饼图,用于展示商品信息中不同出版社的数量分布。以下是相关代码:

    from pyecharts.charts import Pie
    
    # 按数量统计出前10名的数据
    sort_data = df.groupby("出版社").size().sort_values(ascending=True).head(10)
    
    # 进行数据处理,将数据转换为图表所需格式
    data = [list(z) for z in zip(sort_data.index.tolist(), sort_data.values.tolist())]
    
    # 绘制饼图
    pie = Pie()
    pie.add(series_name="排名", data_pair=data)
    pie.render(path="饼图.html")

    这段代码首先对出版社进行数量统计,并选择前10名的数据进行展示。然后,将数据转换为Pyecharts所需的格式,最后绘制了一个饼图,用于展示不同出版社的数量分布情况。

    结论

    通过本教程,你学会了如何使用Python编写一个简单但功能强大的网页爬虫,用于爬取京东商品信息,并进行数据可视化展示。这个过程包括了网页爬取、数据处理和可视化展示等关键步骤,可以帮助你更好地了解市场动态和竞争对手情况。

    数据爬取和可视化是数据分析的重要一环,无论你是电商从业者、数据分析师还是对数据感兴趣的人,这些技能都将对你的工作和个人发展带来很大帮助。希望你能够继续学习和探索,不断提升自己的数据分析能力。

    最后,记得合法使用爬虫技术,遵守网站的使用规则和法律法规,以确保数据获取的合法性和可靠性。祝你在数据分析领域取得成功!