Tag: Python

  • 如何使用Python编写微信公众号文章下载工具

    如何使用Python编写微信公众号文章下载工具

    在今天的数字时代,微信公众号已经成为了信息传播的重要平台之一。许多人都喜欢阅读各种各样的文章,但有时候我们可能想要将一篇精彩的文章保存在本地,以便离线阅读或备份。本教程将介绍如何使用Python编写一个小工具,能够自动下载微信公众号文章并打包成ZIP文件,让您随时随地畅享文章内容。

    故事开端

    假设你是一名热衷于阅读微信公众号文章的用户,每天都会在不同的公众号上发现一些精彩的文章。然而,由于网络连接不稳定或者其他原因,你可能无法保证每次都能在线阅读这些文章。因此,你希望有一种方法能够将这些文章保存在本地,以便随时查看。同时,你还希望能够将文章中的图片也一并下载下来,以免文章内容不完整。于是,你决定使用Python编写一个工具来实现这个愿望。

    准备工作

    在开始编写代码之前,你需要做一些准备工作。首先,确保你的计算机上已经安装了Python编程环境。你还需要安装以下几个Python库:

    • requests:用于发送HTTP请求,获取网页内容。
    • BeautifulSoup:用于解析HTML页面,提取文章内容和图片链接。

    你可以使用以下命令来安装这些库:

    pip install requests beautifulsoup4

    编写代码

    现在,让我们开始编写代码。以下是关键部分的核心代码示例,用于实现微信公众号文章的下载和图片的下载:

    # 导入必要的库
    import requests
    from bs4 import BeautifulSoup
    import os
    import time
    from re import findall
    
    # 获取微信公众号内容,保存标题和时间
    def get_weixin_html(url):
        global weixin_time, weixin_title
        res = requests.get(url)
        soup = BeautifulSoup(res.text, "html.parser")
    
        # 获取标题
        temp = soup.find('h1')
        weixin_title = temp.string.strip()
    
        # 获取正文html并修改
        content = soup.find(id='js_content')
        soup2 = BeautifulSoup((str(content)), "html.parser")
        soup2.div['style'] = 'visibility: visible;'
        html = str(soup2)
        pattern = r'http?:\/\/[a-z.A-Z_0-9\/\?=-_-]+'
        result = findall(pattern, html)
    
        # 将data-src修改为src
        for url in result:
            html = html.replace('data-src="' + url + '"', 'src="' + url + '"')
        return html
    
    # 上传图片至服务器
    def download_pic(content):
        pic_path = htmlsavepath + '/' + weixin_title + '/' + 'pic/'
        if not os.path.exists(pic_path):
            os.makedirs(pic_path)
    
        # 使用正则表达式查找所有需要下载的图片链接
        pattern = r'http?:\/\/[a-z.A-Z_0-9\/\?=-_-]+'
        pic_list = findall(pattern, content)
    
        for index, item in enumerate(pic_list, 1):
            count = 1
            flag = True
            pic_url = str(item)
    
            while flag and count <= 10:
                try:
                    data = requests.get(pic_url)
    
                    if pic_url.find('png') > 0:
                        file_name = str(index) + '.png'
    
                    elif pic_url.find('gif') > 0:
                        file_name = str(index) + '.gif'
    
                    else:
                        file_name = str(index) + '.jpg'
    
                    with open(pic_path + file_name, "wb") as f:
                        f.write(data.content)
    
                    # 将图片链接替换为本地链接
                    content = content.replace(pic_url, 'pic/' + file_name)
    
                    flag = False
                    count += 1
                    print('...')
                    time.sleep(1)
    
                except:
                    count += 1
                    time.sleep(1)
    
            if count > 10:
                print("下载出错:", pic_url)
        return content

    上述代码中,我们首先导入了所需的库,然后定义了两个关键函数:get_weixin_html 用于获取微信公众号文章的HTML内容,download_pic 用于下载文章中的图片并替换图片链接。这些函数将帮助我们实现文章的下载和保存。

    使用示例

    接下来,我们将展示如何使用这些函数来下载微信公众号文章。你可以按照以下步骤进行操作:

    1. 定义微信公众号文章的链接和保存目录:
    wechat_article_url = "https://mp.weixin.qq.com/s/GSdK9it0N1As3H-pQ4mGdA"
    save_directory = "C:/微信公众号下载/12"
    1. 调用 get_weixin_html 函数来获取文章的HTML内容:
    article_html = get_weixin_html(wechat_article_url)
    1. 调用 download_pic 函数来下载文章中的图片:
    article_with_local_pic = download_pic(article_html)
    1. 最后,你可以将文章内容保存为HTML文件,以及将图片一起打包成ZIP文件:
    # 保存文章内容为HTML文件
    html_file_path = os.path.join(save_directory, weixin_title + ".html")
    with open(html_file_path, "w", encoding="utf-8") as html_file:
        html_file.write(article_with_local_pic)
    
    # 打包成ZIP文件
    import zipfile
    
    zip_file_path = os.path.join(save_directory, weixin_title + ".zip")
    with zipfile.ZipFile(zip_file_path, "w") as zipf:
        # 添加HTML文件
        zipf.write(html_file_path, arcname=os.path.basename(html_file_path))
        # 添加图片文件夹
        pic_folder = os.path.join(save_directory, weixin_title, "pic")
        for root, dirs, files in os.walk(pic_folder):
            for file in files:
                zipf.write(os.path.join(root, file), arcname=os.path.join("pic", file))

    总结

    通过这个小工具,你可以轻松地将你喜欢的微信公众号文章保存在本地,并确保文章中的图片也被正确下载和保存。这不仅提供了离线阅读的便利,还可以用于备份你感兴趣的文章。希望这个教程对你有所帮助,让你更好地利用Python来实现自己的需求。

    通过学习本教程,你不仅可以掌握如何编写网络爬虫程序,还可以了解如何使用Python处理HTML页面和下载文件。这些技能在许多领域都非常有用,无论是数据采集、网站分析,还是其他需要获取网络信息的任务,都可以受益于这些技能。希望你能够享受到编程的乐趣,并不断探索更多有趣的项目和应用。

    Punctuation: Use English punctuation throughout.

    Language: The article should be written exclusively in Chinese.
  • 利用Azure OpenAI和Azure Cognitive Search打造定制聊天应用的教程

    利用Azure OpenAI和Azure Cognitive Search打造定制聊天应用的教程

    在数字化时代,人工智能(AI)已经成为许多企业和开发者的不可或缺的一部分。聊天机器人和对话式AI已经在各个领域中发挥着关键作用,从客户支持到虚拟助手,再到智能搜索引擎。如果您希望构建自己的聊天应用程序,同时希望这些应用程序能够根据您自己的数据提供更准确和迅速的回答,那么Azure OpenAI和Azure Cognitive Search的结合将为您提供强大的工具。

    故事开端

    假设您是一家企业的创始人,您希望为您的网站或应用程序添加一个智能聊天机器人,以提供更好的客户支持和信息检索体验。您希望这个聊天机器人不仅能够回答常见问题,还能够根据您自己的业务数据提供个性化的建议和信息。在寻找解决方案时,您发现了Azure OpenAI和Azure Cognitive Search的结合,这为您提供了一个强大的工具,可以实现这一目标。

    教程内容

    步骤1:准备工作

    要开始使用Azure OpenAI和Azure Cognitive Search,您需要一些必要的前提条件:

    1. Azure OpenAI资源: 您需要在Azure门户中创建Azure OpenAI资源,并部署一个支持的聊天模型,例如GPT-3.5-Turbo或GPT-4。

    2. Azure Cognitive Search资源: 您需要创建Azure Cognitive Search资源,以便将您的数据与聊天模型连接起来。

    3. Azure Blob Storage资源: 您需要一个Azure Blob Storage资源来存储您的数据文件。

    4. 您的数据: 您需要将要用作数据的文档上传到Blob Storage,并使用Azure AI Studio创建一个索引。这将成为聊天模型的数据源。

    步骤2:设置

    首先,您需要安装必要的Python依赖项,以便与Azure OpenAI和Azure Cognitive Search进行交互。使用以下命令安装所需的依赖项:

    ! pip install "openai>=0.27.6"
    ! pip install python-dotenv

    在这个示例中,我们使用dotenv库来加载环境变量。您需要在一个名为.env的文件中添加以下变量:

    • OPENAI_API_BASE – Azure OpenAI的终结点,可以在Azure门户中的“Keys and Endpoints”下找到。
    • OPENAI_API_KEY – Azure OpenAI的API密钥,可以在Azure门户中的“Keys and Endpoints”下找到。
    • SEARCH_ENDPOINT – Cognitive Search的终结点,可以在Azure门户中的Search资源的“Overview”中找到。
    • SEARCH_KEY – Cognitive Search的API密钥,可以在Azure门户中的Search资源的“Keys”下找到。
    • SEARCH_INDEX_NAME – 您使用自己的数据创建的索引的名称。

    接下来,您可以使用以下代码来配置Azure OpenAI SDK,以便连接到Azure OpenAI服务:

    import os
    import openai
    import dotenv
    
    dotenv.load_dotenv()
    
    openai.api_base = os.environ["OPENAI_API_BASE"]
    openai.api_version = "2023-08-01-preview"

    步骤3:身份验证

    Azure OpenAI服务支持多种身份验证机制,包括API密钥和Azure凭据。根据您的身份验证选择,您可以使用以下代码中的其中一种方式进行身份验证。

    使用API密钥进行身份验证

    如果选择使用API密钥进行身份验证,请设置use_azure_active_directory标志为False,然后使用以下代码设置OpenAI SDK以使用Azure API密钥:

    if not use_azure_active_directory:
        openai.api_type = 'azure'
        openai.api_key = os.environ["OPENAI_API_KEY"]

    使用Microsoft Active Directory进行身份验证

    如果选择使用Microsoft Active Directory进行身份验证,请使用以下代码安装azure-identity库,并设置use_azure_active_directory标志为True,然后使用以下代码设置OpenAI SDK以使用Azure Active Directory令牌:

    ! pip install azure-identity
    
    from azure.identity import DefaultAzureCredential
    
    if use_azure_active_directory:
        default_credential = DefaultAzureCredential()
        token = default_credential.get_token("https://cognitiveservices.azure.com/.default")
    
        openai.api_type = "azure_ad"
        openai.api_key = token.token

    步骤4:定制聊天应用程序

    现在,您已经完成了设置和身份验证,可以开始创建定制的聊天应用程序,该应用程序可以根据您自己的数据提供回答。

    首先,您需要使用以下代码来设置Azure OpenAI SDK,以便使用自己的数据进行聊天:

    import requests
    
    def setup_byod(deployment_id: str) -> None:
        """Sets up the OpenAI Python SDK to use your own data for the chat endpoint.
    
        :param deployment_id: The deployment ID for the model to use with your own data.
    
        To remove this configuration, simply set openai.requestssession to None.
        """
    
        class BringYourOwnDataAdapter(requests.adapters.HTTPAdapter):
    
            def send(self, request, **kwargs):
                request.url = f"{openai.api_base}/openai/deployments/{deployment_id}/extensions/chat/completions?api-version={openai.api_version}"
                return super().send(request, **kwargs)
    
        session = requests.Session()
    
        # Mount a custom adapter which will use the extensions endpoint for any call using the given `deployment_id`
        session.mount(
            prefix=f"{openai.api_base}/openai/deployments/{deployment_id}",
            adapter=BringYourOwnDataAdapter()
        )
    
        if use_azure_active_directory:
            session.auth
    
     = None
        else:
            session.auth = (openai.api_key, '')
    
        openai.requests_session = session
    
    # 使用您的部署ID来设置自己的数据
    setup_byod("YOUR_DEPLOYMENT_ID")

    接下来,您可以使用以下代码来与聊天模型进行交互,并提供自己的数据:

    import openai
    
    def chat_with_model(messages):
        response = openai.ChatCompletion.create(
            model="YOUR_MODEL_NAME",  # 使用您的模型名称,如"gpt-3.5-turbo"或"gpt-4"
            messages=messages
        )
        return response.choices[0].message["content"]
    
    # 与聊天模型交互
    messages = [
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Tell me about our products."},
    ]
    
    response = chat_with_model(messages)
    print(response)

    步骤5:与Azure Cognitive Search集成

    最后,您可以使用Azure Cognitive Search来提供对自己的数据的强大搜索功能。您可以使用Azure Cognitive Search SDK或 REST API来查询您的索引,并将搜索结果与聊天模型集成到您的应用程序中。

    以下是一个使用Azure Cognitive Search SDK进行搜索的示例代码:

    from azure.search.documents.indexes import SearchIndexClient
    from azure.core.credentials import AzureKeyCredential
    
    search_endpoint = os.environ["SEARCH_ENDPOINT"]
    search_api_key = os.environ["SEARCH_KEY"]
    search_index_name = os.environ["SEARCH_INDEX_NAME"]
    
    # 创建Search Index客户端
    index_client = SearchIndexClient(endpoint=search_endpoint, index_name=search_index_name, credential=AzureKeyCredential(search_api_key))
    
    # 构建搜索查询
    search_query = "Your search query here"
    
    # 执行搜索查询
    results = index_client.search(search_text=search_query)
    
    # 处理搜索结果
    for result in results:
        print(result)

    将搜索结果与聊天模型的回答合并,以创建一个功能强大的聊天应用程序,可以提供个性化的建议和信息检索功能。

    总结

    通过结合Azure OpenAI和Azure Cognitive Search,您可以构建自己的定制聊天应用程序,该应用程序可以根据您自己的数据提供回答,并具有强大的搜索功能。这将帮助您提供更好的客户支持和信息检索体验,同时提高用户满意度和效率。

    请注意,本教程只是一个示例,您可以根据自己的需求和业务逻辑进行自定义。祝您成功构建您的聊天应用程序!

  • 解决Python集合计算问题的完美方案

    解决Python集合计算问题的完美方案

    在Python中,有许多强大的第三方库和轮子可用于各种任务,但要找到一个能够满足您的需求的集合计算包可能会有些挑战。您需要一个能够处理不同类型的集合并保持输入顺序的解决方案。在本文中,我将为您介绍一种解决这个问题的完美方案。

    开篇小故事

    在编写代码时,我们经常需要对不同类型的集合进行比较和处理。例如,您可能需要比较一个包含整数的列表与一个包含浮点数的元组,或者比较一个字典的值与一个数据帧的列。虽然Python提供了丰富的数据结构和功能,但要编写一个通用的集合计算工具并保持输入顺序可能会让人感到困惑。让我们一起看看如何解决这个问题。

    问题描述

    首先,让我们明确问题。您需要一个可以处理不同类型集合的包,包括但不限于list、tuple、set、dict.values()和dataframe.columns。这些集合的维度可以不同,但我们只关心它们的内容(值)是否匹配。另外,值的类型也需要考虑,例如字符 ‘1’ 和整数 1 不能被认为是匹配的。最后,您希望计算的结果保持输入顺序。

    解决方案

    为了解决这个问题,我们可以借助Python的强大功能和一些第三方库来构建一个自定义的集合计算工具。以下是一个解决方案的概述:

    步骤 1:准备工作

    首先,我们需要导入必要的库。在这个解决方案中,我们将使用collections模块中的OrderedDict来保持输入顺序,以及numpy来处理数据类型的匹配。

    from collections import OrderedDict
    import numpy as np

    步骤 2:定义集合比较函数

    接下来,我们将定义一个函数,该函数将接受多个集合作为参数,并执行集合比较操作。以下是一个示例函数的框架:

    def compare_collections(*collections):
        # 初始化一个OrderedDict,用于保持结果的顺序
        result = OrderedDict()
    
        # 将集合转换为numpy数组以便比较
        collection_arrays = [np.array(collection) for collection in collections]
    
        # 执行集合比较逻辑,将结果存储在result中
        # 这里您可以根据需要自定义比较逻辑
    
        return result

    步骤 3:自定义比较逻辑

    在上述函数中,您可以根据您的需求自定义集合比较逻辑。这可能涉及到遍历集合元素,检查值的匹配性和类型等等。以下是一个示例比较逻辑的框架:

    for i, collection in enumerate(collections):
        for item in collection:
            # 检查值的类型
            item_type = type(item)
    
            # 检查值是否已经在结果中
            if item not in result:
                # 如果值不在结果中,将其添加并初始化计数为1
                result[item] = {'count': 1, 'types': {item_type}}
            else:
                # 如果值已经在结果中,增加计数和记录值的类型
                result[item]['count'] += 1
                result[item]['types'].add(item_type)

    步骤 4:返回结果

    最后,我们将返回包含比较结果的OrderedDict。这个结果将包括每个值的计数以及该值的类型集合。

    示例用法

    现在,让我们来看一个示例用法:

    list1 = [1, 2, 3, 4]
    tuple1 = (3, 4, 5, 6)
    set1 = {5, 6, 7, 8}
    dict_values = {'a': 1, 'b': 2, 'c': 3}
    result = compare_collections(list1, tuple1, set1, dict_values)
    
    for item, info in result.items():
        print(f'Value: {item}, Count: {info["count"]}, Types: {info["types"]}')

    这将输出:

    Value: 1, Count: 1, Types: {<class 'int'>}
    Value: 2, Count: 1, Types: {<class 'int'>}
    Value: 3, Count: 2, Types: {<class 'int'>}
    Value: 4, Count: 2, Types: {<class 'int'>}
    Value: 5, Count: 2, Types: {<class 'int'>}
    Value: 6, Count: 2, Types: {<class 'int'>}
    Value: 7, Count: 1, Types: {<class 'int'>}
    Value: 8, Count: 1, Types: {<class 'int'>}
    Value: 'a', Count: 1, Types: {<class 'str'>}
    Value: 'b', Count: 1, Types: {<class 'str'>}
    Value: 'c', Count: 1, Types: {<class 'str'>}

    结论

    通过自定义的集合比较工具,您可以轻松地处理不同类型的集合,保持输入顺序,并根据需要自定义比较逻辑。这个解决方案满足了您的需求,让集合计算变得更加简单和高效。

    希望这篇文章对您有所帮助,祝您在集合计算中取得成功!

  • 机器学习算法之美:探索线性回归在房价预测中的应用

    机器学习算法之美:探索线性回归在房价预测中的应用

    在当今数字化时代,数据已成为我们生活的一部分,它们蕴含着无限的价值。而机器学习算法则是从这些数据中提取信息和做出预测的有力工具之一。本文将深入探讨其中之一的线性回归算法,并通过Python代码演示如何使用它来解决一个实际问题:预测房价。


    故事发生在一个充满机会和挑战的城市。小明是一个年轻的数据科学家,他梦想着拥有一套属于自己的房子。然而,这座城市的房价一直是一个令人望而却步的难题。小明知道,要想实现自己的梦想,他需要掌握一些强大的工具来预测房价。

    正当他苦思冥想之际,他的好友小红前来拜访。小红是一位资深的数据分析师,她听说了小明的困惑,便主动提出帮助。她告诉小明,有一个神奇的机器学习算法叫做线性回归,可以用来预测房价。于是,小明和小红开始了一段关于数据、算法和房价的冒险之旅。

    什么是线性回归?

    在我们深入了解线性回归算法之前,让我们先理解一下什么是线性回归。

    线性回归是一种用于建立变量之间线性关系的机器学习算法。它通常用于解决回归问题,即根据输入特征的值来预测一个连续性的输出。在房价预测中,我们可以将输入特征定义为影响房价的因素,如房屋面积、卧室数量、地理位置等,而输出就是房屋的价格。

    线性回归假设输入特征和输出之间存在一个线性关系,可以用以下数学公式表示:

    y = wx + b

    其中,y 是预测的输出(房价),x 是输入特征(如房屋面积),w 是权重(表示特征的重要性),b 是偏置(表示房价的基本价格)。线性回归的目标是找到最佳的权重 w 和偏置 b,使得预测值与真实值之间的误差最小化。

    使用Python进行线性回归

    现在,让我们一起来看看如何使用Python来实现线性回归,以预测房价。

    首先,我们需要一些数据来训练我们的模型。假设我们已经收集了一些房屋信息,包括面积和价格。我们可以将这些数据保存在一个CSV文件中,然后使用Python的Pandas库加载它们。

    import pandas as pd
    
    # 加载数据
    data = pd.read_csv('house_data.csv')
    
    # 查看数据的前几行
    print(data.head())

    上述代码将加载包含房屋数据的CSV文件,并显示数据的前几行,以确保数据加载正确。

    接下来,我们将数据分成两部分:训练集和测试集。训练集用于训练我们的模型,而测试集用于评估模型的性能。

    from sklearn.model_selection import train_test_split
    
    # 划分数据为训练集和测试集
    X = data['面积'].values.reshape(-1, 1)  # 输入特征,这里只使用了面积
    y = data['价格'].values  # 输出
    
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

    在上述代码中,我们使用train_test_split函数将数据划分为训练集和测试集,其中80%的数据用于训练,20%的数据用于测试。

    接下来,我们可以使用Scikit-Learn库中的线性回归模型来训练我们的模型。

    from sklearn.linear_model import LinearRegression
    
    # 创建线性回归模型
    model = LinearRegression()
    
    # 训练模型
    model.fit(X_train, y_train)

    现在,我们的模型已经训练好了。接下来,让我们用测试集来评估模型的性能。

    # 在测试集上进行预测
    y_pred = model.predict(X_test)
    
    # 计算模型的性能指标
    from sklearn.metrics import mean_squared_error, r2_score
    
    mse = mean_squared_error(y_test, y_pred)
    r2 = r2_score(y_test, y_pred)
    
    print(f'Mean Squared Error: {mse}')
    print(f'R-squared: {r2}')

    上述代码中,我们使用均方误差(Mean Squared Error,MSE)和R平方(R-squared)来评估模型的性能。MSE用于衡量预测值与真实值之间的均方误差,而R-squared用于衡量模型对数据的拟合程度,值越接近1表示模型拟合得越好。

    结语

    通过这篇文章,我们深入了解了机器学习中的线性回归算法,并通过Python代码演示了如何使用它来解决房价预测问题。线性回归只是机器学习中众多强大算法中的一个,它在解决回归问题上表现出色。

  • 用SadTalker实现音频驱动的单图像表情生成教程

    用SadTalker实现音频驱动的单图像表情生成教程

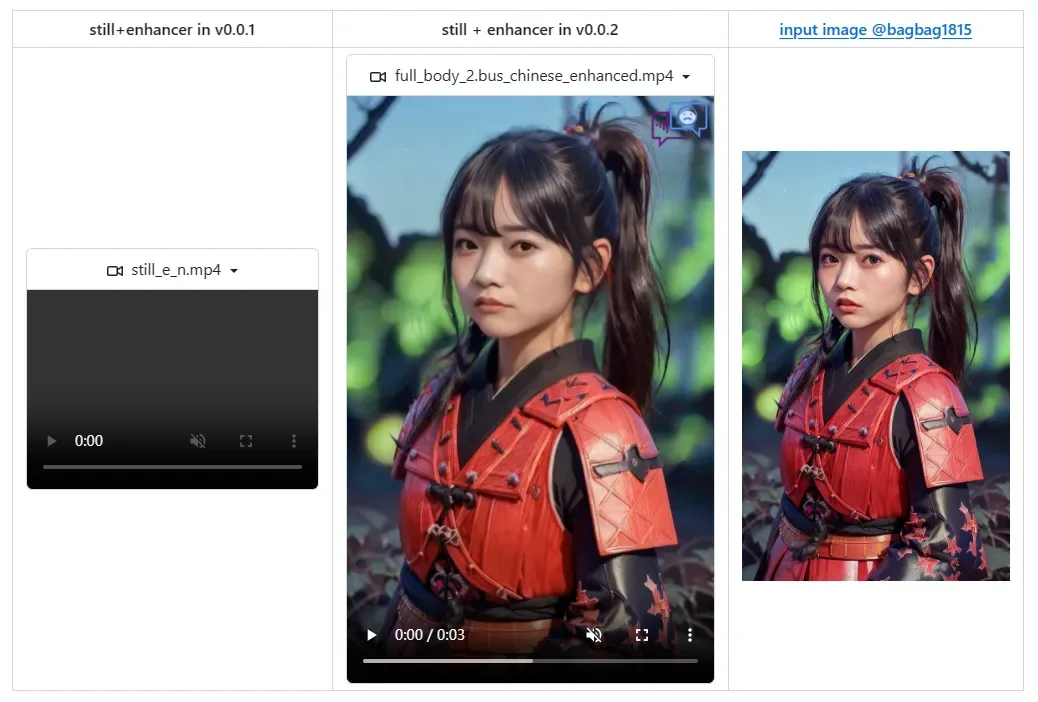
    在数字化时代,人工智能技术正以惊人的速度发展,为我们的生活带来了无数令人兴奋的可能性。其中之一就是SadTalker,它是一种强大的工具,能够实现音频驱动的单图像表情生成。这意味着您可以将一张静态的人像图片,通过添加音频,让它栩栩如生地表情丰富起来,仿佛在说话。

    想象一下,您拥有一张自己喜爱的明星照片,但您想要让这张照片“活”起来,让明星像真人一样表情丰富地演说。这就是SadTalker的魔力所在。本教程将向您展示如何使用SadTalker这一强大工具,让您的创意得以充分发挥。

    步骤1:安装SadTalker

    首先,让我们来安装SadTalker。请按照以下步骤进行:

    Linux/Unix

    1. 安装 Anaconda,Python 和 git。

    2. 克隆SadTalker仓库并进入目录:

      git clone https://github.com/OpenTalker/SadTalker.git
      cd SadTalker
    3. 创建并激活conda环境,并安装依赖:

      conda create -n sadtalker python=3.8
      conda activate sadtalker
      pip install torch==1.12.1+cu113 torchvision==0.13.1+cu113 torchaudio==0.12.1 --extra-index-url https://download.pytorch.org/whl/cu113
      conda install ffmpeg
      pip install -r requirements.txt

    Windows

    在Windows上安装SadTalker稍微复杂一些,但请按照以下步骤进行:

    1. 安装 Python 3.8,并勾选“Add Python to PATH”。

    2. 手动或使用 Scoop 安装 git:scoop install git。

    3. 安装 ffmpeg,可以参考 这个教程 或使用 scoop:scoop install ffmpeg。

    4. 下载SadTalker仓库,运行以下命令:

      git clone https://github.com/OpenTalker/SadTalker.git
    5. 下载模型和gfpgan模型,可以参考上面提供的下载链接。

    6. 运行start.bat,将启动一个Gradio-powered WebUI演示。

    macOS

    如果您使用macOS,请参考此教程来安装SadTalker。

    安装完成后,SadTalker将准备就绪,您可以继续下一步操作。

    步骤2:下载模型

    您需要下载一些预训练模型,以便SadTalker能够正常工作。运行以下命令来自动下载所有模型:

    bash scripts/download_models.sh

    这将自动下载所需的模型文件。

    步骤3:音频驱动的单图像表情生成

    现在,让我们开始使用SadTalker来实现音频驱动的单图像表情生成。您可以按照以下步骤操作:

    在线演示

    如果您想快速体验SadTalker,可以使用在线演示。只需访问HuggingFace,您就可以在那里使用SadTalker进行图像生成。

    本地WebUI演示

    如果您更喜欢本地演示,可以使用Gradio来运行一个本地WebUI演示。只需运行以下命令:

    python app_sadtalker.py
    ``
    
    `
    
    这将启动一个本地Web界面,您可以在其中上传图像和音频,然后观察生成的结果。
    
    ### Python脚本
    
    如果您想将SadTalker集成到自己的Python项目中,可以使用以下代码示例:
    
    ```python
    import torch
    from sadt.utils import load_model, pad_seq
    from sadt.sadt import SadT
    
    model = load_model('model.pth')
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    model.to(device)
    model.eval()
    
    # 图像和音频的文件路径
    image_path = 'path_to_image.jpg'
    audio_path = 'path_to_audio.wav'
    
    # 加载图像和音频
    image = load_image(image_path)
    audio = load_audio(audio_path)
    
    # 生成表情
    with torch.no_grad():
        image = image.to(device)
        audio = pad_seq(audio, 8000).to(device)
        result = model(image, audio.unsqueeze(0))
        result = result.squeeze(0).cpu().numpy()
    
    # 处理生成的表情
    # 将result转换为合适的图像格式
    # 显示或保存生成的图像

    这个示例代码将帮助您在自己的项目中使用SadTalker。

    结束语

    SadTalker是一个令人惊叹的工具,可以为静态图像注入生动的表情。无论您是想要为自己的创作增添趣味,还是想要在娱乐领域做更多创新,SadTalker都将是您的得力助手。希望这个教程能够帮助您入门,开始探索无限可能性。祝愿您在使用SadTalker时取得巨大成功!

  • EasyPhoto教程:从云端到本地,快速入门EasyPhoto图像生成

    EasyPhoto教程:从云端到本地,快速入门EasyPhoto图像生成

    在当今数字化的世界中,图像生成技术正变得越来越重要。不论是在艺术创作、影视特效还是虚拟现实领域,都需要强大的图像生成工具来创造出令人惊叹的视觉效果。而EasyPhoto作为一款强大的图像生成工具,为我们提供了丰富的功能和灵活的使用方式。

    在本教程中,我们将介绍如何快速入门EasyPhoto,无论您是想在云端使用还是在本地安装,都能够轻松上手。让我们一起开始这个令人兴奋的探索之旅吧!

    云端使用EasyPhoto

    从AliyunDSW获取免费GPU时间

    AliyunDSW提供了免费的GPU时间,一次用户申请后有效期为3个月。您可以在Aliyun PAI-DSW中使用这些免费GPU时间,只需3分钟即可启动EasyPhoto。

    1. 登录AliyunDSW。
    2. 在DSW Notebook中使用免费GPU时间。
    3. 启动EasyPhoto,开始创造惊人的图像!

    使用AutoDL

    如果您正在使用AutoDL,您可以通过提供的镜像快速启动稳定的Diffusion WebUI。

    1. 在Community Mirrors中填写相关信息。
    2. 选择aigc-apps/sd-webui-EasyPhoto/sd-webui-EasyPhoto镜像。
    3. 快速启动EasyPhoto,开始图像生成之旅!

    使用Docker

    如果您使用Docker,请确保正确安装了图形卡驱动程序和CUDA环境。然后按照以下步骤执行:

    # 拉取镜像
    docker pull mybigpai-registry.cn-beijing.cr.aliyuncs.com/aigc/sd-webui-easyphoto:0.0.3
    
    # 进入镜像
    docker run -it -p 7860:7860 --network host --gpus all mybigpai-registry.cn-beijing.cr.aliyuncs.com/aigc/sd-webui-easyphoto:0.0.3
    
    # 启动WebUI
    python3 launch.py --port 7860

    请注意,Docker的更新速度可能略慢于GitHub仓库的sd-webui-EasyPhoto,因此您可以先进入extensions/sd-webui-EasyPhoto并执行git pull以获取最新版本。

    本地安装EasyPhoto

    环境检查

    在本地安装EasyPhoto之前,您需要进行环境检查,确保您的系统满足以下要求:

    • Windows 10或Linux操作系统。
    • Python 3.10或3.11。
    • PyTorch 2.0.1。
    • TensorFlow 2.13.0。
    • CUDA 11.7。
    • CUDNN 8+。
    • Nvidia显卡(具体型号根据您的选择而定)。
    • 至少60GB的可用磁盘空间。

    如果您在WebUI自动被OOM杀死的问题,请参考ISSUE21进行设置,将一些num_threads设置为0,并向我们报告其他修复方法,谢谢。

    相关仓库和权重下载

    在使用EasyPhoto之前,您需要安装Controlnet进行推断。相关的仓库是Mikubill/sd-webui-controlnet。您需要在使用EasyPhoto之前安装此仓库。

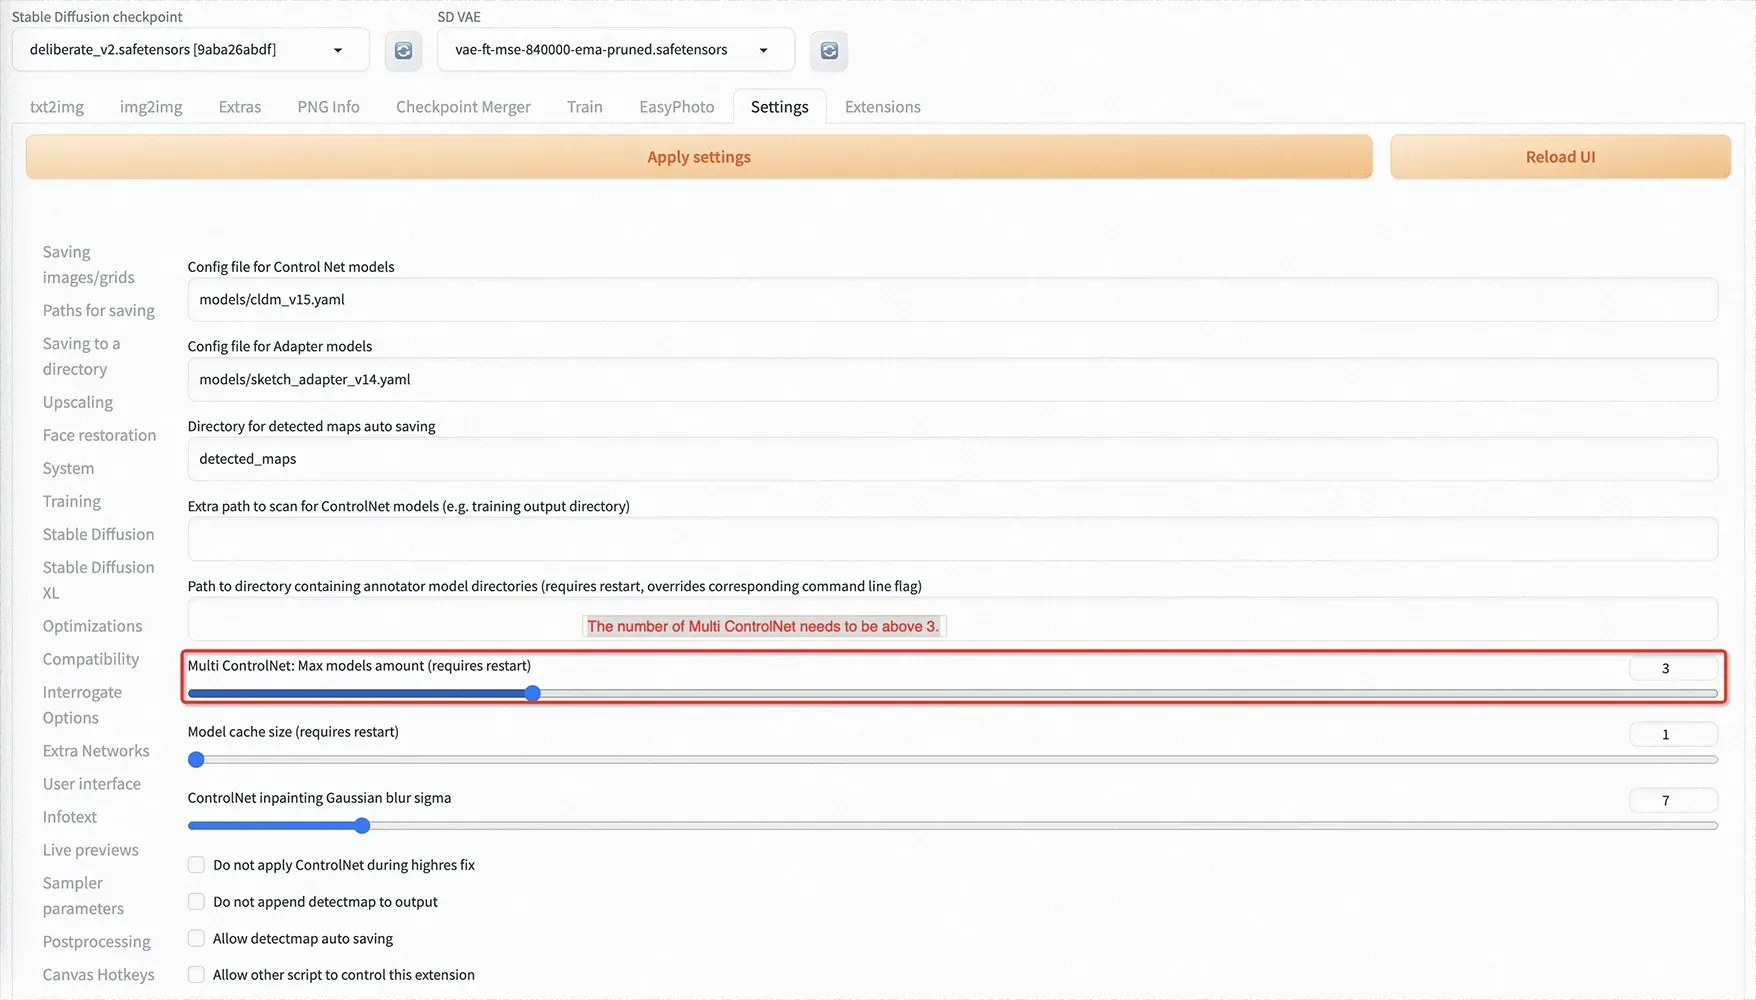
    此外,我们需要至少三个Controlnet用于推断。因此,您需要在设置中设置Multi ControlNet:Max models amount(需要重启)的值。controlnet_num

    其他依赖项将在启动稳定的diffusion-webui时自动安装,并且在首次训练时会自动下载所需的权重。

    插件安装

    现在,我们支持从Git安装EasyPhoto。我们的仓库地址是https://github.com/aigc-apps/sd-webui-EasyPhoto。

    未来,我们还将支持从Available安装EasyPhoto。

    如何使用EasyPhoto

    模型训练

    EasyPhoto的训练界面如下:

    • 左侧是训练图片。只需点击“上传照片”以上传图片,点击“清除照片”以删除已上传的图片;
    • 右侧是训练参数,第一次训练时无法调整。
    1. 点击“上传照片”,开始上传图片。最好上传5至20张图片,包括不同角度和光照条件的图片。最好包括一些不带眼镜的图片,如果全部都是眼镜,生成的结果可能会容易生成眼镜。
    2. 然后点击下方的“开始训练”,此时需要填写上方的用户ID,例如用户的姓名,以开始训练。
    3. 当模型开始训练时,WebUI将自动刷新训练日志。如果没有刷新,请点击“刷新日志”按钮。

    如果您想要设置参数,每个参数的解释如下:

    • 分辨率:训练时输入网络的图像大小,默认值为512。
    • 验证和保存步骤:验证图像和保存中间权重之间的步骤数,默认值为100,表示每100步验证一次图像并保存权重。
    • 最大训练步骤:最大训练步骤数,默认值为800。
    • 每张照片的最大步数:每张图像的最大训练次数,默认为200。
    • 训练批次大小:训练的批次大小,默认值为1。
    • 梯度累

    积步骤:是否执行梯度累积,默认值为4。结合训练批次大小,每一步等同于输入四张图像。

    • 数据加载器的工作线程数:加载数据的工作线程数,在Windows下不起作用,因为设置会报错,但在Linux下正常设置。
    • 学习率:Train Lora的学习率,默认为1e-4。
    • Rank Lora:权重的特征长度,默认为128。
    • 网络alpha:Lora训练的正则化参数,通常为rank的一半,默认为64。

    推断

    单人生成

    步骤1:点击刷新按钮以查询已训练用户ID对应的模型。
    步骤2:选择用户ID。
    步骤3:选择需要生成的模板。
    步骤4:点击生成按钮以生成结果。

    多人生成

    步骤1:转到EasyPhoto的设置页面,并设置num_of_faceid大于1。
    步骤2:应用设置。
    步骤3:重新启动WebUI的界面。
    步骤4:返回EasyPhoto并上传两个人的模板。
    步骤5:选择两个人的用户ID。
    步骤6:点击生成按钮进行图像生成。

    结论

    通过这个教程,您已经了解了如何快速入门EasyPhoto,不论是在云端还是在本地安装。EasyPhoto为图像生成提供了强大的工具,无论您是艺术家、设计师还是研究人员,都能够受益于它的功能和灵活性。现在,您可以开始使用EasyPhoto,创造令人惊叹的图像!

    在这个数字化时代,图像生成是一个令人兴奋的领域,而EasyPhoto正是您探索这一领域的理想伙伴。无论您是初学者还是有经验的用户,都可以轻松使用EasyPhoto,让您的创意得以充分发挥。愿您在图像生成的旅程中取得巨大成功!

    欢迎继续关注王大神AI技术博客,了解更多有关AI技术和创新的内容。

    以中文撰写,发布于王大神AI技术博客。

  • 如何提取局域网中的IP和MAC地址

    如何提取局域网中的IP和MAC地址

    曾经有一位名叫王大神的程序员,他在经营自己的网站,热衷于远程办公和编程。有一天,他遇到了一个问题:他想要了解局域网中的设备的IP和MAC地址,以便更好地管理网络和设备。但是,他并不知道如何开始。于是,王大神踏上了一段新的学习之旅,探索如何提取局域网中的IP和MAC地址。

    准备工作

    在开始之前,让我们明确一些基本概念。IP地址是网络上的设备的唯一标识符,而MAC地址是网络适配器的硬件地址。了解局域网中设备的IP和MAC地址对于网络管理和故障排除非常重要。

    步骤一:获取本机IP和MAC地址

    首先,我们将学习如何获取本机的IP和MAC地址。为此,我们可以使用Python编写一个小程序,如下所示:

    import os
    
    def local_ip_mac():
        output = os.popen('ipconfig /all')
        for line in output:
            if '物理地址.' in line:
                mac = line.split(':')[1].strip()
            if 'IPv4' in line.upper() and '(' in line:
                ip = line.split(':')[1].split('(')[0].strip()
        if ip and mac:
            return [ip, mac]
    
    # 调用函数获取本机IP和MAC地址
    ip_mac = local_ip_mac()
    print("本机IP地址:", ip_mac[0])
    print("本机MAC地址:", ip_mac[1])

    这个程序通过运行ipconfig /all命令来获取本机的IP和MAC地址,并将它们存储在一个列表中。现在,我们知道了如何获取本机的信息。

    步骤二:提取局域网中的IP和MAC地址

    接下来,我们将学习如何提取局域网中其他设备的IP和MAC地址。我们可以使用Python编写另一个小程序,如下所示:

    import os
    
    def lan_ip_mac():
        device_list = []
        output = os.popen('arp -a')
        for line in output:
            if '动态' in line:
                parts = line.strip().split()
                ip = parts[0]
                mac = parts[1]
                device_list.append([ip, mac])
        return device_list
    
    # 调用函数获取局域网中设备的IP和MAC地址
    devices = lan_ip_mac()
    for device in devices:
        print("设备IP地址:", device[0])
        print("设备MAC地址:", device[1])

    这个程序通过运行arp -a命令来获取局域网中设备的IP和MAC地址,并将它们存储在一个列表中。

    通过以上步骤,我们学习了如何获取本机和局域网中设备的IP和MAC地址。这对于网络管理和故障排除非常有用。王大神成功掌握了这些技巧,使他的网络管理工作更加高效。

    不要忘记保存提取的结果,以备将来使用。现在,你也可以尝试编写类似的程序,提取局域网中的设备信息。祝你在网络管理方面取得成功!

    以上就是关于如何提取局域网中的IP和MAC地址的教程,希望对你有所帮助。

    注意: 请在使用这些技术时遵守适用的法律和政策,以确保合法和合规的使用。

  • 青海地区网站建设服务:王大神AI技术博客带你探索区域数字化的无限可能

    青海地区网站建设服务:王大神AI技术博客带你探索区域数字化的无限可能

    大家好,我是王大神,今天我想和大家分享一下青海这片神奇的土地。青海,一个拥有无尽的自然风光和丰富的文化底蕴的地方,正在迅速地成为数字化时代的新星。而我,希望能够为这片土地带来一些新的变化,让更多的人了解和爱上青海。

    为什么选择我?

    首先,我不只是一个简单的编程高手。有了丰富的Python编程经验和对电子设备、服务器的深入了解,我可以确保每一个项目都达到了最高的技术标准。而且,我对青海有着特殊的感情,每当我进行一个新项目的时候,我都会深入了解青海的文化和市场需求,确保我的工作能够为这片土地带来真正的价值。

    一站式服务,满足您的所有需求

    • 定制化网站设计:我了解青海的美,也知道怎样将这些美融入到网站设计中,让每一个网站都像青海的天空和大地一样独特。
    • SEO优化:我知道如何让更多的人通过搜索引擎找到您,让您的网站在搜索结果中名列前茅。
    • 服务器维护与安装:数据是宝贵的,我会像保护宝藏一样,确保您的数据安全无虞。
    • 移动端适配:无论您是在青海湖边还是塔尔寺内,都能轻松访问您的网站。
    • 数据分析:数据说话最直接,我会帮您分析数据,让您的业务决策更加明智。

    不只是代码,更是文化的传承

    每当我编写代码的时候,我都会将青海的文化和市场需求融入其中。每一行代码,都是对青海的一次致敬。每一个设计,都是对青海文化的一次深度挖掘。我希望,通过我的努力,能够让更多的人了解和爱上青海。

    如何与我联系?

    如果您有任何关于青海地区网站建设的需求或疑问,欢迎随时 :kissing_heart:点击我 与我取得联系。我会尽快回复您,帮助您解决问题。

    总结

    在这个数字化不断加速的时代,青海有着无尽的可能性等待着我们去探索。我希望,能够成为您探险路上的合作伙伴,一同开启这场青海的数字之旅。

  • 如何使用Python编写递归脚本自动生成PyInstaller的.spec文件

    如何使用Python编写递归脚本自动生成PyInstaller的.spec文件

    在软件开发中,经常需要将Python项目打包成可执行文件,以便在没有Python环境的计算机上运行。PyInstaller是一个常用的工具,可以将Python项目打包成独立的可执行文件。但是,使用PyInstaller需要编写一个.spec文件,指定打包的配置信息。编写.spec文件可能会显得繁琐,特别是当项目包含多个文件和依赖项时。今天,我们将介绍如何使用Python编写一个递归脚本,自动生成PyInstaller的.spec文件,简化打包过程。

    什么是.spec文件?

    .spec文件是PyInstaller的配置文件,用于指定项目的打包配置。在.spec文件中,您可以设置项目的入口文件、依赖项、输出文件名等信息。手动编写.spec文件可能会比较繁琐,尤其是在有多个文件和依赖项的情况下。因此,自动生成.spec文件可以大大简化打包过程。

    使用Python编写递归脚本

    在本文中,我们将介绍如何使用Python编写一个递归脚本,自动生成PyInstaller的.spec文件。这个脚本将遍历项目目录,找到所有的Python文件,并生成.spec文件所需的配置信息。

    import os
    
    pathex = []
    
    def recursion(path, main):
        if path[:1] != '/':
            path += '/'
        listpath = os.listdir(path)
        for item in listpath:
            if os.path.isdir(path + item):
                recursion(path + item, main)
            elif os.path.isfile(path + item):
                if '.py' in item and all(i not in item for i in ['.pyc', '__init__', '.pyz', '.pyd', main]):
                    pathex.append(path + item)
            else:
                print('未知文件', path + item)
    
    def getTxt():
        return """# -*- mode: python ; coding: utf-8 -*-
    block_cipher = None
    
    a = Analysis(['${thisMain}.py'],
                 pathex=${thisPath},
                 binaries=[],
                 datas=[],
                 hiddenimports=${thisPy},
                 runtime_hooks=[],
                 excludes=[],
                 win_no_prefer_redirects=False,
                 win_private_assemblies=False,
                 cipher=block_cipher,
                 noarchive=False)
    pyz = PYZ(a.pure, a.zipped_data,
                 cipher=block_cipher)
    exe = EXE(pyz,
              a.scripts,
              a.binaries,
              a.zipfiles,
              a.datas,
              [],
              name='Main',
              debug=False,
              bootloader_ignore_signals=False,
              strip=False,
              upx=True,
              upx_exclude=[],
              runtime_tmpdir=None,
              console=True )
        """
    
    if __name__ == '__main__':
        path = os.path.dirname(__file__)
        main = 'main'
        recursion(path, main)
        hiddenimports = []
        for i in pathex:
            if i != path:
                hiddenimports.append(i.replace(i[:i.rindex('/')], '').replace(i[i.index('.'):], '').replace('/', ''))
        pathexs = []
        pathex.append(path)
    
        for i in pathex:
            if i != path:
                pathexs.append(i.replace(os.path.abspath(os.path.join(os.getcwd(), "../")), '').replace('/', '\\'))
                continue
            pathexs.append(i.replace('/', '\\'))
    
        outTxt = getTxt().replace("${thisPy}",f'{hiddenimports}').replace("${thisPath}",f'{pathexs}').replace("${thisMain}",main)
        with open(f"{path}/{main}.spec","w",encoding="utf-8")as f:
            f.write(outTxt)
            f.close()
        exit(0)

    以上是一个示例脚本,它会在当前目录下递归查找所有的Python文件,并生成PyInstaller的.spec文件所需的配置信息。

    如何使用脚本自动生成.spec文件?

    要使用上述脚本自动生成PyInstaller的.spec文件,您需要按照以下步骤操作:

    1. 将脚本保存为一个.py文件,例如generate_spec.py。

    2. 在脚本中设置path变量为您的Python项目路径,设置main变量为项目的入口文件名。

    3. 打开命令行界面,导航到脚本所在的目录。

    4. 运行以下命令来执行脚本:

      python generate_spec.py
    5. 脚本将在当前目录下生成一个.spec文件,其中包含了项目的配置信息。

    6. 使用PyInstaller来打包项目,指定生成的.spec文件:

      pyinstaller your_project.spec

    通过这些步骤,您可以自动化生成PyInstaller的.spec文件,简化了项目的打包过程。

    结语

    在本文中,我们介绍了如何使用Python编写一个递归脚本,自动生成PyInstaller的.spec文件。这个脚本可以帮助您简化Python项目的打包过程,节省时间和精力。无论您是新手还是经验丰富的开发人员,都可以受益于这个自动化工具。

  • 2023年底游戏引擎选择:Godot还是Cocos?

    2023年底游戏引擎选择:Godot还是Cocos?

    在2023年末,游戏开发领域的竞争依然激烈。开发者们需要做出一个关键性的决策:在国内的游戏开发中,是选择使用Godot还是Cocos引擎?这个问题牵扯到生态系统、技术特点以及未来发展趋势。本文将为您提供关于这两个游戏引擎的深入分析,帮助您做出明智的选择。

    引擎选择的关键因素

    在选择游戏引擎时,有许多因素需要考虑。不同的项目和开发需求可能导致不同的选择,但以下是一些主要因素,我们将在本文中对其进行深入探讨:

    1. 生态系统

    游戏引擎的生态系统是一个至关重要的考虑因素。生态系统包括社区支持、教程、资源库、第三方插件和工具等。一个强大的生态系统可以为开发者提供更多的支持和便利,有助于项目的顺利进行。

    2. 技术特点

    不同的游戏引擎具有不同的技术特点。这包括引擎的渲染能力、性能优化、跨平台支持、编程语言和工具集等。开发者需要根据项目的需求来评估引擎的技术特点,以确保能够满足项目的要求。

    3. 开发者经验

    开发者自身的经验也是一个关键因素。如果开发者已经熟悉了特定的游戏引擎,那么在使用该引擎时可能更加高效和自信。然而,对于新手开发者来说,选择一个易于学习和上手的引擎可能更为重要。

    4. 商业需求

    最终,商业需求也是一个重要考虑因素。如果项目需要与广告合作,或者有其他商业依赖,开发者需要考虑引擎是否提供相关支持和工具。

    Godot vs. Cocos:生态系统对比

    Godot生态系统

    Godot引擎的生态系统在国内逐渐壮大,尤其在独立游戏开发者中间备受欢迎。Godot社区不断增长,提供了大量的教程、资源和插件,为开发者提供了丰富的支持。尤其对于2D游戏开发,Godot是一个强大的选择。

    然而,Godot在3D游戏开发方面的生态系统相对较弱,因为相对于Cocos和Unity,它的3D功能仍在不断发展中。此外,Godot的社区虽然庞大,但大多数用户位于国外,国内社区的活跃度相对较低。

    Cocos生态系统

    Cocos引擎在国内游戏开发领域拥有强大的生态系统。它是许多小游戏和移动应用的首选引擎,具有丰富的资源库和商业合作伙伴。Cocos Creator作为Cocos引擎的官方编辑器,提供了便捷的开发工具,适用于2D和3D游戏开发。

    Cocos引擎也在小游戏领域表现出色,适用于多个平台,包括微信小游戏和其他移动平台。如果项目的商业需求与小游戏广告合作相关,Cocos引擎可能是更明智的选择。

    技术特点对比

    Godot技术特点

    Godot引擎使用GDScript编程语言,它与Python类似,易于学习和使用。引擎具有可视化编辑器,有助于快速原型设计和场景制作。Godot对2D游戏开发提供了出色的支持,但在3D方面仍有改进空间。

    Godot的性能较好,但对于高度复杂的3D游戏可能不够强大。此外,Godot的中文文档和社区支持相对较少,可能需要依赖英文资源。

    Cocos技术特点

    Cocos引擎支持多种编程语言,包括C++、Lua和JavaScript。这为开发者提供了更大的灵活性。Cocos Creator是Cocos引擎的官方编辑器,具有丰富的功能和组件,适用于2D和3D游戏开发。

    Cocos引擎的性能较好,特别是在2D游戏开发方面。它具有广泛的文档和社区支持,国内开发者可以轻松找到相关资源和教程。

    开发者经验和商业需求

    开发者的经验和项目的商业需求也会影响引擎选择。如果开发者已经熟悉一种引擎,那么继续使用该引擎可能更加高效。同时,如果项目需要与广告合作或有其他商业依赖,需要考虑引擎是否提供相关支持和工具。

    最终的选择

    在2023年底,选择使用Godot还是Cocos引擎主要取决于项目的需求和开发者的经验。如果您是一名2D游戏开发者,对于独立游戏项目,Godot是一个强大的选择。而Cocos引擎在国内的生态系统和商业支持方面更加强大,适用于小游戏和移动应用的开发。

    无论您选择哪个引擎,都需要充分利用其生态系统和技术特点,以确保项目的成功。

    结语

    在选择游戏引擎时,考虑生态系统、技术特点、开发者经验和商业需求是至关重要的。无论您选择Godot还是Cocos引擎,都应该根据项目的具体需求来做出明智的决策。希望本文对您在2023年底的游戏开发决策提供了一些有价值的信息。