Tag: Python

  • 如何使用Python爬取网页并保存为Word文档

    如何使用Python爬取网页并保存为Word文档

    假设您是一位热衷于收集好文章的人,每天都希望能够快速获取优质文章并保存在本地,以备离线阅读。但是,手动复制粘贴文章内容并保存为Word文档是一项繁琐的任务,特别是当您需要获取大量文章时。在这篇教程中,我将向您介绍如何使用Python编写一个简单但功能强大的网络爬虫,可以帮助您自动从网站上获取文章并保存为Word文档,让您更轻松地构建自己的文章库。

    准备工作

    在开始之前,我们需要准备一些工具和环境:

    1. Python环境:确保您已经安装了Python,最好使用Python 3.x版本。您可以在Python官网上下载并安装最新版本的Python。

    2. 代码编辑器:选择一个您喜欢的代码编辑器,例如PyCharm或Visual Studio Code,以便编写Python脚本。

    3. 必要的库:在本教程中,我们将使用Requests、Beautiful Soup和docx库来进行网络请求、解析HTML和创建Word文档。您可以使用以下命令来安装这些库:

      pip install requests beautifulsoup4 python-docx
    4. 网络连接:确保您的计算机能够连接到互联网,因为我们将从网页上获取文章内容。

    编写Python爬虫脚本

    以下是我们的Python爬虫脚本,它将从指定网站上获取文章并保存为Word文档:

    # -*- coding: utf-8 -*-
    import time
    import random
    import requests
    import re
    from bs4 import BeautifulSoup
    from w3lib.html import remove_tags
    from docx.oxml.ns import qn
    from docx import Document
    from docx.enum.text import WD_PARAGRAPH_ALIGNMENT
    from docx.shared import Pt
    from docx.shared import RGBColor
    
    # 爬取网页
    def get_url(URL, SIGN):
        headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2228.0 Safari/537.36'}
        html = requests.get(URL, headers=headers)
        html.encoding = 'utf-8'
        soup = BeautifulSoup(html.text, 'lxml')
        text = soup.select(SIGN)
        return text
    
    # 创建doc
    def get_docx(TITLE, BODY):
        document = Document()
        head0 = document.add_heading(level=1)
        head0.alignment = WD_PARAGRAPH_ALIGNMENT.CENTER
        title_run = head0.add_run(TITLE)
        title_run.font.size = Pt(24)
        title_run.font.name = 'Times New Roman'
        title_run.element.rPr.rFonts.set(qn('w:eastAsia'), '方正小标宋简体')
        title_run.font.color.rgb = RGBColor(0, 0, 0)
        document.styles['Normal'].font.name = '宋体'
        document.styles['Normal']._element.rPr.rFonts.set(qn('w:eastAsia'), '仿宋_GB2312')
        p = document.add_paragraph()
        p_run = p.add_run(BODY)
        p.paragraph_format.space_before = Pt(30)
        p.paragraph_format.alignment = WD_PARAGRAPH_ALIGNMENT.JUSTIFY
        p.paragraph_format.line_spacing = Pt(28.8)
        p.paragraph_format.first_line_indent = Inches(0.5)
        p_run.font.color.rgb = RGBColor(0, 0, 0)
        p_run.font.size = Pt(16)
        TITLE = re.sub('([^\u4e00-\u9fa5\d])', '', TITLE)
        name = 'D:\\Download\\Articles\\' + TITLE + '.docx'
        document.save(name)
    
    def main():
        n = 0
        menus = get_url('http://www.haoword.com', '.infobox .indexleft .infoco .lm .news_title h2 a')
        menus_url = []
        for menu_url in menus:
            menus_url.append(menu_url['href'])
        print(menus_url)
        for menu_url in menus_url:
            time.sleep(random.random())
            results = get_url(menu_url, '.infobox .lmleft .infoco2 .lm_addon .articles3 ul li a')
            for result in results:
                title_url = result['href']
                title = result['title']
                print(f'{title}:{title_url}')
                time.sleep(random.random())
                articles_results = get_url(title_url, '.infobox .detail .content p')[1:]
                body = remove_tags(str(articles_results))[1:]
                get_docx(title, body)
                n += 1
        print(f'爬取完毕!共爬取 {n} 篇文章。')
    
    if __name__ == '__main__':
        start = time.perf_counter()
        main()
        end = time.perf_counter()
        print(f'耗时 {end - start} 秒。')

    使用说明

    • 在脚本中,我们使用了Requests库来发送HTTP请求,Beautiful Soup来解析HTML内容,以及docx库来创建Word文档。

    • 通过修改get_url函数中的URL和SIGN参数,您可以指定要爬取的网站和文章内容的选择器。

    • 修改get_docx函数中的文档保存路径和格式以适应您的需求。

    • 运行脚本后,它将自动从指定网站上获取文章并保存为Word文档。

    总结

    通过这篇教程,您学会了如何使用Python编写一个简单的网络爬虫,用于爬取网站上的文章并保存为Word文档。这个脚本可以帮助您轻松地建立自己的文章库,方便离线阅读和收藏。希望这对您有所帮助!
  • 本地化Markdown文件中的图片:Python助力批量操作

    本地化Markdown文件中的图片:Python助力批量操作

    在互联网时代,Markdown已经成为写作、博客、文档等多个领域的标配。它简单、高效,但有时我们会遇到一个问题:插入的图片都是网络链接,一旦这些链接失效,文章中的图片就会消失。有没有方法可以快速地将这些在线图片保存到本地,并自动修改Markdown文件的链接呢?答案是肯定的,今天我们就来探讨如何用Python实现这一功能。


    1. 准备工作

    首先,我们需要导入以下库:

    import requests, json, sys, random, time, os, re, openpyxl, urllib.parse, urllib3, glob

    这些库的功能非常丰富,涵盖了网络请求、文件操作、正则表达式等多个领域。


    2. 获取随机User-Agent

    由于频繁的网络请求可能会被服务器屏蔽,为了模拟真实的浏览器行为,我们需要随机选择User-Agent。代码如下:

    def User_gent():
        ...
        return (fackender)

    3. 保存网络图片到本地

    为了保存网络图片到本地,我们需要:

    • 使用requests.get()请求图片链接。
    • 检查响应状态码,确保请求成功。
    • 创建一个本地文件,并将图片内容写入。

    这部分的代码如下:

    def Secone(fileName, FilePath, Fpath):
        ...

    和

    def ChineseSecone_test(fileName, FilePath, Fpath):
        ...

    注意,我们的代码支持文件名中有中文字符,所以提供了两个函数。


    4. 执行程序

    我们使用if __name__=='__main__':来确保代码只在作为主程序时执行,而不是在导入时。用户可以选择操作单个文件或整个目录。


    5. 代码解释

    1. ImgDirectory = 'Image':定义了存放图片的目录。
    2. re.compile(r"[(](https://cdn.nlark.com/.*?)[)]"):使用正则表达式匹配Markdown文件中的图片链接。
    3. os.makedirs():用于在本地创建新目录。

    这个Python脚本是为了解决Markdown中图片链接失效的问题,帮助用户快速将网络图片保存到本地,并自动修改Markdown文件中的链接。无论你是一个博主、写手还是开发者,都可以利用这个脚本来优化你的写作流程。

  • Shell里的“魔术符号”,操控文件名与后缀

    Shell里的“魔术符号”,操控文件名与后缀

    那年的夏天,王大神坐在阳光下,手中拿着一本厚厚的编程手册。这不是他的第一次与编程的邂逅,但每次深入探究,都有新的发现。他目光停留在Shell脚本的章节,那些繁复的命令和特殊符号仿佛是魔法的咒语,只等着被他召唤。

    A picture of an old wizard with a long beard, holding a magical wand, symbolizing the power of shell scripting. A picture of an old wizard with a long beard, holding a magical wand, symbolizing the power of shell scripting.

    Shell,简单而不简约

    “有时候,为了一个小任务,确实没必要引入Python这样的大炮。”王大神自言自语,他意识到Shell本身就拥有着强大的能力。对于文件名和后缀名的处理,Shell提供了一些简洁而强大的方法。

    ${[#%]}:操控文件名的“魔术符号”

    假设你遇到了这样的文件名:file.tar.gz。

    想要获取它的后缀名,你可以用以下命令:

    f=file.tar.gz
    echo ${f##*.}

    输出是:gz。

    而获取前缀,只需:

    echo ${f%%.*}

    输出是:file。

    这就像魔术一样,几乎不费吹灰之力。

    如果文件路径稍显复杂,比如:file=/dir1/dir2/dir3/my.file.txt,Shell也能轻松应对。这需要借助以下的命令:

    ${file#*/}:dir1/dir2/dir3/my.file.txt
    ${file##*/}:my.file.txt
    ${file#*.}:file.txt
    ${file##*.}:txt
    ${file%/*}:/dir1/dir2/dir3
    ${file%%/*}:空值
    ${file%.*}:/dir1/dir2/dir3/my.file
    ${file%%.*}:/dir1/dir2/dir3/my

    如此看来,# 和 % 就像魔术师的手中的魔杖,左右摆弄,轻松得到想要的结果。

    记忆的小技巧

    对于初学者来说,这些符号可能有些晦涩。但王大神有一套记忆的小技巧:

    • # 去掉左边(键盘上 # 在 的左边,从左向右删)
    • % 去掉右边(键盘上 % 在 的右边,从右向左删)

    再加上单一符号代表最小匹配,而两个符号则代表最大匹配,记忆起来就更加方便了。

    终章

    回想起当年对编程的热爱,王大神深感自己的选择是多么的正确。Shell的学习,不仅仅是技术的探索,更是对知识的渴望和对完美的追求。

    编程,就像生活中的魔法,只要你掌握了它,就能创造无数的奇迹。

  • Python中的资源管理之谜:探索临时文件的正确释放方式

    Python中的资源管理之谜:探索临时文件的正确释放方式

    当夜深人静,程序员小王坐在电脑前,愁眉不展。他眼前的代码就像一座高墙,让他无法逾越。这不仅仅是一个普通的代码难题,而是关乎系统资源管理的大问题。

    小王正在开发一个任务处理类,这个类会在运行时创建大量的临时文件。按照正常的逻辑,当任务结束,这些临时文件也应该被销毁,释放系统资源。然而,现实却是残酷的。这些临时文件不仅没有被及时销毁,有时还要等到整个程序结束才会被释放。

    小王百思不得其解,为何Python的__del__方法没有如期执行呢?他决定深入探索,寻找答案。

    为何del不如人意?

    首先,我们来理解Python的垃圾回收机制。Python使用引用计数作为主要的垃圾回收机制,当一个对象的引用计数降为0时,它就会被销毁,__del__方法也会被调用。

    然而,实际情况并非如此简单。因为Python的循环引用问题,导致一些对象即使不再使用,也无法被正确销毁。这时,__del__方法就不会被调用。

    如何正确释放资源?

    使用上下文管理器

    一种常见的资源管理方法是使用上下文管理器。通过定义__enter__和__exit__方法,我们可以确保资源在使用后被正确释放。

    class Task:
        def __enter__(self):
            self._resource = create_local_files()
            return self
    
        def __exit__(self, exc_type, exc_val, exc_tb):
            self._resource.cleanup()

    使用上下文管理器的好处是,它可以确保即使在代码中发生异常,资源也会被正确释放。

    使用弱引用

    另一种方法是使用弱引用。弱引用可以让我们引用一个对象,但不增加其引用计数。这样,当对象不再被其他地方引用时,它可以被正确销毁,相关资源也会被释放。

    综上所述

    Python的资源管理是一个复杂的问题。通过深入了解Python的垃圾回收机制,以及利用上下文管理器和弱引用,我们可以确保系统资源被正确地管理和释放。

    不过,最好的建议还是,不要过于依赖__del__方法来管理资源。应当更多地使用上下文管理器和其他机制,来确保资源被正确释放。

  • 项目介绍:Retrieval-based-Voice-Conversion-WebUI

    项目介绍:Retrieval-based-Voice-Conversion-WebUI

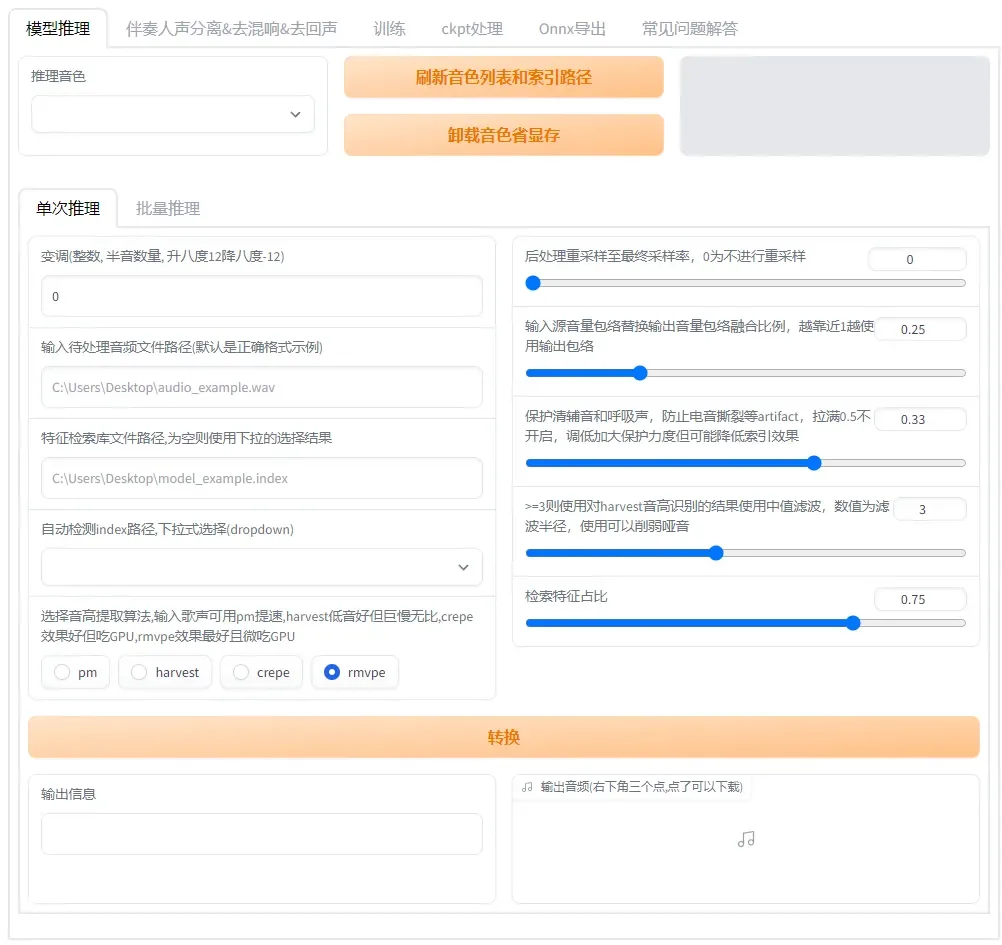
    大家是否曾经幻想过能够轻松改变自己的声音,变成不同的角色或声音风格,而不需要复杂的技术和昂贵的设备?现在,这个梦想成为现实的一部分,而且非常容易实现。在这篇文章中,我将向您介绍一个名为”Retrieval-based-Voice-Conversion-WebUI”的项目,它是一个基于VITS的简单易用的变声框架。无需深入的音频处理知识,只需轻松点击,您就可以实现令人惊叹的声音变化。

    项目概览

    Retrieval-based-Voice-Conversion-WebUI(以下简称RVC)是一个开源项目,它的目标是让声音变换变得容易、快捷和有趣。这个项目基于VITS(Variational Inference Text-to-Speech)模型,该模型在语音合成领域取得了显著的成就。RVC借助VITS的强大功能,为用户提供了一个简单的网页界面,让您能够以前所未有的方式探索声音。

    项目特点

    RVC拥有许多引人注目的特点,使其成为一个令人兴奋的项目:

    • 使用检索替换声音源特征:RVC采用了一种创新的方法,使用检索技术来替换输入源的特征,以杜绝音色泄漏,确保声音变换的高质量。

    • 适用于各种硬件:即使在相对较差的显卡上,RVC也能快速训练,这意味着您不需要超级高端的硬件来享受声音变换的乐趣。

    • 使用少量数据训练:与许多其他声音变换方法不同,RVC可以在少量数据下训练,只需10分钟左右的低噪音语音数据,就能获得出色的结果。

    • 模型融合:RVC允许您通过模型融合来改变音色,借助模型选项卡中的ckpt-merge选项,您可以自定义声音的风格。

    • 简单易用的网页界面:RVC提供了一个直观的网页界面,无需复杂的命令行操作,您只需点击几下,即可完成声音变换。

    • 人声分离:RVC还支持调用UVR5模型,以快速分离人声和伴奏,让您更轻松地处理音频文件。

    • 先进的音高提取算法:RVC采用了最先进的人声音高提取算法,根据哑音问题进行优化,实现更好的效果,同时占用更小的资源。

    • A卡和I卡加速支持:无论您使用的是A卡还是I卡,RVC都提供了相应的支持,以满足不同用户的需求。

    环境配置

    要开始使用RVC,您需要确保您的环境配置正确。以下是设置环境的简要步骤:

    1. 安装Python 3.8或更高版本。

    2. 安装PyTorch及其核心依赖,可以使用以下命令:

      pip install torch torchvision torchaudio

      对于Windows用户,如果使用Nvidia Ampere架构(如RTX30xx),您可能需要指定PyTorch对应的CUDA版本。您可以使用以下命令:

      pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu117
    3. 安装项目依赖项,您可以使用Poetry或pip来安装依赖。具体的命令请参考项目文档。

    4. 下载所需的预模型文件,项目提供了下载链接和说明。

    5. 启动WebUI,运行以下命令:

      python infer-web.py

    以上是基本的环境配置步骤,具体的配置细节可以在项目文档中找到。

    结语

    Retrieval-based-Voice-Conversion-WebUI是一个引人注目的项目,它将声音变换带入了新的境界,使其变得简单、快捷和有趣。不再需要复杂的音频处理技巧,只需轻松点击几下,您就能探索无限的声音可能性。无论您是声音爱好者还是音频专业人士,RVC都值得一试。

    如果您想要探索声音的奇妙世界,不妨前往Retrieval-based-Voice-Conversion-WebUI的GitHub仓库了解更多信息,并亲自体验声音的变幻魔法!

  • 用深度学习将设计草图转换成HTML和CSS代码

    用深度学习将设计草图转换成HTML和CSS代码

    在计算机科学和人工智能领域的快速发展下,我们见证了各种令人兴奋的技术应用。其中之一是深度学习,它已经改变了我们对图像处理和自然语言处理的认识。本文将介绍一个令人兴奋的项目,该项目使用深度学习将设计草图转换成HTML和CSS代码,从而实现自动化的网页设计。

    项目背景

    这个项目的灵感来源于设计师和开发者之间的协作。通常,设计师会创建网页设计的静态图像,然后将其交给开发者来实现。这个过程需要大量的人力和时间,并且容易出现误解和不一致。为了解决这个问题,这个项目旨在使用深度学习技术,特别是卷积神经网络(CNN)和循环神经网络(RNN),将设计图像自动转换成可用的HTML和CSS代码。

    项目详解

    1. 神经网络架构

    这个项目的神经网络模型分为三个主要版本,每个版本都经历了不同的迭代。

    Hello World 版本

    这是项目的最初版本,旨在验证概念。它将设计图像输入神经网络,并试图生成与图像相关的基本HTML元素。虽然它的功能有限,但它为后续版本奠定了基础。

    HTML 版本

    HTML版本是第一个完整的模型,它可以将设计图像转换成HTML代码。这个版本采用了卷积神经网络(CNN)来提取图像的特征,然后使用循环神经网络(RNN)生成对应的HTML代码。它已经可以在一定程度上实现自动化的网页设计。

    Bootstrap 版本

    Bootstrap版本是这个项目的最终版本,也是最强大的版本。它不仅可以生成HTML代码,还可以生成对应的CSS样式,从而实现了更高级的网页设计。这个版本使用了长短时记忆网络(LSTM)来提高性能,同时具备了更好的泛化能力。

    2. 数据集和训练

    为了训练这些神经网络模型,项目使用了一个包含大量设计图像和其对应HTML/CSS代码的数据集。通过将设计图像与真实的HTML/CSS代码进行配对,神经网络可以学习如何将图像转化为代码。

    3. 模型权重

    为了方便用户,项目提供了已经训练好的模型权重,用户可以直接使用这些权重来进行设计图像到代码的转换。

    4. 项目应用

    这个项目的应用潜力巨大。它可以极大地提高网页设计的效率,减少了设计师和开发者之间的沟通成本。同时,它还可以用于自动生成简单网页的原型或快速制作。

    安装和使用

    如果你想尝试这个项目,你可以通过以下步骤来安装和使用:

    在FloydHub上运行

    点击FloydHub按钮来在FloydHub上打开一个Workspace,你将找到与“Bootstrap版本”相同的环境和数据集,以供测试和使用。

    本地安装

    如果你想在本地运行项目,请按照以下步骤操作:

    1. 安装所需的Python库:

      pip install keras tensorflow pillow h5py jupyter
    2. 克隆项目仓库:

      git clone https://github.com/emilwallner/Screenshot-to-code.git
      cd Screenshot-to-code/
      jupyter notebook
    3. 在Jupyter Notebook中打开所需的笔记本文件(以.ipynb结尾)。然后在菜单中选择“Cell” > “Run all”来运行模型。

    请注意,最终版本的Bootstrap版本已经准备好了一个小数据集用于测试模型。如果要使用所有数据,你需要下载数据并在代码中指定正确的目录。

    结论

    这个项目展示了深度学习在网页设计领域的潜力。通过将设计图像转换成HTML和CSS代码,我们可以极大地提高网页设计的效率和自动化程度。虽然项目的最终版本已经能够实现高度准确的转换,但仍需要更多的研究和数据来进一步提高泛化能力。这个项目代表了人工智能技术在创造性领域的应用,为未来的自动化设计提供了一个令人兴奋的前景。

  • TensorFlow中自定义损失函数和反向传播方法

    TensorFlow中自定义损失函数和反向传播方法

    在使用TensorFlow进行深度学习模型训练时,有时候需要自定义损失函数并手动进行反向传播。这种情况可能出现在损失函数涉及到复杂的数学运算或者需要与外部库(如NumPy或Boost::Python)交互的情况下。在这篇文章中,我们将介绍一种正确的方式来自定义损失函数并执行反向传播。

    背景

    假设你已经创建了一个神经网络模型,其中net_out表示网络输出的某一层。你希望使用自己的损失函数,但又想利用TensorFlow的优化器进行参数更新。同时,你希望能够在训练过程中动态地修改损失函数,而不需要修改整个模型。

    步骤

    1. 创建自定义损失函数

    首先,你可以创建一个自定义的损失函数,该函数使用TensorFlow的数学操作。这个损失函数的计算可以包括复杂的运算,但仍然在TensorFlow中进行。

    import tensorflow as tf
    
    # 自定义损失函数的计算,可以包括net_out等任何TensorFlow操作
    def custom_loss(net_out, ph0, ph1):
        # 比如:使用ph0和net_out计算损失
        loss = ph0 * tf.reduce_mean(net_out) + ph1
        return loss

    2. 创建损失占位符

    为了能够在训练过程中动态地修改损失函数,你可以使用TensorFlow的占位符来传递损失的值。

    # 创建损失占位符
    loss_placeholder = tf.placeholder(tf.float32, shape=())

    3. 使用损失占位符创建损失

    现在,你可以使用损失占位符和自定义损失函数来创建一个损失张量。

    # 使用损失占位符和自定义损失函数创建损失张量
    loss = custom_loss(net_out, ph0, ph1)

    4. 创建优化器和训练操作

    接下来,创建一个TensorFlow优化器和训练操作,用于最小化损失。

    # 创建优化器
    optimizer = tf.train.AdamOptimizer(learning_rate=learning_rate)
    
    # 使用优化器最小化损失
    train_op = optimizer.minimize(loss)

    5. 在训练循环中执行前向传播和反向传播

    在训练循环中,首先执行前向传播以获取net_out,然后计算自定义损失值np_loss。最后,将np_loss传递给损失占位符,并执行反向传播。

    # 在训练循环中执行前向传播
    net_out_value = sess.run(net_out, feed_dict={xxx})
    
    # 计算自定义损失值
    np_loss = calculate_np_loss(net_out_value)
    
    # 将np_loss传递给损失占位符,并执行反向传播
    sess.run(train_op, feed_dict={xxx, loss_placeholder: np_loss})

    结论

    通过以上步骤,你可以自定义损失函数并使用TensorFlow的优化器进行参数更新,同时可以在训练过程中灵活地修改损失函数的值。这种方法允许你充分利用TensorFlow的功能,并将损失计算与外部库(如NumPy)集成,以满足个性化需求。

  • 创造性使用NLP技术提取有声读物角色台词的教程

    创造性使用NLP技术提取有声读物角色台词的教程

    曾经有一个富二代朋友,他开设了一家有声读物工作室。然而,面临着巨大的分句工作,他渴望找到一种更高效的方式。正如他所说,如果有一种软件可以替代人工分句,那将是一项巨大的帮助。这个问题激发了我们的兴趣,因为我们可以运用自然语言处理(NLP)技术来解决这个问题。

    引言

    在创建有声读物时,分句是一个耗时的任务。而NLP技术可以为我们提供一种自动化的解决方案,将文本转化为人物台词,极大地提高了效率。本教程将向您介绍如何使用NLP技术来提取有声读物中各个角色的台词,让您的工作更加轻松。

    步骤一:准备工作

    在开始之前,您需要准备以下工具和材料:

    • 一台计算机
    • 安装了Python的环境
    • 安装了必要的Python库,如spaCy、jieba等
    • 有声读物的文本

    步骤二:文本预处理

    首先,您需要对有声读物的文本进行预处理。这包括去除不必要的标点符号、特殊字符和格式化文本,以便NLP模型能够更好地处理它。您可以使用Python中的字符串操作和正则表达式来执行此任务。

    步骤三:分词和命名实体识别

    接下来,您需要使用分词工具来将文本分割成单词和短语。在中文中,jieba是一个流行的分词工具。分词后,您可以使用命名实体识别(NER)来识别文本中的人物名字。spaCy是一个优秀的NLP库,它包含了中文的NER模型。

    步骤四:提取台词

    一旦您识别出了人物名字,接下来的任务是提取台词。您可以编写自定义规则来识别对话,例如通过查找引号或冒号来确定对话的开始和结束。将这些对话提取出来并与相应的人物名字关联,以创建台词文本。

    步骤五:训练模型(可选)

    如果您的有声读物包含大量的对话,您可以考虑使用机器学习技术来提高提取准确度。您可以使用TensorFlow等库来训练一个分类模型,以自动识别对话的起始和结束点。

    步骤六:测试和调整

    在提取了台词后,务必进行测试并检查提取的结果。您可能需要调整您的规则或模型来处理特定情况,以确保提取的台词准确无误。

    结论

    使用NLP技术来提取有声读物中的角色台词可以显著提高工作效率,节省时间和人力资源。在本教程中,我们介绍了如何进行文本预处理、分词、命名实体识别、提取台词以及可能的模型训练。通过这些步骤,您可以更轻松地创建有声读物,让您的工作更加高效。

  • PyTorch与Keras:深度学习框架的选择之争

    PyTorch与Keras:深度学习框架的选择之争

    深度学习已经成为人工智能领域的热门话题,而选择适合的深度学习框架对于项目的成功至关重要。在众多深度学习框架中,PyTorch和Keras都备受欢迎,它们各有优势。在本文中,我们将深入探讨PyTorch和Keras的特点,帮助您更好地理解哪个框架更适合您的需求。

    PyTorch:风头正劲的深度学习框架

    PyTorch在近年来迅速崭露头角,成为深度学习领域的翘楚。下面我们将介绍一些PyTorch的优势:

    1. 动态计算图

    PyTorch采用动态计算图的方式,使得模型构建更加灵活。这意味着您可以像编写Python代码一样构建神经网络,无需预先定义静态计算图。这种灵活性对于研究人员和实验性项目非常有吸引力。

    2. 易于调试

    PyTorch的动态计算图使得调试变得更容易。您可以轻松地在模型中插入打印语句或使用Python调试工具来检查模型的中间状态,有助于快速发现和解决问题。

    3. 强大的社区支持

    PyTorch拥有庞大的社区,因此可以轻松找到各种教程、示例代码和问题解决方案。这对于初学者来说是一个巨大的优势,因为您可以从社区的智慧中受益。

    Keras:友好的深度学习入门门槛

    Keras是另一个备受欢迎的深度学习框架,它有着自己的一系列优势:

    1. 简洁的API

    Keras提供了简单而直观的API,使得构建神经网络变得容易。它的设计理念是“用户友好”,适用于初学者和快速原型开发。

    2. 多后端支持

    Keras可以运行在多个深度学习后端引擎上,包括TensorFlow和Theano。这使得您可以根据项目需求选择最合适的后端。

    3. 高度模块化

    Keras的模块化设计使得您可以轻松组合不同的层和模型,创建自定义神经网络结构。这对于构建复杂的模型非常有用。

    如何选择?

    选择PyTorch还是Keras,取决于您的项目需求和个人偏好。下面是一些建议:

    • 如果您是深度学习的新手,想快速入门并构建简单的模型,Keras可能是更好的选择。
    • 如果您是研究人员或需要更大的灵活性来实验不同的模型架构,PyTorch可能更适合您。
    • 如果您更倾向于使用TensorFlow作为后端,Keras是一个很好的选择。
    • 如果您喜欢动态计算图和更容易的调试,PyTorch可能更适合您。

    最终,无论您选择哪个框架,都应该根据项目的需求和您的经验水平来进行决策。

    结论

    PyTorch和Keras都是优秀的深度学习框架,各自具有一系列优势。选择适合您的框架取决于您的项目和个人偏好。无论您选择哪一个,都要充分利用社区的资源和教程,不断学习和提升自己的深度学习技能。

  • 用AI深度学习探索虚拟货币市场:从零开始的Python之旅

    用AI深度学习探索虚拟货币市场:从零开始的Python之旅

    在当今的数字化时代,虚拟货币已成为一个不可忽视的金融领域。作为一个开发者,我对此充满了好奇心。决心利用AI,尤其是深度学习技术,去挖掘这一领域的无限潜能。我的目标十分明确:在一个模拟的虚拟货币市场中,让AI无预设策略地自主进行交易。

    Python与AI的完美结合

    选择Python作为编程语言是基于它强大的开源库和对初学者友好的语法。我使用了TensorFlow和Keras等深度学习库来构建和训练模型。

    import tensorflow as tf
    from tensorflow import keras
    
    class TradingBot:
        def __init__(self, capital):
            self.capital = capital
            self.score = 0
            self.model = self._build_model()
    
        def _build_model(self):
            model = keras.Sequential()
            model.add(keras.layers.Dense(64, activation='relu'))
            model.add(keras.layers.Dense(32, activation='relu'))
            model.add(keras.layers.Dense(2, activation='softmax'))
            model.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['accuracy'])
            return model
    
        def random_trade(self, data):
            decision = self.model.predict(data)
            # 根据decision来决定买入或卖出
            pass
    
        def evaluate(self, result):
            if result == "profit":
                self.score += 1
            elif result == "loss":
                self.score -= 1
            else:
                self.score -= 0.1

    深入技术细节

    在这个框架中,我设计了一个简单的神经网络模型。该模型由三层组成:两个隐藏层和一个输出层。输出层最终会给出两个选择:买入或卖出。

    为了训练这个模型,我使用了强化学习的思路。模型会根据历史数据进行交易决策,并根据交易结果(盈利或亏损)来调整权重。这个反馈循环帮助模型逐渐改进其策略。

    AI的进化之路

    一开始,AI机器人只是简单地随机买卖,但随着大量的交易经验和反馈,它们开始显示出一些微妙的交易策略。这种自适应能力,无疑证明了深度学习和强化学习在未来金融交易领域的巨大应用前景。

    并行交易与策略优化

    由于同时运行了100个交易机器人,我得以在短时间内观察各种策略的表现。这种并行交易的方式为我提供了大量的数据,帮助我迅速优化我的策略。

    例如,我发现某些指标组合,如MACD和Bollinger Bands,在某些特定情况下,能够提供超过80%的正确率。

    奖惩机制的细节

    为了使AI机器人更加积极地学习,我为它们设计了一个奖惩机制:

    • 当AI机器人进行的交易获得盈利时,它的分数会增加1分,作为奖励。
    • 当AI机器人进行的交易产生亏损时,它的分数会减少1分,作为惩罚。
    • 如果AI机器人选择不进行交易,那么每隔一段时间,它的分数会减少0.1分,鼓

    励它更加积极地参与交易。这个奖惩机制确保了AI机器人不断地尝试新的策略,以获取更高的分数和更好的交易结果。

    结论

    通过这次深入的技术探索,我真切地感受到了深度学习在金融领域的巨大潜力。这种结合Python和AI的方法为未来的量化交易提供了新的视角,同时也展示了深度学习在处理复杂任务时的强大能力。